目录
[1. 为什么企业 Agent 不能只有 ReAct?](#1. 为什么企业 Agent 不能只有 ReAct?)
[2. Graph到底是什么?](#2. Graph到底是什么?)
[3. 第一步不是写API,而是拆业务流程](#3. 第一步不是写API,而是拆业务流程)
[4. State:整个Graph共享的业务上下文](#4. State:整个Graph共享的业务上下文)
[4.1 ReplaceStrategy](#4.1 ReplaceStrategy)
[4.2 AppendStrategy](#4.2 AppendStrategy)
[5. 一个很重要的原则:State不要存Prompt](#5. 一个很重要的原则:State不要存Prompt)
[5.1 Prompt可以独立迭代](#5.1 Prompt可以独立迭代)
[5.2 不同Node可以使用同一份数据](#5.2 不同Node可以使用同一份数据)
[5.3 更容易调试](#5.3 更容易调试)
[6. Node怎么设计?先完成一个工单分类节点](#6. Node怎么设计?先完成一个工单分类节点)
[7. Edge:让Graph真正形成工作流](#7. Edge:让Graph真正形成工作流)
[8. 为什么复杂任务应该交给Agent?](#8. 为什么复杂任务应该交给Agent?)
[9. Human-in-the-Loop:Graph为什么需要暂停和恢复?](#9. Human-in-the-Loop:Graph为什么需要暂停和恢复?)
[10. Checkpoint解决的,不只是"保存记忆"](#10. Checkpoint解决的,不只是“保存记忆”)
[11. 从Demo到生产,还需要解决哪些问题?](#11. 从Demo到生产,还需要解决哪些问题?)
[11.1 超时与重试](#11.1 超时与重试)
[11.2 幂等](#11.2 幂等)
[11.3 可观测性](#11.3 可观测性)
[12. 最后把完整Graph组装起来](#12. 最后把完整Graph组装起来)
[13. Graph为什么越来越像Agent Runtime?](#13. Graph为什么越来越像Agent Runtime?)
[14. Workflow、Agent、Graph到底怎么选?](#14. Workflow、Agent、Graph到底怎么选?)
前言
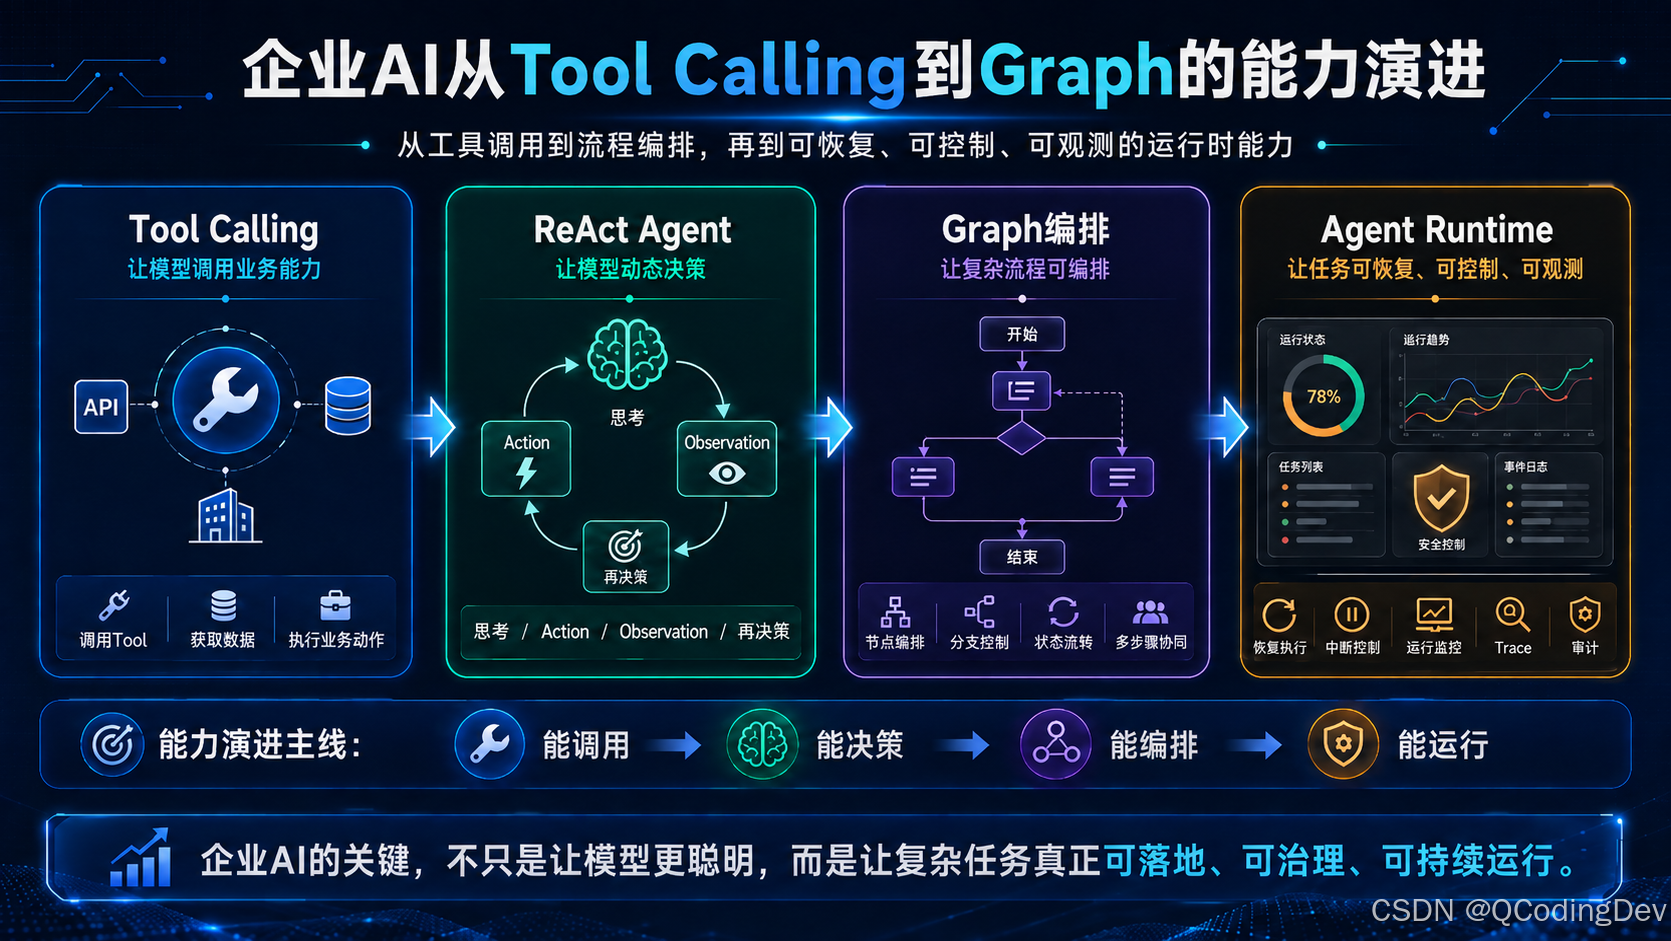
前面我们已经聊过 Tool Calling 和 ReAct Agent。
Tool Calling 解决的是:
如何让大模型不只是"说",而是真正调用企业系统完成查询、计算和操作。
ReAct Agent 又向前走了一步:
不再由开发者提前规定每一步,而是让模型根据当前任务动态决定下一步调用什么工具、如何继续执行。
于是很容易产生一个问题:
既然 Agent 已经可以自己思考、自己调用工具,为什么企业 AI 还需要 Workflow?
原因其实并不复杂。
企业业务真正需要的,往往不是一个"完全自由发挥"的 Agent,而是一套:
关键流程确定、局部决策智能、执行状态可追踪、异常可以恢复、高风险操作可以人工介入的执行系统。
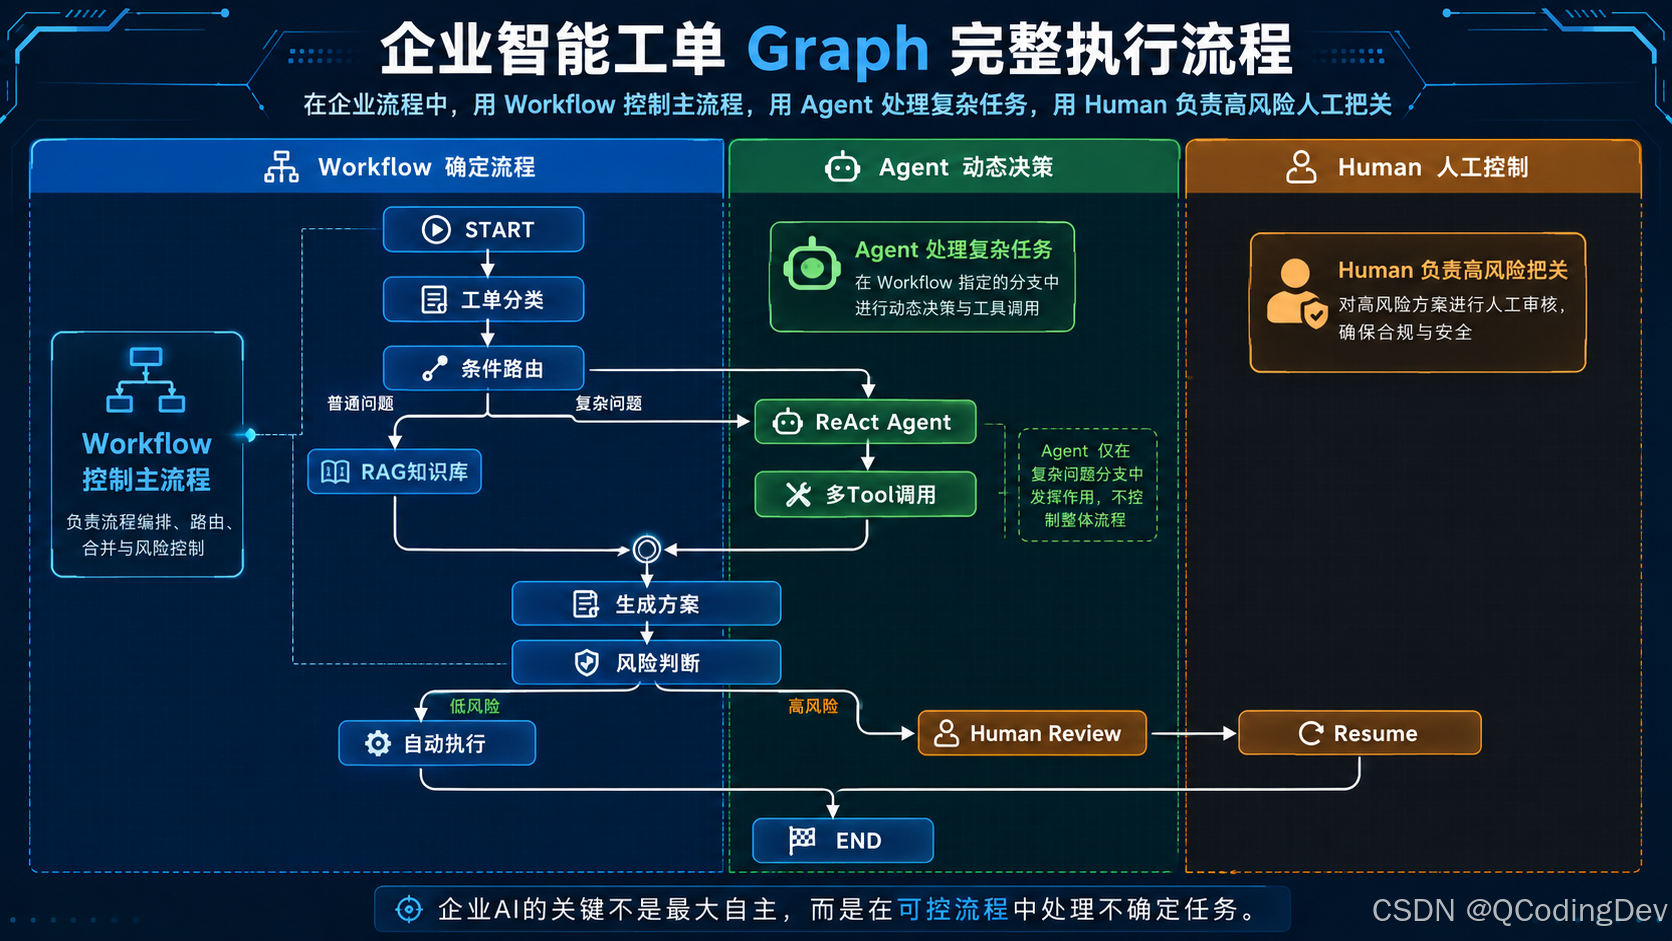
例如一个企业智能工单,完整流程可能是:
用户提交工单 → 问题分类 → 选择处理方式 → 知识库检索 / Agent 分析 → 生成处理方案 → 风险判断 → 自动执行 / 人工审核 → 完成工单
这里有些步骤应该固定执行,有些步骤适合交给 Agent,还有一些高风险步骤必须经过人工确认。
这其实就是典型的:
Workflow + Agent + Human-in-the-Loop。
而在 Spring AI Alibaba 中,Graph 提供的正是这类复杂 AI 工作流的建模与执行能力。
需要先说明一个容易混淆的概念:
Workflow 是业务流程,Graph 是对 Workflow / Agent 执行流程进行建模、编排和运行的一种机制。
所以:
Graph ≠ Workflow。
更准确地说:
我们使用 Graph 来构建和运行 Workflow。
本文参考当前 Spring AI Alibaba Graph 官方工作流编排思路,但不会简单复述官方客服邮件示例,而是通过一个更通用的企业智能工单场景,理解 State、Node、Edge、Checkpoint、Human-in-the-Loop,以及 Graph 为什么会逐渐承担 Agent Runtime 的一部分职责。
**适用说明:**本文代码和接口设计基于 2026 年 8 月 Spring AI Alibaba Graph 官方文档示例整理。Graph Framework 仍在持续演进,具体 API 请以当前官方版本为准。
1. 为什么企业 Agent 不能只有 ReAct?
先看一个典型的 ReAct Agent。
用户提出问题之后,Agent 会经历:
理解问题 → 思考下一步 → 选择 Tool → 执行 Tool → 观察结果 → 再次思考 → 最终回答
它最大的优势就是:
灵活。
例如用户问:
我的订单为什么还没有发货?
Agent 可能动态决定:
- 查询订单状态;
- 发现订单已经付款;
- 查询商品库存;
- 发现库存不足;
- 查询预计补货时间;
- 根据这些信息生成解释。
开发者并不需要提前把每一种情况都写成固定流程。
这种模式非常适合:
- 原因分析;
- 动态工具选择;
- 多步骤信息收集;
- 开放式任务;
- 无法提前确定完整路径的复杂任务。
但如果用户说:
帮我修改这张订单的收货地址。
事情就完全不同了。
企业系统通常至少要经过:
身份校验 → 查询订单状态 → 判断是否允许修改 → 参数校验 → 用户确认 → 调用订单系统 → 更新结果 → 记录审计日志
其中:
- 身份校验不能跳过;
- 已经发货的订单不能修改;
- 修改之前需要确认;
- 最终操作必须留下审计记录。
这些属于确定性业务规则。
如果全部交给 Agent 自己判断,就意味着:
原本由 Java 代码、业务规则和权限体系控制的执行边界,被交给了概率模型。
这显然不是理想的企业系统设计。
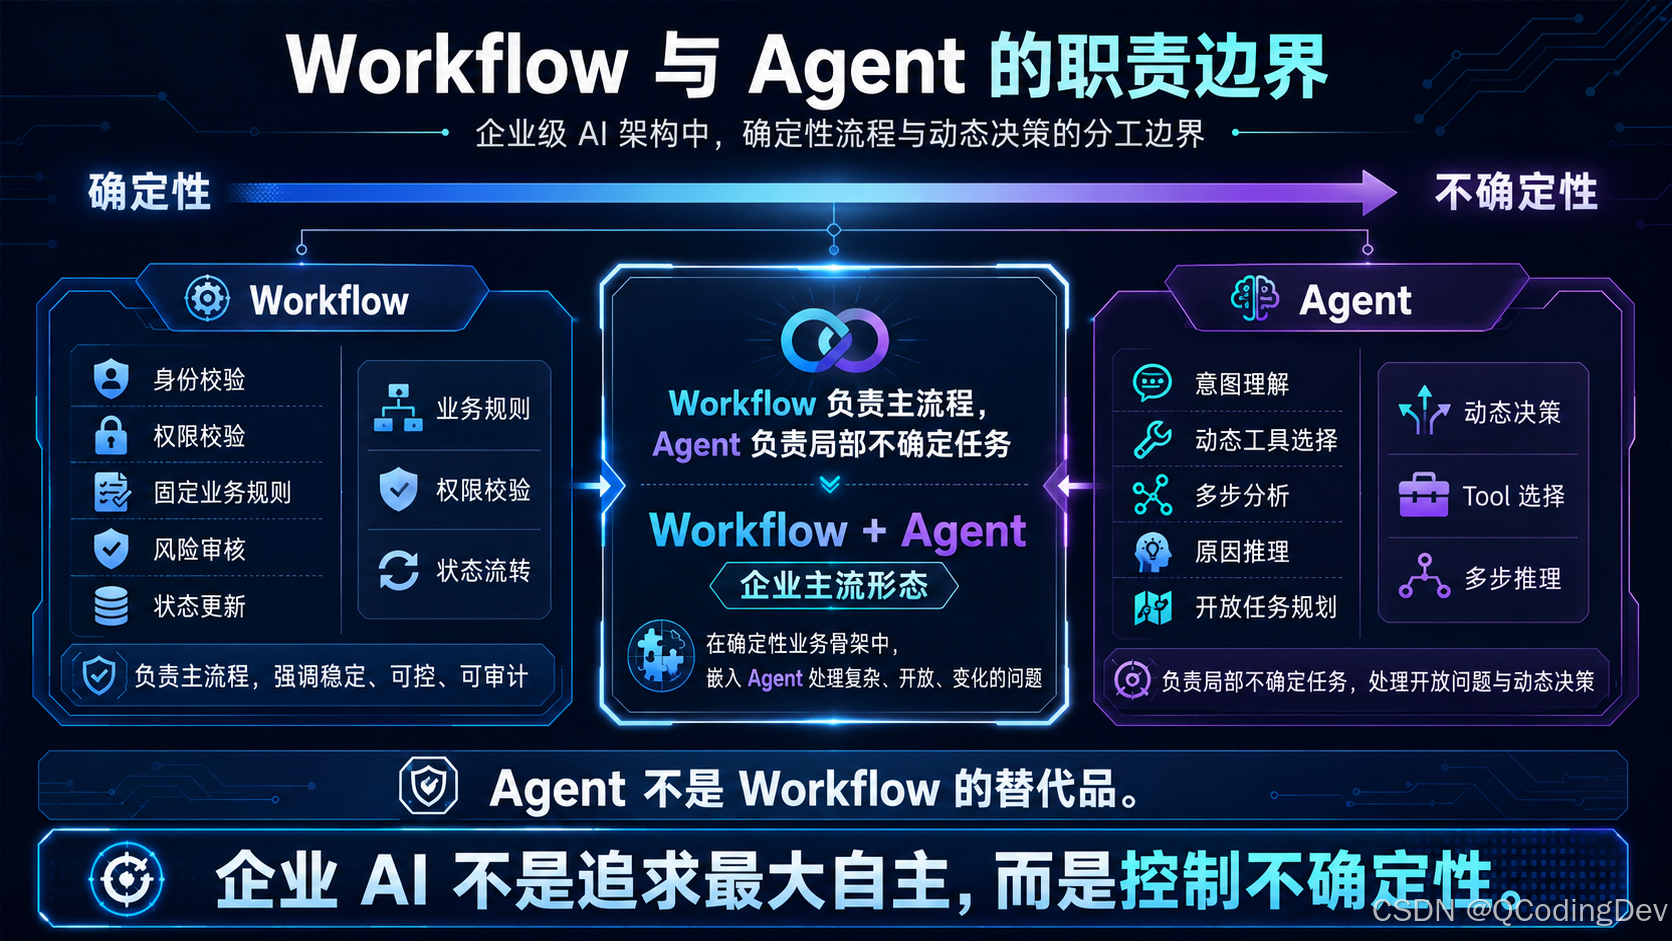
所以我更喜欢用一句话来区分:
Agent 解决"不知道下一步应该做什么",Workflow 解决"这几步必须这么做"。
真正的企业 AI 更常见的形态不是二选一,而是:
Workflow 控制主流程,Agent 负责局部不确定任务。
| 能力 | 更适合 Workflow | 更适合 Agent |
|---|---|---|
| 身份与权限校验 | ✅ | |
| 固定业务规则 | ✅ | |
| 状态流转 | ✅ | |
| 风险审核 | ✅ | |
| 意图理解 | ✅ | |
| 动态 Tool 选择 | ✅ | |
| 多步骤原因分析 | ✅ | |
| 开放式任务规划 | ✅ |
2. Graph到底是什么?
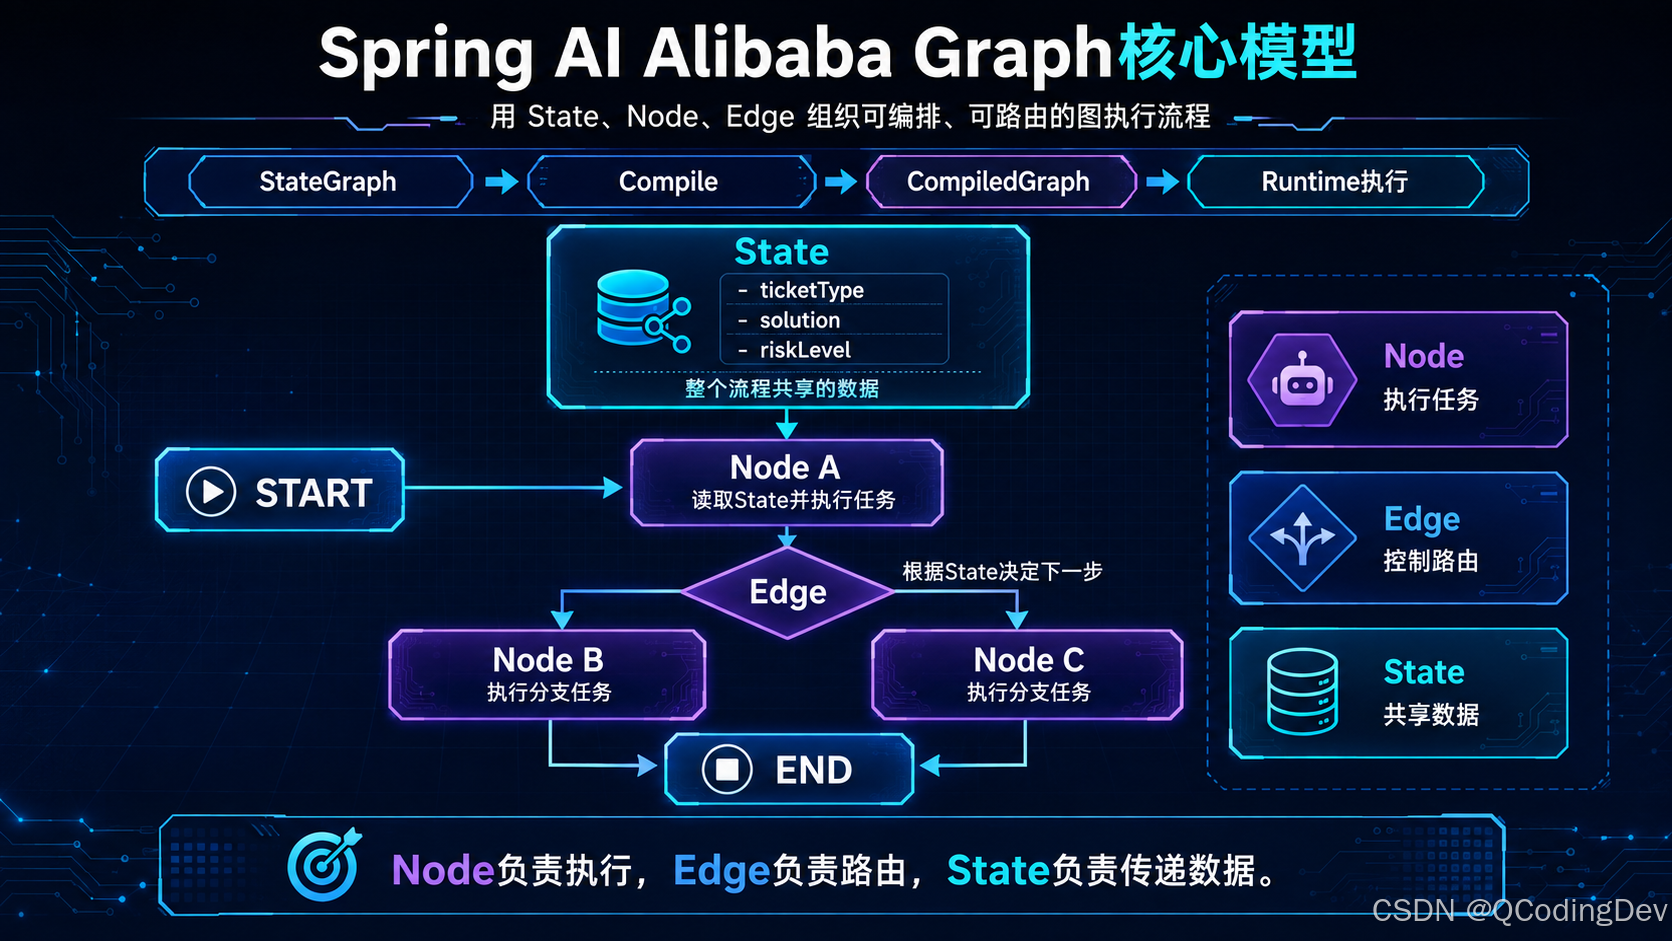
Spring AI Alibaba Graph 最核心的几个概念,其实并不复杂。
主要可以先记住五个:
| Graph概念 | 作用 | Java开发类比 |
|---|---|---|
| State | 保存整个流程共享的数据 | Context |
| Node | 完成一个具体任务 | Service 方法 |
| Edge | 决定节点之间如何流转 | if / switch / 路由 |
| StateGraph | 定义整个执行图 | Workflow Definition |
| CompiledGraph | 编译后真正可以执行的 Graph | Workflow Runtime |
最简单的一句话就是:
Node 负责执行任务,Edge 负责决定下一步去哪,State 负责在整个过程中传递数据。
例如一个最简单的 Graph 可以是:
START → classify → search → generate → END
但 Graph 真正有价值的地方,并不是把几个 Java 方法连接起来。
如果只是:
A 方法调用 B 方法,B 方法调用 C 方法
普通 Java Service 已经完全够用了。
Graph 真正解决的是:
如何把一次复杂 AI 任务,从"一次模型调用"变成一个有状态、可路由、可暂停、可恢复的执行过程。
这也是后面理解 Checkpoint、Human-in-the-Loop 和 Runtime 的基础。
3. 第一步不是写API,而是拆业务流程
Spring AI Alibaba 官方 Graph Quick Start 有一个思路,我非常认同:
先从需要自动化的流程开始,而不是先考虑 Graph API 怎么写。
企业 AI 开发尤其应该如此。
我们以一个企业智能工单为例。
系统需要支持:
- 产品使用问题;
- 系统故障;
- 账号问题;
- 订单问题;
- 复杂业务咨询。
完整业务过程可以先定义成:
读取工单 → 问题分类 → 选择处理方式 → 查询知识库 / Agent分析 → 生成方案 → 风险判断 → 自动处理 / 人工审核 → 完成工单
接下来再把它拆成 Node:
| Node | 职责 |
|---|---|
| classify_ticket | 工单分类 |
| search_knowledge | 查询知识库 |
| complex_agent | 复杂问题分析 |
| generate_solution | 生成处理方案 |
| risk_check | 风险判断 |
| human_review | 人工审核 |
| execute_action | 执行业务操作 |
到这里,其实 Graph 的主要骨架已经出现了。
这也是 Graph 开发和普通"写 Prompt"的一个明显区别:
我们首先设计的是任务执行过程,而不是 Prompt。
4. State:整个Graph共享的业务上下文
Graph 中的 Node 不会孤立执行。
一个工单从开始处理到最终结束,会持续产生各种数据,例如:
ticket_idticket_contentticket_typeknowledge_resultsagent_resultsolutionrisk_levelapprovedstatus
这些需要跨 Node 传递的数据,就应该进入 State。
Spring AI Alibaba Graph 可以通过 Key Strategy 定义不同状态字段的更新策略:
java
public static KeyStrategyFactory createStateStrategy() {

    return () -> {
        Map<String, KeyStrategy> strategies = new HashMap<>();

        strategies.put("ticket_id", new ReplaceStrategy());
        strategies.put("ticket_content", new ReplaceStrategy());
        strategies.put("ticket_type", new ReplaceStrategy());

        strategies.put("knowledge_results", new ReplaceStrategy());
        strategies.put("agent_result", new ReplaceStrategy());

        strategies.put("solution", new ReplaceStrategy());
        strategies.put("risk_level", new ReplaceStrategy());

        strategies.put("approved", new ReplaceStrategy());
        strategies.put("status", new ReplaceStrategy());

        strategies.put("messages", new AppendStrategy());

        return strategies;
    };
}
这里比较常见的是两种策略。
4.1 ReplaceStrategy
新的值覆盖旧值。
例如:
ticket_typerisk_levelstatus
这些字段通常只需要保留当前状态。
4.2 AppendStrategy
新的数据追加到已有数据之后。
例如:
messages- 多轮执行记录;
- 某些需要保存历史的数据。
这也是为什么 State 不能简单理解成:
一个 Map。
真正重要的是:
State 是整个 Graph 执行过程中的共享业务上下文。
5. 一个很重要的原则:State不要存Prompt
官方 Graph 文档中特别强调了一点:
State 应该保存原始数据,而不是已经拼装好的 Prompt 文本。
我认为这一点在真实项目里非常重要。
例如知识库查询结果,更合理的是:
java
knowledge_results = List<Document>而不是把它提前变成:
java
String prompt = """
        以下是知识库查询结果:
        文档1:...
        文档2:...

        请根据这些内容回答用户问题。
        """;
为什么?
因为:
State 是业务数据,Prompt 是某个具体 Node 使用这些业务数据的方式。
正确关系应该是:
State 原始数据 → Node读取数据 → Prompt Template组织上下文 → LLM执行
这样做至少有三个明显好处。
5.1 Prompt可以独立迭代
例如:
Prompt V1 → V2 → V3
不需要修改整个 Graph 的状态结构。
5.2 不同Node可以使用同一份数据
同样的知识库结果:
- 生成节点可以用于回答;
- 风险节点可以用于判断依据是否充分;
- 审核节点可以展示给人工审核人员。
5.3 更容易调试
如果 State 里保存的是原始数据,就可以明确知道:
- RAG 实际召回了什么;
- Agent 得到了什么;
- Node 输入是什么;
- Prompt 又做了什么转换。
这其实仍然是传统软件工程中很重要的一条原则:
业务数据和表现形式分离。
到了 Agent 开发里,这个原则并没有失效。
6. Node怎么设计?先完成一个工单分类节点
Node 本质上就是:
读取当前 State → 执行任务 → 返回需要更新的 State。
例如我们实现一个工单分类节点:
java
public class ClassifyTicketNode implements NodeAction {

    private final ChatClient chatClient;

    public ClassifyTicketNode(ChatModel chatModel) {
        this.chatClient = ChatClient.builder(chatModel).build();
    }

    @Override
    public Map<String, Object> apply(OverAllState state) {

        String ticketContent = state
                .value("ticket_content")
                .map(Object::toString)
                .orElse("");

        String result = chatClient.prompt()
                .system("""
                        你是企业工单分类助手。

                        请将当前工单分类为:
                        faq:普通知识问题
                        business:普通业务问题
                        complex:复杂分析问题

                        只返回分类结果。
                        """)
                .user(ticketContent)
                .call()
                .content();

        return Map.of(
                "ticket_type", result
        );
    }
}
这个 Node 的职责非常清晰:
- 从 State 获取
ticket_content; - 调用模型完成分类;
- 返回
ticket_type; - Graph 将新的数据合并回 State。
Node 本身并不关心:
分类完成以后应该执行哪个节点。
路由应该交给 Edge。
Node应该拆多细?
这里有一个很实用的原则:
一个 Node 最好只负责一个可以独立描述、独立观察、独立失败的业务步骤。
例如:
classify_ticket只负责分类;search_knowledge只负责检索;risk_check只负责风险判断。
不要直接写成:
handleTicket();然后在一个方法里同时完成:
分类、检索、生成、风险判断、执行。
这样即使使用了 Graph,本质上仍然只是把一个大方法包装成 Node。
合理拆分以后,如果最终结果异常,我们可以明确看到:
- 分类节点:SUCCESS
- 知识库节点:SUCCESS
- Agent节点:SUCCESS
- 风险判断节点:FAILED
同时也更方便:
- 节点级测试;
- 节点级重试;
- 节点级监控;
- 中间状态检查;
- Checkpoint;
- 失败恢复。
这也是官方文档为什么强调 Node 粒度的重要原因。
7. Edge:让Graph真正形成工作流
如果所有 Node 永远都是:
A → B → C → D
那么普通 Java 调用链同样可以完成。
Graph 真正开始体现价值,是因为它可以根据 State 进行:
条件路由。
例如工单分类后:
faq→ 查询知识库;business→ 普通业务处理;complex→ 交给 Agent。
可以定义:
java
workflow.addConditionalEdges(
        "classify_ticket",

        edge_async(state -> state
                .value("ticket_type")
                .map(Object::toString)
                .orElse("complex")),

        Map.of(
                "faq", "search_knowledge",
                "business", "business_handler",
                "complex", "complex_agent"
        )
);
这样整个执行流程就会根据 State 动态选择路径。
例如用户问:
怎么修改账号绑定手机号?
可能执行:
classify_ticket → search_knowledge → generate_solution
而用户问:
昨天开始偶发订单创建失败,有些用户又可以正常下单,帮我分析原因。
可能执行:
classify_ticket → complex_agent → generate_solution
同一套 Graph,根据不同输入形成不同执行路径。
这就是 Graph 和简单 Pipeline 的一个明显区别。
8. 为什么复杂任务应该交给Agent?
假设用户提出:
昨天开始订单服务偶发失败,但是部分用户仍然可以正常创建订单,帮我分析可能是什么原因。
这类问题很难提前规定:
第一步必须查什么,第二步必须查什么。
Agent 可能需要:
- 查询订单服务状态;
- 查询异常日志;
- 查看数据库连接情况;
- 查询最近发布时间;
- 分析异常时间分布;
- 再次查询指定实例日志。
而另一个问题的分析过程可能完全不同。
如果继续用 Workflow 穷举所有路径,最终很容易变成:
大量 if / else if / switch 和复杂分支。
这种局部高度不确定的任务,更适合交给 ReAct Agent。
因此更合理的结构是:
Graph控制主流程 → 识别复杂任务 → ReAct Agent动态执行 → 返回分析结果 → Graph继续后续流程
这时候 Agent 只是 Graph 中负责"不确定任务"的一个执行单元。
整体关系可以理解为:
Workflow 中嵌 Agent,而不是让 Agent 接管整个 Workflow。
例如 Agent 可以负责:
- 动态 Tool 选择;
- 多步信息收集;
- 原因分析;
- 开放式决策。
而 Graph 继续负责:
- 主流程;
- 状态流转;
- 风险控制;
- 人工审核;
- 后续确定性业务动作。
9. Human-in-the-Loop:Graph为什么需要暂停和恢复?
假设 Agent 最终给出的建议是:
重新执行订单扣款。
接下来能不能直接执行?
在真实企业系统里,很多情况下不应该。
例如:
- 发起退款;
- 修改订单;
- 删除资源;
- 修改权限;
- 数据写操作;
- 发送重要通知。
这些操作应该根据风险等级决定:
自动执行,还是人工确认后再执行。
因此可以设计:
generate_solution → risk_check → LOW自动执行 / HIGH人工审核
但这里有一个很重要的问题。
很多 Demo 所谓的人工审核只是:
java
if (highRisk) {
    return "等待审核";
}
这其实只是把业务状态改成了:
等待审核。
真正的 Human-in-the-Loop 还需要回答:
- JVM 重启以后怎么办?
- 人工两小时以后才审核怎么办?
- Graph 如何知道之前执行到了哪里?
- 已经完成的节点是否重新执行?
- 审核通过以后如何从原位置继续?
这就需要:
Checkpoint + Interrupt + Resume。
Spring AI Alibaba Graph 可以通过 interruptBefore 在指定 Node 之前暂停:
java
MemorySaver saver = new MemorySaver();

CompileConfig compileConfig = CompileConfig.builder()
        .saverConfig(
                SaverConfig.builder()
                        .register(saver)
                        .build()
        )
        .interruptBefore("human_review")
        .build();

CompiledGraph graph = workflow.compile(compileConfig);
当 Graph 执行到 human_review 之前时,会暂停当前执行。
同时通过 Checkpointer 保存执行状态。
每次 Graph 执行还可以使用一个 threadId:
java
RunnableConfig config = RunnableConfig.builder()
        .threadId("ticket-202608260001")
        .build();
可以把 threadId 理解成:
一次 Graph 执行实例的标识。
例如:
- 工单 10001;
- 工单 10002;
- 工单 10003;
它们虽然运行的是同一个 Graph Definition,但每一个实例都有自己的:
- State;
- Checkpoint;
- 执行位置;
- 业务数据。
第一次执行:
java
Map<String, Object> initialState = Map.of(
        "ticket_id", "ticket-10001",
        "ticket_content", "订单扣款异常,请帮我处理"
);

graph.stream(initialState, config)
        .doOnNext(output -> log.info("节点输出: {}", output))
        .blockLast();
当流程执行到人工审核前,会自动中断。
此时可以读取当前状态:
java
var currentState = graph.getState(config);

Map<String, Object> stateData =
        currentState.state().data();
人工审核通过以后更新 State:
java
var updatedConfig = graph.updateState(
        config,
        Map.of(
                "approved", true
        ),
        null
);
然后继续执行:
java
graph.stream(null, updatedConfig)
        .doOnNext(output -> log.info("节点输出: {}", output))
        .blockLast();
这里最关键的一点是:
不是重新从 START 执行一次。
而是:
保存执行现场 → 暂停 → 等待人工输入 → 更新 State → 从原执行流程继续。
这才是真正意义上的 Human-in-the-Loop。
10. Checkpoint解决的,不只是"保存记忆"
上面的例子使用的是:
MemorySaver它非常适合:
- 本地开发;
- Demo;
- 单元测试;
- 快速验证。
但生产环境显然不能只依赖 JVM 内存。
否则服务一旦重启:
执行状态也会跟着消失。
因此生产环境中的 Checkpoint 更重要的价值,是:
保存 Workflow 的执行现场。
例如一个长流程:
开始任务 → Node A → Checkpoint → Node B → Checkpoint → 等待人工审核 → 服务重启 → 加载Checkpoint → 继续后续Node
这样才真正具备长任务执行能力。
所以:
Checkpoint ≠ 普通聊天记忆。
它解决的是:
这个 Workflow 已经执行到了哪里,现在状态是什么,恢复以后应该从哪里继续。
从工程角度看,这已经开始非常接近传统 Workflow Engine 的 Runtime 能力了。
11. 从Demo到生产,还需要解决哪些问题?
用了 Graph,并不意味着系统自动变成生产级 Agent。
Graph 解决了任务编排和运行机制,但真正上线以后,还需要继续补齐:
11.1 超时与重试
不同 Node 应该根据调用对象设置不同策略。
例如:
| 节点类型 | 示例超时思路 |
|---|---|
| 普通内部Tool | 秒级 |
| RAG检索 | 秒级 |
| 外部HTTP Tool | 根据SLA设置 |
| LLM Node | 根据模型和任务单独设置 |
具体参数不应该简单复制统一值,而要根据:
- 服务 SLA;
- 模型延迟;
- 用户体验;
- 下游接口特性;
进行配置和压测。
重试也不是所有异常都适合。
例如:
适合有限重试:
- 网络瞬时异常;
- 429;
- 临时服务不可用。
通常不应该重试:
- 参数错误;
- 权限不足;
- 业务规则拒绝;
- 明确的数据不存在。
官方 Graph 文档也将错误区分成不同类型:
| 错误类型 | 处理方式 |
|---|---|
| 瞬时错误 | 系统重试 |
| LLM可恢复错误 | 将错误写入State,让Agent重新规划 |
| 用户可修复错误 | 暂停流程等待输入 |
| 未知错误 | 向上抛出,进入异常治理 |
这非常值得在生产环境里继续扩展。
例如 Tool 调用发现订单号不存在,可以把错误写入 State:
java
return Map.of(
        "tool_error", "ORDER_NOT_FOUND",
        "next_node", "complex_agent"
);
Agent 再根据:
ORDER_NOT_FOUND
决定要求用户补充正确订单号,而不是整个系统统一返回:
java
catch (Exception e) {
    return "系统繁忙";
}
也就是说:
错误本身,也可以成为 Workflow 的一部分。
11.2 幂等
假设一个流程:
生成退款方案 → 人工审核 → 执行退款 → 保存Checkpoint
出现一种异常情况:
退款已经成功,但保存 Checkpoint 失败。
系统恢复以后,如果再次执行退款节点,就可能造成重复退款。
因此所有具有副作用的 Node / Tool,都应该考虑幂等。
可以使用类似:
workflowInstanceId + nodeId + businessId
生成 idempotencyKey。
业务系统执行前先检查:
当前操作是否已经成功完成?
如果已经成功,就直接返回已有结果,而不是重复执行。
所以:
Checkpoint 解决"执行到了哪里",幂等解决"已经做过的事情不能重复做"。
两者不能互相替代。
11.3 可观测性
一个完整 Graph 在线上运行以后,仅仅知道:
请求耗时 23 秒。
远远不够。
更应该能够看到:
| Node | 耗时 | 状态 | 关键数据 |
|---|---|---|---|
| classify_ticket | 230ms | SUCCESS | faq |
| search_knowledge | 420ms | SUCCESS | TopK结果 |
| complex_agent | 8.3s | SUCCESS | Token / Tool |
| risk_check | 180ms | SUCCESS | HIGH |
| human_review | WAITING | PAUSED | 等待人工 |
| execute_action | 620ms | SUCCESS | 执行结果 |
进一步还可以记录:
- Graph Instance ID;
- 节点输入输出;
- State变化;
- 模型信息;
- Token;
- Tool调用;
- 异常;
- 重试次数;
- 实际执行路径;
- Human Review;
- Audit Log。
否则 Agent 越复杂,线上越接近黑盒。
Graph 一个很重要的工程价值,就是:
把原本隐藏在"大Agent"中的执行过程拆开。
拆开以后,才有机会真正做到:
可观察、可调试、可恢复、可评测。
12. 最后把完整Graph组装起来
现在整个企业工单流程已经非常清楚:
START → classify_ticket → 条件路由
其中:
- faq →
search_knowledge - complex →
complex_agent
然后两条路径重新汇合:
generate_solution → risk_check
再根据风险等级:
- LOW →
execute_action - HIGH →
human_review→execute_action
最终:
execute_action → END
核心 Graph 可以简化成:
java
StateGraph workflow = new StateGraph(createStateStrategy())

        .addNode(
                "classify_ticket",
                node_async(new ClassifyTicketNode(chatModel))
        )

        .addNode(
                "search_knowledge",
                node_async(new SearchKnowledgeNode())
        )

        .addNode(
                "generate_solution",
                node_async(new GenerateSolutionNode(chatModel))
        )

        .addNode(
                "risk_check",
                node_async(new RiskCheckNode())
        )

        .addNode(
                "human_review",
                node_async(new HumanReviewNode())
        )

        .addNode(
                "execute_action",
                node_async(new ExecuteActionNode())
        );
再定义固定 Edge:
java
workflow.addEdge(
        StateGraph.START,
        "classify_ticket"
);

workflow.addEdge(
        "search_knowledge",
        "generate_solution"
);

workflow.addEdge(
        "complex_agent",
        "generate_solution"
);

workflow.addEdge(
        "generate_solution",
        "risk_check"
);

workflow.addEdge(
        "human_review",
        "execute_action"
);

workflow.addEdge(
        "execute_action",
        StateGraph.END
);
工单分类后进行条件路由:
java
workflow.addConditionalEdges(
        "classify_ticket",

        edge_async(state -> state
                .value("ticket_type")
                .map(Object::toString)
                .orElse("complex")),

        Map.of(
                "faq", "search_knowledge",
                "complex", "complex_agent"
        )
);
风险判断后再次路由:
java
workflow.addConditionalEdges(
        "risk_check",

        edge_async(state -> state
                .value("risk_level")
                .map(Object::toString)
                .orElse("HIGH")),

        Map.of(
                "LOW", "execute_action",
                "HIGH", "human_review"
        )
);
最后配置 Checkpoint 和人工中断:
java
MemorySaver saver = new MemorySaver();

CompileConfig compileConfig = CompileConfig.builder()
        .saverConfig(
                SaverConfig.builder()
                        .register(saver)
                        .build()
        )
        .interruptBefore("human_review")
        .build();

CompiledGraph graph = workflow.compile(compileConfig);
到这里,一套基本的:
Workflow + Agent + Human-in-the-Loop
企业 AI 执行框架就已经形成了。
需要注意,上面重点展示的是 Graph 的核心编排方式,知识库查询、复杂 Agent、业务 Tool 等具体实现可以根据自己的项目进行替换。
真正开发时,建议至少分别验证三条路径:
场景1:普通知识问题
输入:
怎么修改账号绑定手机号?
预期路径:
START → classify_ticket → search_knowledge → generate_solution → risk_check → END
场景2:复杂分析问题
输入:
昨天开始订单服务偶发失败,有些用户又可以正常创建订单,请分析可能原因。
预期路径:
START → classify_ticket → complex_agent → generate_solution → risk_check → END
场景3:高风险操作
输入:
帮我重新执行这笔订单的扣款。
预期路径:
START → classify_ticket → complex_agent → generate_solution → risk_check → PAUSE → human_review → execute_action → END
实际项目中应该结合日志或者 Trace 验证:
Graph 真正走过的 Node 是否与预期执行路径一致。
这一步对于后面的 Agent Evaluation 同样非常重要。
13. Graph为什么越来越像Agent Runtime?
理解完前面的内容,再回头看 Graph,就会发现它已经不只是:
Node + Edge。
当它进一步拥有:
- State;
- Conditional Routing;
- Checkpoint;
- Interrupt;
- Resume;
- Streaming;
- Agent Node;
之后,它开始承担另一层职责:
如何稳定地把一次 Agent 任务执行完整。
可以把三个角色简单区分成:
Agent:决定"想什么、下一步做什么"。
Tool:负责"真正执行什么"。
Graph Runtime:负责"整个任务怎么被控制和运行"。
例如:
- 当前执行到了哪个 Node?
- 下一步走哪条路径?
- State 如何传递?
- 失败以后怎么恢复?
- 需要人工审核怎么办?
- 服务重启怎么办?
- 已经完成的 Node 是否需要重新执行?
- Agent 如何嵌入固定业务流程?
这些问题都不是单纯依靠 Prompt 可以解决的。
也不是一个 ReAct Loop 就能完整解决的。
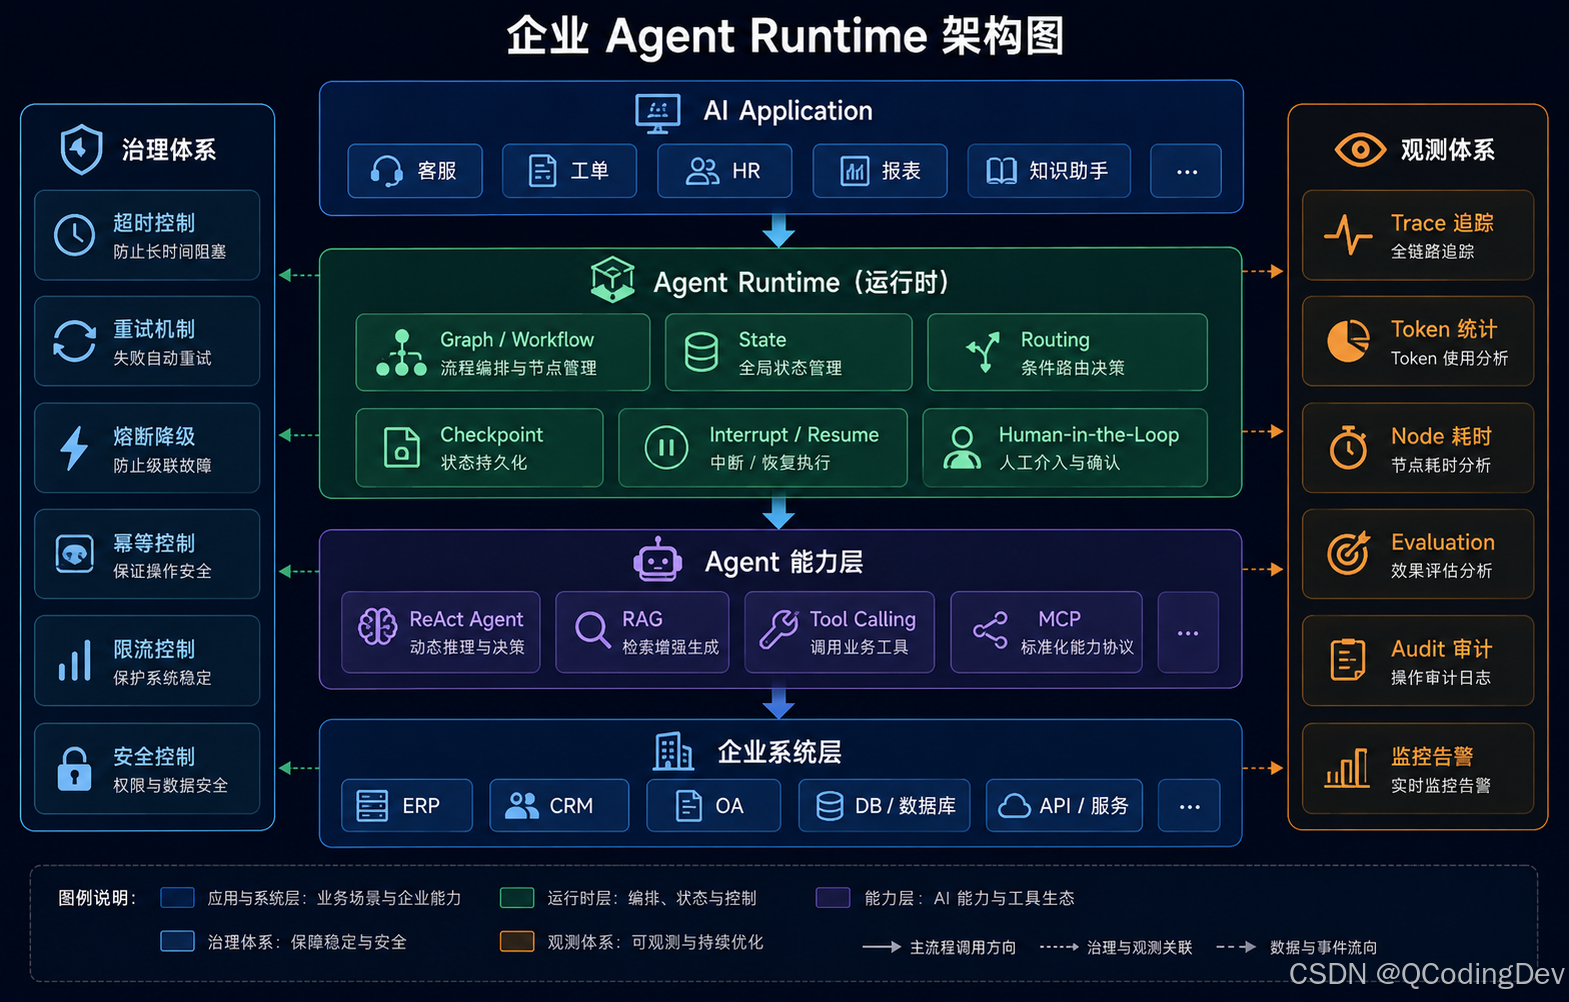
这里需要特别注意:
Graph 是 Runtime 的重要组成部分,但 Graph 本身并不等于完整的企业 Agent Runtime。
真正生产环境仍然需要把:
Graph + 稳定性治理 + 可观测性 + 安全 + Evaluation + Audit
组合起来。
14. Workflow、Agent、Graph到底怎么选?
最后再把三个概念统一一下。
确定性任务
例如:
- 身份校验;
- 权限校验;
- 参数校验;
- 固定业务规则;
- 状态更新;
- 审计记录。
优先使用:
普通 Java 代码 / Workflow。
不确定性任务
例如:
- 复杂问题分析;
- 动态 Tool 选择;
- 原因推理;
- 多步骤信息收集;
- 开放式任务规划。
优先使用:
Agent。
高风险任务
例如:
- 修改数据;
- 退款;
- 审批;
- 删除;
- 重要通知;
- 权限变更。
优先考虑:
Workflow + Human-in-the-Loop。
Graph解决什么?
Graph 并不是和 Workflow、Agent 并列选择。
它更像一层编排与运行机制:
使用 State、Node、Edge 把 Workflow、Agent 和人工控制组织成一个完整的执行图。
因此最终可以形成:
AI Application → Graph Runtime → Workflow / Agent / HITL → Tool / MCP → Enterprise Systems
这也是为什么我认为,企业 Agent 最终不会只是:
LLM + 一堆Tools。
它会逐渐演进成:
Model + Agent + Workflow + State + Checkpoint + Human-in-the-Loop + Observability + Evaluation + Governance
写在最后
从 Tool Calling 到 ReAct Agent,再到 Graph,我越来越觉得:
企业 Agent 真正困难的地方,并不是:
怎么让大模型更聪明。
而是:
怎么把一个具有概率性和不确定性的模型,放进一个要求稳定、可靠、可控制、可审计的企业系统。
Tool Calling 解决的是:
模型怎么连接业务能力。
Agent 解决的是:
复杂任务怎么动态决策。
Graph 进一步解决的是:
如何把这些能力建模成一个有状态、可路由、可暂停、可恢复的执行过程。
这时候,我们讨论的就不再只是:
"怎么写一个 Agent?"
而开始进入另一个更接近生产环境的问题:
怎么运行和治理一套企业 Agent 系统?
下一篇我们继续往下走:
一个企业 Agent 开发完成以后,到底怎么证明它"真的能用"?
这就涉及另一个越来越重要的方向:
Agent Evaluation。
🧩 AI项目实战
我也在持续维护一个面向企业真实业务场景的 Java AI 开源项目:Spring AI Business Copilot。
项目基于 Java + Spring AI 构建,包含知识库、数据分析(NL2SQL)、客服、报表、招聘等典型企业 AI 场景,并持续实践 RAG、Tool Calling、Workflow、Agent、Human-in-the-loop、Guardrails、调用审计与工程治理。
如果你正在学习 Java AI 应用开发,或者想看看一个 AI 项目如何从 Demo 逐步走向完整业务系统,可以作为学习和项目实践参考。
👉 GitHub:qcodingdev/spring-ai-business-copilot
如果项目对你有帮助,欢迎 Star 支持。
👨💻 关于作者|QCoding
专注 AI应用开发与Java技术实践。
持续分享 Spring AI、RAG、 Agentic、Agent Evaluation、企业AI架构、工程治理与AI转型实践