****论文题目:Review of imbalanced fault diagnosis technology basedon generative adversarial networks(****基于遗传神经网络的不平衡故障诊断技术综述)
****期刊:****Journal of Computational Design and Engineering (工程技术 中科院二区)
****摘要:****在工业生产领域,机器故障不仅对生产效率和产品质量造成负面影响,还会导致安全事故的发生,因此及时准确地诊断机器故障并采取相应的措施至关重要。然而,Mac Hines不能在长时间的故障下运行,而且故障模式的分散性导致数据收集有限,这给建立准确的故障预测模型带来了挑战。尽管最近取得了一些进展,但基于传统采样和机器学习的智能故障诊断方法已显示出不可比拟的优势。尽管如此,这些方法依赖于人类的专业知识,这给提取复杂特征信息带来了挑战。为了应对这些挑战,出现了许多基于产生式辅助网络的不平衡故障诊断方法,产生式辅助网络可以生成符合原始数据分布的真实样本,在诊断轴承和齿轮等关键部件的不平衡方面显示出良好的结果,尽管GAN方法具有巨大的潜力,但它也面临着挑战,包括训练和生成异常样本的困难。然而,无论是GaN基重采样技术还是传统采样技术,在小样本中对含噪声不平衡、类内和类间对偶不平衡、多类不平衡、时间序列不平衡等问题的研究较少,缺乏对不平衡问题的解决方案进行较为全面的总结。因此,本文的目的是深入探讨各种失效模式下的不平衡问题,并在此基础上对基于GANS的研究方法和结果进行考察和分析。提出了今后的研究方向,旨在为工业生产维修领域的研究提供指导和参考。
深度解读:基于生成对抗网络的不平衡故障诊断技术综述
一、背景:工业故障诊断为什么难?
在现代工业生产中,机械设备一旦发生故障,轻则影响产品质量与生产效率,重则引发安全事故。因此,准确、及时地诊断机械故障是工业智能化的核心需求之一。
然而,故障诊断的"数据基础"天然存在缺陷------设备大多数时间运行正常,真正的故障状态数据极为稀少。这就造成了训练深度学习模型时绕不开的难题:
- 正常样本数量:远远多于故障样本
- 不同故障类型之间:数据量差异悬殊
- 某些严重故障(如轴承外圈剥落晚期):样本数量极端稀缺
这种现象被称为数据不平衡问题(Data Imbalance)。传统的深度学习分类模型(如CNN)在这种数据上训练,会天然倾向于预测"多数类"(正常状态),导致对"少数类"(故障状态)的识别率极低------而这恰恰是工程实践中代价最高的错误。
本文是发表于 Journal of Computational Design and Engineering (2024年)的一篇系统综述,首次从多种复杂不平衡场景的角度,对基于生成对抗网络(GAN)的故障诊断方法进行了全面梳理与展望。
二、现有方法及其局限性
2.1 传统应对思路:重采样
处理不平衡数据的经典方法分为三大类:
| 方法类型 | 核心思路 | 代表算法 |
|---|---|---|
| 欠采样 | 减少多数类样本 | 随机欠采样 |
| 过采样 | 增加少数类样本 | SMOTE、ADASYN、Borderline-SMOTE |
| 混合采样 | 欠采样与过采样结合 | SMOTEENN等 |
其中,SMOTE(合成少数类过采样技术)是最具代表性的方法:在少数类样本的邻域内进行线性插值,生成新的"合成"样本。
然而,SMOTE 有本质局限:它是基于插值的策略 ,只能在已有样本点之间生成中间样本,无法捕捉原始样本的整体概率分布。实践中常出现以下问题:
- 过泛化:生成样本分布过于平滑,模糊了真实的类别边界
- 样本重叠:在多类场景下,合成样本可能侵入其他类别的特征空间
- 噪声引入:对边界样本、噪声样本同样进行插值,放大了噪声的影响
- 忽略边界样本:无法有效处理靠近决策边界的关键样本
此外,特征选择 和加权损失函数方法虽然无需改变数据量,但前者流程复杂且可能丢失信息,后者对权重超参数极度敏感,在极端不平衡场景下效果有限。
2.2 深度生成模型的兴起
近年来,以变分自编码器(VAE)和生成对抗网络(GAN)为代表的深度生成模型为过采样提供了全新思路:
- 网络合成方法更为复杂 ,但生成样本的真实性和多样性显著更高
- GAN通过对抗训练,能够学习原始数据的高维概率分布,从而生成更贴近真实故障特征的伪样本
值得注意的是,近期兴起的扩散模型(Diffusion Model)也被尝试用于不平衡故障诊断,但论文指出其在小样本场景下适用性尚未充分验证,且采样速度远慢于GAN和VAE。
三、GAN基本原理
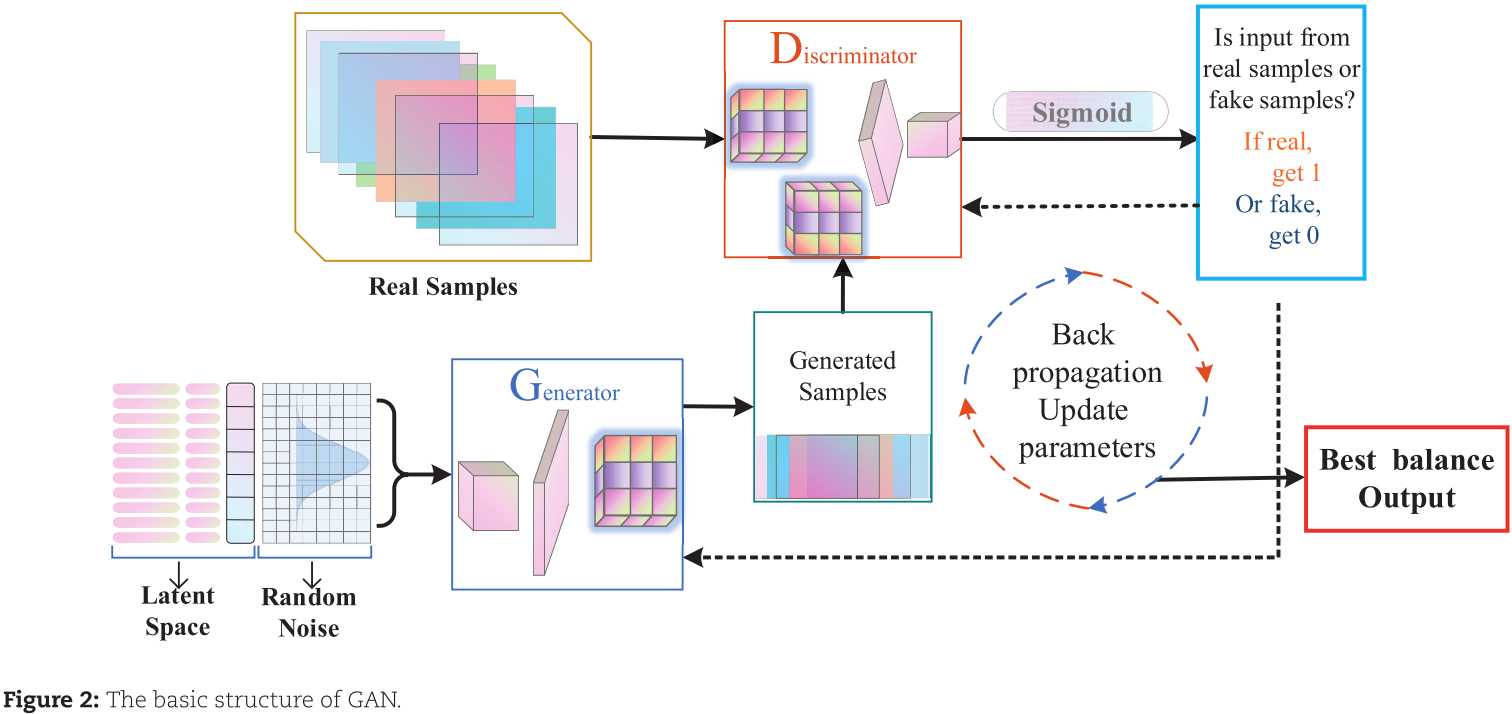
【图2 --- GAN的基本结构示意图(生成器G、判别器D、真实样本与生成样本的对抗流程)】
GAN由 Goodfellow 等人于2014年提出,核心思想是两个网络的对抗博弈:
- 生成器 G(Generator):接收随机噪声 z,学习将其映射为与真实样本分布相似的数据
- 判别器 D(Discriminator):接收输入数据,判断其是"真实样本"还是"生成样本",输出概率值(0~1,理想收敛时为0.5)
两者的训练目标形成零和博弈,数学上表达为:
通过反复迭代,生成器生成的数据越来越"真实",最终能够生成符合原始故障数据分布的高质量伪样本。这种能力,使得GAN成为故障诊断领域解决不平衡问题的强力工具。
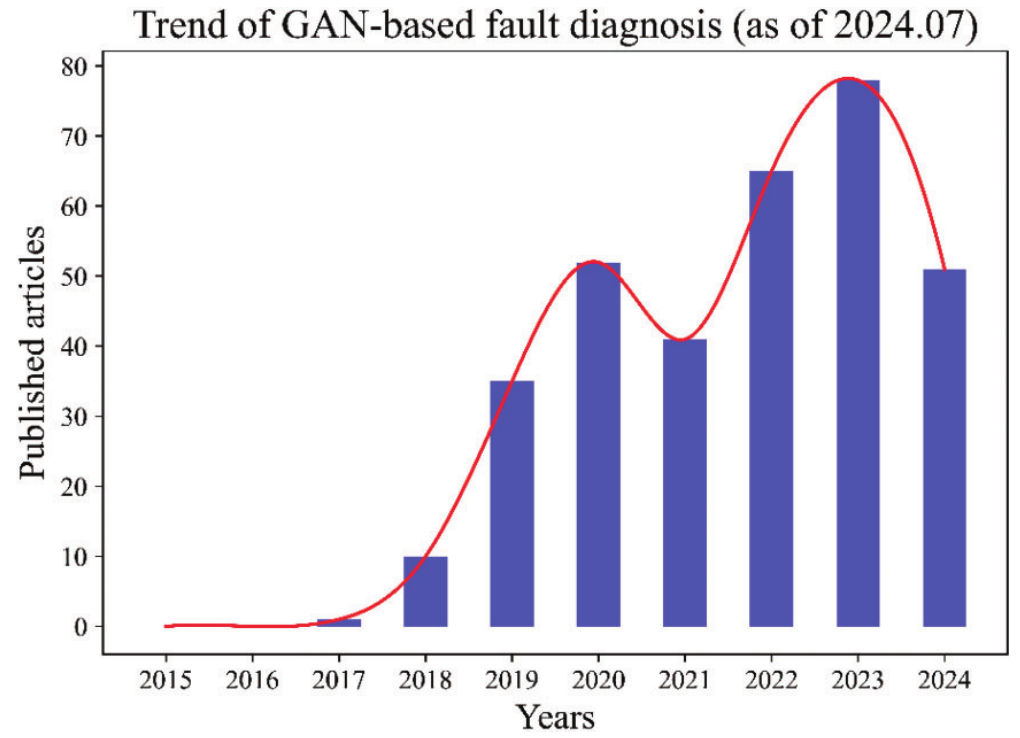
【图1 --- 2014年至2024年7月GAN在故障诊断领域相关论文发表趋势图(2023年峰值约80篇)】
四、复杂不平衡数据的四种形态
本文的重要贡献之一,是系统梳理了工业场景中四类有别于简单二类不平衡的复杂不平衡问题。
4.1 小样本下的噪声不平衡
噪声样本与正常样本差异显著,在训练数据中混入噪声会严重拖慢收敛速度,甚至导致模型无法收敛。小样本场景下,随机误差更容易被放大为"伪类别特征"。
常用的噪声识别方法包括:
- k-NN距离法(Borderline-SMOTE):若样本的k个最近邻与其类别不符,判定为噪声
- 欧氏距离+密度法:距类中心距离大且同类邻居密度小的样本视为噪声
- K-means SMOTE聚类分割:若子簇内多数类数量超过少数类,则该子簇的少数类样本被标记为噪声
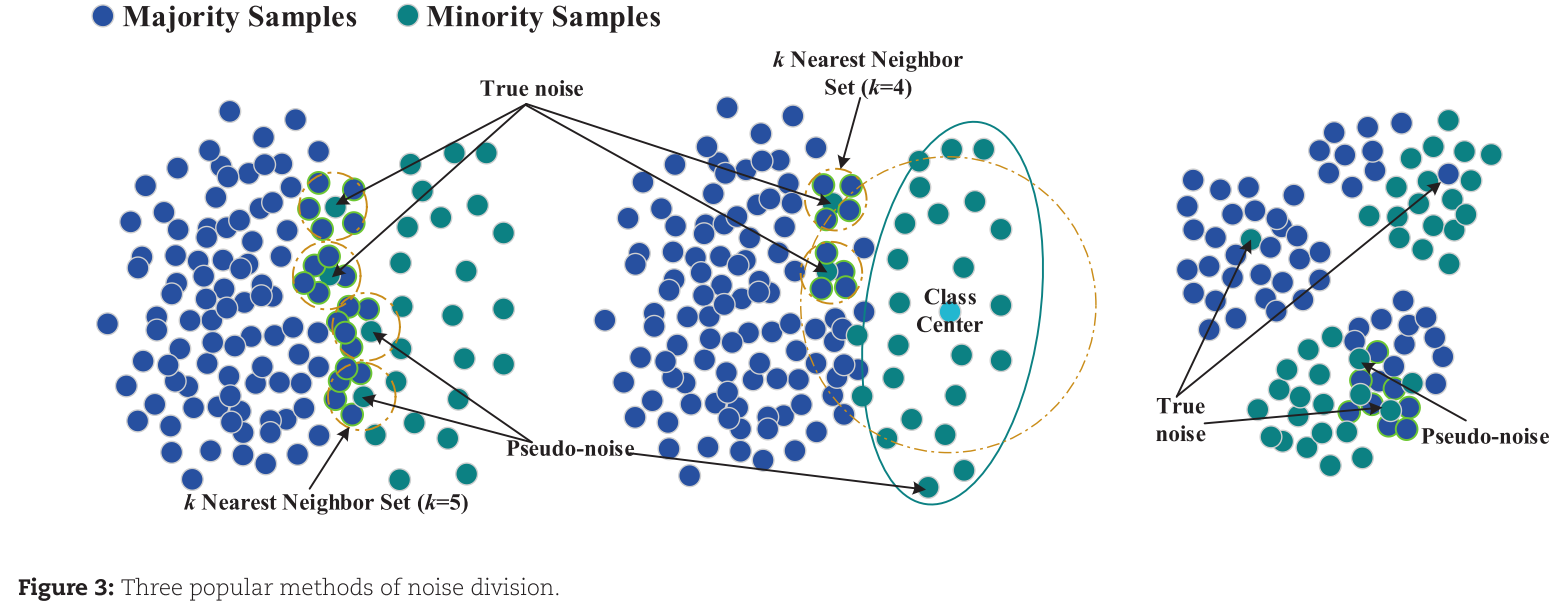
【图3 --- 三种主流噪声划分方法示意图】
4.2 类内与类间双重不平衡
类间不平衡(Inter-class Imbalance)是故障诊断中最常见的形式:不同故障类型之间的样本数量差异悬殊。
类内不平衡 (Intra-class Imbalance)则更为隐蔽:同一种故障类型内部,由于转速变化、负载差异,数据在特征空间中形成多个子簇,且各子簇大小不一。例如,同为"轴承外圈故障",轻微故障阶段样本多,严重故障阶段样本极少,但二者同属一个类别标签。
多类不平衡 (Multi-class Imbalance)则是两者的叠加:多种故障同时存在,部分故障类别样本量远低于正常样本,且少数类之间也存在不平衡,极易发生类别重叠。
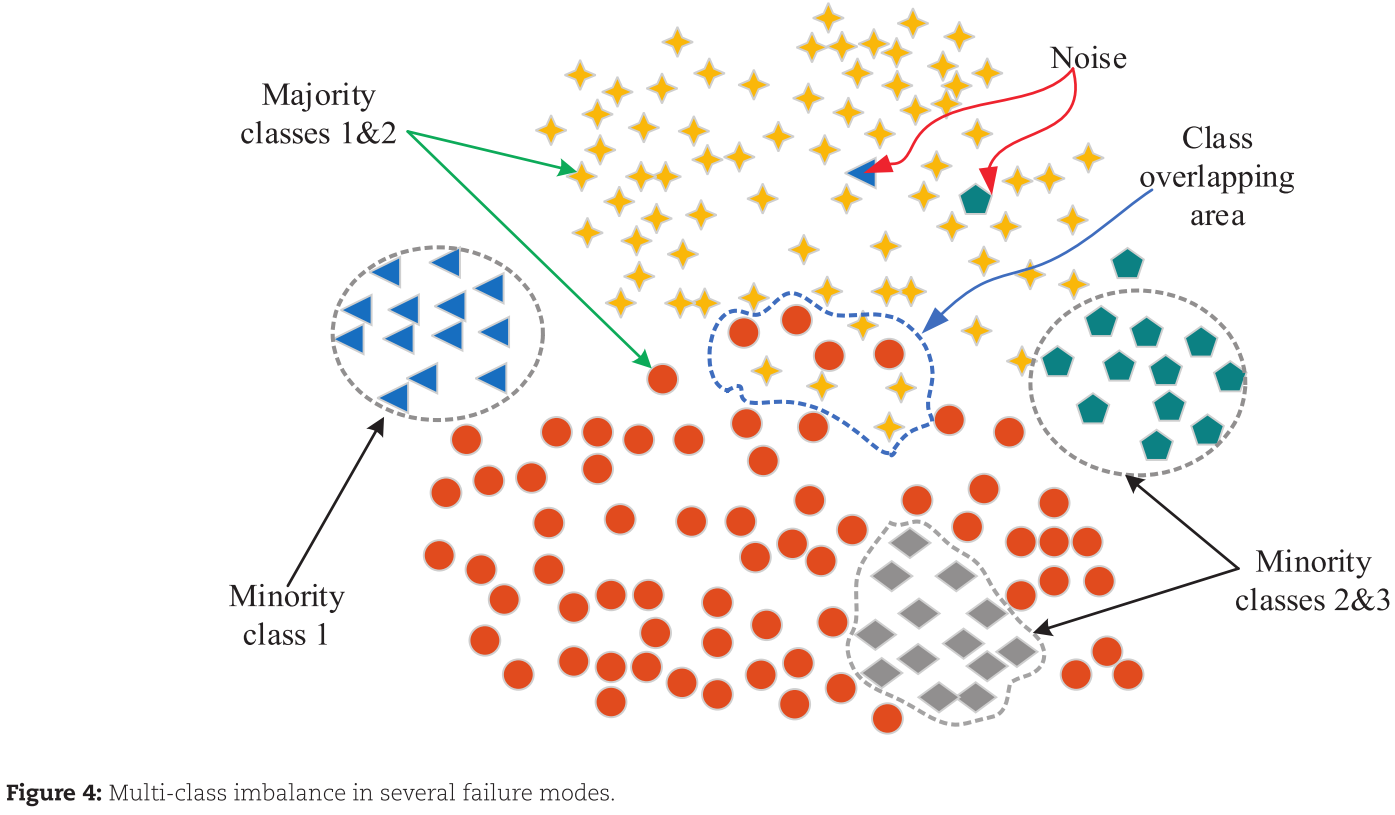
【图4 --- 类内不平衡、类间不平衡与多类不平衡的示意图】
4.3 振动信号的时序不平衡
振动信号本质是时间序列数据,可形式化表示为:
其中每个样本 包含 t 个时间点的观测值。
时序不平衡主要体现在:
- 不同故障类型在时间轴上出现频率不同
- 不同时间节点(故障初期 vs 末期)的数据量悬殊
- 长期预测与短期预测数据比例不匹配,如设备全生命周期中某一退化阶段数据极少
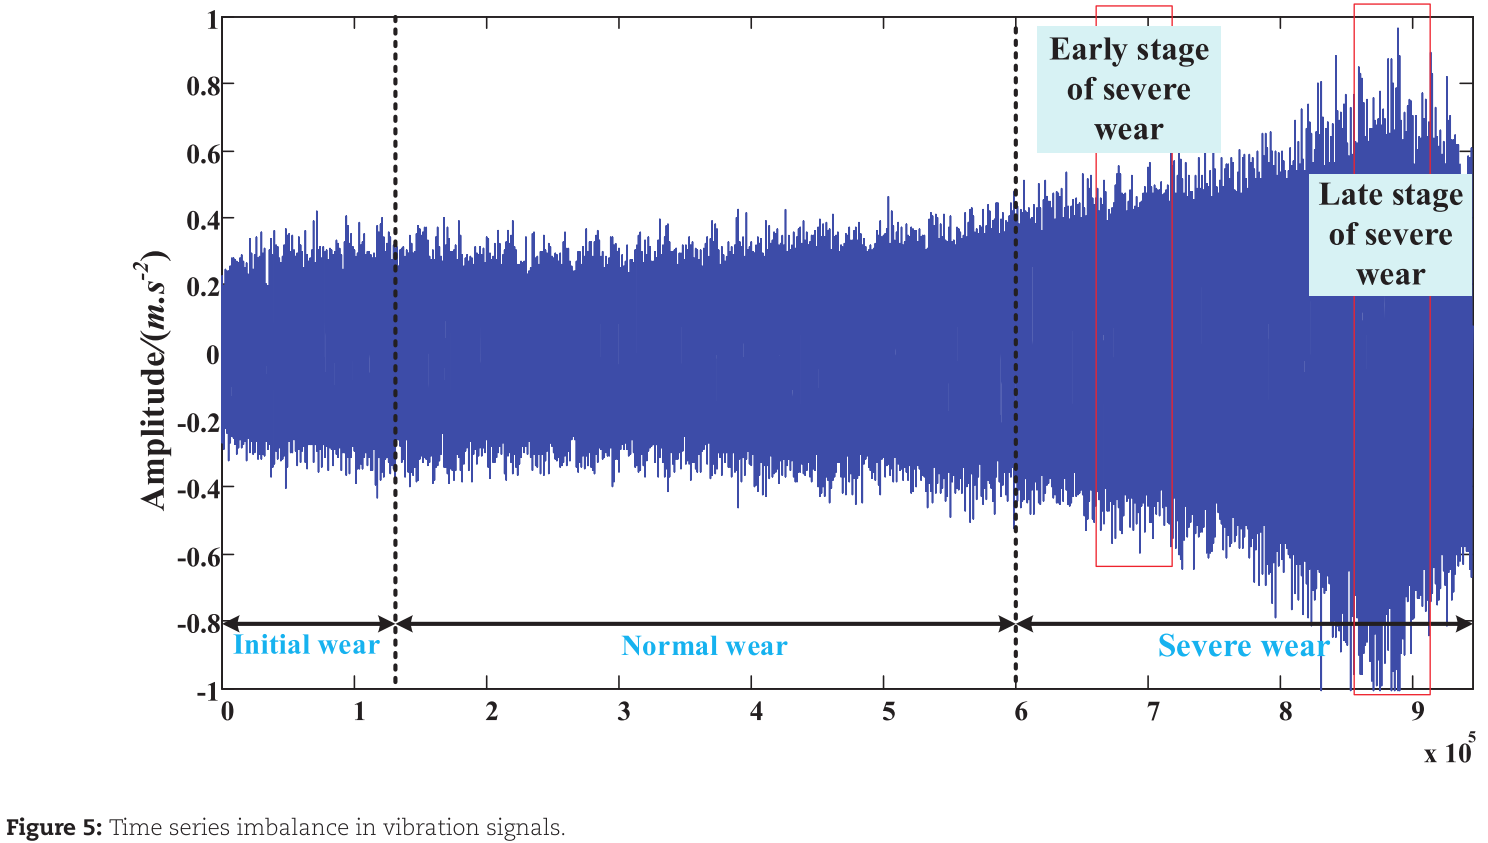
【图5 --- PHM2010铣刀磨损退化数据集C4刀具全生命周期振动信号退化趋势图,展示时序不平衡】
五、GAN变体家族与学习范式
论文按学习范式将GAN变体分为三大类,构建了清晰的分类体系。
5.1 无监督学习GAN
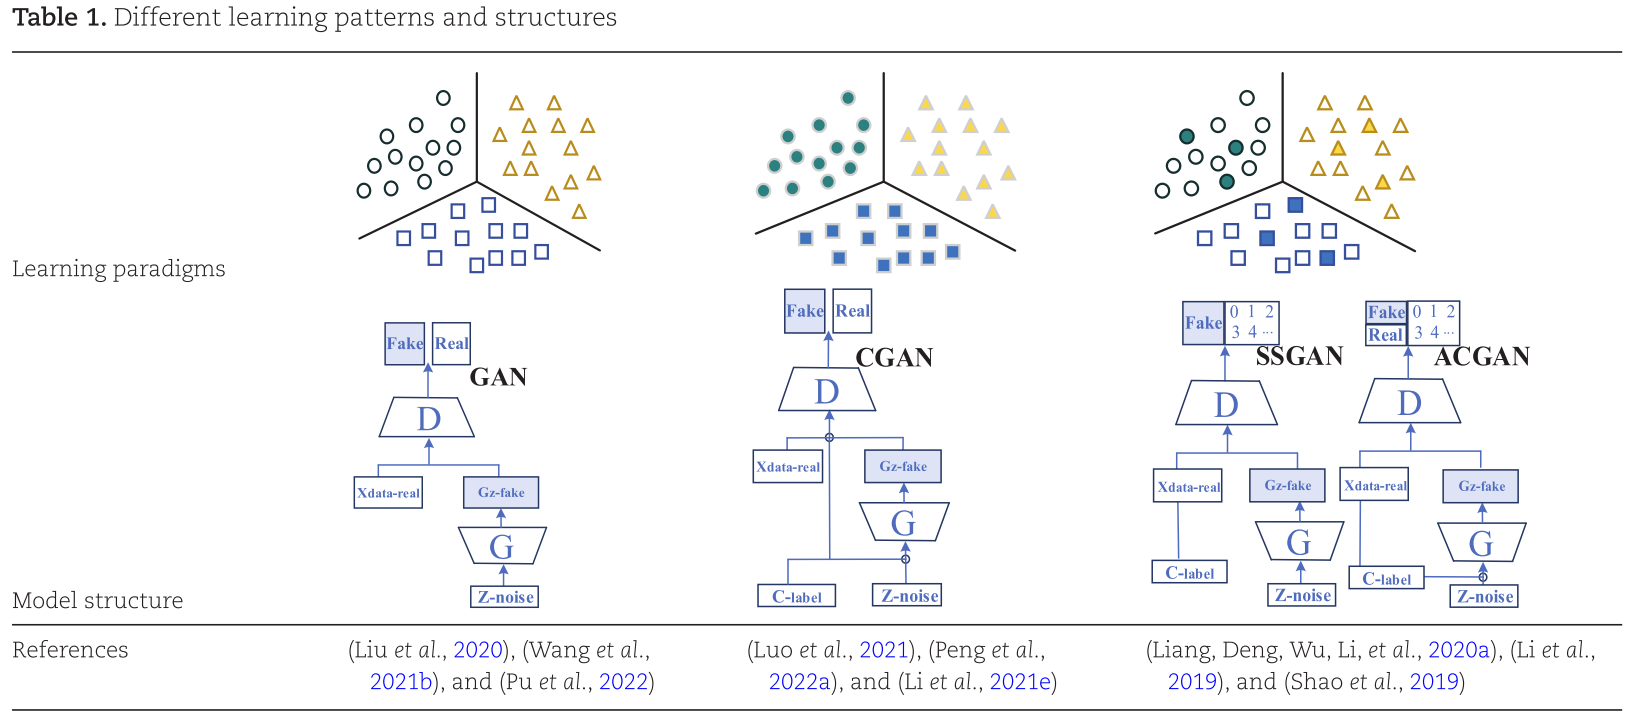
【表1 --- 不同学习范式的GAN模型结构对比图(含结构示意与代表文献)】
原始GAN(Vanilla GAN) 存在训练不稳定、梯度消失、模式崩溃等问题。在小样本不平衡场景下,这些问题会被进一步放大。主要改进方向包括:
- DCGAN:引入卷积结构,提升训练稳定性和生成质量;将二维卷积替换为一维卷积,更适合振动信号的时序数据生成
- VAEGAN:融合VAE的编码器与GAN的生成器,通过将真实数据压缩到隐空间再采样,为GAN提供更可靠的隐向量输入;还可结合自注意力机制进一步提升生成质量
- BiGAN:引入双向结构,将真实数据的编码向量与真实数据组合后送入判别器,已在工业机器人故障诊断和3D打印机故障诊断中展示了良好效果
- CycleGAN:学习两个样本域之间的数据映射关系,循环一致性损失保证生成样本保留源域特征;广泛用于滚动轴承故障诊断和工业故障数据增强
- WGAN / WGAN-GP:将分布距离度量从JS散度改为Wasserstein距离,显著提升训练稳定性和生成样本质量;WGAN-GP在此基础上增加梯度惩罚项,进一步约束判别器满足Lipschitz连续性条件
5.2 有监督学习GAN
CGAN(条件GAN) 在生成器和判别器的输入层中拼接类别标签,使模型能够定向生成特定故障类型的样本,目标函数为:
其中 y 为类别条件标签。代表应用包括:
- CDCGAN:结合DCGAN结构和类别标签,精准捕捉原始振动数据的真实分布
- CGAN + Wasserstein距离:用于冷水机故障诊断,生成数据多样性和平衡性显著提升
- CGAN + WGAN-GP:多篇文献(Li et al.2022、Yan et al.2022等)采用此组合,大幅提升诊断性能
5.3 半监督学习GAN
- SSGAN(半监督GAN):判别器兼作多类分类器,同时接受真实类别标签,适合标注样本极少、无标签数据丰富的场景
- ACGAN(辅助分类器GAN):在判别器中增加辅助分类器,同时输出真伪判别和类别信息;可视为CGAN与SSGAN的混合体,已广泛用于旋转机械故障诊断
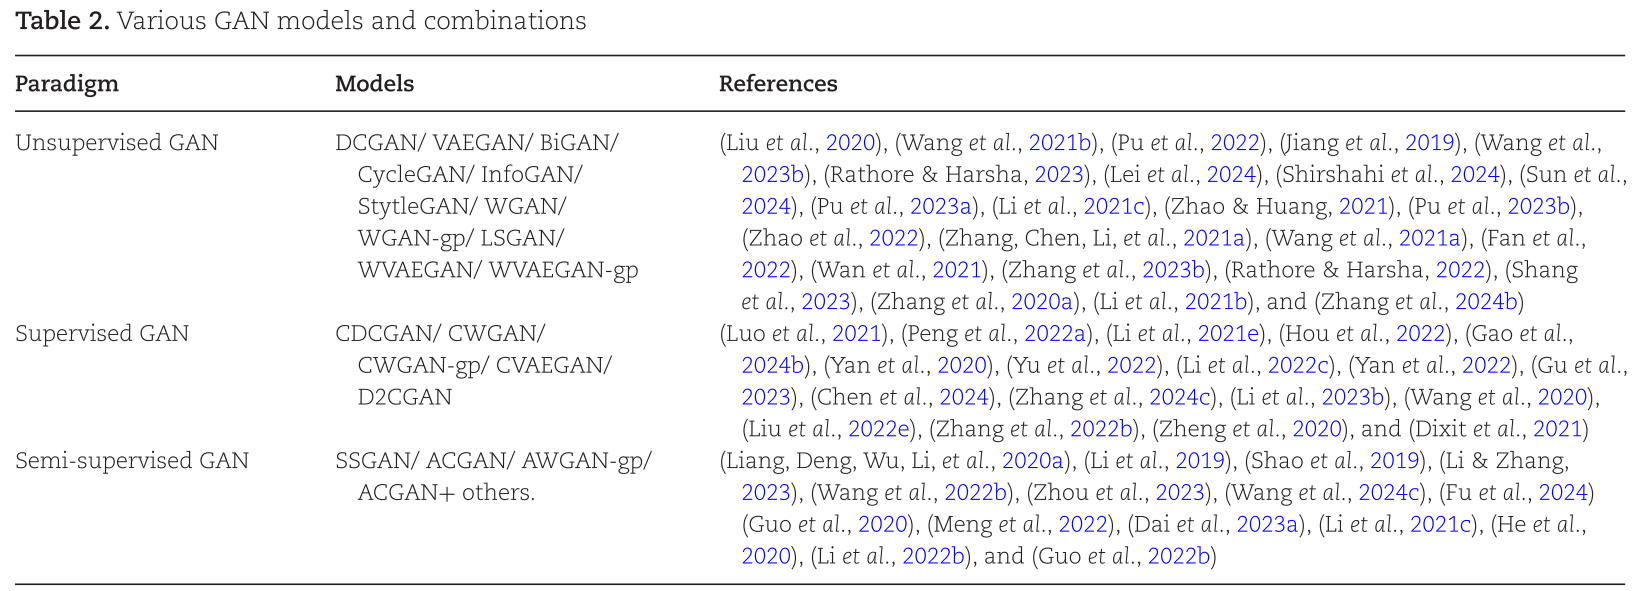
【表2 --- 各GAN变体及其组合的完整索引表(含学习范式、模型结构、参考文献)】
六、数据形式与网络结构的适配选择
工业故障诊断涉及多种数据来源,GAN需要针对不同数据形式选择适配的网络结构。
6.1 四类输入数据形式
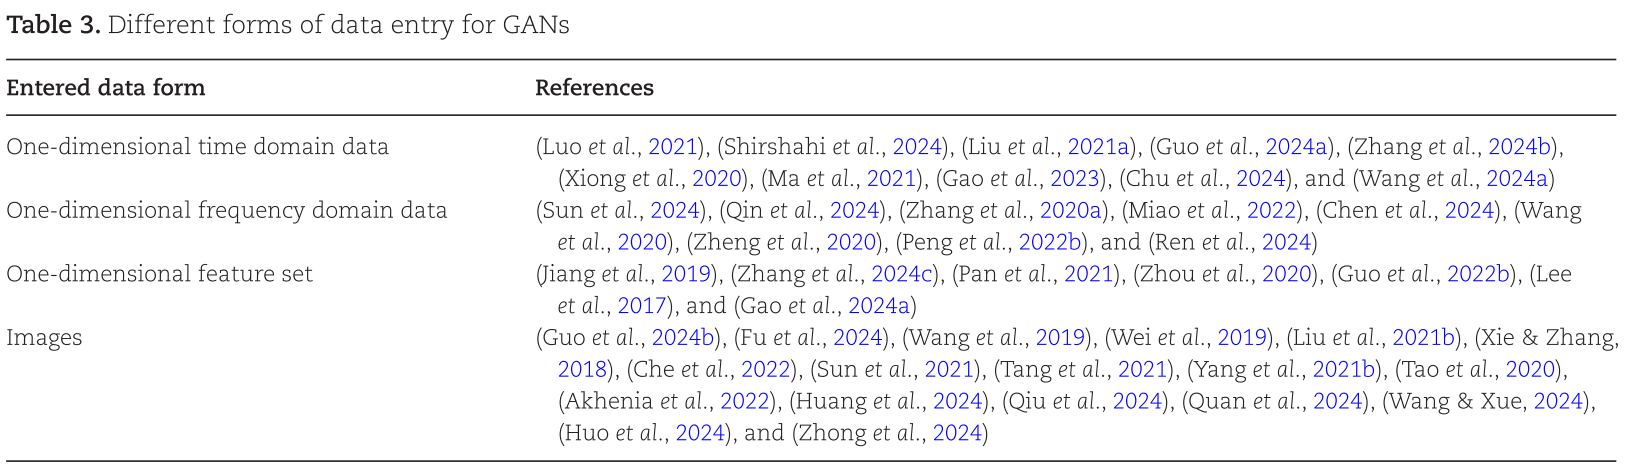
表3 --- 不同数据输入形式(一维时域/频域/特征集/图像)对应参考文献汇总】
- 一维时域数据:最原始的传感器数据,信息最完整,但维度高、特征复杂
- 一维频域数据:经FFT变换后得到,频域特征更明显,但会丢失部分时域信息
- 一维特征集:手动或网络提取的统计特征(均值、方差、峭度、偏度等),维度低
- 图像数据:包括直接采集的图像,以及将时序信号转换为二维图像的形式
6.2 时序转图像的多种路径
论文系统梳理了将一维时序信号转为二维图像的方法体系:
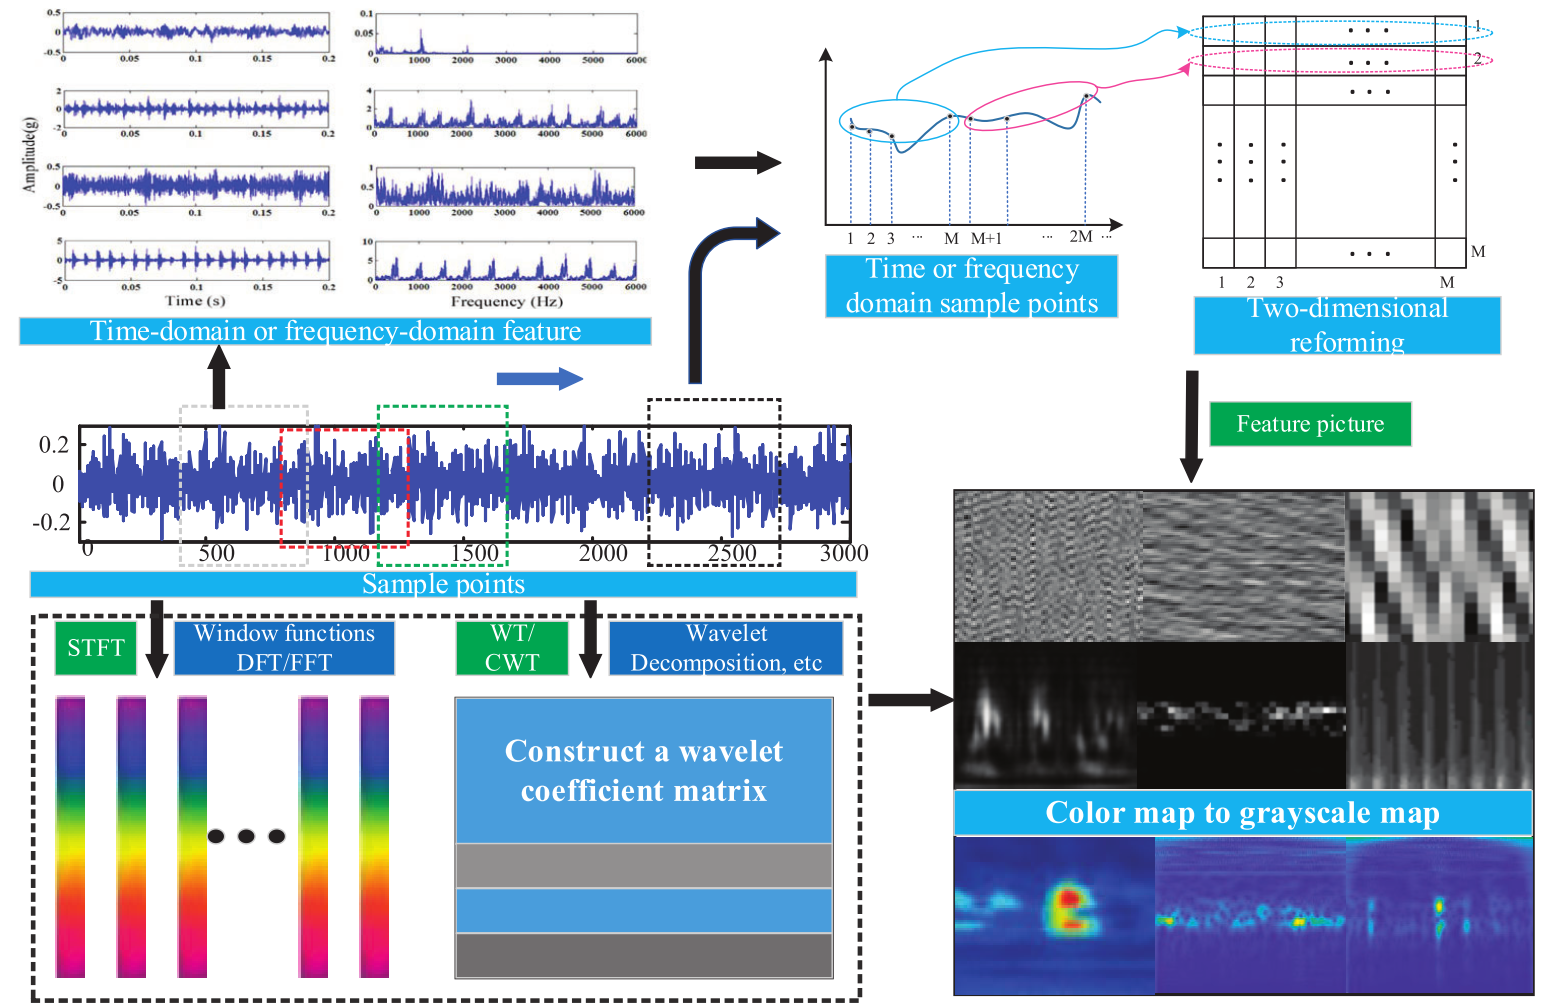
图6 --- 时序数据转图像的原理示意图(含FFT重组、STFT时频图、小波变换等路径)】
-
直接重组 :将长度为
的时序信号重塑为
-
STFT时频谱图:短时傅里叶变换,同时呈现时域和频域信息
-
小波变换系数矩阵:CWT/DWT,适合捕捉非平稳信号的多尺度特征
-
Stockwell变换:生成时频域二维图像,保留相位信息
-
Gramian角场、Markov转移场:将时序的统计关系编码为图像
6.3 GAN内部网络结构的选择
| 网络结构 | 适用场景 | 特点 |
|---|---|---|
| 线性全连接网络 | 低维特征集、频域数据 | 简单直接,表达能力有限 |
| 一维卷积(1D-CNN) | 时域或频域序列 | 保留原始特征,局部模式提取能力强 |
| 二维卷积(2D-CNN) | 图像形式数据 | 图像处理能力强,表征故障特征直观 |
| RNN / LSTM / GRU | 时序数据长期依赖 | 记忆机制强,但训练时间长 |
| Transformer | 长序列、全局依赖 | 并行计算高效,精度优于RNN;TTS-GAN可生成任意长度时序 |
6.4 各类模型的资源消耗对比
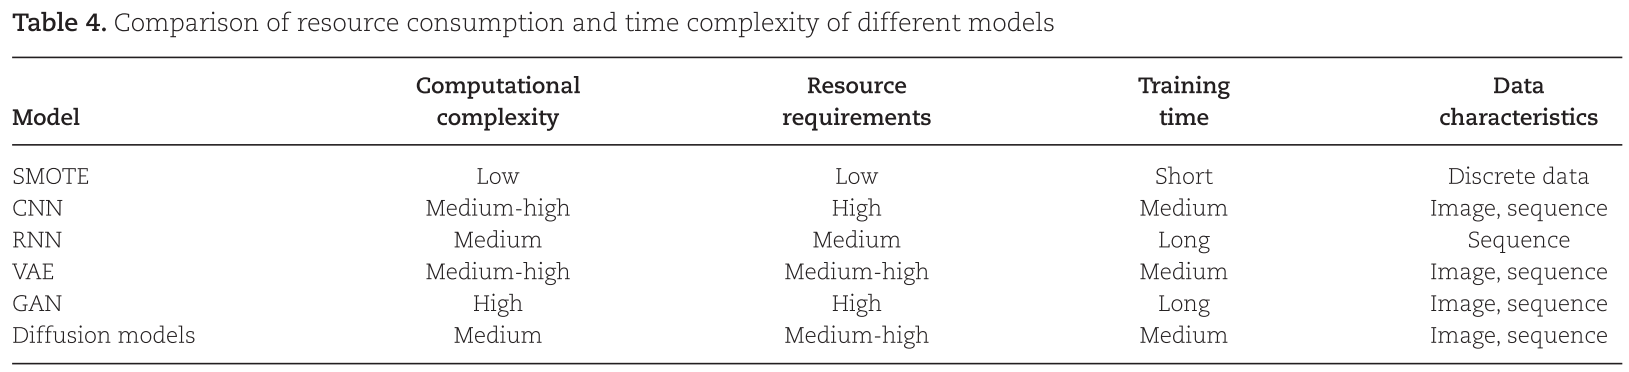
表4 --- 不同模型(SMOTE/CNN/RNN/VAE/GAN/扩散模型)的计算复杂度、资源需求、训练时间与数据特性对比】
核心结论:GAN的计算复杂度高、资源需求大、训练时间长,但在生成高质量、多样性合成数据方面具有独特优势,特别适合复杂高维不平衡数据场景。VAE速度更快但生成质量较低;扩散模型生成图像质量更高,但采样时间显著更长。
七、GAN用于工业故障诊断的通用框架
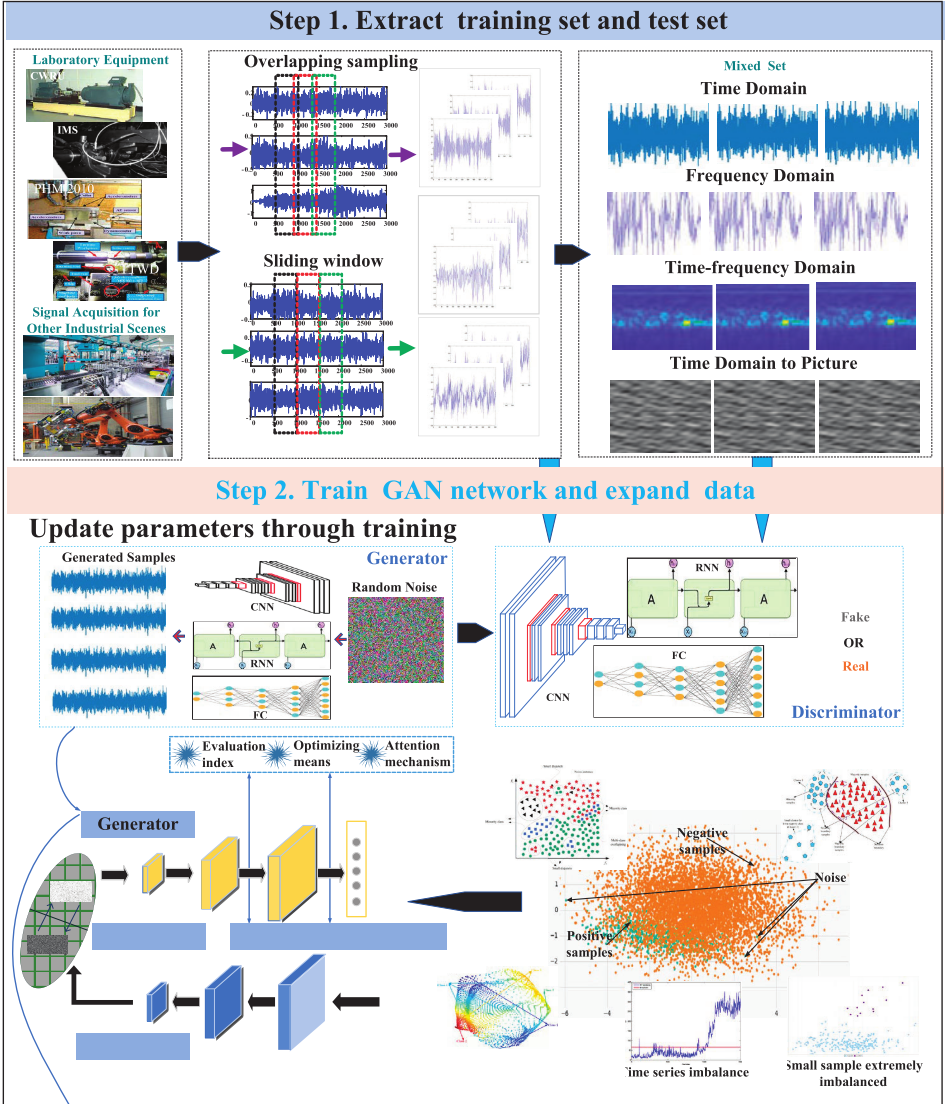
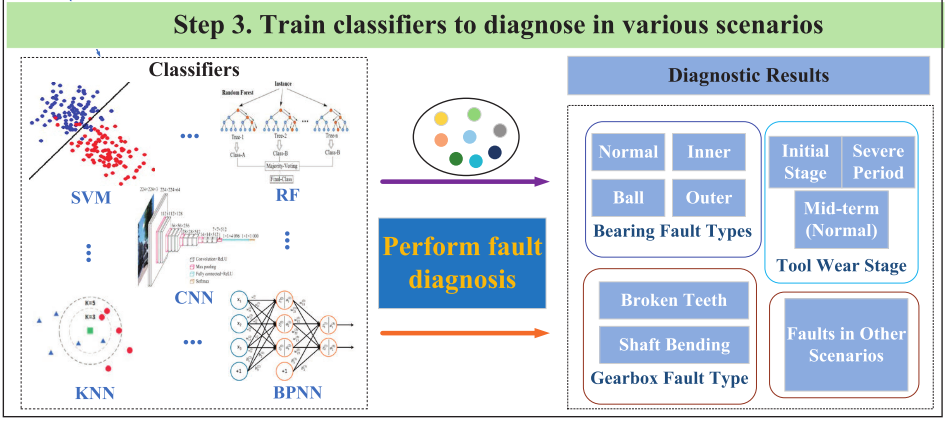
图7 --- 基于GAN的工业故障信号处理完整流程图(三步骤:提取训练/测试集 → 训练GAN扩充数据 → 训练分类器进行故障诊断)】
论文将GAN用于工业不平衡故障诊断的通用流程归纳为三个步骤:
Step 1:提取训练集与测试集
- 从实验室设备或工业现场传感器采集振动信号
- 使用滑动窗口或重叠采样进行分割
- 转换为时域、频域、时频域或图像格式
Step 2:训练GAN网络并扩充数据
- 针对少数类故障样本训练GAN,学习其数据分布
- 生成高质量伪样本,平衡训练集的类别分布
- 对生成样本进行质量评估与筛选(如KL散度、MMD、Pearson相关系数等指标)
Step 3:训练分类器进行故障诊断
- 使用平衡后的数据集训练分类器(CNN、SVM、随机森林、LSTM、Transformer等)
- 识别故障类型(正常/内圈/外圈/滚动体等),判断故障严重程度(初始/中期/严重阶段),以及工具磨损阶段等
关键技术增强手段
研究者们在GAN基础框架上叠加了多种提升技术:
- 注意力机制:帮助GAN从时序或图像中捕捉全局重要特征,CNN+注意力的组合同时关注全局与局部信息(Wan et al.2021、Fan et al.2022等大量文献采用)
- 残差结构:缓解梯度消失/爆炸,稳定训练过程,跳层连接使模型关注更细粒度信息
- 批归一化/谱归一化/梯度归一化:正则化手段,抑制梯度爆炸,提升泛化能力与稳定性
- 元学习(Meta-learning):在极少样本条件下生成更高质量的伪样本(Li et al.2023a等)
- 多域信息融合:同时利用多个域的信息训练GAN,生成更真实多样的数据(Ren et al.2023b等)
特殊应用场景
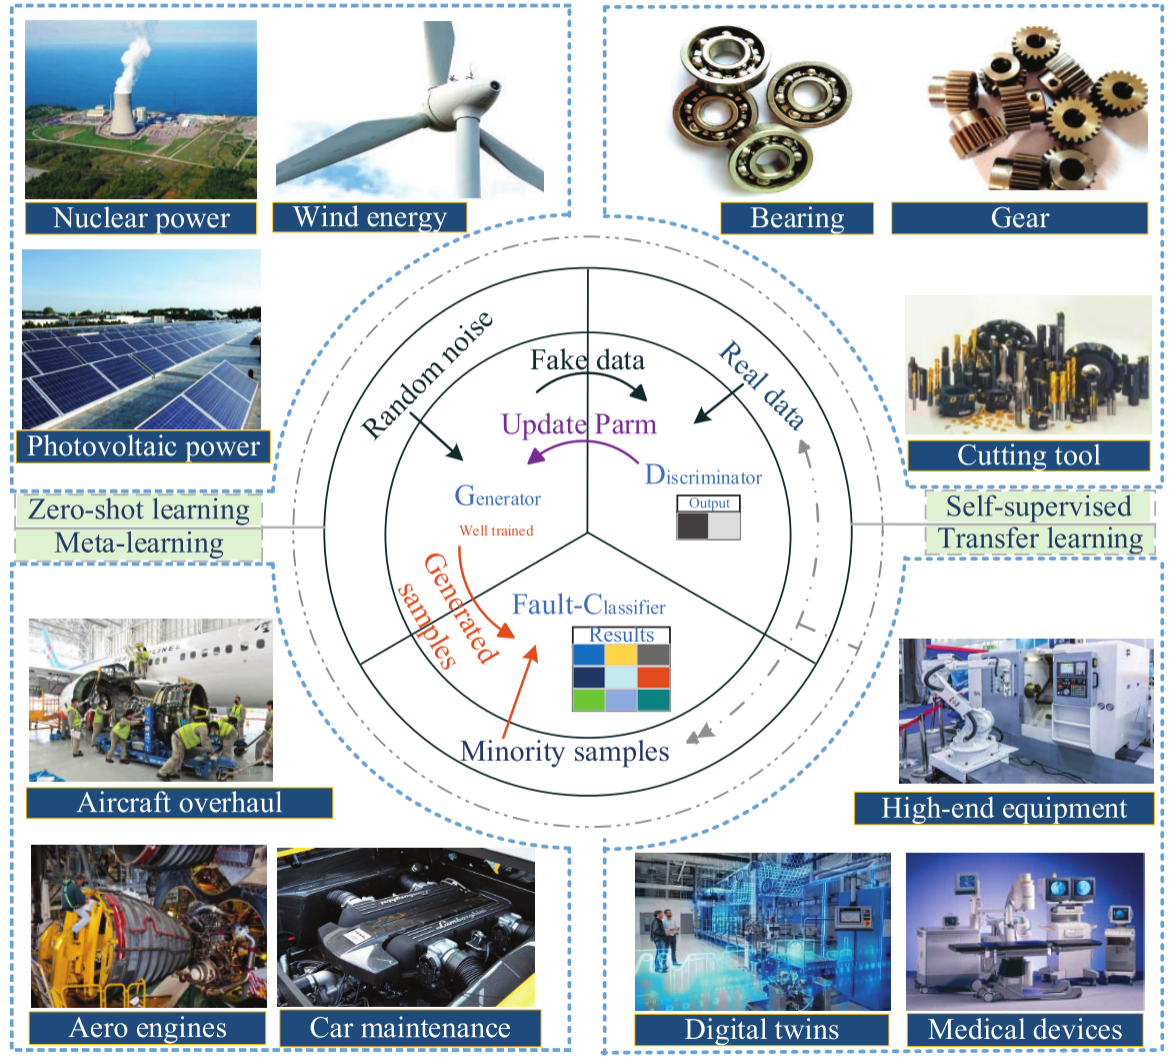
图8 --- GAN在多种工业应用场景中的应用示意图(核能、风能、光伏、轴承、齿轮、航空发动机、汽车维护、数字孪生、医疗设备等)】
GAN的应用已远超传统机械故障场景,涵盖:
- 核电站设备诊断(CGAN轻量化方案)
- 光伏阵列故障(WGAN学习PV系统各类分布)
- HVAC暖通空调系统故障检测
- 数字孪生(WGAN构建虚拟样本,支撑早期故障检测、健康监测、退化追踪)
- 转移学习结合:CycleGAN/DCGAN先增强数据,再通过迁移学习提升模型泛化
- 异常检测:基于GANomaly框架,用重建误差检测异常状态
八、现存挑战与深度分析
8.1 各类不平衡模式下的GAN方法评述
噪声不平衡处理
- 预处理层面:高通滤波去除低频噪声、FFT/STFT/CWT转换到频率域后滤除特定频段噪声
- 渐进式GAN(Ren et al.2024):从低频到宽频逐步生成复杂信号,避免高能信号干扰故障特征频率
- 标签噪声处理:改进的rAC-GAN(Huang et al.2021)在有限数据和正则化互信息驱动下对标签噪声具有更高鲁棒性
类内/类间双重不平衡处理
- 现有研究大多仍聚焦于类间不平衡的单一问题
- 类内不平衡处理的代表:ACWGAN-GP模型(Li et al.2024b)用于不同断齿程度的故障数据增强,降维后生成样本的类间分离度和类内聚合度均有显著提升
- 核心难点:在小样本条件下,类内聚合簇与其他类的聚合簇可能发生重叠,GAN难以建立有效边界
时序不平衡处理
- 现有研究主要针对短时序不平衡,长时序不平衡研究严重匮乏
- GANs被用于缺失数据填补(Gao et al.2022b):恢复多通道时空信息中的长期连续结构响应
- 剩余寿命预测方向:GAN模拟变工况、多故障模式下的退化场景(Huang et al.2022、Zhang et al.2022等)
8.2 可解释性:三个层次的缺失
GAN的"黑箱"属性在故障诊断场景下带来特殊挑战,论文从三个维度指出可解释性的不足:
- 类别决策边界:混合不平衡下的数据分布缺乏明确类别边界,类内/类间聚合模式如何影响生成样本的质量,目前研究严重不足
- 模型结构与权重参数:生成器内部编码机制与判别器的定量判别方式,尤其是低维隐空间中潜向量与特征结果之间的映射关系,尚未得到充分解释
- 样本形式与特征重要性:通过降维可视化(如t-SNE)和模型无关方法(如SHAP、LIME)量化特征贡献度与模型依赖程度,目前应用有限
8.3 隐私保护:新兴但重要的方向
在真实工业场景中,关键设备的运行数据往往涉及商业机密,GAN在数据处理过程中存在潜在的隐私泄露风险。
目前的一种探索方案(Wang et al.2022c):将含类别信息的GAN引入多客户端特征对齐模块,结合对抗学习自适应生成参考分布,在数据隐私条件下构建多客户端的全局故障诊断模型。
但总体而言,基于GAN的故障诊断隐私保护机制在工业界仍是亟待深入研究的空白地带。
九、未来研究展望
论文从三个层次指明了未来方向:
9.1 数据分布场景层
现有方法大多处理单一故障信号分类任务,而现实中机械系统故障往往伴随着:
- 数据中含有大量噪声
- 故障状态数据簇分散分布,类别重叠严重
- 多源、多故障数据集同步融合的研究极度匮乏
未来方向:研究多故障模式、多类不平衡、多源数据共存条件下的联合数据均衡方法。
9.2 应用对象层
高端装备(极端服役条件下)的故障诊断面临特殊挑战:
- 响应延迟与高算力消耗的矛盾
- 短时异常数据缺乏标签
- 噪声干扰严重
未来方向 :预训练集成GAN模型 + 在线学习与分布式计算 + 高效硬件加速,实现实时更新与推理。同时,数字孪生结合GAN数据插值与增强将是重要落地路径,GANs通过在虚拟环境中生成实验与运行数据,可支撑预测性维护、性能监控和风险检测。
9.3 GAN自身机制层
GAN复杂的内部运行机制带来了以下挑战,也指向了未来研究重点:
- 可解释性差:隐空间到生成数据的映射关系难以精确阐明
- 质量与多样性的平衡:一直是生成模型的核心矛盾
- 小样本下训练不稳定:模式崩溃问题在数据极少时更为突出
未来方向 :创新正则化技术稳定训练;采用参数量更少的神经网络作为GAN基础结构;引入强化学习和进化计算进一步优化训练过程;研究能够处理多模态数据的细粒度条件生成方法与GAN架构。
十、总结
本文是目前在GAN用于不平衡故障诊断领域覆盖最为系统全面的综述之一。其核心价值在于:
-
定义了问题边界:将工业不平衡故障诊断中的复杂场景细分为四类(噪声不平衡、类内/类间不平衡、多类不平衡、时序不平衡),填补了已有综述的空白
-
构建了方法图谱:从学习范式 × 数据形式 × 网络结构三个维度,系统梳理了数十种GAN变体及其工业应用,形成便于查阅的参考体系
-
揭示了研究缺口:长时序不平衡研究几乎空白;多源多故障混合场景联合建模研究极少;GAN可解释性与隐私保护机制研究严重不足
-
指明了发展方向:从数据场景、应用对象和GAN机制三个层次,为后续研究提供了清晰的路线图
对于从事工业智能运维、预测性维护、机器健康监测领域的研究者和工程师而言,这篇综述既是一份权威的方法索引,也是理解当前研究前沿与未来挑战的重要参考。