【llm-algo-leetcode学习笔记】训练侧显存优化

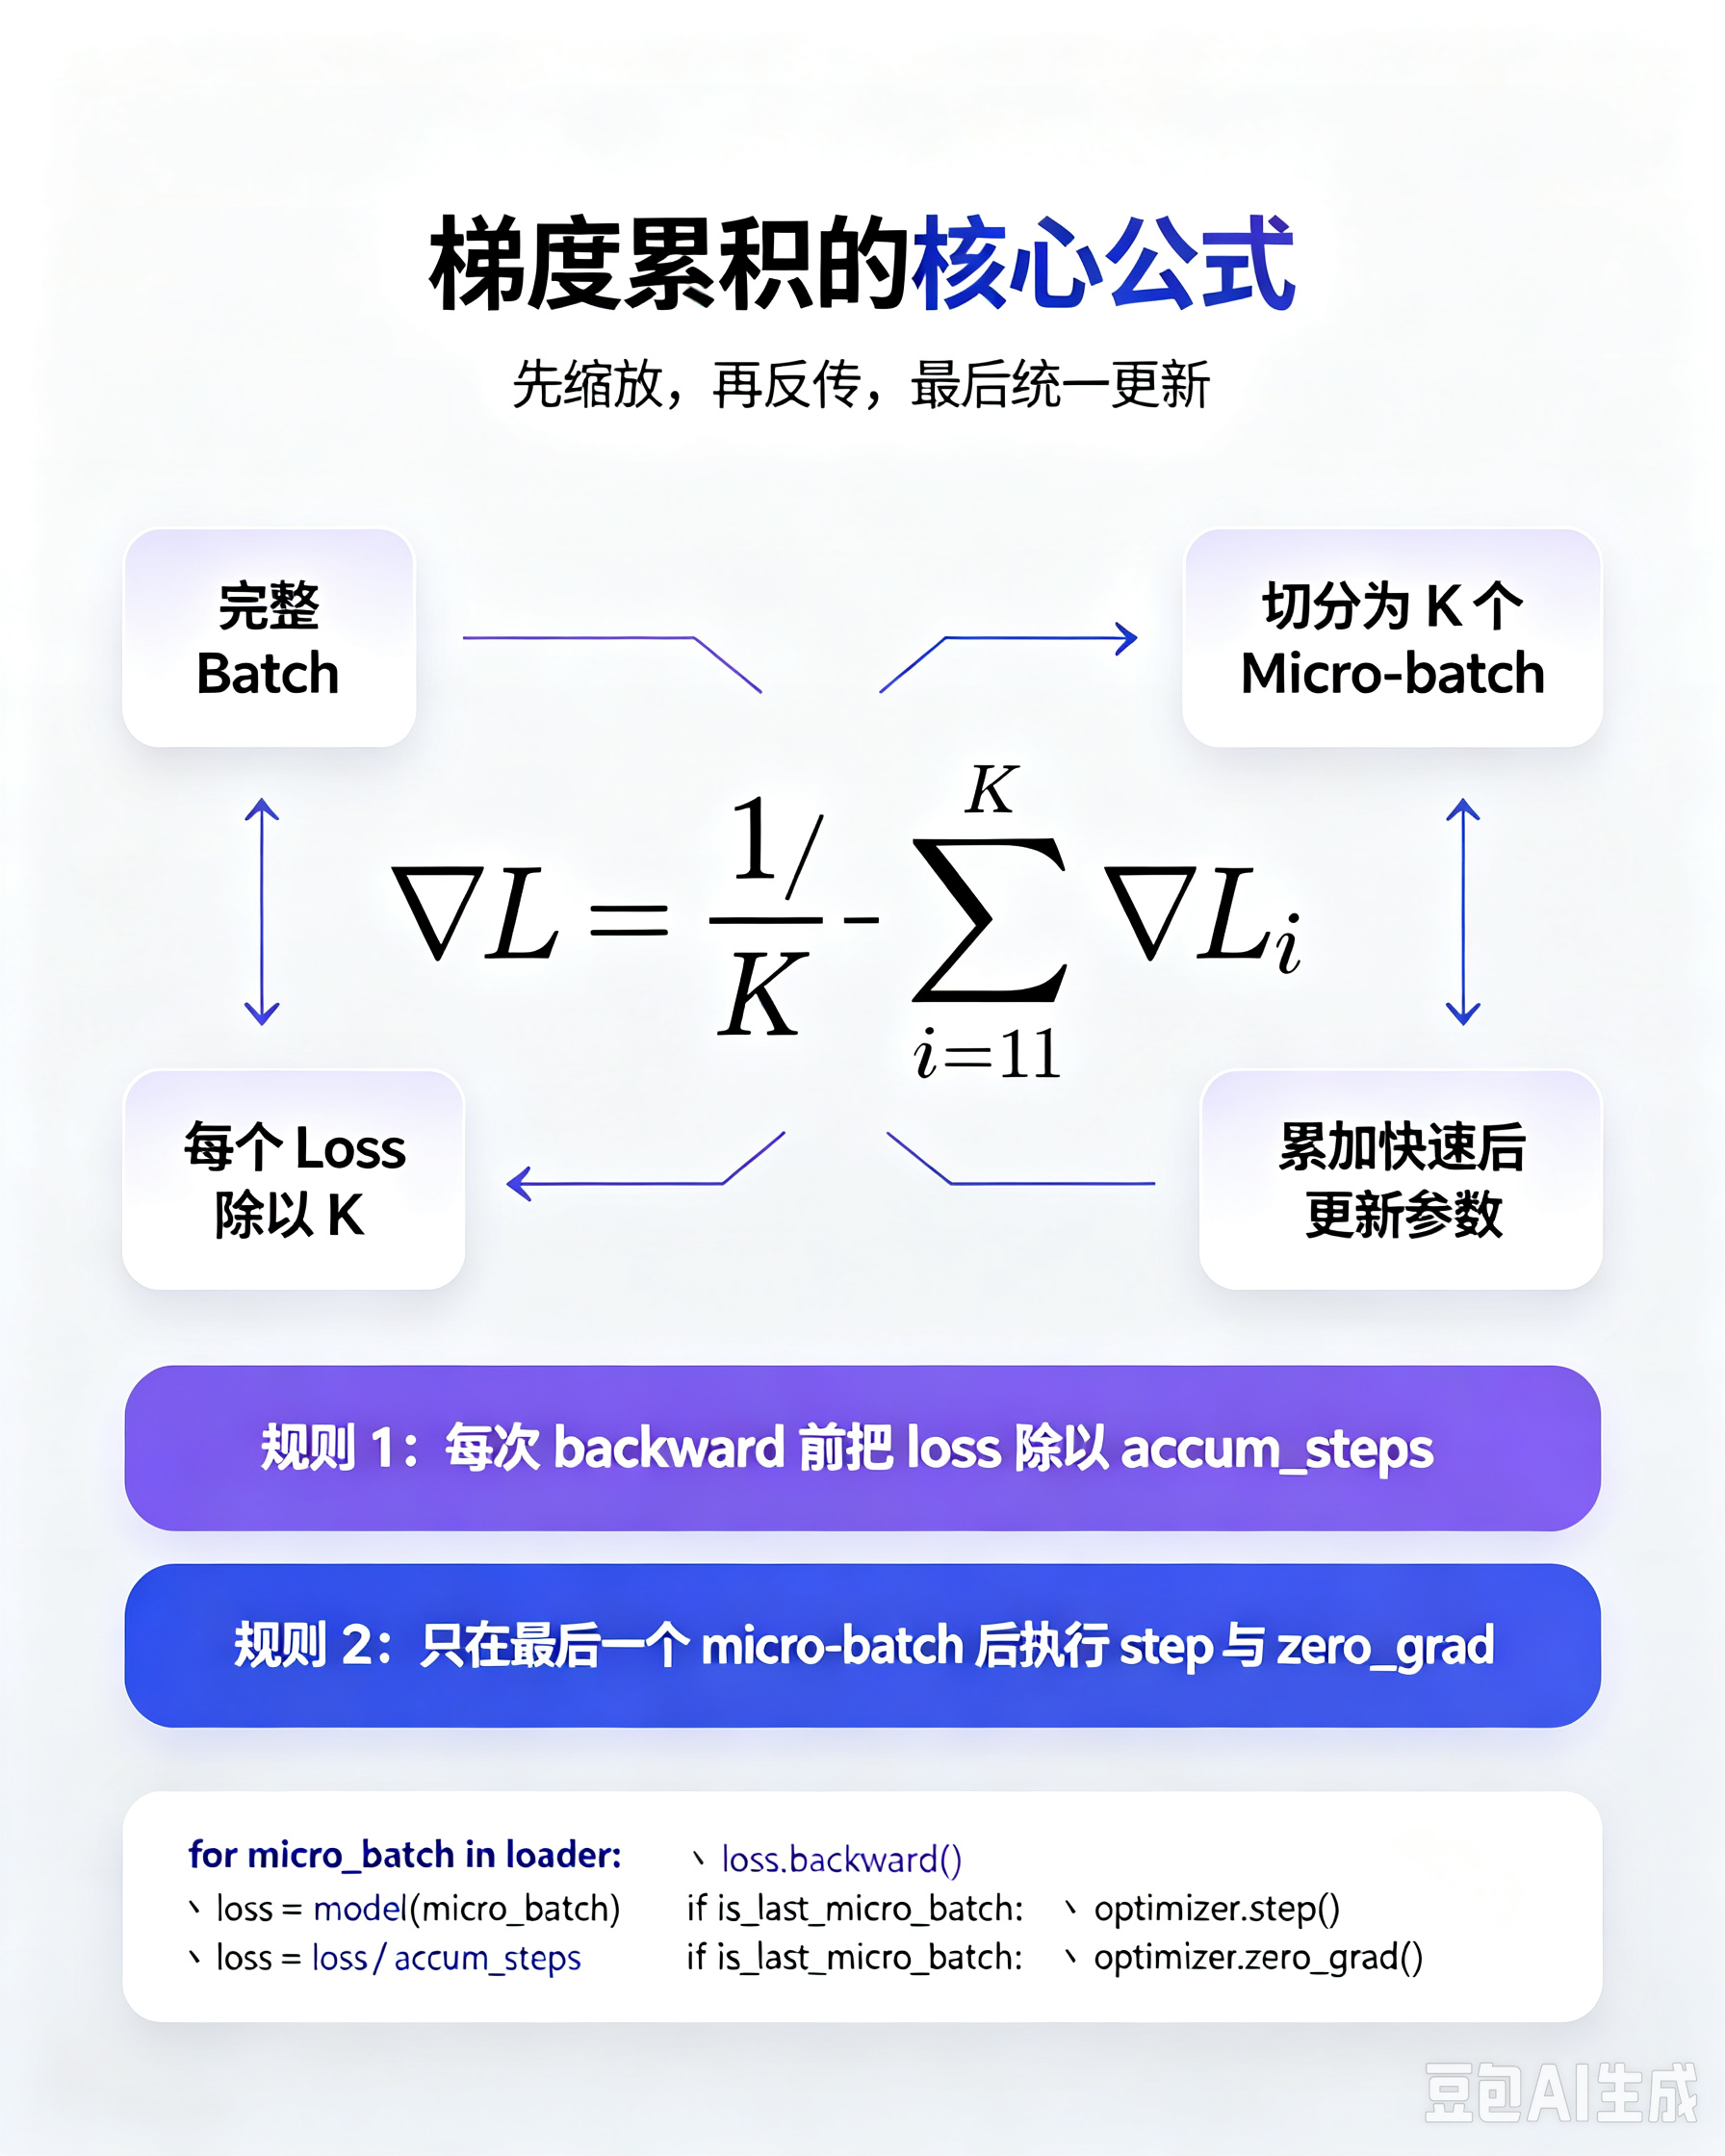
梯度累积

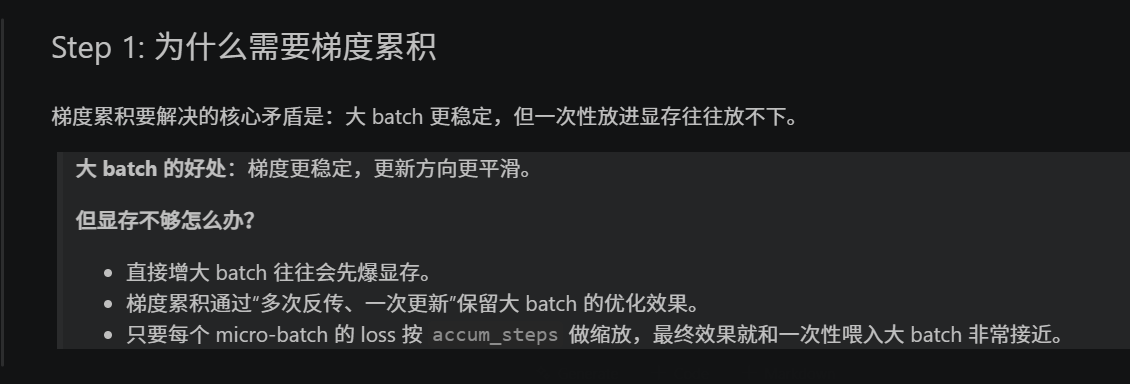
为什么需要梯度累积

Step1: 核心机制

  • 一个完整batch被切成K个micro-batch
  • 每个micro-batch各自前向 + 反转,梯度在.grad中累加。
  • 攒够k次后统一执行一次optimizer.step(), 再zero_grad()清零。

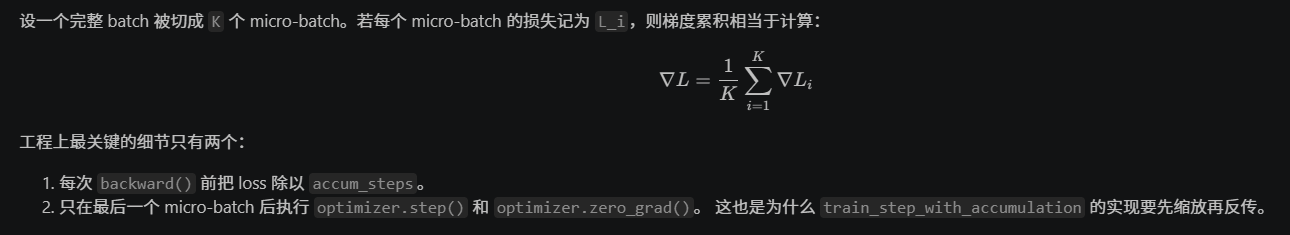
Step2: 数学等价性
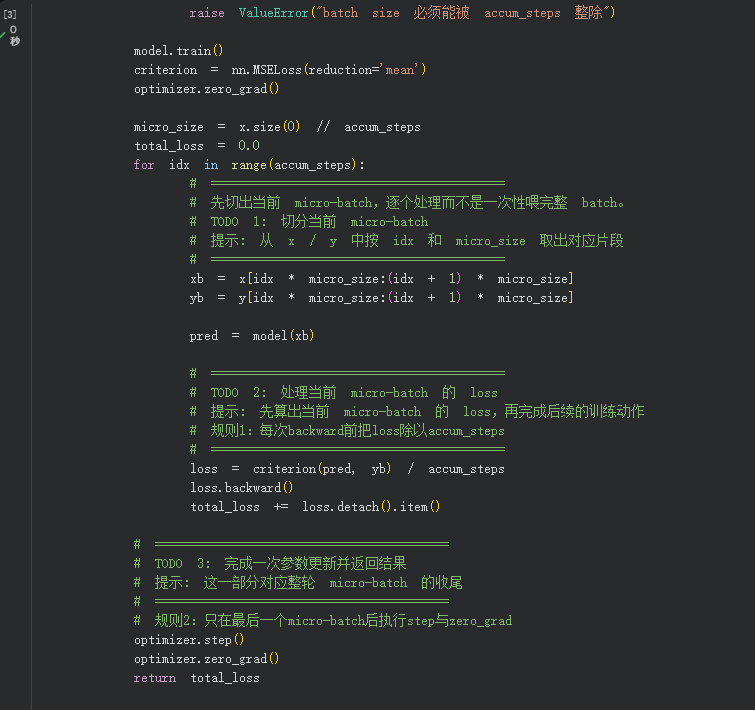
Step3: 代码实现框架
代码测试输出
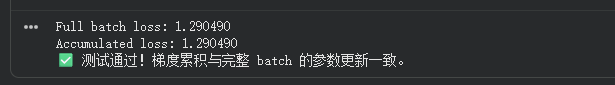
完整学习参考

Gradient Accumulation源码示例

激活检查点与激活卸载

痛点: 显存压力不只来自参数

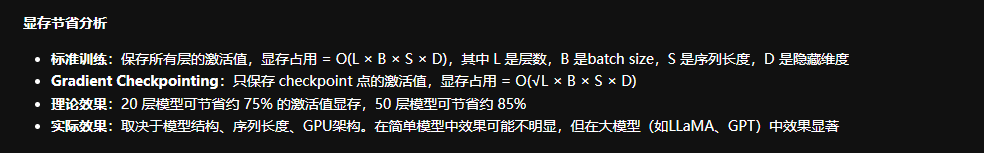
  • 前向传播为了反向传播,必须把每层中间输出(激活值)一直保存到显存里;层级越深、序列越长、batch越大,激活值占比越高。
  • 显存占用等于 O(L X B X S X D), L-层级数,B-batch size, S-序列长度, D-隐藏维度。
  • 问题:能不能少存激活,仍然完成反向传播?

Step1: 两条优化路线

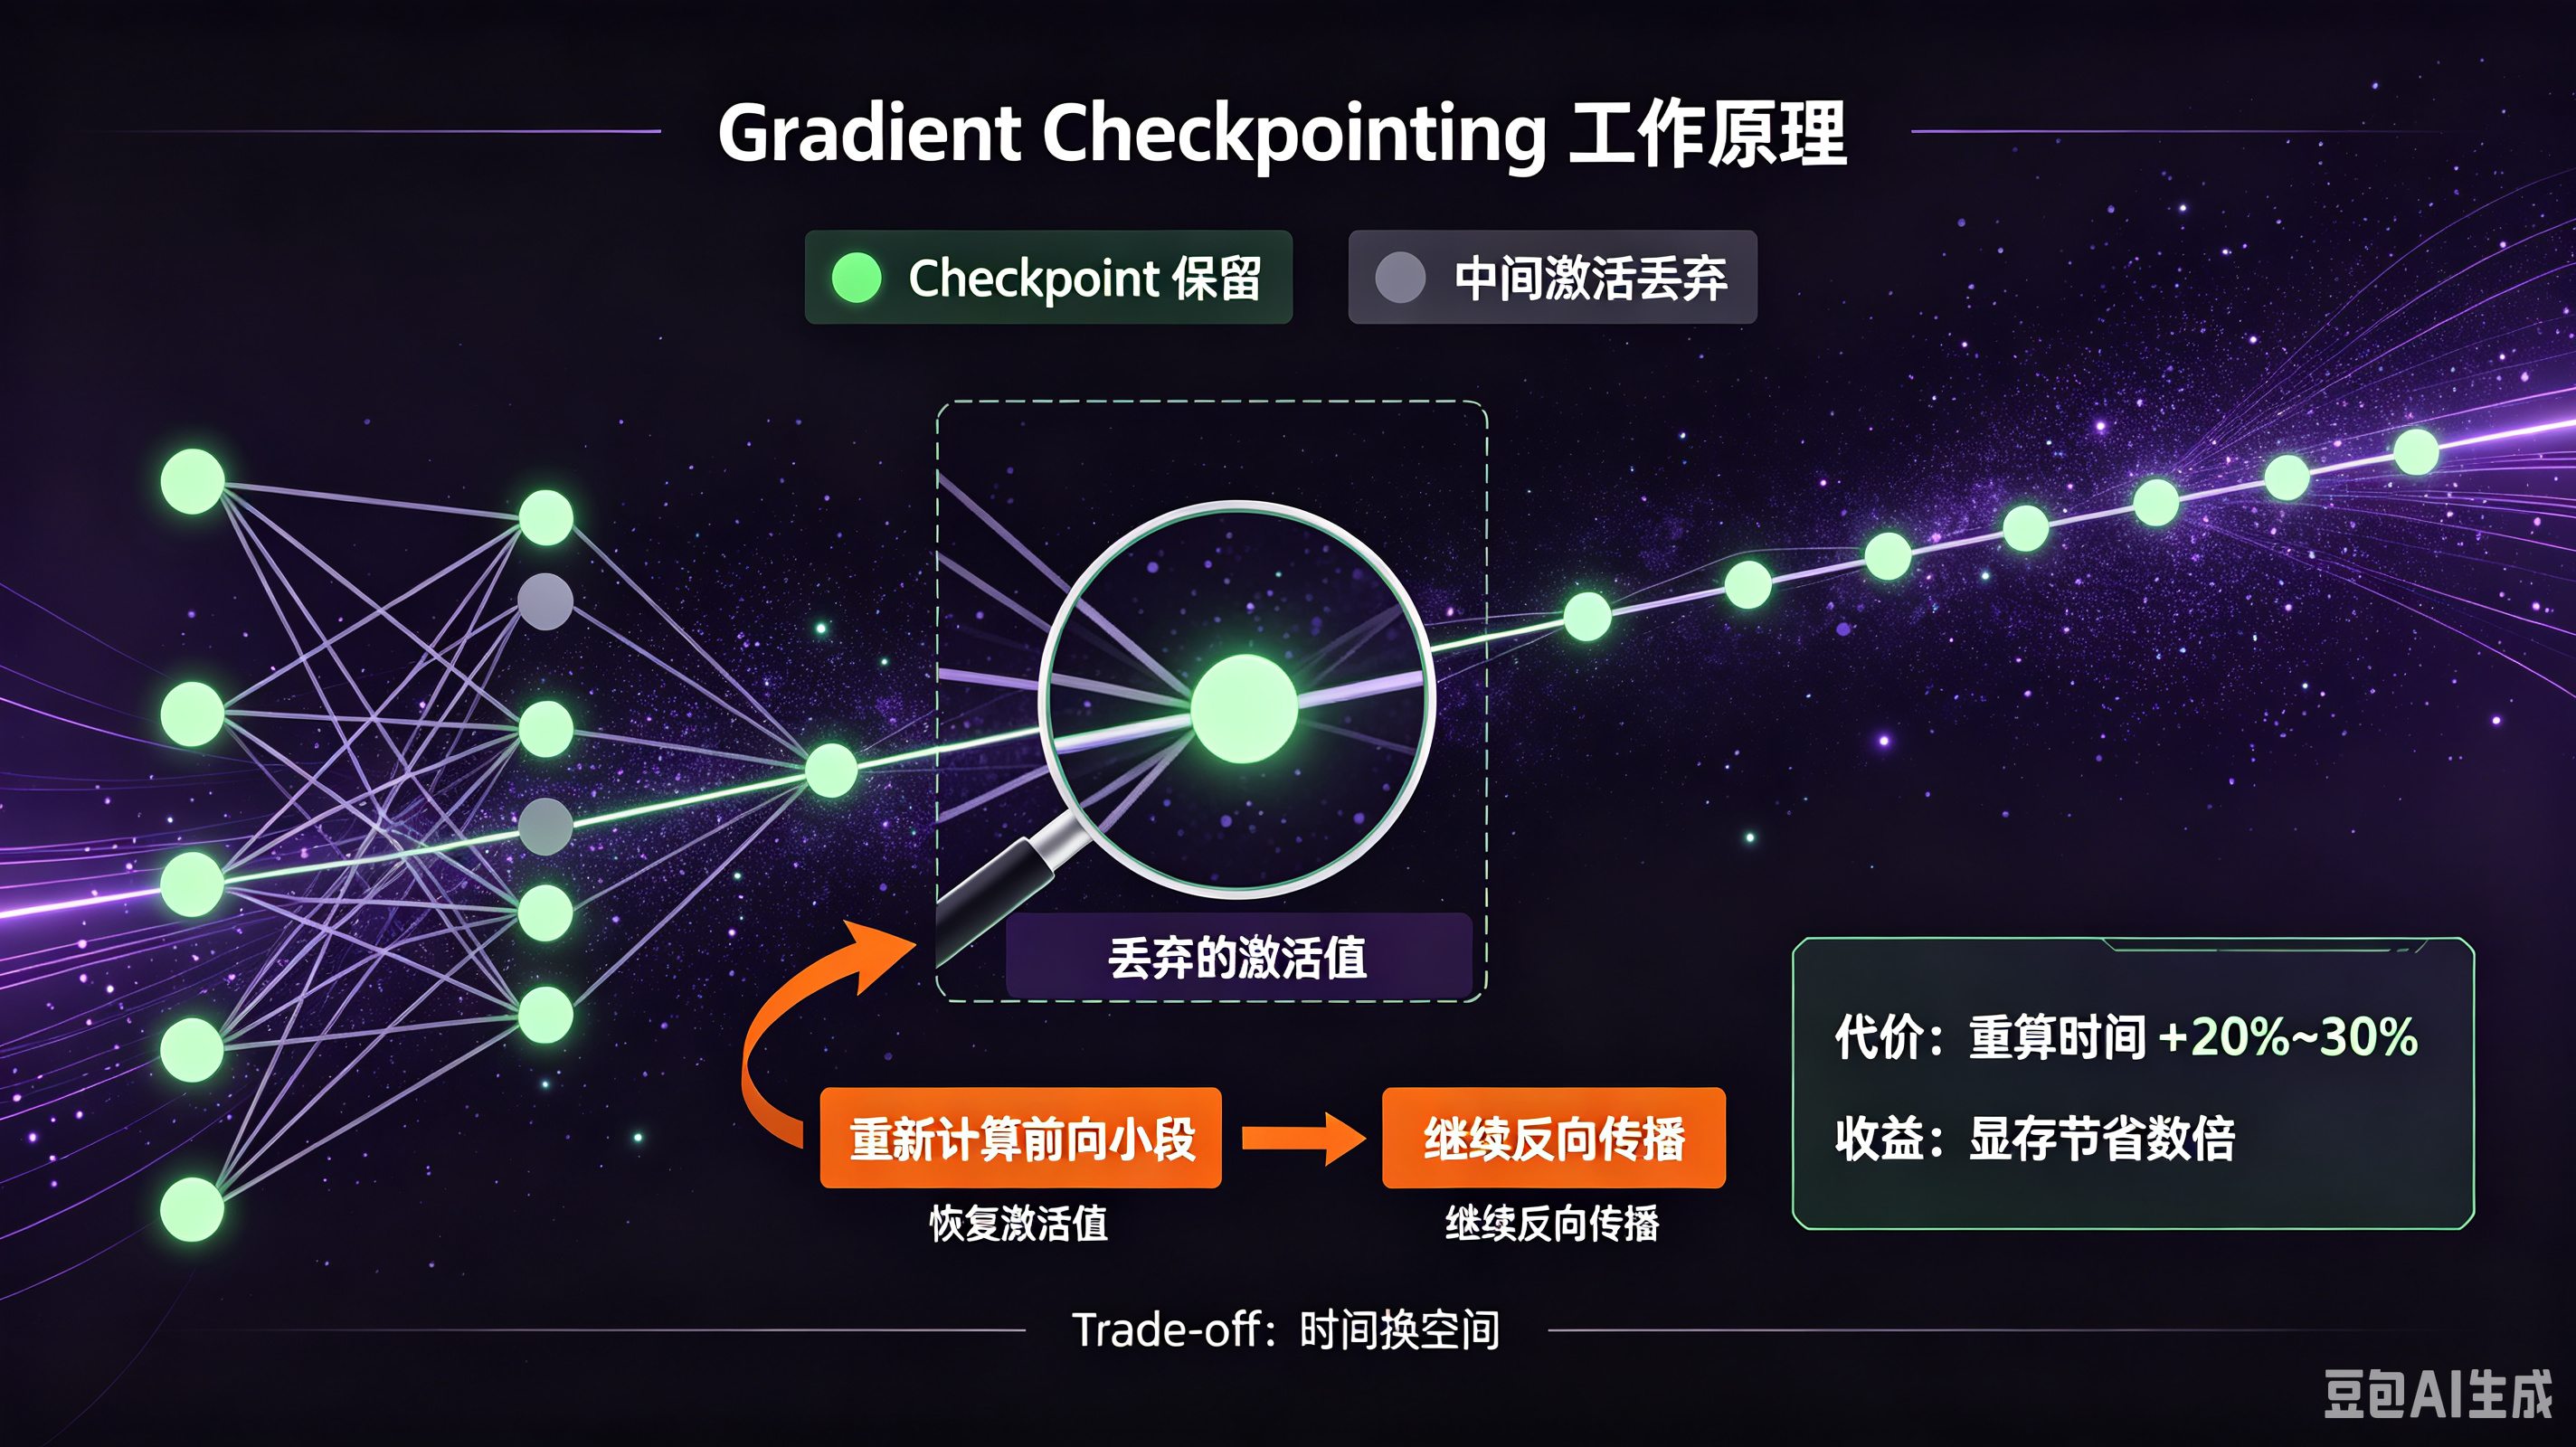
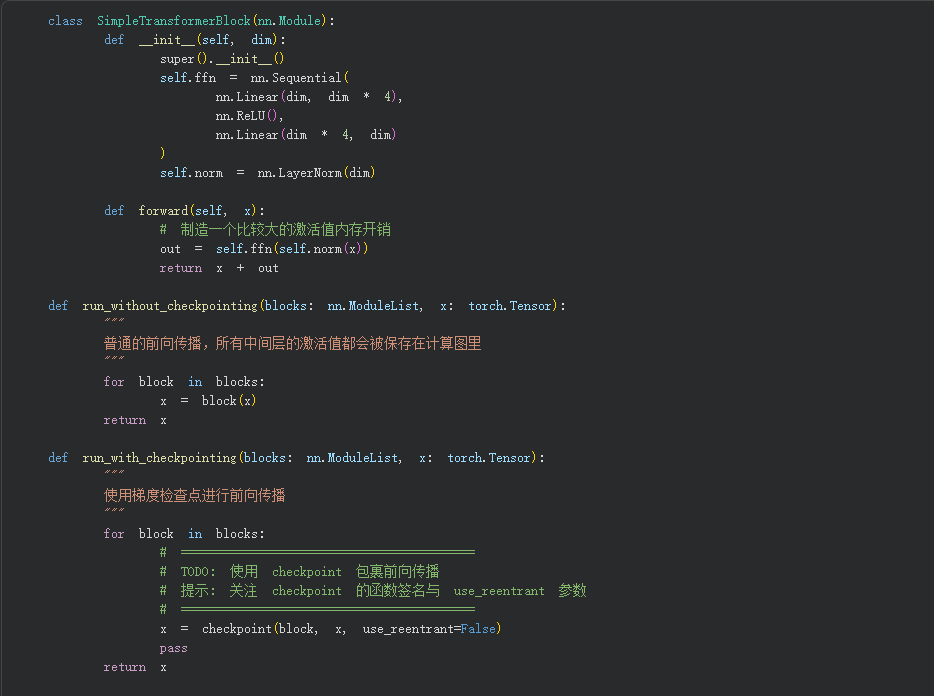
  • Activation Checkpointing(重计算换显存):不保存所有层激活,每隔几层存一个"检查点(Checkpoint)"
  • Activation Offload(搬运换显存): 把部分激活临时搬到CPU或者其他存储层级。
  • 代价对比: checkpointing多花约20% ~ 30%时间,节省成倍甚至数倍显存;本质是"时间换空间"
Step2: 显存节省分析
Step3: 代码实现部分
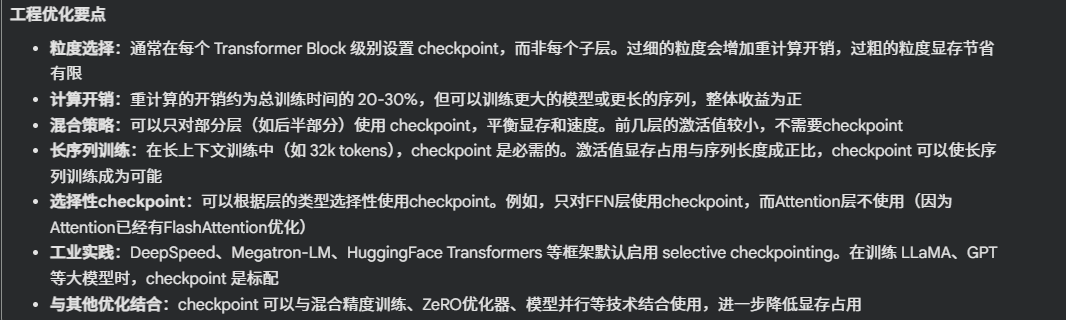
工程优化要点
完整学习参考

Activation Checkpointing源码示例

总结

  • 梯度累积:决定batch能开多大,训练稳不稳

  • 激活检查点与卸载: 决定显存怎么省

相关推荐
谙弆悕博士5 分钟前
从“预测下一个词”到“预测世界下一状态”:世界模型是不是下一个AGI叙事?
人工智能·gpt·深度学习·神经网络·agi·jepa·genie 4
敖老师8 分钟前
企业知识库 × 飞书机器人 —— 从 0 到 1 接入
人工智能
qingwufeiyang_53012 分钟前
Docker学习笔记2
笔记·学习
AI前端工程狮12 分钟前
我给 MCP 长任务做了持久化,结果造出一堆僵尸
人工智能·程序员
黑科技iOS上架25 分钟前
iOS游戏换皮上架困境:4.3同质化拒审
人工智能·ios·审核
咕泡科技28 分钟前
关于机器学习,如何通俗理解全连接层(fully connected layer)?
人工智能·深度学习·机器学习
Java后端的Ai之路30 分钟前
Java并发编程22-Lock接口
java·人工智能·prompt·lock
oil欧哟39 分钟前
AI 编程与写作高效工作流:语音输入、反问采访与多话题并行
人工智能
翰墨之道43 分钟前
黄仁勋回归传闻升温:英伟达领导层风波牵动AI产业
人工智能·数据挖掘·回归
天天代码码天天44 分钟前
把闲置电脑变成家庭照片备份站:开源 lw.HomeNAS v1.5.0 发布
人工智能