阅读时间:12 分钟
关键词:AI 成本治理、额度管理、模型分级、免费 LLM、Ollama、本地部署
全文命令与数据均为 2026-08-23 实测,价格标注"写这篇时"
背景:Codex 周额度重置风波
2026-08-13,OpenAI 重置 Codex 周额度后,社区实测缩水 44%-76%(按 API 价格折算,约从 160 美元/周降至 80 美元/周)。官方回应"没有暗改"。
问题不在于缩水本身,而在于订阅额度无法对账:
| 计费方式 | 透明度 | 可对账 |
|---|---|---|
| API 按量计费 | 输入/输出/缓存单价白纸黑字 | ✅ 每笔可查 |
| 订阅额度(credits) | 不公开 credit-token 换算与动作扣费 | ❌ 黑箱 |
这就是"黑箱货币"问题的典型样本:购买力由平台单方面定义,且随时可调整。7 月另有一例:用户 1450 元额度两天耗尽,OpenAI 开"作战室"后全员重置。
本文给出一套可落地的成本治理方案:体检定位 → 机制归因 → 模型分级 → 渠道组合 → 本地兜底。
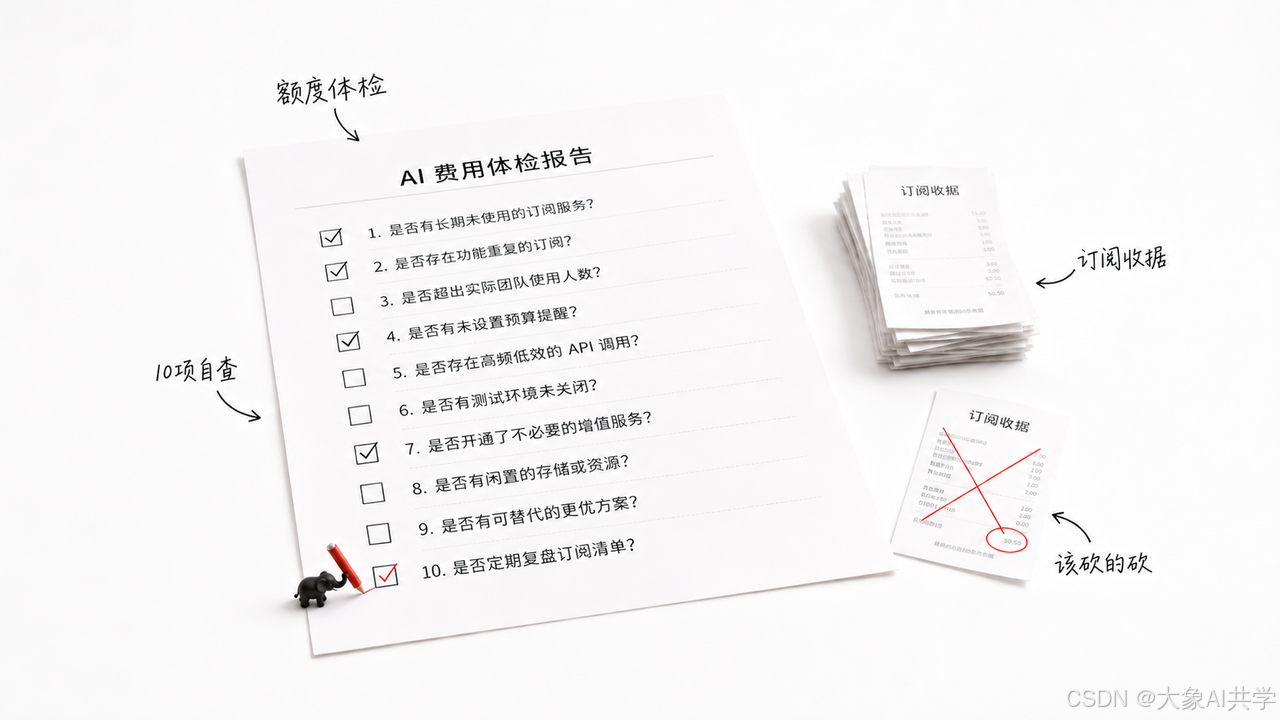 第一步:10 题成本体检表
逐项回答"是/否/答不上来":
| # | 问题 | 考察点 |
|---|---|---|
| 1 | 你现在有几个 AI 订阅? | 订阅冗余 |
| 2 | 每个订阅每月精确花费,凭记忆能说出吗? | 成本感知 |
| 3 | 过去 30 天有几次"额度用完"? | 额度弹性 |
| 4 | 额度用完第一反应:升级还是换工具? | 决策质量 |
| 5 | 最贵的一次 AI 对话花了多少? | 单次成本 |
| 6 | "改错别字"用的哪个模型? | 模型错配 |
| 7 | 知道常用工具的重置周期吗? | 机制认知 |
| 8 | AI 订阅占工具类开销比例过半了吗? | 结构风险 |
| 9 | 过去半年有没有订阅整月未打开但照扣费? | 沉没订阅 |
| 10 | 所有订阅明天价格翻倍,砍得掉几个? | 退出成本 |
结果分档:0-2 项异常(健康)/ 3-5(轻度)/ 6-8(中度,账单大概率 30%+ 浪费)/ 9-10(重度)。
第二步:机制归因,钱是怎么没的
机制 1:Agent 模式 token 消耗是聊天模式的几十倍。 聊天 = 一次输入输出;Agent = 读指令 + 读文件 + 读历史 + 规划 + 分步执行 + 自我反馈,单任务可达数十万 token。
机制 2:订阅额度是黑箱货币 (见背景部分)。
机制 3:订阅制边际陷阱。 "不限量"实为"不限次数、限额度",用户为"回本"心理驱动的使用多为低价值任务,形成"心理安慰 > 实际价值"的支出结构。
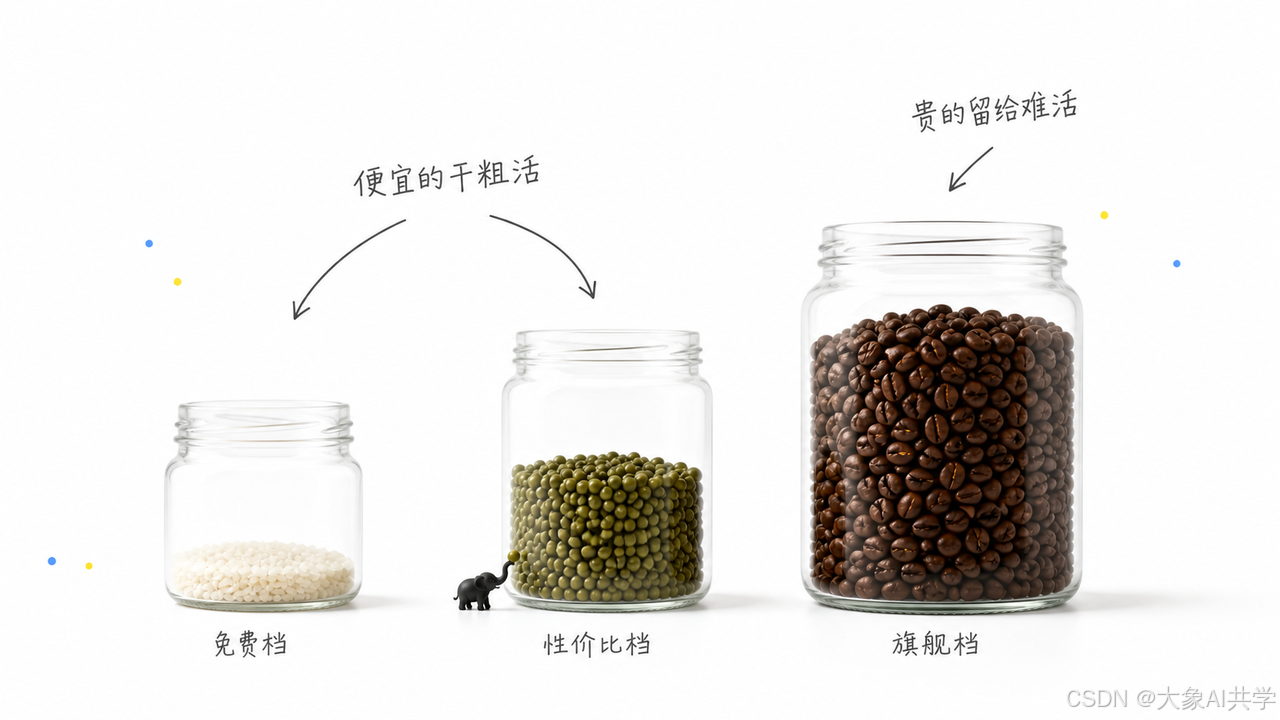
第三步:三档模型组合法
核心原则:按任务分级调用模型,禁止旗舰模型干杂活。
| 档位 | 适用任务 | 推荐配置 | 成本 |
|---|---|---|---|
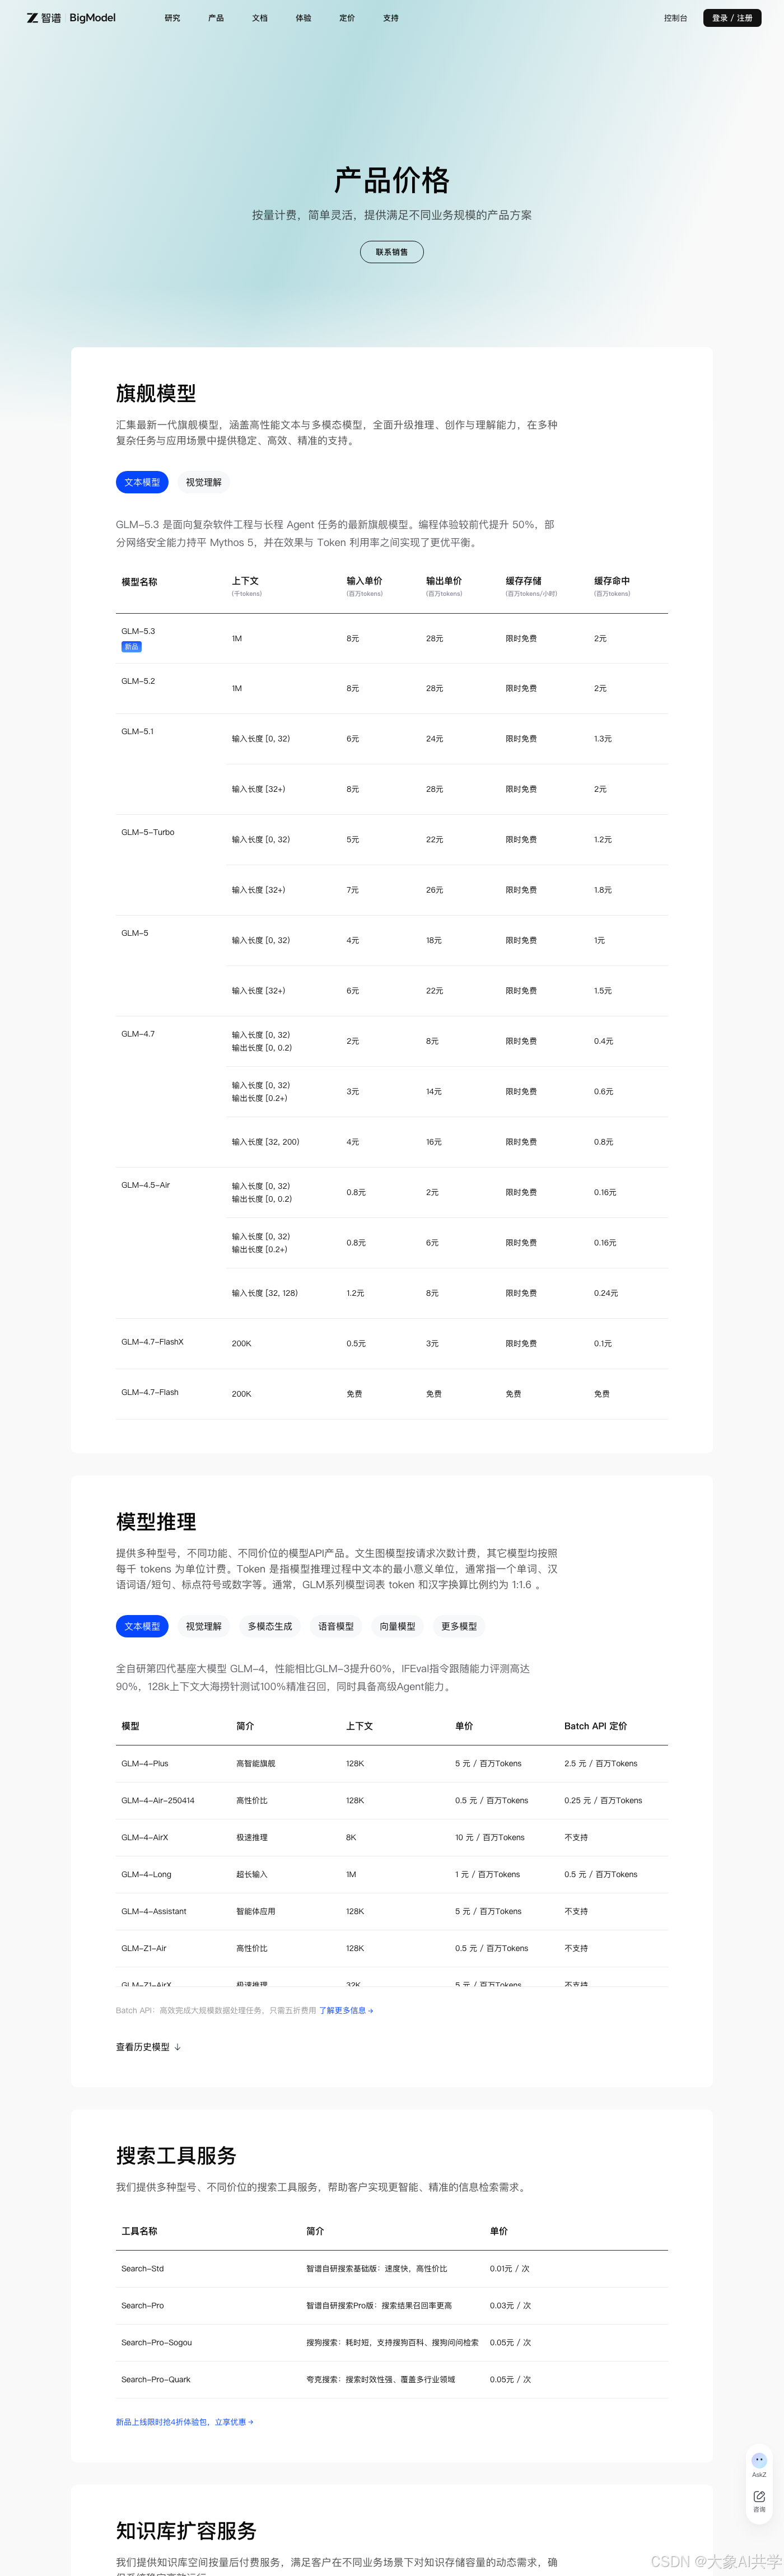
| 免费档 | 改错别字、格式转换、简单总结、翻译、起标题 | GLM-4.7-Flash / OpenRouter :free | 0 元 |
| 主力档 | 写文章、做方案、改代码、分析数据 | DeepSeek v4 系列 | 非高峰 0.07 美元/百万输入 token |
| 旗舰档 | 复杂推理、大型重构、关键决策 | 各家旗舰订阅 | 按需 |
 实测数据(2026-08-23,同一任务"改邮件语气"):
| 模型 | 耗时 | 质量 | 成本 |
|---|---|---|---|
| glm-4.7-flash(免费档) | 14.2s | 合格 | 0 元 |
| glm-5.3(旗舰档) | 9.6s | 合格 | 订阅额度 |
4.6 秒的差距对应一年的订阅差价,性价比自行判断。
笔者的系统级实践:主力任务用旗舰模型,压缩/搜索/审批/格式检查等辅助任务切换 turbo 级模型,一年整体成本下降 81%,辅助操作响应从 10-30s 降至 3-5s。
第四步:免费渠道组合(实测可用)
策略:多渠道轮用,不依赖单点。
渠道 1:智谱 GLM-4.7-Flash(主免费池)
注册 bigmodel.cn,控制台创建 API Key。官方定价页确认:输入免费、输出免费、缓存免费,200K 上下文。
实测调用(2026-08-23,耗时 10.8s,17 输入 token,0 扣费):
curl https://open.bigmodel.cn/api/paas/v4/chat/completions \
  -H "Authorization: Bearer $ZHIPU_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-4.7-flash",
    "messages": [{"role": "user", "content": "用一句话解释什么是API"}]
  }'
实测坑 1:免费模型有并发限制,连续请求触发 429,等 30s 恢复。这不是故障,是免费的价格。
实测坑 2:glm-4.7-flash 默认开启思考模式,简单任务会被思考链拖慢甚至吃空 max_tokens。禁用方法:
"thinking": {"type": "disabled"}封装成 CLI 工具(flash.py,零依赖,保存后 python3 flash.py "任务" 直接用):
# flash.py ------ 免费档专用工具
import os, json, sys, urllib.request

key = os.environ.get("ZHIPU_KEY", "把你的key粘到这里")
task = " ".join(sys.argv[1:]) or input("要它干什么?")

payload = {
    "model": "glm-4.7-flash",
    "thinking": {"type": "disabled"},
    "messages": [{"role": "user", "content": task}],
}
req = urllib.request.Request(
    "https://open.bigmodel.cn/api/paas/v4/chat/completions",
    data=json.dumps(payload).encode(),
    headers={"Authorization": "Bearer " + key,
             "Content-Type": "application/json"},
)
with urllib.request.urlopen(req, timeout=60) as r:
    print(json.loads(r.read())["choices"][0]["message"]["content"])
渠道 2:OpenRouter 免费模型(第二免费池)
一个 Key 串起多厂商模型,:free 后缀全免费。2026-08-23 实拉模型列表接口,当前 22 个免费模型(含 z-ai/glm-5.2:free、google/gemma-4-31b、nvidia/nemotron-3-super-120b):
# 查询当前免费模型列表
curl -s "https://openrouter.ai/api/v1/models?max_price=0" | \
  python3 -c "import sys,json; [print(m['id']) for m in json.load(sys.stdin)['data']]"

# 调用免费模型
curl https://openrouter.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $OPENROUTER_KEY" \
  -d '{
    "model": "z-ai/glm-5.2:free",
    "messages": [{"role": "user", "content": "你好"}]
  }'
渠道 3-5(简述)
- Gemini API 免费层:AI Studio 生成 Key,Flash 系列每日免费额度;注意免费层数据会被用于产品改进,涉隐私内容不走此线。
- Groq:LPU 推理芯片,速度极快,适合轻任务。
- 各家新用户礼 :注册即送数百万 token,定期薅一圈。
第五步:本地部署兜底(Ollama 两步走)
适用判断:高频、轻量、涉隐私 → 本地;低频、重度、要质量 → 云端旗舰。
2026 年 16G 内存普通办公本可流畅跑 7B-14B 开源模型,无需独立显卡。
第一步:安装 Ollama 并拉模型
# macOS(brew)
brew install ollama

# 拉起第一个本地模型(8b:5.2GB,40K 上下文;8G 内存机器用 4b:2.5GB)
ollama run qwen3:8b

# 查看已装模型
ollama list
笔者实测输出(2026-08-23,qwen3:4b):
NAME        ID              SIZE
qwen3:4b    359d7dd4bcda    2.5 GB
第二步:接入图形客户端
ollama 自带 OpenAI 兼容接口(http://localhost:11434/v1),验证:
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3:4b",
    "messages": [{"role": "user", "content": "把这句话改成正式邮件语气:哥们,明天下午三点开会别迟到"}]
}'实测返回:"您好,会议将于明天下午三点召开,请勿迟到。另有重要事项需向您汇报。"
接入 Cherry Studio 等客户端只需三行配置:
| 配置项 | 值 |
|---|---|
| 接口地址 | http://localhost:11434/v1 |
| 模型名 | qwen3:4b |
| API Key | 留空 |
本地部署的核心价值排序:隐私 > 无限量 > 离线可用 > 省钱(电费也是钱)。
 总结
成本治理五步:体检定位(10 题)→ 机制归因(Agent 消耗/黑箱货币/边际陷阱)→ 模型分级(三档组合)→ 渠道组合(免费池轮用)→ 本地兜底(Ollama)。
笔者的系统级实测结果:整体成本下降 81%。核心不是省钱,是身份转变:把账本从平台手里拿回来,自己看。
额度会缩水,能力不会。平台会变脸,你的电脑不会。
作者 :大象,推动 AI 共学(官网:大象AI共学 - 让 AI 不止会聊天,还会替你干活 )
本文所有命令与数据均为 2026-08-23 实测。价格类信息以官方定价页实时为准。