第二讲把概率密度函数的估计方法过了一遍,参数方法里有最大似然和贝叶斯估计,非参数方法里有 kNk_NkN 近邻和 Parzen 窗,两类方法的共同目标是让估计出来的密度在样本数增大时收敛到真实密度。在往下走之前,先回头问一个更前置的问题:一个分类器的错误率,究竟由哪些东西决定。把这个来源拆开,才能判断一个偏高的错误率该归咎于什么,也才能理解后面那些不用概率密度的分类器为什么那样设计。
一、三类误差
1.1 消不掉的贝叶斯误差
把两类的加权条件密度 P(ω1)p(x∣ω1)P(\omega_1)p(\boldsymbol{x}|\omega_1)P(ω1)p(x∣ω1) 和 P(ω2)p(x∣ω2)P(\omega_2)p(\boldsymbol{x}|\omega_2)P(ω2)p(x∣ω2) 画在同一张图上,两条曲线中间会有一段重叠。用最小错误率贝叶斯决策,决策面落在两条曲线的交点处,交点左边判第一类、右边判第二类。重叠区里必然有一批样本判错,交点左边那块阴影是落在第二类区域里的第一类样本,右边那块阴影是落在第一类区域里的第二类样本。
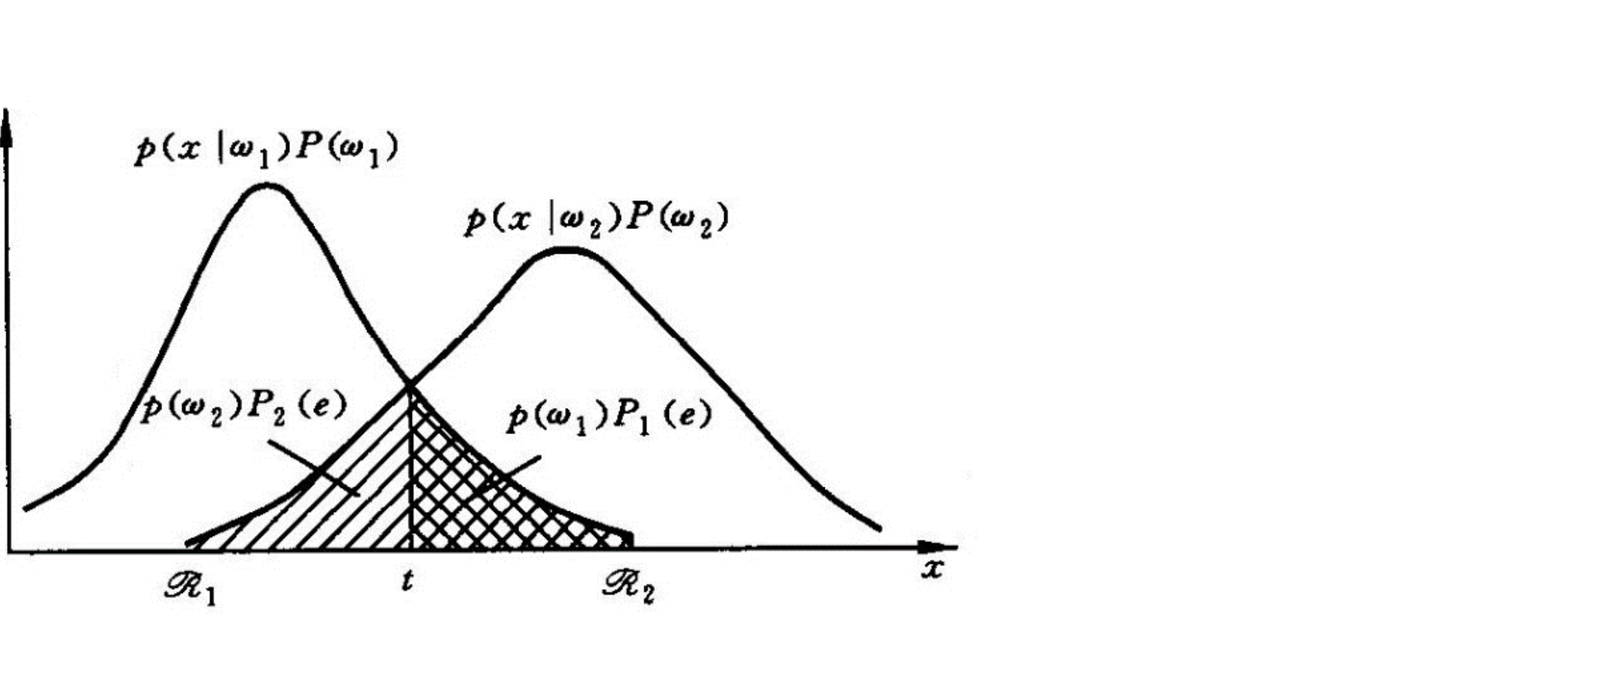
两块阴影的面积之和就是总错误率。
P(e)=∫R1P(ω2)p(x∣ω2)dx+∫R2P(ω1)p(x∣ω1)dx(1-1)P(e)=\int_{\mathcal R_1}P(\omega_2)p(\boldsymbol{x}|\omega_2)d\boldsymbol{x}+\int_{\mathcal R_2}P(\omega_1)p(\boldsymbol{x}|\omega_1)d\boldsymbol{x}\tag{1-1}P(e)=∫R1P(ω2)p(x∣ω2)dx+∫R2P(ω1)p(x∣ω1)dx(1-1)
这种误差来自不同类的概率分布之间的相互重叠,是问题本身固有的属性,在分类器设计阶段无法消除。
一个很自然的反问是:既然错误来自重叠,把决策面往左边或右边挪一点,让一类的错误降下来、另一类升上去,总错误率会不会反而变小?
一个具体的设想是挪阈值。两类等先验时按 0.5 判定,把判定的分界改成 0.64,让其中一类多一点机会被判对。设想里这样能把那一类的错误降下来,另一类的错误升上去,总量或许会减。结论是不会。式(1-1)那个交点位置已经是总错误率的最小值,挪动只是在两类之间重新分配错误,一头减一头增,总量只会变大。第一讲给过这个结论:贝叶斯分类器在所有可能的决策规则里错误率最小。
这个结论的限定条件要说清楚:两类的先验概率给定,类条件概率密度给定,用来分类的特征也给定了。三条都固定住,重叠区的大小就固定下来,决策面取在两条曲线的交点处时总错误率最小。挪动决策面,等价于把判定的分界往一边推,一批本来判对的样本被推进错的一边,另一批从错的一边挪回来,两头相抵之后总量只增不减。所以错误率的最小值由问题本身决定,分类器设计阶段只能逼近它,不能突破它。
落到实践上,拿到一个错误率偏高的结果,先要做的是分辨它来自哪里。是问题本身难,还是分类器没设计好。这两件事的处理方式完全不同,前者再怎么调分类器也无济于事,后者才有改进的余地。回到第一讲的玉米与杂草,两类先验给定、类条件密度给定、特征也选定,重叠区的大小就成了定局,分类器做什么都无法再压下去。这也是下面两小节要接着讨论的另外两种误差的出发点:重叠管不了,但模型和样本这两头还有操作空间。
1.2 模型选错的代价
设实际数据服从正态分布,估计时也按正态假设模型形式,样本充足的情况下估计性能还不错。如果实际是均匀分布,而仍然按正态去假设,情况就不同了:样本采得再多,估计出来的密度和真实分布仍然差得很远。密度估不准,分类决策的性能就跟着变差。
这类误差叫模型误差,根源在模型形式的选择。它比后面要讲的估计误差更难处理,因为真实分布是未知的,模型形式选得对不对,本身就是一个判断问题。
1.3 样本不够的代价
模型形式选对了,事情还没完。样本有限,估出来的密度仍然不准。只取五个样本去估一个概率密度,得到的曲线形状和取五百个样本估出来的差别很大。这类误差叫估计误差,只要样本量不够就会存在,与模型形式是否选对无关。
缓解估计误差有两条路。一条是增加样本量,另一条是换更好的估计方法。
第二条路展开一下。估一门课的平均分,手上只有一两个分数,按最大似然估,得到的就是这两个分数的平均,离真实平均分可能很远,一个偏低的样本会把结果整个拉下去。如果对这门课的成绩分布有一个先验,比如大致落在 85 分附近、波动不大,用贝叶斯估计把先验和样本一起考虑,估计结果就被拉回到合理的位置。第二讲里那个班级平均分的例子说的正是这件事:先验把单一样本带来的偏差校正掉。所以缓解估计误差不只是多采样本一条路,把已经有的先验知识用起来同样有效。
1.4 模型误差与估计误差的取舍
样本数少的时候,这两类误差是矛盾的。
用复杂模型,模型形式接近真实,模型误差小;但模型里的参数多,用很少的样本去估很多参数,估计误差大。用简单模型,需要估的参数少,估计误差小;但模型对真实分布做了简化,模型误差大。典型的例子是估一个多维高斯,假设各个特征相互独立,而且方差相等。这个假设在样本少时能把估计误差压下来,代价是引入模型误差,因为真实特征之间未必独立,方差也未必相等。
| 选择 | 模型误差 | 估计误差 |
|---|---|---|
| 复杂模型 | 小 | 大 |
| 简单模型 | 大 | 小 |
两类误差很难同时压小,实际中要在两者之间取一个平衡,让总的误差最小。这个权衡不是一句原则,它有可操作的一面:样本数已经定死的时候,把模型放复杂,省下来的是模型误差,付出的是估计误差;把模型压简单,省下来的是估计误差,付出的是模型误差。往哪边挪,取决于手上有多少样本,以及真实的分布离假设的模型有多远。样本多到一定程度,复杂模型才划得来。
二、估准一个密度需要多少样本
2.1 一百的 d 次方
估计一维概率密度函数,样本数达到几百,结果一般就不错了,取个整数 100。二维需要 1002100^21002 个,也就是一万个。推广到 ddd 维:
Nd=100d(2-1)N_d=100^d\tag{2-1}Nd=100d(2-1)
这个量随维数按指数增长,涨得比直觉快得多。每增加一个特征维,样本需求就乘上 100。一维时几百个样本够用,二维变成一万个,十维就是一百亿亿个。样本数固定在同一个量级,维数一涨,能落在每个局部区域的样本就迅速稀疏下去,密度估计失去意义。这就是维数灾难的算术根源。
2.2 人脸的例子
拿人脸识别来说。取最简单的几个特征,眼睛的长和宽、鼻子的长和宽、嘴巴的长和宽,再加上两眼之间的间距,凑十来个特征并不困难。十维,按式(2-1)的口径需要
N10=10010=1020(2-2)N_{10}=100^{10}=10^{20}\tag{2-2}N10=10010=1020(2-2)
个样本。
10410^4104 是一万,10810^8108 是一亿,101010^{10}1010 是一百亿,地球人口大约七十到八十亿。把地球上每个人各采一张脸,样本数还差十个数量级。这不是采集能力的问题,是量级上根本无法满足。
维数一高、样本数上不去,密度就估不准,分类器也就无从谈起。这个问题叫维数灾难。
2.3 两条缓解的路
第一条路是假设特征之间相互独立。若 x1x_1x1 到 xdx_dxd 彼此独立,联合密度可以拆成边缘密度的乘积:
p(x1,...,xd∣ω)=p(x1∣ω)⋯p(xd∣ω)(2-3)p(x_1,\dots,x_d|\omega)=p(x_1|\omega)\cdots p(x_d|\omega)\tag{2-3}p(x1,...,xd∣ω)=p(x1∣ω)⋯p(xd∣ω)(2-3)
原本要在 ddd 维空间里估一个联合分布,现在拆成 ddd 个一维密度分别估计,样本需求量随维数变成线性增长,这就是朴素贝叶斯的做法。
代价是那个独立性假设通常不成立。眼睛的长和宽、嘴巴的长和宽,很难说彼此无关。假设一旦偏离实际,就引入了模型误差。所以用不用这个假设,要看它带来的估计误差下降和模型误差上升,哪一头更大。
第二条路是降维。大量的高维数据实际上嵌入在一个低维流形上。
拿 1024×1024 的人脸图像说,每个像素取 0 到 255 之间的一个整数,参数空间是百万维。如果让每个像素都在 0 到 255 之间独立随机取值,得到的是一张噪声图,上面没有人脸的任何结构。真正的人脸图像只占据这个百万维空间里一个低维的、有结构的子集。把有意义的方向找出来、把维度降下去,样本需求就跟着降下去。降维的具体做法后面还有一讲专门展开。
三、过拟合
3.1 泛化能力
对训练样本以外的其他样本的预测能力,称为泛化能力,也叫推广能力。过拟合指的是在训练样本上表现好、但泛化能力差。这个问题在概率密度估计和分类器设计里都会出现,是这两种方法共同的一块短板。
3.2 过拟合的两个来源
概率密度函数估计里的过拟合,最典型的是最大似然。用五个点去估一个二维正态分布,估出来的协方差矩阵被这五个点的走向牵着走,密度的形状与真实分布相去甚远。
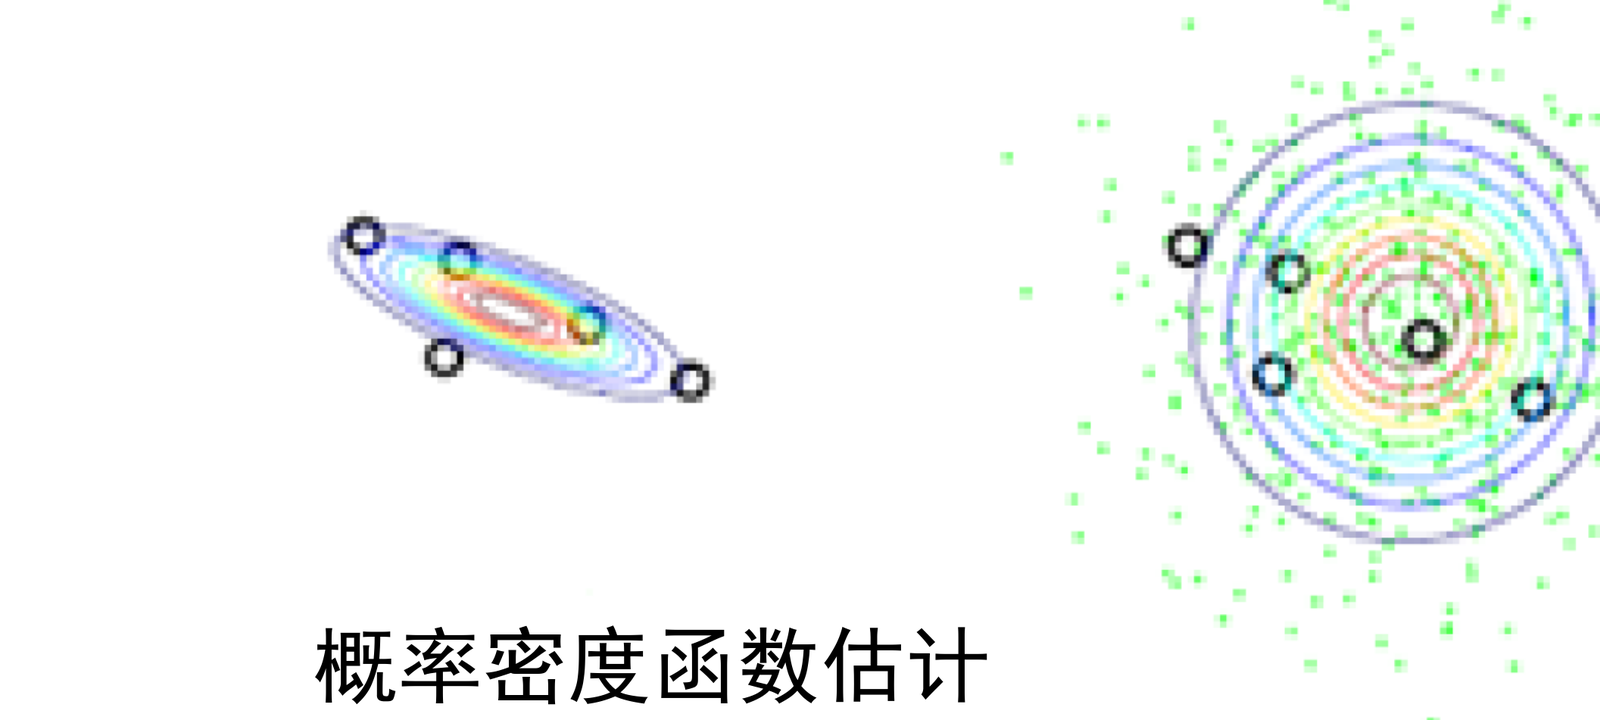
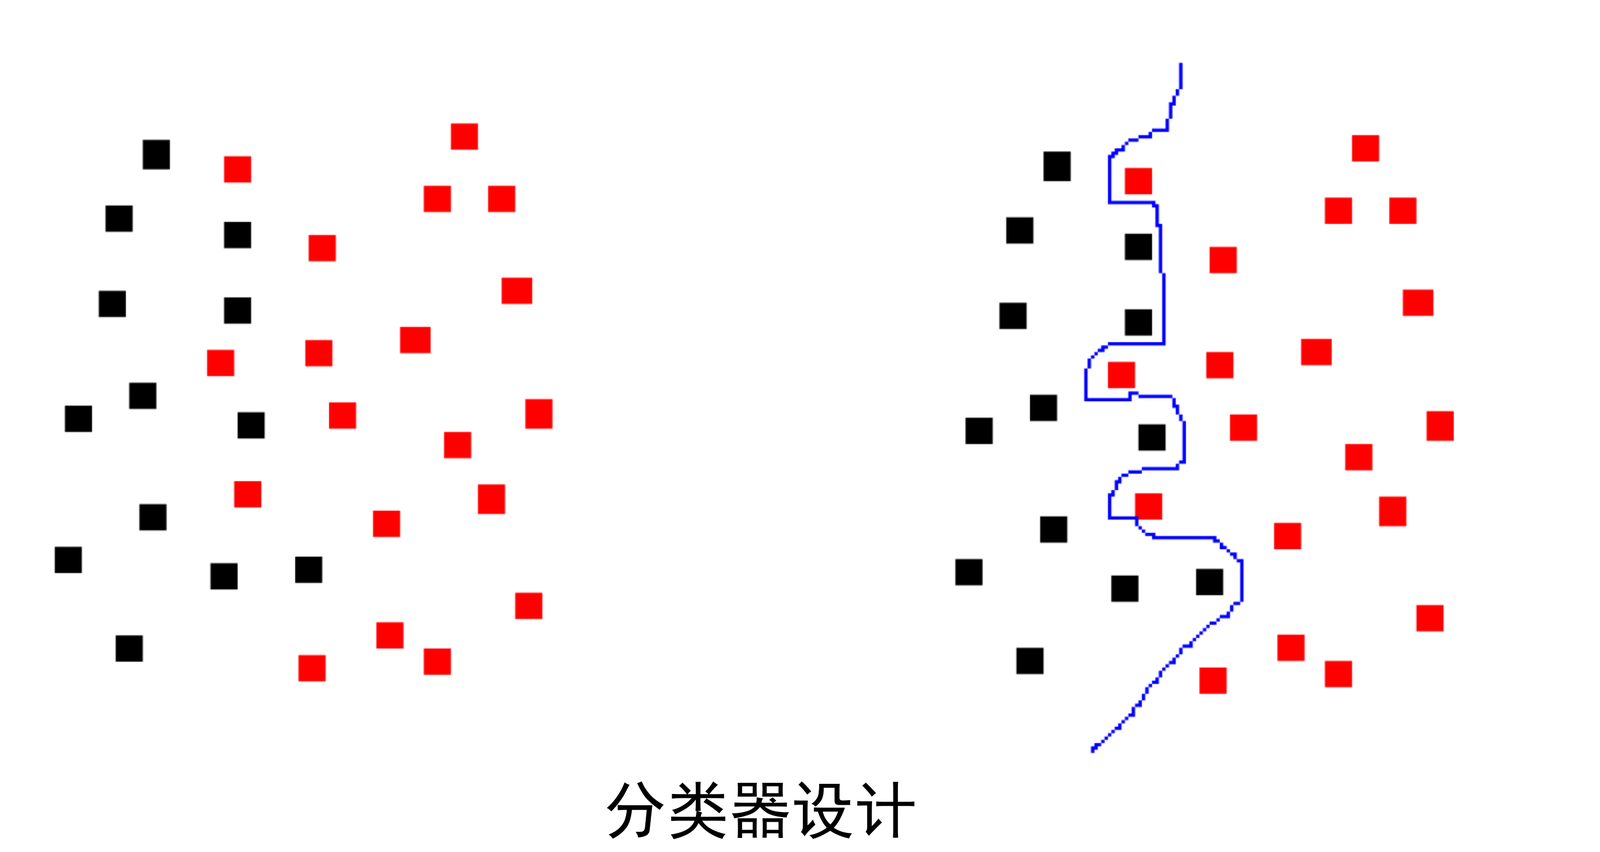
分类器设计里的过拟合同样明显。两类样本,用一个形状很复杂的决策面可以把训练集全部分对,边界在两类样本之间绕来绕去。采样本身带有随机性,测试样本只要稍微偏开训练点的位置,复杂决策面就在那里判错,而一个简单的决策面反而更稳。
3.3 曲线拟合的例子
为了让偏差与方差这两件事讲得清楚,换一个更容易看懂的曲线拟合问题。
xxx 在 0 到 1 之间取值,输出在绿色曲线 g(x)=sin(2πx)g(x)=\sin(2\pi x)g(x)=sin(2πx) 的基础上叠一个系统噪声:
y=g(x)+ϵ⋅N(0,1)(3-1)y=g(x)+\epsilon\cdot\mathcal{N}(0,1)\tag{3-1}y=g(x)+ϵ⋅N(0,1)(3-1)
对应的条件分布是均值 g(x)g(x)g(x)、方差 ϵ2\epsilon^2ϵ2 的正态分布。这个生成过程本身是未知的,能拿到的只有从分布里采出的一组样本点。
把曲线拟合写成一个学习问题,损失取均方误差,假设空间取不超过 MMM 次的多项式:
H={h:h(x)=∑j=0Mwjxj}(3-2)\mathcal{H}=\left\lbrace h: h(x)=\sum_{j=0}^{M}w_jx^j\right\rbrace\tag{3-2}H={h:h(x)=j=0∑Mwjxj}(3-2)
在这一组样本上让经验风险最小,经验风险就是均方误差在训练集上的平均:
f^=argminf∈H1N∑i=1N(f(xi)−yi)2(3-3)\hat{f}=\arg\min_{f\in\mathcal{H}}\frac{1}{N}\sum_{i=1}^{N}\left(f(x_i)-y_i\right)^2\tag{3-3}f^=argf∈HminN1i=1∑N(f(xi)−yi)2(3-3)
样本点固定,只改多项式的阶次,结果分成两类。
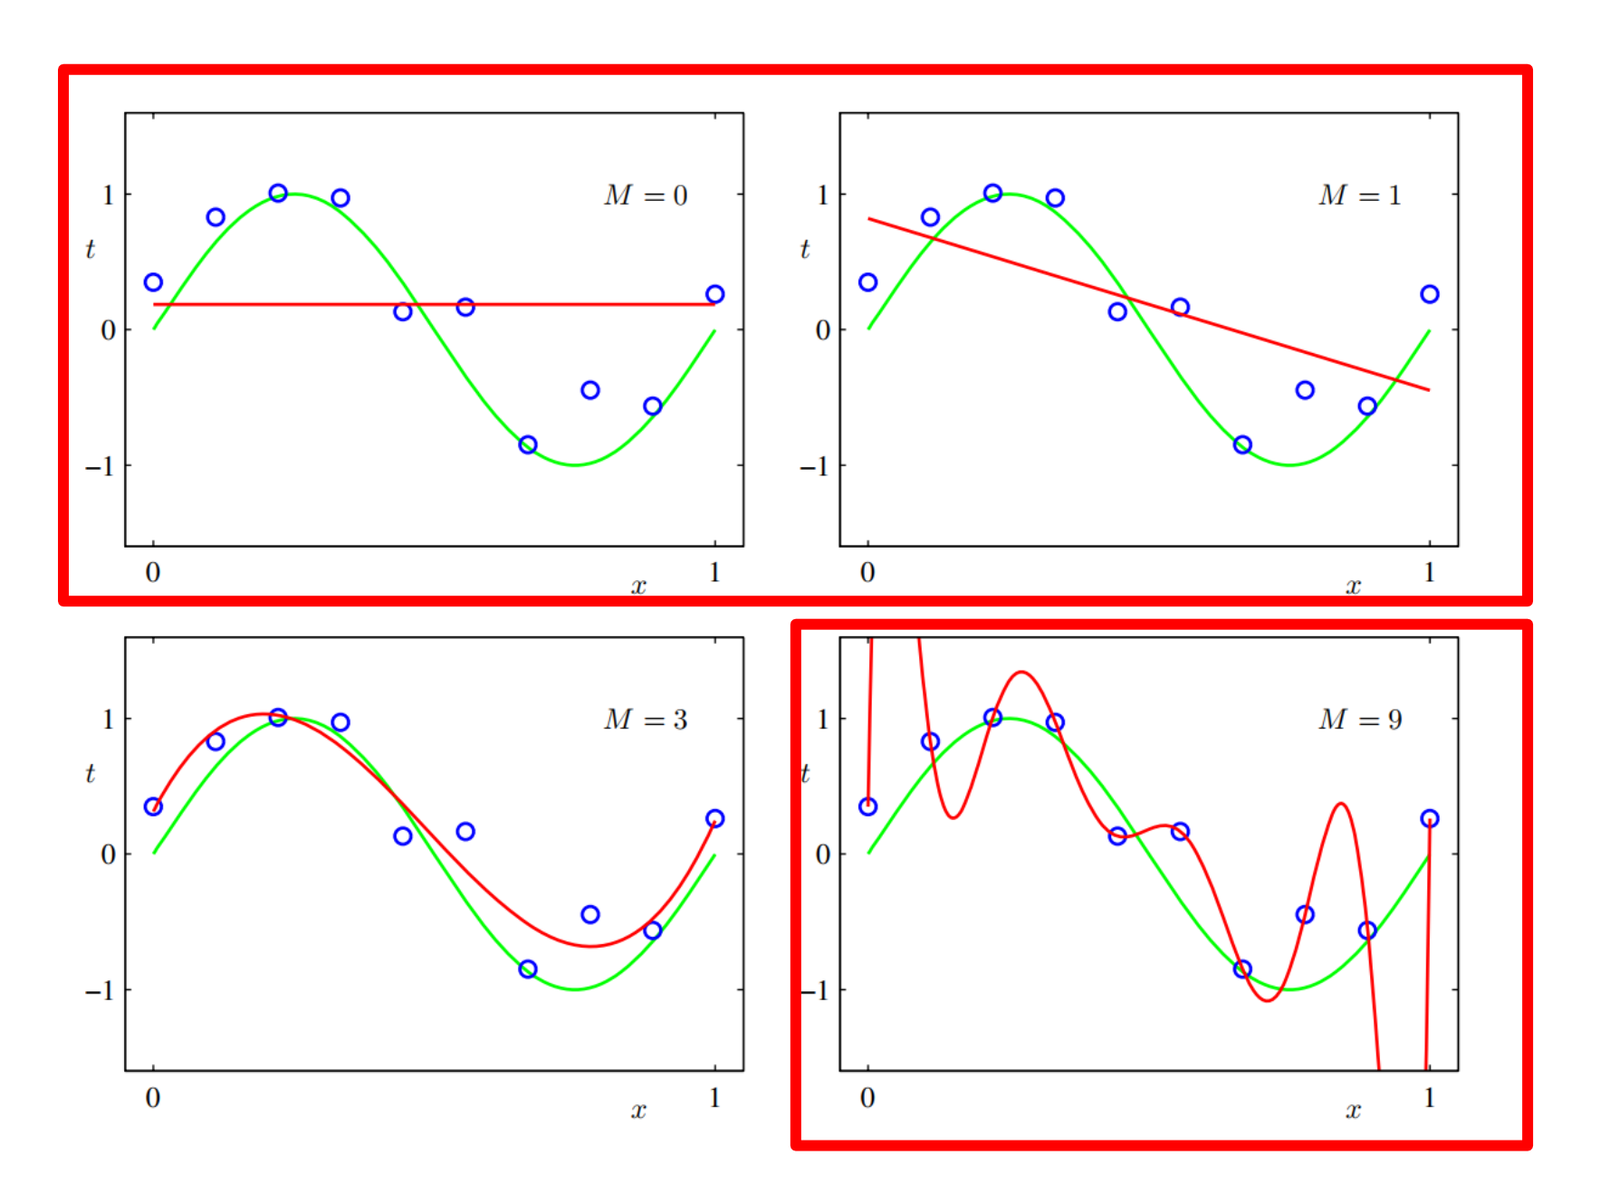
M=0M=0M=0 时假设空间里只有常数,拟合结果是一条水平线;M=1M=1M=1 是一条直线;M=3M=3M=3 基本跟住了绿色曲线的起伏;M=9M=9M=9 能穿过大部分训练点,但在两端和中间剧烈摆动。
前两种情况叫欠拟合:模型不够复杂,无法捕获数据中的模式,训练损失(经验风险)很大。M=9M=9M=9 是过拟合:训练损失非常小,模型却没有学到真实的模式。
3.4 两类现象怎么分辨
欠拟合容易判断,看训练损失就够了。训练损失降不下来,说明假设空间的容量不够,处理办法是扩大假设空间,把模型放复杂。
过拟合麻烦得多。训练损失小这件事,真正学到模型的解和过拟合的解都有,只看训练集分不出来。要判断是哪种,需要一个不依赖训练集、在所有可能数据上衡量的指标。
3.5 期望损失与泛化差距
期望损失,也叫期望风险,定义在所有可能的数据上:
R(f)=E(x,y)∼μℓ(f(x),y)(3-4)R(f)=\mathbb E_{(x,y)\sim\mu}\left\\ell(f(x),y)\\right\tag{3-4}R(f)=E(x,y)∼μℓ(f(x),y)(3-4)
它衡量模型在所有可能数据上的性能,而不只看训练数据,这才是学习真正想优化的目标。
有了它,过拟合就有了可度量的形式,也就是泛化差距 R(f)−R^(f)R(f)-\hat{R}(f)R(f)−R^(f),也就是式(3-4)减去式(3-3)那个训练集上的经验风险。
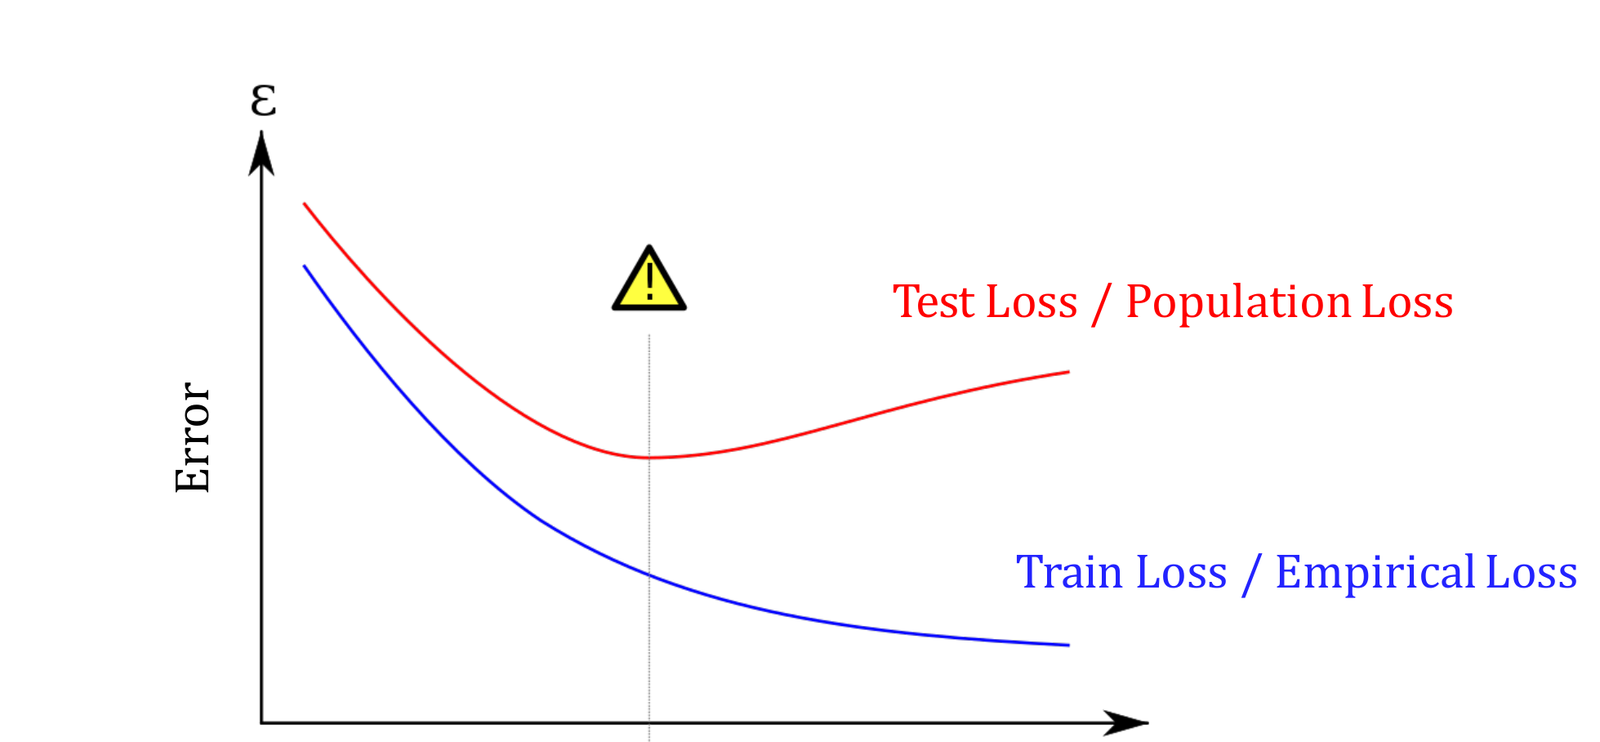
横轴是模型复杂度,蓝色曲线是训练损失,红色曲线是测试损失。训练损失单调下降,测试损失先降后升,两条线在右侧越分越开。训练损失降、测试损失升,就是过拟合在曲线上的样子。
3.6 偏差与方差
模型学习里有两个概念。
偏差表示学习到的模型在所有可能数据集上的期望性能与真实函数之间的差异程度。方差表示训练数据变化时模型性能的变化程度,也就是模型对数据随机性的敏感程度。
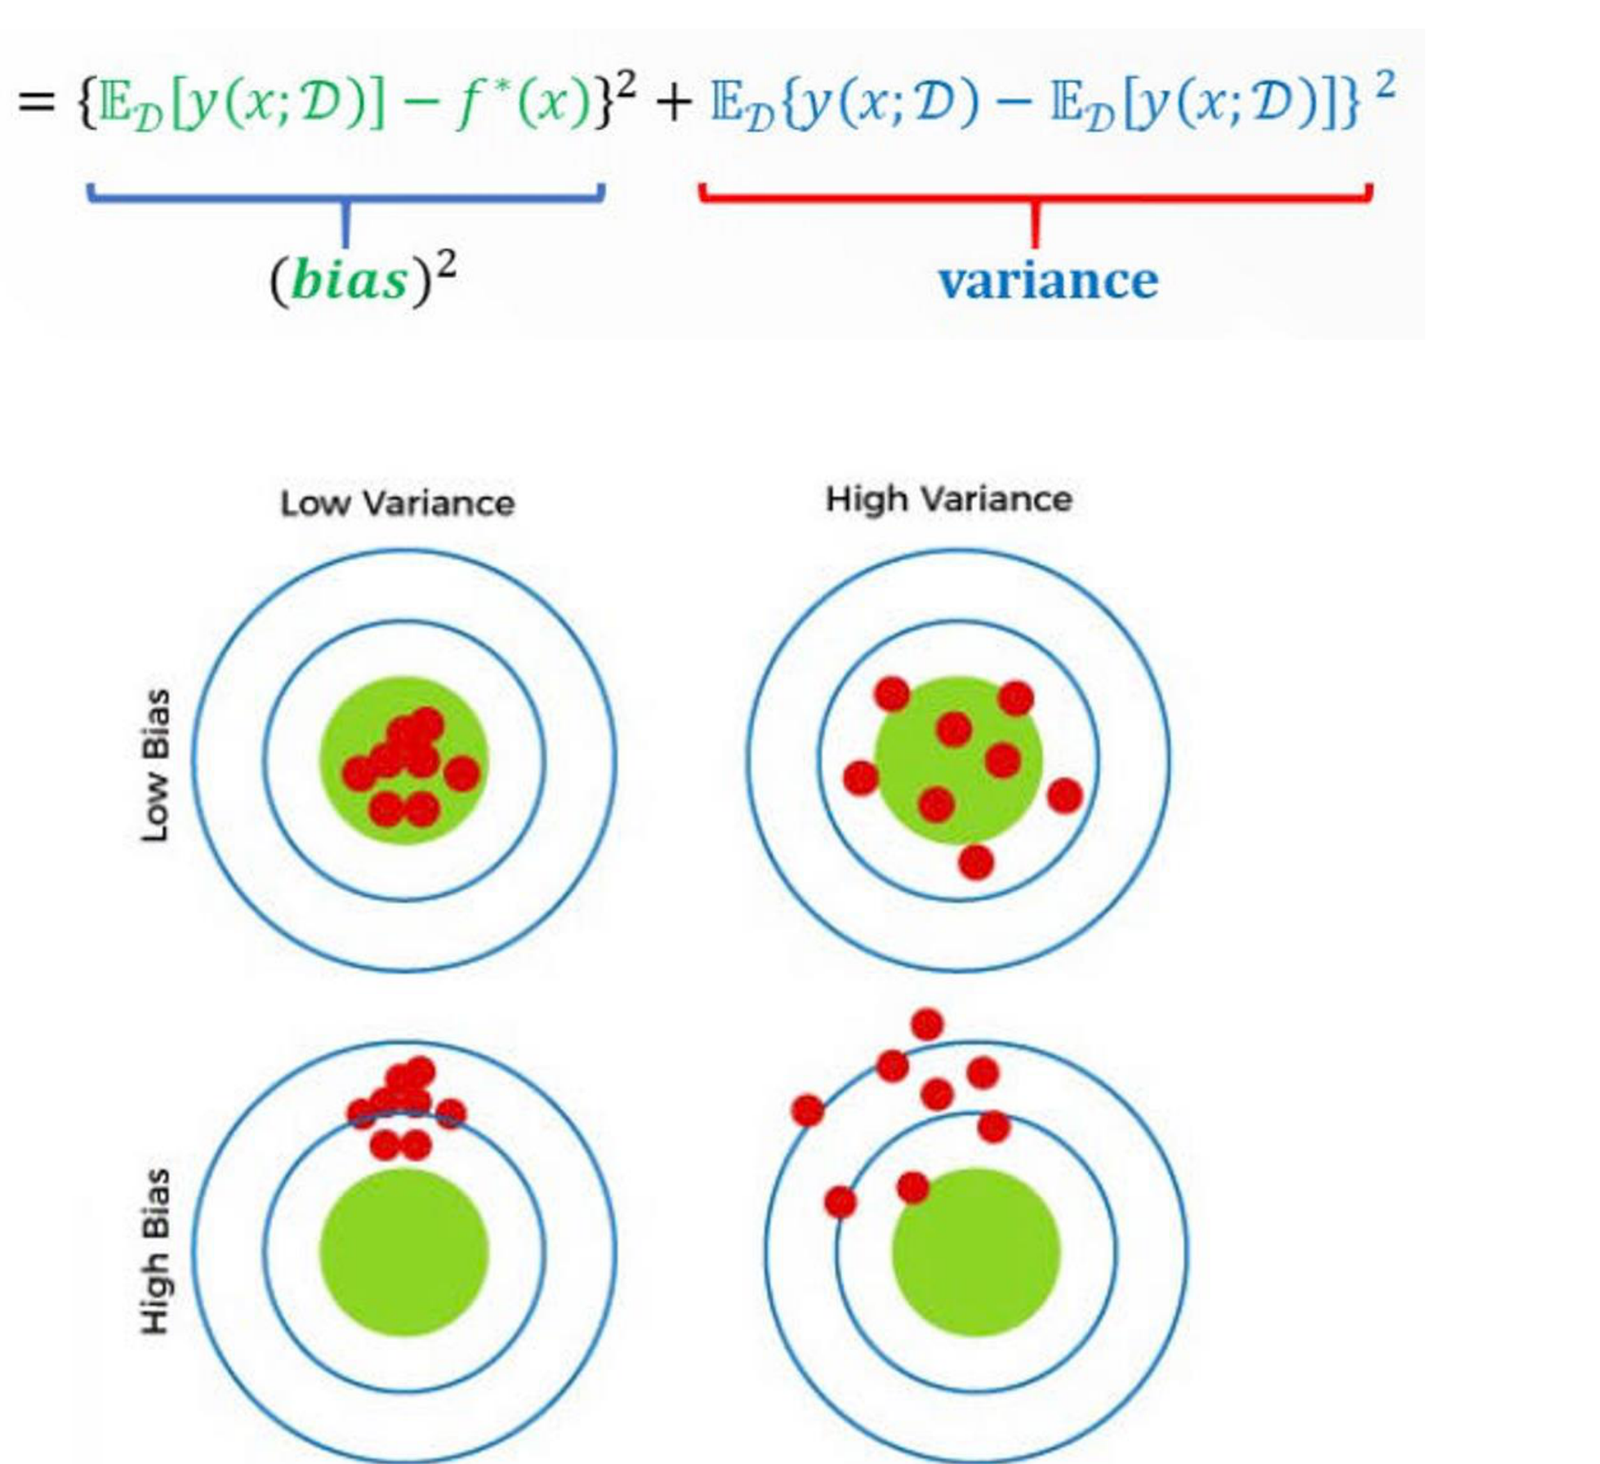
偏差小、方差小是理想的情形,模型既跟住了真实函数,又对数据扰动不敏感。偏差小、方差大是过拟合,模型学到了真实形状,同时被噪声带着走。偏差大、方差小是欠拟合。偏差大、方差大最麻烦,假设空间里选的模型类型本身就不对,再怎么调也学不好。
两者之间存在内在矛盾。数据采集由于噪声的存在带有随机性。复杂模型灵活,偏差小,但数据集里任何一个点变动,模型的形状就跟着变,方差大,容易被噪声影响。简单模型稳,方差小,但对数据模式的表达能力有限,偏离真实函数,偏差大。一边压下去,另一边就抬起来。
3.7 偏差-方差分解
这个矛盾可以写成一个等式。设真实函数为 f∗f^\astf∗,数据分布为 μ\muμ,算法 A\mathcal{A}A 从假设空间 H\mathcal{H}H 学习,把学到的模型在输入 xxx 上的输出简记作 yyy,完整的写法是 y=y(x;D)y=y(x;\mathcal{D})y=y(x;D),它随所抽到的数据集而变。关心的是它对任意 xxx 的估计误差。
先把误差平方里的 yyy 减去再补回它在所有数据集上的期望:
y−f∗(x)2={y−EDy+EDy−f∗(x)}2(3-5)\lefty-f\^\\ast(x)\\right^2=\left\lbrace y-\mathbb E_{\mathcal{D}}y+\mathbb E_{\mathcal{D}}y-f^\ast(x)\right\rbrace^2\tag{3-5}y−f∗(x)2={y−EDy+EDy−f∗(x)}2(3-5)
按平方展开,得到三项:
{y−EDy}2+{EDy−f∗(x)}2−2{y−EDy}{EDy−f∗(x)}(3-6)\left\lbrace y-\mathbb E_{\mathcal{D}}y\right\rbrace^2+\left\lbrace \mathbb E_{\mathcal{D}}y-f^\ast(x)\right\rbrace^2-2\left\lbrace y-\mathbb E_{\mathcal{D}}y\right\rbrace\left\lbrace \mathbb E_{\mathcal{D}}y-f^\ast(x)\right\rbrace\tag{3-6}{y−EDy}2+{EDy−f∗(x)}2−2{y−EDy}{EDy−f∗(x)}(3-6)
对所有可能的数据集 D\mathcal{D}D 取期望,最后一项为零,剩下两项:
ED{y−EDy}2+{EDy−f∗(x)}2(3-7)\mathbb E_{\mathcal{D}}\left\lbrace y-\mathbb E_{\mathcal{D}}y\right\rbrace^2+\left\lbrace \mathbb E_{\mathcal{D}}y-f^\ast(x)\right\rbrace^2\tag{3-7}ED{y−EDy}2+{EDy−f∗(x)}2(3-7)
再把两边对 xxx 按密度 p(x)p(x)p(x) 积分,就得到偏差与方差各自的完整形式:
(bias)2=∫{EDy−f∗(x)}2p(x)dx(3-8)(\mathrm{bias})^2=\int\left\lbrace \mathbb E_{\mathcal{D}}y-f^\ast(x)\right\rbrace^2p(x)dx\tag{3-8}(bias)2=∫{EDy−f∗(x)}2p(x)dx(3-8)
variance=∫ED{y−EDy}2p(x)dx(3-9)\mathrm{variance}=\int\mathbb E_{\mathcal{D}}\left\lbrace y-\mathbb E_{\mathcal{D}}y\right\rbrace^2p(x)dx\tag{3-9}variance=∫ED{y−EDy}2p(x)dx(3-9)
于是
R(f)=(bias)2+variance(3-10)R(f)=(\mathrm{bias})^2+\mathrm{variance}\tag{3-10}R(f)=(bias)2+variance(3-10)
偏差项度量的是估计出来的模型偏离真实函数 f∗f^\astf∗ 的误差的期望,方差项描述的是模型对数据集随机性的敏感程度。
这个分解给出一条操作上的指向:想减偏差,就从较大的假设空间 H\mathcal{H}H 里选复杂模型;想减方差,就优先选简单函数空间中的平滑模型。
3.8 三种权衡办法
在一个偏差更大的估计和一个方差更大的估计之间怎么选,实际用的是三种办法。
第一种是交叉验证。把数据分成训练集和测试集,把阶次从 0 到 9 各跑一遍,分别算出两边的误差,画成一张图。
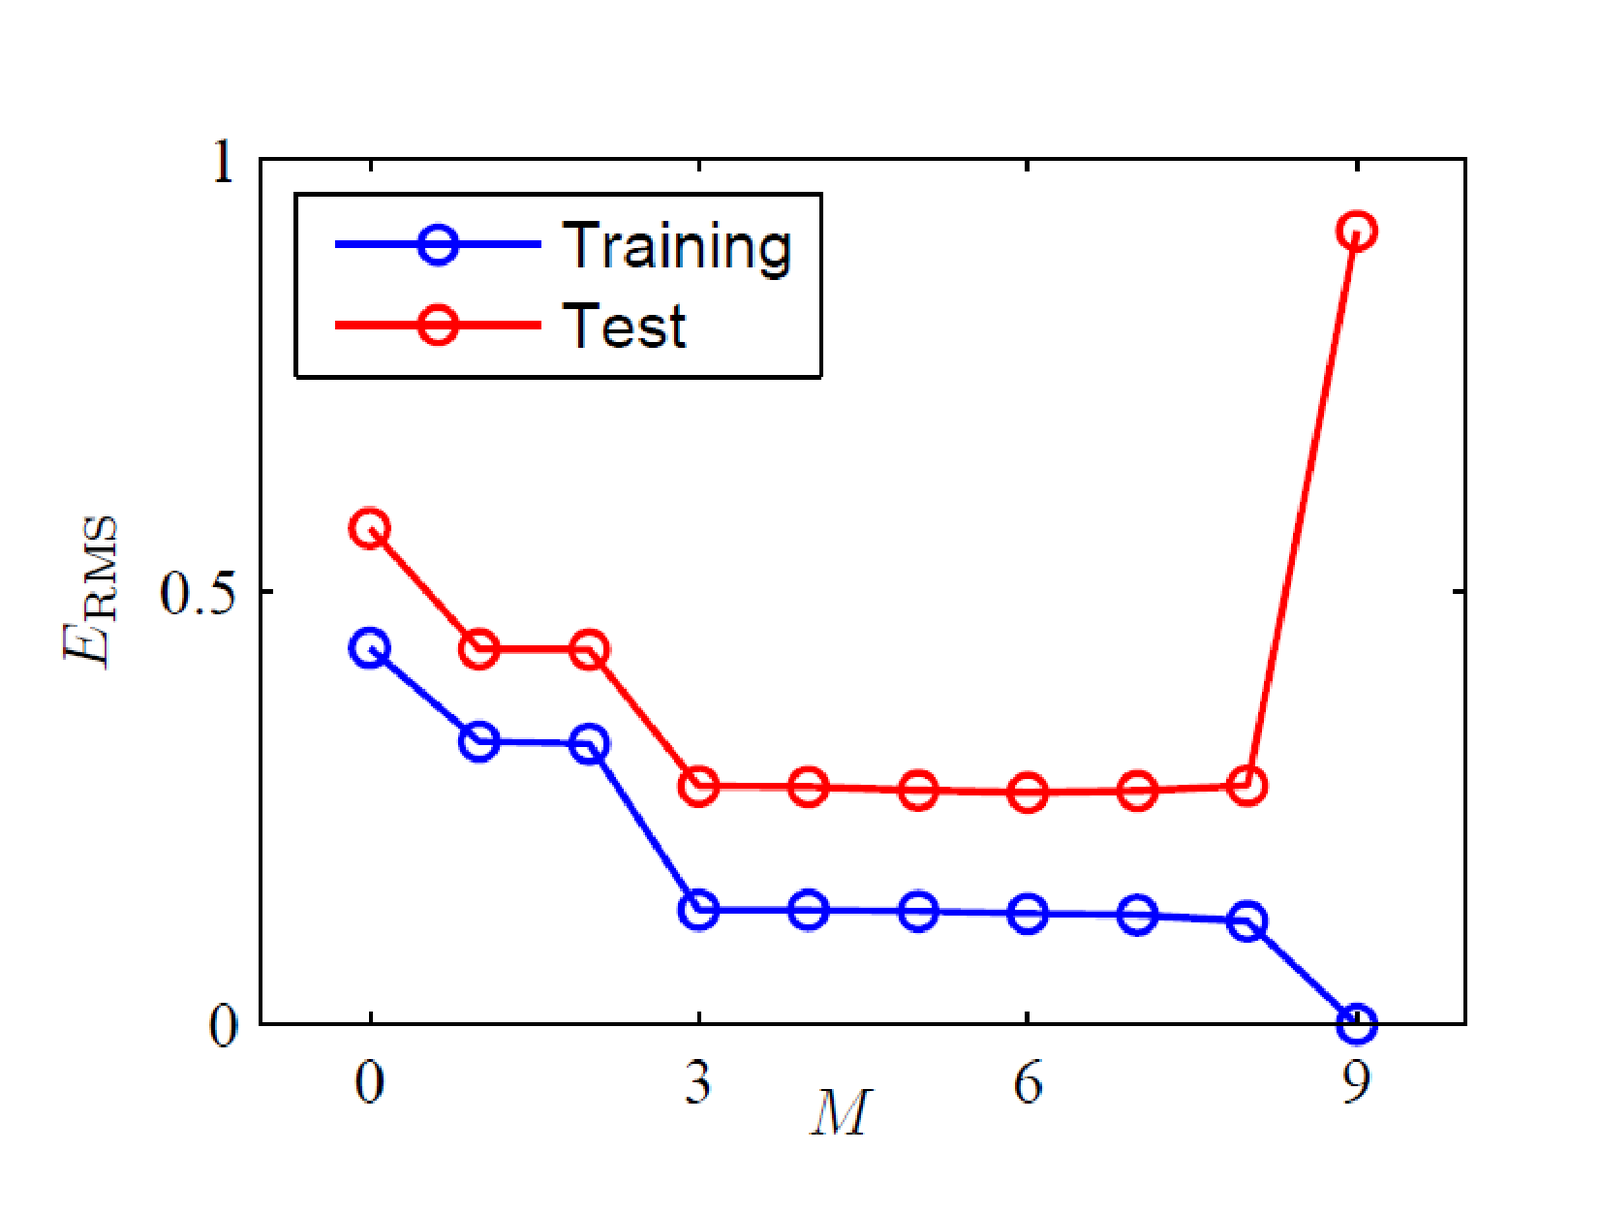
测试误差在 M=3M=3M=3 到 M=6M=6M=6 之间比较平坦,M=9M=9M=9 陡然上升,说明阶次太高已经过拟合。挑选的时候会偏向偏小的那个,比如 M=3M=3M=3。依据是一条通行的原则,在表现相当的情况下选简单的模型,也就是奥卡姆剃刀。
第二种是正则化,直接修改学习算法。在损失函数上加一项对权重的惩罚:
R^=ℓ(y,y^)+λ∥w∥p(3-11)\hat{R}=\ell(y,\hat{y})+\lambda\lVert \boldsymbol{w}\rVert_p\tag{3-11}R^=ℓ(y,y^)+λ∥w∥p(3-11)
按 ppp 的取法分 L0L_0L0、L1L_1L1、L2L_2L2 以及混合几种,混合的写法是把 L1L_1L1 和 L2L_2L2 两项一起加上去。实际中最常用的是 L2L_2L2,把曲线拟合带进去,目标函数写成
R^=12∑i=1N(f(xi,w)−yi)2+λ∥w∥2(3-12)\hat{R}=\frac{1}{2}\sum_{i=1}^{N}\left(f(x_i,\boldsymbol{w})-y_i\right)^2+\lambda\lVert \boldsymbol{w}\rVert^2\tag{3-12}R^=21i=1∑N(f(xi,w)−yi)2+λ∥w∥2(3-12)
其中权重向量的二范数是所有权重分量的平方和:
∥w∥2=wTw=w02+w12+⋯+wM2(3-13)\lVert \boldsymbol{w}\rVert^2=\boldsymbol{w}^T\boldsymbol{w}=w_0^2+w_1^2+\cdots+w_M^2\tag{3-13}∥w∥2=wTw=w02+w12+⋯+wM2(3-13)
惩罚项限制权重不要太大。权重大意味着函数在样本点之间拐得厉害;把权重压小,函数就被压得平缓,模型也就不那么复杂。取 M=9M=9M=9 拟合同一组数据,λ\lambdaλ 取 0 就是原来那个过拟合的结果;λ\lambdaλ 增大以后惩罚变重,模型被压得过于简单,转为欠拟合;中间存在一个合适的位置。把拟合误差与 lnλ\ln\lambdalnλ 的关系画出来,也能看到同一件事:lnλ\ln\lambdalnλ 太小的一侧是过拟合,太大的一侧是欠拟合。
正则化减少的是方差,因此降低的是泛化误差,而不是训练误差。这跟交叉验证的区别也在这里,交叉验证是在多个模型里挑一个,正则化改的是学习算法本身。
这一部分还有两条与前面方法呼应的结论:用最小二乘求模型参数是最大似然的一个特例;用贝叶斯参数估计可以避免过拟合,因为先验信息被引了进来,缺样本的位置由先验补上,相当于在目标函数里多出一项正则项。
第三种是增加样本数。同样用 M=9M=9M=9 的多项式,把样本从 15 个增到 100 个,原本在两端剧烈摆动的曲线被压回合理形状,过拟合随之缓解。
3.9 三个判断
同样的道理可以搬到日常场景里。足球运动员为备战只反复练射门,射门这一项练得很好,传球、跑位这些训练集之外的情形就应付不了,这是过拟合。修车师傅跟着师傅在各种实际故障场景里学三年,见过的故障类型足够杂,遇到新的故障也修得好,泛化能力就强。考前拼命刷题,只在刷过的题型上表现好,考题一变就露馅,同样是过拟合。
四、线性判别函数
4.1 换一个提问方式
前面三节说明了一件事:在特征维数高、样本又少的情况下,把概率密度函数估准并不容易。
但模式识别的目的本身不是估计概率密度,而是在特征空间里找到两类或多类之间的决策面。只要决策面找对了,分类也就对了。于是就有一个新问题:不去估计概率密度,能不能直接利用样本把分类器设计出来?
从线性分类器入手。它形式简单,容易分析,而且后面讲的感知器和 Logistic 回归都建立在同一套基本概念上。
4.2 线性判别函数与决策面
线性判别函数取线性形式:
g(x)=wTx+w0(4-1)g(\boldsymbol{x})=\boldsymbol{w}^T\boldsymbol{x}+w_0\tag{4-1}g(x)=wTx+w0(4-1)
w\boldsymbol{w}w 是权向量,w0w_0w0 是常数偏置项。两类的情形下,取 g(x)=g1(x)−g2(x)g(\boldsymbol{x})=g_1(\boldsymbol{x})-g_2(\boldsymbol{x})g(x)=g1(x)−g2(x)。
判别函数等于 0 的地方就是决策面。g(x)>0g(\boldsymbol{x})>0g(x)>0 判第一类,g(x)<0g(\boldsymbol{x})<0g(x)<0 判第二类。用头发长度和喉结尺寸这两个特征区分性别,两类的点各自聚成一簇,中间那条把平面分成两半的直线就是决策面,落在直线上的点满足判别函数为零。
决策面有一个性质,后面推导距离时要用。在决策面上任取两点 x1\boldsymbol x_1x1、x2\boldsymbol x_2x2,两者都满足判别函数为零,于是
wTx1+w0=wTx2+w0⇒wT(x1−x2)=0(4-2)\boldsymbol{w}^T\boldsymbol x_1+w_0=\boldsymbol{w}^T\boldsymbol x_2+w_0\Rightarrow\boldsymbol{w}^T(\boldsymbol x_1-\boldsymbol x_2)=0\tag{4-2}wTx1+w0=wTx2+w0⇒wT(x1−x2)=0(4-2)
x1−x2\boldsymbol x_1-\boldsymbol x_2x1−x2 是决策面内任意方向的向量,它与 w\boldsymbol{w}w 的内积恒为零,所以权向量 w\boldsymbol{w}w 与决策面垂直。
4.3 点到决策面的距离
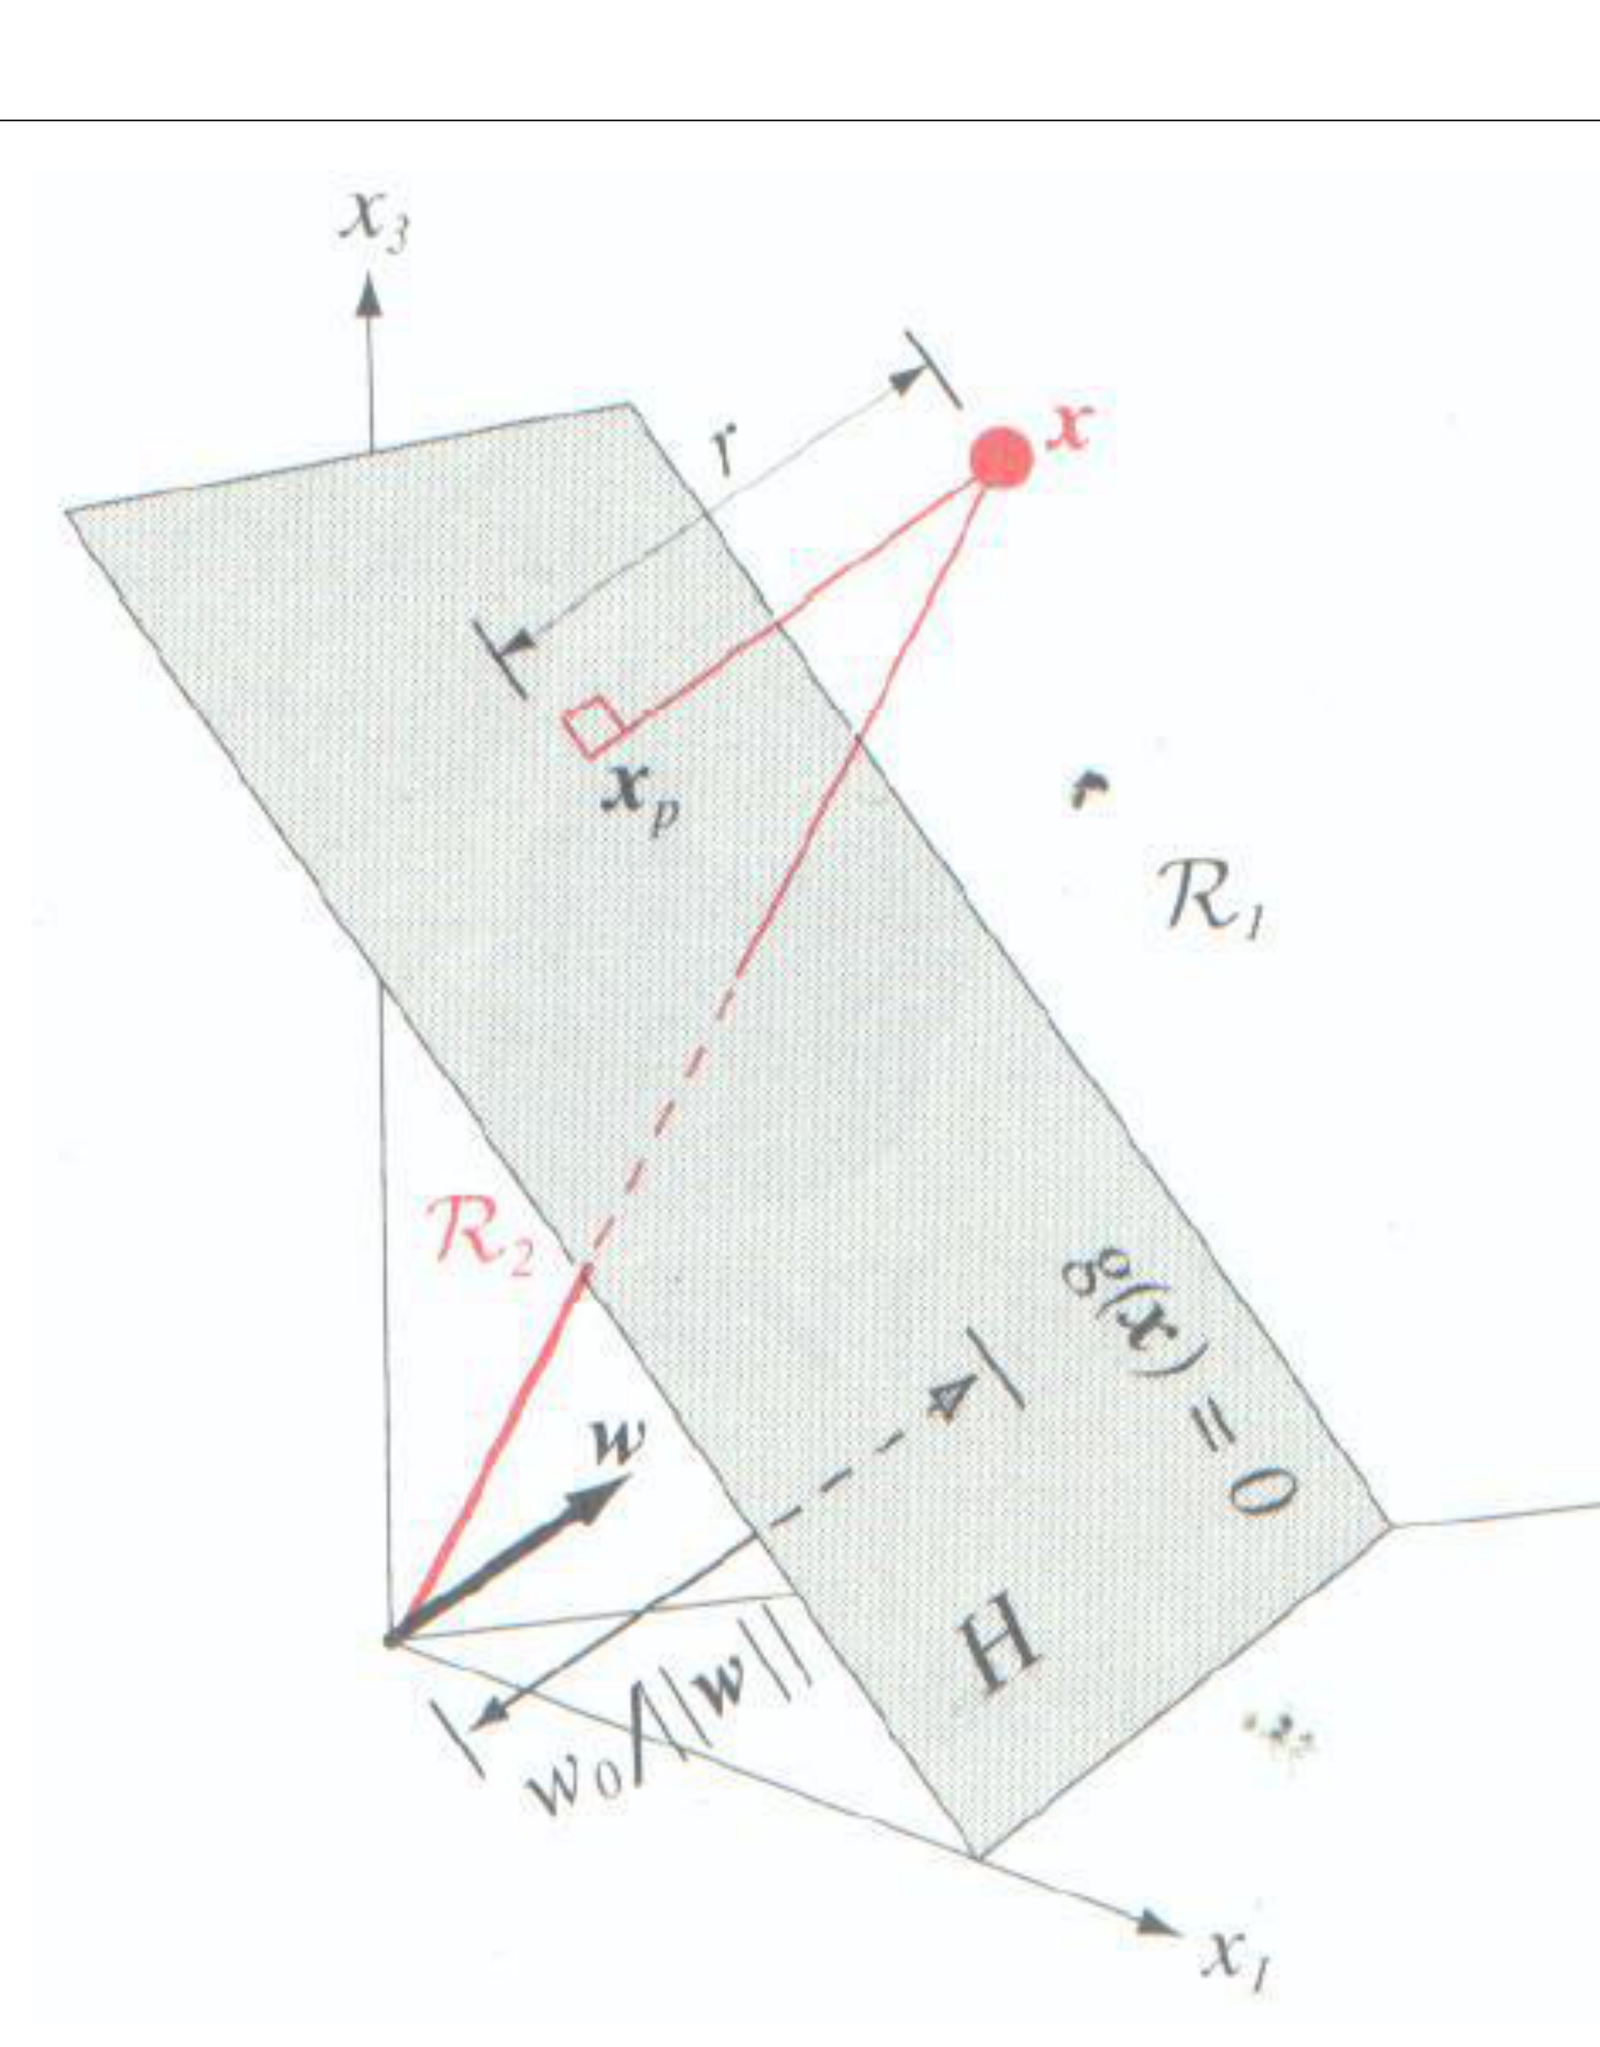
图源:R. O. Duda, P. E. Hart, D. G. Stork,Pattern Classification(第 2 版),Wiley,2001。
任取一个样本 x\boldsymbol{x}x,把它写成垂足加上沿法向的一段:
x=xp+rw∥w∥(4-3)\boldsymbol{x}=\boldsymbol x_p+r\frac{\boldsymbol{w}}{\lVert \boldsymbol{w}\rVert}\tag{4-3}x=xp+r∥w∥w(4-3)
其中 xp\boldsymbol x_pxp 是 x\boldsymbol{x}x 在决策面上的垂足,rrr 是待求的距离。代入判别函数:
g(x)=wTxp+w0+rwTw∥w∥(4-4)g(\boldsymbol{x})=\boldsymbol{w}^T\boldsymbol x_p+w_0+r\frac{\boldsymbol{w}^T\boldsymbol{w}}{\lVert \boldsymbol{w}\rVert}\tag{4-4}g(x)=wTxp+w0+r∥w∥wTw(4-4)
xp\boldsymbol x_pxp 落在决策面上,所以 wTxp+w0=0\boldsymbol{w}^T\boldsymbol x_p+w_0=0wTxp+w0=0;又有 wTw=∥w∥2\boldsymbol{w}^T\boldsymbol{w}=\lVert \boldsymbol{w}\rVert^2wTw=∥w∥2,代入后只剩中间那一项:
r=g(x)∥w∥(4-5)r=\frac{g(\boldsymbol{x})}{\lVert \boldsymbol{w}\rVert}\tag{4-5}r=∥w∥g(x)(4-5)
任何一个样本到决策面的距离,等于它的判别函数值除以权向量的模,见式(4-5)。判别函数的绝对值越大,样本离决策面越远,也就越容易区分。这个关系在感知器的更新规则里会直接用到。
4.4 增广向量
为了把常数项和权向量写在一起,定义增广样本向量 x^=1,xTT\hat{\boldsymbol{x}}=\left1,\\boldsymbol{x}\^T\\right^Tx^=1,xTT 与增广权向量 w^=w0,wTT\hat{\boldsymbol{w}}=\leftw_0,\\boldsymbol{w}\^T\\right^Tw^=w0,wTT,于是
g(x)=w0+wTx≜w^Tx^(4-6)g(\boldsymbol{x})=w_0+\boldsymbol{w}^T\boldsymbol{x}\triangleq\hat{\boldsymbol{w}}^T\hat{\boldsymbol{x}}\tag{4-6}g(x)=w0+wTx≜w^Tx^(4-6)
后面的写法里如果没有特别说明,w\boldsymbol{w}w 和 x\boldsymbol{x}x 都指增广后的向量。
五、感知器
5.1 模型
感知器处理二分类问题。给定独立同分布采样得到的训练数据 (xi,yi)(\boldsymbol x_i,y_i)(xi,yi),其中 1≤i≤N1\le i\le N1≤i≤N,它的判别函数取
fw(x)=wTx(5-1)f_{\boldsymbol{w}}(\boldsymbol{x})=\boldsymbol{w}^T\boldsymbol{x}\tag{5-1}fw(x)=wTx(5-1)
标签取 +1+1+1 与 −1-1−1:wTx>0\boldsymbol{w}^T\boldsymbol{x}>0wTx>0 时取 +1+1+1,wTx<0\boldsymbol{w}^T\boldsymbol{x}<0wTx<0 时取 −1-1−1,预测时按 y=sign(fw(x))y=\mathrm{sign}\left(f_{\boldsymbol{w}}(\boldsymbol{x})\right)y=sign(fw(x)) 决策。
感知器在历史上的分量不在形式,而在于它是第一个能从数据里自动学出权重的分类器。在这之前,权重都是人为设定的。
5.2 规范化与解区域
直接拿分类错误率当目标函数不好优化,因为错误率随 w\boldsymbol{w}w 变化是不连续的。换一个写法,把第一类的样本向量取负、第二类保持不变:xi′=−xi\boldsymbol x_i'=-\boldsymbol x_ixi′=−xi 当 xi∈ω1\boldsymbol x_i\in\omega_1xi∈ω1,xi′=xi\boldsymbol x_i'=\boldsymbol x_ixi′=xi 当 xi∈ω2\boldsymbol x_i\in\omega_2xi∈ω2。
这样一来,对每一个被正确分类的样本 iii,都有
wTxi′>0(5-2)\boldsymbol{w}^T\boldsymbol x_i'>0\tag{5-2}wTxi′>0(5-2)
两类样本的判定条件合并成了同一个不等式,这个操作叫规范化。满足 wTxi′>0\boldsymbol{w}^T\boldsymbol x_i'>0wTxi′>0 的每一个权向量 w∗\boldsymbol w^\astw∗ 叫解向量,所有解向量构成的区域叫解区域。
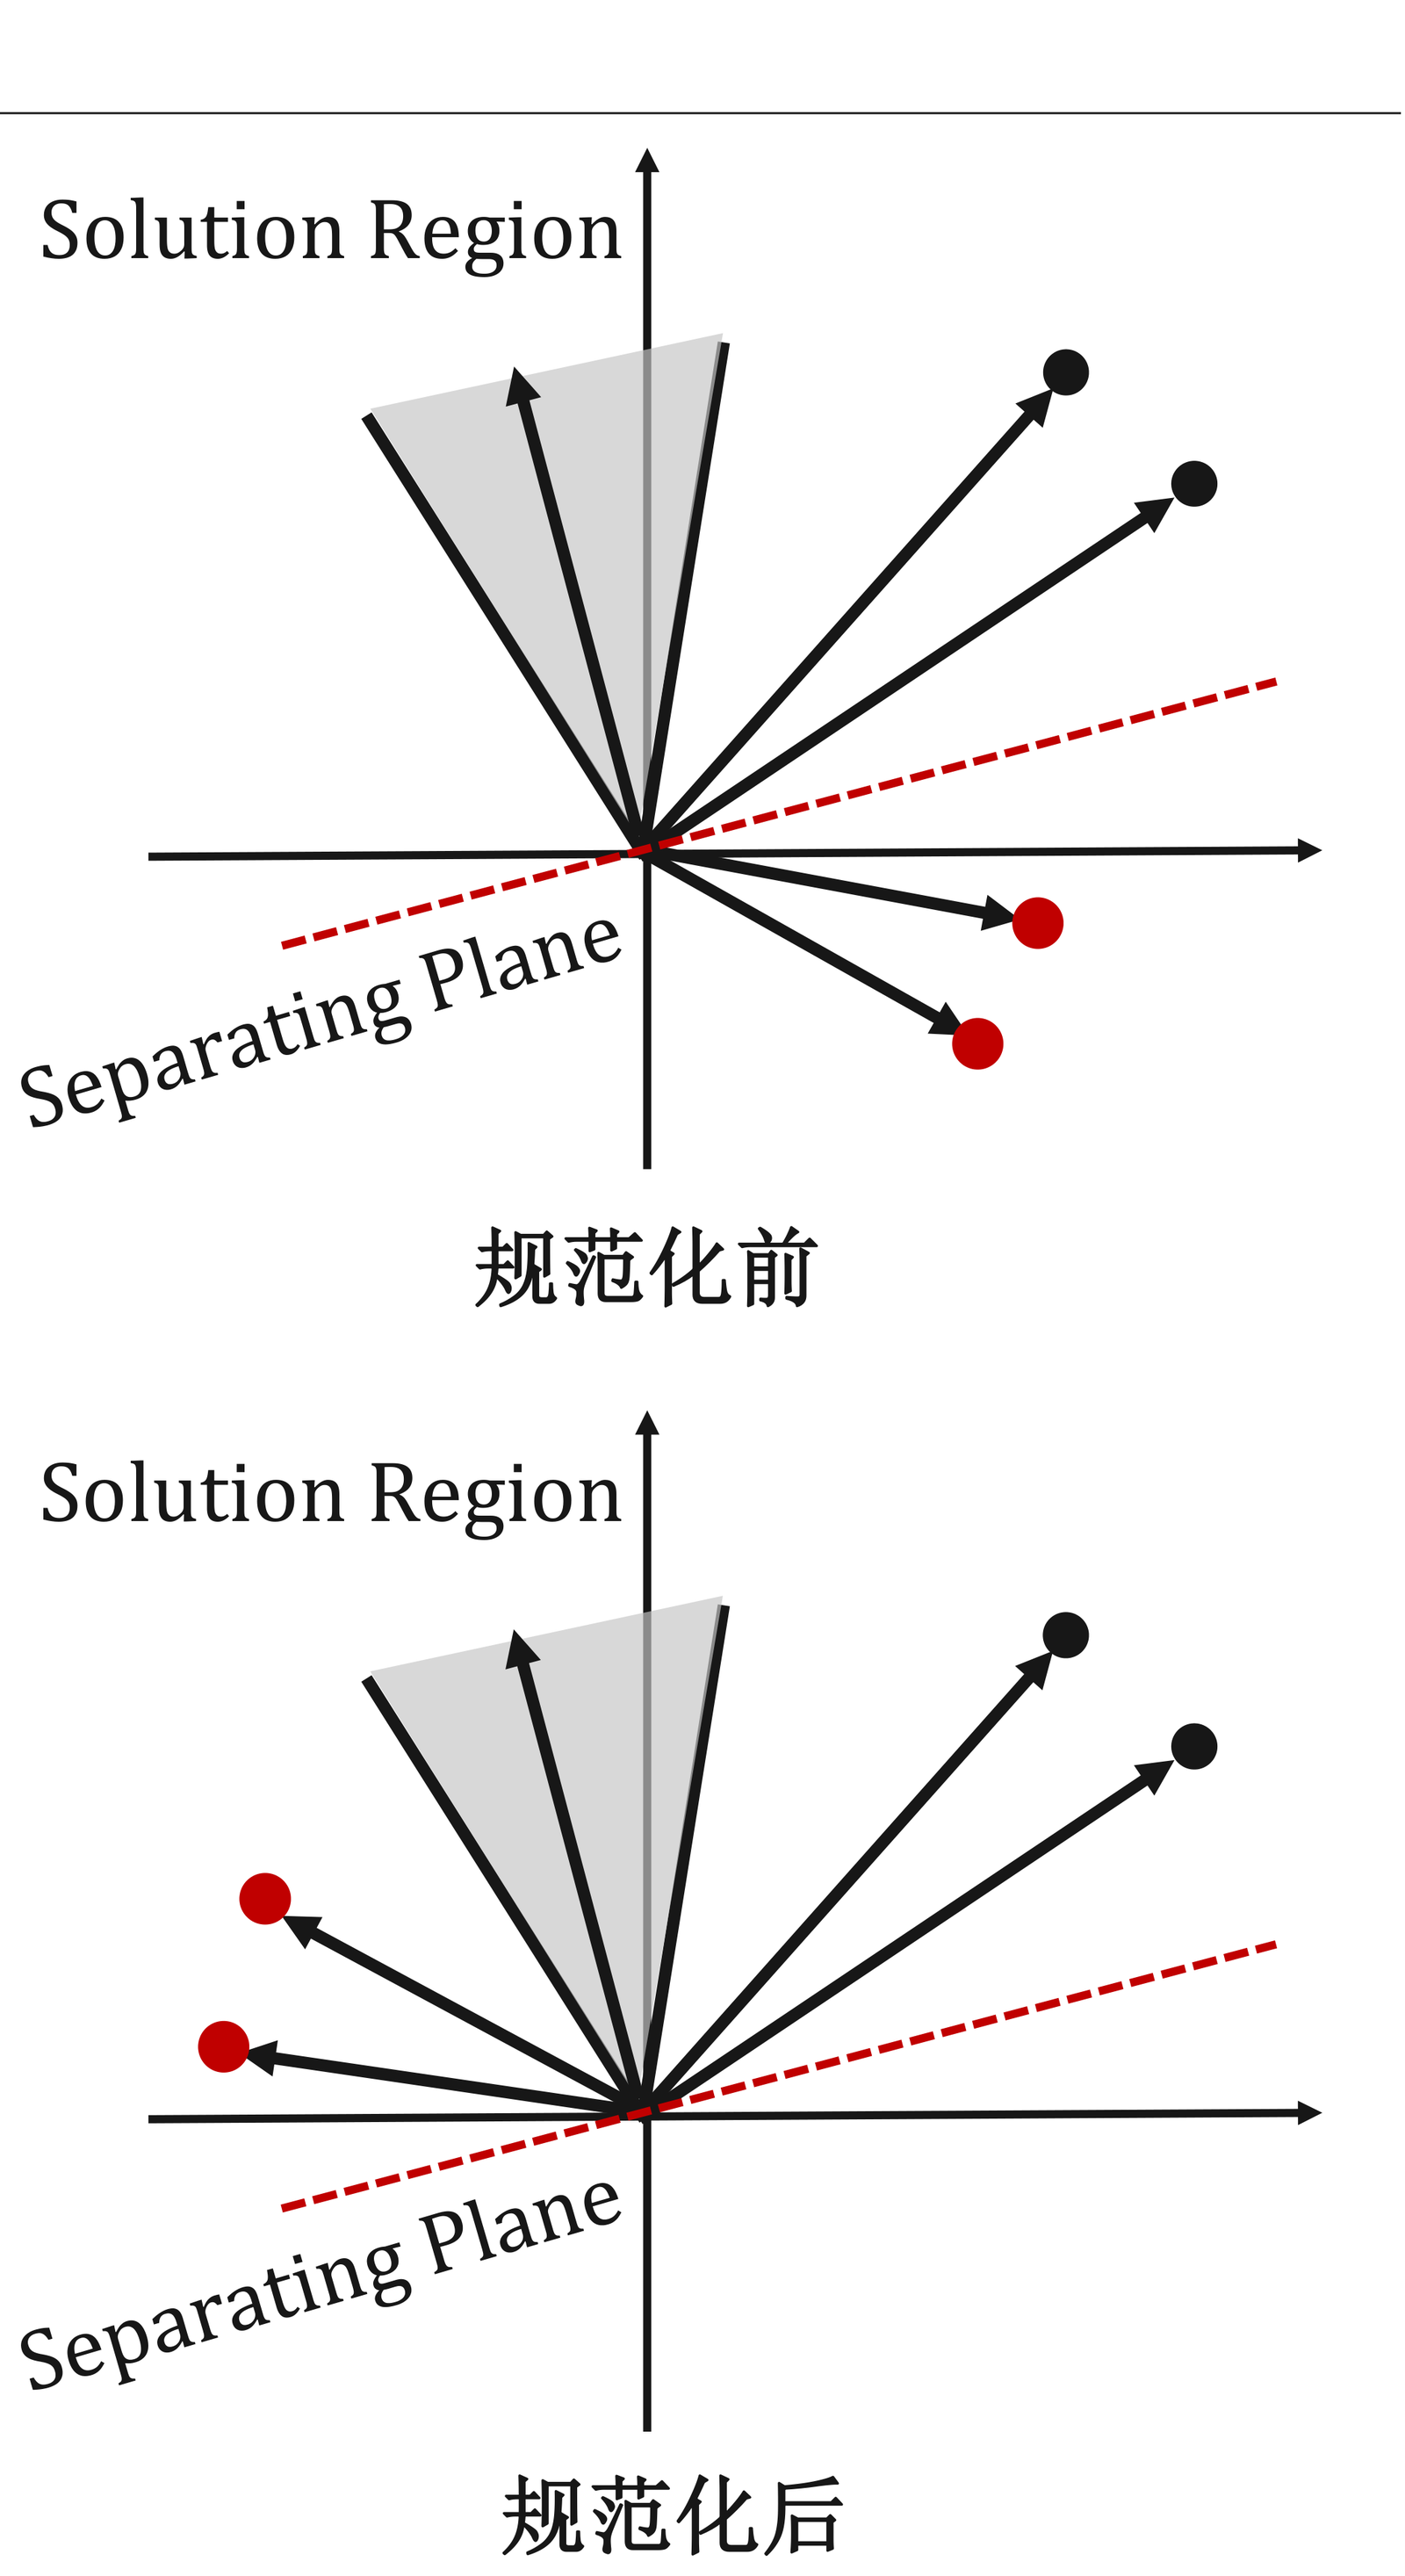
规范化之前,第一类的向量指向一侧、第二类的指向另一侧,解区域是过原点张开的一个楔形。规范化之后,第一类向量被取反,所有样本都落到同一侧,楔形的形状和位置都没有变。操作本身不改变解区域,只是把记法统一了。
5.3 感知器准则
有了规范化,感知器的目标可以写成一个准则函数:
Jp(w)=∑xi∈Xk(−wTxi′)(5-3)J_p(\boldsymbol{w})=\sum_{\boldsymbol x_i\in\mathcal X_k}\left(-\boldsymbol{w}^T\boldsymbol x_i'\right)\tag{5-3}Jp(w)=xi∈Xk∑(−wTxi′)(5-3)
其中 Xk\mathcal X_kXk 是第 kkk 步中分类错误的样本集。对错分的样本,wTxi′<0\boldsymbol{w}^T\boldsymbol x_i'<0wTxi′<0,前面加负号以后每一项都是正数;被正确分类的样本不进入这个求和。所以式(5-3)的值就是错分程度的累加,它的最小值是 0,对应全部分类正确。感知器的目标就是让这个值最小。
5.4 梯度下降
线性可分时,找一个 w\boldsymbol{w}w 让所有样本都满足 wTxi′>0\boldsymbol{w}^T\boldsymbol x_i'>0wTxi′>0,等价于让 JpJ_pJp 取到最小值 0。这个目标函数无约束而且可微,用梯度下降求解:
∇Jp=∂Jp(w)∂w=∑xi∈Xk(−xi′)(5-4)\nabla J_p=\frac{\partial J_p(\boldsymbol{w})}{\partial \boldsymbol{w}}=\sum_{\boldsymbol x_i\in\mathcal X_k}\left(-\boldsymbol x_i'\right)\tag{5-4}∇Jp=∂w∂Jp(w)=xi∈Xk∑(−xi′)(5-4)
按梯度下降的更新式 w(k+1)=w(k)−ρk∇Jp\boldsymbol{w}(k+1)=\boldsymbol{w}(k)-\rho_k\nabla J_pw(k+1)=w(k)−ρk∇Jp,把上面这个梯度代进去:
w(k+1)=w(k)+ρk∑xi∈Xkxi′(5-5)\boldsymbol{w}(k+1)=\boldsymbol{w}(k)+\rho_k\sum_{\boldsymbol x_i\in\mathcal X_k}\boldsymbol x_i'\tag{5-5}w(k+1)=w(k)+ρkxi∈Xk∑xi′(5-5)
每一步把当前权向量加上所有错分样本向量之和的一个倍数。加法的方向正是让错分样本的判别函数值变大的方向,与降低准则函数的目标一致。ρk\rho_kρk 是步长,也叫学习率,是要事先设定的超参数。
这个更新方向为什么有效,可以盯住一个被错分的样本 xj′\boldsymbol x_j'xj′ 看。更新之后它的判别函数值变成原来的 w(k)Txj′\boldsymbol{w}(k)^T\boldsymbol x_j'w(k)Txj′ 加上 ρk∑ixi′Txj′\rho_k\sum_i\boldsymbol x_i'^T\boldsymbol x_j'ρk∑ixi′Txj′。只要其他错分样本与它方向大致一致,内积之和就是正的,判别函数值被往 0 以上推。错分样本越多、步长越大,这一步推得越远。
这里的 JpJ_pJp 是凸函数,整体是一个凸优化问题,梯度下降能收敛到全局最优,JpJ_pJp 可以降到 0。不过最优解并不唯一,解区域里的任意一个 w\boldsymbol{w}w 都是解。
5.5 收敛定理与可变步长
感知器的收敛性有一条明确的结论:如果训练数据集线性可分,感知器学习算法保证在有限步内找到精确解。
步长可以取固定的值,也可以取可变的值。一种可变的取法是
ρk=∑xi∈Xk∣w(k)Txi′∣∥xi∥2(5-6)\rho_k=\sum_{\boldsymbol x_i\in\mathcal X_k}\frac{\left|\boldsymbol{w}(k)^T\boldsymbol x_i'\right|}{\lVert \boldsymbol x_i\rVert^2}\tag{5-6}ρk=xi∈Xk∑∥xi∥2 w(k)Txi′ (5-6)
分子的绝对值衡量当前迭代离目标还有多远。偏差大的时候步长大一些,偏差小的时候步长小一些。固定步长则会遇到两难:取得小,迭代步数多;取得大,在最优点附近来回摆动,收敛不了。
5.6 单样本校正
上面每次更新都要遍历全部错分样本。还有一种做法是每次只看一个样本,按 x1,...,xN\boldsymbol x_1,\dots,\boldsymbol x_Nx1,...,xN 的顺序循环,过完一轮再从 x1\boldsymbol x_1x1 重新开始。
对当前样本 xi\boldsymbol x_ixi,目标函数退化成 Jp(w)=−wTxi′J_p(\boldsymbol{w})=-\boldsymbol{w}^T\boldsymbol x_i'Jp(w)=−wTxi′。先判断 xi\boldsymbol x_ixi 是否被正确分类:分对了就不动;分错了才按梯度下降更新,此时梯度是 −xi′-\boldsymbol x_i'−xi′,更新式变成
w(k+1)=w(k)+ρkxi′(5-7)\boldsymbol{w}(k+1)=\boldsymbol{w}(k)+\rho_k\boldsymbol x_i'\tag{5-7}w(k+1)=w(k)+ρkxi′(5-7)
把当前样本向量加到权向量上,就是把决策面朝这个样本该去的那一侧转一点。整批样本过完一轮以后还要再从头过,直到某一整轮里没有样本被分错才停。
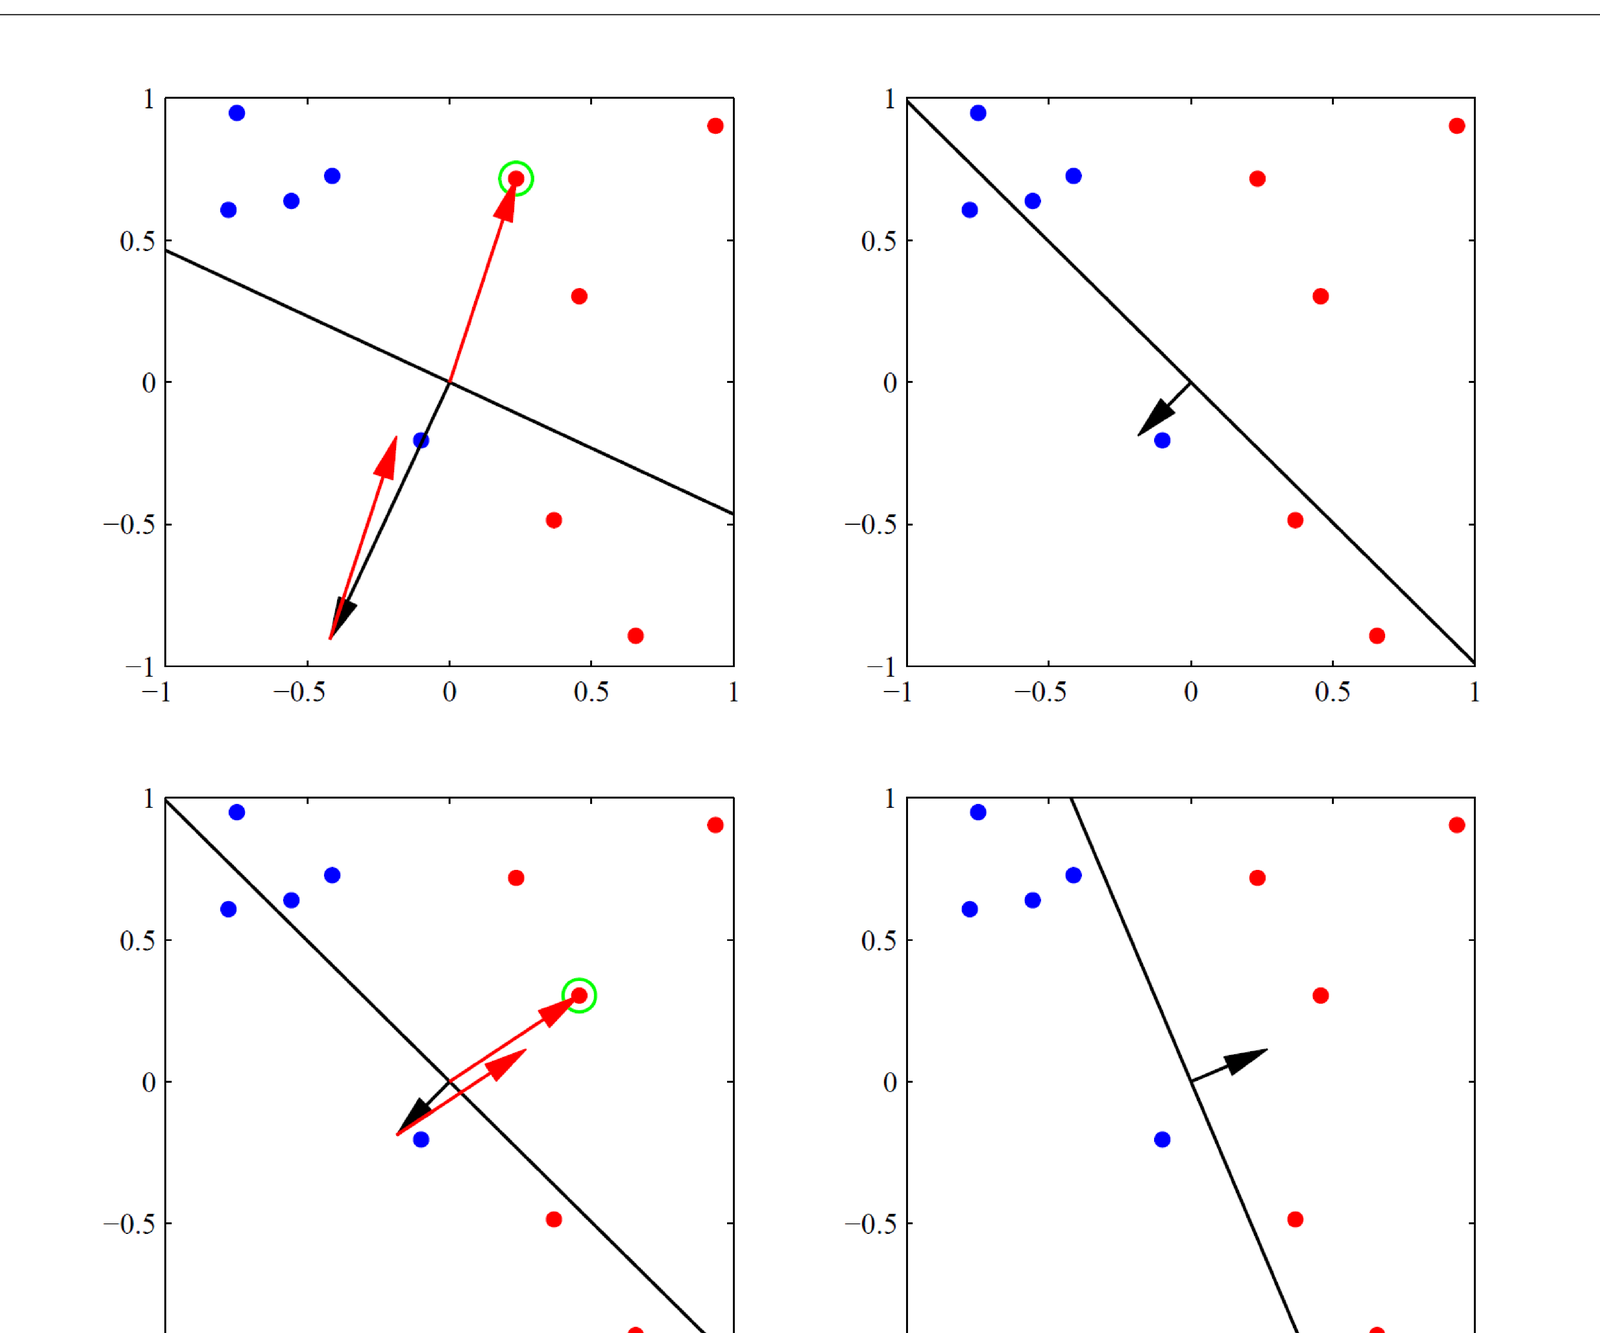
看起来一次只用一个样本,要比批量更新跑更多轮,实际并不需要。同一类的样本通常分布得比较集中,一次更新把一个错分样本拉正,往往连带把附近一批同类样本一起拉正了。
5.7 一次硬件实现
1958 年,由美国海军研究机构资助,Frank Rosenblatt 在康奈尔航空实验室建成了 Mark I 感知器。
这台机器是为图像识别设计的,用强光照射把图像采集到一个 20×20 的光电管阵列上,得到一张 400 像素的图像。接线板允许尝试输入特征的不同配置,实际接线常常是随机连的,这说明感知器的学习能力并不依赖精确的连接。每个权值用一个滑动变阻器实现,由电机驱动,按学习算法自动调节。
权重不再需要硬编码,可以从给定样本里自动学出来,这正是它当时引起轰动的地方。1958 年 7 月 8 日《纽约时报》第 25 版的报道题为 Electronic「Brain」Teaches Itself。报道里写到,海军军官在华盛顿演示这台装置时不愿意把它称作机器,因为它太像一种「没有生命的活物」;还写到它是第一台不依赖人的训练和控制就能感知、识别周围事物的非生命装置。文中引 Rosenblatt 的说法,原则上可以造出能在装配线上自我复制、并且「意识到自身存在」的感知器。
这些说法到今天都没有实现。但当时一台机器能从数据里自动学出权重,这件事情本身的分量很重。
5.8 局限
感知器的短板是清楚的。
它只能处理线性可分的情形,遇到线性不可分的两类样本,无论怎么找,都得不到一个能把两类完全分开的线性分类器。它的输出只有 ±1\pm1±1,不像贝叶斯决策那样给出概率。它也不容易推广到三类以上。即便线性可分,解也不唯一,最终收敛到解区域里的哪一个解,取决于权重的初始值和样本出现的顺序。
对应的出路有几条:允许一定的最小错误,不再要求全部分对;换非线性的方法,后面讲支持向量机时会遇到;改用它之外的多分类器,Logistic 回归就能给出概率输出;在多个解里挑一个最优的,这也是支持向量机要解决的问题。
六、Logistic 回归
6.1 从直线到 S 形曲线
线性回归处理的那种关系,最容易看懂。开车速度与刹车距离,速度越快刹车距离越远,把数据点画出来,大致落在一条直线附近。
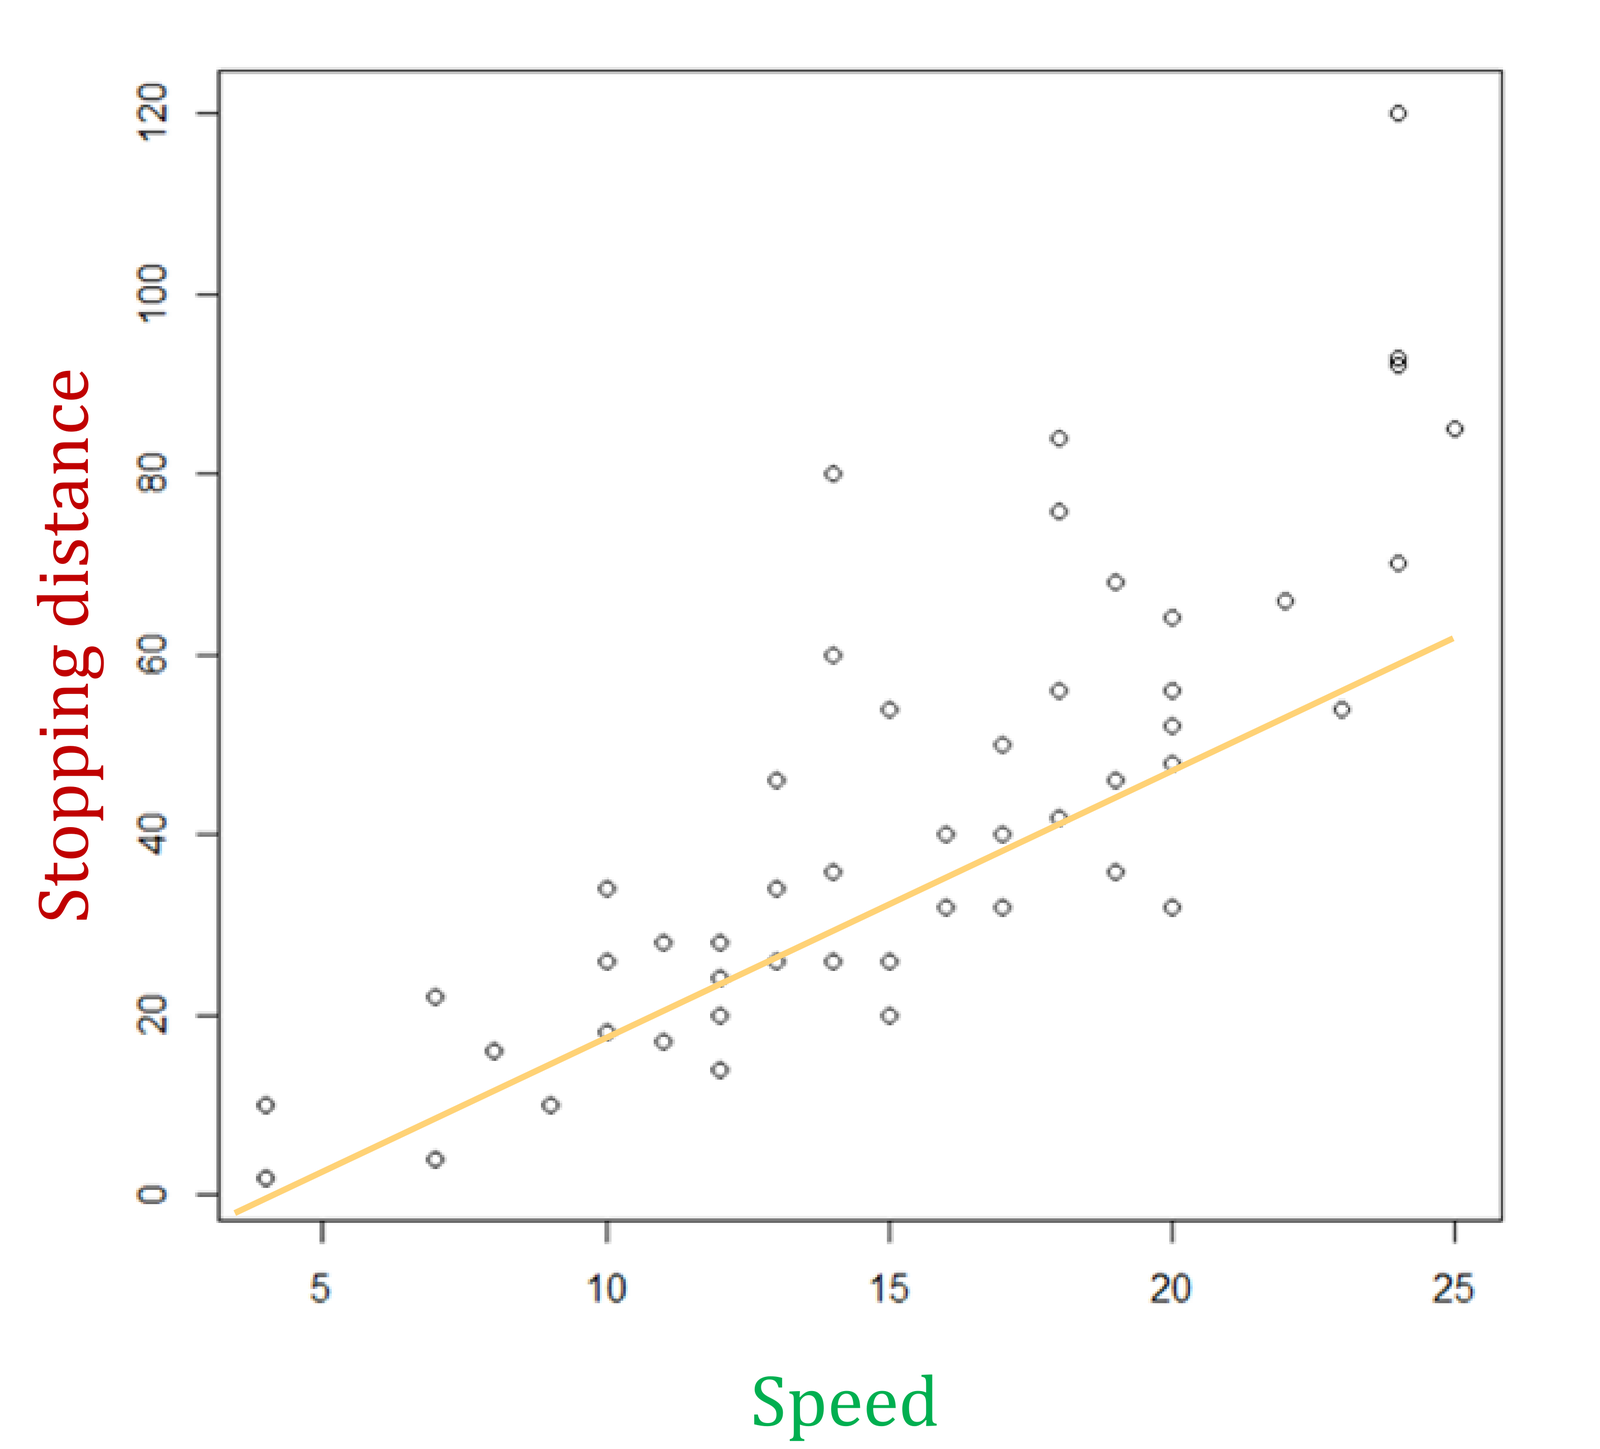
但不是所有问题的输出都是连续量。信用卡欺诈就是一个例子:这张卡本月比上月多刷了若干笔,这算不算被盗刷?
单看笔数定不下来。要统计。按每月交易次数的变化量分组,看每一组里涉及欺诈的比例:
| 交易次数变化 | 欺诈比例 |
|---|---|
| 20 到 29 笔 | 0 |
| 30 到 39 笔 | 17% |
| 40 到 49 笔 | 29% |
| 50 到 59 笔 | 57% |
| 60 到 69 笔 | 80% |
| 70 到 79 笔 | 100% |
| 80 到 89 笔 | 100% |
把这组比例画出来,是一条从 0 升到 1 的曲线。用直线去拟合不行,因为概率必须落在 0 到 1 之间,直线在两端会跑出去。
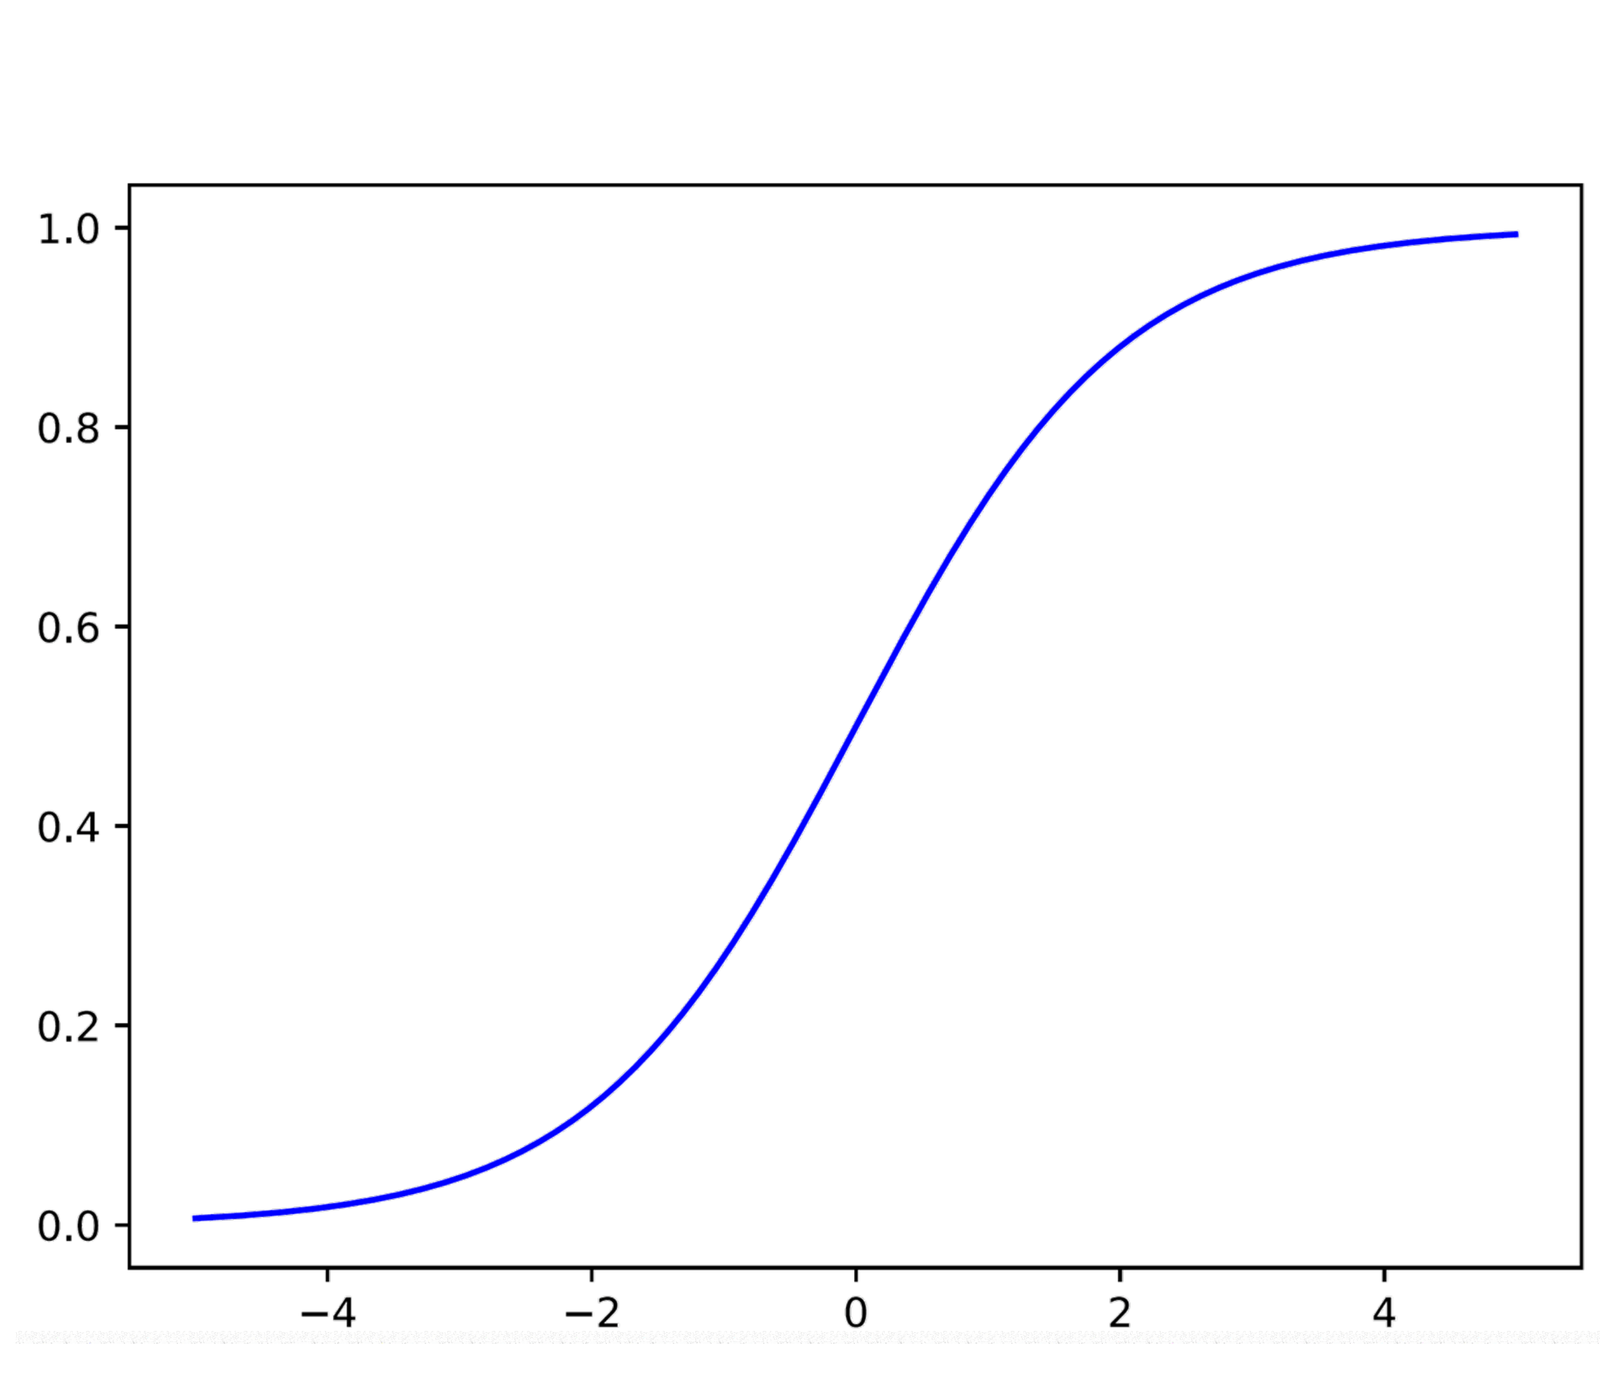
这条 S 形曲线叫 Logistic 函数,也叫 Sigmoid 函数,它把输入映射到 0 到 1 之间的值。
6.2 函数形式、几率与对数几率
函数形式是
P(y∣x)=σ(z)=ez1+ez(6-1)P(y|\boldsymbol{x})=\sigma(z)=\frac{e^z}{1+e^z}\tag{6-1}P(y∣x)=σ(z)=1+ezez(6-1)
单特征的情形写成 z=w0+w1xz=w_0+w_1xz=w0+w1x:
P(y=1∣x)=σ(w0+w1x)=ew0+w1x1+ew0+w1x(6-2)P(y=1|x)=\sigma(w_0+w_1x)=\frac{e^{w_0+w_1x}}{1+e^{w_0+w_1x}}\tag{6-2}P(y=1∣x)=σ(w0+w1x)=1+ew0+w1xew0+w1x(6-2)
除了概率,还有一个叫几率的量。几率是事件发生的概率除以不发生的概率,代入上式化简以后只剩指数部分:
P1−P=ew0+w1x(6-3)\frac{P}{1-P}=e^{w_0+w_1x}\tag{6-3}1−PP=ew0+w1x(6-3)
再取对数,得到对数几率,也叫 logit:
logP1−P=w0+w1x(6-4)\log\frac{P}{1-P}=w_0+w_1x\tag{6-4}log1−PP=w0+w1x(6-4)
这一步的用处在于,对数几率与特征之间是线性关系,系数 w1w_1w1 就是特征 xxx 每增加一个单位时对数几率的变化幅度。
多个特征时写成向量形式,样本属于 y=1y=1y=1 类的概率是 P(y=1∣x)=σ(wTx)P(y=1|\boldsymbol{x})=\sigma(\boldsymbol{w}^T\boldsymbol{x})P(y=1∣x)=σ(wTx),对数几率变成
logP1−P=wTx(6-5)\log\frac{P}{1-P}=\boldsymbol{w}^T\boldsymbol{x}\tag{6-5}log1−PP=wTx(6-5)
此时第 jjj 个系数 wjw_jwj 的含义是:特征 xjx_jxj 每增加一个单位,样本属于 y=1y=1y=1 类的几率在对数尺度上增加 wjw_jwj。
有了概率,分类就是设一个阈值的事,通常取 0.5,P(y=1∣x)>P(y=0∣x)P(y=1|\boldsymbol{x})>P(y=0|\boldsymbol{x})P(y=1∣x)>P(y=0∣x) 判为第一类。
这里有一个容易看漏的地方:Sigmoid 本身是非线性的,Logistic 回归却仍然是线性分类器。判第一类还是第二类,看的只是 P(y=1∣x)P(y=1|\boldsymbol{x})P(y=1∣x) 是否超过 0.5,而 σ(z)\sigma(z)σ(z) 在 z=0z=0z=0 处等于 0.5、随 zzz 单调上升,所以这个条件等价于 wTx\boldsymbol{w}^T\boldsymbol{x}wTx 的符号,也就是一个线性判别函数。把 Sigmoid 换成别的单调函数,只要单调性不变,决策面还是同一个。非线性只出现在概率的输出上,不出现在决策面上。
回到信用卡的例子,A 卡本月比上月多刷 63 笔,落在 60 到 69 这一组,曲线给出的欺诈概率约为 80%,高于 20%,判为欺诈。
6.3 用最大似然求权重
权重本身要从样本里学出来,用的还是最大似然。
训练集是 (xi,yi)(\boldsymbol x_i,y_i)(xi,yi),其中 xi∈Rd+1\boldsymbol x_i\in\mathbb{R}^{d+1}xi∈Rd+1,yiy_iyi 取 0 或 1。为书写简便,记 fi=fw(xi)f_i=f_{\boldsymbol{w}}(\boldsymbol x_i)fi=fw(xi),它是模型把 xi\boldsymbol x_ixi 判为第一类的概率,也就是 σ(wTxi)\sigma(\boldsymbol{w}^T\boldsymbol x_i)σ(wTxi)。
单个样本的似然分两种情形:yi=1y_i=1yi=1 时是 fif_ifi,yi=0y_i=0yi=0 时是 1−fi1-f_i1−fi。用指示函数把两种情形合成一个式子:
Li(w)=fi1(yi=1)(1−fi)1(yi=0)(6-6)L_i(\boldsymbol{w})=f_i^{\mathbf{1}(y_i=1)}\left(1-f_i\right)^{\mathbf{1}(y_i=0)}\tag{6-6}Li(w)=fi1(yi=1)(1−fi)1(yi=0)(6-6)
样本之间相互独立,整个训练集的似然是各样本似然的连乘:
maxwL(w)=maxw∏i=1NP(yi∣xi;w)(6-7)\max_{\boldsymbol{w}}L(\boldsymbol{w})=\max_{\boldsymbol{w}}\prod_{i=1}^{N}P(y_i|\boldsymbol x_i;\boldsymbol{w})\tag{6-7}wmaxL(w)=wmaxi=1∏NP(yi∣xi;w)(6-7)
直接最大化连乘不方便,连乘容易数值下溢,求导也麻烦。取负对数,连乘变求和:
−logL(w)=−∑i=1N{yilogfi+(1−yi)log(1−fi)}(6-8)-\log L(\boldsymbol{w})=-\sum_{i=1}^{N}\left\lbrace y_i\log f_i+(1-y_i)\log\left(1-f_i\right)\right\rbrace\tag{6-8}−logL(w)=−i=1∑N{yilogfi+(1−yi)log(1−fi)}(6-8)
最小化它就等价于最大化原来的似然。这个形式的来历也容易看出来:把似然展开之后,标签为 1 的样本贡献因子 fif_ifi,标签为 0 的样本贡献因子 1−fi1-f_i1−fi。取负对数,乘变成加,标签为 1 的样本剩下 −logfi-\log f_i−logfi,标签为 0 的剩下 −log(1−fi)-\log\left(1-f_i\right)−log(1−fi)。把这两种情形用 yiy_iyi 加权相加,就回到式(6-8)右端那个求和。指示函数的作用只是把两类样本的表达式合成一个,不改变每一项的取值。
6.4 交叉熵
式(6-8)这个损失函数就是交叉熵。
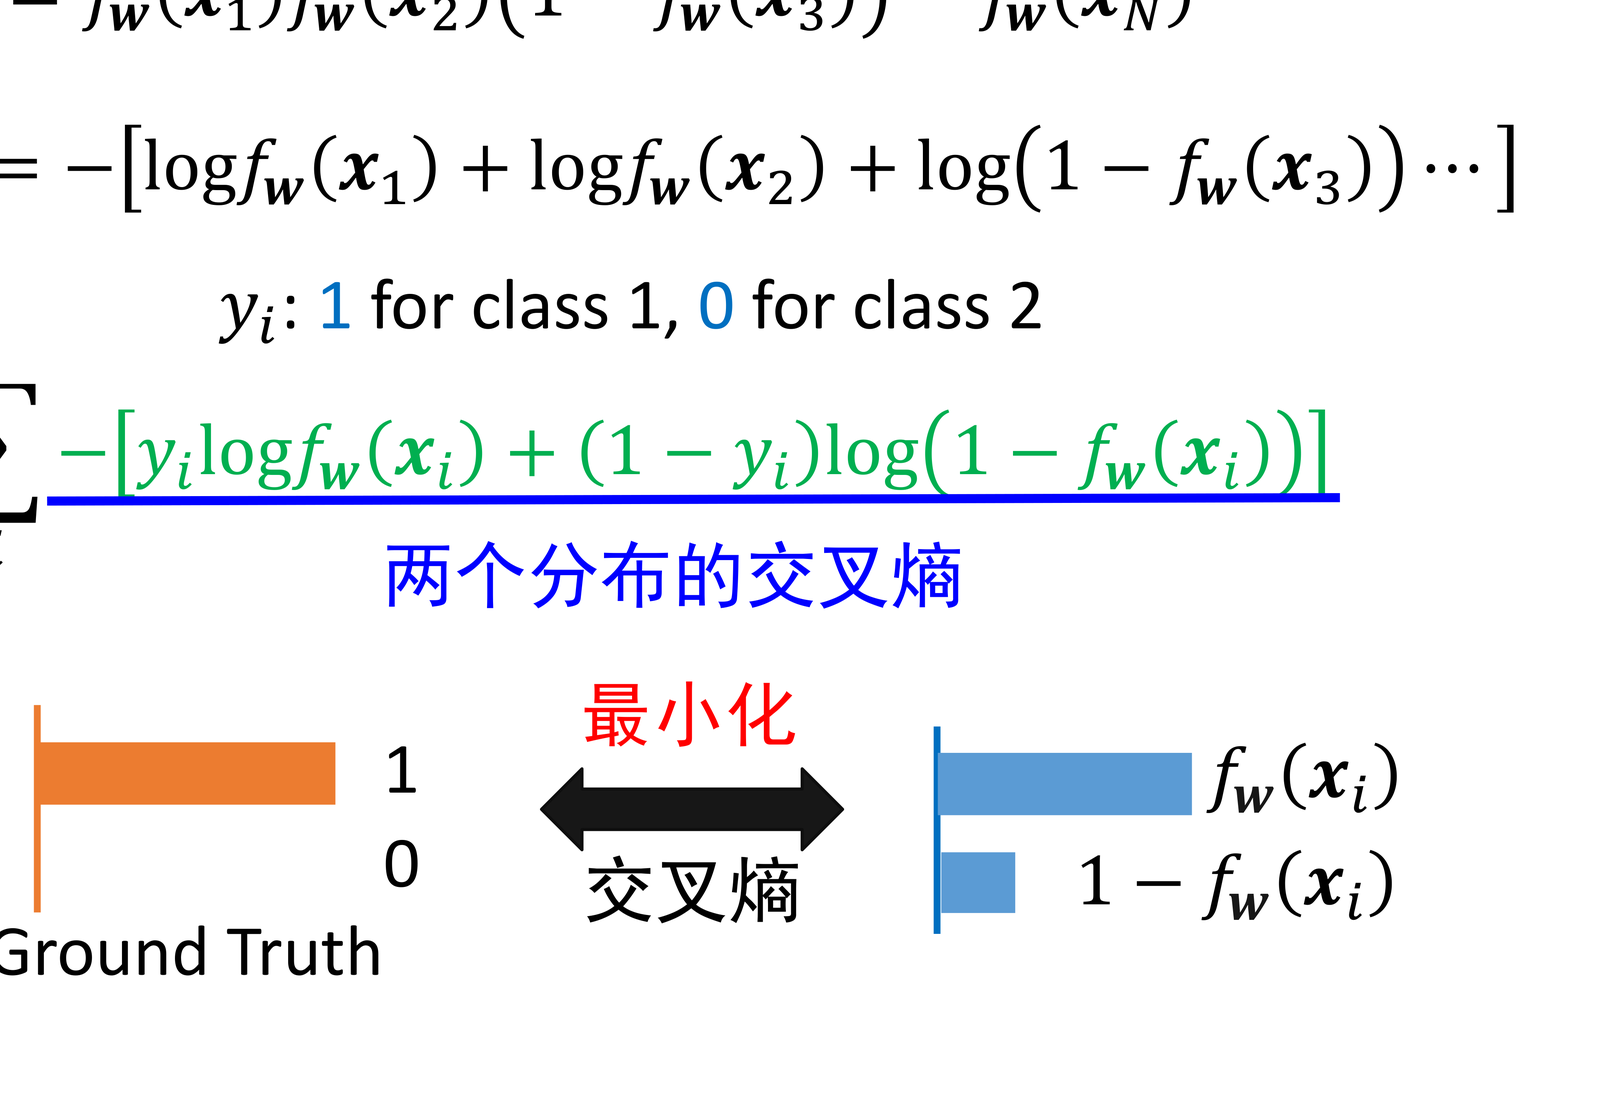
交叉熵衡量两个分布的差异,定义是
H(p,q)=−∑xp(x)logq(x)(6-9)H(p,q)=-\sum_{x}p(x)\log q(x)\tag{6-9}H(p,q)=−x∑p(x)logq(x)(6-9)
放到这个场景里,ppp 是真实标签分布,p(ω1∣xi)=yip(\omega_1|\boldsymbol x_i)=y_ip(ω1∣xi)=yi,p(ω2∣xi)=1−yip(\omega_2|\boldsymbol x_i)=1-y_ip(ω2∣xi)=1−yi,是一个由 0 和 1 组成的确定性分布;qqq 是模型预测分布,q(ω1∣xi)=fw(xi)q(\omega_1|\boldsymbol x_i)=f_{\boldsymbol{w}}(\boldsymbol x_i)q(ω1∣xi)=fw(xi),q(ω2∣xi)=1−fw(xi)q(\omega_2|\boldsymbol x_i)=1-f_{\boldsymbol{w}}(\boldsymbol x_i)q(ω2∣xi)=1−fw(xi)。于是最小化负对数似然,就是在最小化真实标签分布与模型预测分布之间的差异。
这也说明了分类问题里为什么用交叉熵:它和最大似然是同一件事的两种写法。
6.5 梯度下降
对 wjw_jwj 求偏导,整理同类项以后得到
∂(−logL(w))∂wj=∑i=1N−(yi−fw(xi))xi(j)(6-10)\frac{\partial\left(-\log L(\boldsymbol{w})\right)}{\partial w_j}=\sum_{i=1}^{N}-\left(y_i-f_{\boldsymbol{w}}(\boldsymbol x_i)\right)x_i^{(j)}\tag{6-10}∂wj∂(−logL(w))=i=1∑N−(yi−fw(xi))xi(j)(6-10)
按梯度下降更新权重:
wj←wj+η∑i=1N(yi−fw(xi))xi(j)(6-11)w_j\leftarrow w_j+\eta\sum_{i=1}^{N}\left(y_i-f_{\boldsymbol{w}}(\boldsymbol x_i)\right)x_i^{(j)}\tag{6-11}wj←wj+ηi=1∑N(yi−fw(xi))xi(j)(6-11)
求导的链条是两层,外层是 Sigmoid 取对数,内层是线性的加权和:
∂logσ(z)∂z=1−σ(z)(6-12)\frac{\partial\log\sigma(z)}{\partial z}=1-\sigma(z)\tag{6-12}∂z∂logσ(z)=1−σ(z)(6-12)
∂log(1−σ(z))∂z=−σ(z)(6-13)\frac{\partial\log\left(1-\sigma(z)\right)}{\partial z}=-\sigma(z)\tag{6-13}∂z∂log(1−σ(z))=−σ(z)(6-13)
而 ∂z/∂wj=x(j)\partial z/\partial w_j=x^{(j)}∂z/∂wj=x(j),其中 z=wTxz=\boldsymbol{w}^T\boldsymbol{x}z=wTx。把式(6-12)与式(6-13)代回去,yiy_iyi 那一支里的 σ\sigmaσ 与分母上的 σ\sigmaσ 相消,(1−yi)(1-y_i)(1−yi) 那一支同理,两边合并以后只剩下模型输出与真实标签之差。
看式(6-11),更新量是模型输出与真实标签之差乘上对应的特征分量。差得大,说明当前离目标还远,更新就大;差得小,更新就小。这个行为是合理的。
6.6 与线性回归的对照
一个机器学习方法有三个要素:模型(假设函数)、损失函数(学习准则)、学习算法。把 Logistic 回归和线性回归按这三条摆在一起,差别就清楚了。
| 要素 | 线性回归 | Logistic 回归 |
|---|---|---|
| 假设函数 | fw(x)=wTxf_{\boldsymbol{w}}(\boldsymbol{x})=\boldsymbol{w}^T\boldsymbol{x}fw(x)=wTx | fw(x)=σ(wTx)f_{\boldsymbol{w}}(\boldsymbol{x})=\sigma(\boldsymbol{w}^T\boldsymbol{x})fw(x)=σ(wTx) |
| 输出范围 | 任意实数 | 0 到 1 之间 |
| 标签 | 实数 | 0 或 1 |
| 损失函数 | 均方误差 | 交叉熵,见式(6-8) |
| 更新式 | 残差乘特征,见式(6-11) | 残差乘特征,见式(6-11) |
两条更新式在形式上完全相同,都是残差乘特征。差别只在假设函数和损失函数上。
6.7 留下的问题
分类问题为什么不直接用最常用的平方误差,而用交叉熵?
把平方误差套在 Logistic 回归上,记 f=fw(x)f=f_{\boldsymbol{w}}(\boldsymbol{x})f=fw(x),对 wjw_jwj 求导会多出一个因子:
∂(f−y)2∂wj=2(f−y)f(1−f)x(j)(6-14)\frac{\partial\left(f-y\right)^2}{\partial w_j}=2\left(f-y\right)f\left(1-f\right)x^{(j)}\tag{6-14}∂wj∂(f−y)2=2(f−y)f(1−f)x(j)(6-14)
多出来的 f(1−f)f(1-f)f(1−f) 是 Sigmoid 的导数。问题就出在这里:当模型输出接近 0 或接近 1 的时候,这个因子趋近于 0。也就是说,模型已经错得很离谱的时候,比如真实标签是 1 而模型输出接近 0,梯度反而被压没了,更新几乎不动。
这恰好和期望的行为相反。
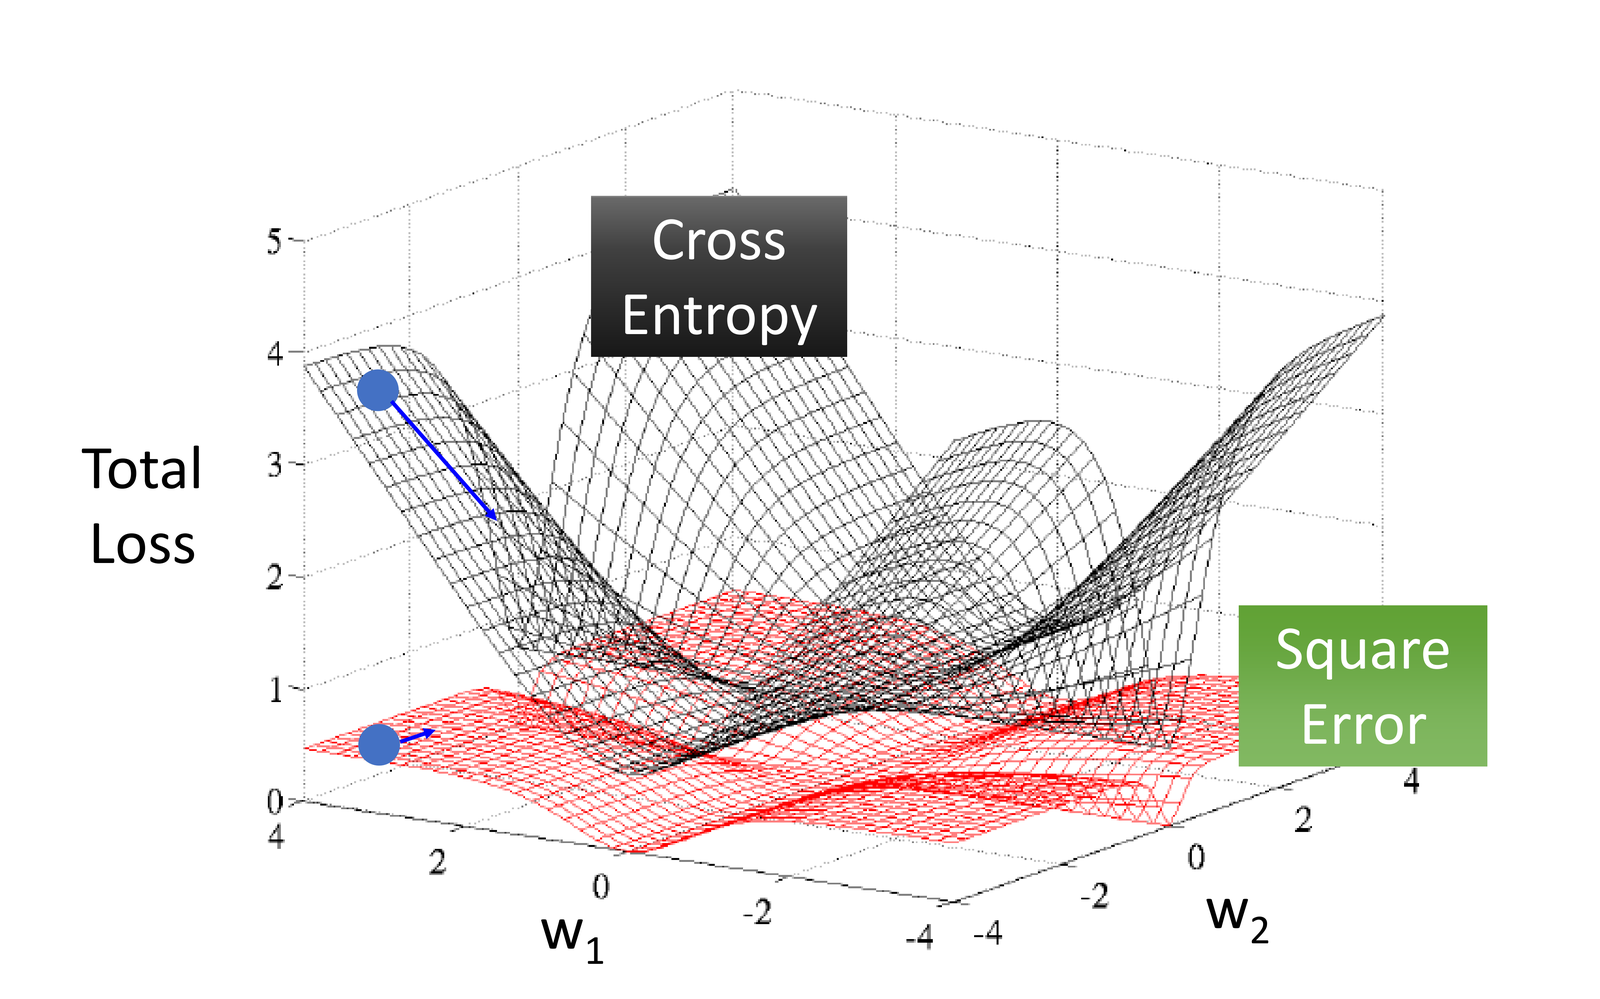
图源:X. Glorot, Y. Bengio,Understanding the difficulty of training deep feedforward neural networks,AISTATS 2010,PMLR 9:249-256。
两张损失曲面对照可以看出这一点,交叉熵的曲面陡,平方误差的曲面平。
类别数超过两类时,把 Sigmoid 换成 Softmax 就可以推广,二分类是它的特例,这一步留到后面。