因为 3.0 是常量,y 是变量------编译器对它们的处理方式完全不同。
核心原因
Power(x, 3.0)     ← 编译期就知道指数是 3.0
                  → 编译器:我可以把 pow(x,3.0) 替换成 x*x*x

Power(x, y)       ← y 是一个 Scalar Parameter,编译期不知道它的值
  y = 3.0          → 这个 3.0 是运行时的值,不是编译期的常量
                  → 编译器:我不知道 y 在运行时会是多少,必须保留 pow()
发生在不同时间:
编译期(Shader 编译时)         运行时(游戏跑起来后)
─────────────────────         ─────────────────────
3.0 → 编译器认识,是个字面量     3.0 → GPU 不认识,是数据

y   → 编译器不认识,是个变量      y  → GPU 从 Uniform Buffer 里读到 3.0
     来自 Parameter Node              然后用 pow(x, 3.0) 算一遍
可视化的对比
材质图中的写法                 编译器视角                 实际 GPU 指令
─────────────────────────────────────────────────────────────────
Power
 ├─ x ──○                      "指数是 3.0"               mul r0, x, x
 └─ 3.0 ──○                    → 折叠掉!                mul r1, r0, x

Power
 ├─ x ──○                      "指数是 y,运行时         log r0, x
 └─ ScalarParam[y] ──○          才能知道是多少"          mul r1, r0, y
   (值 = 3.0)                  → 保留 pow()!            exp r2, r1
更深一层:为什么编译器不能"看一眼" y 的值
Shader 编译发生在打包阶段(Cook),这时候:
- Material Instance 的参数值还没有设置好
- 即使设置了,同一个 Shader 可能被多个 MI 复用,每个 MI 的 y 值都不同
- y 甚至可以通过 Blueprint / C++ 在运行时动态修改
所以编译器必须假设 y 是任意值 ,走最通用的 pow() 实现。
这也解释了为什么 Parameter 不能太多
每个 Scalar Parameter 不仅占一个 Uniform 槽位,还会阻止编译器优化:
Power(x, 0.5)    → 编译器直接替换成 Sqrt(x),1 条指令
Power(x, y)      → 必须用 pow() 通用实现,8-12 条指令
  (即使 y 默认值就是 0.5 也没用,除非你把 Parameter 改成字面量)
这个差值不是 Power 节点本身的问题,而是常量 vs 变量的根本鸿沟------编译器无法跨越编译期和运行时的边界做优化。
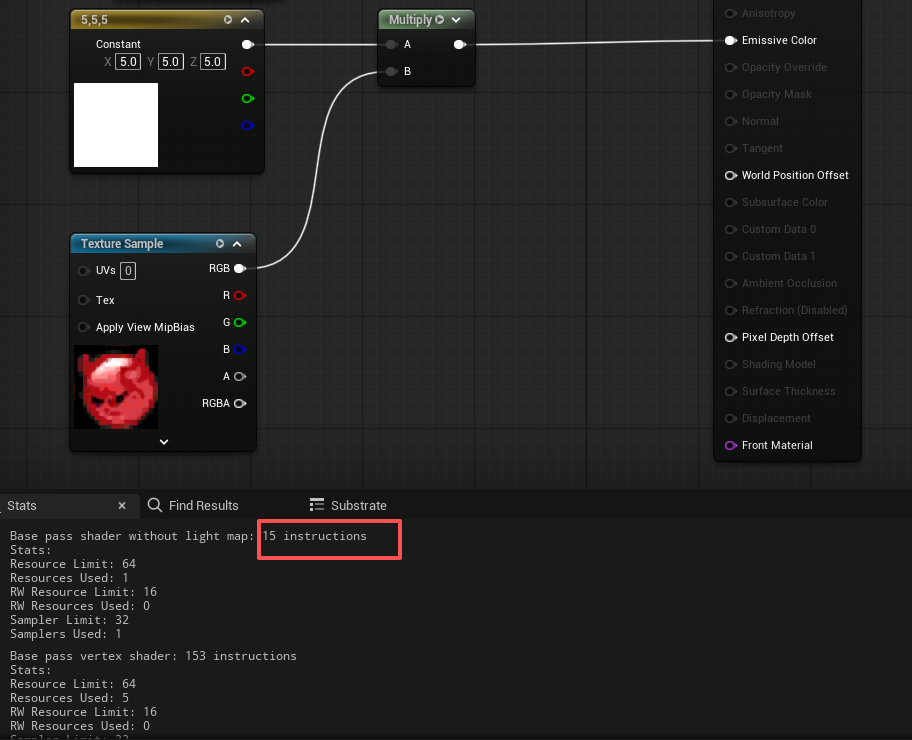
| 常量 | 等价结果 | 优化特点 | 你看到的趋势 |
|---|---|---|---|
(1,1,1) |
Texture.rgb |
整个 Multiply 是恒等操作,直接删掉 |
最低,约 13 |
(0,0,0) |
float3(0,0,0) |
结果完全是黑色常量,理论上贴图采样依赖也可删除 | 最强优化 |
(5,1,1) |
(Texture.r*5, Texture.g, Texture.b) |
G/B * 1 被省,只有 R 需要缩放 |
约 14 |
(5,25,1) |
(Texture.r*5, Texture.g*25, Texture.b) |
B * 1 被省,R/G 缩放可能打包处理 |
约 14 |
(5,25,0) |
(Texture.r*5, Texture.g*25, 0) |
B * 0 让蓝通道变常量,蓝通道依赖死掉 |
可降到约 13 |
(5,25,5) |
RGB 都要乘非 1 常量 | 没有通道能原样通过或死掉 | 约 15 |
(5,5,5) |
Texture.rgb * 5 |
虽然三个系数一样,但 RGB 三个通道都必须缩放 | 约 15 |
关键总结:
* 1:省掉乘法,但通道还活着
* 0:结果变常量,通道依赖可能死掉
全 1:整个 Multiply 节点消失
全 0:Multiply 结果变纯常量,甚至贴图依赖也可能消失
全非 1:RGB 都要参与缩放,代价最高
相同非 1,比如 5,5,5:不是免费,仍然要缩放 RGB