文章目录
爬虫
下面是一段获取页面源代码的代码
python
from urllib.request import urlopen
url = 'http://www.baidu.com'
resp = urlopen(url)
print(resp.read().decode('utf-8')) # 拿到页面源代码
这里是用 urllib 来抓取页面源代码, 这是python内置的一个模块, 但是, 它并不是我们常用的爬虫工具, 常用的抓取页面的模块通常使用一个第三方模块request, 这个模块的优势就是比urllib还要简单, 并且处理各种请求都比较方便
python
import requests

# 爬取百度页面源代码
url = 'http://www.baidu.com'
resp = requests.get(url)
resp.encoding = 'utf-8'
print(resp.text)
GET请求
请看下面代码
python
import requests

content = input("亲输入你要搜索的内容: ")
url = f'https://www.sogou.com/web?query={content}'
resp = requests.get(url)

print(resp.status_code)
print(resp.text)
运行, 在打印的内容中出现了: 此验证码用于确认这些请求是您的正常行为而不是自动程序发出的,需要您协助验证, 这是为什么呢?
这是因为服务器检测出了不是正常的浏览器行为,而是代码自动化的程序
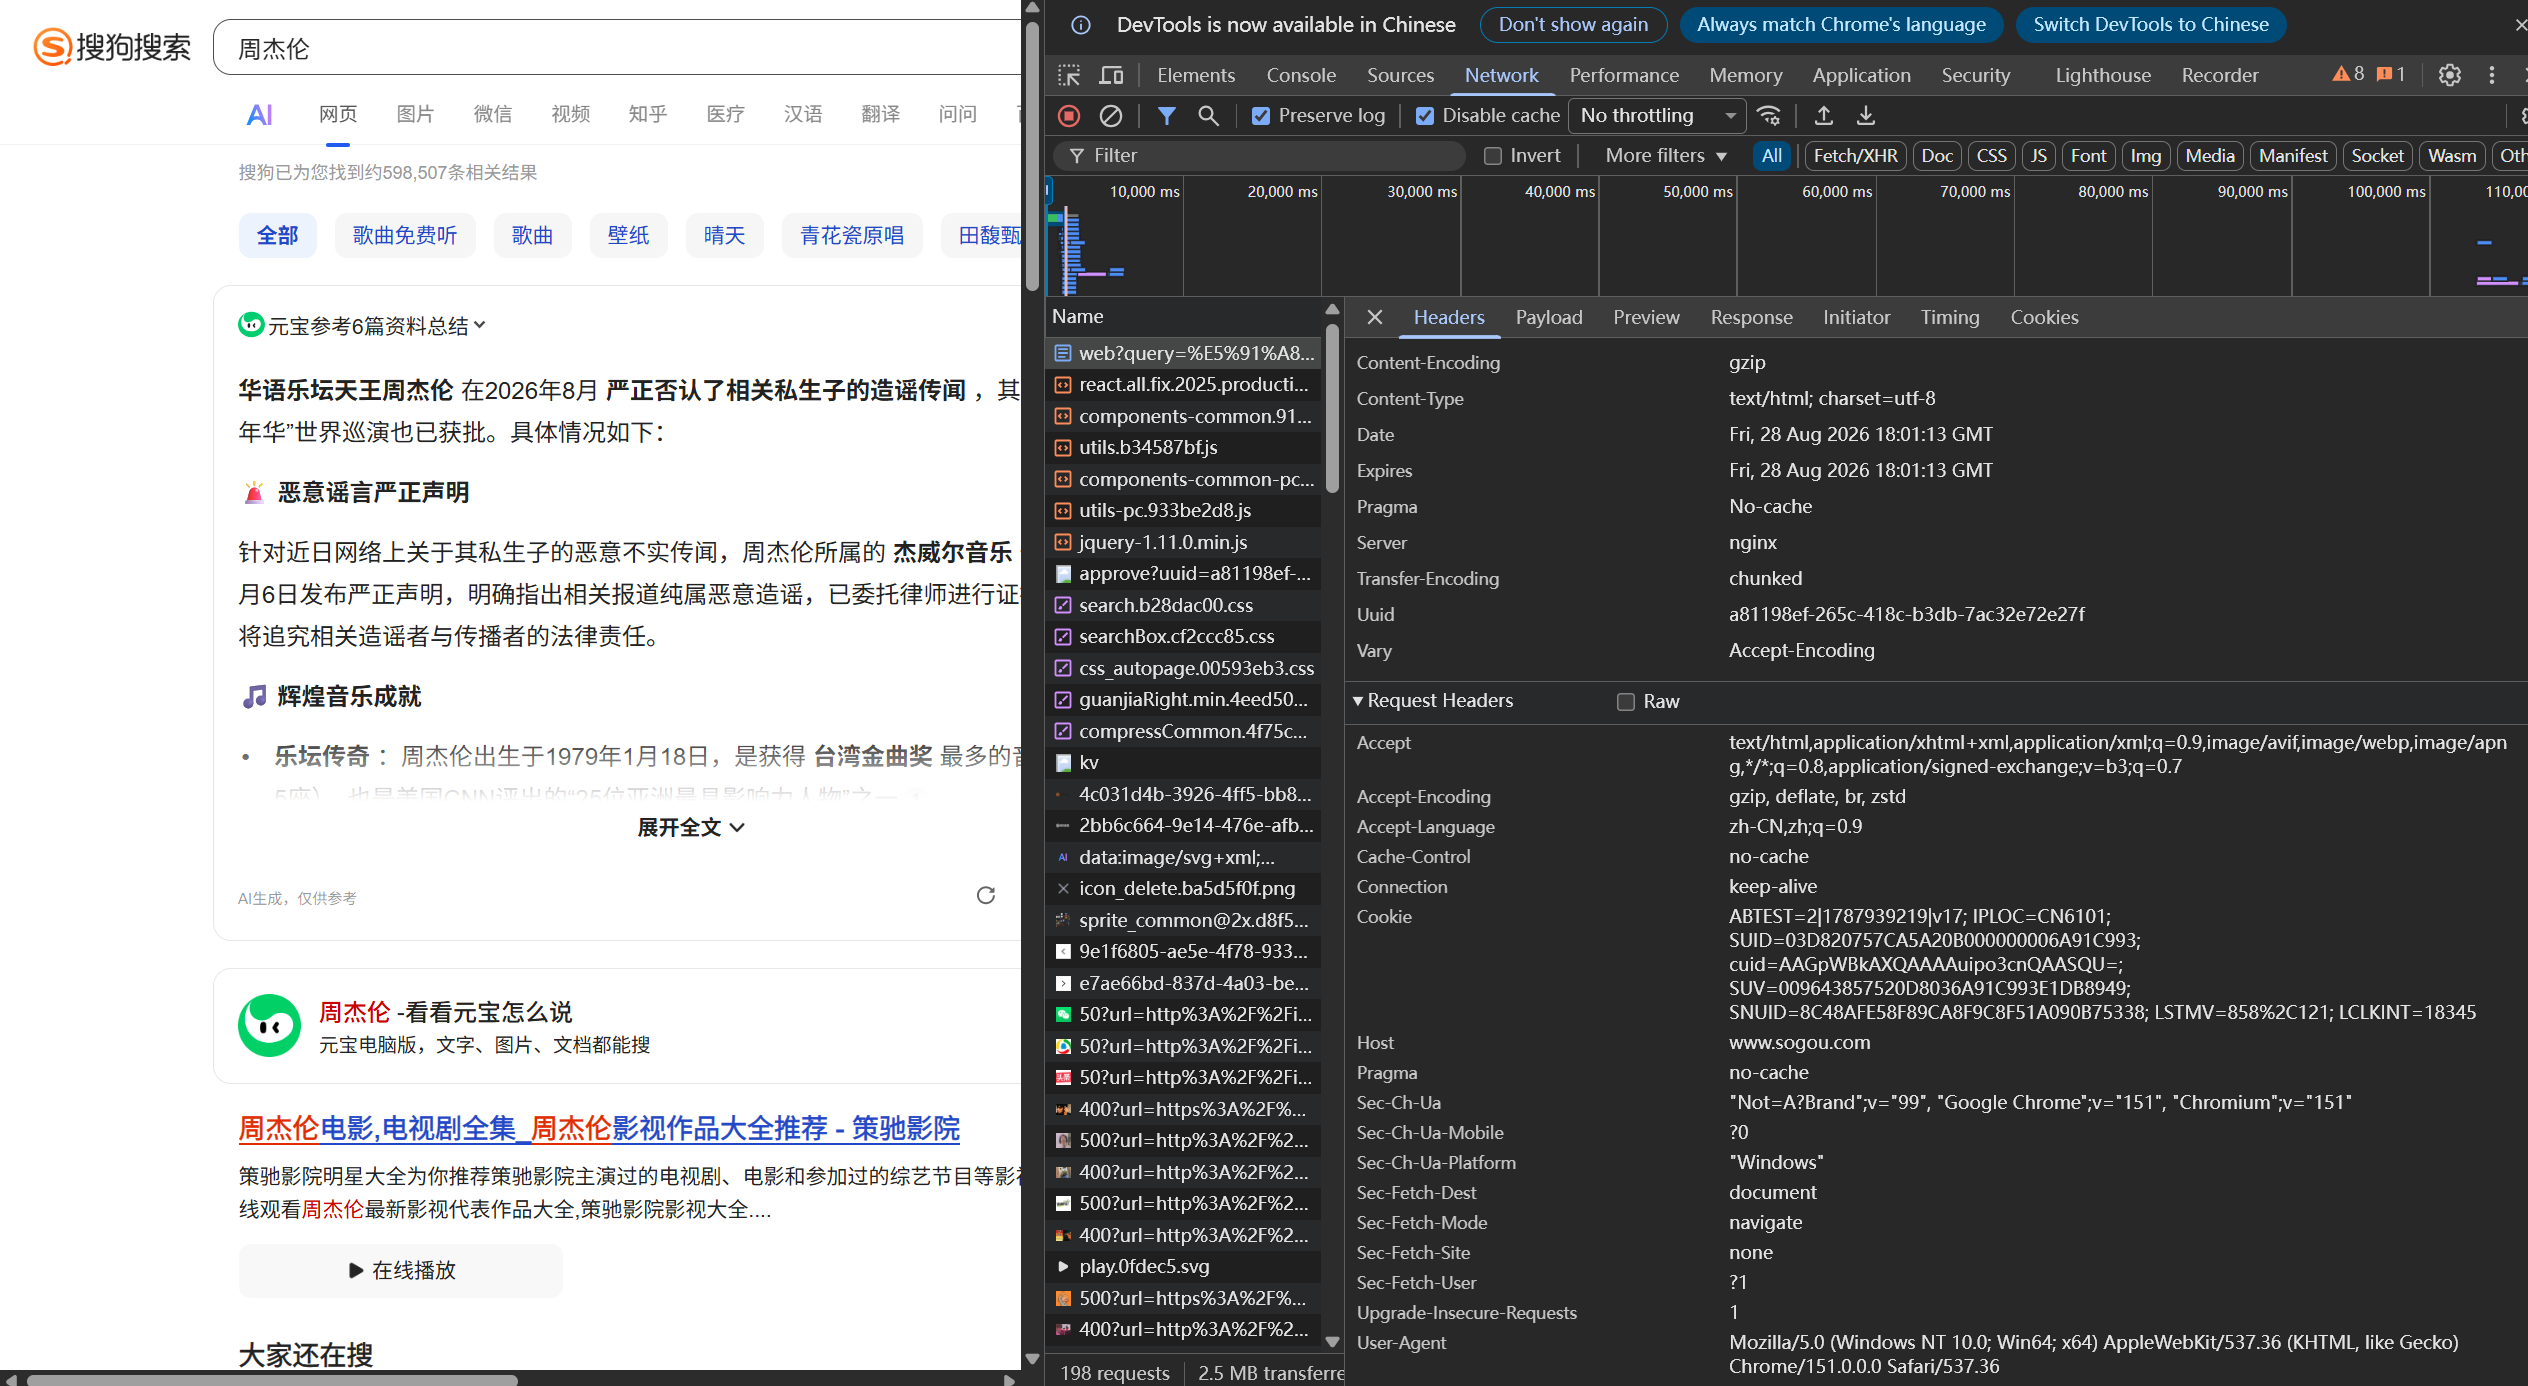
打开网页,查看请求信息,可以看到:
python
user-agent
Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/151.0.0.0 Safari/537.36
这里的信息表示的是用户使用什么设备发送本次请求, 那么我们可以通过添加请求头信息的方式处理这次反爬
python
import requests

content = input("亲输入你要搜索的内容: ")
url = f'https://www.sogou.com/web?query={content}'

headers = {
    "User-Agent": 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/151.0.0.0 Safari/537.36'
}
resp = requests.get(url, headers = headers)

print(resp.status_code)
print(resp.text)
注意: requests 会严格识别 header 键名,写错的话这个请求头等于没生效
POST 请求
python
import requests
url = 'https://fanyi.baidu.com/sug'
data = {
    'kw': input("请输入一个单词: ")
}

resp = requests.post(url, data = data)
print(resp.text) # 拿到的是字符串

print(resp.json()) # 拿到的json数据
GET请求带参数
这里在网页中获取请求参数
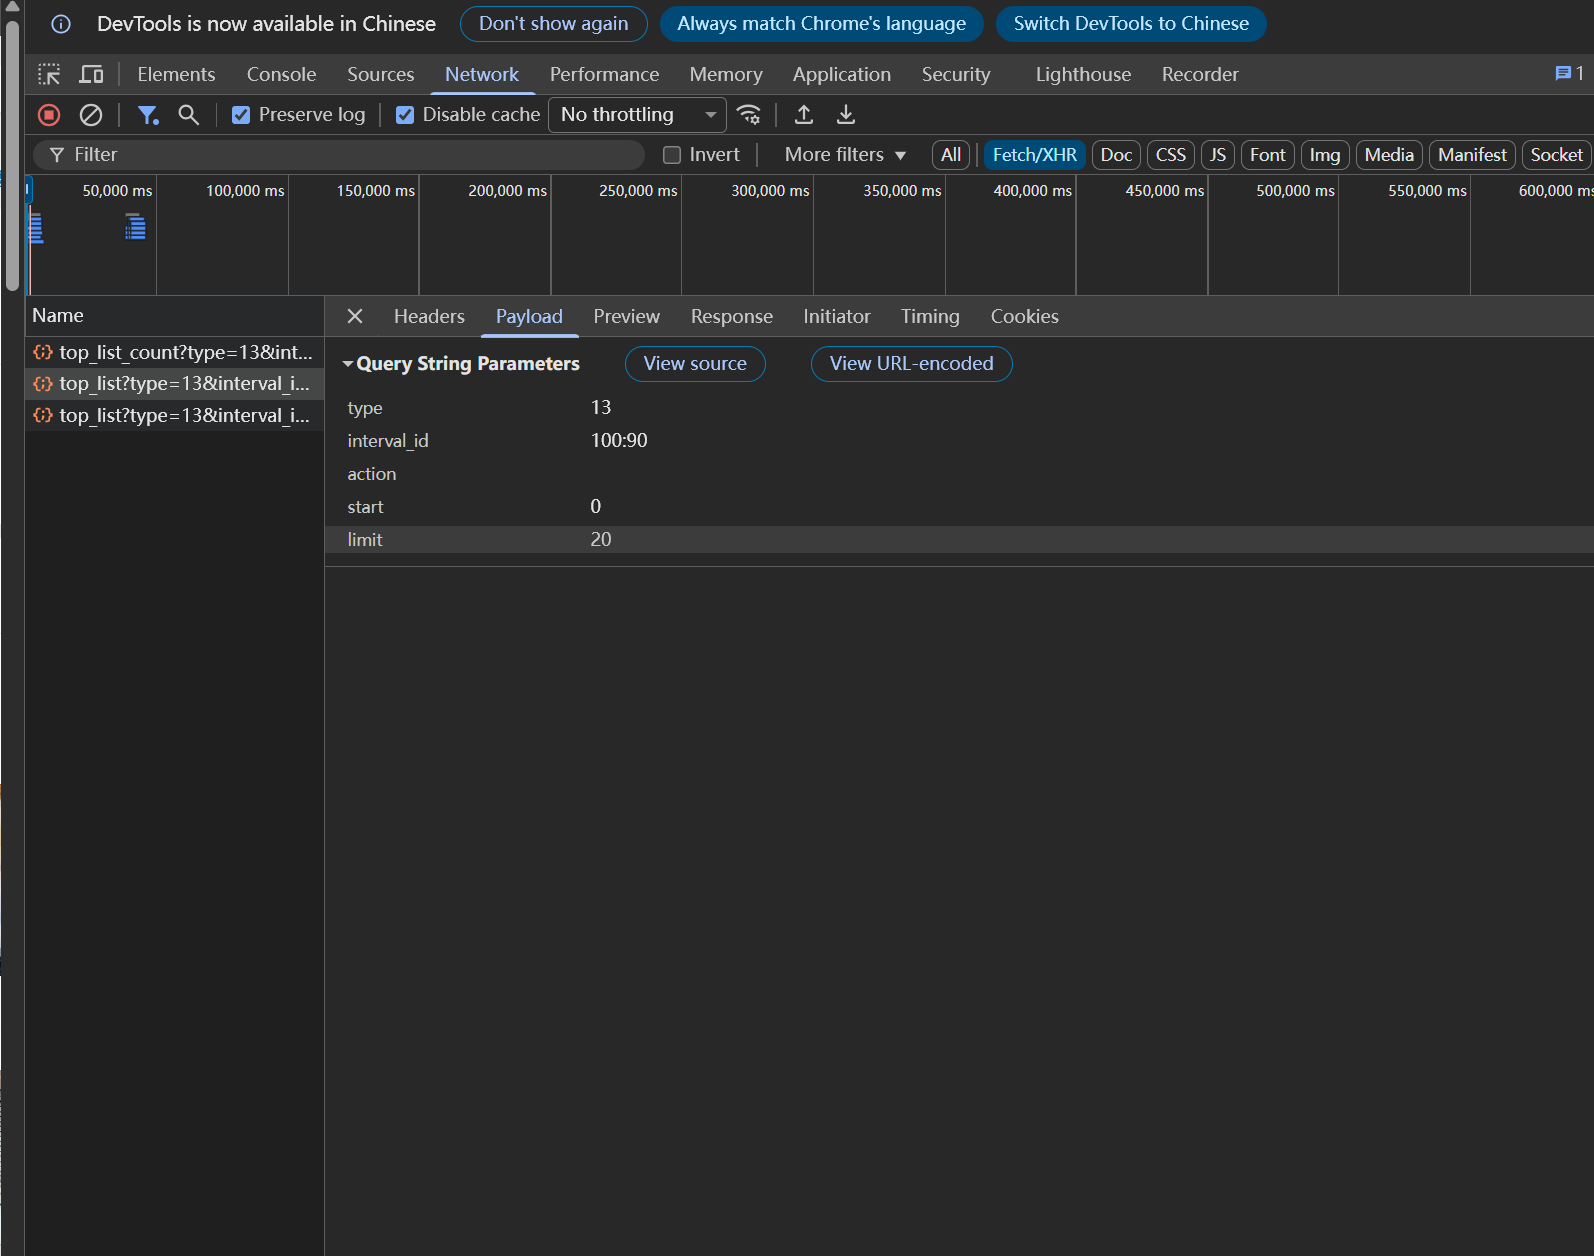
这里可以将查询到的参数统一封装到一个字典, 传给requests的get请求的params参数
python
import requests
url = 'https://movie.douban.com/j/chart/top_list'
data = {
    'type': '13',
    'interval_id': "100:90",
    "action": "",
    'start': '0',
    'limit': '20'
}

headers = {
    'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/151.0.0.0 Safari/537.36'
}
resp = requests.get(url, params=data, headers=headers)
# print(resp.text)
print(resp.json())
print(resp.request.url)
另外,在网页中查看并在代码中添加请求设备信息, 处理反爬