第 9 章 记忆系统
本章要解决的问题
Agent 需要记住用户偏好、历史操作和长期知识,但记太多会污染上下文------记忆该怎么设计?
章节大纲
- 9.1 记忆分类:短期(上下文)/ 长期(向量库)/ 工作记忆
- 9.2 记忆写入、检索与遗忘策略
- 9.3 记忆与 RAG 的分工与配合
- 🛠 解决方案:记忆污染/过期/混淆问题的解决模板
9.1 记忆分类:Agent 的"三层记忆"
9.1.1 人类记忆的启发
人类记忆分三层:工作记忆(眼前的事)、短期记忆(最近的事)、长期记忆(重要的事)。Agent 的记忆也照此设计------不是"要不要记忆"的问题,而是"什么记忆放哪一层"的问题。
9.1.2 三层记忆架构
┌────────────────────────────────────────────┐
│ 短期记忆(上下文窗口)                       │
│ 本次会话的消息/工具结果,会话结束即清空       │
│ 载体:messages 数组(第3章上下文管理)       │
├────────────────────────────────────────────┤
│ 工作记忆(任务期间)                         │
│ 当前任务的中间状态/局部变量,任务结束即清理    │
│ 载体:内存 / Redis(TTL)                   │
├────────────────────────────────────────────┤
│ 长期记忆(跨会话)                           │
│ 用户偏好/历史结论/沉淀知识,可跨会话保留       │
│ 载体:数据库 / 向量库(第8章技术)            │
└────────────────────────────────────────────┘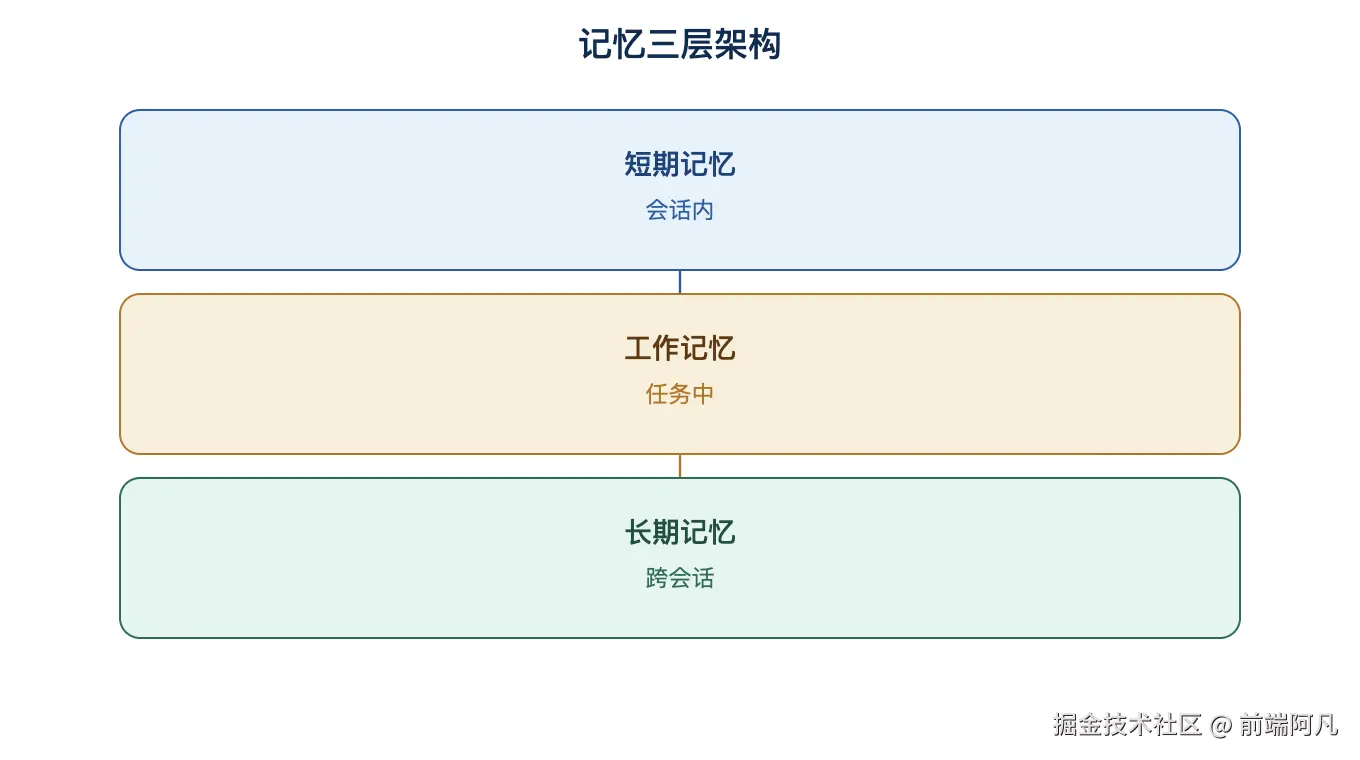
图 1:记忆三层架构
| 层 | 存活期 | 容量 | 载体 | 读写频率 | 呼应章节 |
|---|---|---|---|---|---|
| 短期记忆 | 单次会话 | 小(窗口内) | messages | 每次请求 | 第 3 章 |
| 工作记忆 | 单次任务 | 小 | 内存/Redis | 每步 | 第 6 章 |
| 长期记忆 | 跨会话 | 大 | DB/向量库 | 会话起止 | 本章 |
9.1.3 记忆设计的核心矛盾
记太多 → 上下文污染(记忆噪音干扰当前判断);记太少 → Agent"失忆"(答非所问、重复问)。
这个矛盾贯穿整个记忆设计。解法不是"多记"或"少记",而是分层 + 按需注入:默认只带少量核心记忆进上下文,大量记忆"存在外面、用时才取"(9.2 的检索式记忆)。
9.2 记忆写入、检索与遗忘
9.2.1 记忆的生命周期:写 → 存 → 取 → 忘
css
[写入] 从对话中提炼值得记住的信息(用户偏好/事实/结论)
   ↓
[存储] 按类型存:结构化事实→DB;非结构化内容→向量库
   ↓
[检索] 新会话开始时,按当前话题检索相关记忆注入上下文
   ↓
[遗忘] 过期/低价值记忆降权或删除(防止记忆污染)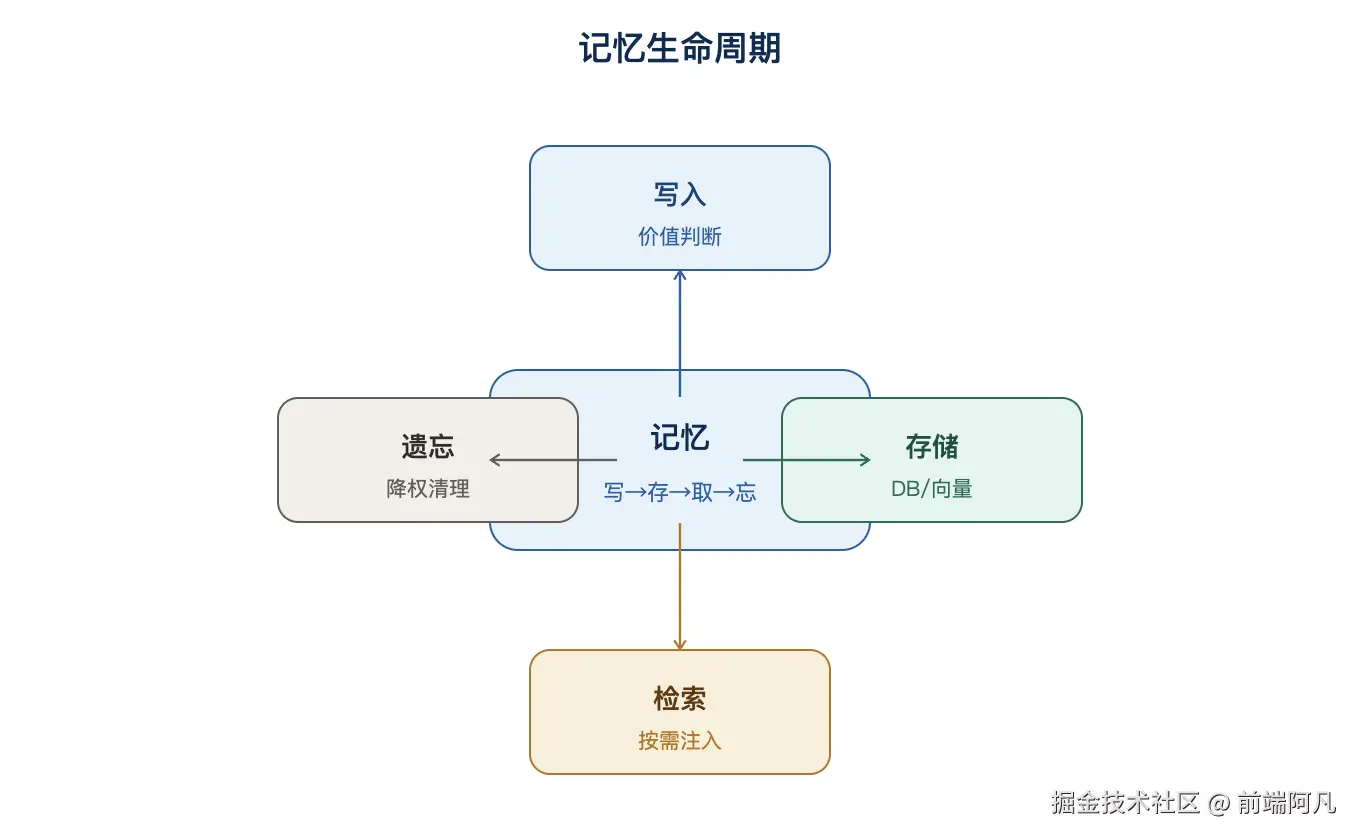
图 2:记忆生命周期
9.2.2 写入:什么值得记住
不是所有对话都值得记忆。写入前先判断价值(用规则或一次模型判断):
python
MEMORY_RULES = [
    "用户明确表达的偏好(我喜欢/我习惯/请以后......)",
    "与用户身份相关的稳定事实(职业/城市/家庭)",
    "跨会话需要的承诺与约定(下周给你方案)",
    "长期结论(上次已确认的决策)",
]

def should_remember(utterance, client):
    """判断是否值得写入长期记忆"""
    # 规则初筛(零成本)
    if any(k in utterance for k in ["我喜欢", "我习惯", "请以后", "记住了", "记住"]):
        return True
    # 模型判断(长尾)------ 呼应"规则优先、模型兜底"心法
    resp = client.chat.completions.create(
        model="deepseek-chat",
        messages=[{"role": "user", "content":
            f"判断以下用户发言是否包含值得长期记住的用户信息。"
            f"只输出 JSON:{{\"worth_memory\": true/false, \"confidence\": 0.0~1.0}}\n发言:{utterance}"}],
        temperature=0.1,
        response_format={"type": "json_object"},
    )
    import json
    try:
        result = json.loads(resp.choices[0].message.content)
    except json.JSONDecodeError:
        return False  # 解析失败时不写入记忆(宁缺毋滥)
    return result.get("worth_memory", False) and result.get("confidence", 0) > 0.7
写入原则:宁缺毋滥。 记忆是稀缺资源(要占上下文),写错/写废的记忆比没有记忆更糟(污染)。
生产加固 :用户发言(
utterance)在写入记忆前应做脱敏处理(手机号、邮箱等 PII 正则替换,呼应第 22 章);记忆写入操作应加权限校验,确保只有授权来源才能写入;长期记忆应设过期和容量上限,避免无限增长。
9.2.3 存储:结构化 vs 向量化
| 记忆类型 | 例子 | 存储 | 检索方式 |
|---|---|---|---|
| 结构化事实 | 偏好/身份/约定 | 关系型/键值库 | 精确查询(按用户 ID) |
| 非结构化内容 | 历史讨论/笔记/结论 | 向量库 | 语义检索(按话题) |
python
# 结构化记忆:按用户 ID 存取(Redis/DB)
def save_fact(user_id, key, value):
    db.set(f"mem:{user_id}:fact:{key}", value)

def load_facts(user_id):
    return db.mget(f"mem:{user_id}:fact:*")

# 非结构化记忆:向量检索(第8章技术)
def save_note(user_id, text):
    vec_db.add(text, metadata={"user_id": user_id})

def search_notes(user_id, topic, top_k=3):
    return vec_db.search(topic, filter={"user_id": user_id}, top_k=top_k)
多租户隔离 :所有记忆都必须带 user_id,检索时强制过滤(呼应第 8 章元数据过滤、第 24 章 A5)。
9.2.4 检索:按需注入,不是全量倾倒
新会话开始时,只注入与当前话题相关的记忆,而不是把用户所有历史都塞进上下文:
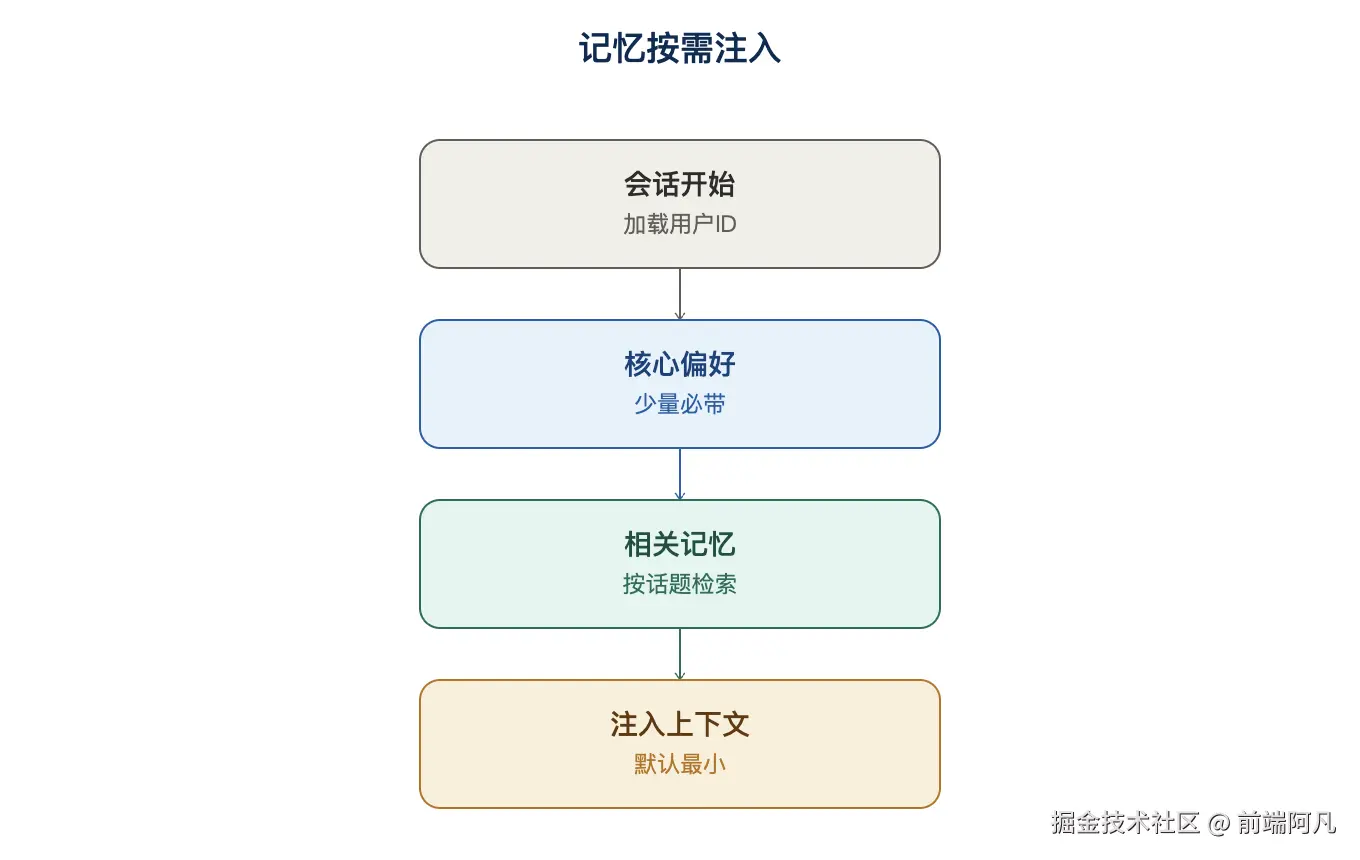
图 3:记忆按需注入
python
def build_user_context(user_id, current_query):
    context = []
    # 1. 核心偏好(少量,总是带)
    context.append(load_facts(user_id, key="core_prefs"))
    # 2. 相关记忆(按当前话题检索)
    relevant = search_notes(user_id, current_query, top_k=3)
    context.extend(relevant)
    return context  # 注入 system 或独立 message
按需注入 = 记忆版的"按需投喂"(呼应第 3 章上下文编排、第 16 章上下文隔离)------同一哲学:默认只带必要的。
9.2.5 遗忘:记忆防污染的关键
记忆不清洗就会积累噪音甚至错误信息。遗忘策略:
| 策略 | 做法 | 适用 |
|---|---|---|
| 时间衰减 | 超期记忆降权/删除 | 偏好可能变化的记忆 |
| 冲突覆盖 | 新信息与旧记忆冲突 → 更新旧记忆 | 用户改了偏好 |
| 价值清理 | 长期未命中/低分记忆归档 | 控制存储膨胀 |
| 用户可控 | 提供"忘记我"功能 | 合规要求 |
记忆过期是常态:用户去年"喜欢咖啡",今年可能改喝茶------记忆必须有更新机制(呼应第 18 章学习漂移与回退保护)。
记忆更新机制 :同一条事实变化时,应按 user_id + fact_key 做 upsert(覆盖旧值),而不是重复写入。示例:
python
def upsert_fact(user_id, key, value):
    """更新或插入记忆(覆盖旧值,而非追加)"""
db.set(f"mem:{user_id}:fact:{key}", json.dumps({"value": value, "updated_at": time.time()}))用户同意与合规:记忆写入前最好有显式或隐式同意,并提供"忘记我"功能(可撤销、可导出、可删除)。尤其涉及用户偏好、身份信息、跨会话记忆时,需遵守相关数据保护法规。
9.3 记忆与 RAG 的分工与配合
9.3.1 两者到底有什么区别
这是最常被混淆的问题。一句话区分:
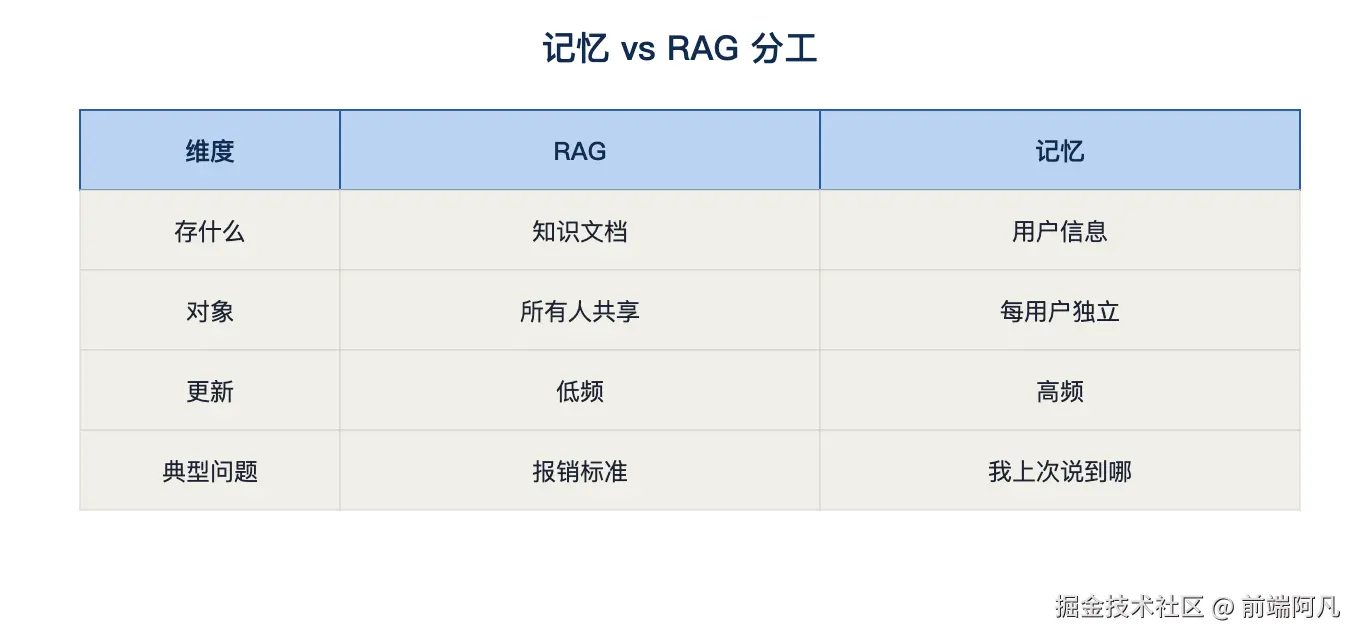
图 4:记忆 vs RAG 分工
RAG 回答"知识性问题"(客观资料),记忆回答"个人化问题"(用户相关)。
| 维度 | RAG(第 8 章) | 记忆(本章) |
|---|---|---|
| 存什么 | 知识库文档(公有的) | 用户记忆(私有的) |
| 服务对象 | 所有用户共享 | 每个用户独立 |
| 更新频率 | 低频(文档变更) | 高频(每次对话) |
| 检索依据 | 问题语义 | 用户身份 + 话题 |
| 典型问题 | "报销标准是多少" | "我上次说到哪了" |
9.3.2 技术同源,场景不同
两者技术上高度同源(都用向量库 + 检索),区别在数据源和检索入口:
erlang
RAG:  query → 向量检索(全库文档)→ 注入 → 回答知识问题
记忆:  query + user_id → 向量检索(该用户记忆)→ 注入 → 回答个性化问题
工程落地 :可以用同一个向量库,用 metadata.scope 区分(scope=kb 知识库 / scope=user:{id} 用户记忆),检索时按 scope 过滤。
9.3.3 配合使用的场景
一个成熟的 Agent 常常两者并用:
python
def build_enhanced_context(user_id, question):
    # 1. 记忆:用户的个性化上下文
    user_ctx = load_user_context(user_id, question)
    # 2. RAG:问题的知识资料
    kb_ctx = rag.retrieve(question, top_k=3)
    # 3. 合并注入(记忆在前,知识在后)
    return f"""【用户背景】{user_ctx}
【参考资料】{kb_ctx}
请结合用户背景,基于参考资料回答。"""
典型例子 :用户问"适合我的报销方案"------记忆提供"该用户是销售岗"(个性化),RAG 提供"公司报销制度"(知识),两者合成才是好答案。记忆管"你是谁",RAG 管"世界是什么"。
🛠 解决方案:记忆污染/过期/混淆问题的解决模板
常见问题
- "记忆把上下文撑爆了":全量倾倒记忆。对策:按需注入(9.2.4)+ 核心偏好限量(最多几条)。
- "记忆过时,答错信息":记忆未更新。对策:冲突覆盖(用户新说法覆盖旧记忆)+ 时间衰减(9.2.5)。
- "A 用户的记忆串到 B 用户":缺 user_id 隔离。对策:所有记忆带 user_id + 检索强制过滤(9.2.3)。
- "记忆里有错误信息,越用越错":写入时未校验。对策:写入前判断价值 + 低置信度不写(9.2.2);错误记忆可被用户纠正覆盖。
- "不知道怎么区分记忆和 RAG":知识问题走 RAG,个人问题走记忆(9.3.1);拿不准就用"合并注入"方案(9.3.3)。
解决方案速查表
| 现象 | 根因 | 解决方案 |
|---|---|---|
| 上下文爆 | 全量倾倒 | 按需注入 + 限量 |
| 记忆过时 | 无更新机制 | 冲突覆盖 + 时间衰减 |
| 记忆串号 | 无隔离 | user_id 过滤 |
| 记忆污染 | 写入不校验 | 价值判断 + 低置信不写 |
| 记忆/RAG 混淆 | 场景不清 | 知识→RAG、个人→记忆 |
实战提示
- 记忆设计三问:存什么(写入判断)、怎么取(按需检索)、何时忘(遗忘策略)------缺一个都不完整。
- 宁缺毋滥:写错记忆比没有记忆更糟(污染上下文)。
- 隔离是底线:多用户场景,user_id 过滤必须强制,否则就是数据事故。
- 记忆要有生命周期:写 → 存 → 取 → 忘,遗忘和写入一样重要。
- 记忆是第 18 章学习的载体:学习到的用户偏好最终沉淀为记忆------两章天然衔接。