摘要:前面讲接收数据时提过,Receiver 模式是 Spark Streaming 早期的 Kafka 集成方式,Direct 模式是它的替代者。这篇把 Direct 模式讲透:它为什么没有 Receiver、offset 怎么自己管理、怎么靠"offset 和 Job 结果绑定"拿到 exactly-once,以及 createDirectStream 的 LocationStrategies 和 ConsumerStrategies 两个参数怎么选。
关键词:Spark Streaming, Direct 模式, Kafka, offset, exactly-once, createDirectStream
一、Direct 模式解决的是 Receiver 模式的老问题
先回顾 Receiver 模式的两个硬伤:
- offset 提交和处理分离。Receiver 用 Kafka 的 High-Level Consumer 拉数据,offset 交给 ZooKeeper 自动提交。处理失败时 offset 可能已经提交了,数据就丢了;开了 WAL 变 at-least-once,又可能重复消费。
- 资源开销大。每个 Receiver 要占一个核,还要开 WAL 写盘保证不丢。
Direct 模式的思路很直接:把 Receiver 拿掉。没有 Receiver,就没有"长驻进程 + WAL + ZK offset"这一整套负担。
二、没有 Receiver,数据怎么进来
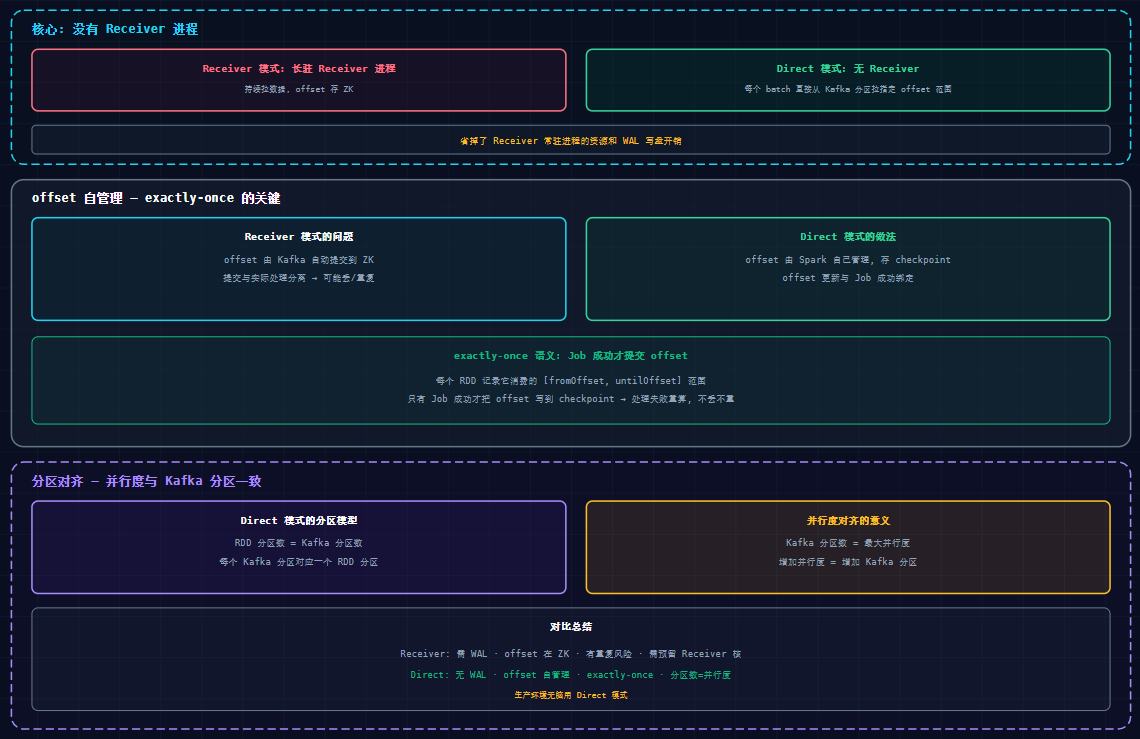
Direct 模式每个 batch 直接从 Kafka 分区拉取指定 offset 范围的数据,拉完就算,算完走人,不留长驻进程。
用代码看最直观:
scala
val stream = KafkaUtils.createDirectStream[String, String](
  ssc,
  PreferConsistent,                         // 位置策略
  Subscribe[String, String](topics, kafkaParams)  // 订阅策略
)
每个 batch 里,Spark 会为每个 Kafka 分区确定一个 offset 区间(fromOffset ~ untilOffset),然后 Executor 直接去 Kafka 把这区间数据拉回来,组成这个 batch 的 RDD。
三、offset 自管理:exactly-once 的由来
这是 Direct 模式最核心的价值。offset 不再交给 ZooKeeper,而是 Spark 自己管理、存在 checkpoint 里 ,并且 offset 的更新和 Job 的成功与否绑定:
- 每个 RDD 记录它消费的
[fromOffset, untilOffset]。 - 只有这个 Job 真正处理成功了,offset 才会被提交(写进 checkpoint)。
- Job 失败 → 不提交 offset → 重算时从原 offset 重新拉,数据不丢也不重。
这就是 exactly-once 的来源。Receiver 模式做不到这点,因为它管不住 offset 的提交时机。
四、分区对齐:并行度由 Kafka 分区决定
Direct 模式里,RDD 的分区数 = Kafka 的分区数,每个 Kafka 分区对应一个 RDD 分区。这带来一个直接的推论:
想提高并行度,就增加 Kafka 分区数;反过来,Executor 再多,如果 Kafka 分区只有 3 个,并行度也上不去(一个 batch 最多 3 个 task)。
所以 Direct 模式下,调并行度不能光看 executor 数,得先看 topic 的分区数。这也是做容量规划时容易忽略的一点。
五、两个参数:LocationStrategies 和 ConsumerStrategies
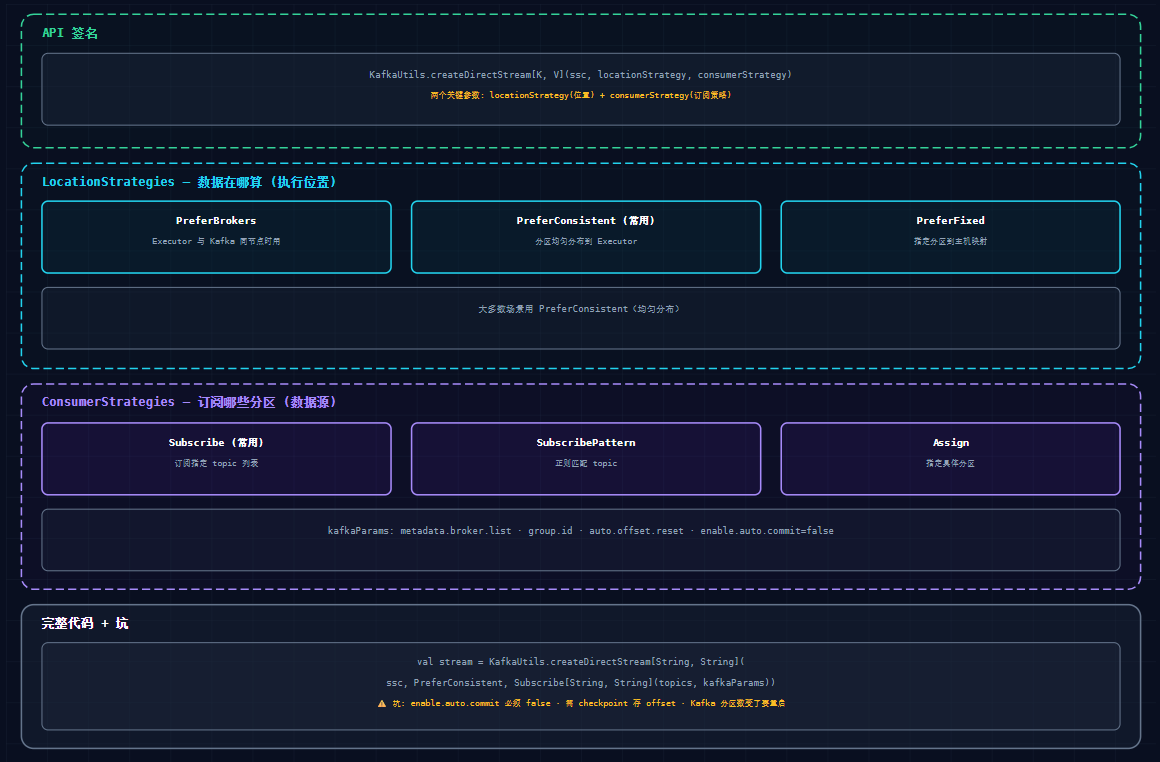
createDirectStream 的两个关键参数,分别回答"在哪算"和"算哪些"。
LocationStrategies(位置策略)
决定 Kafka 分区数据放在哪个 Executor 上处理:
PreferConsistent:分区均匀分布到所有 Executor。大多数场景用它。PreferBrokers:Executor 和 Kafka broker 同节点时用,能走本地读。PreferFixed:手动指定分区到主机的映射,一般用不上。
ConsumerStrategies(订阅策略)
决定订阅哪些 topic/分区:
Subscribe:订阅指定 topic 列表。最常用。SubscribePattern:用正则匹配 topic。Assign:显式指定要消费的具体分区。
六、完整代码 + 三个坑
scala
import org.apache.spark.streaming.kafka010._
import org.apache.kafka.common.serialization.StringDeserializer

val kafkaParams = Map[String, Object](
  "bootstrap.servers" -> "broker1:9092,broker2:9092",
  "key.deserializer" -> classOf[StringDeserializer],
  "value.deserializer" -> classOf[StringDeserializer],
  "group.id" -> "streaming-app",
  "auto.offset.reset" -> "latest",
  "enable.auto.commit" -> (false: java.lang.Boolean)   // 必须 false
)

ssc.checkpoint("hdfs://namenode:8020/checkpoint/app")

val stream = KafkaUtils.createDirectStream[String, String](
  ssc, PreferConsistent,
  Subscribe[String, String](Array("topic-a"), kafkaParams)
)
三个容易踩的坑:
enable.auto.commit必须设 false。Direct 模式的 offset 由 Spark 自己管,如果不关掉 Kafka 的自动提交,就会有两套 offset 在打架,exactly-once 就废了。- 必须开 checkpoint。offset 存在 checkpoint 里,不开 checkpoint,Driver 挂了 offset 就丢,重启后不知道从哪继续。
- Kafka 分区数变了要重启。Direct 模式把 offset 按分区记在 checkpoint 里,如果运行时新增/减少 Kafka 分区,offset 对不上,会报错,需要重启应用并清理 checkpoint。
七、总结
- Direct 模式去掉 Receiver,直接按 offset 区间从 Kafka 分区拉数据,省掉长驻进程、WAL、ZK 这套负担。
- offset 由 Spark 自管理、存 checkpoint,且与 Job 成功绑定,从而拿到 exactly-once。
- 分区对齐意味着并行度 = Kafka 分区数,调并行度先看分区。
- LocationStrategies 常用 PreferConsistent,ConsumerStrategies 常用 Subscribe。
- 三个坑:auto.commit 设 false、必须开 checkpoint、分区数变更要重启。
作者 :大数据技术实践者
博客 :blog.starzy.cn
GitHub :starzy1990.github.io
专注 AI Agent · LangGraph · RAG · 大数据架构 · 数据工程实践