今天我们来看CSP202203C.计算资源调度器这道题目
题意分析
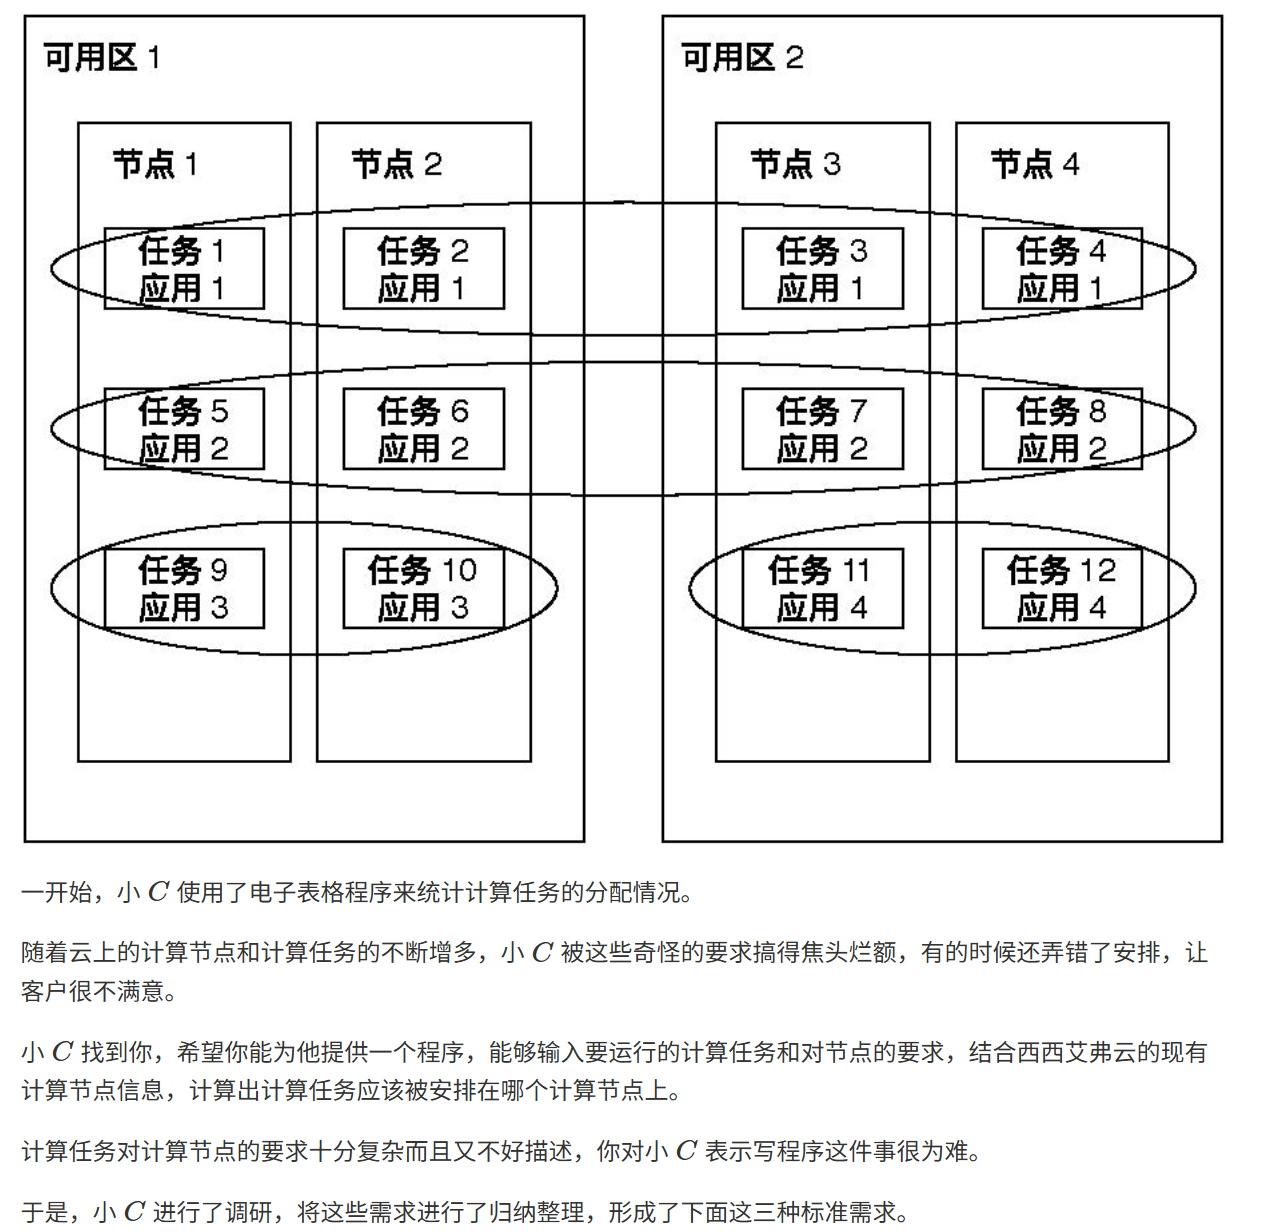
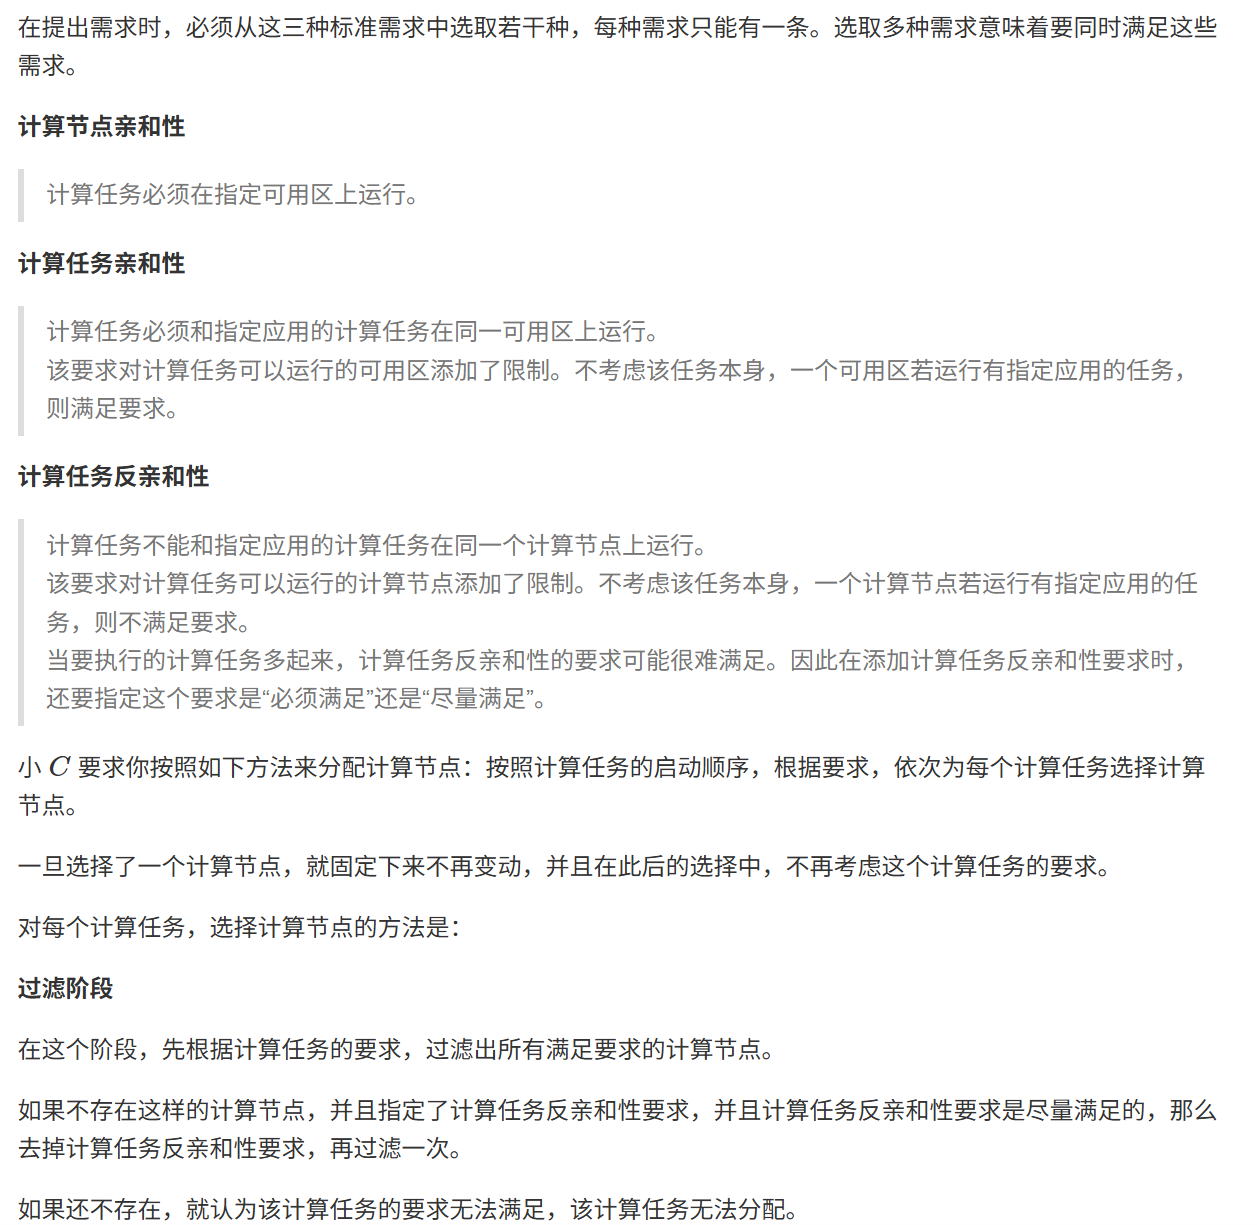
本题要求我们模拟一个云计算平台的资源调度过程。平台有 n 个计算节点,分布在 m 个可用区中。需要按照启动顺序为计算任务分配计算节点,每个任务可能有以下三种约束条件:
- 计算节点亲和性:任务必须在指定可用区上运行
- 计算任务亲和性:任务必须和指定应用的任务在同一可用区运行
- 计算任务反亲和性:任务不能和指定应用的任务在同一节点运行(分为必须满足和尽量满足)
分配规则:
- 先过滤出所有满足要求的节点
- 如果无可用节点且反亲和性是"尽量满足",则去掉反亲和性约束重新过滤
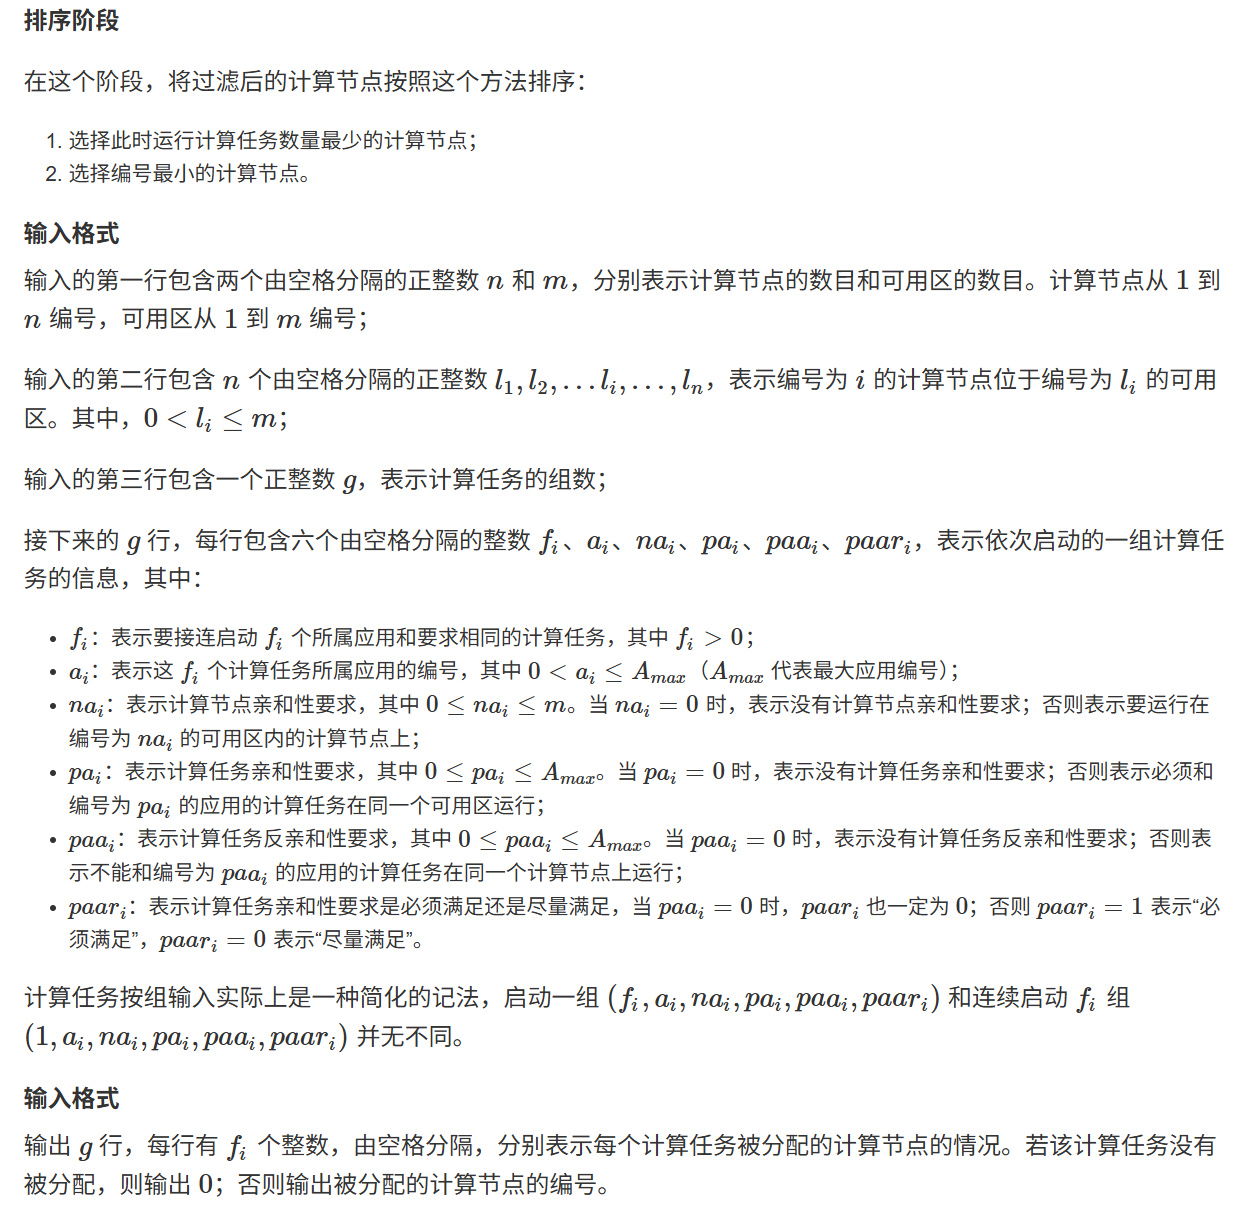
- 在候选节点中选择任务数最少、编号最小的节点
解题思路
1. 数据结构设计
- 使用结构体存储每个节点的信息:所在可用区、任务数量、运行的应用集合
- 使用
unordered_map<int, unordered_set<int>>记录每个应用运行在哪些可用区 - 使用
vector<vector<int>>按可用区分组节点,便于快速筛选
2. 核心算法
过滤阶段:
- 根据节点亲和性确定初始候选池(指定可用区或全部节点)
- 依次检查任务亲和性和反亲和性约束
- 如无候选节点且反亲和性为"尽量满足",去掉该约束重新过滤
排序阶段:
- 遍历候选节点,选择任务数最少的节点
- 任务数相同时选择编号最小的节点
3. 优化技巧
- 使用
unordered_set代替set,将查找复杂度从 O(log n) 降至 O(1) - 根据节点亲和性预先缩小候选范围
- 合并过滤和排序阶段,避免重复遍历
- 使用快速 I/O 提升读写速度
代码实现
cpp
#include <iostream>
#include <vector>
#include <map>
#include <set>
#include <unordered_map>
#include <unordered_set>
#include <algorithm>
#include <climits>

using namespace std;

struct Node {
    int zone;
    int task_count;
    unordered_set<int> apps;  // 该节点上运行的应用集合

    Node() : zone(0), task_count(0) {}
};

int main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);

    int n, m;
    cin >> n >> m;

    vector<Node> nodes(n + 1);
    for (int i = 1; i <= n; i++) {
        cin >> nodes[i].zone;
        nodes[i].task_count = 0;
    }

    // 按可用区分组节点
    vector<vector<int>> zone_nodes(m + 1);
    for (int i = 1; i <= n; i++) {
        zone_nodes[nodes[i].zone].push_back(i);
    }

    // 记录每个应用运行在哪些可用区
    unordered_map<int, unordered_set<int>> app_zones;

    int g;
    cin >> g;

    while (g--) {
        int f, a, na, pa, paa, paar;
        cin >> f >> a >> na >> pa >> paa >> paar;

        vector<int> result;
        result.reserve(f);

        for (int task = 0; task < f; task++) {
            int selected_node = 0;
            int min_tasks = INT_MAX;

            // 确定候选节点范围
            vector<int>* candidate_pool;
            vector<int> all_nodes;

            // 根据节点亲和性确定初始候选池
            if (na != 0) {
                candidate_pool = &zone_nodes[na];
            } else {
                // 所有节点
                all_nodes.reserve(n);
                for (int i = 1; i <= n; i++) {
                    all_nodes.push_back(i);
                }
                candidate_pool = &all_nodes;
            }

            // 第一次尝试:应用所有约束
            for (int node_id : *candidate_pool) {
                bool ok = true;

                // 计算任务亲和性
                if (pa != 0) {
                    if (app_zones[pa].find(nodes[node_id].zone) == app_zones[pa].end()) {
                        ok = false;
                    }
                }

                // 计算任务反亲和性
                if (ok && paa != 0 && nodes[node_id].apps.count(paa)) {
                    ok = false;
                }

                if (ok) {
                    // 选择任务数最少、编号最小的节点
                    if (nodes[node_id].task_count < min_tasks ||
                        (nodes[node_id].task_count == min_tasks &&
                         (selected_node == 0 || node_id < selected_node))) {
                        min_tasks = nodes[node_id].task_count;
                        selected_node = node_id;
                    }
                }
            }

            // 如果没有找到且反亲和性是"尽量满足"
            if (selected_node == 0 && paa != 0 && paar == 0) {
                // 去掉反亲和性约束重新查找
                min_tasks = INT_MAX;
                for (int node_id : *candidate_pool) {
                    bool ok = true;

                    // 计算任务亲和性
                    if (pa != 0) {
                        if (app_zones[pa].find(nodes[node_id].zone) == app_zones[pa].end()) {
                            ok = false;
                        }
                    }

                    if (ok) {
                        if (nodes[node_id].task_count < min_tasks ||
                            (nodes[node_id].task_count == min_tasks &&
                             (selected_node == 0 || node_id < selected_node))) {
                            min_tasks = nodes[node_id].task_count;
                            selected_node = node_id;
                        }
                    }
                }
            }

            // 如果找到节点,更新状态
            if (selected_node != 0) {
                nodes[selected_node].task_count++;
                nodes[selected_node].apps.insert(a);
                app_zones[a].insert(nodes[selected_node].zone);
            }

            result.push_back(selected_node);
        }

        // 输出结果
        for (int i = 0; i < result.size(); i++) {
            if (i > 0) cout << " ";
            cout << result[i];
        }
        cout << "\n";
    }

    return 0;
}
复杂度分析
- 时间复杂度:O(g × f × n),其中 g 是任务组数,f 是每组任务数,n 是节点数。在实际运行中,由于使用了候选池优化和哈希表,实际复杂度会更低
- 空间复杂度:O(n + m),用于存储节点信息、可用区分组和应用分布信息
总结
本题是一个典型的资源调度问题,关键在于:
- 正确理解并实现三种约束条件的过滤逻辑
- 处理"尽量满足"的反亲和性约束
- 合理使用数据结构优化查询效率
- 注意边界条件和状态更新的时机
通过这道题可以加深对哈希表、贪心算法和模拟类问题的理解和应用能力。