目录
前言
上一篇我们完整梳理了深度学习的整套训练流程。本篇延续之前介绍的四大核心组件:数据、模型、损失函数、优化器,完成经典手写数字识别实战案例。本次重在跑通完整工程流程,不会深挖底层数学原理,带你从零实现一个简易手写数字分类网络。
一、数据准备
首先导入 PyTorch 生态需要用到的依赖包:torch 作为基础框架,nn 用来搭建网络模块,DataLoader 实现批量读取数据,torchvision 提供公开数据集与图像预处理工具。
python
import torch
from torch import nn                         # 搭建神经网络
from torch.utils.data import DataLoader      # 批量加载数据
from torchvision import datasets              # 内置公开数据集
from torchvision.transforms import ToTensor   # 图像转为张量Tensor
手写数字识别是深度学习计算机视觉领域的经典入门多分类任务,核心目标是精准识别并区分 0~9 十种手写数字。本实验采用主流的 MNIST 手写数字数据集,可通过 torchvision 库直接在线下载调用,无需手动整理数据。
数据集样本效果如下图所示,我们将以这类手写数字图像作为训练样本完成分类任务。值得注意的是,代码下载的原始数据集为二进制格式,需通过 ToTensor 预处理转换为模型可运算的张量数据。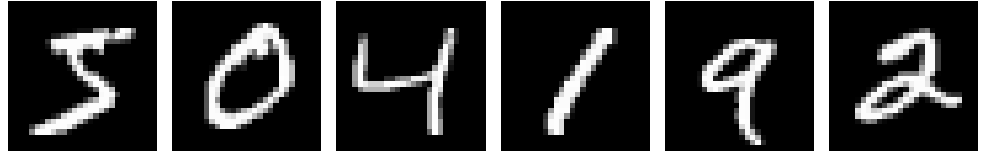
API 说明: datasets.MNIST(root, train, download, transform)
- root:数据集存放 / 读取的本地路径
- train:布尔值,True代表训练集,False代表测试集
- download:是否自动在线下载数据集
- transform:数据预处理操作,将图片转为模型可计算的张量格式
MNIST 官方已经提前划分好数据集:训练集 60000 张样本 ,测试集 10000 张样本。
python
training_data = datasets.MNIST(
    root='./data',
    train=True,
    download=True,
    transform=ToTensor(),
)
# 构建测试集
test_data = datasets.MNIST(
    root='./data',
    train=False,
    download=True,
    transform=ToTensor(),
)
为直观观察数据集样本特征,我们编写可视化代码,随机展示6张MNIST手写数字样本,清晰查看图像形态与对应标签。
python
数据集样本可视化# 可视化展示数据集样本
num_show = 6  # 定义展示样本数量
fig, axes = plt.subplots(1, num_show, figsize=(10, 3))
遍历样本完成绘图展示
for i in range(num_show):
    img, label = training_data[i]
    axes[i].imshow(img.squeeze(), cmap='gray')  # 灰度图展示
    axes[i].set_title(f'Label: {label}')         # 显示对应真实标签
    axes[i].axis('off')                         # 隐藏坐标轴,界面更整洁
plt.tight_layout()  # 自适应布局
plt.show()          # 展示图像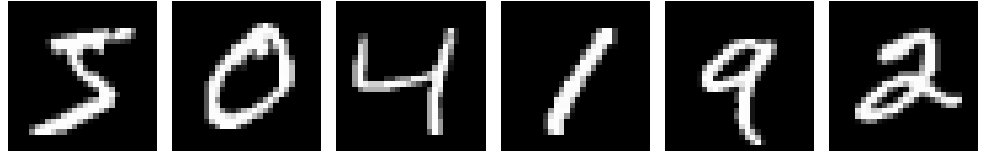
全部数据一次性送入内存或 GPU 训练会造成显存溢出、程序崩溃,工程上采用小批量迭代训练 ,借助DataLoader实现分批加载、打乱数据。
API 说明: DataLoader(data, batch_size, shuffle)
- batch_size:每一批次读取多少张图片,这里设置为 64
- shuffle:是否打乱样本顺序;训练集打乱防止过拟合,测试集不需要打乱
python
train_dataloader = DataLoader(training_data, batch_size=64, shuffle=True)
test_dataloader = DataLoader(test_data, batch_size=64, shuffle=False)
二、搭建网络模型
自定义网络类net,必须继承 nn.Module,这是 PyTorch 自定义模型的规范。
- nn.Sequential:串行容器,把多层操作按顺序拼接,上一层输出直接作为下一层输入
- nn.Flatten():把
的二维图片拉直成一维 784 长度的特征向量
- nn.Linear(in_dim, out_dim):全连接层,本质就是特征矩阵
- nn.Sigmoid():激活函数,引入非线性变换,将数值压缩到
本次搭建三层全连接感知机:
输入层:
隐藏层:
输出层:
最终输出 10 个数字类别的预测得分
forward函数定义前向传播逻辑,输入图片张量,返回网络预测结果。
python
class net(nn.Module):
    def __init__(self):
        super().__init__()
        self.classifier = nn.Sequential(
            nn.Flatten(),
            nn.Linear(28*28, 128),
            nn.Sigmoid(),
            nn.Linear(128,256),
            nn.Sigmoid(),
            nn.Linear(256, 10)
        )
    def forward(self,x):
        y = self.classifier(x)
        return y
自动判断运行设备:优先使用 NVIDIA 显卡cuda,苹果芯片使用mps,无加速硬件则使用 CPU,提升代码跨平台兼容性。最后把模型迁移到对应设备上。
python
device = torch.device('cuda' if torch.cuda.is_available() else "mps" if torch.backends.mps.is_available() else "cpu" )
model = net()
model.to(device)
三、损失函数
多分类任务选用交叉熵损失函数 CrossEntropyLoss,专门用来衡量分类任务预测值和真实标签之间的误差。
python
losser = nn.CrossEntropyLoss()四、优化算法
采用 SGD 随机梯度下降优化器,更新网络权重参数;lr代表学习率,控制每次参数更新的步长。
model.parameters():绑定模型所有可学习权重参数w,后续反向传播算出的参数梯度 w.grad,会自动同步给该优化器
python
optimizer = torch.optim.SGD(model.parameters(), lr=0.1)五、训练函数
PyTorch 深度学习训练遵循四大固定核心步骤,也是模型参数迭代优化的核心逻辑,步骤顺序有严格规范,是模型正常收敛的关键:
- 梯度清零 :optimizer.zero_grad()。每一批次训练开始前,必须清空上一轮批次累积的梯度。若不清零,梯度会持续累加,导致参数更新出错,模型无法收敛。
- 前向传播 :输入数据至模型,计算预测结果与真实标签的损失值。该步骤可与梯度清零调换顺序,但必须在反向传播之前完成梯度清零。
- 反向传播求梯度 :loss.backward()。根据损失值反向链式求导,自动计算模型所有可学习参数
- 参数更新 :optimizer.step()。优化器自动读取参数存储的梯度,结合预设学习率,通过梯度下降公式更新模型权重,完成一轮参数优化。
训练函数除完成核心迭代流程外,还会累计每一轮训练的全局损失与分类准确率,最终输出量化训练指标,直观反馈模型训练效果。完整带规范注释的训练代码如下:
python
def train(model,device,train_dataloader,loss_fn,optimizer):
    length = len(train_dataloader.dataset)  # 统计训练集总样本数
    num_batches = len(train_dataloader)      # 统计训练集总批次数量
    model.train()                            # 开启模型训练模式,启用梯度计算、训练专属网络层
    sum_loss = 0.0                           # 初始化全局累计损失
    correct = 0                              # 初始化预测正确样本计数器
    # 逐批次遍历训练数据,完成迭代训练
    for X,y in train_dataloader:
        X = X.to(device)                     # 将图像特征迁移至训练设备(GPU/MPS/CPU)
        y = y.to(device)                     # 将标签迁移至对应训练设备
        y_pred = model(X)                    # 前向传播,输出10个类别的预测分值,有batch个预测值
        loss = loss_fn(y_pred,y)             # 计算当前批次的平均交叉熵损失
        optimizer.zero_grad()                # 清空历史梯度,避免梯度累加
        loss.backward()                      # 反向传播,计算参数梯度并存入w.grad
        optimizer.step()                     # 优化器读取梯度,更新模型权重参数
        sum_loss += loss.item()              # 累加当前批次损失,统计全局总损失
        # 取预测概率最大值对应的类别,与真实标签对比,统计正确样本数
        correct += (y_pred.argmax(1) == y).sum().item()

    # 计算并打印本轮训练的平均准确率与平均损失
    print(f"平均准确率{correct / length:.4f},平均损失{sum_loss / num_batches:.4f} \n")
六、测试函数
测试阶段不需要更新权重,使用model.eval()关闭 dropout、bn 等训练专用层;torch.no_grad()关闭梯度计算节省显存,只做前向推理,评估模型在未知样本上的泛化能力。
python
def test(model,device,test_dataloader,loss_fn):
    length = len(test_dataloader.dataset)   # 测试集总样本数量(10000张)
    num_batches = len(test_dataloader)       # 测试集总批次数量
    model.eval()                             # 开启模型评估模式,关闭训练专属层(Dropout、BatchNorm等)
    sum_loss = 0.0                           # 初始化测试集总损失
    correct = 0                              # 初始化预测正确样本数
# 关闭梯度计算,节省显存、加速推理,避免测试阶段产生多余梯度
with torch.no_grad():
    # 逐批次遍历测试数据,完成模型推理
    for X,y in test_dataloader:
        X = X.to(device)                # 图像数据迁移至运算设备
        y = y.to(device)                # 标签数据迁移至运算设备
        y_pred = model(X)               # 前向推理,得到10个类别的预测分值
        loss = loss_fn(y_pred,y)        # 计算当前批次的测试损失
        sum_loss += loss.item()         # 累加批次损失,统计全局测试损失
        # 取最高分类别为预测结果,统计本轮预测正确的样本数量
        correct += (y_pred.argmax(1) == y).sum().item()
计算并输出测试集整体准确率与平均损失
print(f"测试集平均准确率{correct/length:.4f},测试平均损失{sum_loss/num_batches:.4f}")
七、主执行入口
设置迭代轮次epochs=10,循环完成多轮训练;训练全部结束后执行一次完整测试。
python
if __name__ == "__main__":
    epochs = 10
    print("开始训练")
    for i in range(epochs):
        print(f"第{i + 1}轮训练")
        train(model, device, train_dataloader, losser, optimizer)
    print("开始测试")
    test(model, device, test_dataloader, losser)
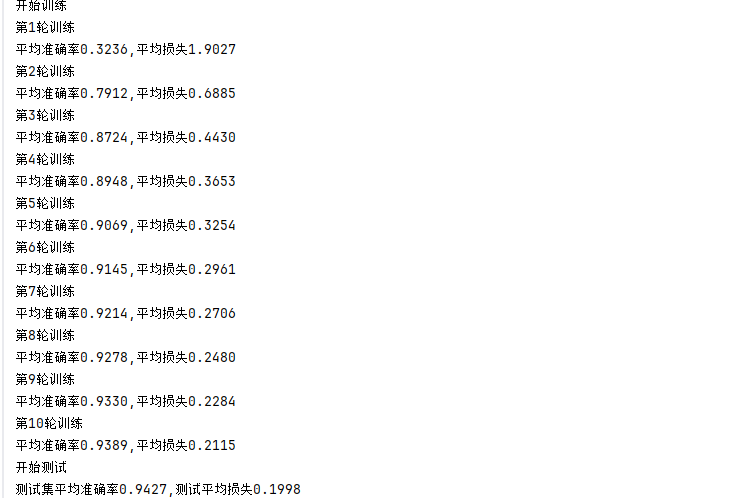
模型训练完成后,在未进行任何参数调优的基础条件下,测试集准确率即可达到 94% 左右,基础模型的分类效果表现优异,充分验证了本次搭建的全连接网络结构的有效性。训练输出结果如下:
总结
本次实验完整实现了基于全连接神经网络的 MNIST 手写数字识别任务,系统跑通了深度学习标准训练全流程,涵盖数据加载、模型搭建、损失计算、梯度反向传播与参数迭代优化等核心环节。本文重点在于夯实基础工程流程,后续将进一步讲解模型参数调优、网络结构优化等进阶内容,持续提升模型识别精度与泛化能力。