目录
[1. DQN and TD Learning](#1. DQN and TD Learning)
[2. Experience Replay](#2. Experience Replay)
[2.1 Benefits of Experience Replay](#2.1 Benefits of Experience Replay)
[3. Prioritized Experience Replay](#3. Prioritized Experience Replay)
1. DQN and TD Learning
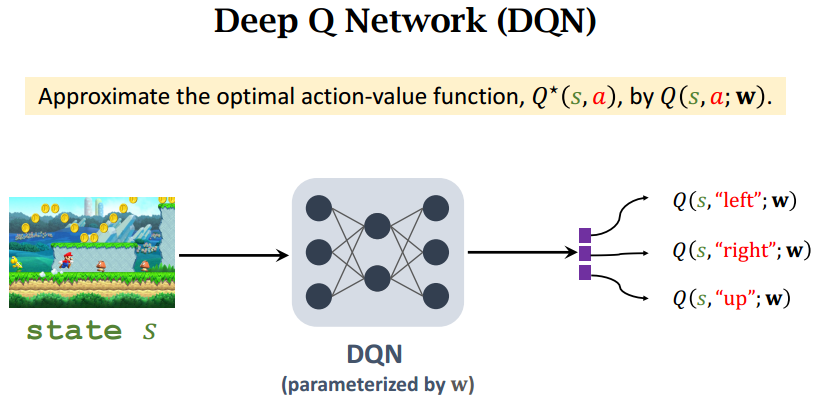
强化学习的目标就是学习到policy函数 或最优动作价值函数
去控制Agent,让Agent基于当前的状态
来做出相应的动作
,争取在未来得到尽量多的奖励。
由于我们并不知道 ,因此使用神经网络
来近似
。
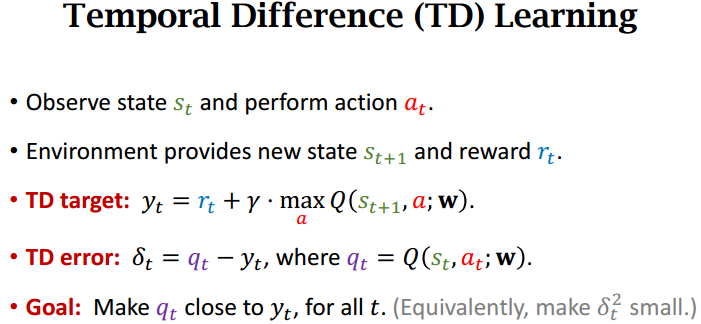
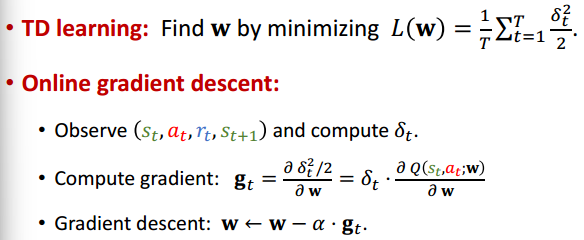
目标是让预测值尽可能接近 ,因此对参数
的更新如下。
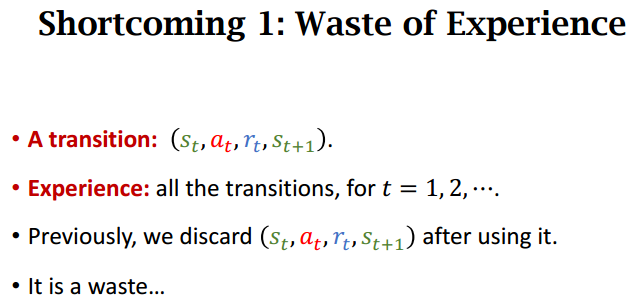
在使用过transition 后,会将transition
丢弃,这会造成经验的浪费。
按照顺序使用每一条transition 更新参数
,前后transition有很强的关联,实验证明这样的相关性是有害的,如果把序列打散,消除相关性,则有利于把DQN训练的更好。
2. Experience Replay
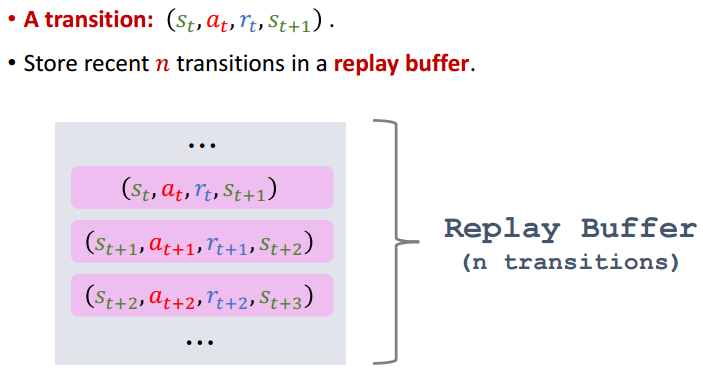
把transition存到一个容量为n的队列(Replay Buffer)里。如果队列已满,存入新的transition就得把早前存的的那个删除,然后再存储新的transition。
其中n是超参数,n通常很大,例如取 。
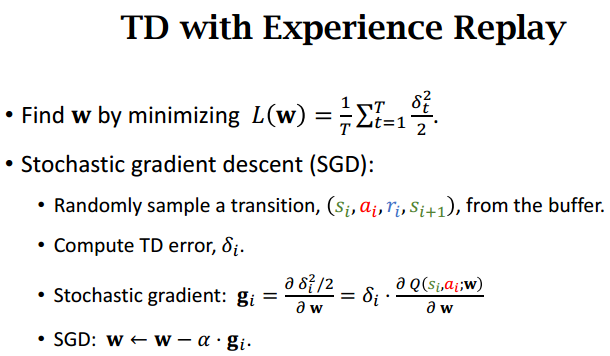
从Replay Buffer中随机抽取一个transition来更新参数 ,实践中通常使用minbatch SGD,每次随机抽取多个transition,算多个梯度,用梯度的平均来更新参数
。
2.1 Benefits of Experience Replay
- 打破transition序列的相关性
- 重新使用过去的经验多次
3. Prioritized Experience Replay
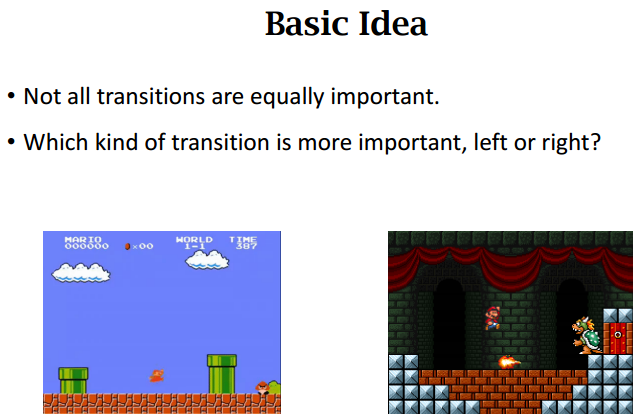
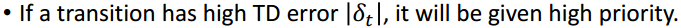
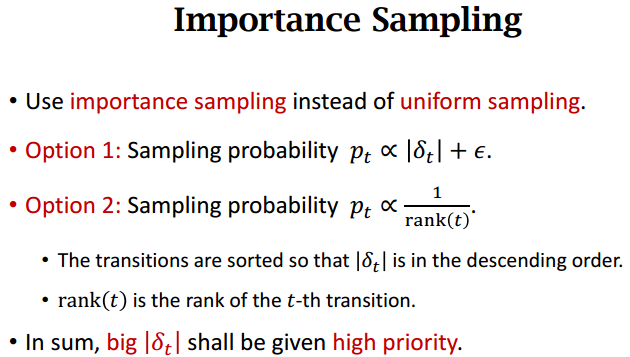
Prioritized Experience Replay与Experience Replay的区别就是用非均匀抽样代替均匀抽样。

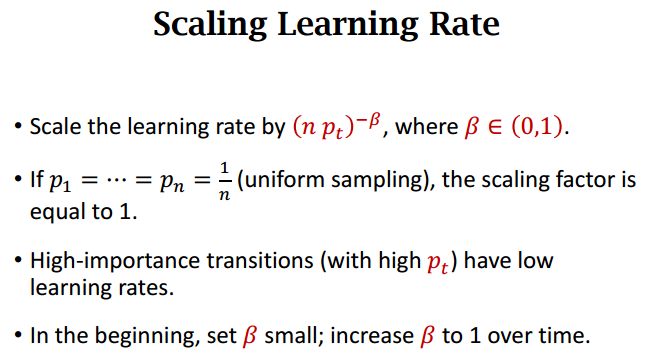
如果做均匀抽样,那么所有的transition都用相同的学习率;如果做非均匀抽样,根据抽样概率调整学习率, 即如果一条transition有较大的抽样概率,应该将它的学习率设置的比较小。
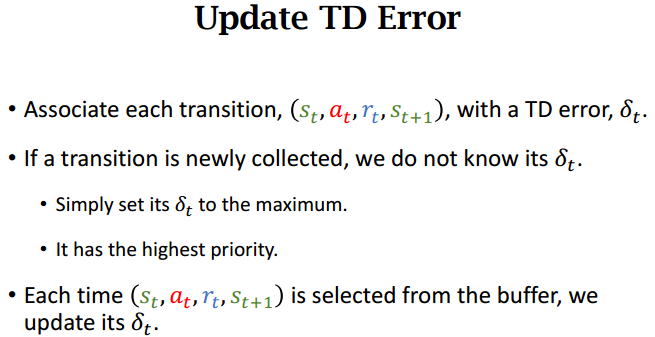
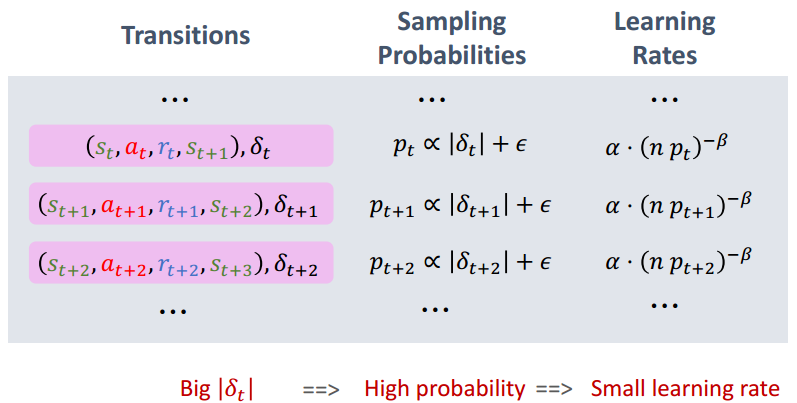
- 每一条transition
都被标上
- 如果一条transition是刚被收集到的,还没被用来训练DQN,所以并不知道它的
- 在训练DQN时,也要对
总而言之, 越大,那么抽样概率越大,进而学习率小,可抵消大抽样概率造成的偏差。