一套生产常用的 P0/P1/P2 分级告警设计。分级原则:P0=服务真没了、P1=资源告急快出事、P2=趋势预警早点看。按"越严重:报警越即时、抑制越短、通知越显眼"来配。
一、分级表(先定规矩)
| 级别 | 含义 | 触发→动作 | 典型 |
|---|---|---|---|
| P0 | 不可用/宕机,用户在哭 | 立即告警、不抑制 | 节点宕机、主服务全挂、DB失联、根盘95% |
| P1 | 资源告急,快撑不住 | ~5~10分钟内告 | CPU/内存/磁盘高水位、Pod频繁重启、OOM |
| P2 | 预警/关注,趋势提醒 | 可宽松点,避免噪音 | 水位预警、采集器丢数据、写盘停滞 |
二、告警规则样例(PromQL + 记录)
P0 ------ 不可用级
# 目标失联(服务/采集器挂了)
- alert: 节点宕机
  expr: up{job="node-exporter"} == 0
  for: 2m
  labels: { severity: critical, p: p0 }
  annotations:
    描述: "节点 {{ $labels.instance }} 持续失联 2 分钟"

# 采集目标普遍失联(整体挂了, 而非个别)
- alert: 采集目标大面积失联
  expr: (sum(up) / count(up)) < 0.8
  for: 10m

# 磁盘根分区写满(会拖垮整机)
- alert: 根分区使用率过高
  expr: (1 - (node_filesystem_avail_bytes{mountpoint="/"}
         / node_filesystem_size_bytes{mountpoint="/"})) * 100 > 90
  for: 5m
  labels: { severity: critical }
P1 ------ 资源告急级
# CPU 高(多核取平均, 用 1 - 空闲 避免瞬时毛刺)
- alert: CPU使用率过高
  expr: 100 - (avg by(instance)
        (rate(node_cpu_seconds_total{mode="idle"}[5m])) * 100) > 85
  for: 10m

# 内存高(减掉 buff/cache 才是真占用)
- alert: 内存使用率过高
  expr: (1 - node_memory_MemAvailable_bytes
        / node_memory_MemTotal_bytes) * 100 > 85
  for: 10m

# 磁盘数据盘 >80%
- alert: 磁盘使用率过高
  expr: (1 - node_filesystem_avail_bytes{mountpoint!~"/|/boot|/run"}
        / node_filesystem_size_bytes) * 100 > 80
  for: 15m

# Pod 频繁重启
- alert: Pod频繁重启
  expr: increase(kube_pod_container_status_restarts_total[15m]) > 3
  for: 5m

# 容器 OOM(加标签便于追哪个)
- alert: 容器OOMKilled
  expr: kube_pod_container_status_last_terminated_reason{reason="OOMKilled"} == 1
  for: 1m
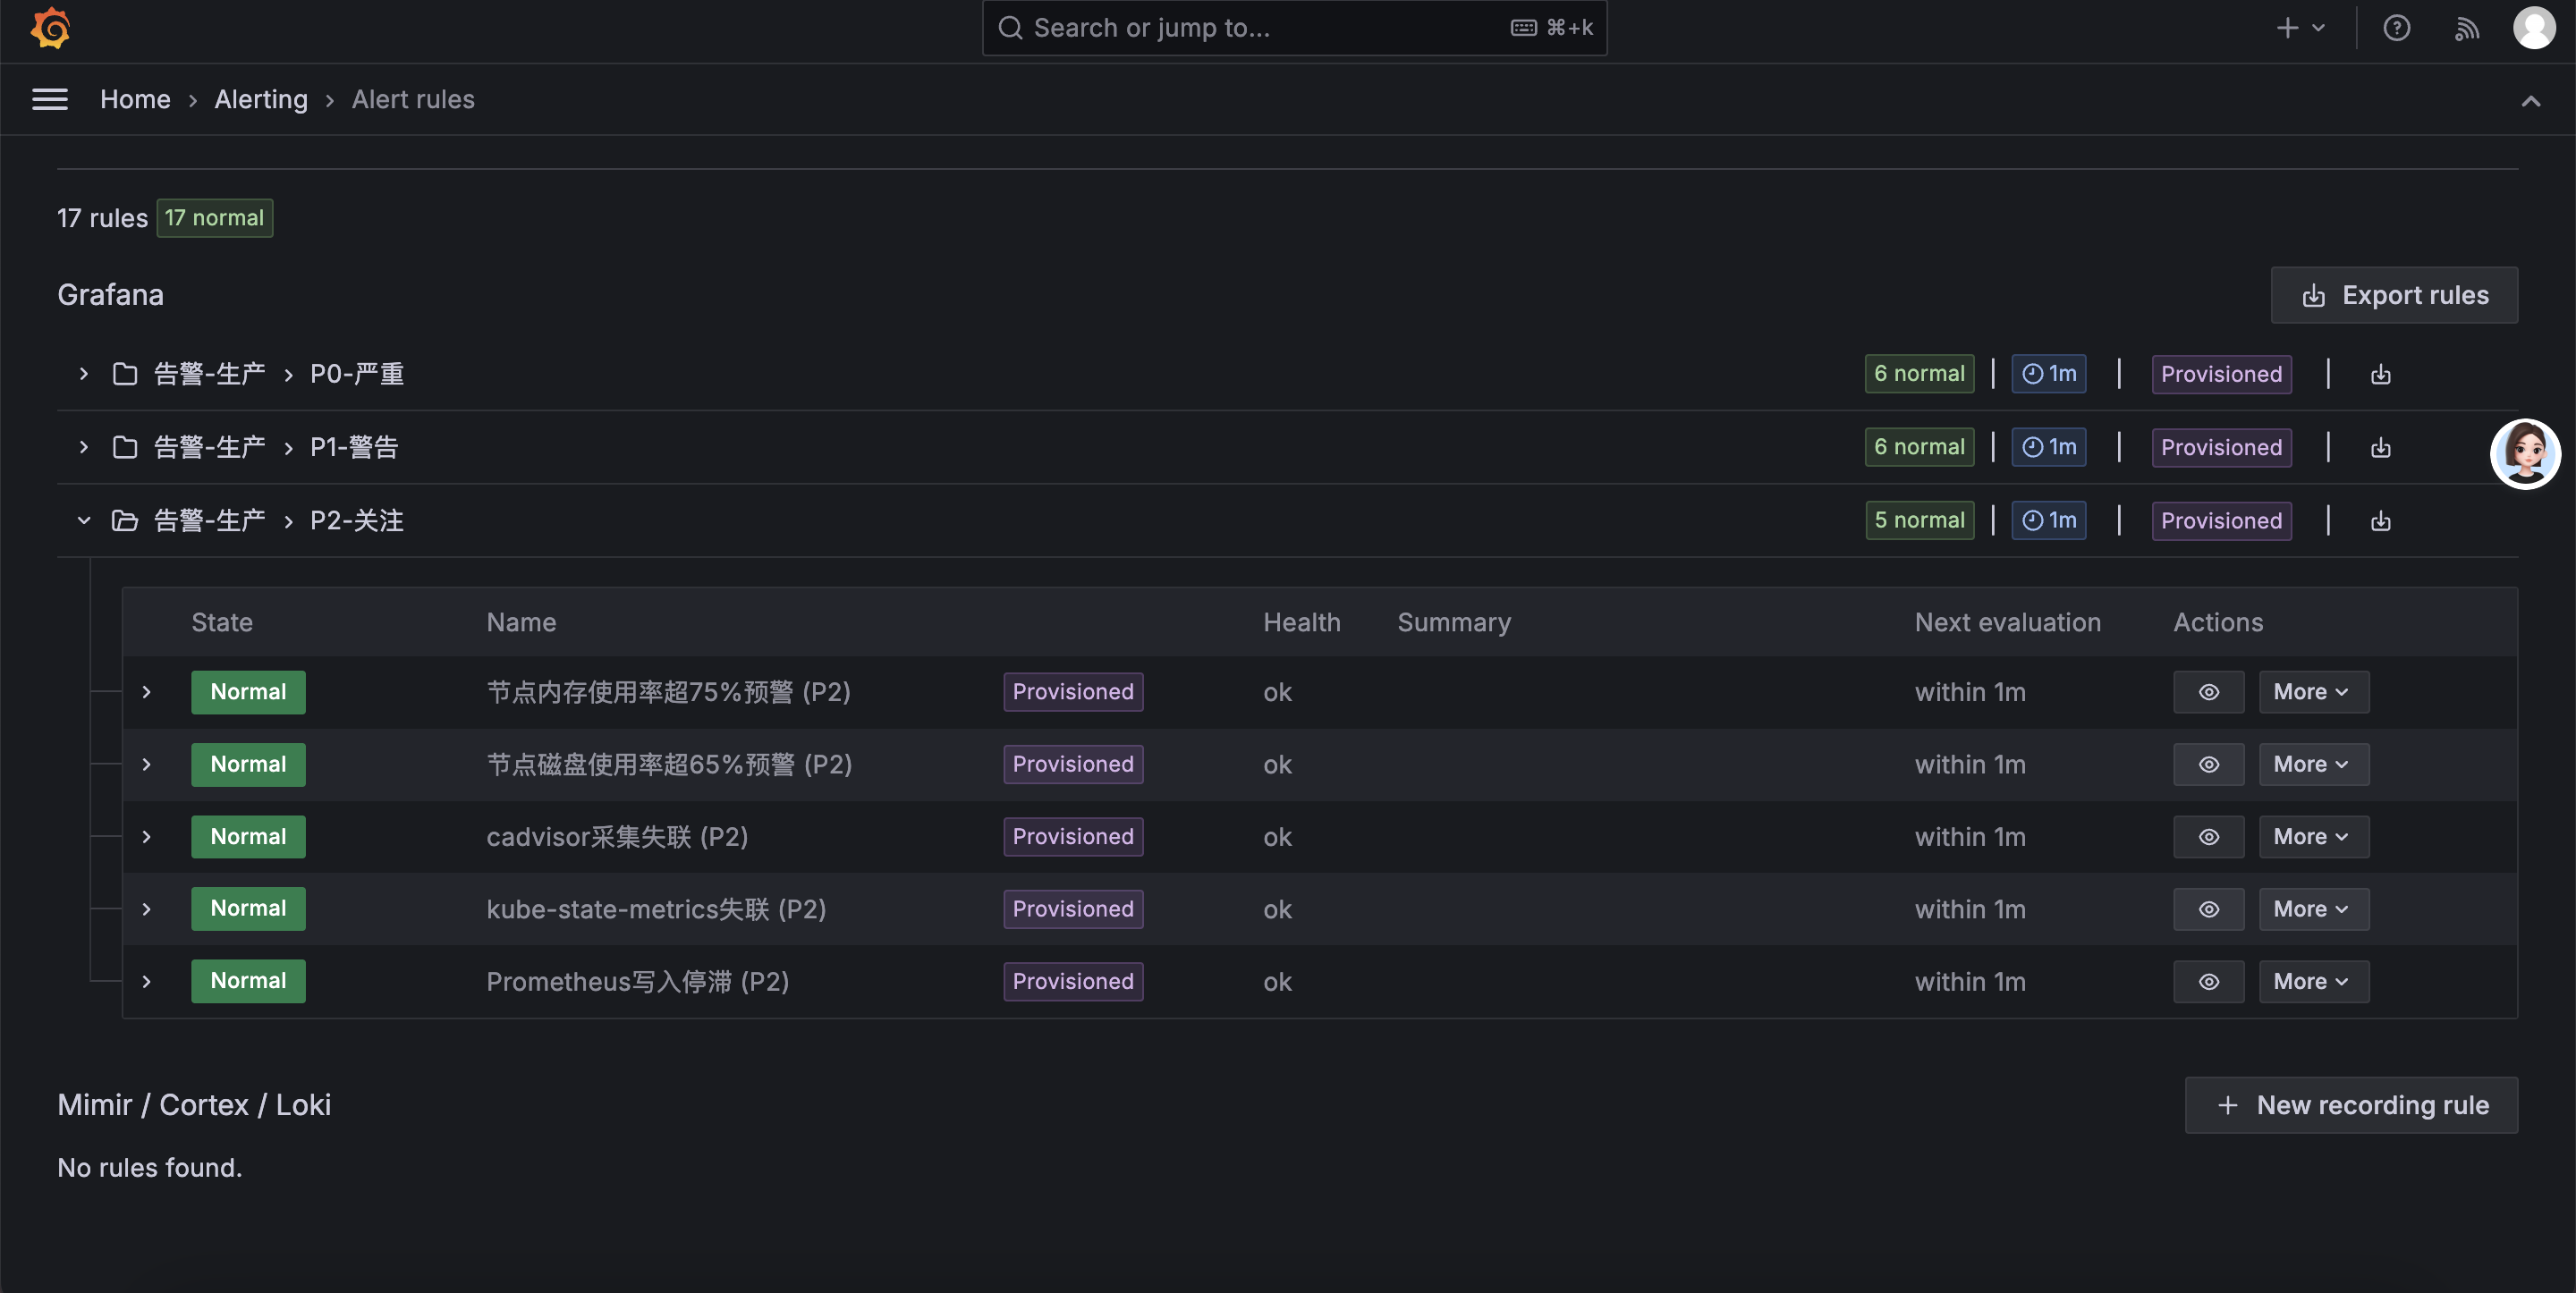
P2 ------ 关注/预警级Copy
# 高水位提前预警(阈值低于 P1, 提前介入)
- alert: 内存预警(P2)
  expr: (1 - node_memory_MemAvailable_bytes
        / node_memory_MemTotal_bytes) * 100 > 75
  for: 20m
  labels: { severity: warning }

# 写盘/写入停滞(用有意义的 label 过滤, 见"坑3")
- alert: 写入停滞
  expr: increase(prometheus_tsdb_head_samples_appended_total{type="float"}[5m]) == 0
  for: 15m

# 某采集目标掉线(区别于 P0 的大面积, 这里单点短时效)
- alert: 采集器失联
  expr: up{job="kube-state-metrics"} == 0
  for: 5m
三、通知策略(Grafana Alerting / Alertmanager)
建议两条主线:邮件沉淀 + 即时 @(钉钉/企微,可选,先不发可只走邮件)。
| 级别 | group_wait | group_interval | repeat_interval |
|---|---|---|---|
| P0 | 立即(或 ≤30s) | 5m | 1h(别停, 服务没恢复就要一直喊) |
| P1 | 30s | 10m | 3~4h |
| P2 | 30s | 10m | 半天~1天(少吵) |
关键点:P0 在服务恢复前不要用很长的 repeat 间隔,不然"用户已经在骂了,你的告警却不重复提醒"。
四、三个必踩的坑(亲测)
_total指标带多个 label 时,== 0会误报 。
increase(xxx[5m]) == 0常用来判"停滞",但如果指标有type=float/histogram等 label 分支,其中 histogram 一路恒为 0 → 条件恒真 → 天天误报 。
✅ 必须加过滤:{type="float"}只看真正在写的那一路。给这类"为0/停滞"告警写 PQL 前,先跑一遍看有没有恒 0 的旁支 label。- 内存/磁盘别用"总-用"或裸用 :内存要看 MemAvailable(已扣 buff/cache),磁盘根分区单独处理、别和挂载盘混在一个正则里。
- 空转/误报把提醒做烂,比"少告"更伤 :每条规则先想"它会不会天天假报",宁可加
for拉长、提阈值,也不要噪音告警。