本文整理于 HOW 2026 演讲内容,演讲者:郭铁成,pg4ml 创始人。
非线性回归的本质,是在线性回归的骨架------矩阵乘法与最小二乘法------之上,引入激活函数以增强模型的非线性表达能力。逻辑回归可视为矩阵乘法与 Sigmoid 激活函数及交叉熵损失函数的组合,而非线性回归则进一步将矩阵乘法与更丰富的激活函数、最小二乘类目标相结合,构成现代深度学习模型的基础范式。
本文从该核心逻辑出发,系统梳理了 PostgreSQL 自定义运算符(CREATE OPERATOR)的语法规范与限制,验证了矩阵乘法的关键运算性质(包括代数性质、几何变换性质及分块拼接性质)及其在大模型 KV Cache 优化中的底层原理,并重点介绍了两类具备完备表达能力的新型激活函数设计。在此基础上,本文进一步探讨了 AI 与数据库深度融合的技术路线与工程化前景。
一、PostgreSQL 自定义运算符(CREATE OPERATOR)语法规范
在 PostgreSQL 中,通过CREATE OPERATOR语法可以扩展自定义运算符,这是本次研究进行矩阵科学计算的基础工具。其语法核心要素如下:
- 运算符名称 :需避免与注释符(
--、/* */)或 SQL 保留符号(如=>)冲突,多字符名称不能以+或-结尾(除非包含~ ! @ # % ^ & |?`等字符)。 - 处理函数:指定该运算符调用的底层函数。
- 操作数类型:定义左操作数和右操作数的数据类型。
- 版本限制:PostgreSQL 14 版本以后不再支持右单目运算符,仅支持左单目运算符。
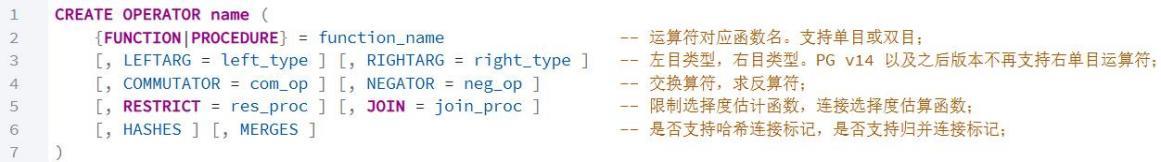
基于上述规范,本文定义了一套完整的矩阵运算运算符体系:
- 双目运算符:矩阵乘法(
|**|)、上下拼接(|-||)、左右拼接(||||)、元素级加法和乘法。 - 左单目运算符:上下翻转(
||~|)、左右翻转(|-~|)、旋转 180°(|~~|)、转置(|^~|)。 - 辅助函数:切片、平均值、标准差、开平方、幂运算等。
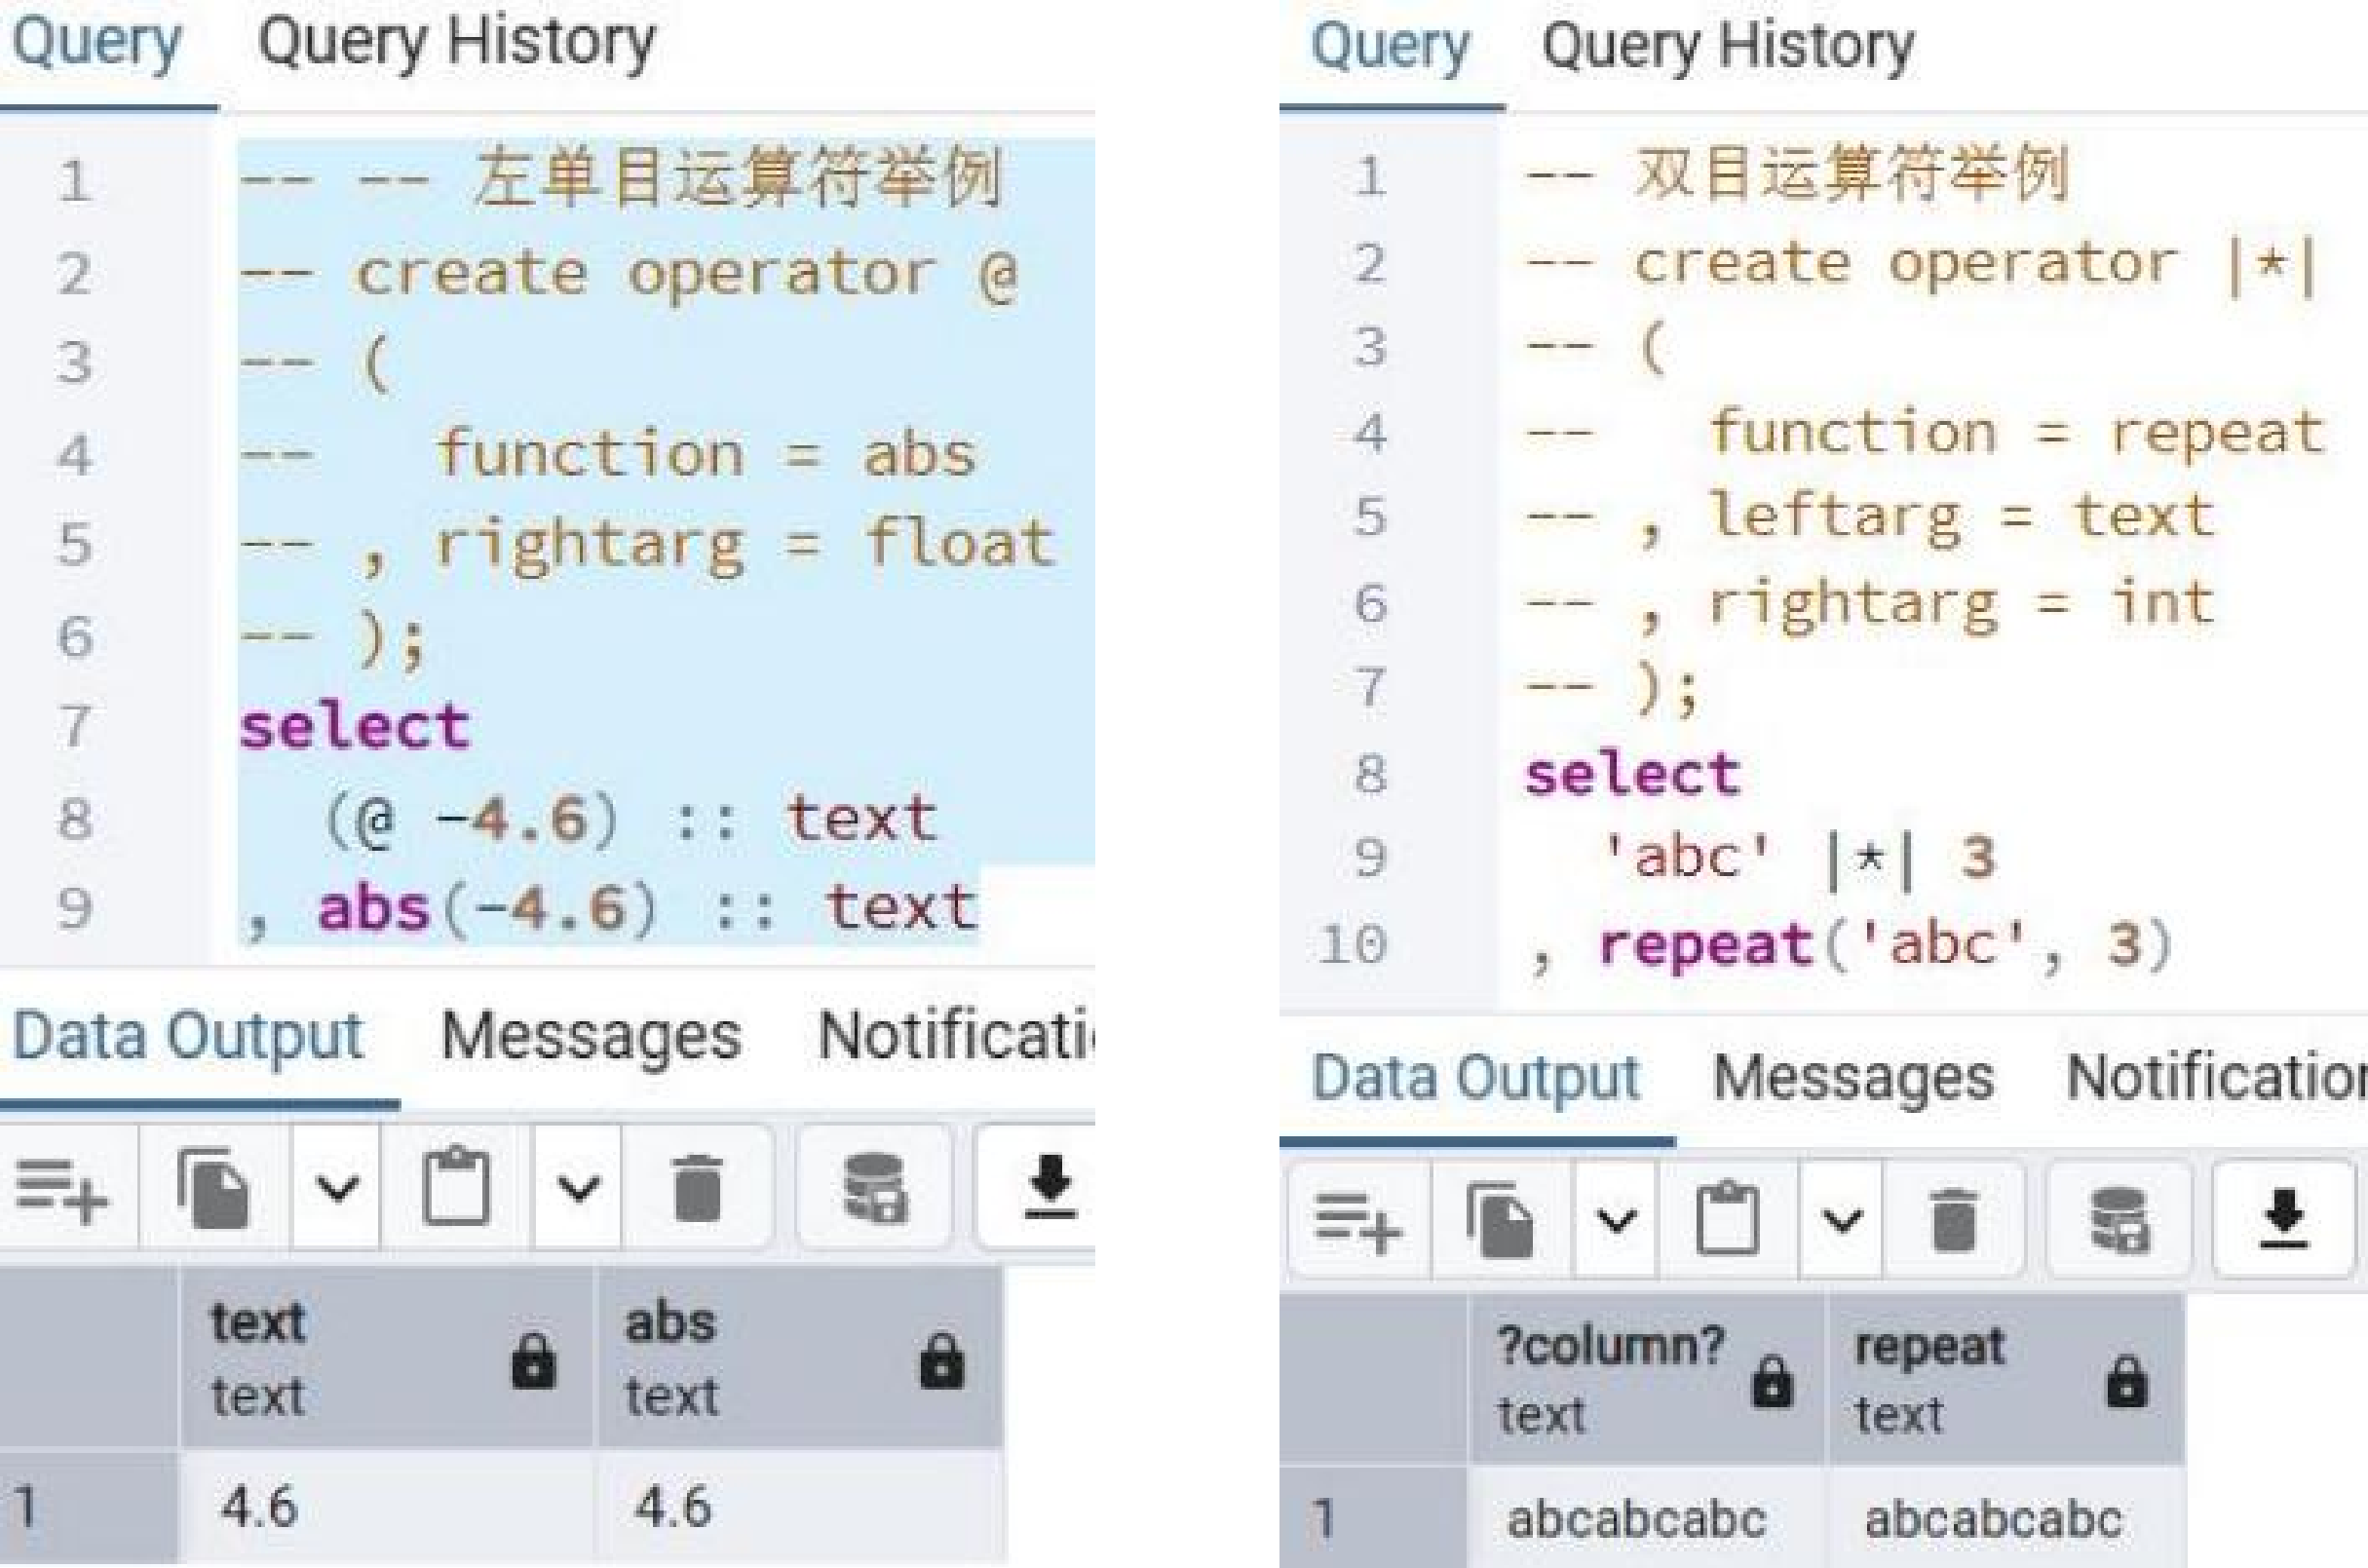
这些扩展使得 PostgreSQL 能够承担矩阵计算验证任务,为后续算子的库内实现提供执行基础。
二、矩阵乘法运算性质的归纳与应用
在 PostgreSQL 15 环境下,本文对矩阵乘法的核心性质进行了系统性验证与归纳,共涉及约 20 条性质。其中,分块拼接性质直接为大模型的 KV Cache 优化提供了数学依据。
1. 基本代数性质
- 交换律 :不满足(A×B≠B×AA \times B \neq B \times AA×B=B×A),维度不匹配时直接报错。
- 结合律 :满足,(AB)C=A(BC)(AB)C = A(BC)(AB)C=A(BC)。
- 分配律:满足左分配律和右分配律(因交换律不成立,需区分方向)。
2. 几何变换性质
- 左操作数上下翻转 → 结果上下翻转;右操作数左右翻转 → 结果左右翻转。
- 两操作数同时旋转 180° → 结果旋转 180°。
- 转置性质:(AB)T=BTAT(AB)^T = B^T A^T(AB)T=BTAT(先转置再交换位置)。
3. 分块拼接性质与 KV Cache 优化原理
将矩阵划分为多个子块进行分别计算后再拼接,结果保持不变。这一性质在大模型的KV Cache(键值缓存) 优化中具有关键作用:
- 将历史长文本对应的张量子块提取并缓存,避免重复计算。
- 当前快照相关的子块规模较小,仅需计算新增部分并与缓存结果拼接。
- 对于上下文长度可达数万乃至数十万的场景,该优化可大幅降低计算量,正是 Transformer 架构中 KV Cache 机制的数学本质。
三、机器学习算子分类与新型激活函数设计
1. 算子分类框架
机器学习算子可按功能划分为:
- 线性/初等运算:矩阵乘法、加减乘除、点乘。
- 非线性变换:激活函数、重分布函数(如 Softmax)。
- 滑窗类:用于 2D 张量的卷积、池化。
- 构造类:升维、降维、切片、拼接等。
- 损失函数虽在训练中计算梯度,但不参与计算图的张量流转,故不作为核心算子纳入。
2. 追求完备表达能力的新型激活函数
传统 ReLU(导数在原点不连续)和 Sigmoid(有界)存在明显瓶颈。本文设计了两类新型激活函数,旨在从数学上实现表达能力的完备性------即等价于高维空间的泰勒展开式。
(1)absqrt 函数
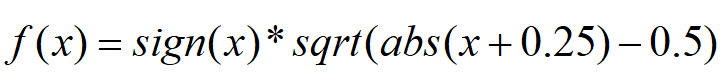
数学原理 :当 β=0.5\beta=0.5β=0.5 时,函数次数涵盖 0.5 次、0 次(偏移量)和 1 次(残差)。通过多层嵌套(如 ResNet 结构),可逐步演化出完备的多项式次数(0 次至 N 次)。这恰好对应泰勒展开式的多项式形式,因此该激活函数驱动的深度模型,在高维空间可完备地表达任意光滑流形。
(2)lnabsa1 函数
基于绝对值对数与正负号设计,自然对数部分本身接近泰勒展开(次数齐备),通过残差补充零次项,同样实现完备表达能力。
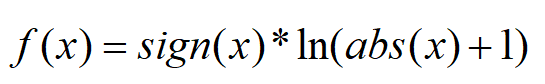
对比优势:
- 导数连续(优于 ReLU 在原点不连续)。
- 单调连续,且能表达正负无穷(优于 Sigmoid 的有界性)。
- 理论层面具备完备表达能力,为深度模型的可解释性提供了数学支撑。
四、AI 与数据库融合的技术路线展望
1. 数据库作为科学计算引擎
PostgreSQL 通过扩展自定义运算符和函数,已能够承担矩阵计算、算子验证等科学计算任务,具备发展为库内深度学习框架的潜力。
2. 工程化配套方向
要实现真正的 AI 与数据库融合,仍需补齐以下环节:
- 算力集群:支持 GPU 等异构计算资源的调度。
- 图形化交互:提供模型设计器,支持拖拉拽方式构建计算图。
- 流式响应:推理过程中支持流式数据输入输出。
3. 库内模型序列化与无代码构建
模型结构可通过库表字段进行序列化存储(仅需 2~3 张表即可完整表达)。这意味着模型构建可以不依赖代码编写,而是通过图形化界面配置计算图,实现"库内模型编排"而非"库内算力执行",降低 AI 应用的门槛。
4. 算力融合的观点
无论代码运行在 Python 环境还是数据库内部,模型推理均依赖 GPU 等硬件算力。数据库与算力并非对立关系,通过合理架构设计可实现数据流与计算任务的深度融合。算力本身不是瓶颈,如何将数据存储、计算调度和模型服务统一在数据库体系内,才是未来开源数据库生态的重要探索方向。
结语
本文从非线性回归的基本原理出发,展示了 PostgreSQL 在自定义运算符、矩阵运算性质验证、新型激活函数设计方面的实践成果,并对 AI 与数据库融合的技术路线进行了展望。随着开源生态的持续发展,数据库有望超越传统存储查询的定位,成为 AI 模型设计、训练和推理的统一平台。以开源之道,见致远之志,这一愿景正逐步走向现实。