问题描述
一张表记录了某个对象在不同时间点的状态值。每个时间点有一条记录,现在要按状态值是否发生变化来分段,输出每个状态的生效起始时间和结束时间------即把连续相同 value 的记录合并成一个时间段。
源数据:
| id | value | timestamp |
|---|---|---|
| 1 | A | 2024-01-01 10:00:00 |
| 1 | A | 2024-01-02 08:00:00 |
| 1 | A | 2024-01-03 12:00:00 |
| 1 | B | 2024-01-04 09:00:00 |
| 1 | B | 2024-01-05 14:00:00 |
| 1 | A | 2024-01-06 11:00:00 |
| 1 | A | 2024-01-07 16:00:00 |
| 2 | X | 2024-02-01 08:00:00 |
| 2 | X | 2024-02-02 09:00:00 |
| 2 | Y | 2024-02-03 10:00:00 |
期望结果(每个值连续出现的区间):
| id | value | effective_from | effective_to |
|---|---|---|---|
| 1 | A | 2024-01-01 10:00:00 | 2024-01-04 09:00:00 |
| 1 | B | 2024-01-04 09:00:00 | 2024-01-06 11:00:00 |
| 1 | A | 2024-01-06 11:00:00 | 9999-12-31 00:00:00 |
| 2 | X | 2024-02-01 08:00:00 | 2024-02-03 10:00:00 |
| 2 | Y | 2024-02-03 10:00:00 | 9999-12-31 00:00:00 |
以对象 1 为例:
-
前三条记录 value 都是 A,合并成一段:2024-01-01 ~ 2024-01-04(下一条变化的时间)
-
第四、五条 value 是 B,合并成一段:2024-01-04 ~ 2024-01-06(下一条变化的时间)
-
第六、七条 value 又变成 A,虽然值相同但中间被 B 隔断,所以作为新的一段:2024-01-06 ~ 无限远(最后一段结束时间为 9999-12-31)
SQLazy 分步实现
核心思路:按时间排序,判断当前行 value 是否发生变化。如果变化,则新开一组;否则归入同一组。最后取每组的最小时间作为起始时间,下一组的最小时间作为结束时间。
|-----------|------------|-----------------------------------------------------------------------------------|
| Value | Anchor | Statement |
| t1 | events | sort timestamp |
| t2 | | segment value; change; as gid |
| t3 | | summarize timestamp first as effective_from, id first as id; group gid, value |
| t4 | | compute nvl(effective_from1, datetime("9999-12-31 00:00:00")) as effective_to |
| | | derive delete gid |
下面逐一解释这些步骤。
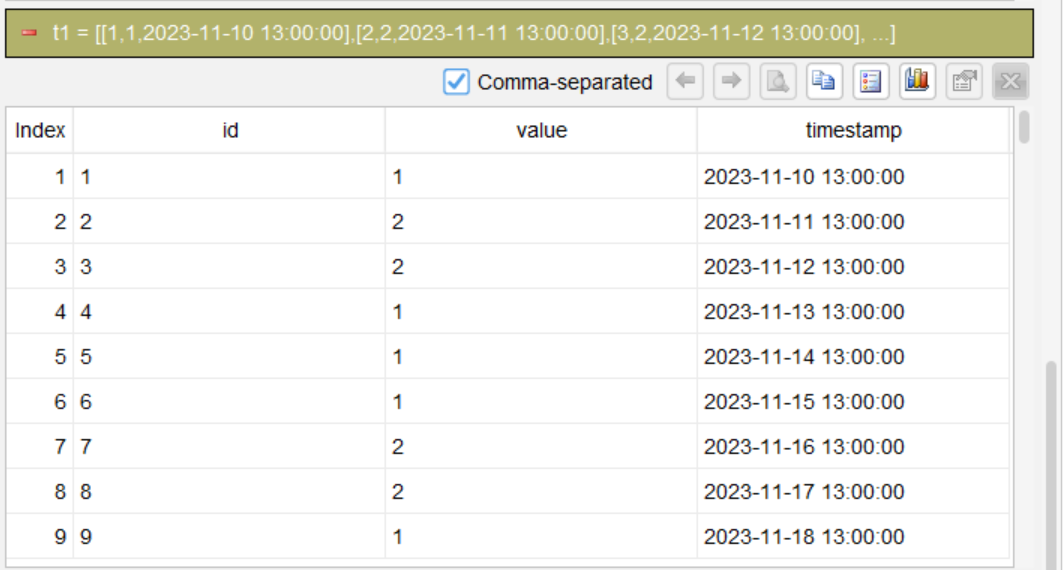
第 1 步:按时间升序排序
sort timestamp
将数据按 timestamp 升序排列,确保记录按时间先后处理。
第 2 步:值变化时新开一组
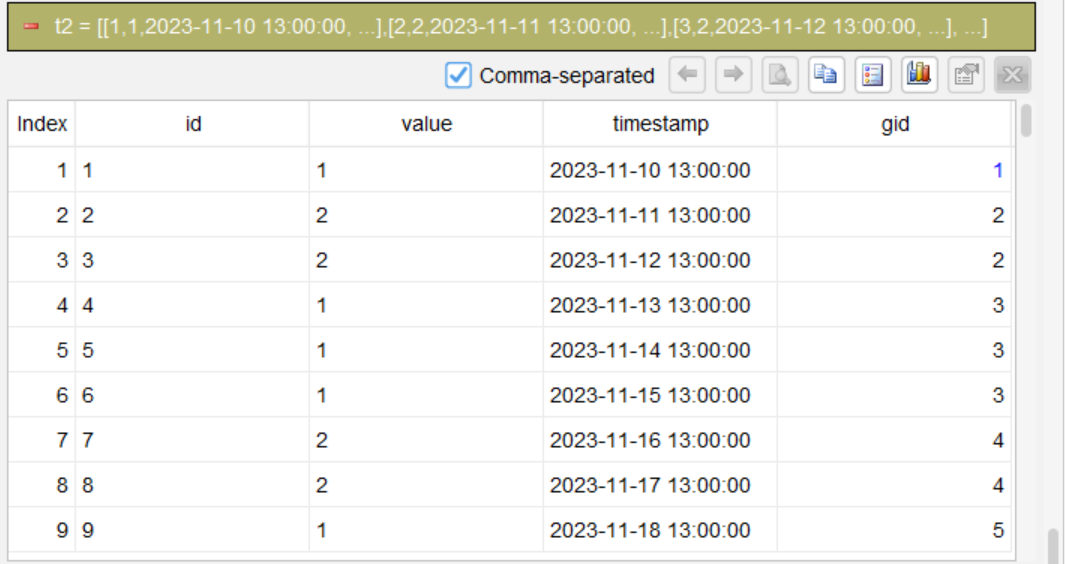
segment value; change; as gid
这是最核心的一步。segment 语句按 value 字段进行分段:每当 value 发生变化,就新开一个组,生成组号 gid。同一段内 value 保持不变。
第 3 步:按组号和值汇总,取起始时间
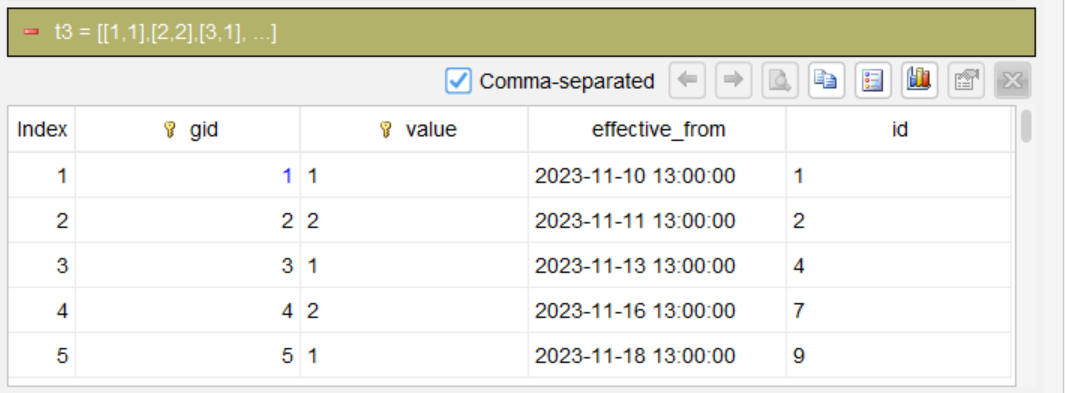
summarize timestamp first as effective_from, id first as id; group gid, value
按 gid 和 value 分组:
-
timestamp 取组内第一条记录的时间(first)作为该状态的生效起始时间
-
id 取组内第一个值
第 4 步:计算生效结束时间
*compute nvl(effective_from1, datetime("9999-12-31 00:00:00")) as effective_to*
effective_from1 取当前组下一行的 effective_from 值,作为当前组的结束时间。如果当前组是最后一组(effective_from1 为空),则用 nvl 设置为极大日期(9999-12-31)表示 "至今"。
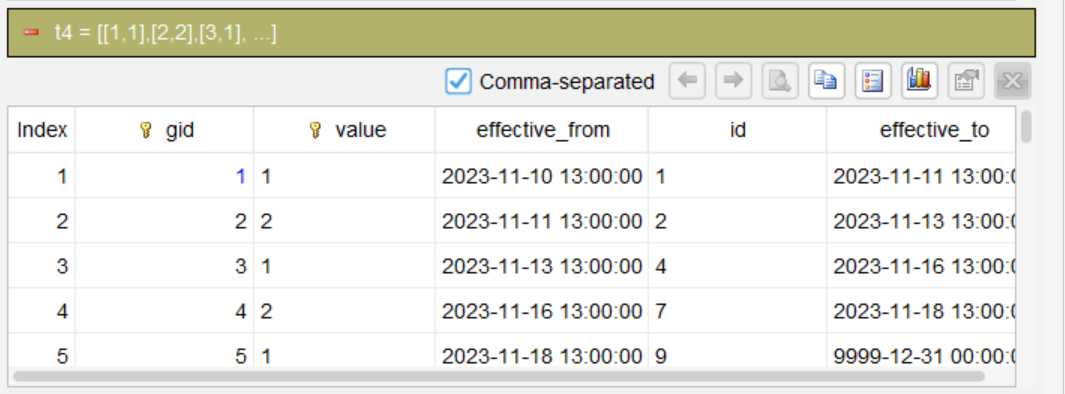
最后删除辅助列 gid,输出最终结果。
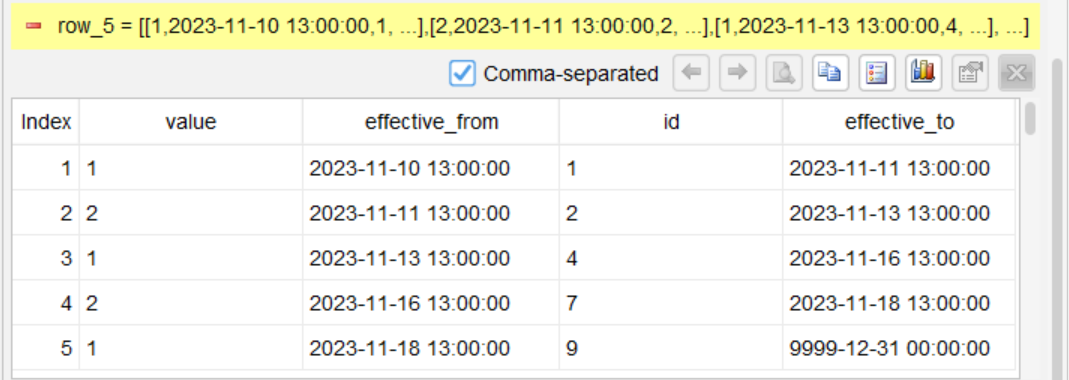
编译生成 SQL
确认上述 4 步逻辑后,SQLazy 编译器自动生成原生 SQL(这里是 Oracle 语法):
WITH Value AS (
    SELECT
        id,
        value,
        timestamp
    FROM
        events
),
Value2 AS (
    SELECT
        gid,
        id AS id,
        value AS value,
        timestamp AS effective_from
    FROM
        (
            SELECT
                id,
                value,
                timestamp,
                SUM(
                    CASE
                        WHEN value <> col__5 THEN 1
                        ELSE 0
                    END
                ) OVER (
                    ORDER BY
                        CASE
                            WHEN timestamp IS NULL THEN 1
                            ELSE 0
                        END,
                        timestamp ASC
                ) + 1 AS gid
            FROM
                (
                    SELECT
                        Value.*,
                        LAG(value) OVER (
                            ORDER BY
                                CASE
                                    WHEN timestamp IS NULL THEN 1
                                    ELSE 0
                                END,
                                timestamp ASC
                        ) AS col__5
                    FROM
                        Value
                ) sub__6
        ) Value1
    GROUP BY
        gid
)
SELECT
    gid,
    id,
    value,
    effective_from,
    LEAD(
        effective_from,
        1,
        TO_DATE('9999-12-31 00:00:00', 'YYYY-MM-DD HH24:MI:SS')
    ) OVER (
        ORDER BY
            gid
    ) AS effective_to
FROM
    Value2
ORDER BY
gid;
你不需要手动调试这段 SQL,只需确认前面 4 步的逻辑正确,编译器就会输出可运行的代码。
SQLazy 让你用业务语言描述逻辑,而不是用 SQL 语法写嵌套查询。这个 "按值变化拆分时间段" 的例子,核心就是一句话:segment value; change,直接对应 "值变了就新开一组" 的业务需求。手写 SQL 时,你需要理解 LAG/LEAD 的窗口边界、手动处理 NULL、还要根据不同数据库调整语法差异。而 SQLazy 把这套复杂的逻辑压缩成 4 个直观步骤------排序、分段、汇总、取下一行作为结束时间------每一步都可以独立验证中间结果,编译器则帮你生成最终的可运行 SQL。你只需要确认每一步的业务含义是否正确,剩下的交给编译器。