本文摘要:两千万行订单表按天分桶的表达式索引建不起来,天级慢查询长期无法收敛。不可变性在建索引那一刻即校验,绕法只有显式化依赖、冗余列、谎称不可变。
一、问题与结论
pg_stat_user_tables 里 n_live_tup 与 orders 实际行数同量级、last_autovacuum 正常,统计信息过期排除;条件写成 created_at = $1::text 会让 btree 因类型不符失效,隐式类型转换也排除。剩下这条路径的终点是 DDL 直接失败:
sql
-- 一、统计信息过期:估算行数与实际差一个数量级就先 ANALYZE
SELECT relname, n_live_tup, last_autovacuum, last_autoanalyze
FROM pg_stat_user_tables WHERE relname = 'orders';

-- 二、隐式类型转换:created_at = $1::text 会让索引失效

-- 三、给 date_trunc('day', created_at) 建表达式索引
CREATE INDEX ON orders ((date_trunc('day', created_at)));
text
ERROR: functions in index expression must be immutable不可变性检查发生在建索引那一刻,不通过就没有索引可用;代价落在 schema 设计、写入链路与结果正确性,不在查询期。前两类失效改 SQL 即可修,第三类必须改 schema 或写入,这就是三种绕法各有代价的根源。
二、排查与选择依据
判定顺序固定三步:先 EXPLAIN (ANALYZE, BUFFERS) 配合 pg_stat_statements 确认慢在哪,估算行数与实际差一个数量级就 ANALYZE 并看 autovacuum;再确认条件没有隐式类型转换;最后查函数 volatility。第三步不能凭记忆,查 catalog:
sql
-- 函数真实 volatility;date_trunc 常因依赖会话 TimeZone 而不是 IMMUTABLE
SELECT p.proname,
       oidvectortypes(p.proargtypes) AS args,
       CASE p.provolatile WHEN 'i' THEN 'IMMUTABLE'
                          WHEN 's' THEN 'STABLE' WHEN 'v' THEN 'VOLATILE' END AS vol
FROM pg_proc p
WHERE p.proname IN ('date_trunc','timezone','now','lower');

-- 已存在的表达式索引
SELECT i.relname AS idx, pg_get_indexdef(x.indexrelid) AS ddl
FROM pg_index x JOIN pg_class i ON i.oid = x.indexrelid
WHERE x.indexprs IS NOT NULL;

-- 业务 schema 里 volatility 非 IMMUTABLE 的自定义函数
SELECT n.nspname, p.proname, p.provolatile
FROM pg_proc p JOIN pg_namespace n ON n.oid = p.pronamespace
WHERE p.provolatile <> 'i'
  AND n.nspname NOT IN ('pg_catalog','information_schema');
两条分界在这里:统计信息与类型转换影响"查询怎么执行",改 SQL 即可;不可变性影响"索引能不能存在",只能改 schema 与写入链路。而真正谎称 IMMUTABLE 的函数自标不可变却依赖会话状态,pg_proc 查不出来,只能审函数体。
替代方案与取舍
| 方案 | 选择条件 | 代价与边界 |
|---|---|---|
范围条件 created_at >= $d AND created_at < $d + interval '1 day' |
只要时间切片,不要函数语义 | 零 schema 变更;可配 BRIN,对乱序写入效果差 |
| 生成列 + 普通索引(PG 12+) | 表达式确实 IMMUTABLE,只想简化 SQL | 写入期求值;加 STORED 列可能重写全表;同样受不可变约束 |
| 非确定性 ICU collation(PG 12+) | 目标是大小写不敏感比较 | collation 版本升级后需 REINDEX;算子与函数支持随版本变化 |
| 冗余列 + 触发器 | 求值依赖会话状态,但业务能固定口径 | 回填产生 WAL;COPY、逻辑复制可绕过触发器 |
| 谎称 IMMUTABLE | 能证明结果只依赖入参,且有兜底校验 | 唯一会静默给错答案,默认不采用 |
不该用表达式索引的场景:只要时间切片就用范围条件;求值依赖 TimeZone、collation 等会话状态而业务锁不定口径时改数据模型,别把函数标成不可变;写入远多于查询的表不适合加冗余列与触发器。
三、关键原理
闸门范围:表达式索引、部分索引谓词、生成列表达式、CHECK 约束、分区键表达式都要求 IMMUTABLE,措辞略有差别------表达式索引报 functions in index expression must be immutable,部分索引谓词报 functions in index predicate must be immutable。报错只针对函数调用,(a + b) 纯运算不受影响。
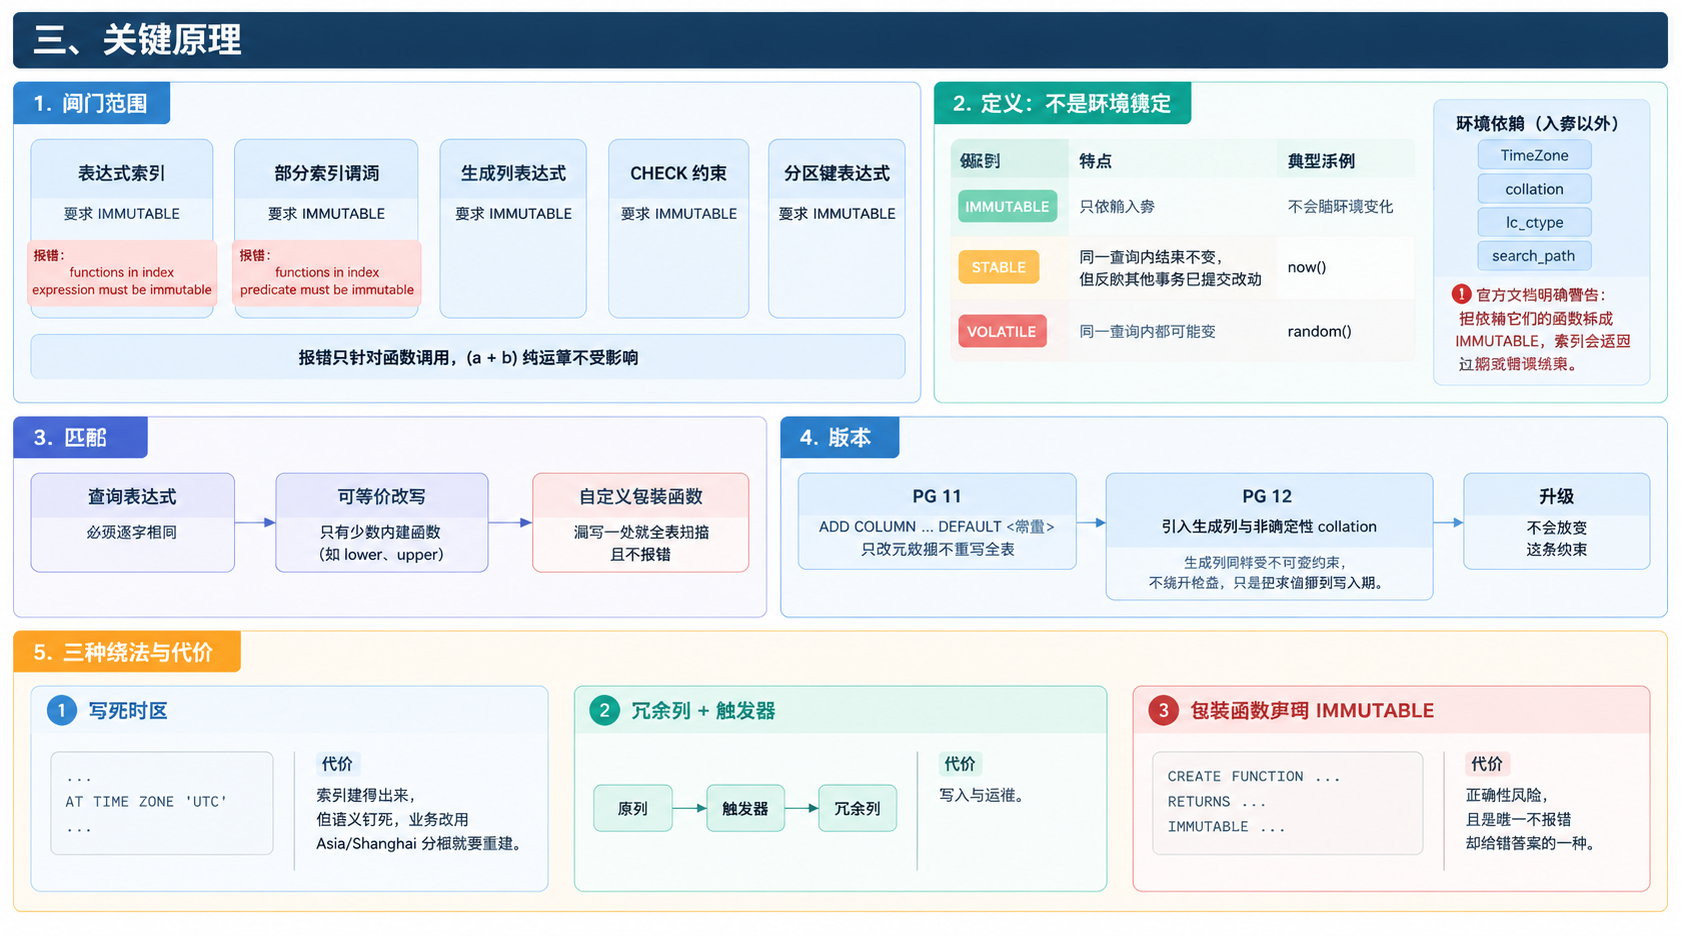
定义:IMMUTABLE 是"只依赖入参",不是"在我环境里稳定"。STABLE(now())同一查询内结果不变,但反映其他事务已提交改动;VOLATILE(random())同一查询内都可能变。TimeZone、collation、lc_ctype、search_path 都是入参以外的依赖,官方文档明确警告:把依赖它们的函数标成 IMMUTABLE,索引会返回过期或错误结果。
匹配:查询里必须逐字写同样的表达式,只有 lower、upper 等少数内建函数有等价改写;自定义包装函数漏写一处就全表扫描,且不报错。
版本:PG 11 起 ADD COLUMN ... DEFAULT <常量> 只改元数据不重写全表;PG 12 引入生成列与非确定性 collation。生成列同样受不可变约束,它不绕开检查,只是把求值挪到写入期。升级不会放宽这条约束。
三种绕法的代价落点由此确定:绕法 1 把 AT TIME ZONE 'UTC' 写进表达式,索引建得出来,代价是语义钉死,业务改用 Asia/Shanghai 分桶就要重建;绕法 2 加冗余列与触发器,代价在写入与运维;绕法 3 用包装函数自行声明 IMMUTABLE,代价是正确性风险,且是唯一不报错却给错答案的一种。
四、可运行示例
环境:一台可建库的 PostgreSQL 实例,版本自行确认,下面的 SQL 不依赖 PG 12+ 特性;输入是一张 orders 表加一行跨日写入的边界数据。按顺序执行。
sql
SET timezone = 'UTC';
DROP TABLE IF EXISTS orders CASCADE;
CREATE TABLE orders (
    id         bigserial PRIMARY KEY,
    created_at timestamptz NOT NULL,
    amount     numeric(12,2)
);
INSERT INTO orders (created_at, amount)
VALUES ('2024-03-10 23:30:00+00', 1.00);
复现闸门(STABLE 情形):
sql
CREATE INDEX ON orders ((date_trunc('day', created_at)));预期输出:ERROR: functions in index expression must be immutable。date_trunc(text, timestamptz) 依赖会话 TimeZone,volatility 以你实例的 catalog 查询为准;若它被标成 IMMUTABLE,这里会直接建成功。
绕法 1:把时区写进表达式,查询逐字一致。
sql
CREATE INDEX orders_day_idx
    ON orders (date_trunc('day', created_at AT TIME ZONE 'UTC'));

EXPLAIN (ANALYZE, COSTS OFF)
SELECT id FROM orders
WHERE date_trunc('day', created_at AT TIME ZONE 'UTC')
= '2024-03-10 00:00:00'::timestamp;预期输出:Index Scan using orders_day_idx,返回 1 行。实际输出:在你的实例执行后把计划与行数填回来对照,均未实测,差异以实例为准。
绕法 2:冗余列 + 触发器,代价落在写入与运维。
sql
ALTER TABLE orders ADD COLUMN day_utc timestamp;

UPDATE orders SET day_utc = date_trunc('day', created_at AT TIME ZONE 'UTC');

CREATE OR REPLACE FUNCTION orders_set_day_utc() RETURNS trigger
LANGUAGE plpgsql AS $$
BEGIN
    NEW.day_utc := date_trunc('day', NEW.created_at AT TIME ZONE 'UTC');
    RETURN NEW;
END $$;

CREATE TRIGGER orders_day_utc
BEFORE INSERT OR UPDATE OF created_at ON orders
FOR EACH ROW EXECUTE FUNCTION orders_set_day_utc();

CREATE INDEX ON orders (day_utc);
预期输出:索引建在普通列上,查询直接写 WHERE day_utc = '2024-03-10 00:00:00'::timestamp,不再受表达式逐字匹配约束。
绕法 3 与它的静默失败(索引在 UTC 会话下建成):
sql
CREATE OR REPLACE FUNCTION day_utc(ts timestamptz) RETURNS timestamp
LANGUAGE plpgsql IMMUTABLE AS $$
BEGIN
    RETURN date_trunc('day', ts);  -- 返回 timestamp 的隐式转换同样依赖会话 TimeZone
END $$;

CREATE INDEX orders_day_lie_idx ON orders (day_utc(created_at));

SET timezone = 'Asia/Shanghai';
SET enable_seqscan = off;
EXPLAIN (ANALYZE, COSTS OFF)
SELECT id FROM orders
WHERE day_utc(created_at) = '2024-03-10 00:00:00'::timestamp;
RESET enable_seqscan;
EXPLAIN (ANALYZE, COSTS OFF)
SELECT id FROM orders
WHERE day_utc(created_at) = '2024-03-10 00:00:00'::timestamp;
预期输出:第一次 Index Scan using orders_day_lie_idx 返回 1 行(索引冻结的是 UTC 口径的值),第二次 Seq Scan 返回 0 行。同一条 SQL、同一份数据,结果随执行计划而变。
常见失败与修复有两个:LANGUAGE sql IMMUTABLE 的包装函数可能被内联,内层 STABLE 调用重新暴露给检查,CREATE INDEX 仍报同样的错------改用 plpgsql(不内联)并先在实例验证;绕法 1 的查询漏写 AT TIME ZONE 'UTC',索引不命中也无报错,以 EXPLAIN 里是否出现 orders_day_idx 为准。
五、验证结果与边界
不给耗时与收益数字,文中现象均为依据文档语义的预期,除标注外均未验证。上线前需在实例核对:date_trunc、timezone 的 provolatile 实际值;LANGUAGE sql 包装函数是否被内联;切换 timezone 后返回行数是否随计划变化;ADD COLUMN ... GENERATED ... STORED 是否重写全表;非确定 collation 支持的算子范围。
边界三条:pg_dump 恢复后默认 timezone 不同,索引条目口径与查询口径会整体错位;触发器可被 COPY 或逻辑复制绕过,冗余列会漂移,需要约束或校验脚本兜底;绕法 3 的函数在生成列、CHECK 约束处另有措辞不同的检查,不能统一使用。
思考
- 按天分桶口径固定为 UTC 后,冗余列与表达式索引哪种更易在团队代码里保持一致?
- 谎称 IMMUTABLE 的函数应靠代码评审禁止,还是靠
pg_proc体检 SQL 定期扫描?