【第一章】MySQL简介
- 数据库是什么,为什么要使用数据库
-
- 数据库是什么
- 从"文件"到"数据库"的演进
- [为什么要使用数据库:10 个理由](#为什么要使用数据库:10 个理由)
- 数据库的"代价"
- 主流数据库
- SQL简介
-
- [SQL 能做什么](#SQL 能做什么)
- [一条 SQL 的"直觉"](#一条 SQL 的“直觉”)
- MySQL架构
-
- [一个常见问题:为什么 MySQL 要做"存储引擎可插拔"](#一个常见问题:为什么 MySQL 要做“存储引擎可插拔”)
- 存储引擎
- 本章小结
在结束了数据结构以后,我深思熟虑,决定为大家开始数据库模块的介绍。因为数据库在我们学习和开发的阶段都非常重要:它既是"存数据的地方",也是"让数据变得可用"的一整套工程体系。
这一章不写太多花活,主要把三个问题说清楚:
- 数据库到底解决什么问题
- 主流数据库都是什么定位,我们该怎么选
- MySQL(尤其是 InnoDB)大概是怎么工作的
后面我们的实战和练习,会以 MySQL 为主。
数据库是什么,为什么要使用数据库
很多同学第一次接触数据库的时候,会把它理解成"一个更高级的 Excel",这句话对一半:数据库确实在管理表格数据,但它真正厉害的地方不在"能存",而在"能在多人、多业务、高并发、可恢复的情况下稳定地存取"。
数据库是什么
数据库(Database)本质上是:
以某种数据模型组织起来的数据集合 + 一套能安全高效访问/维护这些数据的系统(DBMS)。
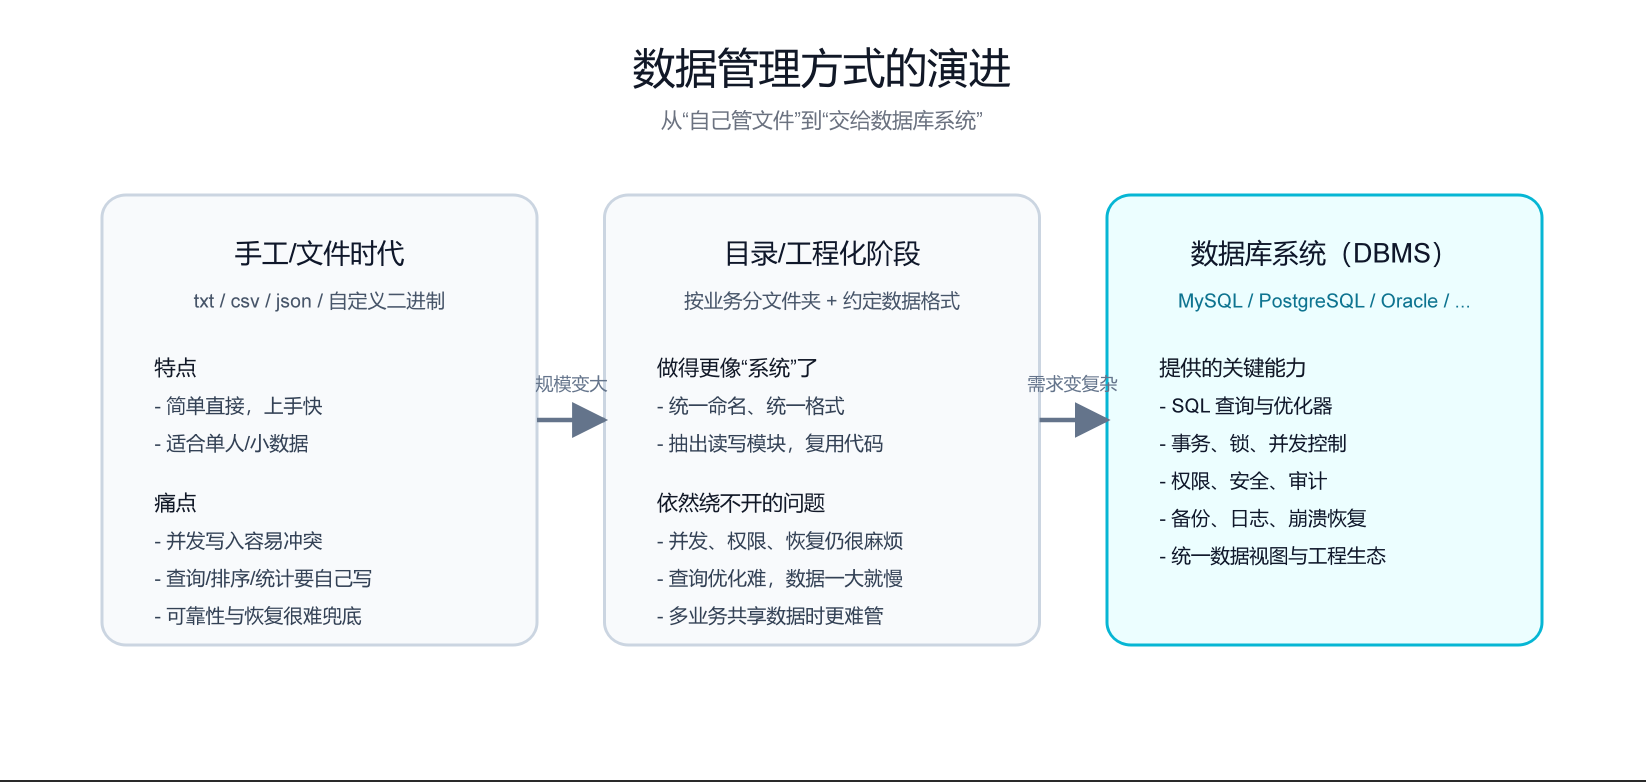
也就是说,数据库不是单纯的"文件",而是一整套系统能力的打包,包括:
- 存储:数据怎么落盘、怎么组织
- 查询:怎么把你想要的数据捞出来(并尽量快)
- 修改:插入/更新/删除如何保持一致性
- 并发:多个人同时读写时怎么不出事
- 可靠性:断电、崩溃之后怎么恢复
- 安全:权限、审计、加密等
从"文件"到"数据库"的演进
最早我们用文件存数据:txt、csv、json,或者自己写二进制文件。轻量是轻量,但一旦业务变复杂,问题就开始集中爆炸。
为什么要使用数据库:10 个理由
我们使用数据库的时候,也会有下面这些的设计给我们提供方便
1.并发控制
多人同时下单、修改资料、扣库存,如果没并发控制,轻则数据覆盖,重则账对不上。
2.事务(ACID)保证
"扣余额 + 生成订单 + 写流水"这种事,少一步都不行;数据库事务就是干这个的。
3.数据一致性与完整性约束
主键唯一、外键约束、非空、默认值、检查约束(不同库支持程度不同)------这些东西能把"脏数据"挡在门外。
4.索引与查询优化
数据量一上来,"全表扫一遍"就是灾难。索引 + 优化器,解决的是"同一句 SQL,数据库能选更快的执行方式"。
5.数据共享与统一视图
同一份数据,多个业务一起用;数据库提供统一的读写入口和一致的语义。
6.备份、恢复与容灾能力
误删、宕机、断电都不是"如果",而是"什么时候"。数据库的日志、备份和恢复机制是底线能力。
7.安全性与权限体系
谁能读、谁能写、能写哪些表、能不能看到敏感字段------权限管理是数据库天然擅长的。
8.统一的标准化语言(SQL)
SQL 不是完美,但它足够通用,让你换语言/换业务时不至于推倒重来。
9.工程化运维能力
监控、慢查询分析、参数调优、连接池管理、冷热数据分层......这些数据库生态比"自己写文件系统"成熟太多。
10.可扩展能力(从单机到分布式的路线)
一开始用单机 MySQL 就够,后面要读写分离、分库分表、上分布式数据库,也有比较清晰的迁移路径。
数据库的"代价"
- 学习成本:SQL、索引、事务、锁、隔离级别都要理解
- 运维成本:备份、迁移、升级、监控、容量规划
- 性能开销:强一致带来的锁/日志/写放大,都是实际成本
- 设计约束:表结构设计不合理,后期改起来很伤
主流数据库
下面就开始铺开,来为大家介绍主流数据库
Oracle
Oracle 基本就是"传统企业级关系型数据库"的代表之一,特点非常鲜明:
- 定位:金融、政企、传统大型企业的核心系统
- 优点:稳定、功能全、生态成熟,性能与可用性方案多
- 代价:授权/维护成本高,学习与运维门槛高
- 常见场景:核心账务、ERP、重要业务中台
客户端工具:
- Oracle SQL Developer
- DBeaver / DataGrip(也能连,但细节功能可能不如原生工具)
MySQL(我们后续的主角)
MySQL 的关键词:开源生态、Web 场景、易上手、工具多。
- 定位:互联网与中小企业项目的通用关系型数据库
- 默认引擎:InnoDB(现在几乎就是事实标准)
- 优点:成本低、资料多、生态强、上手快
- 注意:要写出"快且稳"的 MySQL,需要懂索引、事务与锁(后面会重点讲)
常见客户端工具(后续我建议你固定用其中一个,减少环境差异):
- MySQL Workbench(官方)
- Navicat(很多人用,商业软件)
- DataGrip(JetBrains,全家桶用户很舒服)
- DBeaver(开源,够用)
后续章节我默认你用的是 MySQL,并且会以常见工具(Workbench/Navicat/DataGrip 任意其一)来展示操作界面与 SQL 执行方式。
GaussDB(华为系)
GaussDB 你可以把它理解成"面向企业级、国产化场景的一套数据库产品线",既有偏 OLTP 的,也有偏 OLAP 的,使用方式上同样离不开 SQL。
- 定位:国产化替代、政企项目、多云/混合云场景
- 你可能会遇到它的情况:校招/实习做政企项目、上云项目
- 注意:产品线较多,具体能力要看版本与部署形态
客户端工具:
- 官方控制台(云上)
- DBeaver / DataGrip(兼容协议的情况下)
其他数据库
- PostgreSQL:更"学院派"和"标准化",扩展能力强,工程场景也很常见
- SQL Server:Windows/微软生态里非常常见
- Redis:严格说是内存数据库/缓存,做热点数据与高并发非常强
- MongoDB:NoSQL 文档数据库,适合结构变化快、文档型数据场景
- TiDB / OceanBase:分布式关系型数据库,规模上来以后你会听得越来越多
SQL简介
SQL(Structured Query Language)是关系型数据库的通用语言。你可以把它理解成:你和数据库沟通的"普通话"。
SQL 能做什么
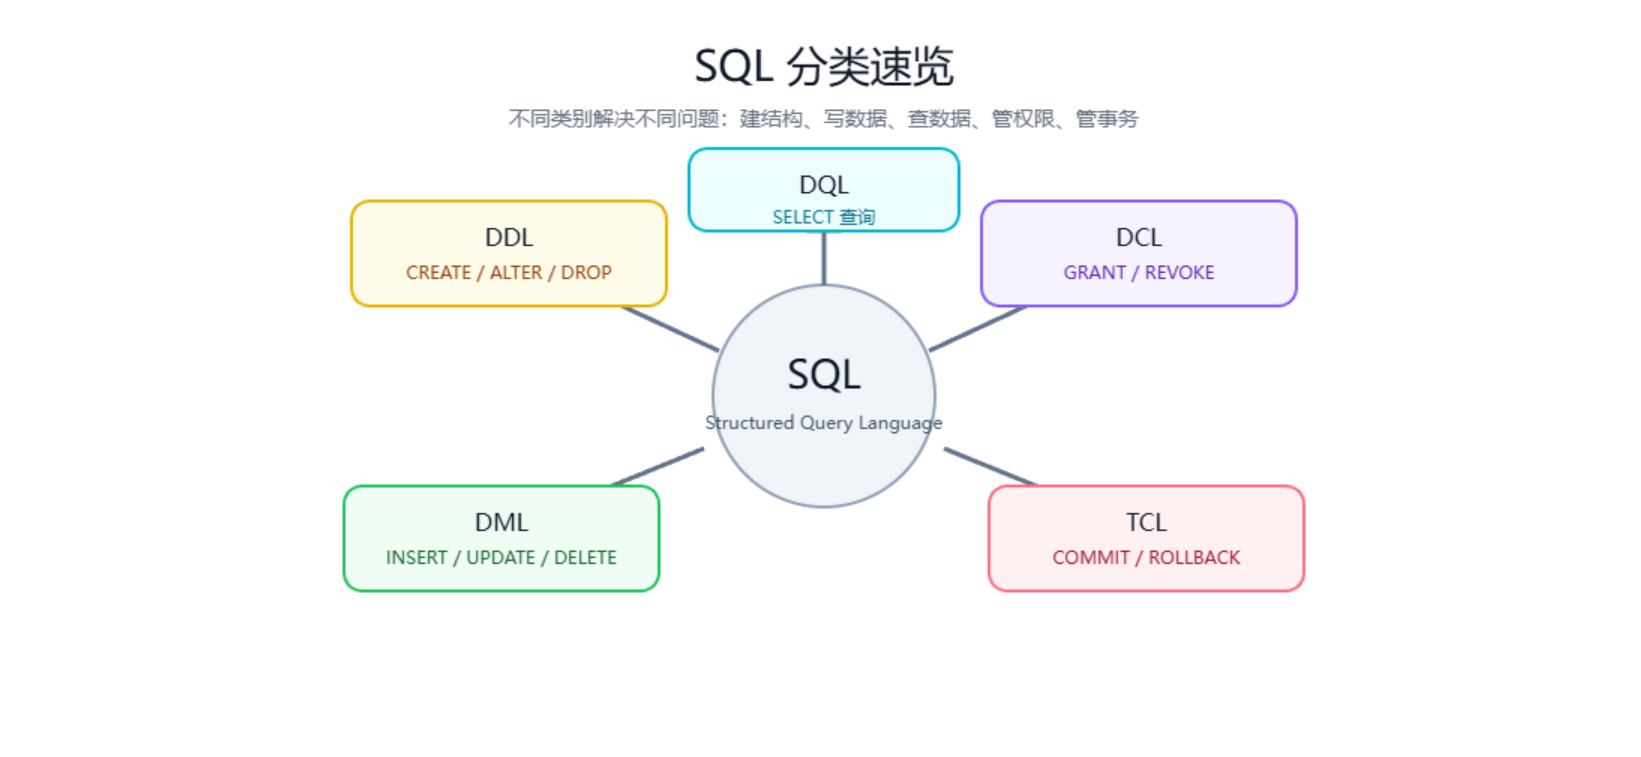
按常见分类:
- DDL:数据定义语言(建库、建表、改表)
CREATE / ALTER / DROP
- DML:数据操作语言(写数据)
INSERT / UPDATE / DELETE
- DQL:数据查询语言(查数据)
SELECT(最常用)
- DCL:数据控制语言(权限相关)
GRANT / REVOKE
- TCL:事务控制语言
COMMIT / ROLLBACK / SAVEPOINT
一条 SQL 的"直觉"
比如这条查询:
sql
SELECT id, name
FROM user
WHERE status = 1
ORDER BY id DESC
LIMIT 10;
你写的时候只是在描述"你想要什么数据",但数据库真正做的事,通常是:
- 能不能用索引把数据尽快定位出来
- 用哪种连接/排序策略更划算
- 在并发情况下读到什么版本的数据
所以后面我们讲索引、事务、锁,本质上都是为了回答:为什么同样是 SELECT,有的人能写出毫秒级查询,有的人能把库打到 100%。
MySQL架构
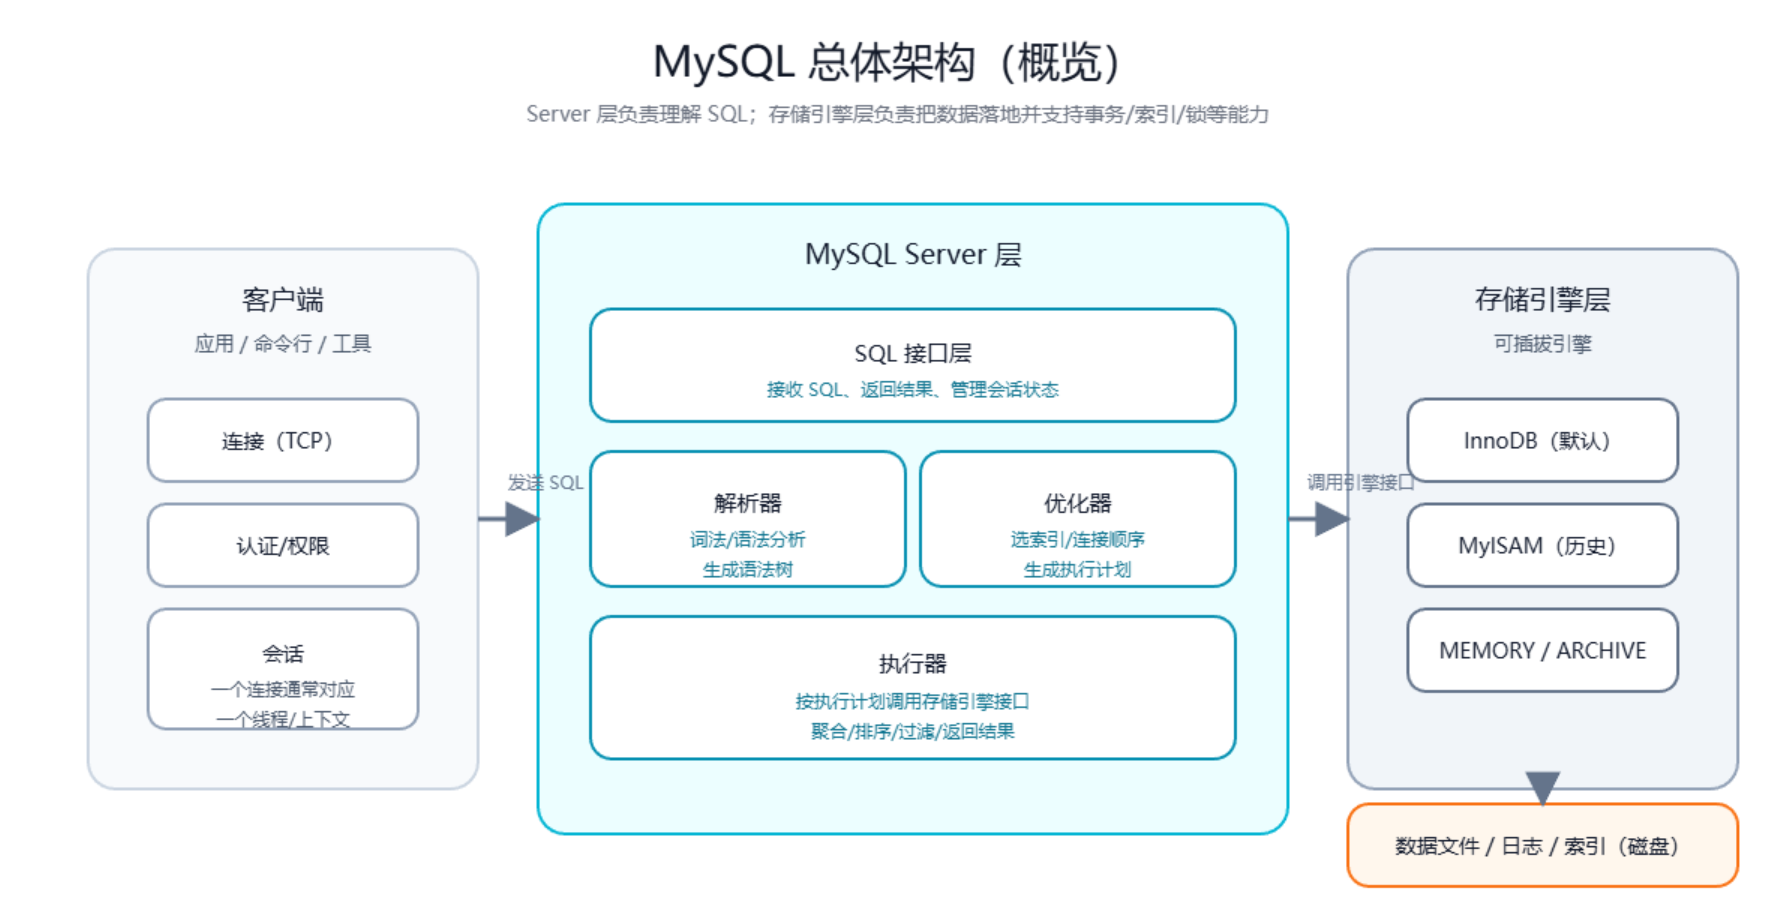
MySQL 你可以粗略理解成两层:
- Server 层:连接管理、SQL 解析、优化、执行等("理解 SQL 的那层")
- 存储引擎层:数据到底怎么存、怎么读、怎么写("理解磁盘的那层")
一个常见问题:为什么 MySQL 要做"存储引擎可插拔"
因为不同场景对存储的诉求不同:
- 有的场景追求事务与崩溃恢复(InnoDB)
- 有的场景追求简单读性能(历史上的 MyISAM)
- 有的场景追求内存级速度(MEMORY)
- 有的场景是归档写入(ARCHIVE)
把"SQL 处理"和"存储实现"拆开,就能让上层尽量稳定,下层按场景替换。
存储引擎
存储引擎(Storage Engine)决定了至少这些事:
- 数据文件长什么样(怎么组织)
- 索引怎么存(B+Tree 还是别的)
- 事务、锁、MVCC 支不支持
- 崩溃恢复怎么做
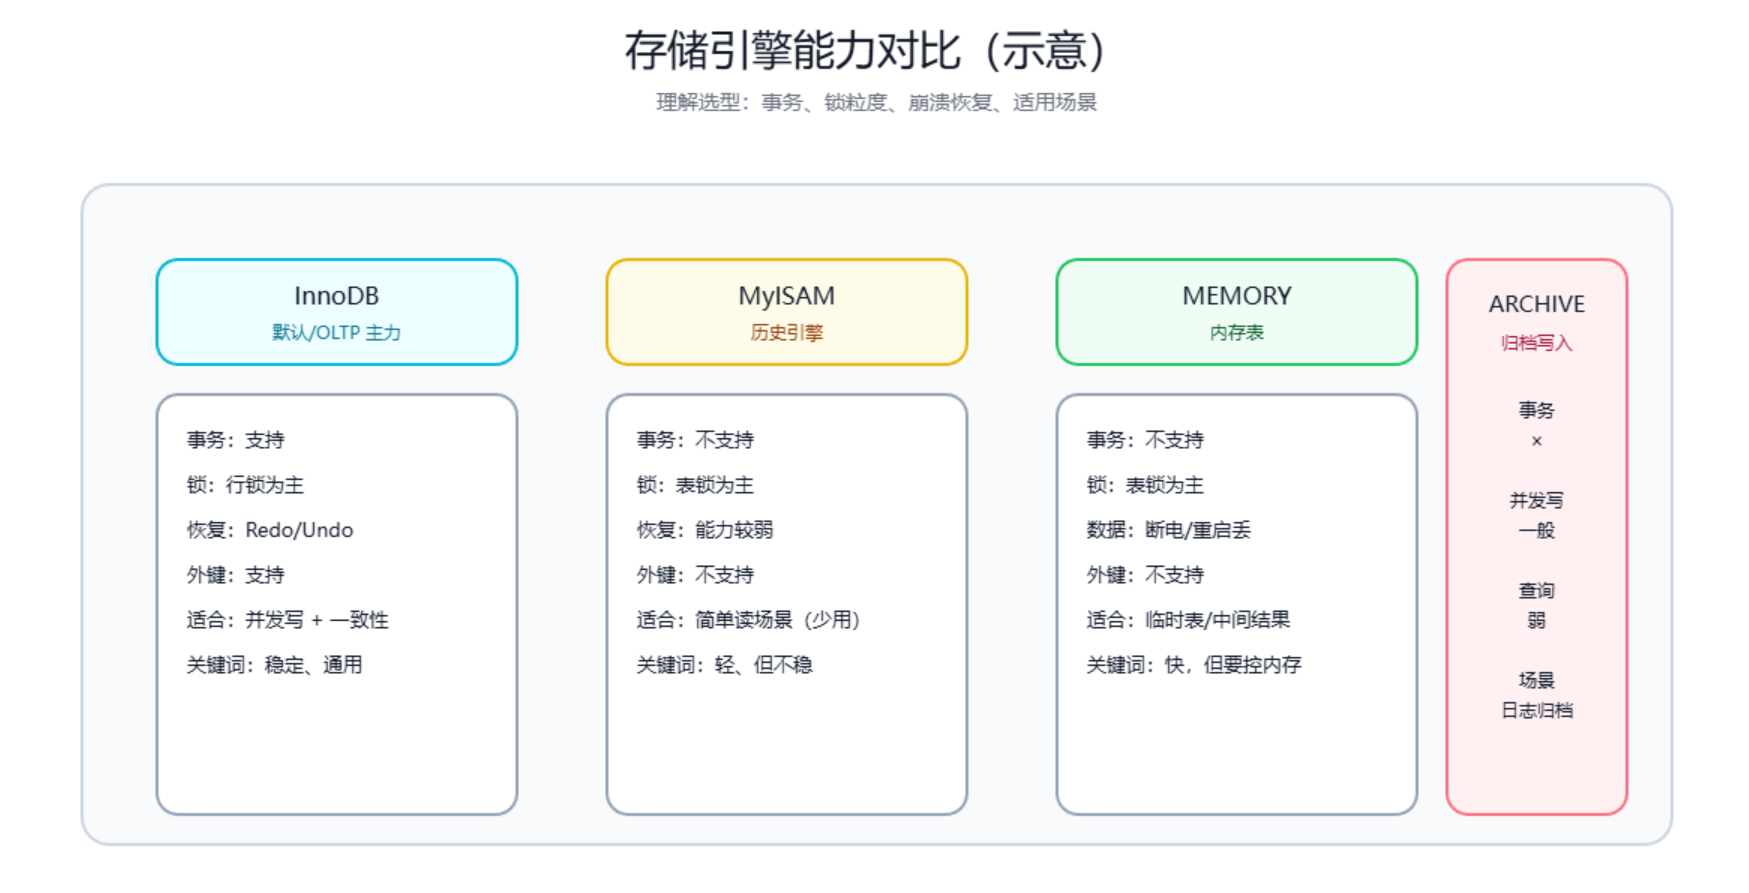
常见存储引擎对比(先把印象建立起来)
我先放一个"够用的对比表",后面讲 InnoDB 时会把每一项展开。
| 维度 | InnoDB | MyISAM | MEMORY | ARCHIVE |
|---|---|---|---|---|
| 是否默认 | 是(主流) | 否(偏历史) | 否 | 否 |
| 事务 | 支持 | 不支持 | 不支持 | 不支持 |
| 锁粒度 | 行锁为主 | 表锁为主 | 表锁为主 | 表锁为主 |
| 崩溃恢复 | 强 | 弱 | 弱 | 弱 |
| 外键 | 支持 | 不支持 | 不支持 | 不支持 |
| 典型场景 | 业务系统 OLTP | 读多写少(历史) | 临时表/缓存表 | 归档写入 |
选型建议
- 不确定用什么:默认 InnoDB,别纠结
- 需要事务、并发写、多表关联:InnoDB
- 临时计算/中间结果:MEMORY(注意内存占用与重启丢数据)
- 只追加写、很少查询:ARCHIVE 可以考虑,但多数情况下你会用分区/冷热分层替代
本章小结
这一章我们大致介绍了如下的内容:
- 数据库解决的是数据管理的工程问题(不仅是存储)
- 主流数据库各自有定位,我们后续以 MySQL 为主
- SQL 是你和数据库沟通的语言,但性能与一致性要靠底层机制支撑
- MySQL 架构分 Server 层与存储引擎层,后面很多知识点都会落在这张图上
下一章开始,我们会从 MySQL 的连接、SQL 执行过程、索引与 InnoDB 的核心机制往下拆,争取把"写得对"升级成"写得对且跑得快"。