第(四)篇反复提到"开源/闭源"。到底啥是开源大模型?上哪找?怎么用?
这篇讲透:开源 vs 闭源怎么选,以及两个最大的开源模型社区------Hugging Face 和魔搭 ModelScope。
目录
目录
[一、开源 vs 闭源:核心区别与怎么选](#一、开源 vs 闭源:核心区别与怎么选)
[1.1 定义](#1.1 定义)
[1.2 优缺点对比](#1.2 优缺点对比)
[1.3 怎么选?](#1.3 怎么选?)
[二、Hugging Face:机器学习界的 GitHub](#二、Hugging Face:机器学习界的 GitHub)
[2.1 三大核心组件](#2.1 三大核心组件)
[2.2 技术基石:Transformers 库](#2.2 技术基石:Transformers 库)
[三、魔搭 ModelScope:中文版 Hugging Face](#三、魔搭 ModelScope:中文版 Hugging Face)
[3.1 核心组件](#3.1 核心组件)
[3.2 和 Hugging Face 的差异](#3.2 和 Hugging Face 的差异)
[五、易混点 + 面试官追问](#五、易混点 + 面试官追问)
[5.1 易混点速记](#5.1 易混点速记)
[5.2 面试官追问(3 个 + 答案)](#5.2 面试官追问(3 个 + 答案))
一、开源 vs 闭源:核心区别与怎么选
1.1 定义
| 类型 | 定义 |
|---|---|
| 开源大模型 | 模型权重公开,任何人都能下载、部署、微调、研究其代码 |
| 闭源大模型 | 只通过 API 接口提供服务,核心代码和权重完全保密,只能调用功能 |
开源 ≠ 免费 API。权重免费下载,但部署要自己出 GPU 和运维成本
1.2 优缺点对比
| 维度 | 开源大模型 | 闭源大模型 |
|---|---|---|
| 数据安全 | 可私有化部署,数据不出域 | 数据要发给第三方,有合规风险 |
| 成本 | 前期买 GPU 贵,长期高频调用省 | 上手便宜,量大后线性增长 |
| 定制化 | 可微调、可改架构 | 只能靠提示词或有限微调接口 |
| 供应商锁定 | 无,权重在自己手里 | 有,换厂商成本高 |
| 技术门槛 | 高,要会 GPU 运维 | 低,注册拿 Key 就能调 |
| 性能上限 | 略低,但差距在缩小 | 头部略高 |
1.3 怎么选?
| 场景 | 选择 |
|---|---|
| 核心数据、敏感信息、长期大量调用 | 开源(私有化部署) |
| 快速验证想法、团队没 GPU/运维 | 闭源(API 调用) |
| 既有数据安全需求、又想省心 | 混合(核心业务开源 + 非核心闭源) |
二、Hugging Face:机器学习界的 GitHub
官网:
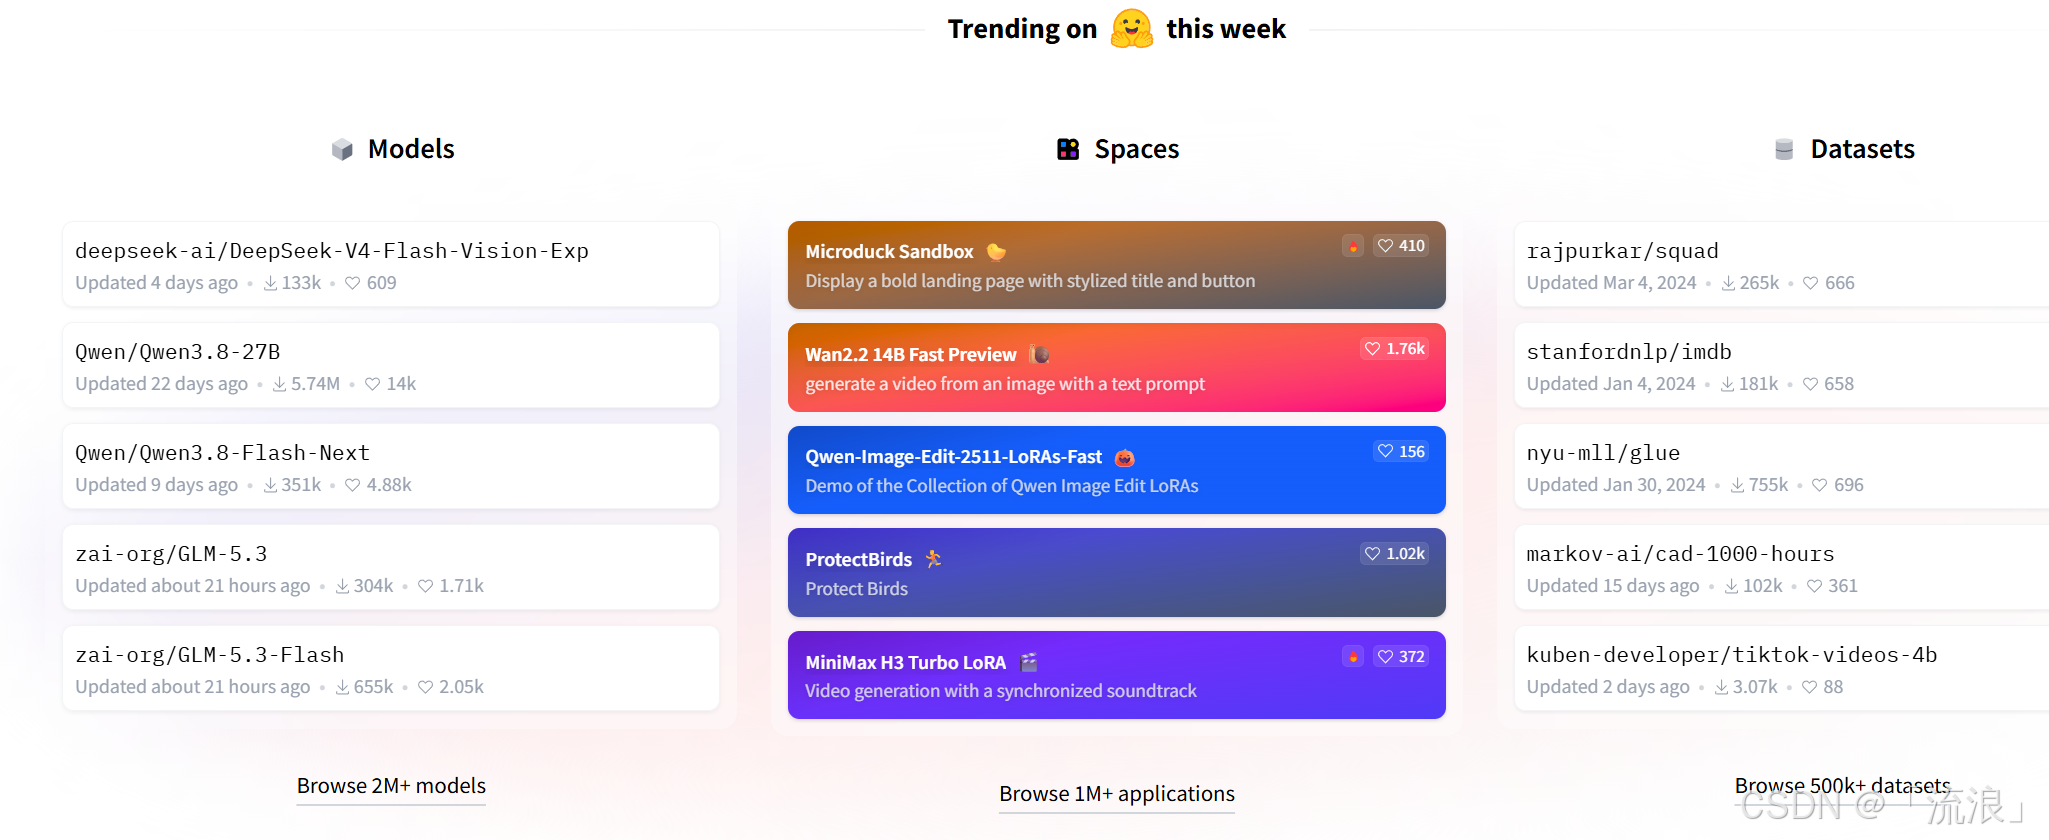
Hugging Face 起初是一家聊天机器人创业公司,后来靠开源的 Transformers 库 大火,如今成为共享超 10 万个预训练模型、1 万个数据集的机器学习社区,被称为"机器学习界的 GitHub"。
2.1 三大核心组件
| 组件 | 作用 |
|---|---|
| Models(模型库) | 托管数十万个预训练模型:Llama、Qwen、Gemma、DeepSeek、Stable Diffusion 等都能找到 |
| Datasets(数据集) | 海量文本/图像/音频数据集,是训练模型的"粮仓" |
| Spaces(应用空间) | 免费托管 AI 应用,几分钟把模型部署成可交互的 Web 演示 |
2.2 技术基石:Transformers 库
Transformer 是 2017 年提出的神经网络架构 ,核心依靠自注意力机制,摒弃 RNN 循环结构,能够并行处理文本,捕捉词语间远距离依赖;**分为编码器、解码器两部分,**BERT 基于编码器做理解类任务,GPT 基于解码器做文本生成,而🤗Transformers 是 HuggingFace 的开源库,封装了各类 Transformer 模型,方便加载、调用与微调预训练大模型。
Hugging Face 开源的 Python 库,抽象了模型加载、训练、推理的复杂逻辑。
- 简化使用:三行代码就能加载一个顶级预训练模型做文本生成
- 统一接口:BERT、Llama、GPT 都能用几乎相同的 API 调用
对入门者,HF 最大的价值是"站在大牛肩膀上"------不用从头训,直接下载别人训好的模型用。
三、魔搭 ModelScope:中文版 Hugging Face
官网:
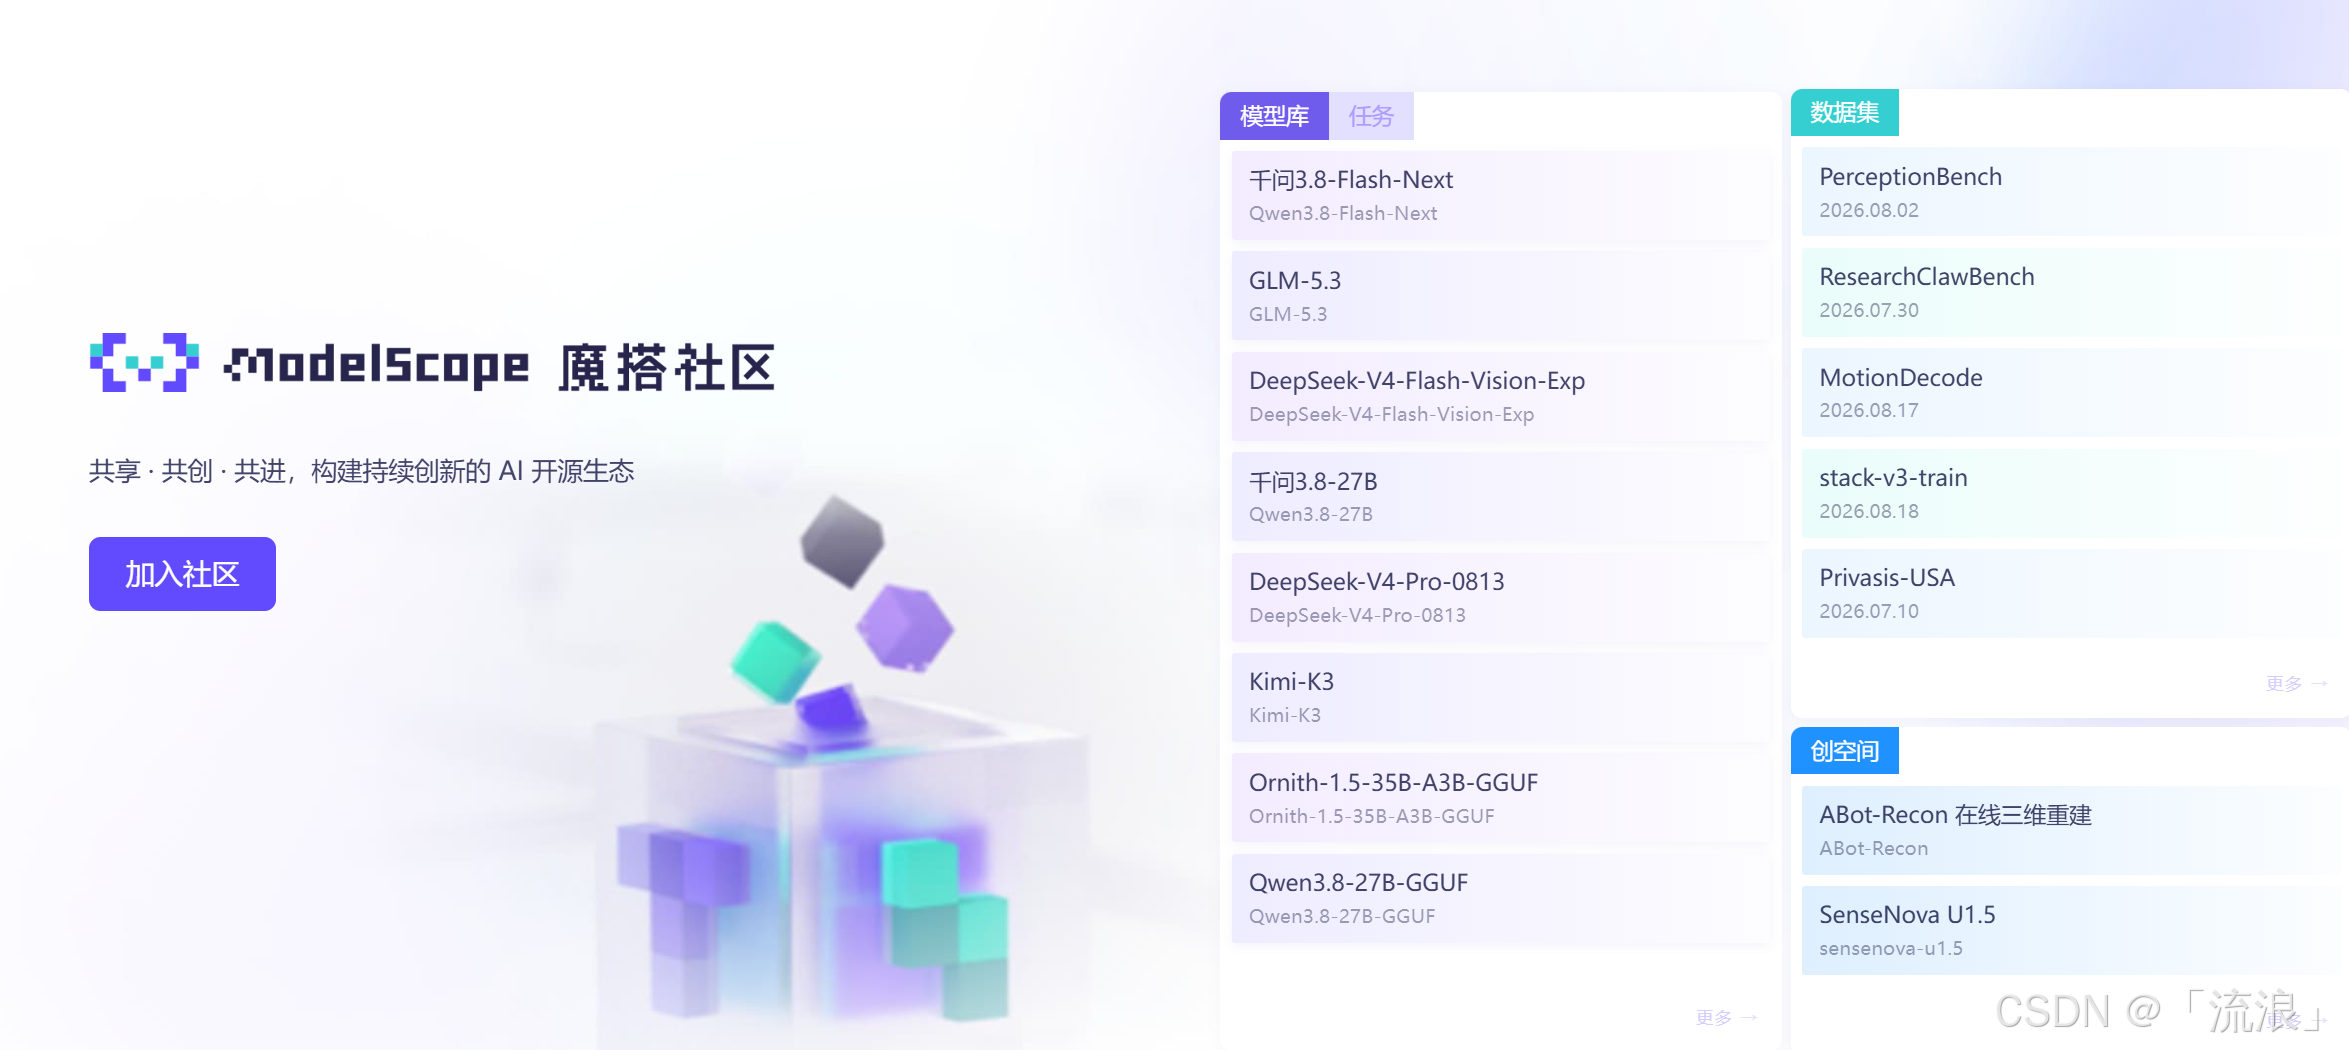
魔搭(ModelScope)是阿里达摩院联合发起的国内最大 AI 模型开源社区 ,可以简单理解为"中文版 Hugging Face"。
3.1 核心组件
| 组件 | 作用 |
|---|---|
| 模型库 | 汇聚 Qwen、Kimi、DeepSeek 及大量衍生模型 |
| 数据集 | 中文语料、医学影像等丰富数据集 |
| 创空间 | 沉淀超 1 万个 AI 应用,类似 HF 的 Spaces |
| MCP 广场 | 聚合 MCP 服务,给智能体接外部工具(第(八)篇细讲) |
3.2 和 Hugging Face 的差异
| 对比 | Hugging Face | 魔搭 ModelScope |
|---|---|---|
| 定位 | 全球 | 国内 |
| 语言/生态 | 英文为主 | 中文优化 |
| 算力适配 | 国际 GPU | 支持昇腾等国产芯片 |
| 特色 | 起步早、模型最全 | 国内访问快、中文场景友好 |
四、怎么找模型、怎么用
使用链路一句话:搜模型 → 看文档 → 下载权重 → 本地/云端部署 → 推理或微调。
| 步骤 | 做什么 | 例子 |
|---|---|---|
| ① 搜模型 | 在 HF/魔搭搜关键词 | 搜 "Qwen2.5" |
| ② 看信息 | 看参数量、协议、榜单 | 0.5B 适合 CPU 跑,7B 需要 GPU |
| ③ 下载 | 拉权重到本地/租的机器 | git clone 或平台一键下载 |
| ④ 部署 | 加载模型跑推理 | Transformers / Ollama / LM Studio |
| ⑤ 微调(可选) | 用自己数据调优 | 魔搭 SWIFT、LoRA 轻量微调 |
不会写代码?用 Ollama / LM Studio 这类工具,下载模型后图形界面直接用,适合本地体验开源模型。
五、易混点 + 面试官追问
5.1 易混点速记
- 开源 ≠ 免费:权重免费,GPU、电费、运维都要钱。
- 开源 ≠ 不安全:本地/私有云部署反而最安全;不安全的是把敏感数据发给闭源 API。
- 大厂抢着开源 ≠ 做慈善:开源是生态卡位------谁开源,谁定标准,谁吸引开发者。
5.2 面试官追问(3 个 + 答案)
Q1:开源大模型免费吗?为什么很多人说"开源更贵"? A:权重免费,但部署和运维要钱------GPU 服务器采购、机房电费、运维人员工资都是隐形成本。高频大量调用时自建长期更省;低频使用反而闭源 API 更划算。
Q2:企业用开源模型,数据就一定安全吗? A:不一定。安全的前提是部署在本地或私有云,数据不出域才安全。如果只是把开源模型挂在公有云上,同样有数据风险。所以"开源+私有化部署"才是企业数据安全的标准组合。
Q3:为什么 OpenAI、Meta、阿里都抢着开源模型? A:三层动机:①生态卡位 ------让开发者基于你的模型开发,形成生态;②标准制定 ------用的人多了,你的格式就成了行业标准;③人才和声誉------开源吸引顶尖人才,提升公司技术影响力。
如果这篇帮你搞懂了开源生态,欢迎点赞收藏。评论区聊聊:你会更倾向用开源还是闭源大模型?为什么?