做 Agent 的人常有个执念:效果不好就换更强的模型,再不行就改提示词,改它一百版。
但有个团队真这么干了------换上最好的模型,提示词改了上百版,参数调了个遍,真实场景成功率还是卡在 70% 以下。最后让他们一刀干到 95% 以上的改动,既没动模型,也没动提示词。
改的是:任务怎么拆、状态怎么管、关键步骤怎么校验、失败怎么恢复。也就是说,改的全是模型外面那套东西。这套东西,现在有了个统一的名字------Harness。
一、先给个定义:Harness = Agent 减 Model
LangChain 工程师给过一个很干净的等式:
Agent = Model + Harness
移项就是 Harness = Agent − Model。大白话:在一个 Agent 系统里,除模型本身之外、所有决定它能不能稳定交付的东西,都算 Harness。
这个定义之所以重要,是因为它把"模型"和"系统"在账本上彻底分了家。模型是上限,Harness 是下限------决定一个产品能不能落地的,从来是下限。那个 70% 到 95% 的案例,改的全是下限。
二、三阶段演进:问题一层比一层大
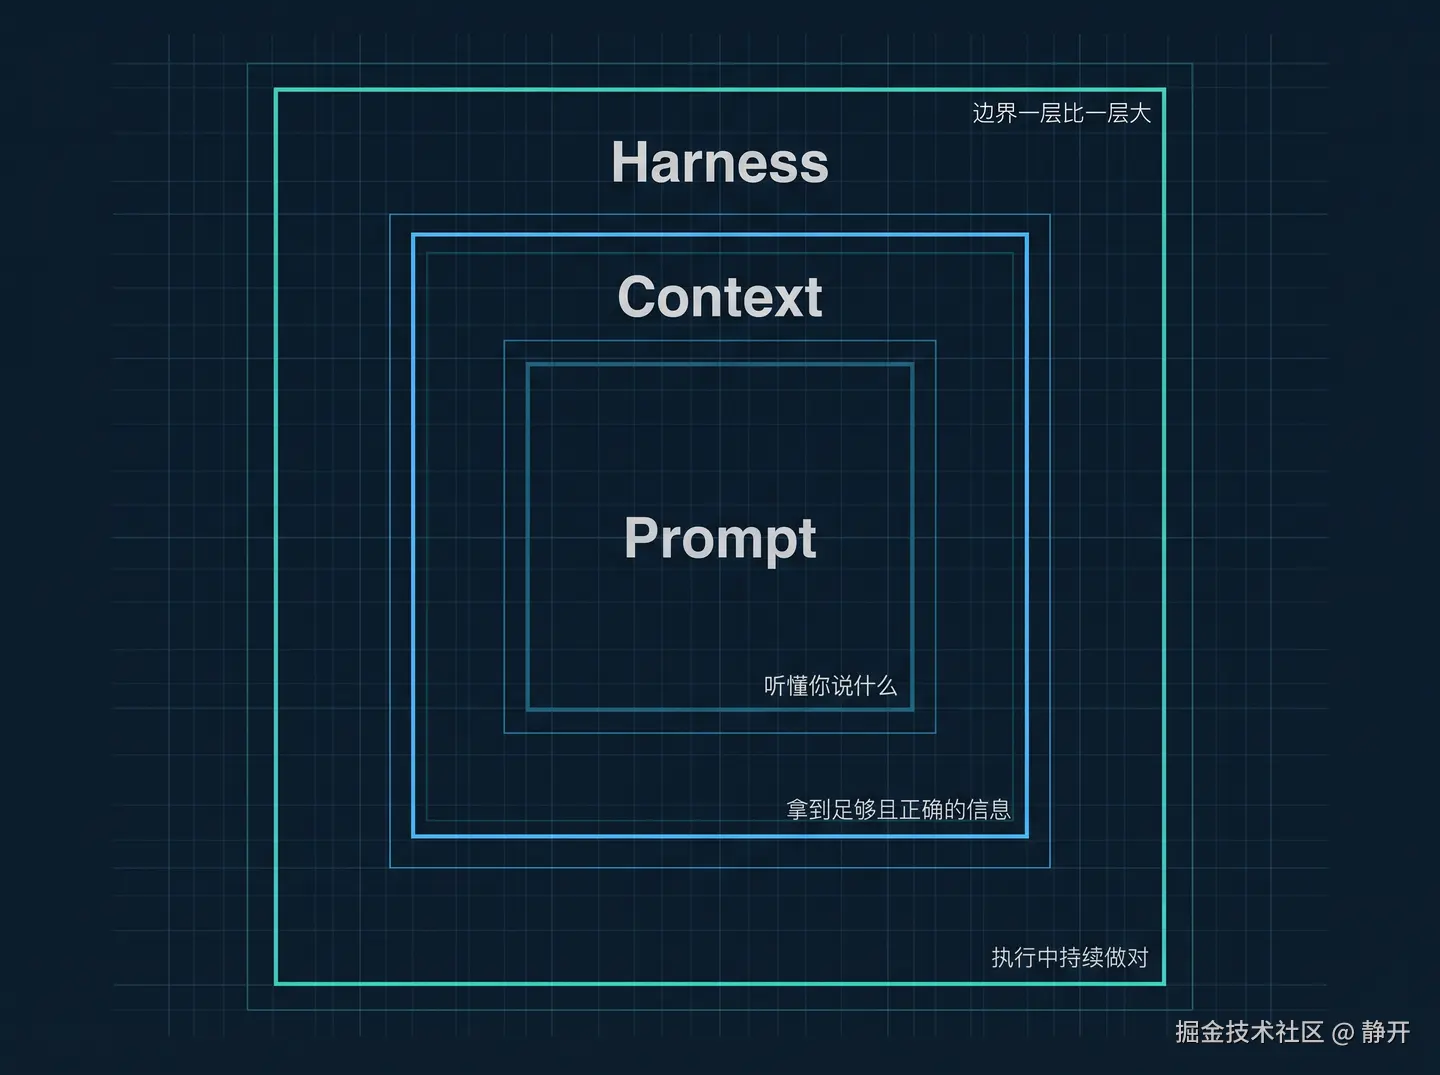
Harness 不是凭空蹦出来的。过去两年 AI 工程其实走完了三级跳:Prompt Engineering → Context Engineering → Harness Engineering。这看着像术语流行史,实际是 AI 系统要回答的三层问题在依次显形:
- 模型有没有听懂你在说什么?
- 模型有没有拿到足够且正确的信息?
- 模型在真实执行里能不能持续做对?
三层问题一层包一层,越往外越大。
第一级 · Prompt Engineering:把话说清楚
大模型刚火那阵,大家最直观的体验是:同一个模型,换个说法结果差很多。于是全民研究提示词------角色设定、Few-shot、风格约束、输出格式。
为什么有效?因为大模型本质是一个对上下文极度敏感的概率生成器。你给它什么身份,它就顺着那个身份往下接;给它什么样例,它就按那个范式补全。提示词工程的本质,不是命令模型,而是给它框一个概率分布,让它更可能落进你想要的解空间。
它的天花板也很硬:很多任务不是你说清楚就行,是你真得知道。让模型按一套长规范写代码、回答某个产品的最新配置------提示词写得再漂亮,也替代不了事实本身。一句话:Prompt 解决的是表达问题,不是信息问题。
第二级 · Context Engineering:把信息喂对
Agent 一火,问题就变了。模型不再只是回答,而是要进真实环境做事:多轮对话、调浏览器、写代码、查数据库,多步之间传中间结果,根据反馈改计划。问题从"一次答得对不对"变成"整条链路跑不跑得通"。
这时核心命题换成一句:模型不知道的,系统必须在合适时机把正确信息送进去。
注意,这里的"信息"远不止几段背景资料,它是所有影响模型当前决策的东西的总和------用户输入、历史对话、检索结果、工具返回、任务状态、中间产物、系统规则、安全约束、别的 Agent 传来的结构化结果。Prompt 只是其中一小块。
RAG 是这级的典型实践:先检索再塞上下文。但成熟的 Context 工程不止检索,它管整条链路------文档怎么切块、结果怎么排序、长文怎么压缩、历史何时保留何时摘要、工具返回要不要全暴露、多 Agent 间传原文还是摘要还是结构化字段。
前两篇讲过的 Agent Skills(渐进式披露:不一开始把十几个工具说明全塞进来,等触发再动态加载),本质也是这一级的高级手法。核心信条就一句:上下文是稀缺资源,优化不是给更多,是按需给、分层给、在正确时机给。
但这级也有够不着的地方:就算信息喂对了,模型也不一定稳定执行对。它可能计划漂亮,执行却跑偏------掉工具、误读返回、长链路里悄悄偏航而系统毫无察觉。Prompt 和 Context 都在解决输入侧 (意图表达 + 信息供给),可模型一旦连续行动,谁来监督它、约束它、拉回它?
第三级 · Harness Engineering:把执行驾驭住
Harness 原意是缰绳、马具。借到 AI 里,提醒的是件朴素的事:模型从"回答问题"走到"执行任务",系统不只负责喂信息,还要驾驭整个过程。
前两级关注"让模型更会响应",这级关注"让模型别跑偏、跑得稳、出了错还拉得回来"。
一个类比,讲清三者的包含关系
开一辆车送重要客人去机场:
- Prompt:你把任务跟司机讲清楚------走哪条路、几点到、乘客要安静。重点是把意图说清楚。
- Context:你把信息喂齐------导航路线、实时路况、油量、乘客行李数量。重点是信息供给对不对。
- Harness :你装了方向盘助力、车道偏离提醒、疲劳驾驶监测、备胎和保险,还要求司机每段路汇报、到站按清单验收。重点是执行全程有人盯、有偏差能纠、出事能兜底。
三者不是替代,是包含:Prompt ⊂ Context ⊂ Harness。边界一层比一层大。
三、成熟 Harness 的六层架构
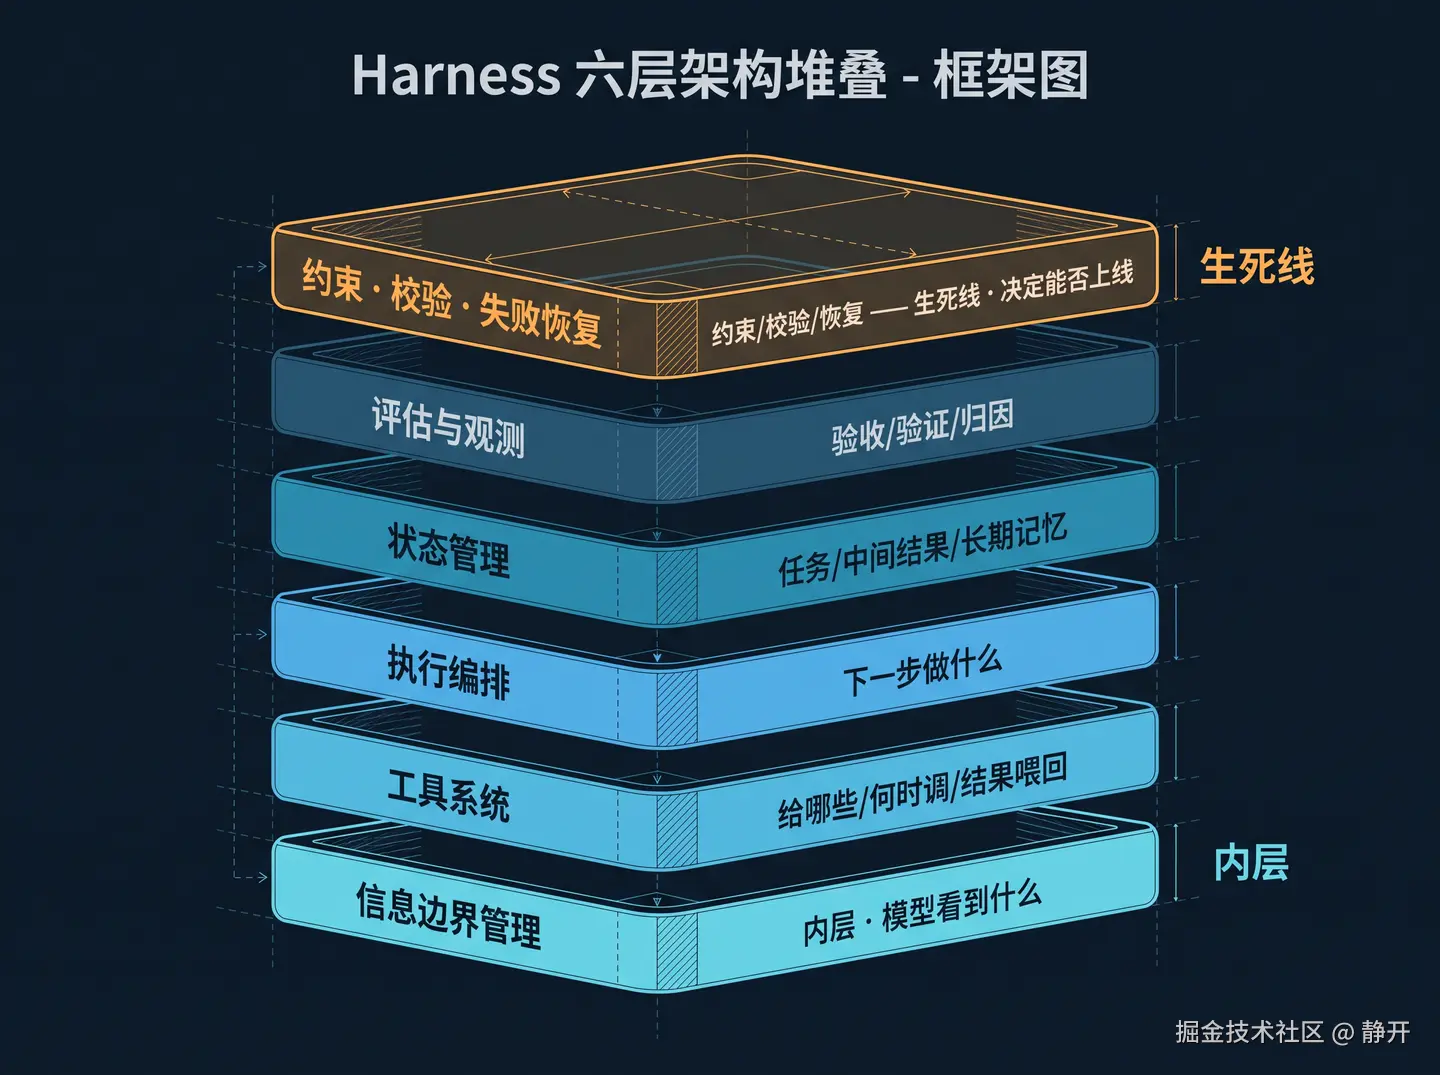
把 Harness 摆开看,我把它归成六层。这六层从内到外,越往外越是"能不能上线"的生死线。
第一层 · 信息边界管理。 重新站到 Harness 视角看 Context:模型发挥稳不稳,很多时候取决于它看到了什么。这层管三件事------角色与目标的定义(你是谁、成功标准是什么)、信息裁剪(越相关越好,不是越多越好)、结构化分区(固定规则、当前任务、运行状态、外部证据各归其位)。信息一乱,模型就漏重点、忘约束,甚至自我污染。
第二层 · 工具系统。 没工具,大模型的本质就是个文本预测器,碰不到真实世界。但 Harness 不是简单挂工具,它要回答三个问题:给哪些工具(太少不够用、太多会乱用)、什么时候调(不该查别乱查、该查别硬答)、工具结果怎么喂回(几十条搜索结果不能原封塞回去,要提炼筛选保相关性)。
第三层 · 执行编排。 解决"下一步做什么"。很多 Agent 不是某一步不会,而是不会把步骤串起来------会搜、会总结、会写代码,结果想到哪做到哪,交出一堆半成品。一条完整轨道该是:理解目标 → 判断信息够不够 → 基于结果分析 → 生成输出 → 检查不达标就修正重试。区别于人的是:人靠经验,Agent 靠这套环境、记忆和状态。
第四层 · 状态管理。 没状态的 Agent 每轮都像失忆。至少要分清三类东西:当前任务状态、会话中间结果、长期记忆与用户偏好。混在一起系统必然越来越乱。
第五层 · 评估与观测。 最被轻视的一层。很多系统不是生成不出来,是生成完了不知道自己做得好不好。没有独立评估,Agent 就长期停在"自我感觉良好"。这层包括输出验收、环境验证、自动测试日志指标、错误归因。会做,还要知道自己有没有真做对。
第六层 · 约束、校验与失败恢复。 这层才真正决定能不能上线。真实环境里失败不是例外是常态------搜索不准、API 超时、文档混乱、模型误解任务。没有恢复机制,每次出错只能从头再来。这层管三件事:约束(能做什么不能做什么)、校验(输出前后怎么检查)、恢复(失败后重试、切回、回滚到稳定状态)。
把这六层落到代码里,大概长这样(我写的最小骨架,只为示意六层在主循环里的投影,非任何真实框架代码):
python
def run_task(goal):
    state = {"goal": goal, "steps": [], "verified": False}
    while not state["verified"]:
        plan = planner(state)               # 编排:下一步做什么
        result = executor(plan, tools)      # 工具系统 + 状态管理
        if not validator(result):           # 评估观测 + 校验
            state = recover(state, result)  # 失败恢复
            continue
        state["steps"].append(result)
        state["verified"] = evaluator(state)  # 独立验收(生产/验收分离)
    return state
看到没?六层不是六张孤立的图,而是同一个主循环里六个职责。缺哪一层,循环就在哪里漏。
四、一线公司到底怎么用
概念讲完,看真正有参考价值的部分------谁把 Harness 做进了产品。
战绩很直白:LangChain 底层模型不变,只改 Harness,把自家 Agent 从榜单 30 开外杀进前 5;OpenAI 用几名人类工程师 + Agent 搭出百万行代码的生产级应用,100% 代码 Agent 写,耗时纯人工的十分之一;Anthropic 做到一句自然语言需求、无人干预连跑数小时,产出完整游戏和数字音频工作站。
挑两个最有迁移价值的实践讲。
Anthropic 之一:对付「上下文焦虑」
长程自主任务里,模型会得一种病(作者叫「上下文焦虑」,我沿用一次):上下文越塞越满,模型开始丢细节、丢重点,甚至出现一种微妙现象------它好像知道自己快装不下了,于是急着草草收尾。
常规解法是 Context Compaction(压缩历史再继续)。但 Anthropic 发现对某些模型这还不够------压缩只是变短,那种「快撑爆」的负担感没真正消失。
他们做了更激进的一招:Context Reset------不在这条上下文里硬压,而是开一个干净的新 Agent,把工作交接过去。
我换个壳讲:像长跑接力赛,一个选手跑累了不硬撑、不靠喝咖啡死扛,而是把棒交给一个状态满格的新选手继续跑。也像工程里遇到内存泄漏------与其一遍遍清缓存,不如直接重启进程再恢复状态。本质都是:承认局部状态会腐化,用交接代替硬撑。这是非常典型的 Harness 设计------它管的不是模型能力,是运行节奏。
Anthropic 之二:生产与验收必须分离
模型自己干活再给自己打分,几乎必然偏乐观。尤其在体验、产品完整度这类没标准答案的问题上,偏差更明显。
Anthropic 的解法是一条铁律:把干活的人和验收的人拆开。
- Planner:把模糊需求扩成完整规格
- Generator:逐步实现
- Evaluator:像 QA 一样真实测试
关键在 Evaluator 不只看代码,它真实操作页面、看交互、查实际结果。不是抽象审查,是具体环境验证。
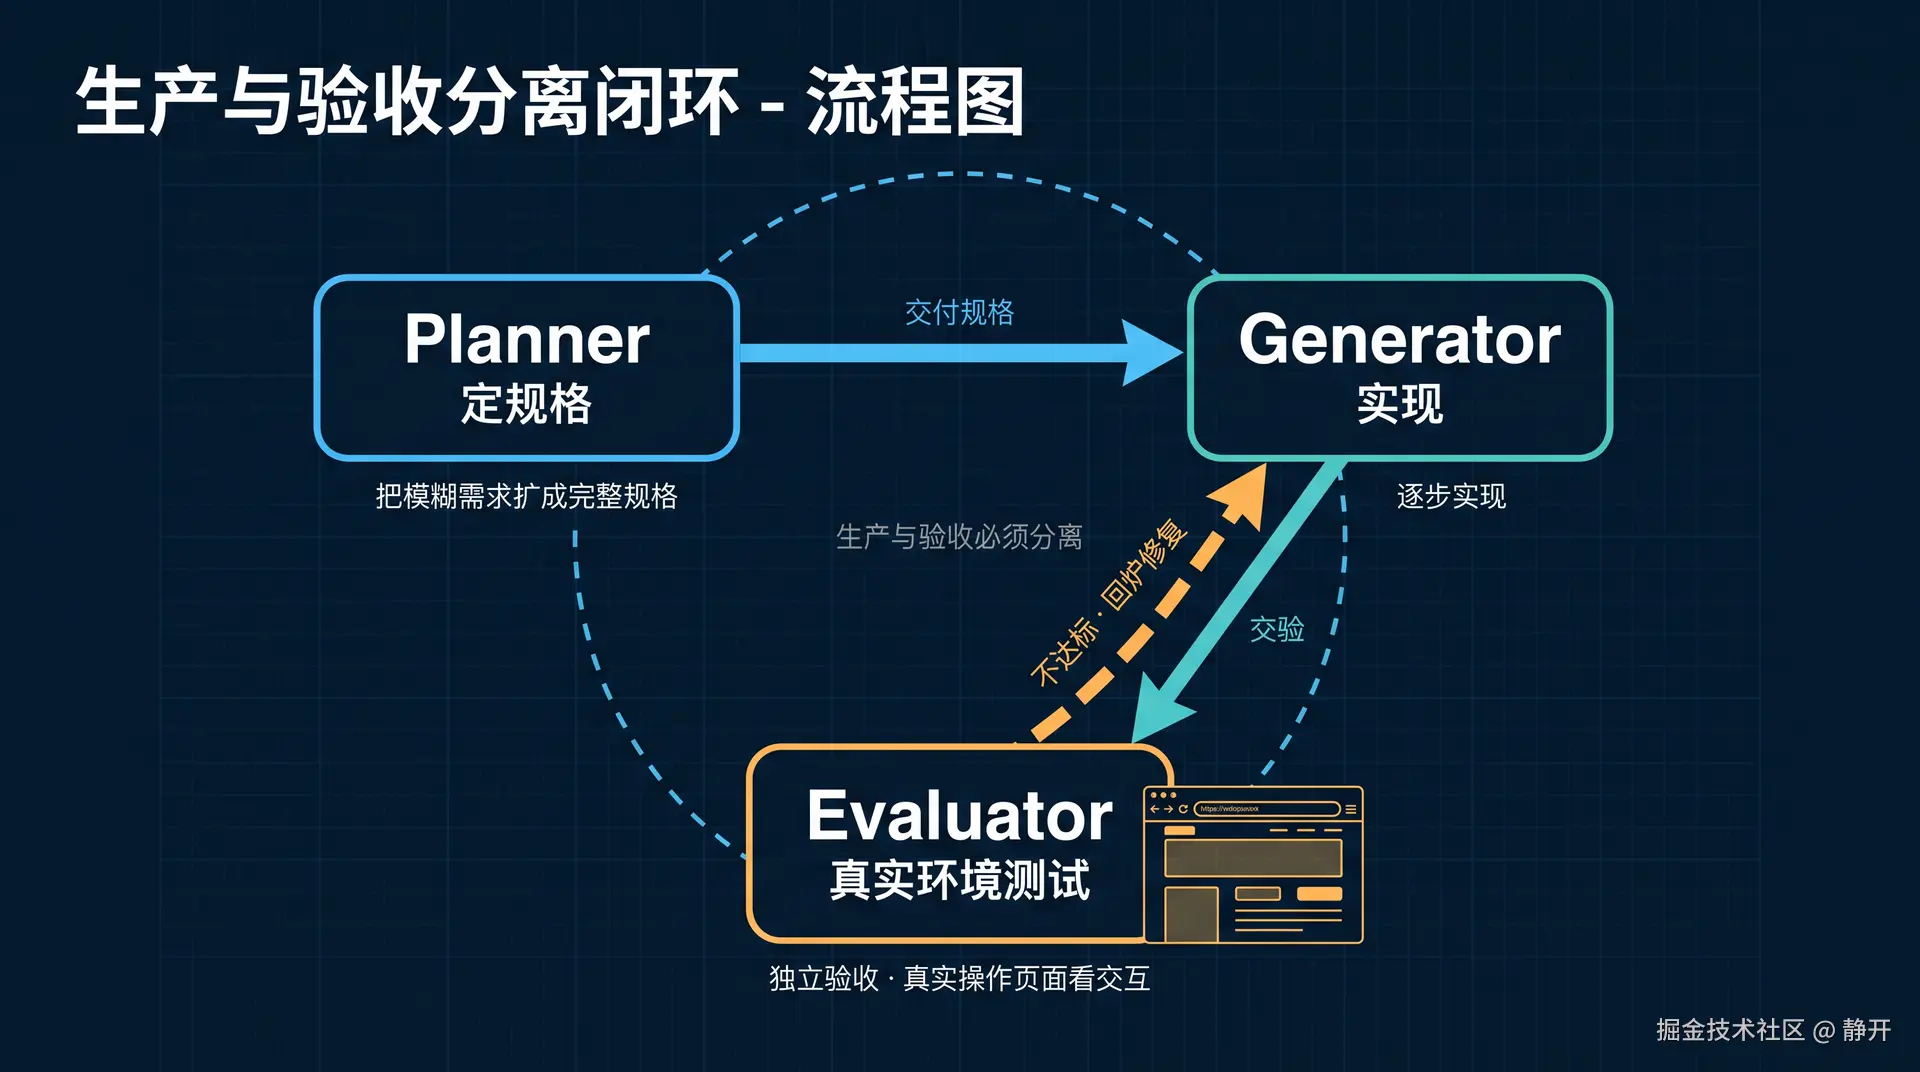
这背后是个老辣的工程原则,用考试类比最清楚:让学生出题又自己批卷,必将偏乐观;必须换老师独立阅卷。 只要评估者足够独立,系统就能形成"生成→检查→修复→再检查"的有效循环。
OpenAI:工程师不写代码,只设计环境
OpenAI 的实践等于重定义了 Agent 时代工程师的活:人类一行代码不写,只负责设计环境。三件事------把产品目标拆成 Agent 能懂的小任务;Agent 失败时不让它"更努力点",而是问环境缺了什么能力;建立反馈链路让 Agent 看见自己的工作结果。
最值得记的一句话:Agent 出问题时,修复方案几乎从来不是「更努力一点」,而是确定它缺了什么结构性能力。------这是 Harness 思维的内核。
他们还踩过一个人人都会踩的坑:早期写了一个巨大的 Agent.md,把所有规范全塞进去,结果 Agent 更糊涂了。道理前两篇讲过------上下文窗口稀缺,塞满等于什么都没说。后来改成目录页 + 子文档,需要时再钻进去。和 Skills 的渐进式披露同一个根:不一次性全给,按需索取。
更狠的是自动治理:Agent 提交太快,人类 Code Review 根本盯不过来,于是把资深工程师的经验直接写成系统规则------模块怎么分层、哪层不能依赖哪层、什么时候必须拦截。而且规则不只报错,还把"该怎么修"一起返回给 Agent,进入下一轮上下文。这已经不是代码规范了,是一套可持续运转的自动治理系统。
五、收口:上限归模型,下限归 Harness
把三阶段收成一句:
- Prompt Engineering:把任务讲清楚
- Context Engineering:把信息喂对
- Harness Engineering:让模型在真实执行里持续做对
Harness 不取代前两者,它在更大的系统边界上把两者包了进去。任务还是单轮生成时 Prompt 重要;依赖外部知识时 Context 关键;一旦进入长链路、可执行、低容错的真实场景------Harness 几乎不可避免。
这也解释了开头那个执念为什么总落空:同样的模型,在不同产品里表现天差地别,因为真正决定上限的可能是模型,但真正决定能不能落地、能不能稳定交付的,是 Harness。
AI 落地的核心战场,正在从"让模型看起来更聪明",转向"让模型在真实世界里稳定工作"。这趟车,做 Agent 的人趁早想明白。
模型决定 Agent 能多聪明,Harness 决定 Agent 能不能上线。前者是天花板,后者是准入证。