AI Agent 工程化落地实战系列 第 18 篇(核心技能篇)
摘要
本文是 AI Agent 工程化落地实战系列第 18 篇,聚焦多模态 Agent 的设计与实现。我们从实际应用场景出发,系统讲解如何让 Agent 具备视觉理解(图片描述、OCR、图表解析)、语音交互(ASR + TTS)以及多模态融合处理能力。文章涵盖多模态工具设计模式、融合架构方案,并提供一个完整的多模态 Agent 实现代码。通过本文,你将掌握构建能"看"、能"听"、能"说"的智能 Agent 的核心方法论。
版本声明:本文基于 Python 3.10+,核心依赖包括 OpenAI API (gpt-4o)、Whisper、 pyttsx3 / Edge-TTS、Pillow 等,写作时间为 2025 年,相关 API 接口和库版本以官方最新文档为准。
适用边界:本文方案适用于中小规模多模态 Agent 的快速原型开发与生产部署。对于超大规模实时流式多模态交互(如实时视频流分析),需要结合流式处理框架另行设计。
文章目录
-
- 摘要
- [一、多模态 Agent 的应用场景与核心挑战](#一、多模态 Agent 的应用场景与核心挑战)
-
- [1.1 为什么 Agent 需要多模态能力?](#1.1 为什么 Agent 需要多模态能力?)
- [1.2 多模态 Agent 的能力矩阵](#1.2 多模态 Agent 的能力矩阵)
- [1.3 核心技术挑战](#1.3 核心技术挑战)
- [二、视觉理解:让 Agent "看懂"图片](#二、视觉理解:让 Agent "看懂"图片)
-
- [2.1 图片描述:从像素到语义](#2.1 图片描述:从像素到语义)
- [2.2 OCR 文字识别:提取图片中的文字](#2.2 OCR 文字识别:提取图片中的文字)
- [2.3 图表解析:理解数据可视化](#2.3 图表解析:理解数据可视化)
- [2.4 视觉理解工具的 Agent 集成](#2.4 视觉理解工具的 Agent 集成)
- [三、语音交互:让 Agent "听懂"和"说话"](#三、语音交互:让 Agent "听懂"和"说话")
-
- [3.1 语音识别(ASR)](#3.1 语音识别(ASR))
- [3.2 语音合成(TTS)](#3.2 语音合成(TTS))
- [3.3 语音 Agent 的交互循环](#3.3 语音 Agent 的交互循环)
- 四、多模态融合:如何将文本、图片、语音统一处理
-
- [4.1 多模态消息格式](#4.1 多模态消息格式)
- [4.2 多模态上下文管理](#4.2 多模态上下文管理)
- [4.3 多模态融合架构](#4.3 多模态融合架构)
- 五、多模态工具设计:图片生成、语音合成等工具的定义
-
- [5.1 工具设计原则](#5.1 工具设计原则)
- [5.2 图片生成工具](#5.2 图片生成工具)
- [5.3 完整工具注册](#5.3 完整工具注册)
- [六、实战:一个多模态 Agent 的完整实现](#六、实战:一个多模态 Agent 的完整实现)
- 七、适用边界与风险提示
-
- [7.1 技术适用边界](#7.1 技术适用边界)
- [7.2 成本分析](#7.2 成本分析)
- [7.3 风险提示与应对措施](#7.3 风险提示与应对措施)
- 八、总结
- 参考资料
一、多模态 Agent 的应用场景与核心挑战
1.1 为什么 Agent 需要多模态能力?
传统的文本对话 Agent 只能处理文字输入和文字输出,这在很多实际场景中是远远不够的。设想以下场景:
- 智能客服:用户上传一张商品破损的照片,Agent 需要识别损坏类型并判断是否符合理赔条件。
- 医疗辅助:医生上传一张 X 光片,Agent 需要识别异常区域并给出初步分析。
- 会议助手:Agent 听完一场会议录音,自动生成会议纪要和待办事项。
- 内容创作:用户描述一个创意,Agent 生成配图、配音的短视频脚本。
- 数据分析:Agent 看到一张柱状图截图,解读数据趋势并给出建议。
这些场景有一个共同点:信息载体不仅仅是文字。人类获取信息的方式天然是多模态的------我们看到画面、听到声音、阅读文字、表达情感。一个真正实用的 Agent,必须能够跨越单一模态的边界。
1.2 多模态 Agent 的能力矩阵
一个完整的多模态 Agent 通常需要具备以下能力:
| 能力维度 | 输入模态 | 输出模态 | 典型技术 | 应用场景 |
|---|---|---|---|---|
| 视觉理解 | 图片/视频 | 文本 | GPT-4V, Claude Vision, Qwen-VL | 图片描述、OCR、图表解析、缺陷检测 |
| 语音识别 | 音频 | 文本 | Whisper, paraformer, conformer | 会议转写、语音指令 |
| 语音合成 | 文本 | 音频 | Edge-TTS, Azure TTS, CosyVoice | 语音播报、有声内容 |
| 图片生成 | 文本 | 图片 | DALL-E 3, Stable Diffusion, Midjourney | 配图生成、设计辅助 |
| 多模态融合 | 多模态 | 多模态 | LLM + Tool Use | 综合判断、跨模态推理 |
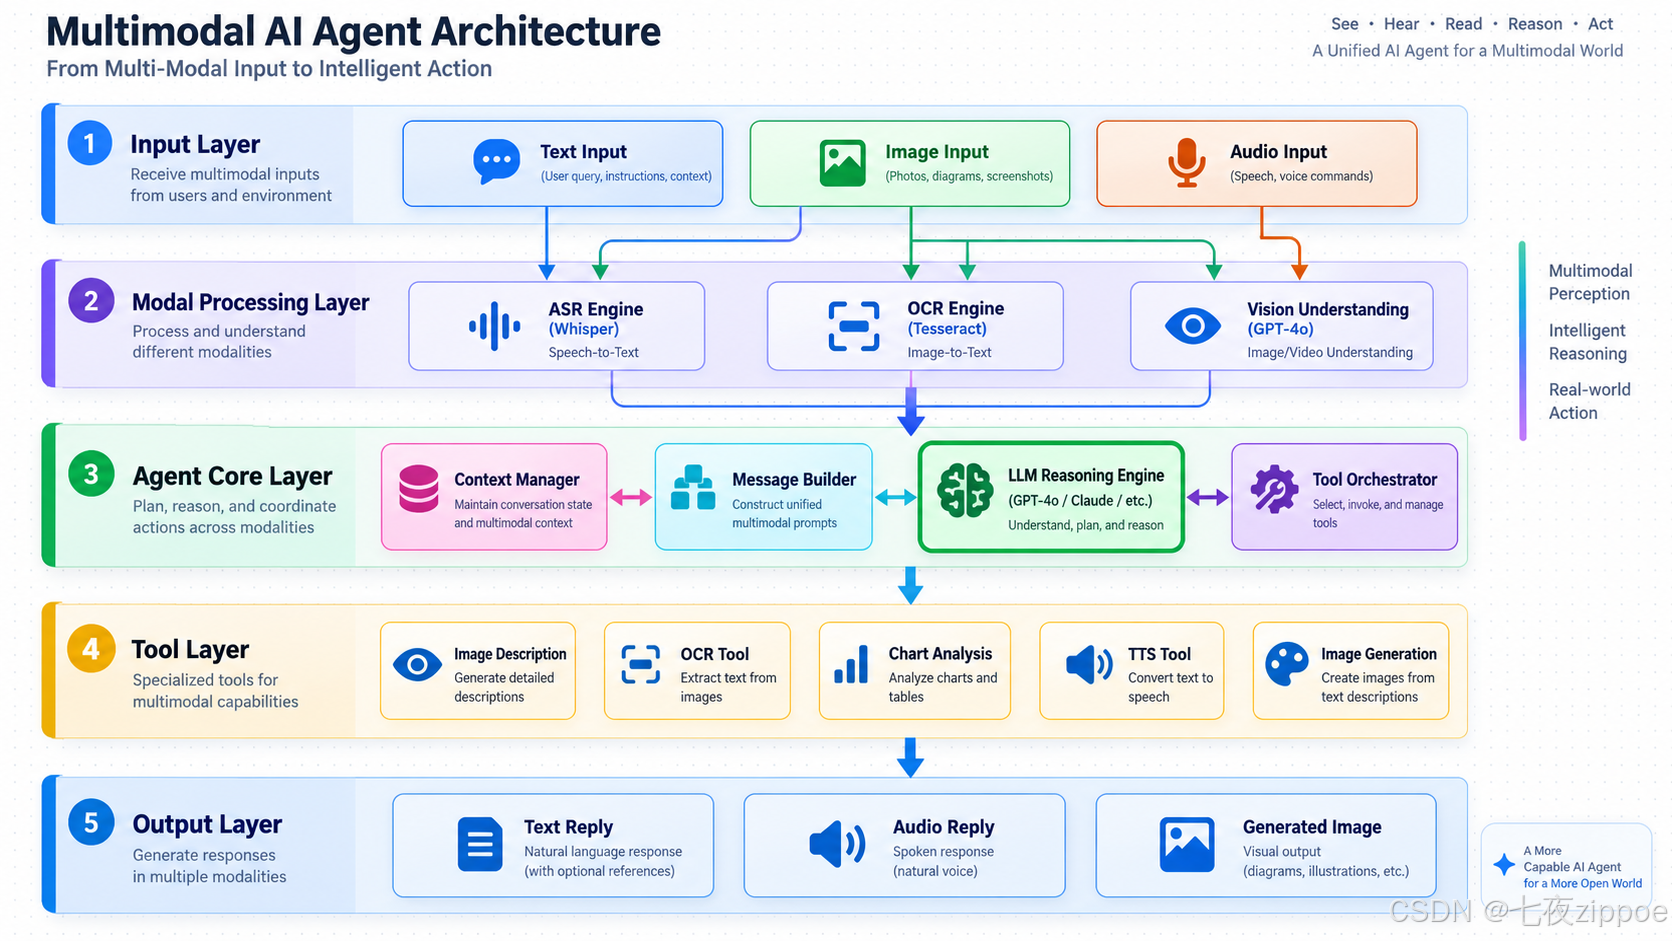
图:多模态Agent五层架构:输入层(文本/图片/音频)→模态处理层(ASR/OCR/Vision)→Agent核心层(上下文管理/消息构建/LLM推理/工具编排)→工具层(图片描述/OCR/图表分析/TTS/图片生成)→输出层(文本/语音/图片)
1.3 核心技术挑战
构建多模态 Agent 并非简单地把多个模型串联起来。真正的挑战在于:
挑战一:模态对齐问题
不同模态的信息密度和结构差异巨大。一张图片可能包含数千个像素的信息,而对应的文字描述可能只有一句话。如何让 Agent 在不同模态之间建立有效的语义映射,是首要难题。
#mermaid-svg-V0o2yQuucFmz0aF3{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-V0o2yQuucFmz0aF3 .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-V0o2yQuucFmz0aF3 .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-V0o2yQuucFmz0aF3 .error-icon{fill:#552222;}#mermaid-svg-V0o2yQuucFmz0aF3 .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-V0o2yQuucFmz0aF3 .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-V0o2yQuucFmz0aF3 .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-V0o2yQuucFmz0aF3 .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-V0o2yQuucFmz0aF3 .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-V0o2yQuucFmz0aF3 .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-V0o2yQuucFmz0aF3 .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-V0o2yQuucFmz0aF3 .marker{fill:#333333;stroke:#333333;}#mermaid-svg-V0o2yQuucFmz0aF3 .marker.cross{stroke:#333333;}#mermaid-svg-V0o2yQuucFmz0aF3 svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-V0o2yQuucFmz0aF3 p{margin:0;}#mermaid-svg-V0o2yQuucFmz0aF3 .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-V0o2yQuucFmz0aF3 .cluster-label text{fill:#333;}#mermaid-svg-V0o2yQuucFmz0aF3 .cluster-label span{color:#333;}#mermaid-svg-V0o2yQuucFmz0aF3 .cluster-label span p{background-color:transparent;}#mermaid-svg-V0o2yQuucFmz0aF3 .label text,#mermaid-svg-V0o2yQuucFmz0aF3 span{fill:#333;color:#333;}#mermaid-svg-V0o2yQuucFmz0aF3 .node rect,#mermaid-svg-V0o2yQuucFmz0aF3 .node circle,#mermaid-svg-V0o2yQuucFmz0aF3 .node ellipse,#mermaid-svg-V0o2yQuucFmz0aF3 .node polygon,#mermaid-svg-V0o2yQuucFmz0aF3 .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-V0o2yQuucFmz0aF3 .rough-node .label text,#mermaid-svg-V0o2yQuucFmz0aF3 .node .label text,#mermaid-svg-V0o2yQuucFmz0aF3 .image-shape .label,#mermaid-svg-V0o2yQuucFmz0aF3 .icon-shape .label{text-anchor:middle;}#mermaid-svg-V0o2yQuucFmz0aF3 .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-V0o2yQuucFmz0aF3 .rough-node .label,#mermaid-svg-V0o2yQuucFmz0aF3 .node .label,#mermaid-svg-V0o2yQuucFmz0aF3 .image-shape .label,#mermaid-svg-V0o2yQuucFmz0aF3 .icon-shape .label{text-align:center;}#mermaid-svg-V0o2yQuucFmz0aF3 .node.clickable{cursor:pointer;}#mermaid-svg-V0o2yQuucFmz0aF3 .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-V0o2yQuucFmz0aF3 .arrowheadPath{fill:#333333;}#mermaid-svg-V0o2yQuucFmz0aF3 .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-V0o2yQuucFmz0aF3 .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-V0o2yQuucFmz0aF3 .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-V0o2yQuucFmz0aF3 .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-V0o2yQuucFmz0aF3 .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-V0o2yQuucFmz0aF3 .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-V0o2yQuucFmz0aF3 .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-V0o2yQuucFmz0aF3 .cluster text{fill:#333;}#mermaid-svg-V0o2yQuucFmz0aF3 .cluster span{color:#333;}#mermaid-svg-V0o2yQuucFmz0aF3 div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-V0o2yQuucFmz0aF3 .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-V0o2yQuucFmz0aF3 rect.text{fill:none;stroke-width:0;}#mermaid-svg-V0o2yQuucFmz0aF3 .icon-shape,#mermaid-svg-V0o2yQuucFmz0aF3 .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-V0o2yQuucFmz0aF3 .icon-shape p,#mermaid-svg-V0o2yQuucFmz0aF3 .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-V0o2yQuucFmz0aF3 .icon-shape .label rect,#mermaid-svg-V0o2yQuucFmz0aF3 .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-V0o2yQuucFmz0aF3 .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-V0o2yQuucFmz0aF3 .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-V0o2yQuucFmz0aF3 :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 视觉编码器
文本编码器
音频编码器
图片输入
视觉特征向量
文本输入
文本特征向量
音频输入
音频特征向量
跨模态对齐层
统一语义空间
LLM 推理引擎
多模态输出
挑战二:上下文窗口管理
多模态输入的数据量远超纯文本。一张高分辨率图片经过编码后可能占用数千 token 的上下文空间,一段 10 分钟的音频转写后可能有上万字。如何在有限的上下文窗口中高效管理多模态信息,直接影响 Agent 的推理质量。
挑战三:工具编排复杂度
多模态 Agent 通常需要调用多个外部工具(视觉模型、语音模型、图片生成模型等)。不同工具的输入输出格式各异,延迟特性不同,错误处理方式也不一样。设计一个健壮的工具编排层是工程化的关键。
挑战四:成本与延迟的平衡
多模态模型通常比纯文本模型更昂贵、更慢。一张图片的视觉理解 API 调用成本可能是文本调用的 3-5 倍,语音合成和图片生成的耗时可能达到数秒到数十秒。如何在用户体验和成本之间找到平衡点,是一个需要持续优化的工程问题。
二、视觉理解:让 Agent "看懂"图片
视觉理解是多模态 Agent 最核心的能力之一。我们将从图片描述、OCR 文字识别和图表解析三个维度展开。
2.1 图片描述:从像素到语义
图片描述是视觉理解的基础能力------给定一张图片,Agent 能够用自然语言描述图片内容。当前主流方案有两种:
- 多模态大模型直接理解:如 GPT-4o、Claude 3.5 Sonnet、Qwen-VL 等,直接将图片输入模型,模型输出描述文本。
- 视觉编码器 + LLM 组合:如 BLIP-2 架构,使用视觉编码器提取特征,再通过 Q-Former 对齐到 LLM 的语义空间。
对于工程实践,推荐使用多模态大模型 API,因为它省去了模型部署和特征对齐的复杂工作。
下面是一个基于 OpenAI Vision API 的图片描述工具实现:
python
import base64
import json
from pathlib import Path
from openai import OpenAI

client = OpenAI()

def describe_image(image_path: str, prompt: str = "详细描述这张图片的内容") -> str:
    """
    使用 GPT-4o 的视觉能力描述图片内容。

    参数:
        image_path: 图片文件路径
        prompt: 引导描述的提示词

    返回:
        图片内容的文字描述

    工作原理:
        将图片转为 base64 编码,作为 multimodal 消息的一部分
        发送给 GPT-4o,模型同时处理图像和文本信息生成描述。
        支持 jpg/png/gif/webp 等主流格式,单次最大 20MB。
    """
    path = Path(image_path)
    if not path.exists():
        raise FileNotFoundError(f"图片不存在: {image_path}")

    # 读取图片并编码为 base64
    image_data = base64.b64encode(path.read_bytes()).decode("utf-8")

    # 根据文件扩展名确定 MIME 类型
    mime_map = {
        ".jpg": "image/jpeg", ".jpeg": "image/jpeg",
        ".png": "image/png", ".gif": "image/gif",
        ".webp": "image/webp"
    }
    mime_type = mime_map.get(path.suffix.lower(), "image/jpeg")

    response = client.chat.completions.create(
        model="gpt-4o",
        messages=[
            {
                "role": "user",
                "content": [
                    {"type": "text", "text": prompt},
                    {
                        "type": "image_url",
                        "image_url": {
                            "url": f"data:{mime_type};base64,{image_data}",
                            "detail": "high"  # high 模式提供更精细的视觉理解
                        }
                    }
                ]
            }
        ],
        max_tokens=1000
    )
return response.choices[0].message.content上述代码实现了图片描述工具的核心逻辑。detail 参数设为 "high" 让模型以更高分辨率分析图片,适合需要识别细节的场景(如产品缺陷检测)。对于只需要整体概览的场景,可以用 "low" 降低 token 消耗。注意 base64 编码会增大传输数据量约 33%,对于大图片建议先进行压缩。
2.2 OCR 文字识别:提取图片中的文字
虽然多模态大模型已经能识别图片中的文字,但在需要高精度 OCR 的场景下(如票据识别、证件信息提取),专业的 OCR 引擎仍然更可靠。
python
import pytesseract
from PIL import Image, ImageEnhance
from typing import List, Dict

def extract_text_from_image(
    image_path: str,
    lang: str = "chi_sim+eng",
    preprocess: bool = True
) -> Dict[str, any]:
    """
    从图片中提取文字内容,支持中英文混合识别。

    参数:
        image_path: 图片路径
        lang: 识别语言,chi_sim 为简体中文,eng 为英文
        preprocess: 是否进行图像预处理(灰度化、增强对比度、二值化)

    返回:
        包含完整文本和结构化信息的字典:
        - full_text: 完整识别文本
        - words: 单词列表(含位置坐标)
        - confidence: 平均置信度

    原理:
        使用 Tesseract OCR 引擎,它是基于 LSTM 的文字识别系统。
        图像预处理可以显著提升识别准确率,尤其是对低质量图片。
        对于复杂版面(表格、多栏),建议使用 PaddleOCR 或云服务。
    """
    img = Image.open(image_path)

    if preprocess:
        # 转灰度图,减少颜色干扰
        img = img.convert("L")
        # 增强对比度,使文字与背景更分离
        enhancer = ImageEnhance.Contrast(img)
        img = enhancer.enhance(2.0)

    # 获取完整文本
    full_text = pytesseract.image_to_string(img, lang=lang)

    # 获取带位置和置信度的单词级结果
    data = pytesseract.image_to_data(img, lang=lang, output_type=pytesseract.Output.DICT)

    words = []
    confidences = []
    for i in range(len(data["text"])):
        if data["text"][i].strip():
            words.append({
                "text": data["text"][i],
                "x": data["left"][i],
                "y": data["top"][i],
                "width": data["width"][i],
                "height": data["height"][i]
            })
            confidences.append(float(data["conf"][i]))

    avg_conf = sum(confidences) / len(confidences) if confidences else 0

    return {
        "full_text": full_text.strip(),
        "words": words,
        "confidence": round(avg_conf, 2)
    }
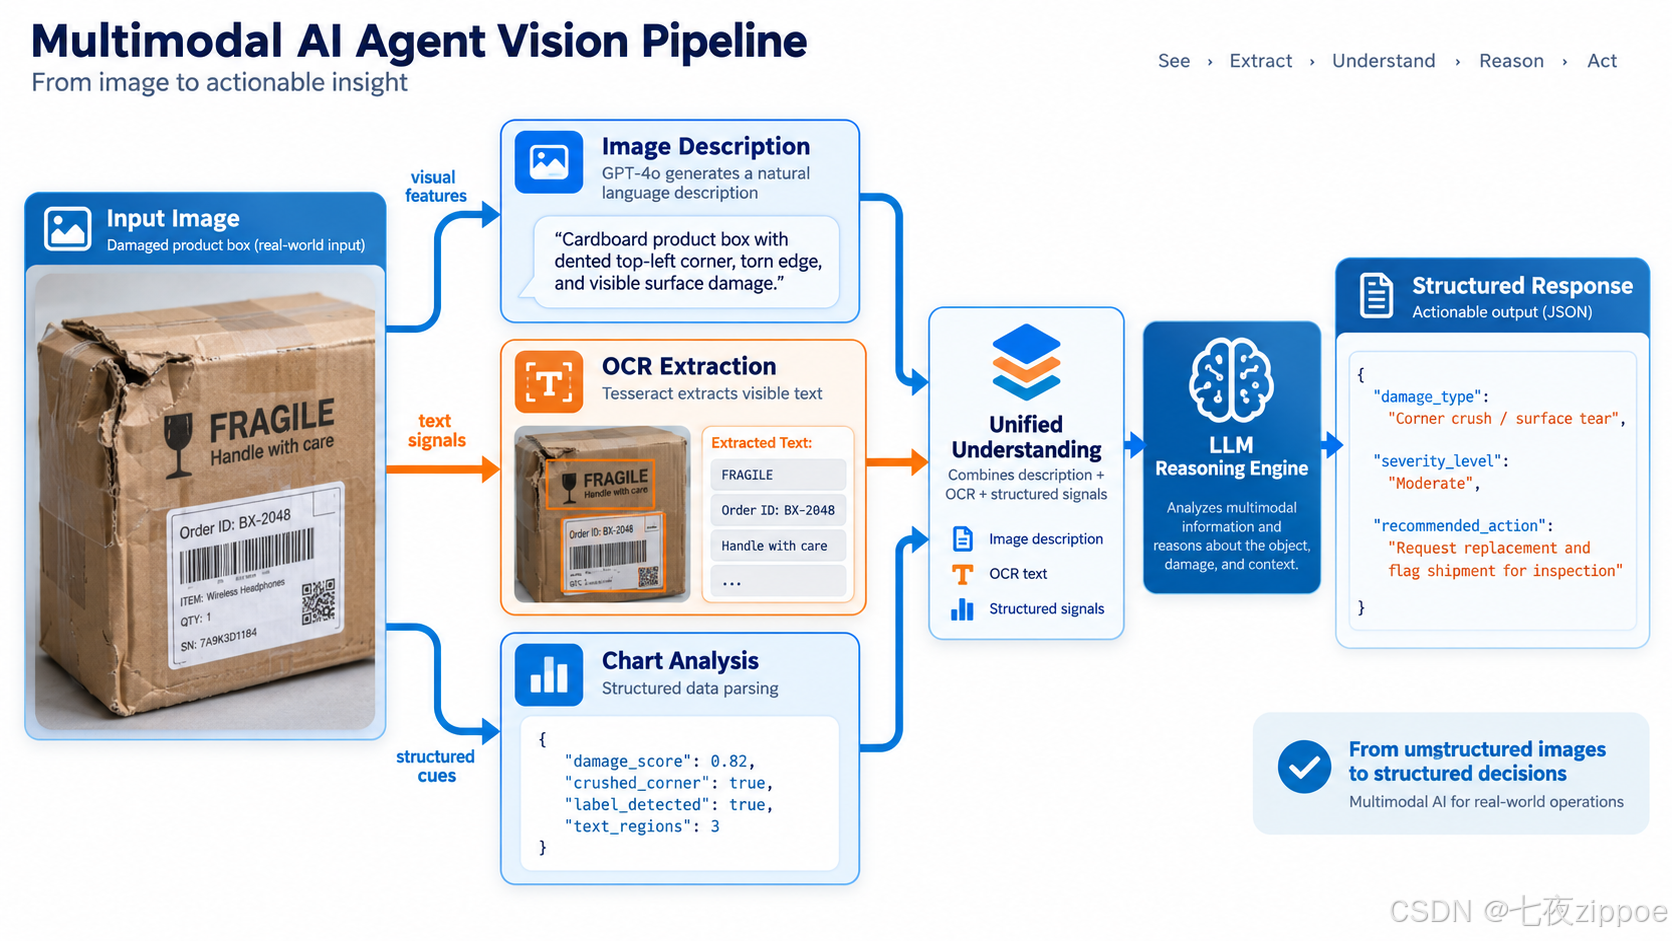
这段代码使用 Tesseract OCR 引擎进行文字识别。关键点在于图像预处理:灰度化减少了颜色通道的干扰,对比度增强使文字边缘更清晰,这对低质量扫描件尤为重要。返回结果不仅包含完整文本,还包含每个文字块的位置坐标和置信度,方便后续做版面分析和信息抽取。对于复杂的中文场景,推荐使用 PaddleOCR,它在中文识别准确率上明显优于 Tesseract。
2.3 图表解析:理解数据可视化
Agent 在实际应用中经常遇到用户发来的图表截图,需要理解图表中的数据趋势和含义。这是一个比 OCR 更复杂的任务,因为它不仅需要识别文字,还需要理解图形元素的语义。
python
def analyze_chart(image_path: str, context: str = "") -> Dict[str, any]:
    """
    分析图表图片,提取数据趋势和关键洞察。

    参数:
        image_path: 图表图片路径
        context: 额外上下文(如"这是2024年Q3的销售数据")

    返回:
        分析结果字典,包含图表类型、数据趋势、关键发现

    原理:
        利用 GPT-4o 的视觉理解能力,通过精心设计的提示词
        引导模型识别图表类型、提取数据点、分析趋势。
        对于标准图表(柱状/折线/饼图),准确率可达 90%+。
        对于复杂复合图表,建议结合专业工具如 ChartOCR。
    """
    prompt = f"""
    你是一位数据分析专家。请分析这张图表并返回以下信息:

    1. 图表类型(柱状图/折线图/饼图/散点图/混合图等)
    2. 坐标轴含义和单位
    3. 主要数据点(尽可能精确地读取数值)
    4. 数据趋势(上升/下降/波动/季节性等)
    5. 异常值或值得关注的点
    6. 简要总结(2-3句话)

    请以 JSON 格式返回结果。

    额外上下文: {context}
    """

    image_data = base64.b64encode(Path(image_path).read_bytes()).decode("utf-8")

    response = client.chat.completions.create(
        model="gpt-4o",
        messages=[{
            "role": "user",
            "content": [
                {"type": "text", "text": prompt},
                {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{image_data}"}}
            ]
        }],
        response_format={"type": "json_object"},
        temperature=0.1  # 低温度保证结果稳定
    )

    return json.loads(response.choices[0].message.content)
这段代码将图表分析任务转化为结构化的视觉问答。关键在于提示词设计:明确要求识别图表类型、数据趋势、异常值等维度,并要求 JSON 格式输出。temperature 设为 0.1 确保多次调用结果的一致性,这对数据分析场景非常重要。注意,模型对数值的读取是近似值,需要精确数据时仍应获取原始数据源。
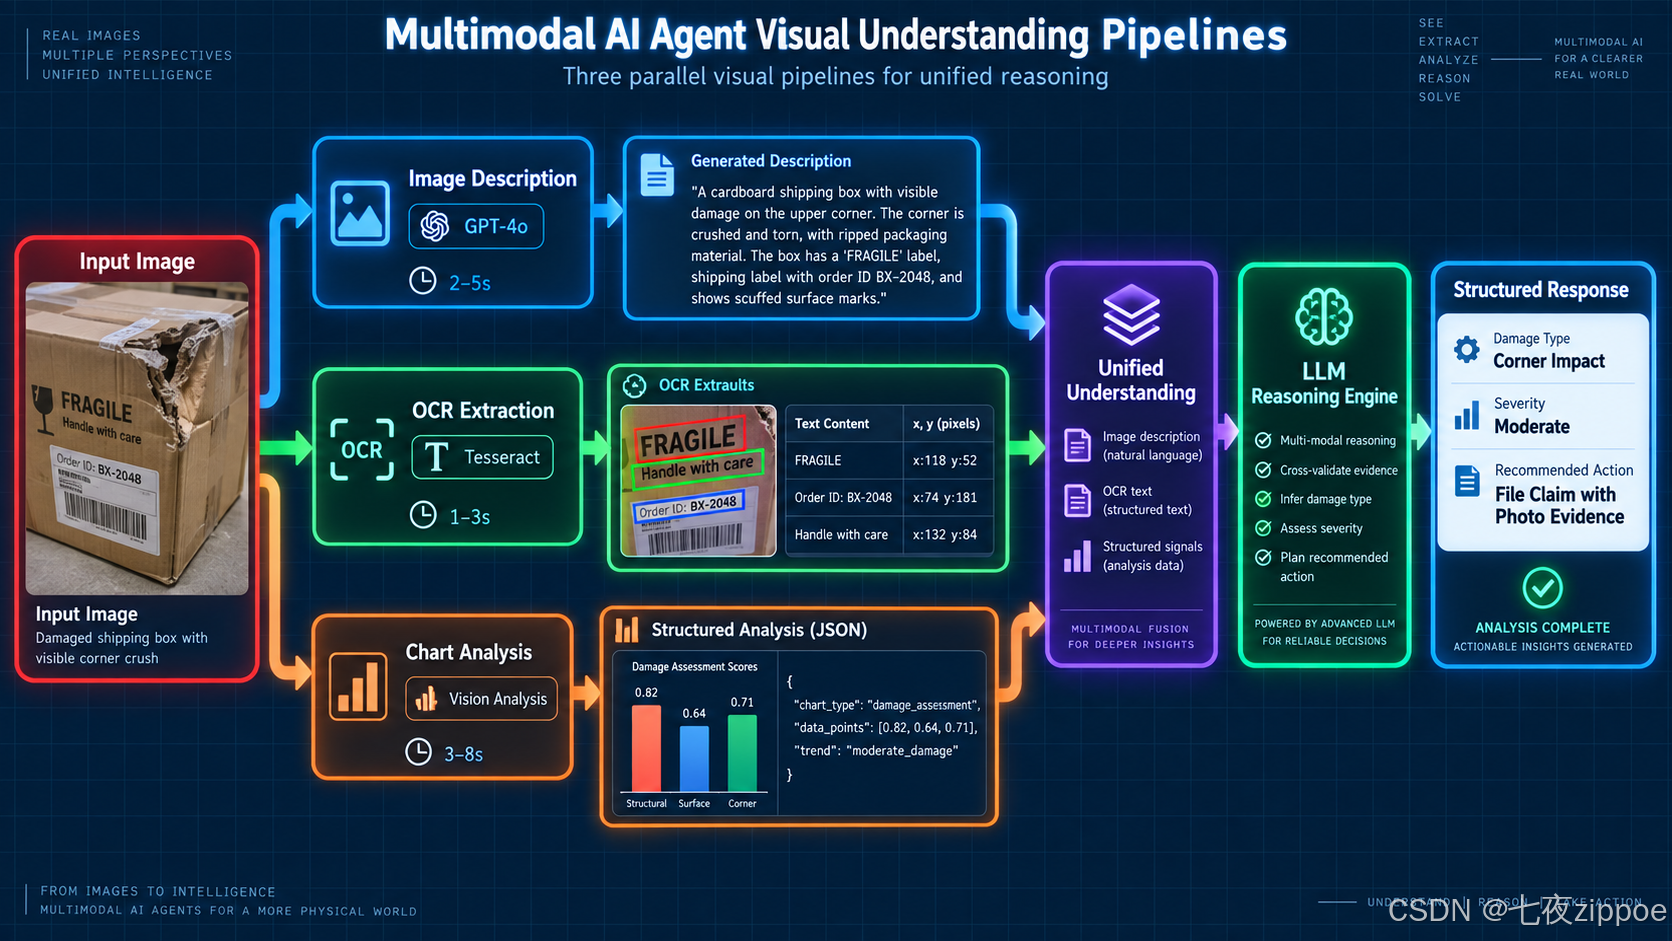
图:图片输入分三路并行处理:图片描述(GPT-4o生成自然语言)、OCR提取(Tesseract提取带坐标文字)、图表分析(数据解析为结构化格式),三路结果汇入统一理解节点
2.4 视觉理解工具的 Agent 集成
将上述视觉能力封装为 Agent 可调用的工具,是构建多模态 Agent 的第一步。我们使用 Function Calling 来定义这些工具:
python
import inspect

# 将工具函数注册为 Agent 可调用的工具
vision_tools = [
    {
        "type": "function",
        "function": {
            "name": "describe_image",
            "description": "描述图片内容。当用户上传图片并希望了解图片内容时使用。",
            "parameters": {
                "type": "object",
                "properties": {
                    "image_path": {"type": "string", "description": "图片文件路径"},
                    "prompt": {"type": "string", "description": "描述引导提示词", "default": "详细描述这张图片的内容"}
                },
                "required": ["image_path"]
            }
        }
    },
    {
        "type": "function",
        "function": {
            "name": "extract_text_from_image",
            "description": "从图片中提取文字(OCR)。当需要识别图片中的文字内容时使用。",
            "parameters": {
                "type": "object",
                "properties": {
                    "image_path": {"type": "string", "description": "图片文件路径"},
                    "lang": {"type": "string", "description": "识别语言", "default": "chi_sim+eng"}
                },
                "required": ["image_path"]
            }
        }
    },
    {
        "type": "function",
        "function": {
            "name": "analyze_chart",
            "description": "分析图表图片,提取数据趋势和关键洞察。当用户上传图表并希望获得数据分析时使用。",
            "parameters": {
                "type": "object",
                "properties": {
                    "image_path": {"type": "string", "description": "图表图片路径"},
                    "context": {"type": "string", "description": "额外上下文信息", "default": ""}
                },
                "required": ["image_path"]
            }
        }
    }
]

# 工具函数映射表
TOOL_FUNCTIONS = {
    "describe_image": describe_image,
    "extract_text_from_image": extract_text_from_image,
    "analyze_chart": analyze_chart
}
上述代码将三个视觉理解函数注册为 OpenAI Function Calling 格式的工具定义。每个工具定义包含名称、描述和参数 schema,LLM 会根据这些定义自主判断何时调用哪个工具。TOOL_FUNCTIONS 映射表用于在 Agent 执行循环中根据工具名称找到对应的 Python 函数。这种设计遵循了"工具即接口"的原则,新增视觉能力只需添加新的工具定义即可。
三、语音交互:让 Agent "听懂"和"说话"
语音交互是多模态 Agent 的另一项核心能力。它包含两个方向:语音转文字(ASR,Automatic Speech Recognition)和文字转语音(TTS,Text-to-Speech)。
3.1 语音识别(ASR)
语音识别让 Agent 能够"听懂"用户的语音输入。当前主流方案对比:
| 技术方案 | 中文准确率 | 实时性 | 部署成本 | 适用场景 |
|---|---|---|---|---|
| OpenAI Whisper API | 96%+ | 中等 | API 调用费 | 通用场景,开发快速 |
| Whisper 本地部署 | 96%+ | 较慢 | GPU 服务器 | 数据敏感场景 |
| 阿里 paraformer | 97%+ | 快 | API 调用费 | 中文场景,支持实时流式 |
| 讯飞星火 ASR | 97%+ | 快 | API 调用费 | 方言识别,中文优化 |
下面是一个基于 Whisper 的语音识别工具实现:
python
import openai
from pathlib import Path
from typing import Optional

def transcribe_audio(
    audio_path: str,
    language: Optional[str] = None,
    prompt: Optional[str] = None
) -> Dict[str, any]:
    """
    使用 Whisper 模型将语音转为文字。

    参数:
        audio_path: 音频文件路径(支持 mp3/wav/m4a/webm/mp4 等)
        language: 语言代码(如 'zh', 'en'),不指定则自动检测
        prompt: 引导提示词,可提供上下文帮助识别专业术语

    返回:
        包含转录文本和时间戳的字典:
        - text: 完整转录文本
        - segments: 分段信息(含时间戳)
        - language: 检测到的语言

    原理:
        Whisper 是基于 Transformer 的 seq2seq 模型,训练数据覆盖
        96 种语言、68 万小时多语言数据。它使用多任务训练,
        同时学习语音识别、语音翻译、语言识别和语音活动检测。
        prompt 参数可以注入领域词汇,显著提升专业场景准确率。
    """
    path = Path(audio_path)
    if not path.exists():
        raise FileNotFoundError(f"音频文件不存在: {audio_path}")

    with open(path, "rb") as f:
        kwargs = {"model": "whisper-1", "file": f}
        if language:
            kwargs["language"] = language
        if prompt:
            kwargs["prompt"] = prompt

        # 使用 verbose_json 格式获取分段和时间戳信息
        kwargs["response_format"] = "verbose_json"

        response = openai.Audio.transcriptions.create(**kwargs)

    segments = []
    if hasattr(response, "segments"):
        for seg in response.segments:
            segments.append({
                "id": seg.get("id", 0),
                "start": seg.get("start", 0),
                "end": seg.get("end", 0),
                "text": seg.get("text", "").strip()
            })

    return {
        "text": response.text,
        "segments": segments,
        "language": getattr(response, "language", language or "unknown")
    }
这段代码调用 Whisper API 实现语音转文字。关键参数包括 language(指定语言可提升识别准确率)和 prompt(注入领域上下文,如"以下是一段关于机器学习的学术演讲"可帮助模型识别专业术语)。返回的 segments 包含每个语音段落的时间戳,这对于生成会议纪要、字幕对齐等场景非常关键。verbose_json 格式提供了比普通 JSON 更丰富的元数据。
3.2 语音合成(TTS)
语音合成让 Agent 能够"说话"。这在语音助手、有声内容生成、无障碍访问等场景中非常重要。
python
import edge_tts
import asyncio
from pathlib import Path

async def synthesize_speech(
    text: str,
    output_path: str,
    voice: str = "zh-CN-XiaoxiaoNeural",
    rate: str = "+0%",
    volume: str = "+0%"
) -> Dict[str, any]:
    """
    使用 Edge-TTS 将文字转为语音。

    参数:
        text: 要合成的文本
        output_path: 输出音频文件路径(.mp3)
        voice: 语音角色,推荐选项:
            - zh-CN-XiaoxiaoNeural: 女声,温暖自然(默认)
            - zh-CN-YunxiNeural: 男声,年轻活力
            - zh-CN-YunjianNeural: 男声,沉稳大气
            - en-US-AriaNeural: 英文女声
        rate: 语速调节,如 "+20%" 加速,"-10%" 减速
        volume: 音量调节,如 "+30%" 增大

    返回:
        包含文件路径和时长的字典

    原理:
        Edge-TTS 利用微软 Edge 浏览器的在线 TTS 服务,
        基于 DeepWave 神经声码器,音质接近真人录音。
        无需 API Key,免费使用,支持 300+ 语音角色。
        SSML 标签可进一步控制情感、停顿和发音。
    """
    communicate = edge_tts.Communicate(
        text=text,
        voice=voice,
        rate=rate,
        volume=volume
    )

    await communicate.save(output_path)

    # 获取音频时长
    import mutagen.mp3
    audio = mutagen.mp3.MP3(output_path)
    duration = audio.info.length

    return {
        "file_path": output_path,
        "duration_seconds": round(duration, 2),
        "voice": voice,
        "text_length": len(text)
    }

def tts_sync(text: str, output_path: str, voice: str = "zh-CN-XiaoxiaoNeural") -> str:
    """同步包装的 TTS 函数,方便在非异步环境中调用。"""
    result = asyncio.run(synthesize_speech(text, output_path, voice))
    return result["file_path"]
Edge-TTS 是一个优秀的免费 TTS 方案,音质在免费方案中名列前茅。关键参数 voice 决定了声音角色,不同角色适合不同场景:Xiaoxiao 适合通用场景,Yunjian 适合新闻播报。rate 和 volume 可以在不改变音质的情况下调节语速和音量。注意 Edge-TTS 是异步库,在同步代码中需要用 asyncio.run 包装。对于需要更高音质的场景(如有声书制作),推荐 Azure Neural TTS 或 CosyVoice。
3.3 语音 Agent 的交互循环
将 ASR 和 TTS 组合起来,就可以构建一个语音交互循环:
语音合成(Edge-TTS) 大模型(GPT-4o) 语音识别(Whisper) Agent 用户 语音合成(Edge-TTS) 大模型(GPT-4o) 语音识别(Whisper) Agent 用户 #mermaid-svg-J9ri9W0TlfUUnd1O{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-J9ri9W0TlfUUnd1O .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-J9ri9W0TlfUUnd1O .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-J9ri9W0TlfUUnd1O .error-icon{fill:#552222;}#mermaid-svg-J9ri9W0TlfUUnd1O .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-J9ri9W0TlfUUnd1O .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-J9ri9W0TlfUUnd1O .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-J9ri9W0TlfUUnd1O .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-J9ri9W0TlfUUnd1O .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-J9ri9W0TlfUUnd1O .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-J9ri9W0TlfUUnd1O .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-J9ri9W0TlfUUnd1O .marker{fill:#333333;stroke:#333333;}#mermaid-svg-J9ri9W0TlfUUnd1O .marker.cross{stroke:#333333;}#mermaid-svg-J9ri9W0TlfUUnd1O svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-J9ri9W0TlfUUnd1O p{margin:0;}#mermaid-svg-J9ri9W0TlfUUnd1O .actor{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;}#mermaid-svg-J9ri9W0TlfUUnd1O text.actor>tspan{fill:black;stroke:none;}#mermaid-svg-J9ri9W0TlfUUnd1O .actor-line{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);}#mermaid-svg-J9ri9W0TlfUUnd1O .innerArc{stroke-width:1.5;stroke-dasharray:none;}#mermaid-svg-J9ri9W0TlfUUnd1O .messageLine0{stroke-width:1.5;stroke-dasharray:none;stroke:#333;}#mermaid-svg-J9ri9W0TlfUUnd1O .messageLine1{stroke-width:1.5;stroke-dasharray:2,2;stroke:#333;}#mermaid-svg-J9ri9W0TlfUUnd1O #arrowhead path{fill:#333;stroke:#333;}#mermaid-svg-J9ri9W0TlfUUnd1O .sequenceNumber{fill:white;}#mermaid-svg-J9ri9W0TlfUUnd1O #sequencenumber{fill:#333;}#mermaid-svg-J9ri9W0TlfUUnd1O #crosshead path{fill:#333;stroke:#333;}#mermaid-svg-J9ri9W0TlfUUnd1O .messageText{fill:#333;stroke:none;}#mermaid-svg-J9ri9W0TlfUUnd1O .labelBox{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;}#mermaid-svg-J9ri9W0TlfUUnd1O .labelText,#mermaid-svg-J9ri9W0TlfUUnd1O .labelText>tspan{fill:black;stroke:none;}#mermaid-svg-J9ri9W0TlfUUnd1O .loopText,#mermaid-svg-J9ri9W0TlfUUnd1O .loopText>tspan{fill:black;stroke:none;}#mermaid-svg-J9ri9W0TlfUUnd1O .loopLine{stroke-width:2px;stroke-dasharray:2,2;stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);}#mermaid-svg-J9ri9W0TlfUUnd1O .note{stroke:#aaaa33;fill:#fff5ad;}#mermaid-svg-J9ri9W0TlfUUnd1O .noteText,#mermaid-svg-J9ri9W0TlfUUnd1O .noteText>tspan{fill:black;stroke:none;}#mermaid-svg-J9ri9W0TlfUUnd1O .activation0{fill:#f4f4f4;stroke:#666;}#mermaid-svg-J9ri9W0TlfUUnd1O .activation1{fill:#f4f4f4;stroke:#666;}#mermaid-svg-J9ri9W0TlfUUnd1O .activation2{fill:#f4f4f4;stroke:#666;}#mermaid-svg-J9ri9W0TlfUUnd1O .actorPopupMenu{position:absolute;}#mermaid-svg-J9ri9W0TlfUUnd1O .actorPopupMenuPanel{position:absolute;fill:#ECECFF;box-shadow:0px 8px 16px 0px rgba(0,0,0,0.2);filter:drop-shadow(3px 5px 2px rgb(0 0 0 / 0.4));}#mermaid-svg-J9ri9W0TlfUUnd1O .actor-man line{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;}#mermaid-svg-J9ri9W0TlfUUnd1O .actor-man circle,#mermaid-svg-J9ri9W0TlfUUnd1O line{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;stroke-width:2px;}#mermaid-svg-J9ri9W0TlfUUnd1O :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 全程语音交互循环 🎤 发送语音消息 传入音频文件 返回转录文本 将文本加入对话历史 发送对话上下文 返回回复文本 传入回复文本 返回音频文件 🔊 播放语音回复
这个流程图展示了一次完整的语音交互循环:用户发送语音 → Agent 转写为文字 → LLM 生成回复 → Agent 合成为语音 → 播放给用户。整个流程中,Agent 充当协调者角色,ASR 和 TTS 作为工具被按需调用。关键优化点在于:ASR 转写结果应保留在对话历史中,让 LLM 理解上下文;TTS 合成可以与 LLM 流式输出同步进行,减少用户等待时间。
四、多模态融合:如何将文本、图片、语音统一处理
前面几节我们分别实现了视觉理解和语音交互能力。但真正的多模态 Agent 不是简单地把这些能力拼接在一起,而是要让不同模态的信息在推理时能够相互参照和融合。
4.1 多模态消息格式
OpenAI 的 Chat Completions API 原生支持多模态消息格式,这为多模态融合提供了基础。一条消息可以同时包含文本和图片:
python
from typing import List, Dict, Union
import base64
from pathlib import Path

class MultimodalMessageBuilder:
    """
    多模态消息构建器,统一管理文本、图片、音频等模态的输入格式。

    设计理念:
        将不同模态的内容封装为统一的消息格式,
        对上层 Agent 屏蔽底层的编码细节。
        支持文本+图片混合输入、音频转写+图片组合等复杂场景。
    """

    @staticmethod
    def text_message(role: str, content: str) -> Dict:
        """构建纯文本消息。"""
        return {"role": role, "content": content}

    @staticmethod
    def image_message(
        role: str,
        text: str,
        image_paths: List[str],
        detail: str = "auto"
    ) -> Dict:
        """
        构建图文混合消息。

        参数:
            text: 文字描述或问题
            image_paths: 图片路径列表(支持多图)
            detail: 图片分析精度 auto/high/low

        返回:
            OpenAI 多模态消息格式
        """
        content = [{"type": "text", "text": text}]

        for img_path in image_paths:
            path = Path(img_path)
            image_data = base64.b64encode(path.read_bytes()).decode("utf-8")
            mime_map = {".jpg": "image/jpeg", ".png": "image/png",
                       ".gif": "image/gif", ".webp": "image/webp"}
            mime_type = mime_map.get(path.suffix.lower(), "image/jpeg")

            content.append({
                "type": "image_url",
                "image_url": {
                    "url": f"data:{mime_type};base64,{image_data}",
                    "detail": detail
                }
            })

        return {"role": role, "content": content}

    @staticmethod
    def audio_message(role: str, text: str, audio_path: str) -> Dict:
        """
        构建音频消息(先转写为文本,再作为上下文传入)。

        注意: 当前 OpenAI API 不直接支持音频输入到 Chat Completions,
        需要先通过 Whisper 转写为文本,再以文本形式传入。
        这里在消息中添加元数据标记原始模态。
        """
        # 先用 Whisper 转写
        transcription = transcribe_audio(audio_path)

        content = [
            {"type": "text", "text": f"[语音输入转写] {transcription['text']}"},
            {"type": "text", "text": text}
        ]
        return {"role": role, "content": content}

    @staticmethod
    def mixed_message(
        role: str,
        text: str,
        image_paths: List[str] = None,
        audio_path: str = None
    ) -> Dict:
        """
        构建多模态混合消息:文本 + 图片 + 音频。

        这是多模态 Agent 最常用的消息构建方法,
        支持用户同时发送语音指令和参考图片的场景。
        """
        content = [{"type": "text", "text": text}]

        if image_paths:
            for img_path in image_paths:
                path = Path(img_path)
                image_data = base64.b64encode(path.read_bytes()).decode("utf-8")
                mime_map = {".jpg": "image/jpeg", ".png": "image/png",
                           ".gif": "image/gif", ".webp": "image/webp"}
                mime_type = mime_map.get(path.suffix.lower(), "image/jpeg")
                content.append({
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:{mime_type};base64,{image_data}",
                        "detail": "high"
                    }
                })

        if audio_path:
            transcription = transcribe_audio(audio_path)
            content.append({
                "type": "text",
                "text": f"[用户语音补充说明] {transcription['text']}"
            })

        return {"role": role, "content": content}
MultimodalMessageBuilder 是多模态融合的基础设施。它将不同模态的输入统一为 OpenAI 的多模态消息格式,对上层 Agent 屏蔽了编码细节。mixed_message 方法支持用户同时发送文字、图片和语音,这在实际场景中非常常见------比如用户拍一张产品照片,同时用语音描述问题。音频由于 API 限制需要先转写为文本再传入,但通过元数据标记保留了模态信息,LLM 可以据此理解用户的表达意图。
4.2 多模态上下文管理
多模态 Agent 的上下文管理比纯文本 Agent 更复杂,因为不同模态占用的 token 数量差异巨大。我们需要一个智能的上下文管理策略:
python
class MultimodalContextManager:
    """
    多模态上下文管理器,维护对话历史并控制 token 消耗。

    核心策略:
        1. 图片消息在超过 N 轮后自动替换为文本摘要
        2. 长音频转写文本做摘要压缩
        3. 保留最近的完整多模态消息,压缩历史消息
        4. 追踪总 token 消耗,超限时触发压缩

    这样可以保持近期对话的多模态完整性,
    同时避免历史图片/音频数据耗尽 token 预算。
    """

    def __init__(self, max_tokens: int = 120000, image_retention_rounds: int = 3):
        self.messages: List[Dict] = []
        self.max_tokens = max_tokens
        self.image_retention_rounds = image_retention_rounds
        self._round_counter = 0

    def add_message(self, message: Dict, contains_image: bool = False):
        """添加一条消息到上下文。"""
        self.messages.append(message)
        if contains_image:
            self._round_counter += 1
        self._compress_if_needed()

    def _estimate_tokens(self, messages: List[Dict]) -> int:
        """粗略估算消息列表的 token 数量。"""
        total = 0
        for msg in messages:
            content = msg.get("content", "")
            if isinstance(content, str):
                # 中文约 1 字 = 1.5 token,英文约 4 字符 = 1 token
                total += int(len(content) * 1.2)
            elif isinstance(content, list):
                for item in content:
                    if item.get("type") == "text":
                        total += int(len(item["text"]) * 1.2)
                    elif item.get("type") == "image_url":
                        # GPT-4o 图片约消耗 85-1100 token(取决于 detail)
                        detail = item.get("image_url", {}).get("detail", "auto")
                        total += 765 if detail == "high" else 85
        return total

    def _compress_if_needed(self):
        """当 token 超限时压缩历史消息。"""
        while self._estimate_tokens(self.messages) > self.max_tokens and len(self.messages) > 2:
            # 找到最早的非系统消息进行压缩
            for i, msg in enumerate(self.messages):
                if msg["role"] == "system":
                    continue
                content = msg.get("content", "")
                if isinstance(content, list):
                    # 将多模态消息压缩为文本摘要
                    text_parts = [item["text"] for item in content if item.get("type") == "text"]
                    summary = f"[历史消息摘要] {text_parts[0][:200]}..." if text_parts else "[历史消息摘要]"
                    self.messages[i] = {
                        "role": msg["role"],
                        "content": summary
                    }
                    break
            else:
                # 没有可压缩的消息,删除最旧的非系统消息
                for i, msg in enumerate(self.messages):
                    if msg["role"] != "system":
                        self.messages.pop(i)
                        break

    def get_messages(self) -> List[Dict]:
        """获取当前上下文消息列表。"""
        return self.messages.copy()

    def clear(self):
        """清空上下文。"""
        self.messages.clear()
        self._round_counter = 0
上下文管理是多模态 Agent 的隐藏难点。这段代码实现了一个带 token 感知的多模态上下文管理器。核心策略是:图片在经过 N 轮对话后,自动替换为文本摘要,因为一张高清图片可能消耗上千 token,而历史图片在后续对话中的参考价值通常递减。_estimate_tokens 方法提供了粗略但够用的 token 估算,实际应用中可以用 tiktoken 库做更精确的计算。当总 token 超出限制时,优先压缩最早的多模态消息,保留最近几轮的完整多模态上下文。
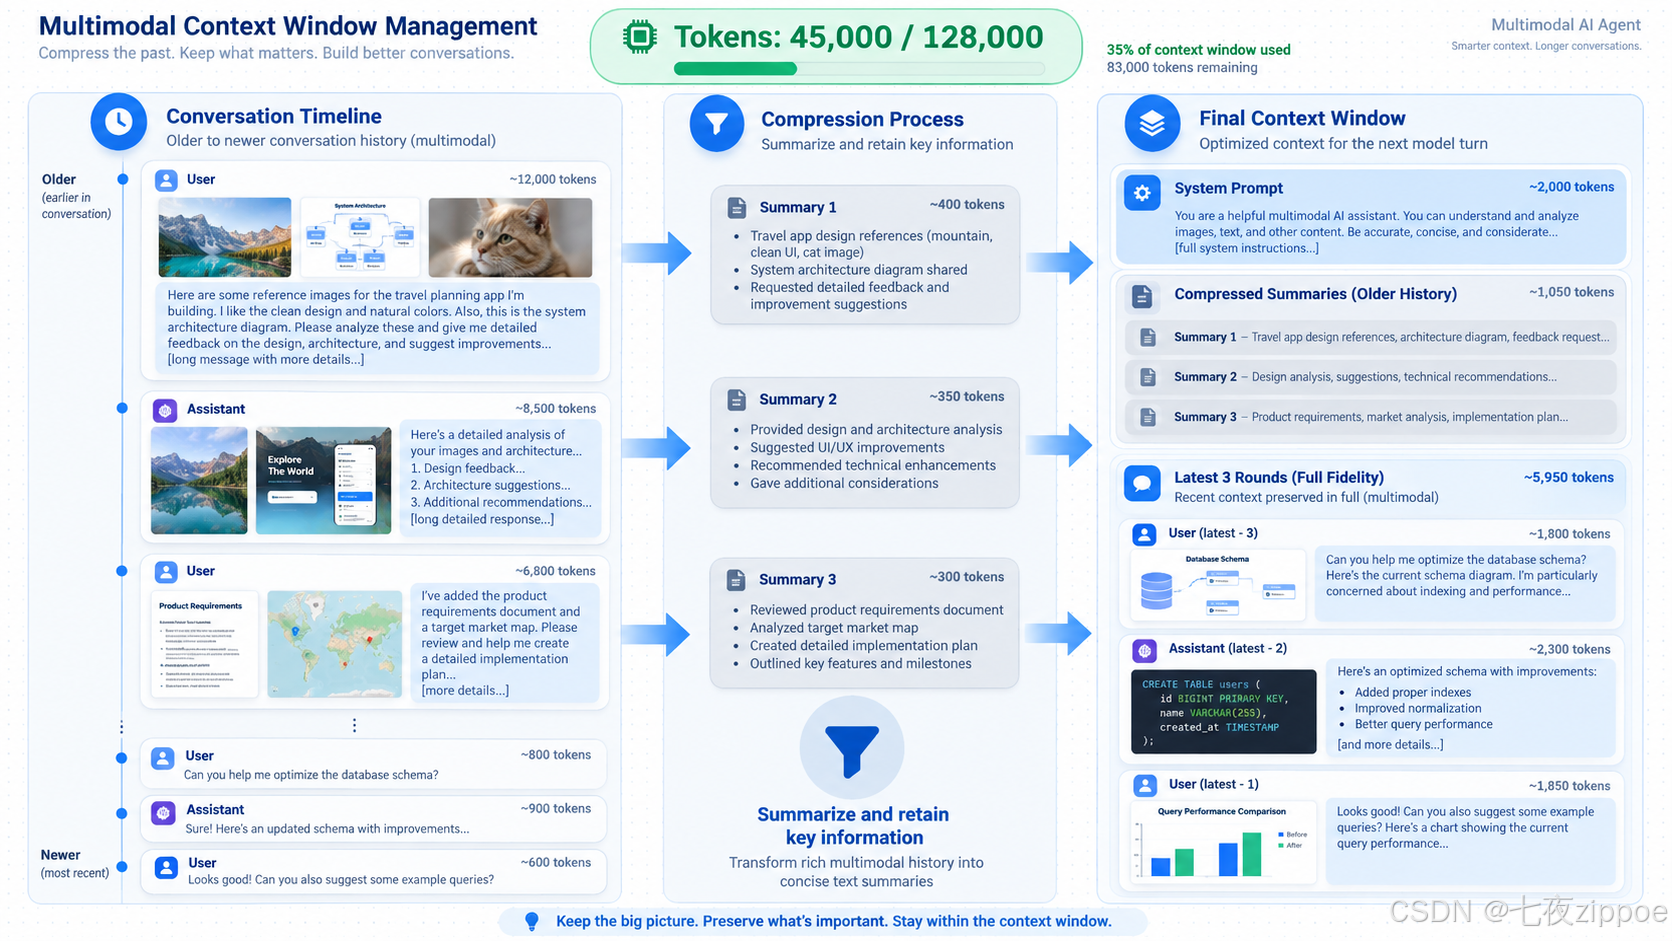
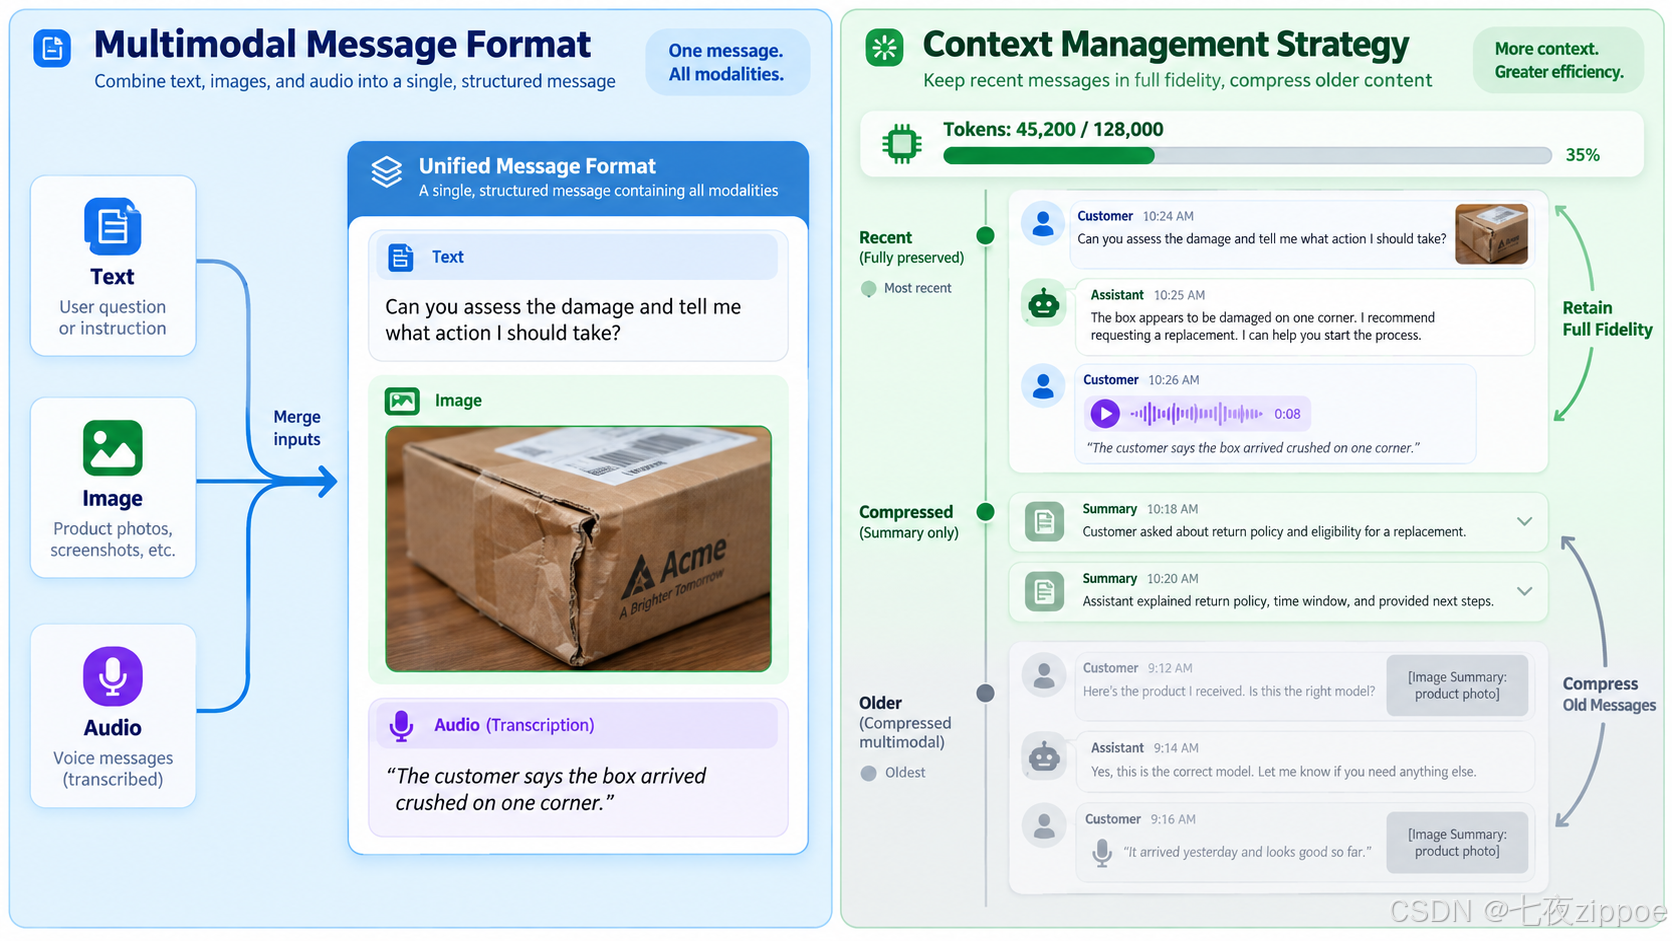
图:左侧展示多模态消息统一格式(文本+图片+音频转写组合),右侧展示上下文压缩策略(历史图片→文本摘要,近期保留完整多模态)
4.3 多模态融合架构
将所有组件整合在一起,多模态 Agent 的整体架构如下:
#mermaid-svg-7Ux18NAfeeOMBMyi{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-7Ux18NAfeeOMBMyi .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-7Ux18NAfeeOMBMyi .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-7Ux18NAfeeOMBMyi .error-icon{fill:#552222;}#mermaid-svg-7Ux18NAfeeOMBMyi .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-7Ux18NAfeeOMBMyi .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-7Ux18NAfeeOMBMyi .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-7Ux18NAfeeOMBMyi .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-7Ux18NAfeeOMBMyi .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-7Ux18NAfeeOMBMyi .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-7Ux18NAfeeOMBMyi .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-7Ux18NAfeeOMBMyi .marker{fill:#333333;stroke:#333333;}#mermaid-svg-7Ux18NAfeeOMBMyi .marker.cross{stroke:#333333;}#mermaid-svg-7Ux18NAfeeOMBMyi svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-7Ux18NAfeeOMBMyi p{margin:0;}#mermaid-svg-7Ux18NAfeeOMBMyi .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-7Ux18NAfeeOMBMyi .cluster-label text{fill:#333;}#mermaid-svg-7Ux18NAfeeOMBMyi .cluster-label span{color:#333;}#mermaid-svg-7Ux18NAfeeOMBMyi .cluster-label span p{background-color:transparent;}#mermaid-svg-7Ux18NAfeeOMBMyi .label text,#mermaid-svg-7Ux18NAfeeOMBMyi span{fill:#333;color:#333;}#mermaid-svg-7Ux18NAfeeOMBMyi .node rect,#mermaid-svg-7Ux18NAfeeOMBMyi .node circle,#mermaid-svg-7Ux18NAfeeOMBMyi .node ellipse,#mermaid-svg-7Ux18NAfeeOMBMyi .node polygon,#mermaid-svg-7Ux18NAfeeOMBMyi .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-7Ux18NAfeeOMBMyi .rough-node .label text,#mermaid-svg-7Ux18NAfeeOMBMyi .node .label text,#mermaid-svg-7Ux18NAfeeOMBMyi .image-shape .label,#mermaid-svg-7Ux18NAfeeOMBMyi .icon-shape .label{text-anchor:middle;}#mermaid-svg-7Ux18NAfeeOMBMyi .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-7Ux18NAfeeOMBMyi .rough-node .label,#mermaid-svg-7Ux18NAfeeOMBMyi .node .label,#mermaid-svg-7Ux18NAfeeOMBMyi .image-shape .label,#mermaid-svg-7Ux18NAfeeOMBMyi .icon-shape .label{text-align:center;}#mermaid-svg-7Ux18NAfeeOMBMyi .node.clickable{cursor:pointer;}#mermaid-svg-7Ux18NAfeeOMBMyi .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-7Ux18NAfeeOMBMyi .arrowheadPath{fill:#333333;}#mermaid-svg-7Ux18NAfeeOMBMyi .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-7Ux18NAfeeOMBMyi .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-7Ux18NAfeeOMBMyi .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-7Ux18NAfeeOMBMyi .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-7Ux18NAfeeOMBMyi .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-7Ux18NAfeeOMBMyi .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-7Ux18NAfeeOMBMyi .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-7Ux18NAfeeOMBMyi .cluster text{fill:#333;}#mermaid-svg-7Ux18NAfeeOMBMyi .cluster span{color:#333;}#mermaid-svg-7Ux18NAfeeOMBMyi div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-7Ux18NAfeeOMBMyi .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-7Ux18NAfeeOMBMyi rect.text{fill:none;stroke-width:0;}#mermaid-svg-7Ux18NAfeeOMBMyi .icon-shape,#mermaid-svg-7Ux18NAfeeOMBMyi .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-7Ux18NAfeeOMBMyi .icon-shape p,#mermaid-svg-7Ux18NAfeeOMBMyi .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-7Ux18NAfeeOMBMyi .icon-shape .label rect,#mermaid-svg-7Ux18NAfeeOMBMyi .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-7Ux18NAfeeOMBMyi .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-7Ux18NAfeeOMBMyi .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-7Ux18NAfeeOMBMyi :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 输出层
工具层
Agent 核心层
模态处理层
输入层
用户输入
图片文件
音频文件
ASR 引擎
Whisper
OCR 引擎
Tesseract
视觉理解
GPT-4o Vision
上下文管理器
消息构建器
LLM 推理引擎
GPT-4o
工具编排器
图片描述工具
OCR 工具
图表分析工具
语音合成工具
图片生成工具
文本回复
语音回复
生成图片
这个架构图展示了多模态 Agent 的五层设计。输入层接收用户的多模态输入,模态处理层将非文本模态转换为 LLM 可理解的形式,Agent 核心层负责上下文管理和推理决策,工具层提供具体的多模态能力,输出层生成多模态回复。核心是 LLM 推理引擎与工具编排器的协作:LLM 决定"何时调用什么工具",工具编排器负责"如何执行工具并返回结果"。
五、多模态工具设计:图片生成、语音合成等工具的定义
5.1 工具设计原则
在多模态 Agent 中,工具是连接 LLM 推理和具体能力执行的桥梁。好的工具设计应遵循以下原则:
- 单一职责 :每个工具只做一件事,但做好它。
describe_image只负责描述图片,不做推理判断。 - 清晰描述 :工具的
description字段是 LLM 决策的唯一依据,必须准确描述工具的功能、适用场景和限制。 - 类型安全:参数使用 JSON Schema 严格定义类型,避免 LLM 生成无效参数。
- 错误友好:工具返回错误时,错误信息应对 LLM 友好,让 LLM 能理解失败原因并决定下一步操作。
- 幂等性:尽量保证工具调用的幂等性,同一参数多次调用结果一致。
5.2 图片生成工具
python
def generate_image(
    prompt: str,
    size: str = "1024x1024",
    quality: str = "standard",
    n: int = 1
) -> Dict[str, any]:
    """
    使用 DALL-E 3 生成图片。

    参数:
        prompt: 图片描述提示词(英文效果通常优于中文)
        size: 图片尺寸 1024x1024/1792x1024/1024x1792
        quality: 图片质量 standard/hd
        n: 生成数量(DALL-E 3 仅支持 1)

    返回:
        包含图片 URL 和元数据的字典

    原理:
        DALL-E 3 基于扩散模型,通过逐步去噪生成图片。
        它对提示词的理解能力远超 DALL-E 2,
        能自动补全细节、调整构图、优化色彩。
        GPT-4o 可以先优化提示词再调用本工具。
    """
    response = client.images.generate(
        model="dall-e-3",
        prompt=prompt,
        size=size,
        quality=quality,
        n=n
    )

    images = []
    for img in response.data:
        images.append({
            "url": img.url,
            "revised_prompt": getattr(img, "revised_prompt", prompt)
        })

    return {
        "images": images,
        "count": len(images),
        "original_prompt": prompt
    }
图片生成工具将 DALL-E 3 API 封装为 Agent 可调用的工具。关键设计点:返回结果中包含 revised_prompt,这是 DALL-E 3 自动优化后的提示词,Agent 可以据此学习如何写更好的提示词。size 参数支持横版(1792x1024)和竖版(1024x1792),应根据生成内容类型选择。对于中文提示词,建议先让 LLM 翻译为英文再调用,因为 DALL-E 3 的训练数据以英文为主。
5.3 完整工具注册
将所有多模态工具统一注册:
python
# 多模态 Agent 完整工具注册表
MULTIMODAL_TOOLS = [
    # === 视觉理解类 ===
    {
        "type": "function",
        "function": {
            "name": "describe_image",
            "description": "描述图片内容。当用户上传图片并希望了解图片中的内容、场景、物体时调用此工具。",
            "parameters": {
                "type": "object",
                "properties": {
                    "image_path": {"type": "string", "description": "图片文件的本地路径"},
                    "prompt": {"type": "string", "description": "引导描述的提示词,如'描述图片中的人物动作'", "default": "详细描述这张图片的内容"}
                },
                "required": ["image_path"]
            }
        }
    },
    {
        "type": "function",
        "function": {
            "name": "extract_text_from_image",
            "description": "从图片中提取文字(OCR识别)。当用户上传包含文字的图片(如截图、票据、文档扫描件)并希望提取文字内容时调用。",
            "parameters": {
                "type": "object",
                "properties": {
                    "image_path": {"type": "string", "description": "图片文件路径"},
                    "lang": {"type": "string", "description": "识别语言代码,中文'chi_sim',英文'eng',默认'chi_sim+eng'", "default": "chi_sim+eng"}
                },
                "required": ["image_path"]
            }
        }
    },
    {
        "type": "function",
        "function": {
            "name": "analyze_chart",
            "description": "分析图表图片并提取数据趋势。当用户上传柱状图、折线图、饼图等数据可视化图片并希望获得数据分析时调用。",
            "parameters": {
                "type": "object",
                "properties": {
                    "image_path": {"type": "string", "description": "图表图片路径"},
                    "context": {"type": "string", "description": "图表的背景信息,如'2024年Q3销售数据'", "default": ""}
                },
                "required": ["image_path"]
            }
        }
    },
    # === 语音交互类 ===
    {
        "type": "function",
        "function": {
            "name": "transcribe_audio",
            "description": "将音频文件转为文字。当用户发送语音消息或音频文件时调用此工具进行语音转文字。",
            "parameters": {
                "type": "object",
                "properties": {
                    "audio_path": {"type": "string", "description": "音频文件路径"},
                    "language": {"type": "string", "description": "语言代码,如'zh'、'en',不指定则自动检测"}
                },
                "required": ["audio_path"]
            }
        }
    },
    {
        "type": "function",
        "function": {
            "name": "synthesize_speech",
            "description": "将文字转为语音。当用户希望以语音形式接收回复,或需要生成音频内容时调用。",
            "parameters": {
                "type": "object",
                "properties": {
                    "text": {"type": "string", "description": "要合成的文本内容"},
                    "voice": {"type": "string", "description": "语音角色", "default": "zh-CN-XiaoxiaoNeural"},
                    "output_path": {"type": "string", "description": "输出音频文件路径"}
                },
                "required": ["text", "output_path"]
            }
        }
    },
    # === 内容生成类 ===
    {
        "type": "function",
        "function": {
            "name": "generate_image",
            "description": "根据文字描述生成图片。当用户希望根据文字描述创建图片、插图或设计时调用。",
            "parameters": {
                "type": "object",
                "properties": {
                    "prompt": {"type": "string", "description": "图片描述提示词,英文效果更佳"},
                    "size": {"type": "string", "description": "图片尺寸", "default": "1024x1024"},
                    "quality": {"type": "string", "description": "图片质量", "default": "standard"}
                },
                "required": ["prompt"]
            }
        }
    }
]

# 工具函数映射
MULTIMODAL_TOOL_FUNCTIONS = {
    "describe_image": describe_image,
    "extract_text_from_image": extract_text_from_image,
    "analyze_chart": analyze_chart,
    "transcribe_audio": transcribe_audio,
    "synthesize_speech": lambda text, output_path, voice="zh-CN-XiaoxiaoNeural":
        asyncio.run(synthesize_speech(text, output_path, voice)),
    "generate_image": generate_image
}
这段代码将所有多模态工具统一注册。注意 synthesize_speech 使用了 lambda 做异步包装,这是因为 OpenAI Function Calling 是同步的,而 Edge-TTS 是异步的。工具描述(description)的措辞非常关键,它直接决定了 LLM 何时调用该工具。描述应包含两个要素:工具做什么 + 何时该用。比如 "当用户上传包含文字的图片时调用" 比 "提取图片中的文字" 更有助于 LLM 做出正确的调用决策。
六、实战:一个多模态 Agent 的完整实现
现在我们将前面所有组件整合为一个完整的多模态 Agent。这个 Agent 能够:
- 接收用户的多模态输入(文本 + 图片 + 音频)
- 自主决定调用哪些工具
- 生成多模态回复(文本 + 语音 + 图片)
python
"""
多模态 Agent 完整实现
支持文本、图片、语音的多模态交互
"""

import json
import asyncio
import base64
from pathlib import Path
from typing import Dict, List, Optional, Any
from openai import OpenAI

class MultimodalAgent:
    """
    完整的多模态 Agent 实现。

    架构:
        用户输入 → 模态检测 → 消息构建 → 上下文管理 → LLM 推理
        → 工具调用 → 结果整合 → 多模态输出

    特性:
        1. 自动检测输入模态(通过文件扩展名判断)
        2. 支持多轮多模态对话
        3. 工具调用的自动编排和错误处理
        4. 输出模态可选(纯文本/文本+语音/文本+图片+语音)
    """

    def __init__(
        self,
        system_prompt: str = None,
        model: str = "gpt-4o",
        enable_voice_output: bool = False,
        enable_image_output: bool = True,
        max_context_tokens: int = 120000
    ):
        self.client = OpenAI()
        self.model = model
        self.enable_voice_output = enable_voice_output
        self.enable_image_output = enable_image_output

        # 使用前面定义的上下文管理器
        self.context = MultimodalContextManager(max_tokens=max_context_tokens)

        # 系统提示词
        default_prompt = """你是一个多模态智能助手,具备以下能力:
1. 视觉理解:可以看懂图片内容、提取文字(OCR)、分析图表数据
2. 语音交互:可以听懂语音消息、用语音回复
3. 内容生成:可以根据描述生成图片

当用户发送图片时,主动使用 describe_image 或 extract_text_from_image 工具。
当用户发送音频时,主动使用 transcribe_audio 工具。
当分析数据图表时,使用 analyze_chart 工具。
根据用户需求自主决定是否需要生成语音或图片回复。

请始终用中文回复,除非用户使用其他语言。"""

        self.context.add_message({
            "role": "system",
            "content": system_prompt or default_prompt
        })

        # 工具函数映射
        self.tool_functions = MULTIMODAL_TOOL_FUNCTIONS

    def detect_modality(self, user_input: Any) -> Dict[str, Any]:
        """
        检测用户输入的模态类型,返回结构化信息。

        支持的输入格式:
            - 纯文本字符串
            - 文件路径字符串(根据扩展名判断模态)
            - 字典(包含 text, image_paths, audio_path 等字段)
        """
        if isinstance(user_input, str):
            # 检查是否是文件路径
            path = Path(user_input)
            if path.exists() and path.is_file():
                ext = path.suffix.lower()
                image_exts = {".jpg", ".jpeg", ".png", ".gif", ".webp", ".bmp"}
                audio_exts = {".mp3", ".wav", ".m4a", ".webm", ".mp4", ".ogg", ".flac"}

                if ext in image_exts:
                    return {"modality": "image", "image_paths": [str(path)], "text": ""}
                elif ext in audio_exts:
                    return {"modality": "audio", "audio_path": str(path), "text": ""}
                else:
                    return {"modality": "text", "text": user_input}
            else:
                return {"modality": "text", "text": user_input}

        elif isinstance(user_input, dict):
            return {
                "modality": "mixed",
                "text": user_input.get("text", ""),
                "image_paths": user_input.get("image_paths", []),
                "audio_path": user_input.get("audio_path")
            }

        return {"modality": "text", "text": str(user_input)}

    def build_user_message(self, input_info: Dict[str, Any]) -> Dict:
        """根据模态检测结果构建用户消息。"""
        modality = input_info["modality"]
        text = input_info.get("text", "")

        if modality == "text":
            return MultimodalMessageBuilder.text_message("user", text)

        elif modality == "image":
            return MultimodalMessageBuilder.image_message(
                "user",
                text or "请描述这张图片的内容。",
                input_info["image_paths"]
            )

        elif modality == "audio":
            return MultimodalMessageBuilder.audio_message(
                "user",
                text or "请处理这段语音消息。",
                input_info["audio_path"]
            )

        elif modality == "mixed":
            return MultimodalMessageBuilder.mixed_message(
                "user",
                text,
                image_paths=input_info.get("image_paths"),
                audio_path=input_info.get("audio_path")
            )

        return MultimodalMessageBuilder.text_message("user", text)

    def execute_tool(self, tool_name: str, arguments: Dict) -> str:
        """执行工具调用并返回结果字符串。"""
        func = self.tool_functions.get(tool_name)
        if not func:
            return json.dumps({"error": f"未知工具: {tool_name}"}, ensure_ascii=False)

        try:
            result = func(**arguments)
            return json.dumps(result, ensure_ascii=False, default=str, indent=2)
        except Exception as e:
            error_msg = f"工具执行失败: {tool_name},错误: {str(e)}"
            return json.dumps({"error": error_msg}, ensure_ascii=False)

    def chat(self, user_input: Any, output_audio_dir: str = "./output") -> Dict[str, Any]:
        """
        多模态对话的主入口。

        参数:
            user_input: 用户输入,支持文本/图片路径/音频路径/字典
            output_audio_dir: 语音输出目录

        返回:
            包含文本回复、可能的音频路径和图片路径的字典
        """
        # 1. 检测输入模态
        input_info = self.detect_modality(user_input)

        # 2. 构建用户消息
        user_message = self.build_user_message(input_info)
        has_image = input_info["modality"] in ("image", "mixed")
        self.context.add_message(user_message, contains_image=has_image)

        # 3. LLM 推理循环(支持多轮工具调用)
        result = {"text": "", "audio_path": None, "image_urls": []}
        Path(output_audio_dir).mkdir(parents=True, exist_ok=True)

        max_tool_rounds = 5  # 最多 5 轮工具调用
        for round_idx in range(max_tool_rounds):
            response = self.client.chat.completions.create(
                model=self.model,
                messages=self.context.get_messages(),
                tools=MULTIMODAL_TOOLS,
                tool_choice="auto",
                temperature=0.7
            )

            message = response.choices[0].message

            # 如果没有工具调用,直接返回文本
            if not message.tool_calls:
                result["text"] = message.content
                self.context.add_message({"role": "assistant", "content": message.content})
                break

            # 将助手消息(含工具调用)加入上下文
            self.context.add_message(message.model_dump())

            # 执行所有工具调用
            for tool_call in message.tool_calls:
                tool_name = tool_call.function.name
                arguments = json.loads(tool_call.function.arguments)

                print(f"[工具调用] {tool_name}({arguments})")
                tool_result = self.execute_tool(tool_name, arguments)

                # 将工具结果加入上下文
                self.context.add_message({
                    "role": "tool",
                    "tool_call_id": tool_call.id,
                    "content": tool_result
                })

                # 如果是语音合成,记录音频路径
                if tool_name == "synthesize_speech":
                    result["audio_path"] = arguments.get("output_path")

                # 如果是图片生成,记录图片URL
                if tool_name == "generate_image":
                    try:
                        img_result = json.loads(tool_result)
                        for img in img_result.get("images", []):
                            result["image_urls"].append(img["url"])
                    except:
                        pass

            # 继续下一轮,让 LLM 处理工具结果

        # 4. 可选:自动生成语音回复
        if self.enable_voice_output and result["text"] and not result["audio_path"]:
            audio_path = str(Path(output_audio_dir) / f"reply_{len(self.context.messages)}.mp3")
            try:
                asyncio.run(synthesize_speech(result["text"], audio_path))
                result["audio_path"] = audio_path
            except Exception as e:
                print(f"[语音合成失败] {e}")

        return result


# ===================== 使用示例 =====================
if __name__ == "__main__":
    # 创建多模态 Agent
    agent = MultimodalAgent(
        enable_voice_output=True,
        enable_image_output=True
    )

    # 示例 1: 纯文本对话
    print("=== 示例 1: 文本对话 ===")
    result = agent.chat("你好,请介绍一下你自己")
    print(f"回复: {result['text']}")

    # 示例 2: 图片理解
    print("\n=== 示例 2: 图片理解 ===")
    result = agent.chat({
        "text": "请描述这张图片的内容,并提取图片中的文字",
        "image_paths": ["./test_image.png"]
    })
    print(f"回复: {result['text']}")

    # 示例 3: 语音输入
    print("\n=== 示例 3: 语音输入 ===")
    result = agent.chat("./voice_message.mp3")
    print(f"回复: {result['text']}")
    if result["audio_path"]:
        print(f"语音回复: {result['audio_path']}")

    # 示例 4: 多模态混合输入
    print("\n=== 示例 4: 多模态混合 ===")
    result = agent.chat({
        "text": "我发了一张产品图片和一段语音说明,请综合分析产品是否有质量问题",
        "image_paths": ["./product.jpg"],
        "audio_path": "./description.mp3"
    })
    print(f"回复: {result['text']}")
    if result["image_urls"]:
        print(f"生成的图片: {result['image_urls']}")
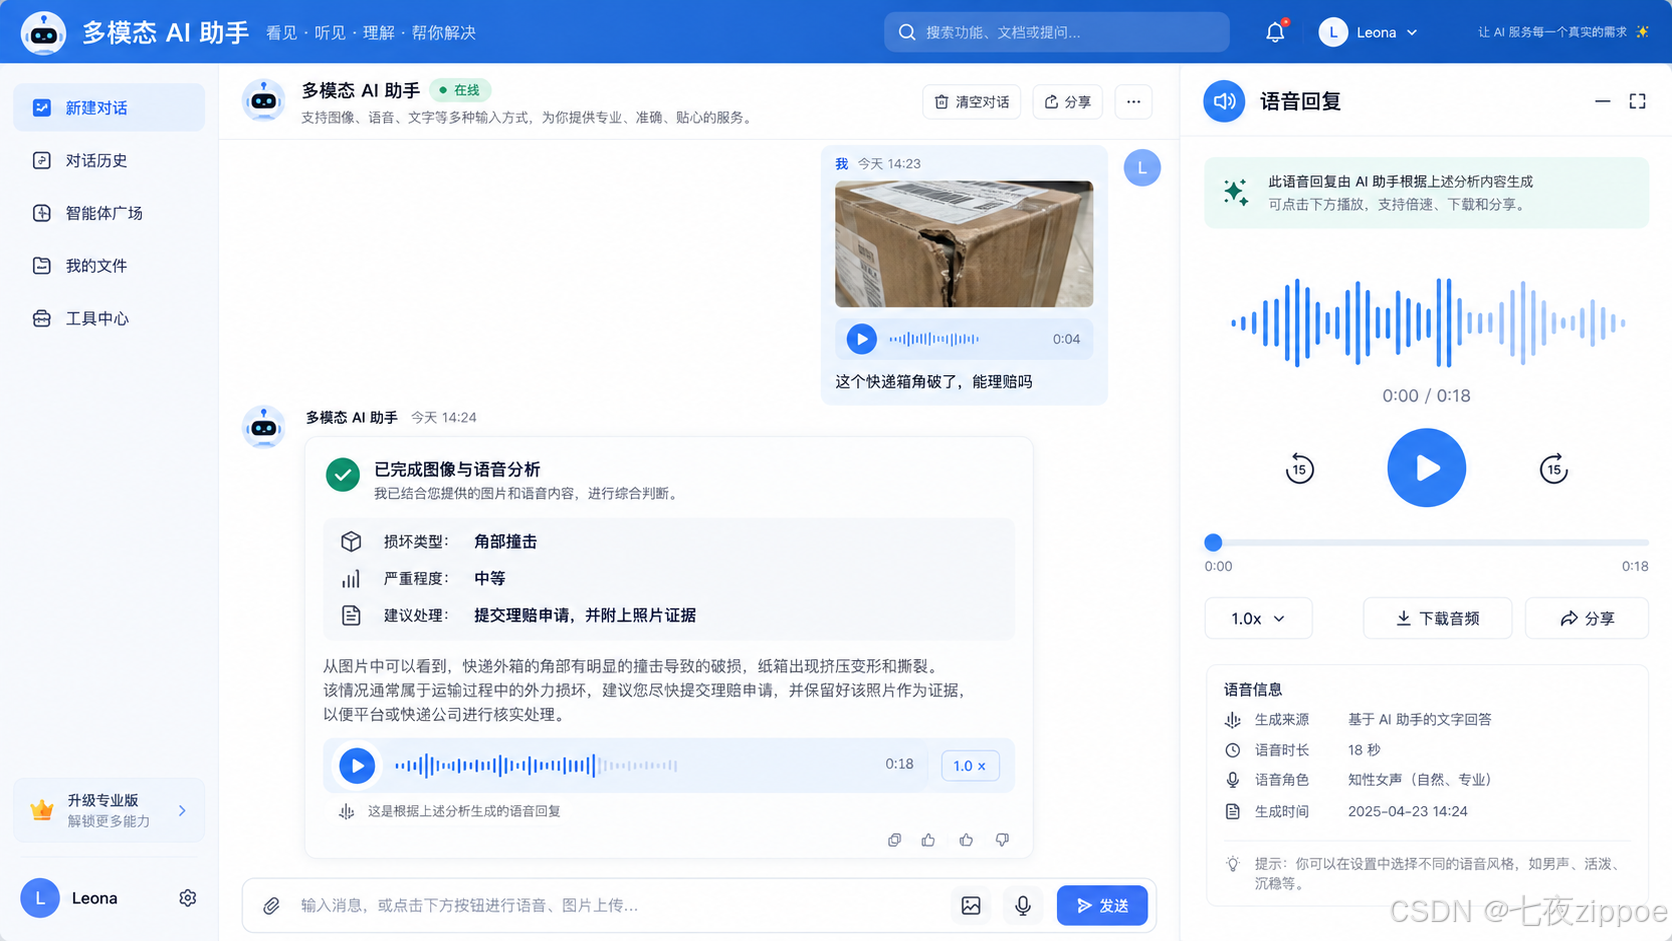
这是多模态 Agent 的完整实现。代码虽然较长,但结构清晰:MultimodalAgent 类封装了完整的对话循环,detect_modality 方法自动判断输入模态,chat 方法是主入口,内部通过最多 5 轮的工具调用循环完成复杂任务。关键设计决策包括:工具调用上限设为 5 轮以防止无限循环;语音合成失败不影响文本回复(降级策略);工具执行错误以 JSON 格式返回给 LLM 让其自行处理。
七、适用边界与风险提示
7.1 技术适用边界
多模态 Agent 虽然强大,但并非所有场景都适用。以下是明确的适用与不适用边界:
适合使用多模态 Agent 的场景:
- 需要理解图片内容并做出判断的客服场景(如理赔审核、商品识别)
- 需要语音交互的场景(如车载助手、无障碍服务)
- 需要生成多模态内容的创作辅助场景(如配图+文案生成)
- 需要从图表中提取数据洞察的分析场景
- 需要同时处理多种信息形式的综合助手场景
不适合使用多模态 Agent 的场景:
- 需要像素级精确分析的场景(如医学影像诊断,应使用专业模型)
- 需要实时视频流处理的场景(当前方案延迟较高,无法满足实时性要求)
- 对 OCR 准确率要求 99.9%+ 的场景(应使用专业 OCR 服务 + 人工校验)
- 需要处理超长音频(>30 分钟)的场景(应使用分段处理 + 批量转写)
- 数据高度敏感不允许调用云端 API 的场景(应使用本地部署方案)
7.2 成本分析
| 操作类型 | 单次成本(估算) | 延迟 | 适用频率 |
|---|---|---|---|
| GPT-4o 文本对话(1K token) | ~$0.01 | 1-3s | 高频 |
| GPT-4o 图片理解(1张高清图) | ~$0.005-0.01 | 2-5s | 中频 |
| Whisper 语音转写(1分钟音频) | ~$0.006 | 3-10s | 中频 |
| Edge-TTS 语音合成(500字) | 免费 | 1-3s | 高频 |
| DALL-E 3 图片生成(标准质量) | ~$0.04 | 5-15s | 低频 |
一个典型的多模态对话(含1张图片理解 + 文本回复)单次成本约 0.02-0.03。对于日活 1000 的应用,月成本约 600-900。建议根据实际业务需求选择性地启用多模态功能,而非所有对话都走多模态通道。
7.3 风险提示与应对措施
风险一:隐私安全
多模态输入可能包含敏感信息------用户照片中的人脸、语音中的声纹、文档中的个人信息。应对措施:
- 明确告知用户数据将发送至云端 AI 服务处理
- 对敏感图片先做脱敏处理(如人脸模糊、身份证号遮挡)
- 选择通过 SOC2 等安全认证的 API 服务商
- 不在日志中存储原始多模态数据
风险二:错误输出
多模态模型可能对图片内容"看错"或"编造"信息,尤其在图片质量不佳或场景复杂时。应对措施:
- 关键判断需要设置人工审核环节
- 对模型输出设置置信度阈值,低置信度结果不自动执行
- 在系统提示词中明确要求模型标注不确定性
风险三:成本失控
多模态 API 调用成本远高于纯文本,如果 Agent 进入工具调用循环可能导致高额费用。应对措施:
- 设置单次对话的工具调用上限(如本文实现的 5 轮上限)
- 设置每日 API 调用预算上限和告警
- 对非必要场景降级使用(如用
detail: "low"替代"high")
风险四:延迟体验
多模态处理涉及多个 API 调用,单次对话可能耗时 10-30 秒。应对措施:
- 实现流式输出,让用户看到中间进度
- 对语音合成等耗时操作采用异步处理
- 设置合理的超时时间和降级策略
八、总结
本文从多模态 Agent 的应用场景出发,系统讲解了视觉理解、语音交互、多模态融合三大核心能力的实现方法,并提供了一个完整的多模态 Agent 代码实现。
核心要点回顾:
-
多模态 Agent 的本质是让 LLM 成为多种感知能力的协调者。 LLM 本身不直接"看"或"听",而是通过工具调用将不同模态的处理任务分发给专业模型,再统一整合结果。这种"LLM 即协调者"的架构是当前最务实且灵活的多模态方案。
-
视觉理解的关键在于工具设计和提示词工程。 图片描述、OCR、图表分析三个工具各有适用场景,工具描述必须清晰准确,LLM 才能做出正确的调用决策。图片的
detail参数是成本和精度的关键调节器。 -
语音交互需要处理异步和同步的矛盾。 ASR 和 TTS 都是潜在的异步操作,而 Function Calling 是同步的。用
asyncio.run包装是最简单的解决方案,但对于生产环境建议使用消息队列做解耦。 -
多模态融合的难点是上下文管理。 图片和音频的数据量远超文本,必须有智能的压缩和淘汰策略。本文实现的
MultimodalContextManager提供了一个实用的方案:保留近期完整多模态消息,压缩历史消息为文本摘要。 -
工程化落地需要关注成本、延迟和可靠性三者的平衡。 不是所有场景都需要多模态,应该根据实际需求选择性启用。设置工具调用上限、实现降级策略、对关键判断保留人工审核,这些是生产环境必须考虑的问题。
多模态 Agent 的技术栈仍在快速演进。GPT-4o 已经支持原生音频输入输出,未来多模态融合的架构可能会进一步简化。但"LLM 作为协调者 + 专业工具执行"这一模式在可预见的未来仍是主流设计,因为它提供了最大的灵活性和可扩展性------新增一个模态能力,只需要定义一个新的工具函数。
希望本文能为你构建自己的多模态 Agent 提供实质性的帮助。在下一篇中,我们将探讨 Agent 的记忆系统设计,让 Agent 拥有跨会话的持久记忆能力。