系列导航
- 上一篇:AI Agent 工程实践(48):什么时候应该 Multi-Agent-CSDN博客
- 下一篇:AI Agent 工程实践(50):最终项目------一个真正可运行的 Production Agent
发布时间:2026-09-28
标签:AI Agent|工程实践|优化|V1 到 V2
从第 39 篇那个 100 行的最小版,到这一篇,Repo Doctor 已经跌跌撞撞走了十篇。
中间我修过幻觉、调过工具描述、建过评估集、挡过回归、锁过版本、做过模型实验、把 PR review 退回过 Workflow、给 bug 定位抽过 Reviewer。
散落了一路的改动,是时候收个账了。
这一篇,我把它们全部串起来,做一次完整的 v1 → v2,然后看看到底涨了多少。
问题背景
这是第五阶段的第十四篇,也是整个阶段的高潮篇。
前面十三篇,每一篇都解决了一个具体问题,但也都是"散点"------这篇修幻觉,那篇调工具。这一篇要做的,是把散点收拢成一条线 :把所有改动汇总成一次完整的 v1 → v2 升级,用数据回答一个总问题------我们折腾了这么久,到底有没有用?
这也是第五阶段的"验收时刻"。如果前面的方法论都是对的,那么这一刻,数字应该会说话。
错误尝试:改了很多,但说不清改了什么
我先坦白一个之前的毛病:改了很多,但说不清每处改动对应哪篇、带来了什么收益。
幻觉问题改了、工具描述改了、加了 Reviewer、退了 Workflow......这些改动散落在代码、Prompt、Tool 定义里,混在一起。当我被问"v1 和 v2 到底差在哪"时,我只能含糊地说"改进了很多地方"。
"改进了很多地方"------这是一句废话说得最像结论的样子。
问题出在哪?我没有在每次改动时,记录"改了哪一层、为什么、预期影响什么指标"。 这导致最后想复盘时,只剩一团浆糊。
关键观察:v1 和 v2 之间,隔的是"决策",不是"代码量"
我把 v1 到 v2 的所有改动,重新梳理成了一张"因果账"------每一处改动,都对应着一篇、一个根因、一个预期收益:
| 改动 | 来自哪篇 | 解决的根因 | 影响的指标 |
|---|---|---|---|
| 加 Task Router | 38 | 任务串味 | Success Rate |
| 加 Planner(终点意识) | 38、40 | 无终点,烧 Token | Cost |
| 改 Tool 描述 | 41 | Tool Selection Error | Tool Accuracy |
| 加验证节点(拦截幻觉) | 42 | Reasoning Error | Answer Accuracy |
| 建 eval 数据集 | 43 | 无法量化 | (尺子) |
| 回归门槛 | 44 | 隐蔽回归 | 稳定性 |
| 锁七维版本 | 45 | 无法复现 | 可复现 |
| 模型选型(换 B) | 46 | 模型不匹配 | 综合 |
| PR review 退 Workflow | 47 | 自主性过度 | Cost、漏报 |
| 抽 Reviewer 节点 | 48 | 职责冲突 | Answer Accuracy |
核心洞察:
v1 到 v2 之间隔着的,不是代码量,是你踩过的每一次失败和每一次验证。
代码量其实没增加多少,增加的是决策的密度------每一个改动,都是一次"失败 → 定位 → 归因 → 修复 → 验证"的完整闭环。
最终方案:v1 → v2 完整对照
架构对照
v1(第 39 篇的最小版):
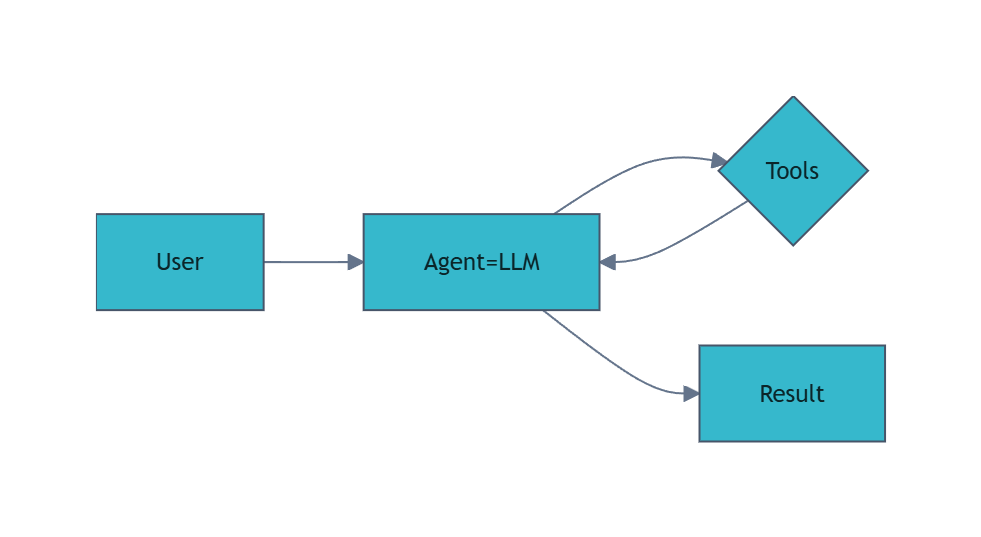
v2(当前):
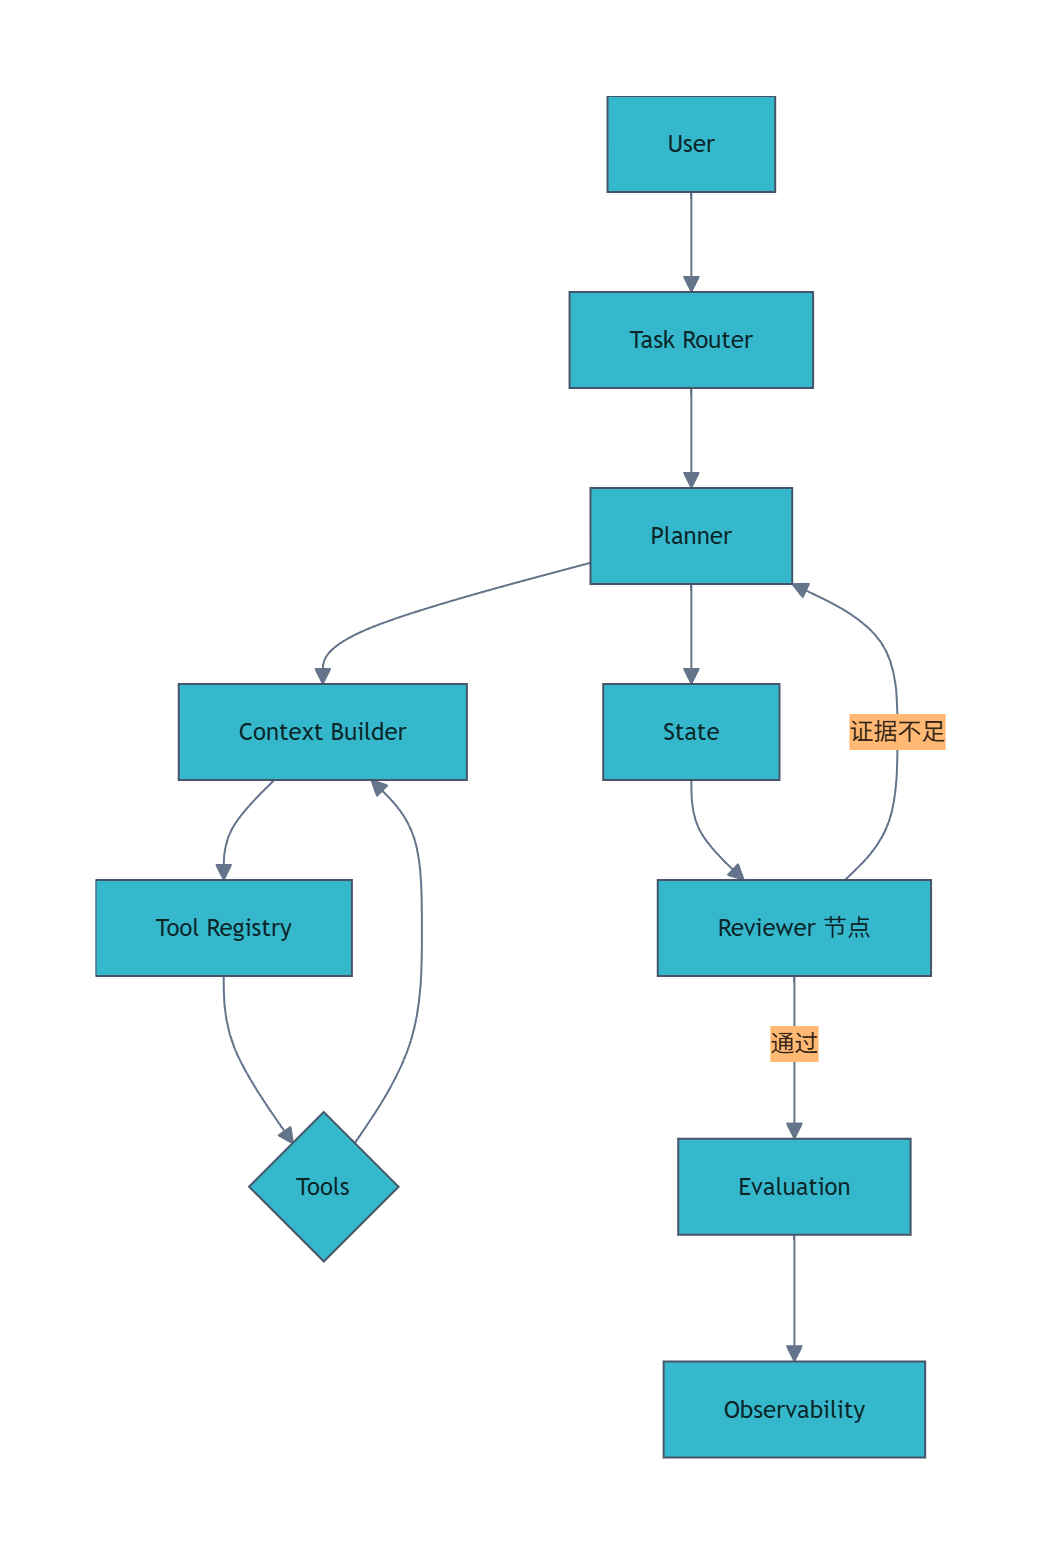
多了 Task Router、Planner、Context Builder、Tool Registry、State、Reviewer、Evaluation------但注意,这些不是"拍脑袋加的组件",而是前面每一篇的根因倒逼出来的。
收益总表
跑同一份 eval 数据集,v1 和 v2 的全指标对比:
| 指标 | v1 | v2 | 变化 |
|---|---|---|---|
| Success Rate | 55% | 85% | +30% |
| Tool Accuracy | 60% | 88% | +28% |
| Answer Accuracy | 48% | 82% | +34% |
| Cost (avg tokens) | 4200 | 2900 | -31% |
| Latency (avg s) | 9.8s | 6.9s | -30% |
五个指标,全面改善。 尤其 Success Rate 从 55% 到 85%------这意味着,原来有一半的任务是错的,现在只有 15% 会错。
而这张表最有价值的地方,是每一个数字都能回溯到具体改动:Success Rate +30%,主要来自 Task Router(+10%)+ Reviewer(+12%)+ 工具描述优化(+8%);Cost -31%,主要来自 Planner 终点意识 + PR review 退 Workflow。
代码或配置示例
v2 的"总装",是这一篇的收束------把散落的改动,收进一个清晰的目录结构:
repo_doctor/
├── agent.lock              # 第45篇:七维版本锁定
├── nodes/
│   ├── task_router.py      # 第38篇:任务分流
│   ├── planner.py          # 第38篇:规划调查
│   ├── context_builder.py  # 第42篇:控制读什么(防上下文爆炸)
│   └── reviewer.py         # 第48篇:独立审查节点
├── tools/
│   ├── registry.py         # 第41篇:统一管理工具+描述
│   └── schemas.py          # 第41篇:工具参数约束
├── eval/
│   ├── normal/             # 第43篇:评估数据集
│   └── scorer.py           # 第43篇:打分器
├── version/
│   └── check.py            # 第45篇:版本漂移校验
└── tasks/
    └── pr_review.py        # 第47篇:退回的固定 Workflow
每一个目录,都能说出"它来自哪一篇、解决了什么问题"。 这,就是"工程"和"堆代码"的区别。
设计权衡
| 候选方案 | 优点 | 缺点 | 为什么不选 |
|---|---|---|---|
| 一次大重构 | 干净 | 无法定位每处改动的收益,回归风险极高 | 一口吃不成胖子 |
| 逐篇小步改+复盘 | 每步可验证、可回溯 | 慢 | 每次改动都能说清"为什么" |
这十篇走下来,最深的一个体会是:Agent 的优化,从来不是"一次性大改"能完成的,而是"失败→修复→验证"的小步快跑。 大改看似高效,实则让你失去对每一处改动的掌控,最后连"哪里改对了"都说不清。
总结
✅ v1→v2 的所有改动,都能回溯到具体的一篇、一个根因、一个预期收益。
✅ 架构从 4 节点涨到 10 节点,但每个节点都是根因倒逼出来的,不是拍脑袋。
✅ 收益总表:Success Rate 55%→85%、Cost -31%、Latency -30%,全面改善。
✅ 铁律:v1 到 v2 之间隔着的,不是代码量,是你踩过的每一次失败和每一次验证。
✅ 下一篇,给 v2 补上最后一层生产外壳,收尾整个阶段。
参考资料
- 本系列第 39--48 篇 → 为什么引用:本文是它们的汇总,每处改动都能回溯到原篇。
- 《Accelerate》中的"小步快跑 vs 大爆炸" → 为什么引用:小步改进优于大重构,是这十篇方法论的理论支撑。
系列导航
- 上一篇:AI Agent 工程实践(48):什么时候应该 Multi-Agent-CSDN博客
- 下一篇:AI Agent 工程实践(50):最终项目------一个真正可运行的 Production Agent
本文是 AI Agent 工程实践 系列的第 49 篇。