通过这篇文章,我们要复习常见概率的计算,知道贝叶斯公式,了解朴素贝叶斯是什么,了解拉普拉斯平滑系数的作用,知道朴素贝叶斯的API,能够应用朴素贝叶斯实现商品评论情感分析。
一、朴素贝叶斯算法-利用概率值进行分类的一种机器学习算法
举个例子,计算条件概率和联合概率。
联合概率:P(A,B),A 事件并且 B 事件同时发生的概率
条件概率:P(A|B),在 B 已经发生的前提下,A 发生的概率
公式:
P(A|B)=P(A,B)/{P(B)
P(A,B)=P(B) P(A|B)
班级一共 10 人:
| 男生 | 女生 | |
|---|---|---|
| 戴眼镜 | 3 人 | 2 人 |
| 不戴眼镜 | 2 人 | 3 人 |
总人数 =10
事件定义:
- A:是男生
- B:戴眼镜
1️⃣ 联合概率 P(A,B):既是男生,并且戴眼镜
男生且戴眼镜一共 3 人
P(A,B)=3/10=0.3
2️⃣ 边缘概率 P(B):戴眼镜(不管男女)
戴眼镜总人数 3+2=5
P(B)=5/10=0.5
3️⃣ 条件概率 P(A|B):已知这个人戴眼镜,求他是男生的概率
套用公式:
P(A|B)=P(A,B)P(B)=0.3*0.5=0.6
直观理解:限定只看戴眼镜 5 个人,其中男生 3 人:\(3/5=0.6\)。
反过来算 P(B|A):已知是男生,求戴眼镜概率
男生一共:3+2=5人 男生且戴眼镜 3 人
P(B|A)=P(A,B)/{P(A)}=0.3/{5/10}= 0.3/0.5=0.6
区分记忆
-
联合概率 P (A,B) :两件事同时发生,分母是全部总样本。
-
条件概率 P (A|B):B 已经确定发生,样本空间缩小,分母变成 B 的数量。
和贝叶斯挂钩
P(A|B)=P(B|A)P(A)/P(B)
二、朴素贝叶斯(Naive Bayes)
1、核心基础
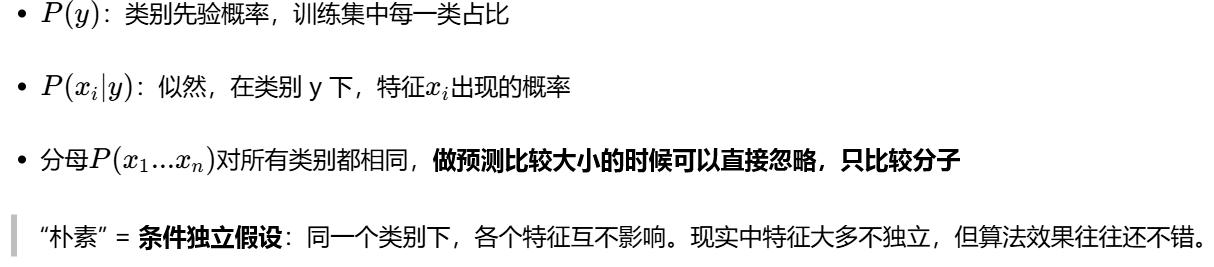
基于贝叶斯公式 ,加一个朴素假设:所有特征条件相互独立。
贝叶斯公式:
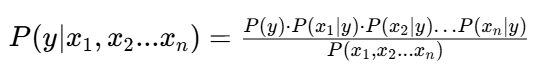
三、拉普拉斯平滑系数
为了避免概率值为 0,我们在分子和分母分别加上一个数值,这就是拉普拉斯平滑系数的作用
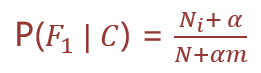
α 是拉普拉斯平滑系数,一般指定为 1
Ni 是 F1 中符合条件 C 的样本数量
N 是在条件 C 下所有样本的总数
m 表示所有独立样本的总数
为了避免概率值为 0,我们在分子和分母分别加上一个数值,这就是拉普拉斯平滑系数的作用
四、朴素贝叶斯API
sklearn.naive_bayes.MultinomialNB(alpha = 1.0)
-
朴素贝叶斯分类
-
alpha:拉普拉斯平滑系数
五、商品评论情感分析
已知商品评论数据,根据数据进行情感分类(好评、差评)
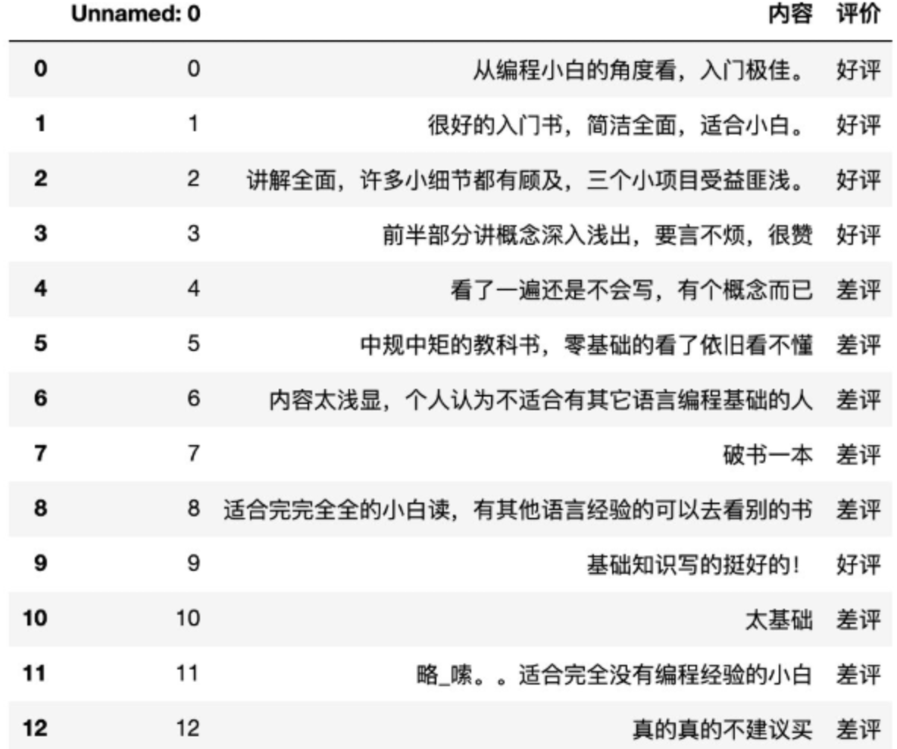
1 获取数据
2 数据基本处理
#2-1 处理数据y
2-2 加载停用词
2-3 处理数据x 把文档分词
2-4 统计词频矩阵 作为句子特征
3 准备训练集测试集
4 模型训练
4-1 实例化贝叶斯 添加拉普拉斯平滑参数
4-2 模型预测
5 模型评估
"""
案例:
    演示通过 朴素贝叶斯算法 实现 商品评论情感分析,即:好评,差评……

朴素贝叶斯介绍:
    概述:
        贝叶斯:仅仅依赖概率 就可以进行分类的一种机器学习算法
        朴素:不考虑特征之间的关联性,即:特征间都是相互独立的。
            原始:P(AB) = P(A)*P(B/A) * P(B) * P(A/B)
            加入朴素之后:P(AB) = P(A)*P(B)
    细节:
        因为我们分词用到jieba分词器,记得先装一下,例如:pip install jieba

"""

# 导包
import numpy as np                      # 数学计算包
import pandas as pd                     # 数据处理包
import matplotlib.pyplot as plt         # 画图包
import jieba                            # 分词包
from nltk import accuracy
from nltk.corpus import stopwords
from sklearn.feature_extraction.text import CountVectorizer      # 词频统计包,把评论内容 转成 词频矩阵
from sklearn.metrics import accuracy_score
from sklearn.naive_bayes import MultinomialNB       # 朴素贝叶斯对象

# 1. 读取文件,获取原始数据。
df = pd.read_csv('./data/书籍评价.csv',encoding='gbk')
# df.info()

# 2. 数据预处理。
# 2.1 添加labels列,充当:标签列,好评->1,差评->0
df['label'] = np.where(df['评价'] =='好评', 1, 0)
# print(df)
# 2.2 抽取'labels'列,作为:标签。
y = df['label']
# 2.3 演示 jieba 分词
# print(jieba.lcut('好好学习,天天向上!我爱你你爱我,蜜雪冰城甜蜜蜜!小明骑车,一把把把把住了。'))
# 2.4 对用户的评论信息,做切词
# 数据格式:[[第1条评论切词1,切词2,切词3……],[第2条评论切词1,切词2,切词3……]]
comment_list = [','.join(jieba.lcut(line)) for line in df['内容']]
# 数据格式:[[第1条评论切词1,切词2,切词3……,[第2条评论切词1,切词2,切词3……]]
print(comment_list)
# 2.5 加载 停用词列表,即:里边记录的词,不需要参与模型训练,预测,要被删除的词,例如:的,啊,哈,从,都……
with open('./data/stopwords.txt','r',encoding='utf-8') as src_f:
    # 2.5.1 依次读取所有的行
    stopwords_list = src_f.readlines()
    # 2.5.2 删除最后的'\n'
    stopwords_list = [line.strip() for line in stopwords_list]
    # 2.5.3 对 停用词列表去重
    stopwords_list = list(set(stopwords_list))
    # print(stopwords_list)

# 2.6 创建向量化对象,从 评论切词列表(comment_list)中 删除 停用词,并且统计词频(单词矩阵)。
transfer = CountVectorizer(stop_words=stopwords_list)   # 参数:停用词列表。

# 2.7 统计词频矩阵,先训练,后转换,再转数组。
transfer.fit(comment_list)
x = transfer.transform(comment_list).toarray()
print(x)

# 2.8 看一下 我们13条评论,切词,且删除 停用词后,一共剩下多少个词了。
print(transfer.get_feature_names_out())
print(len(transfer.get_feature_names_out()))  # 37个词

# 2.9 应为就 13条数据,我们把前10条当训练集,后3条当测试集
x_train = x[:10]
y_train = y[:10]

x_test = x[10:]
y_test = y[10:]

# 3. 特征工程,此处略

# 4.模型训练
estimator = MultinomialNB()       # 创建朴素贝叶斯模型
estimator.fit(x_train,y_train)

# 5.模型预测
y_pred = estimator.predict(x_test)
print('模型预测结果是:',y_pred)

# 6.模型评估
print(f'准确率:{accuracy_score(y_test, y_pred)*100}%')