第 18 章 学习与适应 Learning
本章要解决的问题
Agent 上线后表现会随用户使用而变化------怎么让它从反馈中学习,又不会越学越偏?
章节大纲
- 18.1 从用户反馈中学习
- 18.2 行为调优与策略迭代
- 18.3 持续改进的闭环设计
- 18.4 主流框架对照与变体
- 🛠 解决方案:学习漂移与回退保护
18.1 模式原理:让 Agent 越用越好
18.1.1 一句话定义
学习与适应(Learning & Adaptation)是让 Agent 从真实使用反馈中持续改进------把"上线后就不会变"的静态系统,变成"越用越准"的动态系统。 它是 9 大设计模式的收官章,因为它把前 8 个模式串成了一个持续进化的闭环。
18.1.2 为什么需要学习:静态 Agent 的退化宿命
一个不学习的 Agent 会面临双重困境:
- 用户表达在变:今天问"物流到哪了",明天问"我的包裹飞哪去了"------静态路由规则(第 11 章)覆盖不了的新表达会不断出现,准确率持续下滑。
- 业务知识在变:商品上新、政策调整、数据源变更------静态提示词(第 4 章)里的旧知识会过期,幻觉风险上升。
静态系统的规律:上线即巅峰,之后缓慢退化。 学习的意义在于对抗这个退化------把"真实使用数据"变成"改进燃料"。
18.1.3 学习 vs 反思:范围与频率的区别
先厘清概念,避免和前几章混淆:
| 维度 | 反思(第 13 章) | 学习(本章) |
|---|---|---|
| 范围 | 单次输出 | 跨会话、跨用户 |
| 频率 | 每次生成时 | 定期/事件触发 |
| 记忆 | 无(用后即弃) | 有(沉淀教训) |
| 载体 | 修正当前输出 | 更新规则/提示词/记忆/模型 |
反思是"单次自我修正",学习是"跨次持续进化"------第 13 章 13.4.2 的 Reflexion 就是两者的桥梁(带记忆的反思)。
18.2 从用户反馈中学习
18.2.1 反馈信号的分级
学习需要反馈,反馈从哪来?按质量与获取成本分级:
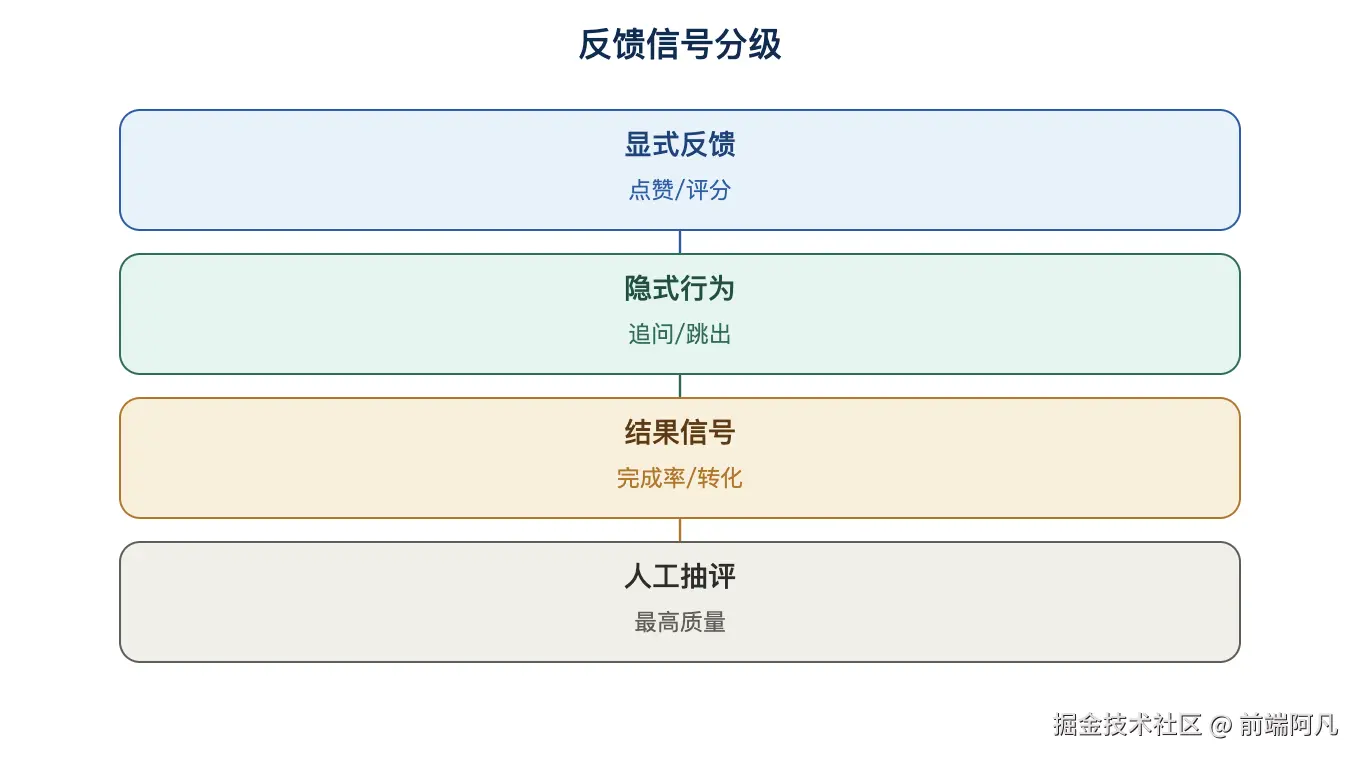
图 1:反馈信号分级
| 反馈来源 | 信号 | 质量 | 获取成本 |
|---|---|---|---|
| 显式反馈 | 点赞/点踩、评分、"有用吗" | 高 | 低(但用户不爱点) |
| 隐式行为 | 追问、复制、重新提问、跳出 | 中 | 零(自动采集) |
| 结果信号 | 任务完成率、转化、工单关闭率 | 高 | 中(要打点) |
| 人工抽评 | 运营/质检团队抽样打分 | 最高 | 高 |
| LLM-as-Judge | 模型按规范打分(第 17 章) | 中高 | 低 |
工程建议:显式反馈 + 隐式行为 + LLM-as-Judge 三路并用,人工抽评做高价值抽检。
18.2.2 反馈的落地动作(从信号到改进)
拿到反馈后,按改进的"成本与深度"分四个层次:
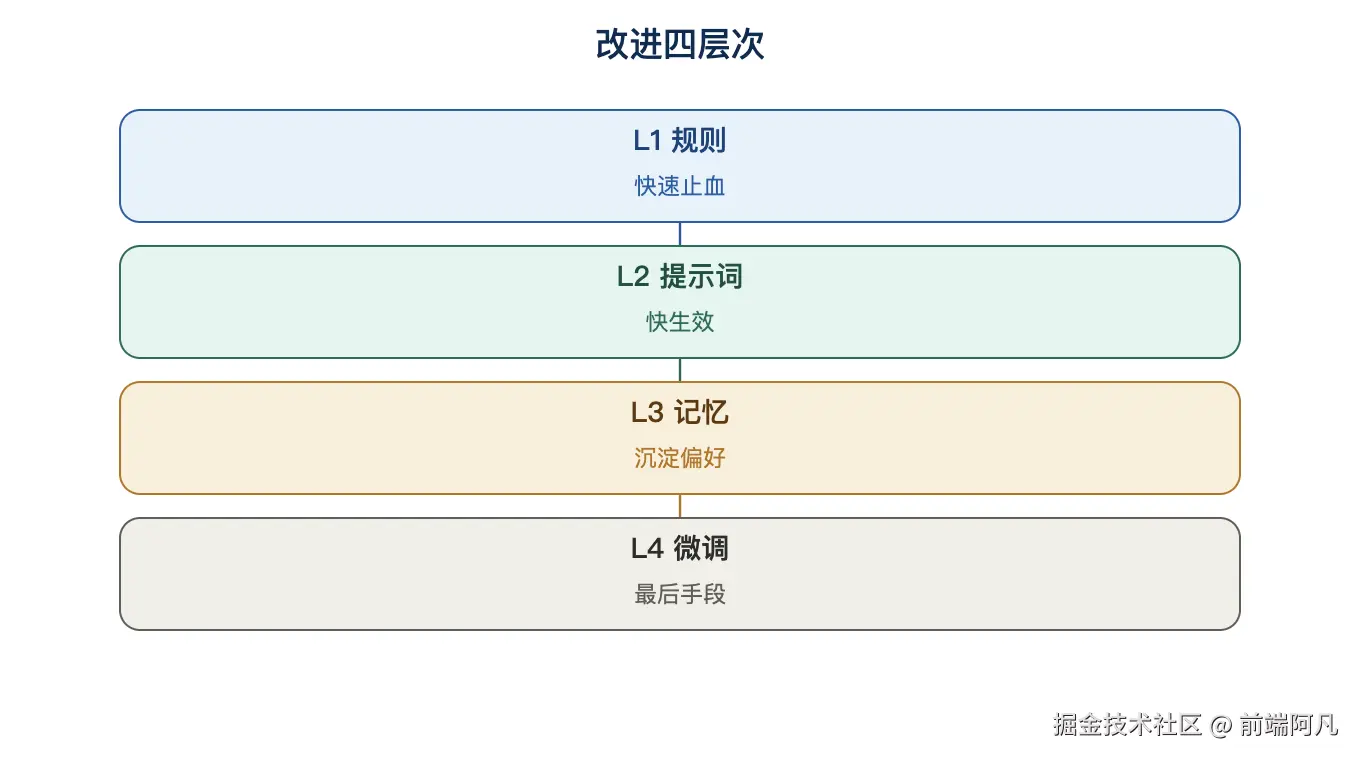
图 2:改进四层次
| 层次 | 动作 | 成本 | 生效速度 | 例子 |
|---|---|---|---|---|
| L1 规则更新 | 往路由/Guardrail 规则库加规则 | 极低 | 即时 | "用户说'包裹飞走了'→加进物流关键词" |
| L2 提示词迭代 | 改系统提示词/加 few-shot 示例 | 低 | 快 | 把高频失败案例加进提示词示例 |
| L3 记忆沉淀 | 写入长期记忆(第 9 章) | 低 | 快 | 记住"VIP 用户优先补偿" |
| L4 模型级优化 | 微调/蒸馏(第 23 章相关) | 高 | 慢 | 收集 1000 条数据微调分类模型 |
经验法则:先用 L1L3 快速止血(低成本、快生效),L4 只在 L1L3 解决不了时才上。 大多数业务问题在规则和提示词层就能解决,别动不动微调模型。
18.2.3 反馈闭环的最小实现
python
def collect_feedback(session):
    """采集显式反馈 + 隐式信号"""
    return {
        "liked": session.get("like"),                 # 显式
        "re_asked": session.get("re_asked", False),   # 隐式:追问
        "judge_score": llm_judge(session["reply"]),   # 模型评分
    }

def learn_from_feedback(feedback, context):
    """把反馈变成改进动作"""
    improvements = []
    if not feedback["liked"] or feedback["re_asked"]:
        # 失败样本 → 分析根因 → 产出规则/提示词修改建议
        analysis = analyze_failure(context)
        improvements.append({
            "type": "rule" if analysis["kind"] == "routing"
                    else "prompt",
            "content": analysis["suggestion"],
        })
    return improvements
18.3 行为调优与策略迭代
18.3.1 策略迭代的节奏:多久改一次?
学习的节奏与被学习的对象强相关:
| 学习对象 | 更新节奏 | 说明 |
|---|---|---|
| 路由规则 | 按天/周 | 新表达出现快,规则要常更 |
| 提示词 | 按周/月 | 大改需评测集回归(第 20 章) |
| 长期记忆 | 实时 | 记忆写入是流式的 |
| 模型微调 | 按月/季度 | 数据积累期长,谨慎 |
节奏的核心约束:每次"学习后的改动"都要过评测集(呼应第 20 章防退化)------学习的反面是退化,没有评测护栏的学习就是盲改。
18.3.2 学习的双轨制:线上热更新 vs 线下沉淀
| 轨道 | 机制 | 风险 | 用途 |
|---|---|---|---|
| 线上热更新 | 规则/记忆实时更新(L1/L3) | 低(可回滚) | 快速止血、个性化 |
| 线下沉淀 | 每周复盘 → 提示词/模型迭代(L2/L4) | 中(需评测) | 系统性改进 |
规则和记忆可以热更新(快、低风险),提示词和模型必须线下迭代(慢、要评测)------这是学习工程最重要的一条纪律。
18.3.3 学习的停止条件:何时"学会"了
学习不是无限进行的,三个停止信号:
- 收益递减:连续 N 轮改进后指标不再提升(学习曲线平坦)。
- 过拟合征兆:训练样本上持续提升,但真实流量上不升反降(第 20 章回归验证能发现)。
- 漂移警报:改进后的行为偏离了产品边界(见 18.5 学习漂移)。
18.4 持续改进的闭环设计(完整示例)
一个完整的"数据 → 分析 → 改进 → 验证 → 上线"闭环:
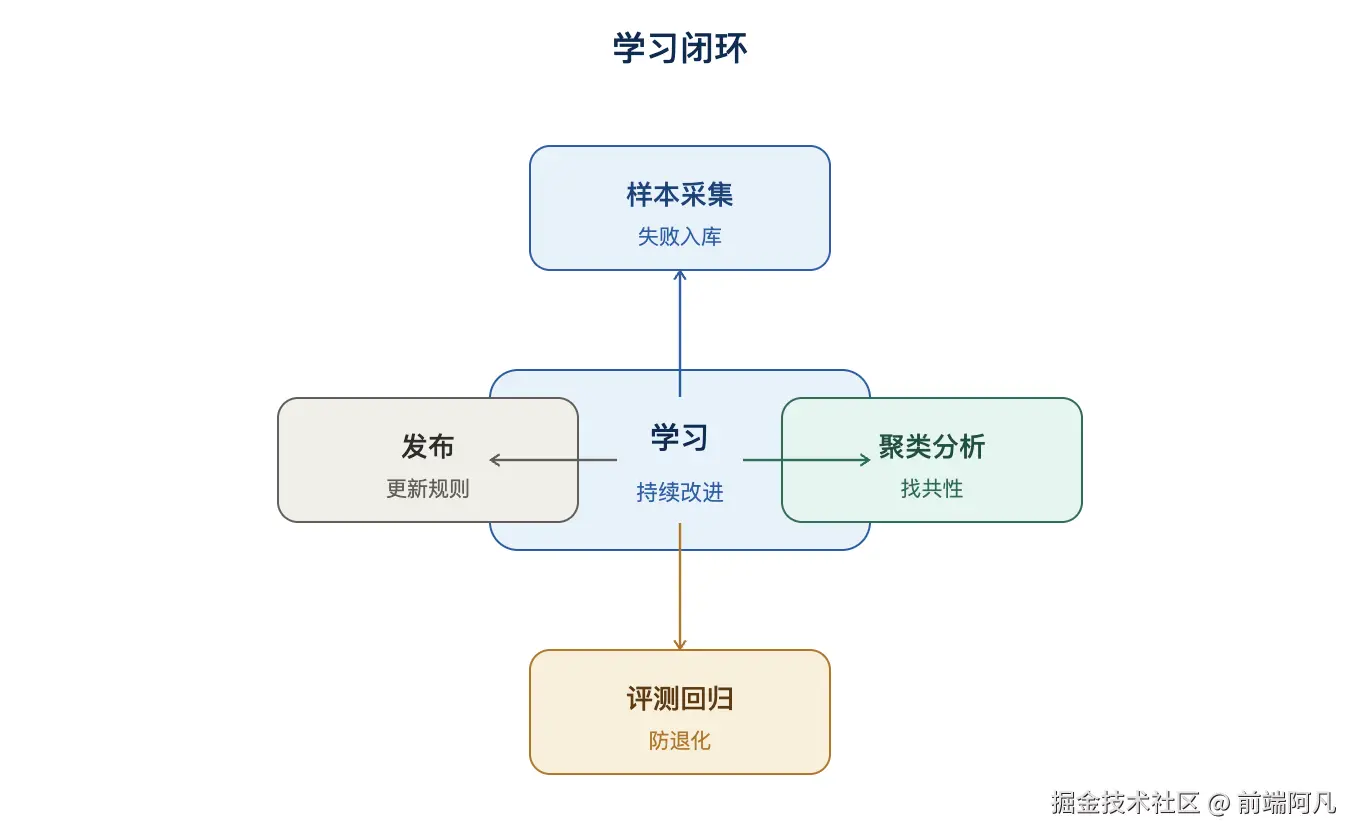
图 3:学习闭环
python
import json, time
from collections import defaultdict

class LearningLoop:
    def __init__(self, eval_set=None):
        self.failure_bank = []        # 失败样本库
        self.rules = load_rules()     # 当前规则集
        self.eval_set = eval_set or load_eval_set()   # 评测集(第20章)
        self.baseline = None

    def on_session_end(self, session):
        """每次会话结束:采集反馈 → 判断失败 → 入失败库"""
        fb = collect_feedback(session)
        if not fb["liked"] or fb["re_asked"]:
            self.failure_bank.append({
                "time": time.time(),
                "query": session["query"],
                "reply": session["reply"],
                "feedback": fb,
            })

    def weekly_review(self):
        """每周复盘:分析失败库 → 产改进 → 评测回归 → 上线"""
        if len(self.failure_bank) < 20:
            print("样本不足,跳过本周复盘")
            return
        # 1. 失败聚类(找共性)
        clusters = cluster_failures(self.failure_bank)
        # 2. 生成规则建议
        new_rules = []
        for c in clusters:
            if c["kind"] == "routing" and len(c["samples"]) >= 5:
                new_rules.append(generate_rule(c["pattern"]))
        # 3. 评测回归(关键!防退化)
        old_score = self.evaluate(self.rules)
        if not self.evaluate(self.rules + new_rules) >= old_score:
            print("改进未通过评测,本次不发布")
            return
        # 4. 发布 + 清空样本
        self.rules += new_rules
        publish_rules(self.rules)
        self.failure_bank = []
        print(f"发布 {len(new_rules)} 条新规则")

    def evaluate(self, rules):
        """在固定评测集上打分(第20章完整体系)"""
        return sum(1 for q, expected in self.eval_set
                   if run_with_rules(q, rules) == expected) / len(self.eval_set)

loop = LearningLoop()
loop.on_session_end(session_1)
loop.on_session_end(session_2)
# ... 持续运行
loop.weekly_review()
闭环四要素缺一不可 :样本采集 → 分析聚类 → 评测回归 → 发布。评测回归是学习闭环的刹车片------没有它,学习就会变成"越改越烂"。
生产加固 :失败样本库中存储的用户查询和回复可能包含 PII(个人身份信息),持久化前应做脱敏处理(手机号、身份证号等正则替换,呼应第 22 章);
failure_bank应设置容量上限和过期清理,避免无限增长;生成的规则在发布前应经过人工审核,防止自动学习引入偏差。
18.5 主流框架对照与变体
18.5.1 框架对照
| 实现方式 | 特点 | 适用 |
|---|---|---|
| 自研闭环(本章主线) | 采集/分析/回归/发布四段式,完全可控 | 教学、定制 |
| LangSmith / Langfuse 反馈采集 | 框架级 trace + 反馈标注 | 已用 LangChain 生态 |
| 微调管线(LoRA/QLoRA) | 收集数据微调模型(呼应第 23 章) | 规则/提示词解决不了时 |
| AutoML 提示词优化(DSPy 等) | 自动搜索提示词/示例 | 想把提示词迭代自动化 |
18.5.2 变体一:基于记忆的个性化适应
利用第 9 章长期记忆:Agent 记住"该用户上次的偏好/上下文",新会话自动适应("您上次提到预算有限,这次方案默认经济型")。这是"学习"最贴近用户的形态------记忆即个性化。
18.5.3 变体二:主动澄清 vs 被动学习
被动学习(等反馈)之外,Agent 可以主动降低误解:不确定用户意图时主动追问澄清 ("您说的'发货'是指物流进度还是发货时间?")。主动澄清能显著减少错误反馈的产生------少犯错就是最好的学习。
18.5.4 变体三:A/B 实验驱动的学习
不盲改,而是把候选改进做成 A/B 实验:10% 流量跑新版,90% 跑旧版,对比关键指标后决定全量(呼应第 20 章灰度、第 24 章灰度参数)。学习 + 实验 = 有证据的进化。
🛠 解决方案:学习漂移与回退保护
常见问题
- "越学越偏,开始胡说"(学习漂移):学习引入了错误规则/记忆污染。对策:评测回归 + 漂移检测(18.3.3)+ 一切改进可回滚。
- "规则越加越多,越来越乱":失败样本直接变规则,规则库膨胀。对策:聚类后合并(18.4),定期清理低频规则;规则过 100 条考虑改用模型路由(第 11 章)。
- "样本太少,学了等于没学":失败样本 <20 就复盘,噪声大于信号。对策:设最低样本阈值 + 只对高频失败模式学。
- "改完上线又出新的错":改进未过评测回归。对策:任何改动必须过评测集(18.4 第三步),不过不发布。
- "学习让成本上升":每次学习动作都触发全量回归/微调。对策:L1/L3 热更新低成本,L4 微调低频化,别让学习成本超过收益。
解决方案速查表
| 现象 | 根因 | 解决方案 |
|---|---|---|
| 越学越偏 | 无评测护栏 | 评测回归 + 漂移检测 |
| 规则膨胀 | 无聚类合并 | 聚类 + 定期清理 |
| 学而无果 | 样本不足 | 最低阈值 + 高频优先 |
| 改了又错 | 无回归 | 必须过评测才发布 |
| 成本上升 | 学习动作过重 | 热更新优先 + 微调低频 |
实战提示
- 评测回归是学习闭环的刹车片------没有它,学习就变成"越改越烂"。
- 先用 L1~L3 快速止血(规则/提示词/记忆),微调是最后手段。
- 规则和记忆可热更新,提示词和模型必须线下迭代(双轨制)。
- 每次改进都要可回滚------配置版本化(呼应第 24 章 G4),出问题一键回退。
- 少犯错就是最好的学习:主动澄清、Guardrail 前置(第 17 章),减少错误产出的产生。
本章结语:9 大设计模式的完整图景
至此,9 大设计模式全部讲完。它们不是孤立的,而是一个按"任务复杂度"递进的选择体系:
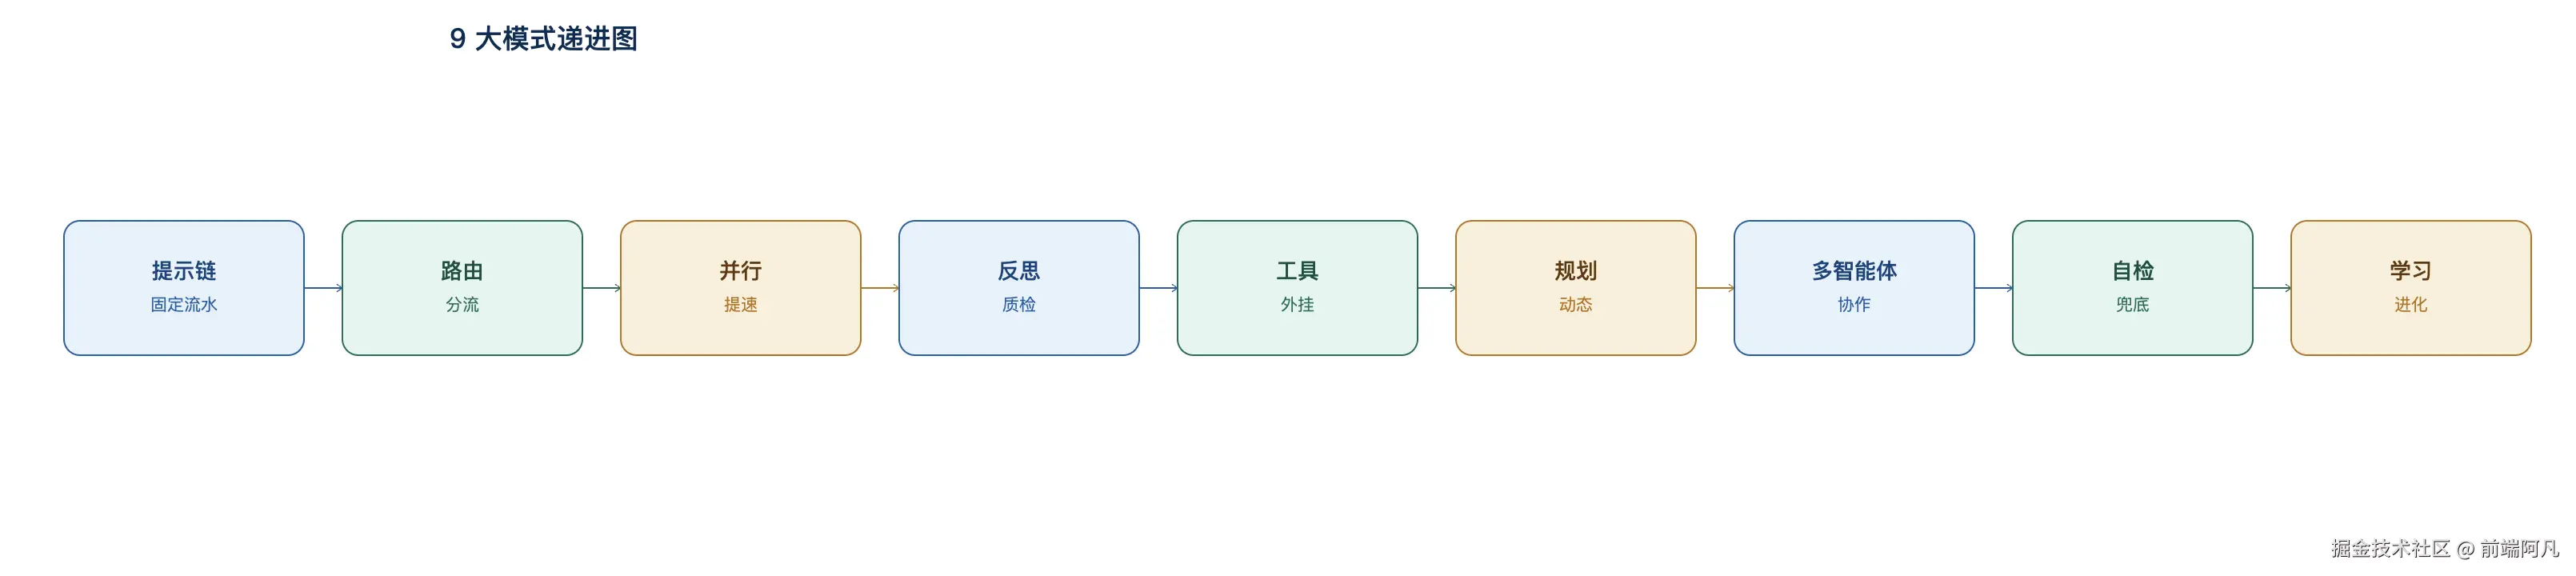
图 4:9 大模式递进图
scss
简单任务 ────────────────────────────────→ 复杂任务
提示链(10) → 路由(11) → 并行化(12) → 反思(13) → 工具(14)
    → 规划(15) → 多智能体(16) → 自检(17) → 学习(18)
   ↑                                          ↑
固定流水线 持续进化系统设计模式的选型心法:
- 任务路径固定 → 提示链
- 输入多样 → 路由
- 子任务独立 → 并行化
- 输出质量不稳 → 反思
- 需要外部能力 → 工具
- 任务动态复杂 → 规划
- 单一 Agent 不够 → 多智能体
- 输出要兜底 → 自检
- 上线后要变好 → 学习
从第 10 章到第 18 章的进阶顺序,就是"从一个固定的链"走向"一个会学习的系统"的完整路径。 第 V 部分将把它们放进生产环境,讲评测、排错、安全与治理------让模式真正落地。