一.生------进程创建之fork函数
1.fork()
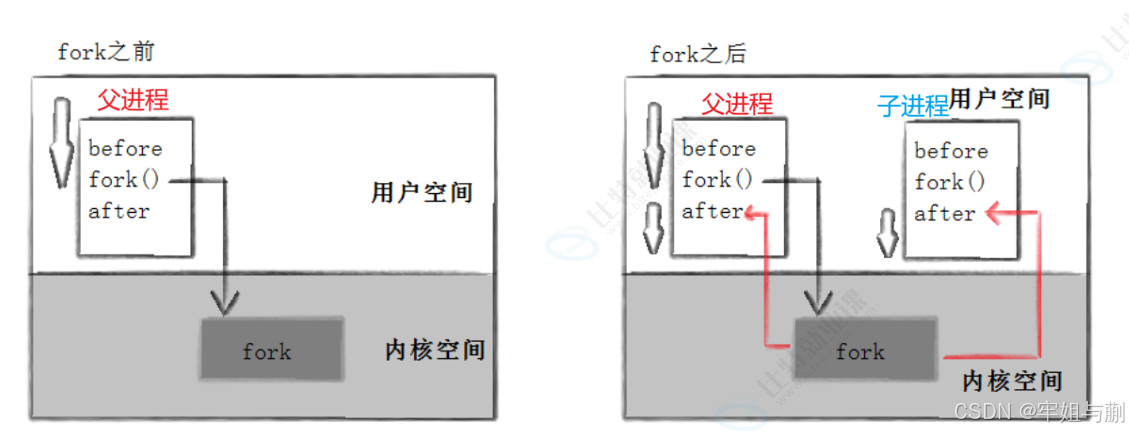
由于之前在讲进程概念的时候,已经提到过fork函数,所以这里着重强调,在调用fork时,内核在干什么。
进程调⽤ fork ,当控制转移到内核中的 fork 代码后,内核做:
• 分配新的内存块和内核数据结构给⼦进程
• 将⽗进程部分数据结构内容拷⻉⾄⼦进程
• 添加⼦进程到系统进程列表当中
• fork 返回,开始调度器调度
此外,再补充一下进程概念这篇文章里fork()函数创建进程里没说清楚的地方,就是创建子进程以后,fork()以后的代码,父进程和子进程各自执行各自的,究竟谁先执行,由调度器决定。
示意图:
2.写时拷贝的实现原理
①.原理
在上一篇文章中,我们暂且了解了写时拷贝是为了将父子进程在内存上的实际储存空间岔开,防止一个进程修改数据时,由于实际地址相同,导致另一个进程受到干扰。
但我们并不知道写时拷贝是如何实现的,这里就来说明一下。
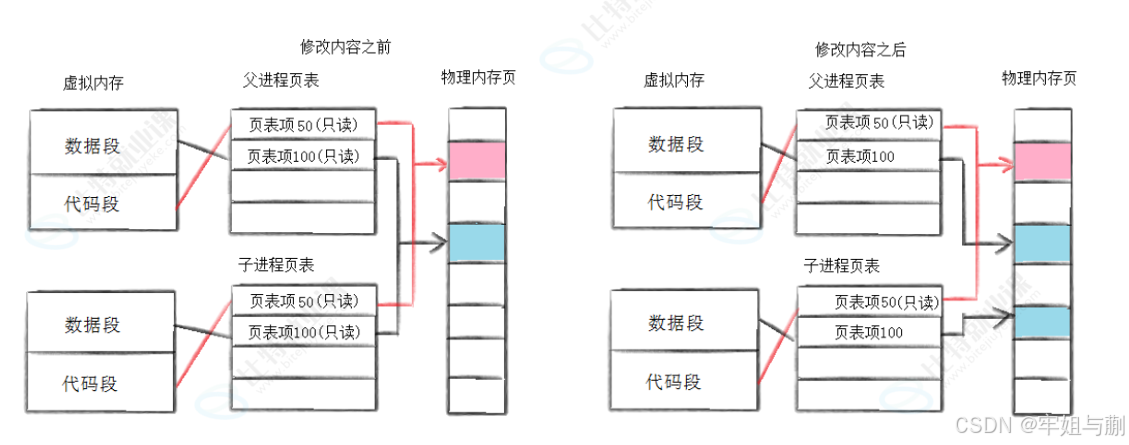
内容修改之前,父子进程的数据和代码是共享的(物理地址相同)。此时父子进程页表上的所有项的权限是只读权限 。当某个进程修改内容(写入)时,由于只有读权限,会出现"错误",系统基于这个"错误"就会作出反应,做出类似缺页中断的操作,然后磁盘重新加载数据代码进内存,形成新的物理地址和空间 ,同时,对应项为了能够被修改,在页表上的权限也会发生改变,不再只有读权限。修改就是改子进程新空间上的内容。
②.为什么要写时拷贝?
1.因为有写时拷⻉技术的存在,所以⽗⼦进程得以彻底分离!完成了进程独⽴性的技术保证!
2.在创建子进程的新空间时,要修改的代码和数据才加载进内存,其余与父进程重复的内容不再加载进来,这样就能节省内存空间,以及创建空间的时间。
那其他相同的数据和代码在哪呢?答案是接着和父进程共用,毕竟这些相同的东西不发生改变,就不会触发写时拷贝去开新空间。
③.OS如何区分数据段和代码段?
上篇文章说过,mm_struct里有虚拟地址空间各个大区域的起始地址(虚拟地址)。
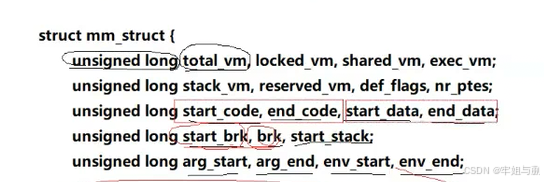
OS一查数据位于哪些区域的起始地址之间,就能判别它是隶属数据段还是代码段。
3.fork()的常规用法
①.执行父进程代码的一部分,即⼀个⽗进程希望复制⾃⼰,使⽗⼦进程同时执⾏不同的代码段。
②.执行一个全新的进程。
4.fork调⽤失败的原因
• 系统中有太多的进程
• 实际⽤⼾的进程数超过了限制
归根结底还是内存不足。
二.亡------进程终止
1.详谈进程终止的返回值(退出码)
在进程状态这篇文章里,曾经提到一个进程终止后,不会马上清除掉进程的所有东西,而是会保留PCB(内部含退出信息)和pid,处于Z(僵尸)状态,等待父进程获取pid和退出信息,进而知晓子进程的执行情况。子进程做完事,需要父进程来查看执行情况!
c/cpp的main函数的返回值代表程序的执行情况。执行情况分为三种:
• 代码运⾏完毕 ,结果正确->返回0。
• 代码运⾏完毕 ,结果不正确->返回非0数(1,2,3...)。
• 代码异常终⽌,退出码无意义!
0代表成功,即成功就是成功,无人去问你如何成功。非0代表失败,有多个非0数,代表多种失败原因,即失败时会去想是由于什么原因出的错。
这些不同的返回值叫做退出码。退出码(退出状态)可以告诉我们最后⼀次执⾏的命令的状态。在命令结束以后,我们可以知道命令 是成功完成的还是以错误结束的。其基本思想是,程序返回退出代码 0 时表⽰执⾏成功,没有问题。 代码 1 或 0 以外的任何代码都被视为不成功。
这是退出码的对照表:
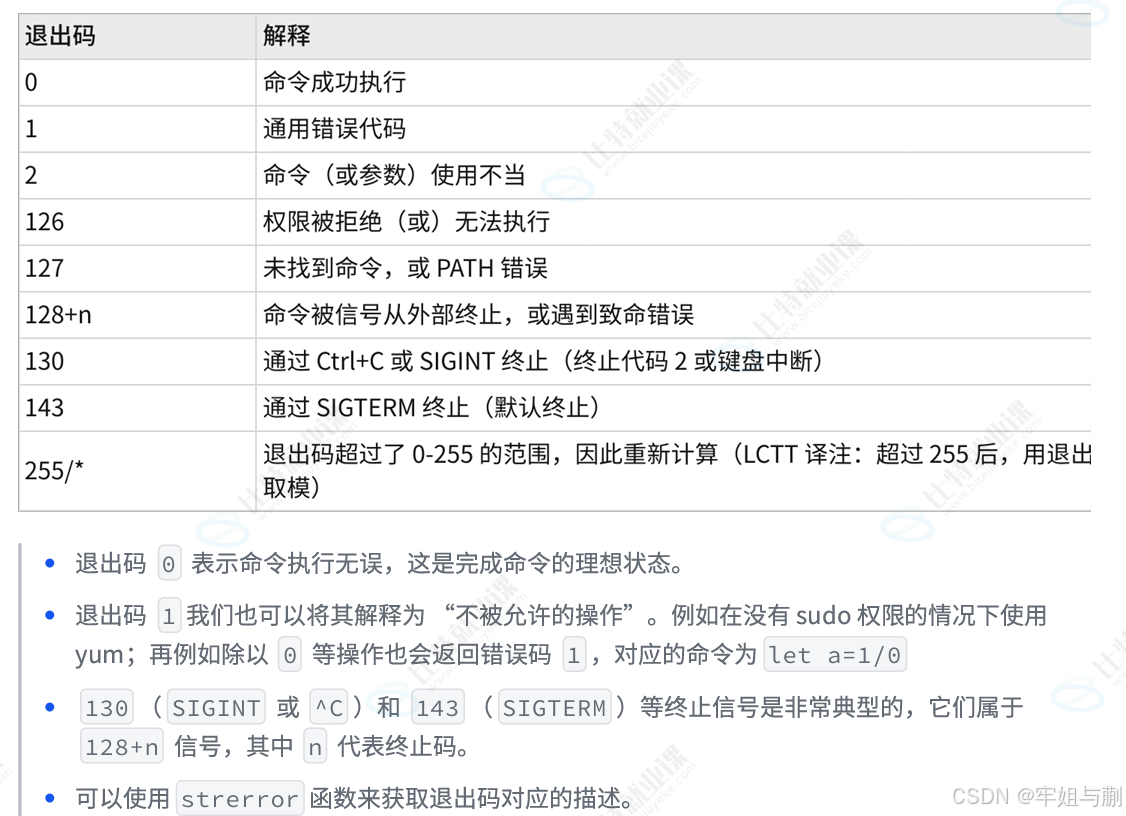
子进程执行完毕后,退出码写给PCB,然后僵尸状态等待,父进程(bash)就会从僵尸状态子进程的PCB里读取到退出码,进而知晓执行情况。
这里有个指令:echo $? 可以查询到最近一个进程的退出码:
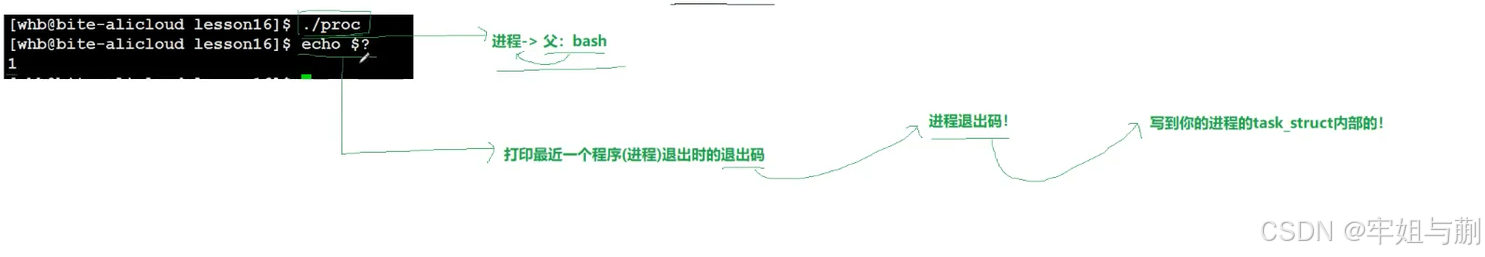
至于父进程如何读取子进程退出码,这是下部分进程等待的事,这里暂且不提。
2.exit函数
#include <unistd.h>
void exit(int status);注:这里的status指的是退出码。
任何地方调用了该函数,就代表一个进程的结束,并将子进程的退出码返回给父进程bash。main函数结束,就代表一个进程的结束,那么main函数末尾的return n就相当于执⾏exit(n),因为调⽤main的运⾏时,函数会 将main的返回值当做exit的参数。
3._exit VS exit
①._exit
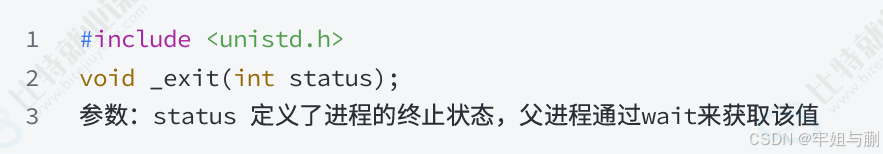
这玩意跟上面那个一样的用法,但它俩到底有啥区别呢?
②.对比
Ⅰ.调用关系
exit的是个库函数,_exit是个系统调用函数(system call);库函数在执行的时候,会去调用系统调用函数,库函数与系统调用函数属于一个上下层的关系,(系统调用的知识点在笔者进程概念这篇文章),也就是说,exit在执行时会去调用_exit。
exit最后也会调⽤_exit,但在调⽤_exit之前,还做了其他⼯作:
-
执⾏⽤⼾通过atexit或on_exit定义的清理函数。
-
关闭所有打开的流,所有的缓存数据均被写⼊。
-
调⽤_exit。
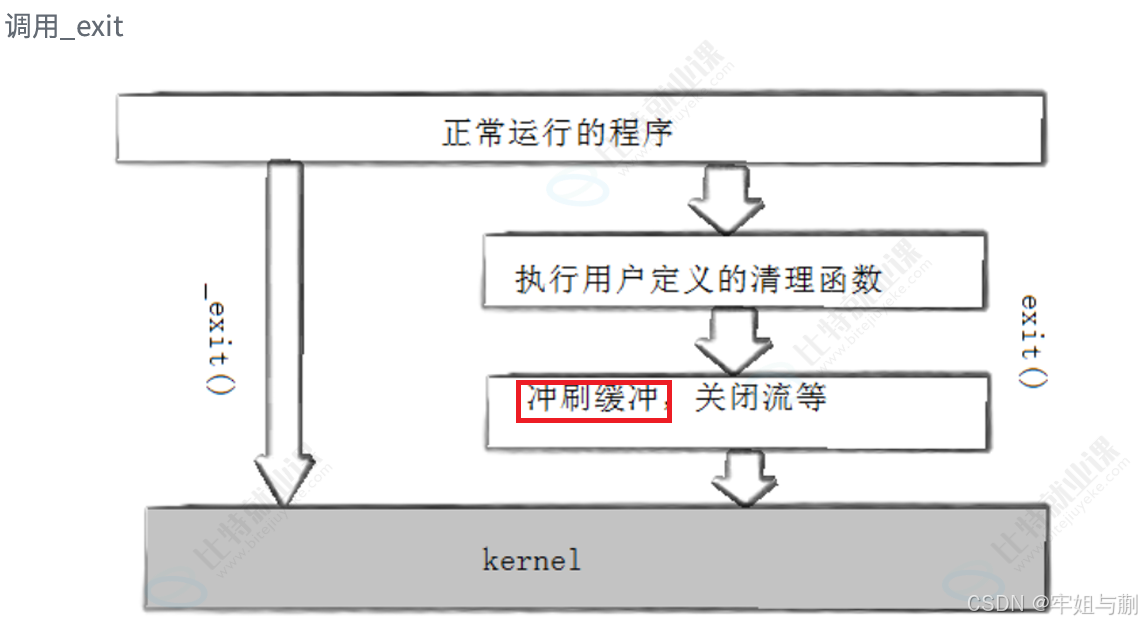
Ⅱ.关于缓冲区
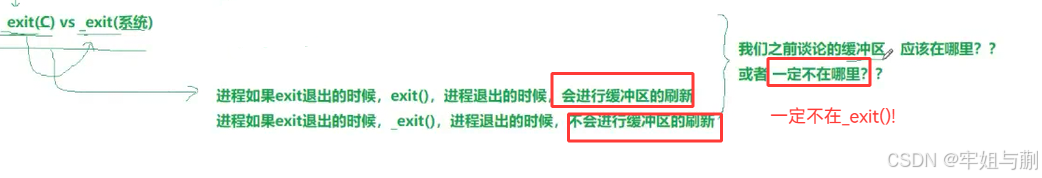
缓冲区是c语言提供的库缓冲区!这里只能轻轻点一下,缓冲区的细节要交给后面的文章。
三.进程等待
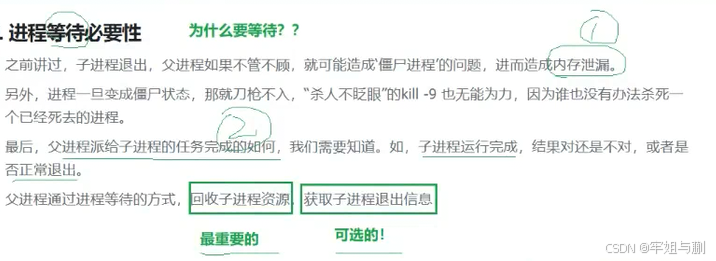
1.为何要等待?
2.什么是进程等待?
进程等待是一种通过接口wait/waitpid(系统调用)的方式,主动阻塞自己(即父进程阻塞在wait()处),等待子进程执行完毕;回收子进程的资源,获取子进程退出信息(状态),避免子进程出现僵尸状态,导致内存泄漏。
3.进程等待的方式
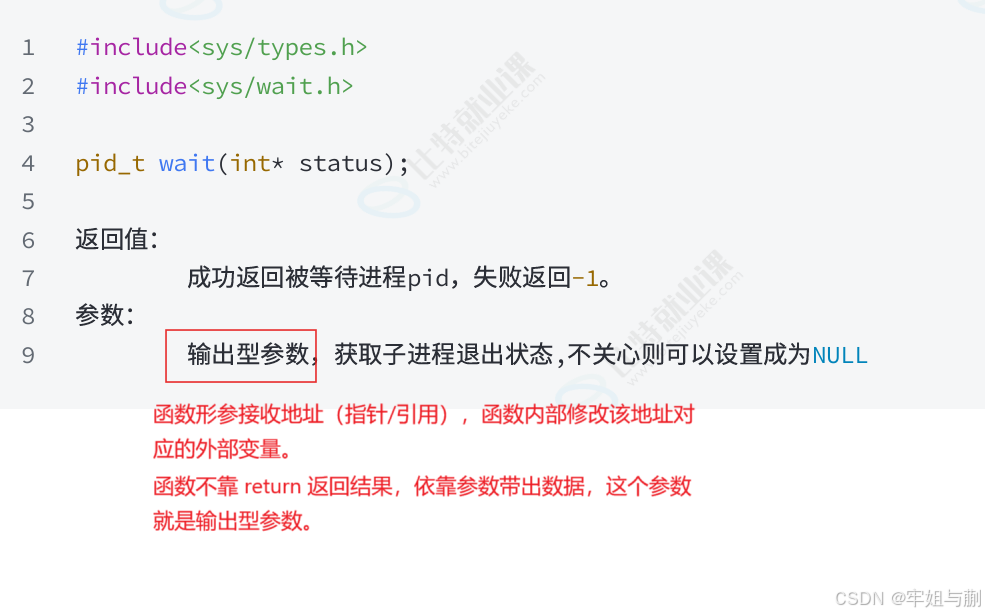
①.wait()
②.waitpid()(更推荐)
想要更多的状态控制,可以选择waitpid(),它拥有更多的形参:
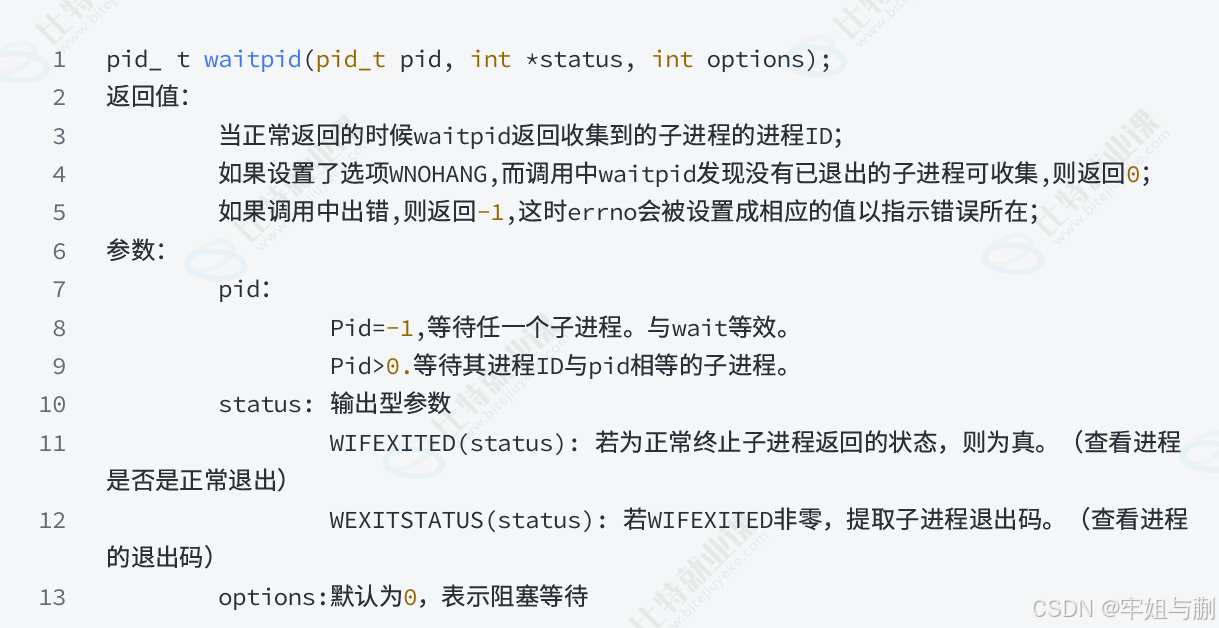
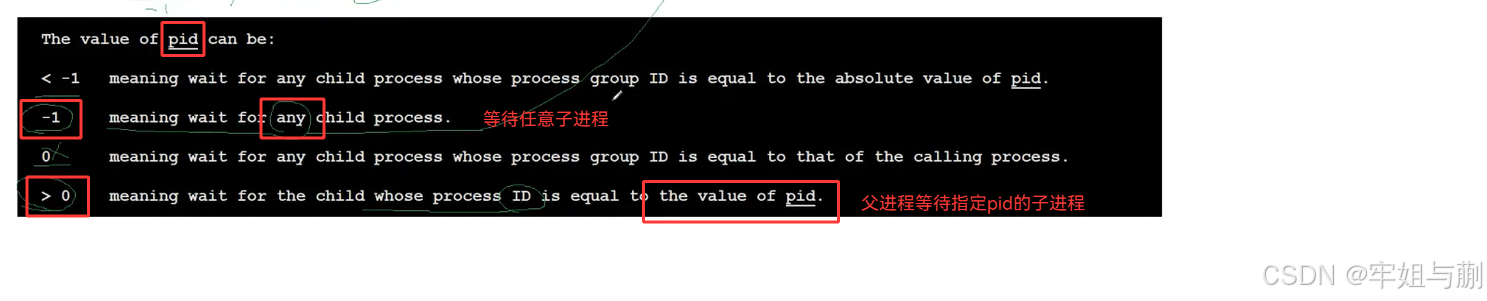
存在形参pid,这就是为什么fork()成功以后,会给父进程返回子进程的pid,父进程可以通过形参pid来选择等待指定的进程。
形参pid值几种情况(只考虑= -1 和 大于0的情况):
③.父进程如何获得子进程退出信息?
Ⅰ.起底status
答案是,父进程通过wait/waitpid里的返回型参数status。这个返回型参数解引用以后的整数,并不是退出码!! 要把这个整数看成一张32位的二进制位图!其中我们研究的是低16比特位,高16位不考虑:
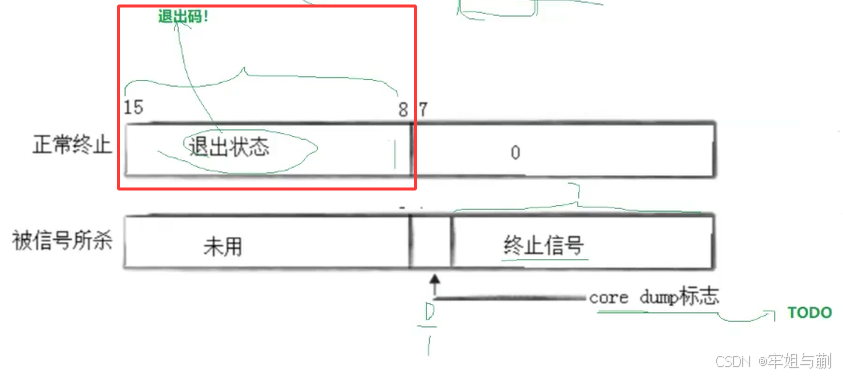
其中第八位到第十五位组成的数才是退出码!
那么父进程要是只想获得退出码,这该怎么做呢?
将退出码的那8位向右移动8位,然后再与0xFF进行按位与操作,提取出这八位二进制退出码:
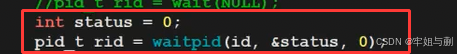

注意:示例的status非此status,真正的status是地址,即&status。
Ⅱ.那么waitpid是如何拿到子进程的退出码(退出信息),并存进status,进而使父进程拿到退出码的呢?
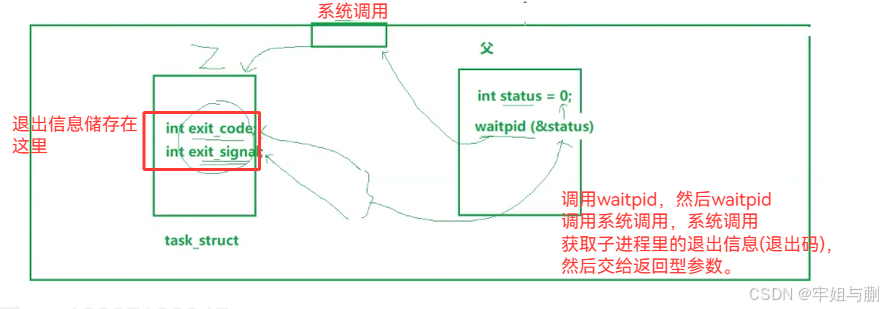
补充一点:系统是如何把退出信息存入status里的呢?
答案是,系统将错误码和信号按照位图规则打包,然后写入status的内存空间中。
4.阻塞调用与非阻塞调用
默认情况下,options的值为0,表示父进程在waitpid()处阻塞等待。这种特性叫做阻塞调用。
如果把options的值设置为WNOHANG时,父进程调用waitpid就变成了非阻塞调用 ,也就是如果子进程不退出,父进程不会阻塞住自己,在waitpid()处等待;而是直接返回。当然,返回了以后,还是会去反复调用waitpid()函数,不停检查子进程有没有退出,直至子进程退出。这个反复调用函数的过程,叫做非阻塞轮询。

非阻塞调用时,waitpid()的返回值也有讲究:
大于0:等待结束,即子进程退出,就不用再非阻塞轮询了。
等于0:waitpid()一次调用结束,即return了,此时子进程没有结束,父进程需要轮询。
小于0:等待失败。
非阻塞调用效率更高,因为可以让等待方做一做自己的事,而不让其完全停下来等待。但常用的还是阻塞调用!