基本上现在要做生物大分子 通用、多任务(通用的狭义定义)的模型,都是用的大语言模型(多模态可以适配多任务),
因为广义上理解只有语言能够统一多种任务描述,
也只有语言模型能够通往AGI,所以语言模型也被用来做各个领域的多任务、通用模型。
比如说,一个模型搞定分子生成、性质预测、分子描述、结构翻译等所有分子任务。
所谓通用,狭义上理解,什么都能做,那就是目前有什么任务,就都拿来做一做、比一比
但是,语言模型要想通用、统一,就需要在多任务上联合学习,这个学习过程有很多需要解决的问题:
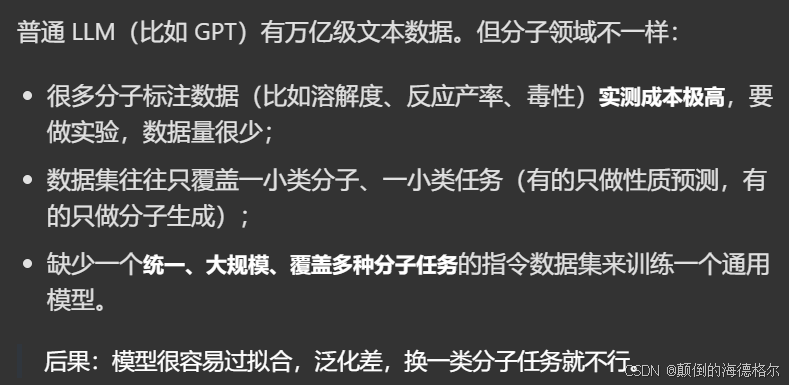
在分子领域,已有大量研究探索利用多模态大语言模型(LLM)构建通用、多任务的分子模型。然而,现有工作距离实现真正的通用分子模型仍有较大差距。我们梳理出该方向存在三大核心挑战:
(1)现有的分子任务数据集通常规模较小,领域覆盖不够全面。
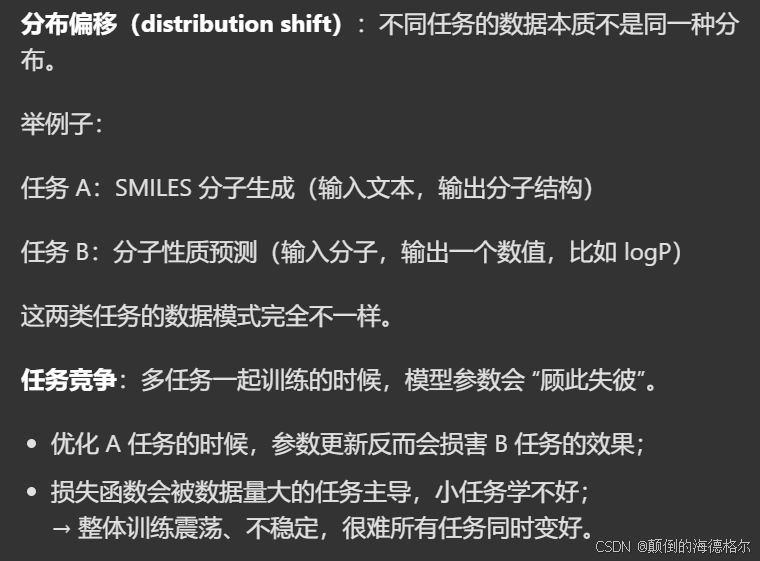
(2)不同分子子领域的任务存在显著分布偏移与任务竞争问题,难以通过大语言模型实现有效的联合学习,造成学习过程不稳定。
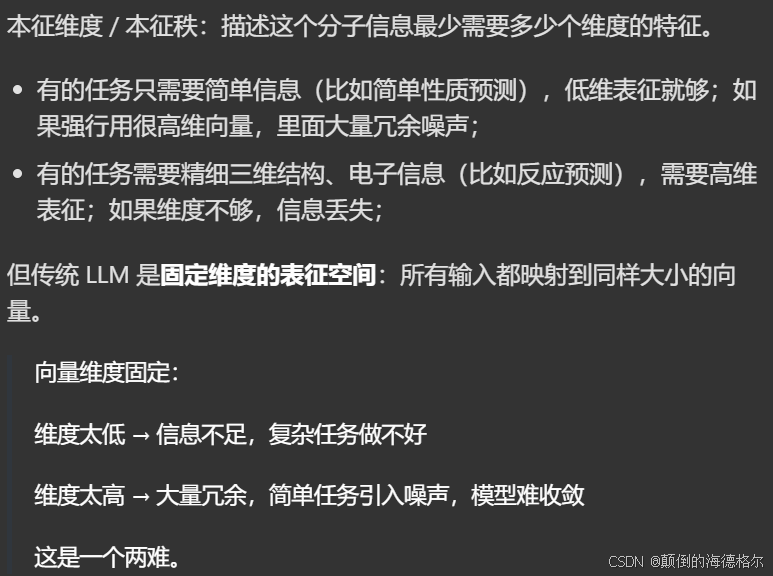
(3)任务间与任务内的分子表征在语言空间需要不同的本征维度,导致语言模型表征难以在冗余性与信息不足之间取得平衡。比如说有的任务,无序预测,只需要低维feature,描述这个任务只需要简单信息、几个低维表征就够了,比如说随便举几个物理化学性质、参数即可,你不需要搞什么ESM-2 256、1280等高的不得了的维度特征来处理这个任务;
但是有的任务,比如说反应途径预测,那就需要非常复杂的维度信息、非常高维来表征描述
"为解决上述挑战,我们创新性地将现有小分子任务划分为四类:Mol2Mol、Mol2Text、Mol2Num、Text2Mol。随后构建了包含16项以上任务、超过140万样本的数据集,是目前规模最大的分子指令微调数据集。依托大语言模型在海量化学文献上完成的预训练基础,本文提出全新多模态大语言模型框架Omni-Mol,统一处理全部小分子任务,同时支持分子生成与分子理解。Omni-Mol的核心是本文提出的MoGE模块,它能够动态适配不同任务的本征秩。该混合专家架构有效提升模型处理各类任务与模态的能力。我们的模型在16项任务上完成统一指令微调,并在其中13项任务上取得当前最优性能。大量实验进一步验证了Omni-Mol具备良好的可扩展性与通用性。"
Omni-Mol 简要解析
Omni-Mol(NeurIPS 2025)是基于共享LLM主干(Llama-3.2-1B-Instruct)的小分子多任务统一模型,主打任意模态间分子任务,用一套模型同时处理16种分子/化学任务。
核心创新
- 多任务指令微调 :构建小分子指令微调数据集;多任务联合训练优于每个任务单独LoRA,看似无关任务(分子描述Molcap、量子性质预测)互相增益。
- MoGE:提出MoGE,结合改进LoRA适配器+MoE扩展层,提升多任务性能,同时让不同任务效果更均衡。
- 统一底座:单共享LLM backbone,覆盖四大类16项化学任务。
16项任务分类
- 分子↔分子:正向反应、试剂预测、逆合成、溶剂/催化剂预测、分子编辑MolEdit
- 分子→数值:量子力学性质、分子量、TPSA、LogP、反应产率预测
- 分子→文本:实验流程、分子问答、分子字幕Molcap
- 文本→分子:IUPAC转SELFIES、文本引导分子设计
工程与版本
- 依赖:Llama3.2-1B-Instruct作为LLM主干,MoleculeSTM提供GNN编码器;使用uv管理环境,DeepSpeed、PyG等。
- 模型权重:V1为论文主结果;V2除产率回归外全部任务效果更强。
- 代码状态:推理代码、数据集已发布;训练代码是预览版,未完整复现验证,可读性差,后续会重构。
- 推理:配置test.sh,支持多GPU批量推理;输出预测json与任务指标json。
论文指出的局限与未来方向
- 评测基准问题
- 分子字幕、分子问答:现有指标靠文本匹配,模型给出正确但和参考文本不一样的答案会被低估;建议改成单选/多选客观评测集。
- 逆合成等反应任务:存在多条可行合成路线,但评测只校验单一条路线;建议用正向预测模型做结果验证器。
- 训练数据:现有数据集只有输入+最终答案,缺少中间推理步骤;计划用大模型拒绝采样蒸馏推理链,后续可做RLVR强化学习。
- 多轮分子对话:基于同一分子构建多轮对话数据,进一步提升模型对分子的深度理解。
现在回过头来前面的3个问题怎么解决
- 第1个问题是数据的问题
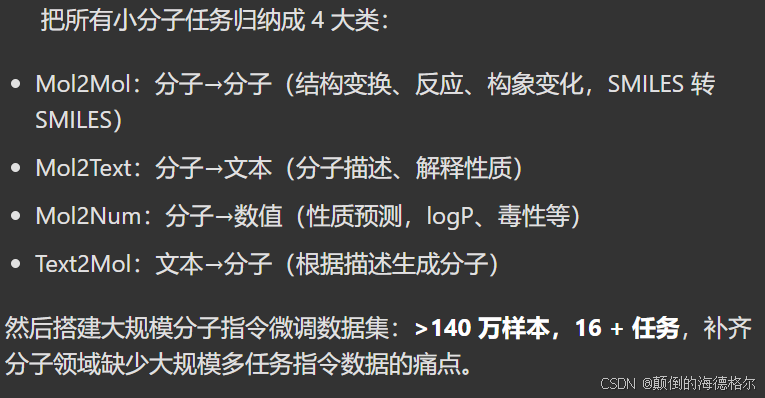
这里我粗浅的理解是数据集本来就小,是不是把零散小任务归类,然后数据集分到4大类的话,可以避免单个任务样本太少?
当然,基本方向上应该是理解没问题的,但是这还没有理解到本质点子上,重点其实不在于将数据集合并拆分为4类,拆分成更少的3类、2类也不是我们应该学习的点;
更本质的其实是统一任务的输入输出格式,最小统一只能统一到4类输入输出格式,那么就再拆分不了了。
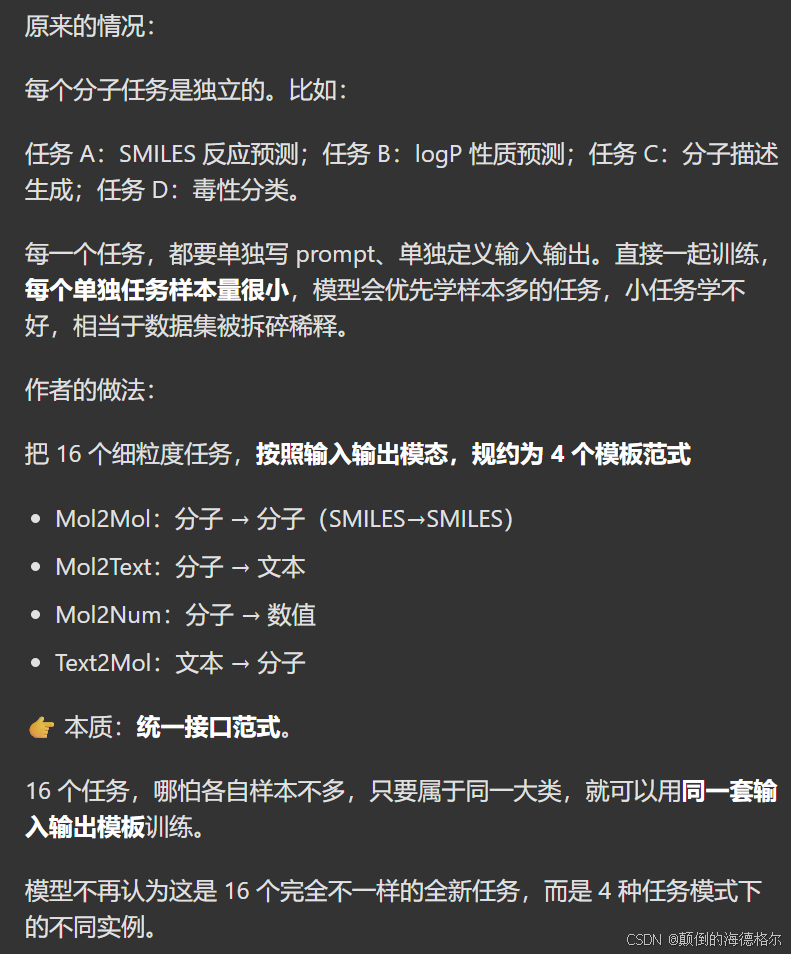
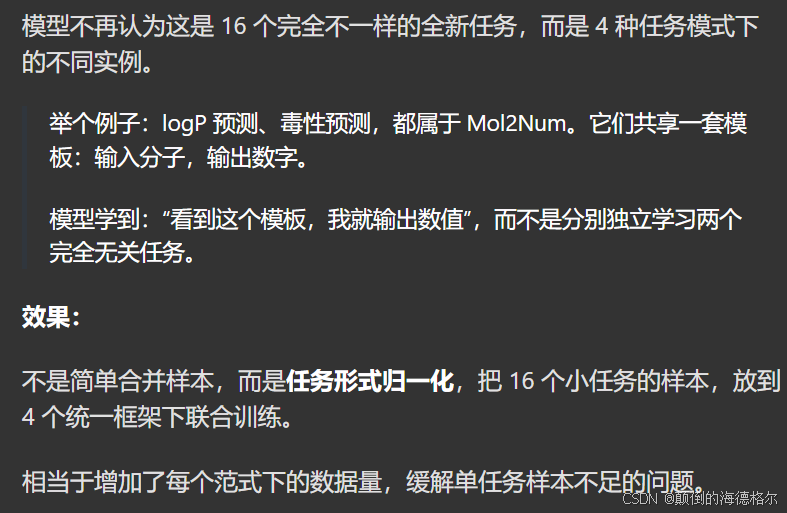
不是数据集路由到 4 类;是任务的输入输出范式被统一成 4 类,所有样本都套入这 4 种模板,降低每个子任务的学习难度
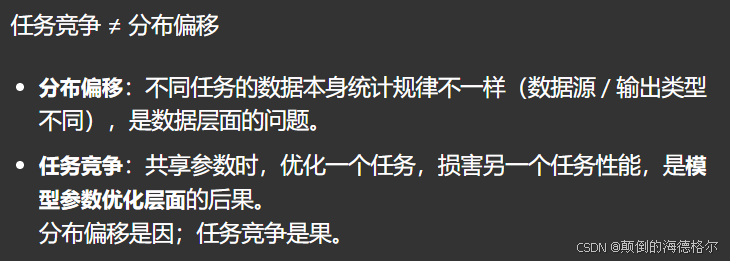
- 第2个问题是任务竞争、分布偏移的问题
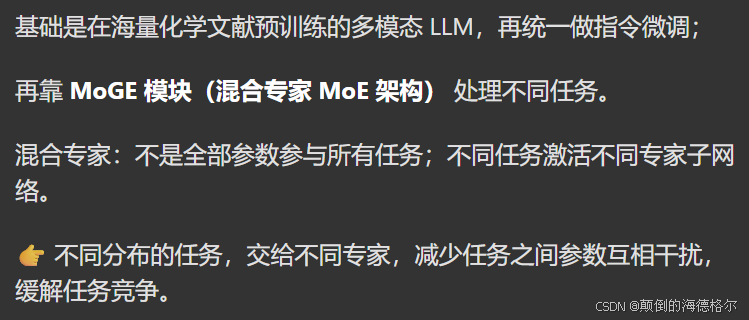
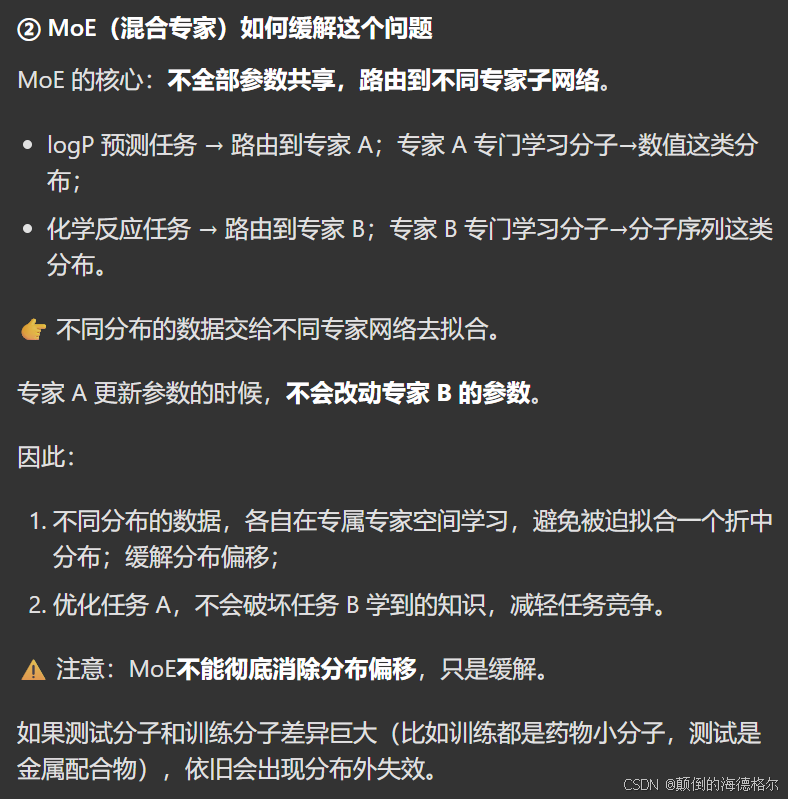
这种多任务的,基本上都是走MOE混合专家架构,就是全部参数不是参与所有任务,什么任务激活网络中的什么专家子网,然后更新什么参数。
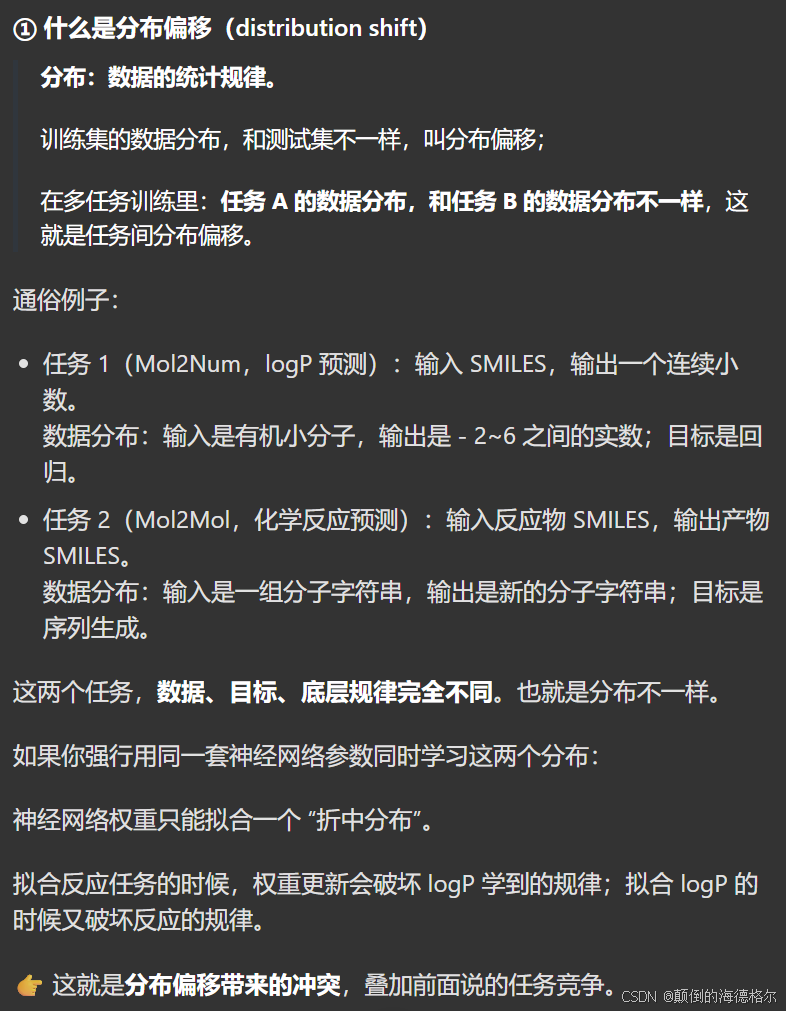
分布偏移是因,任务竞争是果;
就是因为不同需要学习的数据统计规律不一致,所以不能一刀切参数,那么用同一套神经网络参数同时学习这两种规律的时候,就是同时学习这两个分布的时候,网络只能拟合到一个折中分布,就会产生竞争
- 第3个任务,不同任务表征本征维度不匹配,任然需要动态匹配
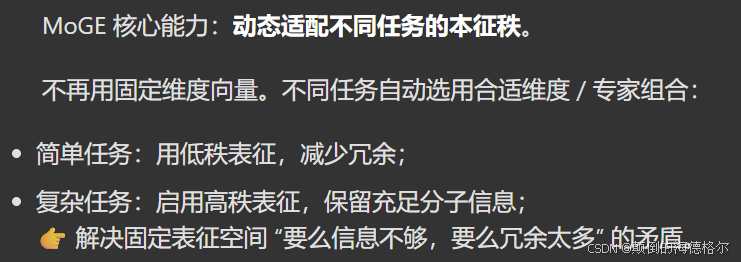
一个粗糙的想法就是,不同的任务使用固定的独立向量长度,比如说任务a就用128维的embedding,任务b用12维等等。
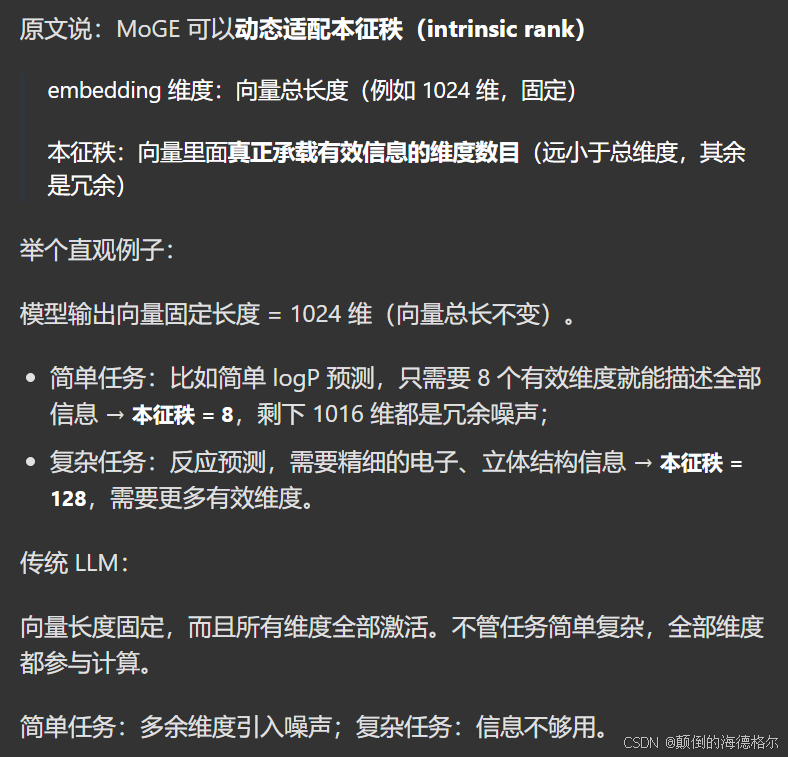
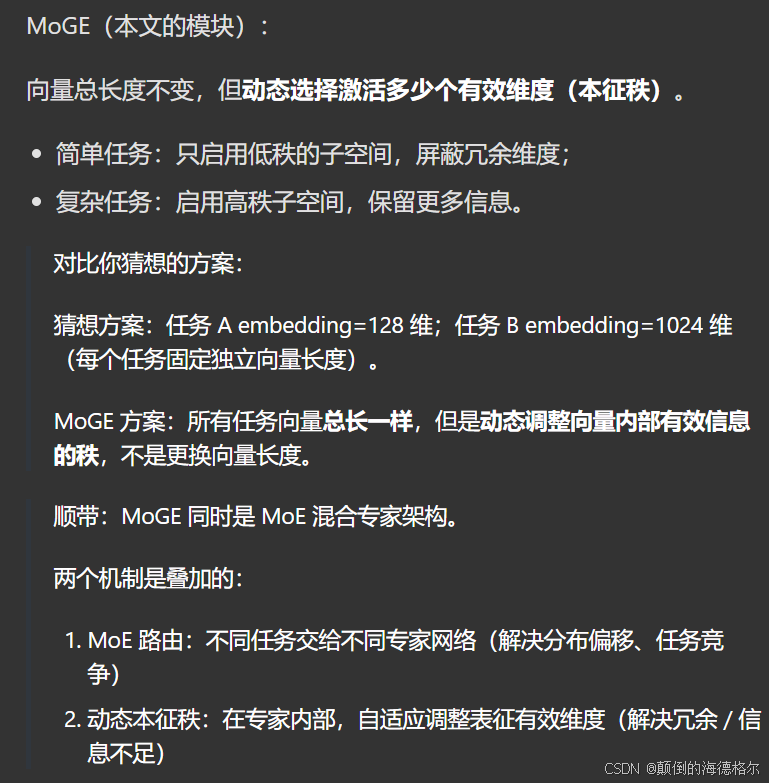
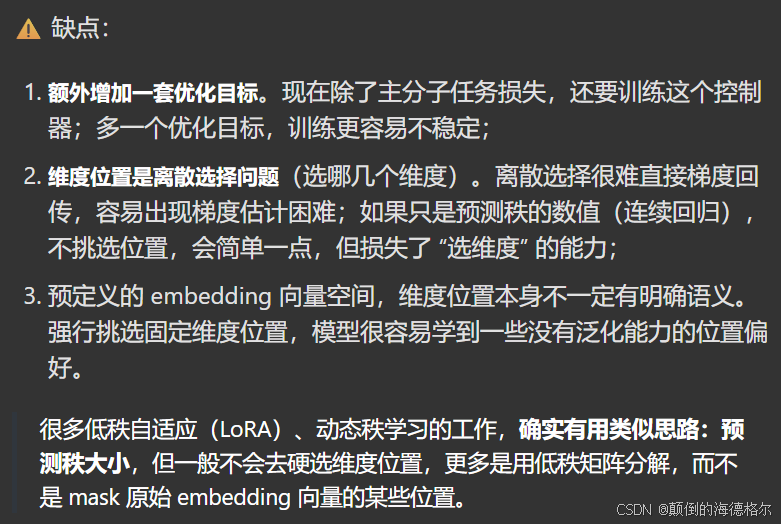
也可以有另外一种想法,就是语言model embedding输入的维度统一,在内部再采样挑选哪些维度。
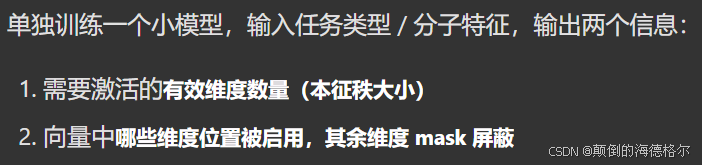
粗浅的平替实现,我们可以再单独训练1个小模型,用来预测每个任务单独路由需要激活哪些维度,
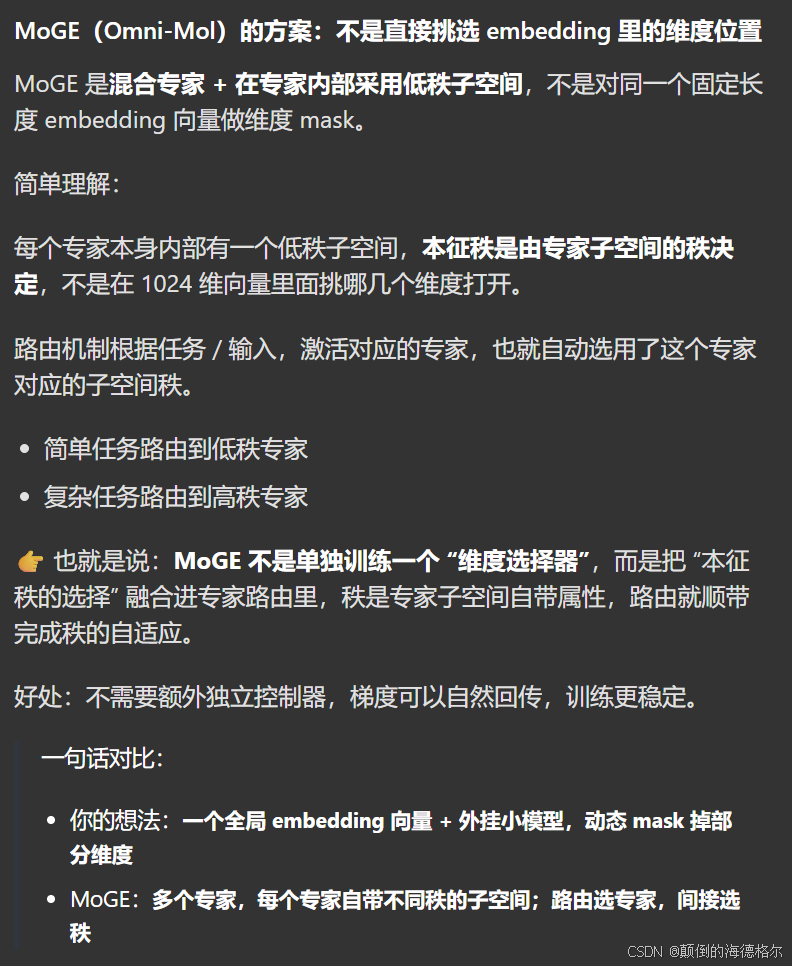
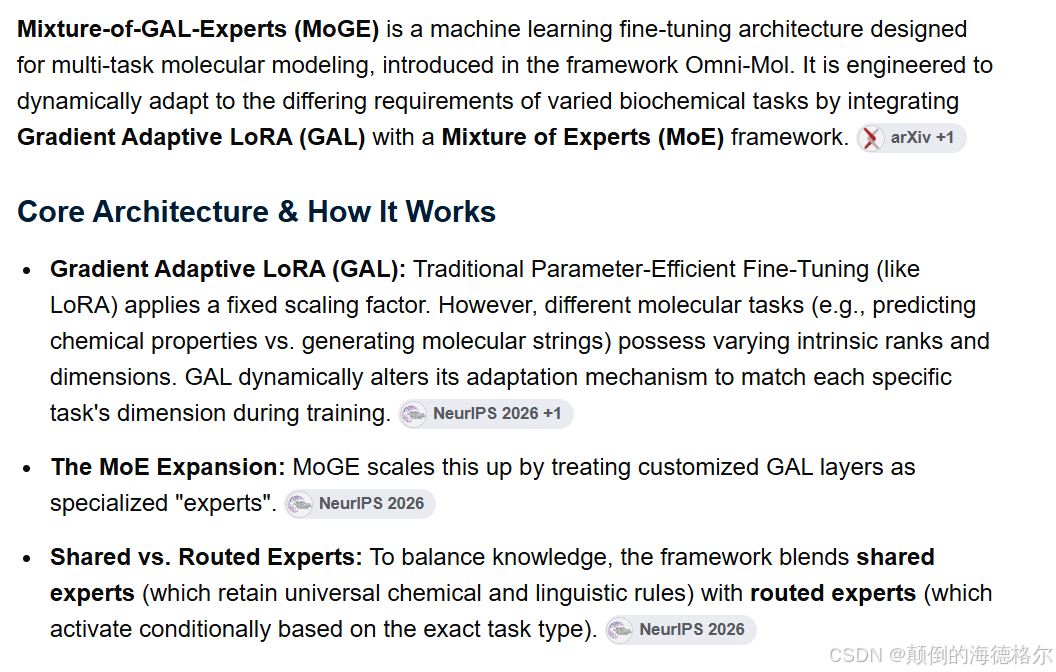
MoGE = Mixture-of-GAL-Experts
GAL,Gradient Adaptive LoRA
总结:
Omni-Mol 是化学领域多任务通用大模型,用MoGE+多任务指令微调,依托LLM+GNN,把反应、性质、分子生成、文本描述等16个化学任务放到同一个模型里完成,是分子大模型往通用化学智能方向的尝试。