Meta 在 Muse Glimmer 的模型卡里写得很自信:用 4-bit 动态量化(K-Quant),把约 300 亿参数的模型塞进 17--20 GB,放进 24--32 GB 的消费级显卡,它对 Agent 任务几乎没有性能损失。
但 2026 年 7 月 29 日挂在 arXiv 上的一篇论文给出了一个很不体面的结果:把同样的模型量化到 4-bit,Agent 每一步的失败率最高翻到 2.5 倍,而 benchmark 总分纹丝不动。
两边都没说谎。差别在于,一个测的是"最后做成了几题",另一个看的是"中间错了几次"。
一、先把账算清楚:一张 24 GB 显卡里到底住了谁
不要在显存这个问题上凭感觉。把每个居民逐个点名:
| 居民 | 是否随上下文增长 | 30B 稠密模型的典型开销 |
|---|---|---|
| 模型权重 | 否 | FP16/BF16 约 55 GB+ ;4-bit 量化后约 17--20 GB |
| KV 缓存 | 是,线性增长 | 随上下文长度 × 层数 × KV 头数变化(下文算) |
| 视觉编码器 | 否 | Muse Glimmer 的感知编码器约 1.8 B 参数 |
| 投机解码草稿模型 | 否 | DFlash drafter(数百 MB 量级) |
| 激活值与推理框架开销 | 部分随批大小变化 | 通常 1--2 GB 的余量必须留 |
关键点:权重只是入场券。 把 55 GB 压到 20 GB 之后,24 GB 卡上只剩约 4 GB 给其余全部------而这 4 GB 要同时招待一个随上下文线性增长的 KV 缓存、一个 1.8B 的视觉编码器和一个草稿模型。这就是为什么 Meta 强调要在 24--32 GB 的"封套"(envelope)里跑,而不是"我们需要 20 GB"。
KV 缓存的公式,和你为什么会算错
ini
KV_bytes = 2 × L × N_kv × d_head × S × bytes_per_elem
              │     │       │        │
              │     │       │        └─ 上下文长度(token)
              │     │       └────────── 每个 KV 头的维度
              │     └────────────────── KV 头数(不是 Query 头数!)
              └──────────────────────── 层数
注意那个 N_kv。决定 KV 缓存大小的是 KV 头数,不是 Query 头数。 这正是分组查询注意力(GQA, Grouped-Query Attention)存在的唯一理由。
Muse Glimmer 公开的架构参数是:52 层、隐藏维度 6656、32 个 Query 头、2 个 KV 头(16:1 的 GQA 压缩比)、原生上下文 131,072 token。按这组参数估算(本文估算,非官方数据):
| 注意力排布 | 单层 KV 缓存 (FP16) | 131K 上下文总占用 |
|---|---|---|
| 假设全部 52 层都是全局注意力 | 约 665 KB/千 token | 约 11.3 GB |
| 实际:39 层滑动窗口(2048)+ 13 层全局 | --- | 约 2.8--3.0 GB |
| 再叠 4-bit KV 缓存 | --- | 约 0.7--0.8 GB |
差别来自两处:2 个 KV 头(相比 MHA 的 32 个直接砍到 1/16) ,以及那套 [局部, 局部, 局部, 全局] 循环 13 次的混合注意力------只有 13 层需要保留完整 KV,其余 39 层永远只保留 2048 token 的窗口,那部分长上下文下是常数大小。
一句话点破:所谓"端侧长上下文 Agent",从来不是靠硬堆显存实现的,而是靠"让大多数层根本不看远处" + "让看远处的那些层共享极少的 KV 头"这两刀切出来的。
顺带回答:为什么是 Dense 而不是 MoE
2026 年的开源模型几乎清一色 MoE(Mixture-of-Experts,混合专家)。Muse Glimmer 反其道选择了全稠密。理由值得记下来:
- MoE 的路由方差会沿着任务轨迹累积。几十次工具调用、数万 token 的上下文维持里,每次专家选择的微小偏移最后会表现为行为不一致。
- Dense 消除了 router 的不确定性,延迟可预测、长程连贯性好。
- 代价是单 token 的内存压力全部由参数量承担,只能靠量化和投机解码补。
这不是架构品味之争,是优化目标不同:对话模型追求首 token 延迟和性价比,Agent 模型追求的是长程一致性和故障恢复。
二、先蒸馏,再量化:把能力搬进预算内的正确顺序
Muse Glimmer 不是从零训的,它是从 Meta 闭源旗舰 Muse Spark 蒸馏出来的,三阶段:
vbnet
① 对数蒸馏(Logit Distillation)
   用匹配的预训练数据混合,把基础推理能力从 Spark 搬过来
        ↓
② 中期训练(Mid-Training)
   在长上下文序列上放大:复杂推理轨迹、图文交错、多步工具调用轨迹
        ↓
③ 后训练对齐
   SFT + on-policy 蒸馏 + RL 的混合,覆盖代码 / 工具使用 / 结构化规划
同一周开源的 MiniCPM5-2B 在这条路的最难处也给出了可复现的答案。给只有 2B 参数的模型做长思维链强化学习,最常见的问题是训练中分数不升反降------数据噪声大、难度不匹配导致奖励信号把模型带偏,加上 GRPO 的信用分配太粗糙,面对上万 token 的推理链分不清哪一步错。面壁的解法叫 JustRL II:
- 数据上:三阶段流水线------可验证性过滤、奖励可信性校验、难度匹配
- 算法上 :给 GRPO 装上 Critic,做词元级(token-level)信用分配
配套开源的 Meshy 框架干脆把 RL 训练的中央控制器和 Ray 依赖整个丢掉,把训练、推理、奖励计算全部建模成对等服务,用 TransferQueue 里的数据就绪状态驱动控制流,可以在同步/异步/全异步三种模式间切换。
所以"把强模型搬进小设备"这件事的技术栈已经公开了:不是先训一个大模型再狠命压,而是先在云端把能力蒸馏进目标尺寸,再谈量化。
三、"几乎无损"这句话从哪来,以及它原本的适用范围
先给量化一个公道。这轮描述是真有大量证据支持的:
| 结论 | 来源 |
|---|---|
| FP8 权重+激活量化事实上无损 | arXiv:2411.02355 |
| 调优良好的 INT8 平均精度损失 1--3% | arXiv:2411.02355 |
| Q5_K_M / Q8_0 等格式恢复 FP16 基线的 95--99%(MMLU、GSM8K 级别任务) | arXiv:2601.14277 |
| GPTQ-INT8 与 Q5_K_M 在多款开源模型上保持 BF16 的 95--99% | Ionio 模型优化平台基准 |
这些研究有一个共同点:评测对象几乎全是单轮任务------给一段输入,算一个答案,比一次对错。
这在物理上说得通。量化给 logits 加的是近似零均值的噪声 ,所以只有那些决策裕度很薄(thin margin)的 token 才会翻转。在一段连续的自然语言里,个别 token 翻错了,语义通常还能自愈;在多选题里,只要被选中的那个 option 的字母没翻错,分数就不受影响。
这就是那句 "logit-margin 解释":量化不创造新错误,它只放大旧错误在薄裕度处的概率。
问题在于,Agent 不一样。
四、理想丰满,现实骨感:错误预算是怎么把损伤吃掉藏起来的
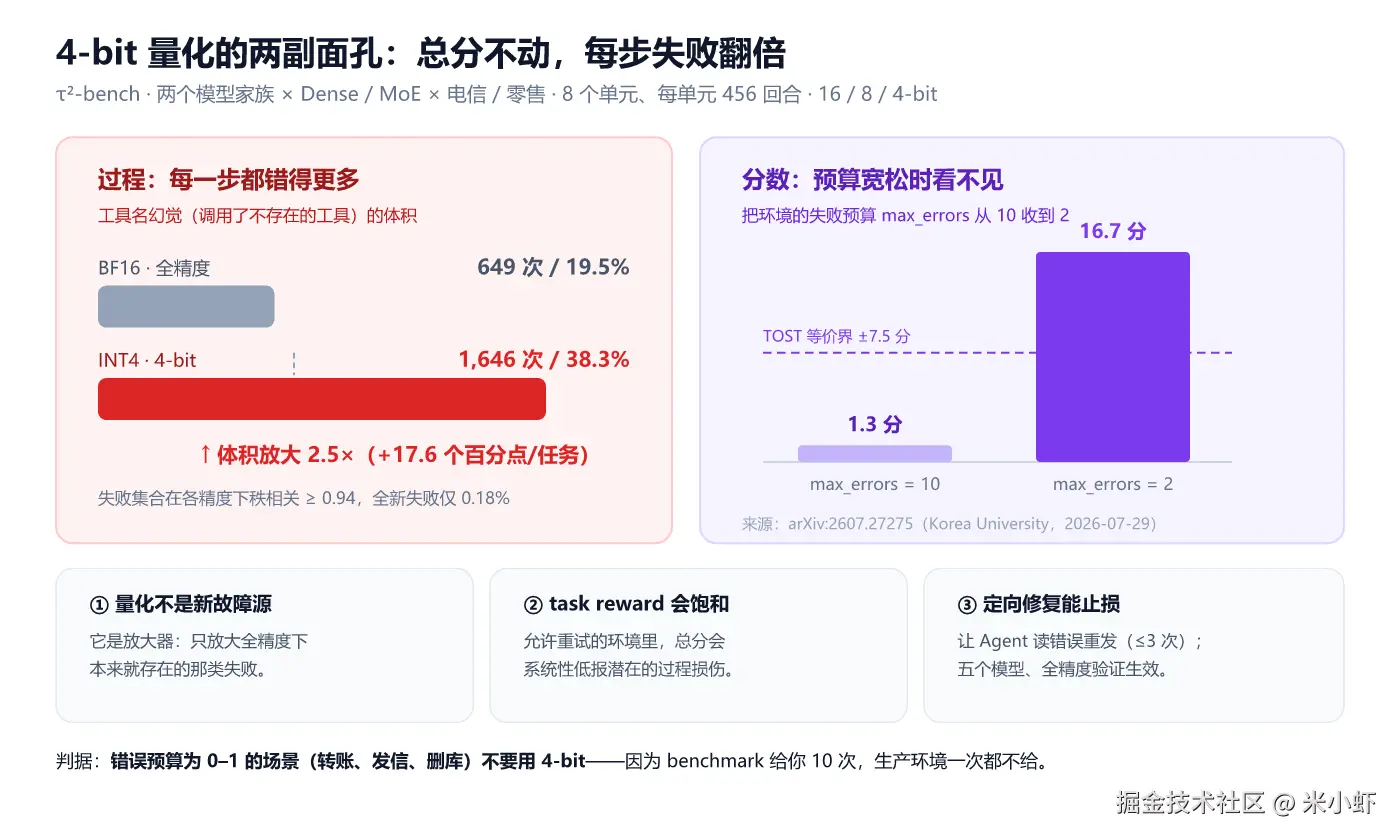
韩国大学团队 2026 年 7 月 29 日挂在 arXiv 的这篇论文标题起得极准------《Flat Score, Amplified Failures: How the Error Budget Masks Damage in Quantized LLM Agents》(arXiv:2607.27275)。
实验设计 :τ²-bench 多轮工具调用基准(带模拟用户),两个开源模型家族 × Dense 与 MoE 变体 × 电信与零售两个领域,8 个单元、每单元 456 个回合,分别在 16-bit、8-bit、4-bit 权重下跑。
结果一:总分看不见
在全部 8 个单元里,没有一个单元的分数变化通过多重比较校正 。在过程损伤最重的那个单元做等价性检验(TOST),把变化界定在 ±7.5 分以内。作者还估了运行间噪声地板------同一个 456 回合的重跑会让均值漂移约 1.5 分。
换句话说:按常规口径,4-bit 确实"几乎没有损失"。
结果二:过程惨不忍睹
作者没有停在总分,而是把每一次工具调用及其返回值全 log 下来,按"通道"拆:
| 指标 | BF16(全精度) | INT4(4-bit) | 变化 |
|---|---|---|---|
| 越界工具调用次数(单单元) | 649 次 | 1,646 次 | 2.5× |
| 占自身工具调用比例 | 19.5% | 38.3% | +18.8 个百分点 |
| 每任务工具名幻觉率 | 基线 | +17.6 个百分点 | 最高到 2.5× 放大 |
| 失败集合秩相关(精度间) | --- | ≥ 0.94 | 几乎同一个集合 |
| 全新(全精度从未出现)的失败事件 | --- | 0.18% | 基本没有新类型 |
这个表格最扎心的两行是最后两行:量化没有让模型学会新的错误,它只是把已有的错误(工具名幻觉)重复得更多了。 这与 logit-margin 解释完全吻合------薄裕度的决策来来回回就是那几个工具名。
结果三:掩盖机制------把预算从 10 收到 2
τ²-bench 每个回合允许 10 次失败的工具调用才扣任务分。多出来的失败稳稳地塞进了这个预算里。
作者把 max_errors 当旋钮拨了一下,重新计算"只用不超过 K 次失败调用就成功"的存活率:
markdown
错误预算 K       BF16 与 INT4 的分数差
    10               约 1.3 分   ← 常规口径,看不见
     2               约 16.7 分  ← 真相浮出水面
16.7 分的差距,而且只出现在那个量化确实增加了错误量的单元里------这正是"掩盖"假说的精确预测。如果你接受这个假说,那么"总分没变"这件事,恰恰成了支持假说的最强证据。
五、五个工程死结
死结 1:benchmark 的失败预算是 10 次,你的生产环境是 0 次
这是最致命的一条。做一道信用社的转账、发一封属于别人的邮件、执行一条 DROP 语句------这些操作不存在"重试 10 次"的预算。凡涉及不可逆动作、高成本动作、有副作用动作的 Agent,"看着平稳的总分"给你的安全感是假的。
判据:你的 Agent 每步失败的环境容忍度,决定了你能否信任 vendor 的量化报告。
死结 2:薄裕度决策在 JSON / schema 上高度集中
工具调用的参数是一个结构刚性极强 的输出:字段名必须是枚举里的某个字符串、类型必须是 number 不能是 string、嵌套层级必须闭合。这些位置恰恰是 logit 裕度最薄的地方------模型不是"不知道该调哪个工具",而是"在 user_id 和 customer_id 之间犹豫"。
自然语言里的 token 翻错可以自愈,一个 JSON 字段名翻错就是一次工具不存在。这就是为什么 +17.6 个百分点的损伤全部落在"工具名幻觉"这一个通道上。
死结 3:会恢复的 Agent 把过程损伤换算成延迟和钱
Muse Glimmer 卖点之一就是"失败恢复"------工具调用出错时它会自动诊断并重试。这当然是好事,但要算清楚账:每一次被吸收的失败都是一次完整的多轮推理 。若某环节固有失败率从 19.5% 涨到 38.3%,一个 20 步的任务里期望重试次数将近翻倍。你没有在分数上看到它,你会在时延和 token 账单上看到它。
死结 4:量化"配方"本身是未被控制的混淆变量
论文自己承认:两个模型家族用的 4-bit 配方(分组方式、缩放策略不同)并没做等价性对照。这意味着你从"A 模型的 4-bit 很稳"推不出"B 模型的 4-bit 也稳"------同一个 lint 名字底下,K-Quant、AWQ、GPTQ、bitsandbytes 的行为差异可能比 bit 数本身的差异更大。任何外推都必须自己重测。
死结 5:扩展律在这里帮不上忙
量化方案的支持者通常在 MMLU 或 GSM8K 上证明自己的做法是 lossless,厂商再把这张证书迁移到 Agent 场景。但这两类任务之间不存在可靠的保真度传递。
一个在 GSM8K 上保持 99% 的 4-bit 模型,它在 τ²-bench 上的每步失败率可能已经翻倍。前者是几百道题的平均准确率,后者是几十步 × 几百个 episode 的过程可靠性------这两个数字之间没有任何换算公式,只能各自独立测量。
六、解法:一套能落地的验证清单
论文给出的解法本身很朴素,而且便宜得惊人。
处方 1:预量化风险筛查(最省钱的那一招)
量化本质是放大器。所以全精度下目标领域的失败倾向,就是 4-bit 的风险指示计:
arduino
全精度下,该领域固有失败率 ≈ 0      →  4-bit 大概率安全
全精度下,该领域固有失败率偏高       →  4-bit 会把这个斜坡放大 2.5×
在你花时间做 QAT 或者纠结 K-Quant 参数之前,先在 BF16 下跑一遍目标领域的失败通道统计。这一步只需要一轮推理,但它是整个决策里信息量最大的一次测量。基线本身就是最好的预报器。
处方 2:把度量从 task reward 换成 per-channel error rate
别只看"任务做完了没有"。对每一次工具调用打标签,拆成通道:
- 工具名幻觉(调了一个不存在的函数名)
- 实体/参数错(调用合法但 ID/参数找不到对应记录)
- 格式错误(JSON 解析失败、schema 不匹配)
- 规划偏离(调用合法但偏离目标,这个最难自动识别)
论文说得很直接:这两个诊断来自 benchmark 本来就在收集的日志,成本几乎为零。
处方 3:画一条 shrinking-budget 曲线
这是我认为最值得引入到团队 CI 里的做法:
ini
max_errors = 1   →  成功率 S(1)
max_errors = 2   →  成功率 S(2)
max_errors = 5   →  成功率 S(5)
max_errors = 10  →  成功率 S(10)   ← 常规口径
把这条曲线和全精度基线并排画出来。 如果两条曲线在高预算区重合而在低预算区分叉,你手上就是一个典型的"被掩盖的过程损伤"。per-task reward 看不到它,但你的 SLA 会。
处方 4:定向错误修复提示(targeted repair prompt)
这是论文里最有工程价值的一条。既然失败集合在各精度下几乎相同 (秩相关 ≥ 0.94,仅 0.18% 新事件),那么那个"模型已经会幻觉的工具名列表"就是一个可枚举的小集合。作者加了一个自反式修复:工具调用失败时,让 Agent 读错误信息、诊断并重发,最多三次。
结果:在五个电信领域的模型、所有精度下,这个提示精确地把损伤抹掉了------而且只在损伤存在的那个地方生效。 不需要通用鲁棒性,只需要针对已知通道做约束。
处方 5:精度选型建议
| 场景 | 建议 | 理由 |
|---|---|---|
| 不可逆动作(转账、发邮件、删资源) | FP8 或 BF16,不要 4-bit | 这类场景的真实错误预算是 0--1 |
| 多步工具编排、长程任务 | 优先 INT8 ;4-bit 需配处方 4 的定向修复 + 必跑预算曲线 | 步数会复合放大单步失败率 |
| 有收益的自愈回路(自动重试) | 4-bit 可用,但预算已进入时延与 token 成本 | 死结 3 |
| 单次问答、摘要、改写 | 4-bit 基本安全 | 单轮,无累积 |
| 纯代码生成 | 4-bit 通常可接受 | 输出有编译器/测试当验收器 |
七、一个反直觉但更划算的顺序:先蒸馏,别先压(本文观点)
如果你的约束是"这张 24 GB 的卡",大多数人第一反应是:拉一个 30B,量化到 4-bit,塞进去。
但本周 MiniCPM5-2B 给出的数据指向另一个答案。同样完成一个任务:
MiniCPM5-2B        2B 参数    约 21k token(14k 思考 + 7k 答案)    智能分 23
Qwen3.5 9B         9B 参数    约 34k token                        智能分 22
Granite 4.2 3B     3B 参数    约 19k token(12k 思考 + 7k 答案)   智能分 14
LFM2.5-2.6B        2.6B 参数  约 21k token(14k 思考 + 7k 答案)   智能分 11
每 token 换来的任务完成度,是一个可以被数据治理和 RL 直接改变的量------而 quantization 只改变字节数,不改变 token 效率。
所以决策树长这样:
arduino
你的硬约束是什么?
│
├─ 显存紧张 → 先问:目标任务的固有失败率高不高?
│              │
│              ├─ 高(工具调用/不可逆动作)→ 换更小的模型 + 更高精度
│              │      └─ 优先 FP8/INT8,别硬压 4-bit
│              └─ 低(摘要/改写/翻译)→ 4-bit 直接上,省下的显存给上下文
│
├─ 延迟紧张 → 投机解码优先于降精度
│              DFlash 在 RTX 5090 上 3.1×,M5 Max 1.8×,M4 Max 1.5×
│              (草稿模型本身也占显存,注意和 KV 缓存抢空间)
│
└─ 都不紧张 → BF16/FP16 打底,把预算留给更长上下文与更多重试
顺手记一个容易被忽略的参数:MiniCPM5-2B 官方推荐采样是 temperature=1.0、top_p=0.95 ------相当高的温度。而 logit-margin 解释告诉我们,温度越高,有效决策裕度越薄,量化噪声越容易翻转。如果你打算同时开高温和 4-bit,处方 3 的预算曲线是非跑不可的。
八、我的判断
这不是"量化不好",而是"量化的质保范围本来就只覆盖单轮输出质量,不覆盖多轮过程可靠性"。
三点结论:
- 厂商说的"几乎无损"大概率是真的,只是 scope 需要你自己划。 问题不在厂商撒谎,在于我们拿一个为单轮任务定义的质量声明,去给多轮系统做风险决策。
- 过程度量应该成为 Agent 评测的一等公民。 task reward 在允许重试的环境里是一个饱和指标------它会系统性低报潜在损伤。期待 τ²-bench 这类 benchmark 开始把"错误预算曲线"和 per-channel error rate 跟 task reward 并列报告。
- 端侧 Agent 的真正瓶颈不在算法,而在"现在的预算里能跑多少步"。 GQA + 滑动窗口解决的是显存,DFlash 解决的是延迟,蒸馏解决的是能力密度。三者都不涉及 bit 数------4-bit 是最后一道工序,不是第一步。
下一个值得盯的信号很简单:看有没有 Agent 框架开始默认输出 per-step failure rate。 那个指标一旦出现在常规日志里,"几乎无损"这句话就会被重新定义。
参考
- 核心论文:Flat Score, Amplified Failures: How the Error Budget Masks Damage in Quantized LLM Agents(韩国大学,arXiv:2607.27275,2026-07-29)
- 量化基线证据:arXiv:2411.02355(FP8 无损、INT8 1--3% 损失、INT4 权重-only 有竞争力);arXiv:2601.14277(Q5_K_M / Q8_0 恢复 95--99%);Ionio 模型优化平台基准
- 模型与部署:Meta Muse Glimmer 30B(Apache 2.0,Hugging Face 模型卡;52 层 / 6656 隐藏维 / 32 Query 头 : 2 KV 头 / 局部×3, 全局 循环 13 次 / 2048 滑动窗口 / 1.8B 感知编码器 / 131,072 上下文 / 4-bit K-Quant 后 17--20 GB / DFlash 投机解码 RTX 5090 3.1×);面壁智能 MiniCPM5-2B 与 OpenBMB(GitHub: OpenBMB/MiniCPM、OpenBMB/Meshy;JustRL II 技术博客)
- 评测:τ²-bench(多轮工具调用基准,每回合允许 10 次失败工具调用);Artificial Analysis Intelligence Index(v4.11,综合 9 项评测)、Agentic Index、GDPval-AA v2
说明:文中按公开架构参数估算的 KV 缓存占用(2.8--3.0 GB @131K、同尺度全全局注意力约 11.3 GB)为本文计算值,非官方数据;Muse Glimmer 的 MCP Atlas 75.5、SWE-Bench Verified 76.0 等基准分数来自 Meta 公布与第三方转述,不同来源口径可能存在差异。