从零搭建一个简易 AI 运维问答机器人(RAG + LangChain + Streamlit)
> 本文记录如何基于 RAG(检索增强生成)架构,搭建一个面向运维场景的简易 AI 问答机器人。核心栈:LangChain + Chroma 向量库 + 阿里云 DashScope(通义千问)+ Streamlit。
一、项目概述
1.1 为什么做这个项目?
通用大模型在垂直领域(如运维)存在明显短板:
- 知识不实时:模型训练数据有截止日期,不懂公司内部的运维规范,例如: Jenkins 上线流程,新员工入职运维守则不熟悉;
- 幻觉问题:遇到具体故障时可能"一本正经地胡说八道"
- 数据安全:内部运维手册不能传到公网模型
RAG(检索增强生成) 是解决这些问题的最佳入门方案:将内部运维文档向量化存入本地向量库,用户提问时先检索相关资料,再让模型基于"参考资料"回答。
1.2 核心功能
- 📚 知识库管理:通过 Web 页面上传 TXT /PDF等多种格式的运维文档,操作手册,自动去重、分割、向量化入库
- 💬 智能问答:基于本地知识库回答运维问题,支持多轮对话记忆
- 🔄 流式输出:AI 回答逐字显示,体验接近 ChatGPT
- 💾 长期记忆:对话历史持久化到本地 JSON 文件,重启不丢失
二、技术架构
┌─────────────────┐ ┌─────────────────┐ │ Streamlit 网页 │ │ Streamlit 网页 │ │ app_file_upload │ │ app_qa.py │ │ (上传文档) │ │ (问答对话) │ └────────┬────────┘ └────────┬────────┘ │ │ ▼ ▼ ┌─────────────────┐ ┌─────────────────┐ │KnowledgeBaseService│ │ RagService │ │ 文本分割 + 入库 │ │ 检索 → Prompt → LLM └────────┬────────┘ └────────┬────────┘ │ │ ▼ ▼ ┌─────────────────────────────────────┐ │ Chroma 向量数据库 │ │ (离线:add_texts / 在线:search) │ └─────────────────────────────────────┘
plain
技术选型:
| 模块 | 技术 | 说明 |
|---|---|---|
| 大模型 | 通义千问 qwen3-max | 通过 DashScope 调用 |
| 向量模型 | text-embedding-v4 | 1536 维,阿里云免费额度充足 |
| 向量库 | Chroma | 轻量级,本地持久化,无需额外服务 |
| 框架 | LangChain | 统一封装模型、向量库、Prompt、记忆 |
| 前端 | Streamlit | 纯 Python 写网页,10 分钟出界面 |
三、环境准备
3.1 安装依赖
powershell
pip install streamlit langchain langchain-community langchain-chroma dashscope3.2 配置阿里云 API Key本项目使用阿里云 DashScope(灵积)提供的模型和嵌入服务,需要设置环境变量:
bash
# Windows PowerShell
$env:DASHSCOPE_API_KEY="sk-你的API密钥"

# Windows CMD
set DASHSCOPE_API_KEY=sk-你的API密钥

# Linux / Mac
export DASHSCOPE_API_KEY=sk-你的API密钥密钥获取:阿里云百炼/灵积控制台 免费创建。
四、项目结构
plain
ai-ops-bot/
├── src/
│   ├── config_data.py          # 全局配置(模型名、路径、分割参数)
│   ├── file_history_store.py   # 长期会话记忆(本地 JSON 持久化)
│   ├── vector_stores.py        # 向量库服务 + 自定义 DashScope 嵌入
│   ├── knowledge_base.py       # 离线:文档去重、分割、入库
│   ├── rag.py                  # 在线:RAG 检索 + 问答核心
│   ├── app_file_upload.py      # Streamlit 知识库上传页
│   └── app_qa.py               # Streamlit 问答对话页
├── data/                       # 存放运维文档(如 实习笔记.txt)
├── chroma_db/                  # 向量库持久化目录(自动创建)
├── chat_history/               # 对话历史存储目录(自动创建)
└── md5.txt                     # 文件去重记录(自动创建)
五、核心代码实现
5.1 全局配置(config_data.py)
集中管理所有参数,避免魔法数字散落在各文件中。
python
# src/config_data.py
import os

# 去重记录文件
md5_path = "./md5.txt"

# Chroma 向量库配置
collection_name = "rag"
persist_directory = "./chroma_db"

# 文本分割器配置
chunk_size = 1000
chunk_overlap = 100
separators = ["\n\n", "\n", ".", "!", "?", "。", "!", "?", " ", ""]
max_split_char_number = 1000

# 检索配置:返回 Top-K 篇参考文档
retrieval_k = 10
# 兼容旧代码引用(vector_stores 中使用 similarity_threshold)
similarity_threshold = retrieval_k

# 模型配置
embedding_model_name = "text-embedding-v4"
chat_model_name = "qwen3-max"

# 默认会话配置
session_config = {"configurable": {"session_id": "user_001"}}
5.2 长期记忆存储(file_history_store.py)
InMemoryChatMessageHistory 重启即丢,我们基于 BaseChatMessageHistory 实现本地 JSON 文件版,并增加文件损坏自动降级(避免 JSON 不完整导致服务崩溃)。
python
# src/file_history_store.py
import json
import os
from typing import Sequence
from langchain_core.chat_history import BaseChatMessageHistory
from langchain_core.messages import BaseMessage, message_to_dict, messages_from_dict

CHAT_HISTORY_DIR = "./chat_history"

def get_history(session_id: str) -> "FileChatMessageHistory":
    """工厂函数:获取指定会话的文件历史存储"""
    return FileChatMessageHistory(session_id, CHAT_HISTORY_DIR)


class FileChatMessageHistory(BaseChatMessageHistory):
    """基于本地 JSON 文件的长期会话记忆"""

    def __init__(self, session_id: str, storage_path: str):
        self.session_id = session_id
        self.storage_path = storage_path
        self.file_path = os.path.join(self.storage_path, self.session_id)
        os.makedirs(self.storage_path, exist_ok=True)

    def add_messages(self, messages: Sequence[BaseMessage]) -> None:
        all_messages = list(self.messages)
        all_messages.extend(messages)
        new_messages = [message_to_dict(m) for m in all_messages]
        with open(self.file_path, "w", encoding="utf-8") as f:
            json.dump(new_messages, f, ensure_ascii=False, indent=2)

    @property
    def messages(self) -> list[BaseMessage]:
        if not os.path.exists(self.file_path):
            return []
        try:
            with open(self.file_path, "r", encoding="utf-8") as f:
                data = json.load(f)
                return messages_from_dict(data)
        except (json.JSONDecodeError, Exception):
            # 文件损坏时自动重置,避免整个服务崩溃
            return []

    def clear(self) -> None:
        with open(self.file_path, "w", encoding="utf-8") as f:
            json.dump([], f)
5.3 向量库与自定义嵌入(vector_stores.py)
由于 DashScope 的嵌入模型在社区版 LangChain 中偶有兼容问题,我们直接基于 dashscope.TextEmbedding 封装一个符合 LangChain Embeddings 接口的自定义类,更可控。
python
# src/vector_stores.py
from langchain_chroma import Chroma
from langchain_core.embeddings import Embeddings
from dashscope import TextEmbedding
import config_data as config


class DashScopeEmbeddings(Embeddings):
    """基于 DashScope 灵积的文本嵌入实现"""

    def __init__(self, model: str):
        self.model = model

    def embed_documents(self, texts: list[str]) -> list[list[float]]:
        # 过滤空字符串,避免 API 报错
        valid_texts = [t for t in texts if isinstance(t, str) and t.strip()]
        if not valid_texts:
            raise ValueError("没有有效的文本可供向量化(所有输入为空)")
        resp = TextEmbedding.call(model=self.model, input=valid_texts)
        if resp.status_code == 200:
            return [item["embedding"] for item in resp.output["embeddings"]]
        else:
            raise ValueError(f"向量化失败: {resp.message}")

    def embed_query(self, text) -> list[float]:
        # 兼容某些链式调用传入 dict 的情况
        if isinstance(text, dict):
            text = text.get("input", "")
        if not text or not isinstance(text, str):
            raise ValueError("查询文本必须是非空字符串")
        return self.embed_documents([text])[0]


class VectorStoreService:
    def __init__(self):
        self.embedding = DashScopeEmbeddings(model=config.embedding_model_name)
        self.vector_store = Chroma(
            collection_name=config.collection_name,
            embedding_function=self.embedding,
            persist_directory=config.persist_directory,
        )

    def get_retriever(self):
        return self.vector_store.as_retriever(
            search_kwargs={"k": config.similarity_threshold}
        )
5.4 离线流程:知识库入库(knowledge_base.py)
核心职责:MD5 去重 → 文本分割 → 向量化 → 写入 Chroma。
这里做了两层空内容防御:文件级 + 分割后 chunk 级,避免空文件触发底层异常。
python
# src/knowledge_base.py
import os
import hashlib
from datetime import datetime
from langchain_chroma import Chroma
from langchain_text_splitters import RecursiveCharacterTextSplitter
from vector_stores import DashScopeEmbeddings
import config_data as config


def check_md5(md5_str: str) -> bool:
    if not os.path.exists(config.md5_path):
        open(config.md5_path, "w", encoding="utf-8").close()
        return False
    with open(config.md5_path, "r", encoding="utf-8") as f:
        for line in f:
            if line.strip() == md5_str:
                return True
    return False


def save_md5(md5_str: str) -> None:
    with open(config.md5_path, "a", encoding="utf-8") as f:
        f.write(md5_str + "\n")


def get_string_md5(input_str: str, encoding: str = "utf-8") -> str:
    return hashlib.md5(input_str.encode(encoding)).hexdigest()


class KnowledgeBaseService:
    def __init__(self):
        os.makedirs(config.persist_directory, exist_ok=True)
        self.chroma = Chroma(
            collection_name=config.collection_name,
            embedding_function=DashScopeEmbeddings(model=config.embedding_model_name),
            persist_directory=config.persist_directory,
        )
        self.splitter = RecursiveCharacterTextSplitter(
            chunk_size=config.chunk_size,
            chunk_overlap=config.chunk_overlap,
            separators=config.separators,
            length_function=len,
        )

    def upload_by_str(self, data: str, filename: str) -> str:
        # 防御空文件或纯空白文件
        if not data or not data.strip():
            return "[跳过]文件内容为空,未载入知识库"

        md5_hex = get_string_md5(data)
        if check_md5(md5_hex):
            return "[跳过]内容已经存在知识库中"

        if len(data) > config.max_split_char_number:
            chunks = self.splitter.split_text(data)
        else:
            chunks = [data]

        # 过滤分割后可能产生的空片段(双重保险)
        chunks = [c for c in chunks if c and c.strip()]
        if not chunks:
            return "[跳过]文件内容为空,未载入知识库"

        base_metadata = {
            "source": filename,
            "create_time": datetime.now().strftime("%Y-%m-%d %H:%M:%S"),
            "operator": "admin",
        }
        metadatas = [{**base_metadata} for _ in chunks]

        self.chroma.add_texts(chunks, metadatas=metadatas)
        save_md5(md5_hex)
        return "[成功]内容已经成功载入向量库"
5.5 在线流程:RAG 问答核心(rag.py)
这是整个系统的大脑。关键设计:
- 参考资料注入 :检索到的文档作为
context写入 System Prompt,约束模型基于事实回答 - 长期记忆接入 :使用
FileChatMessageHistory替代内存字典,重启后对话不丢失 - 流式输出支持 :提供
ask_stream()生成器方法,配合 Streamlit 的write_stream实现打字机效果
python
# src/rag.py
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_core.messages import HumanMessage, AIMessage
from langchain_community.chat_models.tongyi import ChatTongyi
from vector_stores import VectorStoreService
from file_history_store import get_history
import config_data as config


class RagService:
    def __init__(self):
        self.retriever = VectorStoreService().get_retriever()

        # Prompt 模板:参考资料 + 历史对话 + 当前问题
        self.prompt = ChatPromptTemplate.from_messages([
            ("system", "你是一名专业的 AI 运维工程师,请严格以我提供的参考资料为主,"
                       "简洁、专业地回答用户问题。如果参考资料中找不到答案,请明确告知"
                       ""根据现有资料无法回答"。\n\n参考资料:\n{context}"),
            ("system", "以下是你与用户的最近对话记录:"),
            MessagesPlaceholder("history"),
            ("user", "用户提问:{input}")
        ])

        self.model = ChatTongyi(model=config.chat_model_name)
        self.parser = StrOutputParser()

    def _build_context(self, question: str) -> str:
        """检索向量库并拼接参考资料"""
        docs = self.retriever.invoke(question)
        if not docs:
            return "无相关参考资料"
        return "\n\n".join([f"[参考片段 {i+1}]\n{d.page_content}"
                            for i, d in enumerate(docs)])

    def ask(self, question: str, session_id: str = "user_001") -> str:
        """同步非流式问答(适合后台调用)"""
        context = self._build_context(question)
        history_store = get_history(session_id)
        history = history_store.messages[-5:]  # 只取最近 5 条,防止 token 爆炸

        prompt_value = self.prompt.invoke({
            "input": question,
            "context": context,
            "history": history
        })

        response = self.model.invoke(prompt_value)
        answer = self.parser.invoke(response)

        history_store.add_messages([
            HumanMessage(content=question),
            AIMessage(content=answer)
        ])
        return answer

    def ask_stream(self, question: str, session_id: str = "user_001"):
        """流式问答生成器(配合 Streamlit write_stream)"""
        context = self._build_context(question)
        history_store = get_history(session_id)
        history = history_store.messages[-5:]

        prompt_value = self.prompt.invoke({
            "input": question,
            "context": context,
            "history": history
        })

        full_answer = ""
        for chunk in self.model.stream(prompt_value):
            content = chunk.content
            if content:
                full_answer += content
                yield content

        # 流式结束后一次性写入历史文件
        history_store.add_messages([
            HumanMessage(content=question),
            AIMessage(content=full_answer)
        ])
5.6 前端:知识库上传页(app_file_upload.py)
基于 Streamlit 的 file_uploader + session_state 实现。增加内容预览功能,方便用户确认上传的是正确文件。
python
# src/app_file_upload.py
import time
import streamlit as st
from knowledge_base import KnowledgeBaseService

st.title("知识库更新服务")

if "service" not in st.session_state:
    st.session_state["service"] = KnowledgeBaseService()

uploader_file = st.file_uploader(
    "请上传 TXT 格式的运维文档(如故障排查手册、运维规范)",
    type=["txt"],
    accept_multiple_files=False,
)

if uploader_file is not None:
    file_name = uploader_file.name
    file_type = uploader_file.type
    file_size = uploader_file.size / 1024

    st.subheader(f"文件名:{file_name}")
    st.write(f"格式:{file_type} | 大小:{file_size:.2f} KB")

    text = uploader_file.getvalue().decode("utf-8")

    # 内容预览,方便确认
    with st.expander("点击预览文件内容"):
        st.text(text[:2000] + ("..." if len(text) > 2000 else ""))

    with st.spinner("正在分割文本并向量化入库,请稍候..."):
        time.sleep(0.5)
        result = st.session_state["service"].upload_by_str(text, file_name)

    if result.startswith("[成功]"):
        st.success(result)
    else:
        st.info(result)
5.7 前端:问答对话页(app_qa.py)
核心交互:使用 st.chat_message 构建对话气泡,使用 write_stream 消费 ask_stream 生成器,实现逐字输出效果。
python
# src/app_qa.py
import streamlit as st
from rag import RagService

st.title("AI 运维问答机器人")
st.divider()

# 初始化
if "messages" not in st.session_state:
    st.session_state["messages"] = [
        {"role": "assistant", "content": "你好,我是 AI 运维助手,请问有什么可以帮你?"}
    ]

if "rag" not in st.session_state:
    st.session_state["rag"] = RagService()

# 渲染历史消息
for msg in st.session_state["messages"]:
    st.chat_message(msg["role"]).write(msg["content"])

# 用户输入
prompt = st.chat_input("请输入您的问题,例如:服务器 CPU 飙高如何排查?")
if prompt:
    # 显示用户消息
    st.chat_message("user").write(prompt)
    st.session_state["messages"].append({"role": "user", "content": prompt})

    # AI 流式回复
    with st.spinner("AI 正在检索知识库并思考..."):
        response_container = st.chat_message("assistant")
        full_response = response_container.write_stream(
            st.session_state["rag"].ask_stream(prompt)
        )

    # 记录完整回答,供页面刷新后显示
    st.session_state["messages"].append(
        {"role": "assistant", "content": full_response}
    )
六、运行流程
步骤 1:启动知识库上传页面
将运维文档(如 实习笔记.txt、故障排查手册.txt)放入项目,然后启动上传服务:
bash
streamlit run src/app_file_upload.py在网页中选择文件上传,看到 "成功内容已经成功载入向量库" 即表示入库完成。
步骤 2:启动问答页面
bash
streamlit run src/app_qa.py浏览器会自动打开 http://localhost:8501,即可开始对话。
七、效果演示
上传知识库:
plain
文件名:实习笔记.txt
格式:text/plain | 大小:5.24 KB
[成功]内容已经成功载入向量库
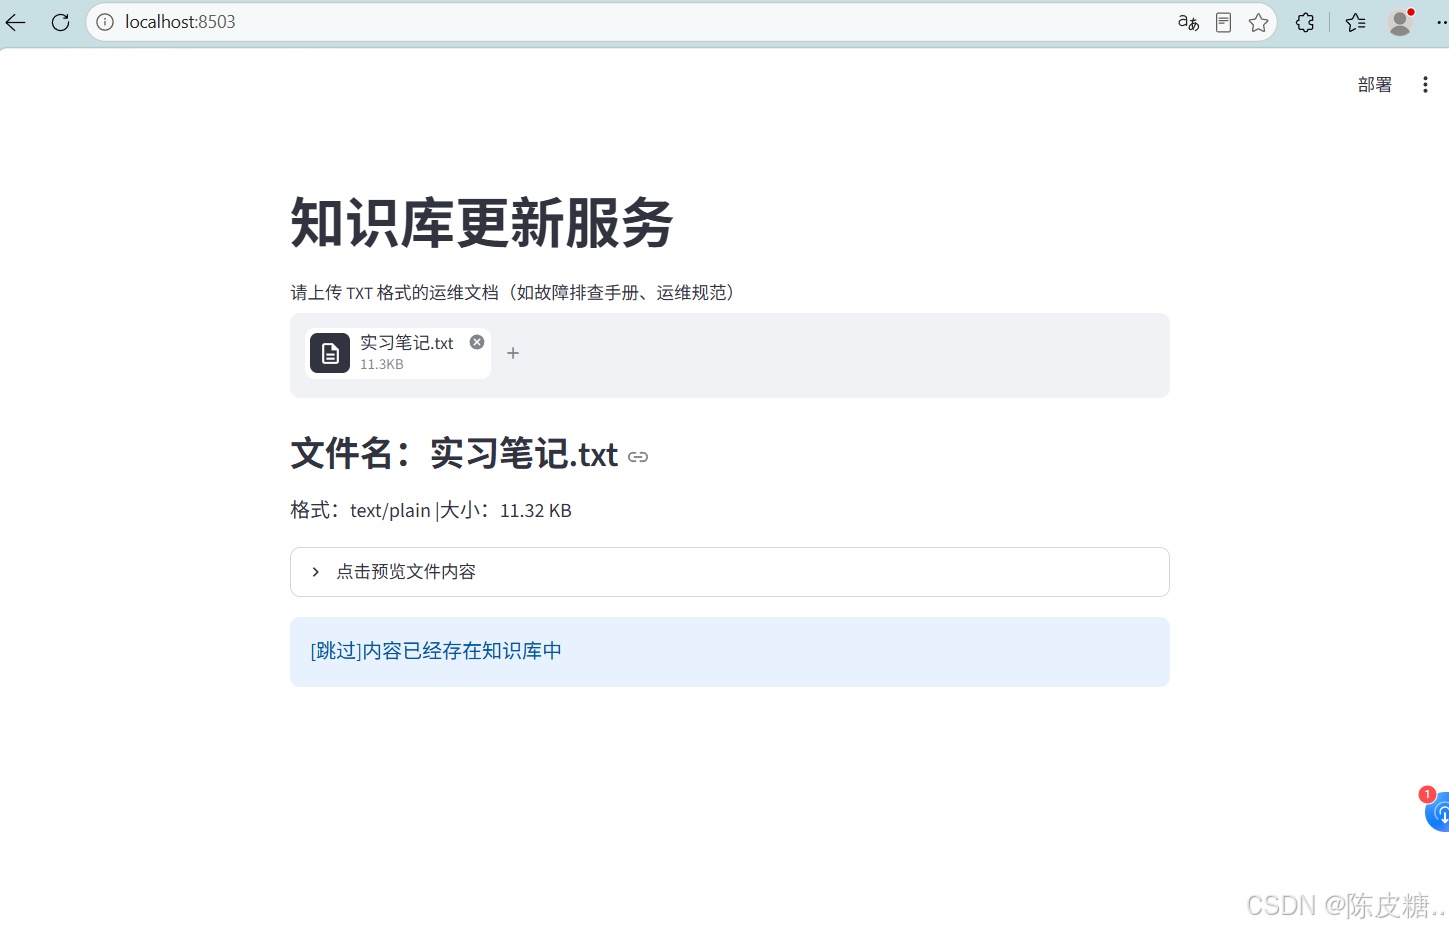
效果展示图:
本地资料库展示页面:
做了预览模式方便区分传入内容;
做了去重提醒;
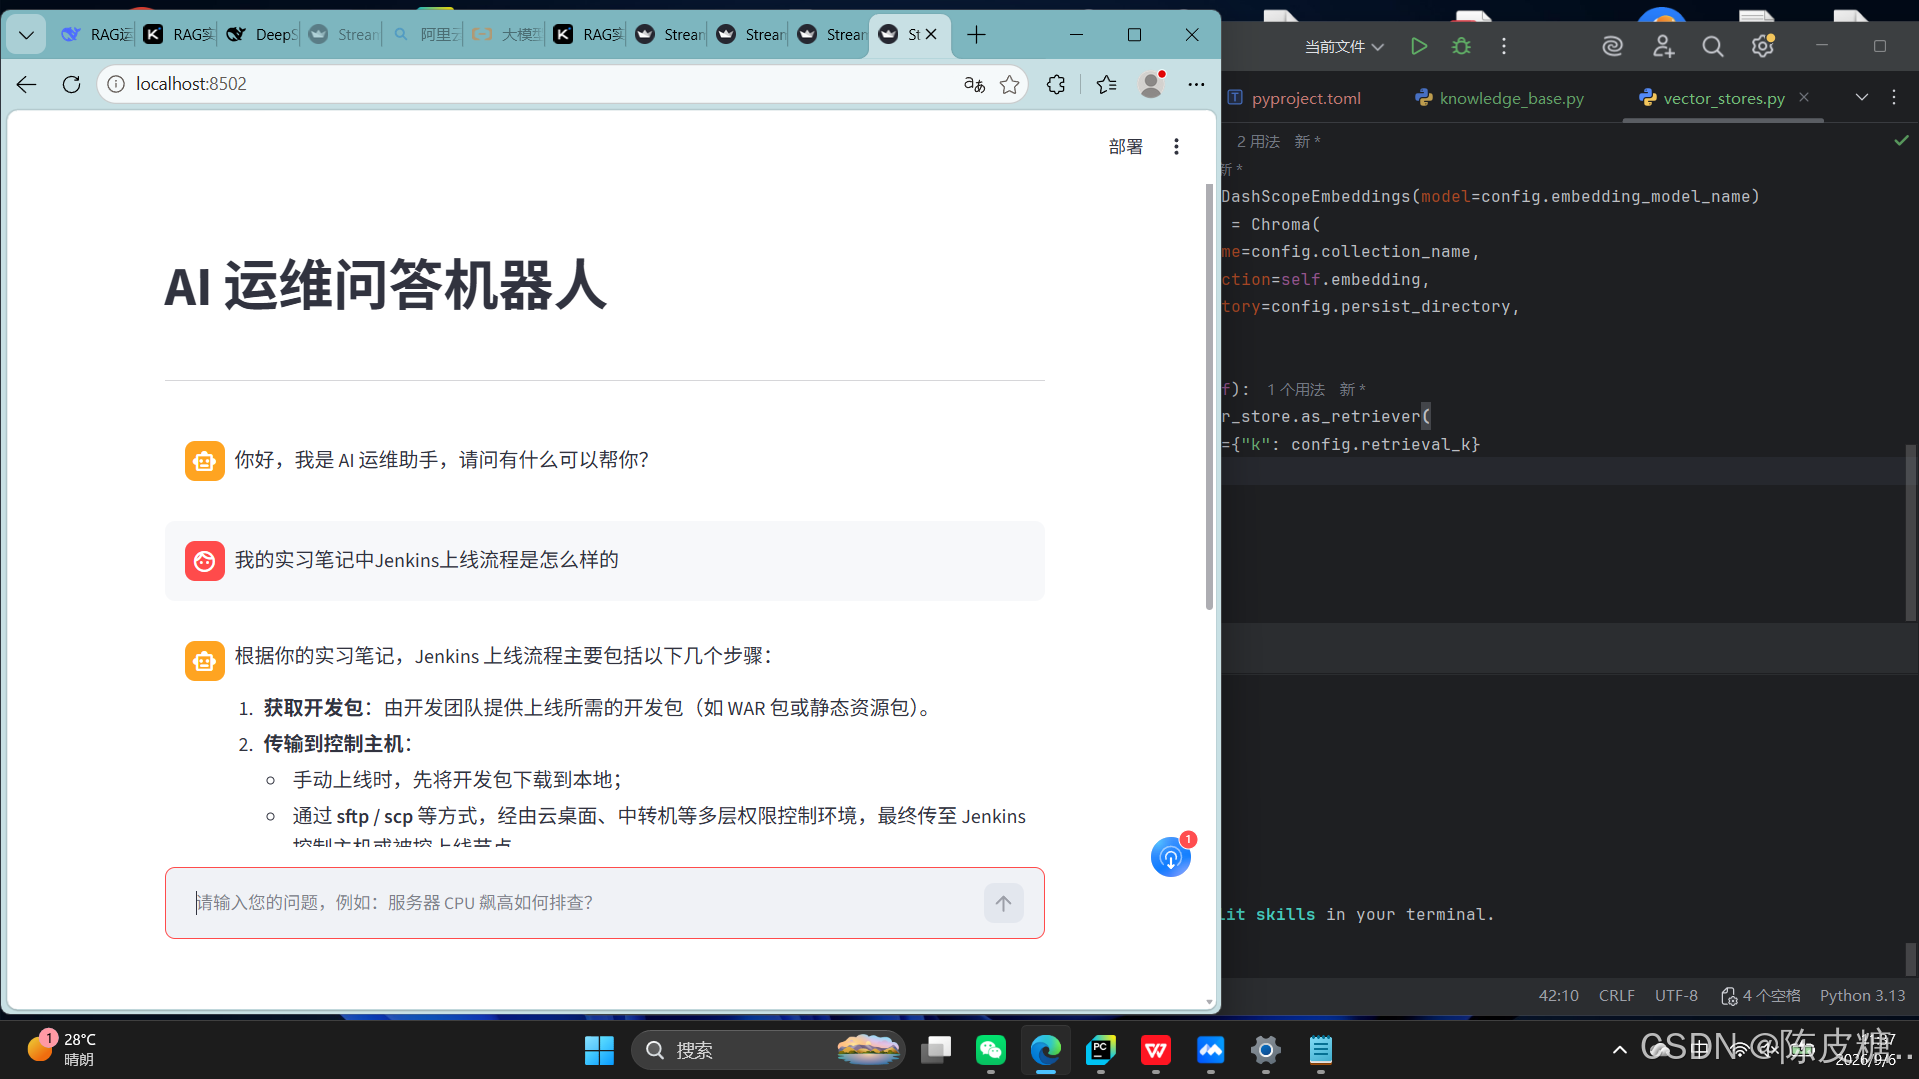
问答示例:
用户:4A 平台按钮失效但清缓存后恢复,可能是什么原因?
AI:根据参考资料,该现象通常与浏览器本地缓存或 DNS 解析异常有关。当 4A 平台页面可正常打开但某一功能按钮失效时,清除浏览器缓存并重新登录即可恢复,说明服务端接口和程序本身正常,问题出在客户端缓存数据损坏或前端资源加载异常。建议排查浏览器控制台是否有 404/500 错误,并确认 DNS 解析是否稳定。
八、踩坑记录
表格
| 坑点 | 现象 | 解决方案 |
|---|---|---|
| 空文件上传 | ValueError: 没有有效的文本可供向量化 |
在 upload_by_str 中增加 if not data.strip() 前置拦截 |
| 变量名不一致 | AttributeError: module 'config_data' has no attribute 'similarity_threshold' |
配置文件中保留兼容别名 similarity_threshold = retrieval_k |
| 导入笔误 | ModuleNotFoundError: No module named 'langlangchain_chroma' |
修正为 from langchain_chroma import Chroma |
| 历史记忆丢失 | 重启程序后对话历史清空 | 用 FileChatMessageHistory 替代内存字典,持久化到 ./chat_history/ |
| JSON 文件损坏 | 程序异常退出后历史记录无法读取 | messages 方法中捕获 JSONDecodeError,损坏时返回空列表自动恢复 |
九、后续可扩展方向
- 多格式支持 :目前只支持 TXT,可集成
PyPDFLoader、CSVLoader支持 PDF、Excel 运维文档 - Agent 增强:接入工具调用(如实时查询服务器状态、执行 Shell 命令),从"问答"升级为"操作"
- 混合搜索:Chroma 支持 metadata 过滤,可基于文档来源(如"仅搜索故障排查类文档")做精细化检索
- 部署上线:使用 Docker 打包,配合 Nginx 反向代理,做成团队内部统一的运维助手平台
十、总结
本项目是一个最小可用的 RAG 应用,代码量控制在 300 行左右,但完整覆盖了 RAG 的两条核心链路:
- 离线链路:文档 → 分割 → 向量化 → 持久化存储
- 在线链路:用户提问 → 向量检索 → Prompt 组装 → 大模型生成 → 流式输出
对于个人学习或小型团队内部使用,这个架构已经足够。希望这篇记录对你有帮助!