Agent Memory / 强化学习 MemPO源码学习笔记 ---(1)--- 总体
文章目录
- [Agent Memory / 强化学习 MemPO源码学习笔记 ---(1)--- 总体](#[Agent Memory / 强化学习] MemPO源码学习笔记 ---(1)--- 总体)
-
- [0x00 概要](#0x00 概要)
- [0x01 基础 & 背景](#0x01 基础 & 背景)
-
- [1.1 用RL训练记忆系统的要点](#1.1 用RL训练记忆系统的要点)
- [1.2 主要难点](#1.2 主要难点)
- [1.3 主要思路](#1.3 主要思路)
- [1.4 RL训练方案](#1.4 RL训练方案)
- [0x02 MemPO 论文](#0x02 MemPO 论文)
- [0x03 总体架构](#0x03 总体架构)
-
- [3.1 路径](#3.1 路径)
- [3.2 关键算法细节速查表](#3.2 关键算法细节速查表)
- [3.3 架构图](#3.3 架构图)
- [3.4 流程全景](#3.4 流程全景)
- [3.5 VeRL](#3.5 VeRL)
-
- VeRL的可扩展点(从易到难)
- 新增代码
- [MemPO 修改点汇总表](#MemPO 修改点汇总表)
- [0x04 设计思路](#0x04 设计思路)
- [0x05 训练 & 推理](#0x05 训练 & 推理)
-
- [5.1 Agent 单轮交互格式 (训练 & 推理通用)](#5.1 Agent 单轮交互格式 (训练 & 推理通用))
- [5.2 训练架构图](#5.2 训练架构图)
- [5.3 评估架构图](#5.3 评估架构图)
- [5.4 函数的数据流串联](#5.4 函数的数据流串联)
- [5.5 环境](#5.5 环境)
- [0x06 环境](#0x06 环境)
- [0xFF 参考](#0xFF 参考)
0x00 概要
现有的基于强化学习的 Memory 管理方法往往缺乏一种有效机制针对 Memory 的更新内容进行引导优化,Memory 的内容难以保证质量。而 MemPO(Self-Memory Policy Optimization)使模型对 Memory 进行自管理,并引入了基于有效信息含量的 Memory-level 的优势估计,引导 Memory 保留对解决任务更有效的信息,进而提升记忆有效性。
MemPO的独特切入点是:让模型把记忆写在每轮开头(),形式上像"自我对话的草稿纸",既是记忆又是思考链的一部分。这样,变成可训练的策略变量,用RL信号端到端地教会模型"什么值得记、怎么记"。RL 直接端到端优化这一行为,无需额外的记忆模块。
MemPO 的信息如下:
-
论文标题:MemPO: Self-Memory Policy Optimization for Long-Horizon Agents
-
模型和数据集地址:https://huggingface.co/collections/NewBeeKing/mempo
0x01 基础 & 背景
MemPO 的核心目标是:不仅要"用 RL 训练 Agent",还需要为记忆本身设计可学习、可归因的优化信号,让模型在交互过程中主动压缩、组织并保留最有助于任务完成的信息。
因此,我们需要先看看用RL训练记忆系统的要点或者难点。
1.1 用RL训练记忆系统的要点
现有的基于强化学习的 Memory 管理方法往往缺乏一种有效机制针对 Memory 的更新内容进行引导优化,Memory 的内容难以保证质量。比如,在长程交互下奖励稀疏,信用分配困难下,模型很难学清楚"到底是哪一步的记忆写得好/坏"在影响最终成败,导致记忆容易冗余、遗漏关键信息。
1.2 主要难点
| 难点 | 说明 |
|---|---|
| Credit assignment | 奖励稀疏、延迟,难以归因哪一轮的记忆决策导致最终成败 |
| 记忆增长失控 | Naive 全上下文方案随轮次指数级膨胀,超出 context window 或算力预算 |
| 信息遗忘与误传 | 早期关键信息被压缩丢失,或记忆摘要引入幻觉,误差沿 episode 累积 |
| 格式约束与 RL奖励设计 | 要同时优化"记忆质量"和"答案正确性",奖励函数设计困难(MemPO 用 format validate + EM) |
| 训练稳定性 | 多轮异步 rollout 与 FSDP/SGLang的协同,工程复杂度高 |
| 分布外泛化 | 模型在训练轮次内学会记忆,但在更长horizon的推理时,是否仍有效是开放问题 |
1.3 主要思路
如何让 Agent 在交互过程中自主组织历史信息,并且通过强化学习优化 Memory 的信息质量,同时还能对齐最终任务目标?
目前,业界主要的思路如下:
-
隐式记忆压缩(MemPO/MEM1思路)
- MemPO 让模型自主生成每轮的记忆摘要(token),通过RL奖励信号反向驱动模型学会"哪些信息值得保留"
- MEM1(MIT,2025):维持固定大小的内部 state,每步 consolidate&丢弃无关记忆,在QA任务上比全上下文方案节省 3.7x内存,性能提升3.5x
-
外部检索增强(RAG-in-the-loop)
- Agent 在推理中主动调用搜索工具(Search-R1、ASearcher、MemPo),将外部知识动态注入上下文
- RL训练"何时搜索、搜什么"的策略
-
分层RL + LLM规划
- LLM负责长时序抽象规划(高层),小 RL policy 负责原子动作(低层),两者分离训练
-
多粒度记忆系统
- 短期(working memory)+ 长期(vector DB/ knowledge graph)结合,通过注意力机制动态检索
1.4 RL训练方案
下面是一个假想的方案,展示如何设计和训练一个智能体记忆系统,使其在强化学习框架中学会记忆和利用环境的关键信息。这个方案分为模块选择、任务设计、模型结构、训练流程以及优化策略。
1.4.1 方案概述
目标是训练一个强化学习智能体代理(Agent),通过交互学习获得有用的记忆能力,从而在部分可观察的环境中利用历史信息更好地完成任务。
1.4.2 任务与环境描述
我们选择一个适合训练记忆能力的任务场景:
迷宫导航任务
- 环境:一个迷宫或网格世界,智能体只能观测到当前网格周围的状态(部分可观察)。
- 目标:智能体需要记忆已经访问的区域,避免重复探索,并最终找到目标位置。
- 挑战:当前观测不足以推断全局状态,智能体必须依赖其内部记忆。
稀疏奖励环境
-
仅在智能体到达目标时给予奖励,其余时间没有奖励信号。
-
增加智能体对关键状态的记忆需求(例如记住目标方向)
长期信用分配
-
智能体需要学习关联长时间跨度中的关键行为,从而优化整体策略。
-
示例:在需要规避障碍物的场景中,智能体必须记住数步前的重要观测。
1.4.3 模型架构
智能体的核心由策略网络(Policy Network)和记忆模块构成,关键架构如下:
策略网络
-
基于Actor-Critic框架(例如PPO或A3C):
- Actor(策略):输出动作分布π(a_t丨o_t,h_t)
- Critic(值函数):评估当前策略的价值V(o_t,h_t)
-
输入:当前观测o_t和结合记忆模块生成的隐藏状态h_t。
记忆模块
- 需要按照实际情况进行组织。
1.4.4 强化学习训练流程
交互与记忆更新
训练采用多步RL算法(如PPO),训练过程如下:
-
智能体在每一步获得当前观测 o_t和回报 r_t,输入记忆模块。
-
策略网络利用当前观测和记忆生成动作分布P(a_t l o_t,h_t)。
-
智能体执行动作,环境返回下一个状态及奖励。
奖励信号设计
-
稀疏奖励:奖励信号只有在完成目标任务时才被赋予;
-
记忆相关奖励:在关键状态正确存储、提取信息时,提供额外奖励。一例如:记住目标方向并靠近它。
目标函数
每个时间步的损失由以下部分组成:
-
策略优化目标(PPO或A3C):通过最大化长时回报训练动作策略。
-
记忆模块学习目标:通过显式奖励信号
R_{memory}训练记忆模块:- 写入奖励:存储关键状态
- 读取奖励:正确提取有用的记忆内容辅助决策。
综合目标函数为:
python
L=L_{policy} + lambda_{value}L_{value} + lambda_{memory}L_{memory}
其中:
    - L_{policy} 是策略梯度损失
    - L_{value}  是值函数估计的均方误差损失
    - L_{memory} 是由记忆模块预测的读写行为相关损失
经验回复(Experience Replay)
如果环境是确定性的,使用Replay Buffer存储轨迹样本,将历史数据用于训练。
优先经验回放:优先采样TD误差大的样本。
1.4.5 优化策略
记忆消耗的正则化
- 限制智能体对记忆模块的使用,以防止存储过多无关数据。例如,加入以下约束最小化无意义的存储:L_{reg} =| MemoryUsage |
长时目标的分层学习
- 在复杂的长期任务中,使用层次强化学习(HRL)将任务分解为多个阶段,分别学习记忆和决策。
使用奖励基于注意力优化记忆
- 优化Transformer中的注意力权重,使其更注重奖励关联较高的观测。
1.4.6 结果评估与改进
训练完成后,评估智能体的记忆性能:
- 任务完成率:测试智能体完成任务的成功率。
- 记忆关联性:检查策略中是否有效利用历史信息。
- 泛化能力:测试智能体能否将记忆迁移到新的未见环境中。
如果性能不足,可能需要:
- 提升网络结构(如改用更复杂的Transformer)。
- 增强经验回放机制。
- 重新设计奖励信号引导记忆学习。
1.4.7 小结
此方案通过强化学习训练一个智能体的记忆系统,结合策略网络和记忆模块(如RNN、Transformer或外部记忆),在部分可观察环境中学习记忆有用的信息,用以优化决策。
我们接下来看看 MemPO 是如何处理的。
0x02 MemPO 论文
MemPO 的核心洞察:不需要外部记忆模块,AgentMemory.prepare_prompt()在构建下一轮prompt 时,让模型在每个 assistant 轮次的开头自己写下记忆摘要...。即,只保留最近一轮的工具结果(short_text截断版),之前所有信息必须靠模型自己写入 来保留。RL 奖励信号端到端地驱动模型学会"什么值得记、怎么记"。这就是"倒逼"模型学会记忆的机制。
MemPO 采用 Multi-turn RL,Rollout 采样阶段,模型与外界进行多轮交互,每一轮交互模型都会生成历史上下文的 Memory。优势计算时,MemPO 采用两类优势估计相结合的方式来得到最终结果。

Advantages of Global Trajectory 用以衡量轨迹整体的准确性,使用答案准确性和格式准确性来进行奖励计算,此部分的优势估计可以表示为:

而 Advantages of Informative Memory 用以衡量每一段生成的 Memory 内保留了多少对于解决问题有效的信息。其奖励计算通过已知 Memory 内容的情况下,生成最终正确答案的后验概率来表示,此部分的优势估计可以表示为:
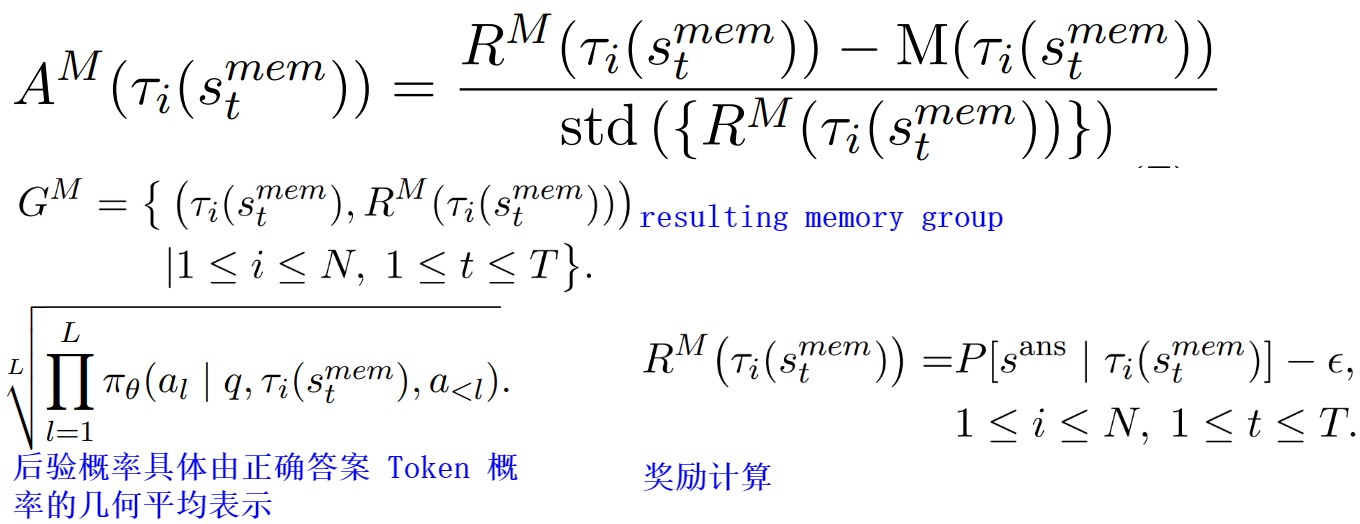
这样,模型在训练的过程中就可以通过奖励的反馈情况来学习什么样的 Memory 内容是对于解决最终问题更加有效的,这样就大大缓解了 Memory 内容的不可控性和盲目性。
最终,整体的优势估计可以表示为:

0x03 总体架构
3.1 路径
代码具体路径上的关键点如下(后续分析时候会频繁遇到):
python
A1   _postprocess(P_mem/P_full段)          MemPO核心:记忆奖励如何计算
A2   compute_grpo_memory_advantage        mem_adv如何归一化、作用于哪些 token
A3   compute_advantage(mem叠加段)          两种优势如何叠加、被注释的条件版本
A4   ToolAgentLoop.__init__(mem收集段)     full/mem_traj 收集时机、ans_mask 构造
A5   AgentMemory.prepare_prompt           "倒逼记忆"机制:每轮只保留1轮工具
                                          这是MemPO的"约束机制"入口
B1   NaiveRewardManager.__call_           outcome reward计算和放置位置
B2   compute_score                        三种 target 类型处理、EM check
B3   validate_format                      8条格式规则(隐式prompt工程)
B4   compute_grpo_outcome_advantage       对比 outcome_adv vs mem_adv 的差异
B5   RewardManagerWorker.compute_score     Ray async 奖励计算接口
B6   AgentLoopManager.generate_sequences   rollout 调度+mem_rewards 收集
C1   RayPPOTrainer.fit                     训练主循环(宏观流程)
C2   extract_solution                      答案提取逻辑
C3   ToolParser.register("search")         <search>标签解析
C4   AsearcherSearchTool,execute           RAG检索调用+5次重试
据此,我们可以把代码的核心路径划分为三段:
- A路径(memory):计算Memory Reward (Local Memory Signal),即模型log prob差值(连续)→密集→限域→仅作用于 区间。
- 比如:"记忆奖励是什么" A5→A4→A1;"记忆奖励如何推动训练" A5→A4→A1→A2→A3;
- A5: 评估专用路径, 限制上下文窗口 (训练时不使用)
- B路径(outcome):对应论文中 "global trajectory-level reward signal",即字符串EM匹配(0/1)→稀疏→归一化→ 全序列等值广播→全序列梯度,对应论文中 "global trajectory-level reward signal"。
- C路径:代表整个系统的主循环,比如 系统骨架 - 训练循环、工具解析、RAG检索 ;
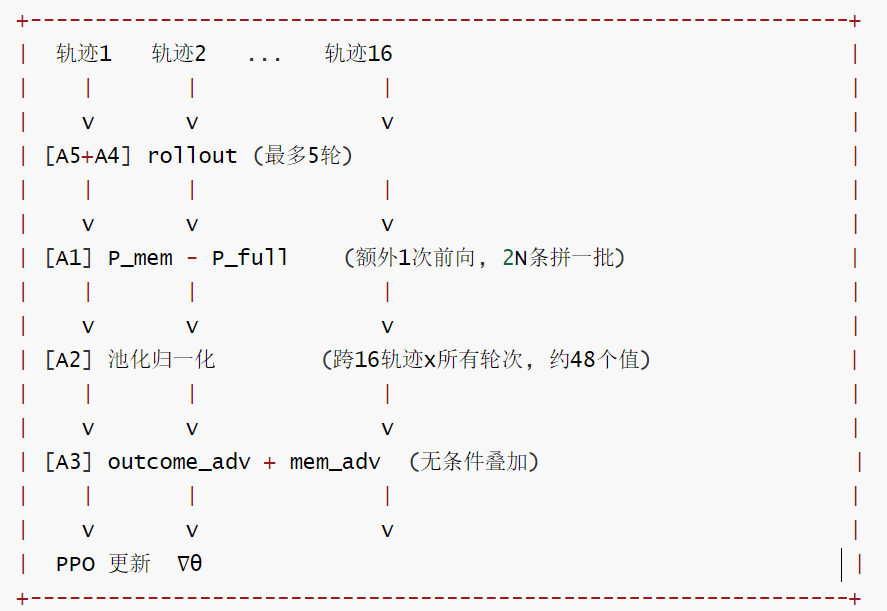
极简版数据流图如下:

以A5 → A4 → A1(记忆奖励是什么)为例:
python
rollout 结束
|
├─ 每条轨迹 i, 每轮 t:
|  mem_rewards [i] = [P_mem_t2 - P_full_t2, P_mem_t3 - P_full_t3, ...]
|   (A1 计算)
v
compute_advantage ()
├─ outcome_adv [i, :] = (reward_i - mean_group) /std_group
| 广播:整条 response 序列每个 token 都获得相同的 outcome_adv
|
├─ mem_adv [i, start_t:end_t] = (mem_reward_it - mean_pool) /std_pool
| 仅在 <mem>...</mem> 区间填非零值
| (A2 计算)
|
└─ final_adv = outcome_adv + mem_adv
| (A3 无条件叠加)
|
v
PPO 更新: ∇θ = Σ final_adv [t] × ∇ log π(token_t)

对于 <mem> token:
    梯度信号 = outcome_adv ("这轮整体答对了吗") + mem_adv (" 这段 <mem> 相比全局均值好不好 ")

对于其他 response token:
    梯度信号 = outcome_adv ("这轮整体答对了吗")

张量形状可视化 (bsz=4, seq_len=512 为例):

outcome_adv (Round 1-5 的 response 全填同一值):
  [[ 0.3  0.3  0.3  ...  0.3  0.3 ]   轨迹1, 答对 (+0.3)
   [-0.7 -0.7 -0.7  ... -0.7 -0.7 ]   轨迹2, 答错 (-0.7)
   [ 0.3  0.3  0.3  ...  0.3  0.3 ]   轨迹3, 答对
   [-0.7 -0.7  ...                ]   轨迹4, 答错 ]

mem_adv (仅 <mem>...</mem> 位置非零):
  [[ 0.0  0.0 | 1.2  1.2  1.2 | 0.0  0.0 | -0.5  ... -0.5 | 0.0 ]
   [ 0.0  0.0 | 0.8  0.8  0.8 | 0.0  0.0 |  0.3  ...  0.3 | 0.0 ]
   ...]

final_adv = outcome_adv + mem_adv:
  <mem> token 同时受两种信号约束,其他 token 只受 outcome 信号约束
全局流水线 (单条 question, 16条轨迹并发)如下:
3.2 关键算法细节速查表
| 模块 | 关键细节 |
|---|---|
| mem_traj 构成 | prompt_ids + ... tokens (不含 short_text) |
| ans_mask 构造 | -1\*(core_len+4):-4 =1; \n=4 tokens |
| -4 的含义 | Qwen tokenizer: \n=1 token, =3 tokens |
| threshold 过滤 | log(0.5) ≈ -0.693; prob > 50% 才参与 P 计算 |
| mem_rewards 归一化 | 同 question 所有轨迹所有轮次 pooled |
| Round 1 处理 | 不收集任何 mem_reward,全 0 |
| 多目标格式 | ListList\[str] → ";".join(gt\[0 for gt]); Liststr → 只用 0 |
| 条件 mem 已注释 | advantages * (outcome_adv >= 0) 被注释掉 |
3.3 架构图
MemPO 的架构图如下,其中,sglang_multiturn 是 MemPO 项目中实现多轮对话场景下自记忆策略优化训练的关键模块,它通过 SGLang 框架提供了高效的多轮对话处理能力,并集成了灵活的配置管理和 RAG增强功能。即,sglang_multiturn/是MemPO项目的"运维配置层",提供训练启动脚本、超参配置、以及训练时用的本地RAG 检索服务。核心算法逻辑全部在verl/里。

3.4 流程全景
从RL角度来看,MemPO 的流程全景如下:

3.5 VeRL
我们接着看看围绕VeRL都做了哪些工作?
原版VeRL的GPU通信、FSDP、SGLang集成、Ray调度等基础设施完全复用,没有触碰。MemPO 的贡献集中在"如何定义和计算记忆奖励"这一层。
python
MemPO = VeRL(分布式PPO/GRPO框架)
        + 4处外科手术式修改(标记→计算→组装→叠加,即训练流程的4个节点)
        + 独立的训练配置和评估代码
注:4个节点表示,在rollout时记录token位置→计算记忆信息价值→ 组装→叠加到GRPO 优势上
VeRL的可扩展点(从易到难)
可扩展点层次如下:
python
Level 0:配置文件(yaml/sh)          ←  最简单,不改代码,比如替换奖励函数(最常用)
Level 1:外部Python 文件            ←  只写新文件,比如替换奖励管理器
Level 2:继承注册类                 ←  写新类,注册,比如添加自定义工具
Level 3:修改 tool_agent_loop.py   ←  改数据收集逻辑
Level 4:修改 core_algos.py        ←  改优势函数
Level 5:修改 ray_trainer.py       ←  改训练主循环
新增代码
MemP0核心新增代码如下:
- core_algos.py: compute_grpo_memory_advantage()
- ray_trainer.py: mem_advantages 叠加逻辑
- tool_agent_loop.py:mem token 标记 + full/mem_traj 收集
- agent_loop.py:P_mem/P_full计算
- my_reward_score.py:EM奖励函数(全新文件)
- asearcher_*_tool.py:搜索/访问工具(全新文件)
MemPO 修改点汇总表
| 修改层级 | 文件 | 改了什么 |
|---|---|---|
| L1 外部文件 | my_reward_score.py | 新增 EM 奖励函数 |
| L1 外部文件 | asearcher_search_tool.py | 新增搜索工具 |
| L3 数据收集 | tool_agent_loop.py | 收集 full/mem_traj、idx_list |
| L4 优势函数 | core_algos.py | 新增 compute_grpo_memory_advantage |
| L5 主循环 | ray_trainer.py | mem_adv 叠加 |
| L5 主循环 | agent_loop.py | P_mem/P_full 计算 (A1) |
具体可以参见下图。
python
项目结构: 哪些是原版 VeRL, 哪些是 MemPO 新增?

MemPO-master/
├── verl/                     ← 主要是 VeRL 0.5.0.dev 的代码
│   ├── trainer/
│   │   └── ppo/
│   │       ├── ray_trainer.py      ← ⚠️魔改: 在 GRPO 分支里加了 compute_grpo_memory_advantage
│   │       └── core_algos.py       ← ⚠️魔改: 新增 compute_grpo_memory_advantage 函数
│   ├── experimental/
│   │   └── agent_loop/
│   │       ├── agent_loop.py       ← ⚠️魔改: 加了 P_mem/P_full 计算逻辑
│   │       └── tool_agent_loop.py  ← ⚠️魔改: 加了 mem_rewards_idx_list 标记逻辑
│   ├── utils/reward_score/
│   │   └── my_reward_score.py      ← ✅ MemPO 新增: EM + format validate 的奖励函数
│   └── ... (其余基本是原版 VeRL)
├── sglang_multiturn/         ← ✅ MemPO 新增
│   ├── config/
│   │   ├── multiturn_mempo.yaml    ← MemPO 训练配置
│   │   └── tool_config/            ← 搜索工具配置
│   └── run_train.sh                ← 训练启动脚本
└── eval/                     ← ✅ MemPO 新增 (评估代码)
    ├── agent/
    │   ├── asearcher_mem.py        ← MemPO 的评估 Agent (带记忆的推理)
    │   └── asearcher.py            ← 对照组 (无记忆的推理)
    └── evaluation/                 ← 评估脚本
示例如下:
python
# Level 5: 修改训练主循环 (ray_trainer.py)

# MemPO 的 mem_adv 叠加就在这里:

# ray_trainer.py: compute_advantage() 函数
elif adv_estimator == AdvantageEstimator.GRPO:
    advantages, returns = compute_grpo_outcome_advantage(...)

    # ← MemPO 在这里插入了 ~15 行
    mem_advantages, _ = compute_grpo_memory_advantage(...)
    advantages = advantages + mem_advantages

# 同时还要修改 _postprocess() 来处理新的 non_tensor_batch 字段 (A1 的约80行)。
0x04 设计思路
我们来看看 MemPO 的设计思路。
4.1 通俗解释
假设有个侦探要回答一个很难的问题,比如:"爱因斯坦出生在哪个城市,那个城市的市长叫什么名字?"
普通侦探(老方法)
每次查完一条线索,就把所有笔记都带进下一个房间。
问题是:随着调查越来越深,要带的笔记越来越多,书包越来越重,最后根本搬不动了
MemPO 侦探(新方法)
MemPO侦探每进一个新房间,只能带一张自己写的小纸条()
他在小纸条上写:"目前已知:爱因斯坦生于乌尔姆市,我还需要查乌尔姆的市长。
下一个房间里,他只看这张小纸条+刚查到的最新信息,就能继续推理。
关键问题
关键问题:侦探怎么学会"写好小纸条"?这就是RL(强化学习)的作用!
就像训练小狗:做对了给零食,做错了不给。
- 侦探最终答对了 → 奖励
- 侦探最终答错了,或者小纸条格式乱了 → 不给奖励 ×
经过成千上万次这样的练习,侦探自己就学会了:"我应该在小纸条上写什么,才能让自己最终答对。"
推理格式
侦探每次推理的格式是固定的
markdown
<mem>       ←    小纸条(我记住了什么)
爱因斯坦生于乌尔姆市
</mem>

<think>     ←     脑子里的推理
现在要查乌尔姆市长
</think>

<search>乌尔姆市市长</search>  ←去查资料
(系统返回查到的内容)

<mem>      ←   下一轮更新小纸条
乌尔姆市长是XXX
</mem>
...
<answer>乌尔姆,xxx</answer>   ←  最终答案
小结
MemPO是让AI学会"边做笔记边推理",用RL奖励来训练它把最重要的信息压缩进每轮的小纸条,这样就算查了很多很多轮,也不会"书包太重"。
4.2 详细解析
MemPO的关键设计是双通路奖励机制:
- Outcome Reward:EM 匹配正确答案,信号作用于全序列。
- Memory Reward:P_mem - P_full 衡量记忆摘要质量,信号仅作用于token。
这使得标签内的token同时受到「答对/答错」和「记忆是否有效压缩了上下文」两个梯度信号的驱动。
双通路

本质区别
两种奖励的本质区别
| outcome reward | mem reward | |
|---|---|---|
| 计算方式 | 字符串 EM match (0/1) | P_mem - P_full (连续) |
| 计算时机 | rollout 结束后 (独立调用) | rollout 结束后 (额外前向) |
| 流向训练 | 通过 reward_tensor → advantage | 通过 non_tensor_batch → advantage |
| 作用范围 | 全序列 (广播) | 仅 区间 |
| 归一化基准 | 同组16条轨迹 (GRPO 组均值) | 同 question 跨轨迹跨轮次池化 |
0x05 训练 & 推理
5.1 Agent 单轮交互格式 (训练 & 推理通用)
每轮Assistant 输出必须遵循:
markdown
<mem>
	[本轮对之前所有信息的压缩摘要] ◄─── 模型"主动记忆"
</mem>

<think>	[推理链] </think>

<search>查询词</search>        ◄─── 或 <access>url</access> 或 <answer>答案</answer>

系统注入:
<tool_response>	[RAG检索结果/网页内容]</tool_response>

──► 进入下一轮
5.2 训练架构图

5.3 评估架构图

5.4 函数的数据流串联
A5 制造了"必须写 "的压力,A4 记录了"写了什么 ",A1 测量了" 写得有多好"(好 = 有了 预测答案的概率比有完整上下文时差多少)。

5.5 环境
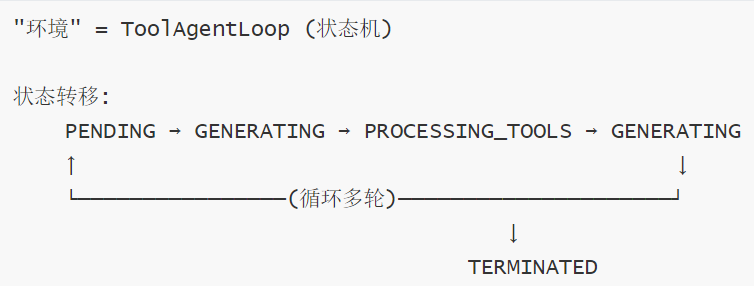
MemPO 的环境是完全自己实现的,基于 VeRL 框架 + SGLang 推理引擎定制。它不是传统 RL 的 Gym 环境,而是一个异步多轮 Agent Loop 充当环境角色。
核心架构
0x06 环境
6.1 特点
具体特点
特点1:不是标准 Gym 环境,而是 "自己既是环境也是 Agent"
传统 RL: Agent (模型) ↔ Environment (外部)
MemPO: Agent Loop 本身就是环境
- "action" = 模型生成的 token 序列
- "observation" = 工具返回的搜索结果
- "reward" = 在轨迹完成后才计算 (不是每步)
特点2:异步状态机设计
ToolAgentLoop 是一个 async 状态机,每个请求独立运行:
- PENDING: 编码初始 prompt
- GENERATING: 调用 SGLang 生成 (停在 )
- PROCESSING_TOOLS: 调用工具 (搜索 / 访问)
- TERMINATED: 生成完毕
特点3:工具系统 = 外部 RAG 服务
python
# search_tool_config_local.yaml
tools:
    - class_name: verl.tools.search_tool.SearchTool
      config:
          retrieval_service_url: http://127.0.0.1:8013/retrieve   # 本地 RAG 服务
          rate_limit: 120
          timeout: 30
工具不是模拟的 --- 它调用真实的 dense retrieval 服务 (基于 e5-base-v2 + Faiss),返回 Wikipedia 检索结果。
特点4:关键差异:环境不提供中间奖励
传统 RL 环境:每步给 reward (r_t)
MemPO 环境:仅在 episode 结束后给 1 个 reward (答对 1, 答错 0) → 这就是为什么需要 GRPO 来做信用分配
特点5:停止词机制替代 action space 定义
python
sep_list = ["</search>", "</access>", ""]
# SGLang 遇到这些 token 就停止生成
# 相当于 "环境接管控制权"
模型的 action space 是连续的 token 序列,而不是离散动作。环境通过停止词来 "截断" 模型输出并注入工具结果。
特点6:response_mask 区分训练 / 非训练 token
python
# 模型生成 → mask = 1 (有梯度)
agent_data.response_mask += [1] * len(agent_data.response_ids)
# 工具返回 / 用户输入 → mask = 0 (无梯度)
agent_data.response_mask += [0] * len(response_ids)
特点7:记忆收集嵌入在环境循环中
环境在每轮生成后自动收集 full_traj 和 mem_traj,这不是一个独立组件,而是嵌入在状态机的 _handle_generating_state 中。
与标准 RL 环境的对比
| 维度 | 标准 Gym | MemPO 环境 |
|---|---|---|
| 接口 | step(action) → obs, reward, done | 异步状态机,无显式接口 |
| Action | 离散 / 连续有限维 | 变长 token 序列 |
| Observation | 固定维度向量 | 变长文本 (工具结果) |
| Reward | 每步 / 每 episode | 仅 episode 结束 |
| 并发 | 单环境 / VecEnv | 异步并发 (批量 rollout) |
| 实现 | 独立包 | 嵌入在训练框架中 |
总结
MemPO 的环境不是独立的外部模拟器,而是一个紧耦合在训练循环中的异步 Agent Loop。它的核心创新是:
- 用 SGLang 停止词 模拟 "环境暂停 → 注入观测 → 继续" 的交互
- 用 response_mask 区分 "agent 行为" 和 "环境反馈"
- 在循环中原地收集记忆对比数据 (full_traj/mem_traj)
6.2 两套环境
MemPO 实际上有两套完全不同的环境,它们独立实现、独立运行,具体如下(下面把RAG单独列了出来):
训练环境                          评估环境
──────────────────              ──────────────────
Docker: verlai/verl:...         conda: mempo-eval
RAG server: port 8013           RAG server: port 8002
检索器:e5-base-v2+faiss         检索器:e5-base-v2+faiss
语料:wiki-18 (Search-R1)        语料:ASearcher-Local-Knowledge
conda env: retriever            +JinaAPI/OpenAI(网页)
详细对比如下:
| 维度 | 训练环境 | 评估环境 |
|---|---|---|
| 入口 | ToolAgentLoop (异步状态机) | AsearcherMemAgent (独立 Agent 类) |
| 框架 | VeRL + Ray + SGLang | 纯 Python + SGLang 推理 |
| LLM 调用 | SGLang 内置 server (权重热更新) | 独立 SGLang server (固定权重) |
| 工具 | verl/tools/search_tool.py (rate limit + Ray) | eval/tools/search_utils.py (直接 HTTP) |
| RAG 端口 | 8013 | 8002 |
| RAG 后端 | 本地 FAISS + E5-base | ASearcher(在线搜索) |
| 输出 | token_ids + log_probs + mask + mem_traj | text 答案 + 评分 |
| 并发 | 批量 (N=16 per question, Ray 分布式) | asyncio 并发 |
| 记忆机制 | 收集 full_traj/mem_traj 用于 mem_reward | AgentMemory.prepare_prompt () 主动截断 |
| 上下文窗口 | 固定截断 (max_response_length) | 滑动窗口(只保留最近1轮) |
| 停止词 | , | , , |
| 多轮上限 | 8 turns (max_assistant_turns) | 64 turns (max_turns) |
| 工具结果 | 最多2000 token(截断左侧) | 每篇5000字(取topk=5) |
| 响应长度 | 4096 token (max_response_length) | 模型最大输出(无硬限制) |
| 并发数 | 120 workers | 按评估脚本并发数 |
为什么需要两套独立环境?
- 训练环境需要梯度信息:必须记录每个 token 的 log_prob、维护 response_mask、与 PPO 紧耦合
- 评估环境需要真实截断:模拟部署场景,验证 在信息缺失时是否有效
- RAG 数据可能不同:训练用 Wikipedia,评估可能用不同知识库
- 并发模式不同:训练需要 Ray 分布式 + 批量 rollout; 评估只需 asyncio
6.3 训练环境
训练环境的关键特点
python
# tool_agent_loop.py - 状态机
# 特点:
# - 模型权重在训练中持续更新 (SGLang server 支持热更新)
# - 每个 token 的 log_prob 被记录 (用于 PPO ratio)
# - response_mask 标记哪些 token 参与梯度
# - 原地收集 mem_traj/full_traj (用于 memory reward)
# - 不截断上下文 - 模型看到全部历史
具体可以参见下图:

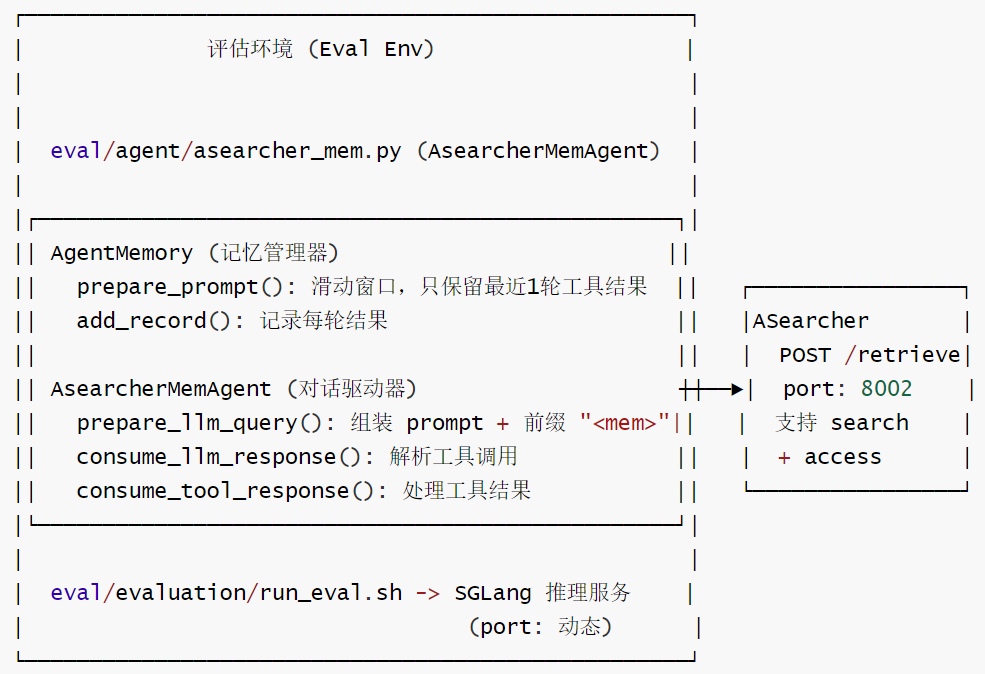
6.4 评估环境
评估环境的关键特点
# eval/agent/asearcher_mem.py - AgentMemory
class AgentMemory:
    def prepare_prompt(self):
        # 关键差异!只保留:
        # 1. system prompt + question (初始)
        # 2. 最近一轮的 search/webpage (short_text 版)
        # 3. 所有 llm_gen 以 "<mem>" + text 形式注入
        # 这就是 A5 的评估截断逻辑
        prompt_text += "<mem>" # 强制以 <mem> 开头
评估环境的核心设计:
- short_text 而非 text (搜索结果被压缩)
- 历史只保留最近一轮工具结果
- 作为前缀注入,模型必须依赖记忆摘要
具体参见下图:
6.5 RAG 服务 (两套独立进程)
训练 RAG (port 8013):
- conda env: retriever
- 模型: e5-base-v2
- 索引: Flat index on Wikipedia
- 启动: bash sglang_multiturn/retrieval_launch.sh
评估 RAG (port 8002):
- conda env: mempo-eval
- 模型: e5-base-v2
- 索引: inclusionAI/ASearcher-Local-Knowledge
- 启动: bash eval/scripts/launch_local_server.sh
6.6 小结
训练环境 vs 评估环境的本质差异
训练时:
- 模型输入 =
[system][Q][round1_full][tool_result_full][round2_full]... - 完整上下文 → 模型 "可以看到一切"
- 但必须学会写 (因为 validate_format 强制)
评估时:
- 模型输入 =
[system][Q][last_tool_short_text] + "<mem>" - 截断上下文 → 模型 " 只能看到 "
- 如果训练时没学会写好 ,评估时就无法正确回答
这个 gap 就是 memory reward 的训练信号来源
