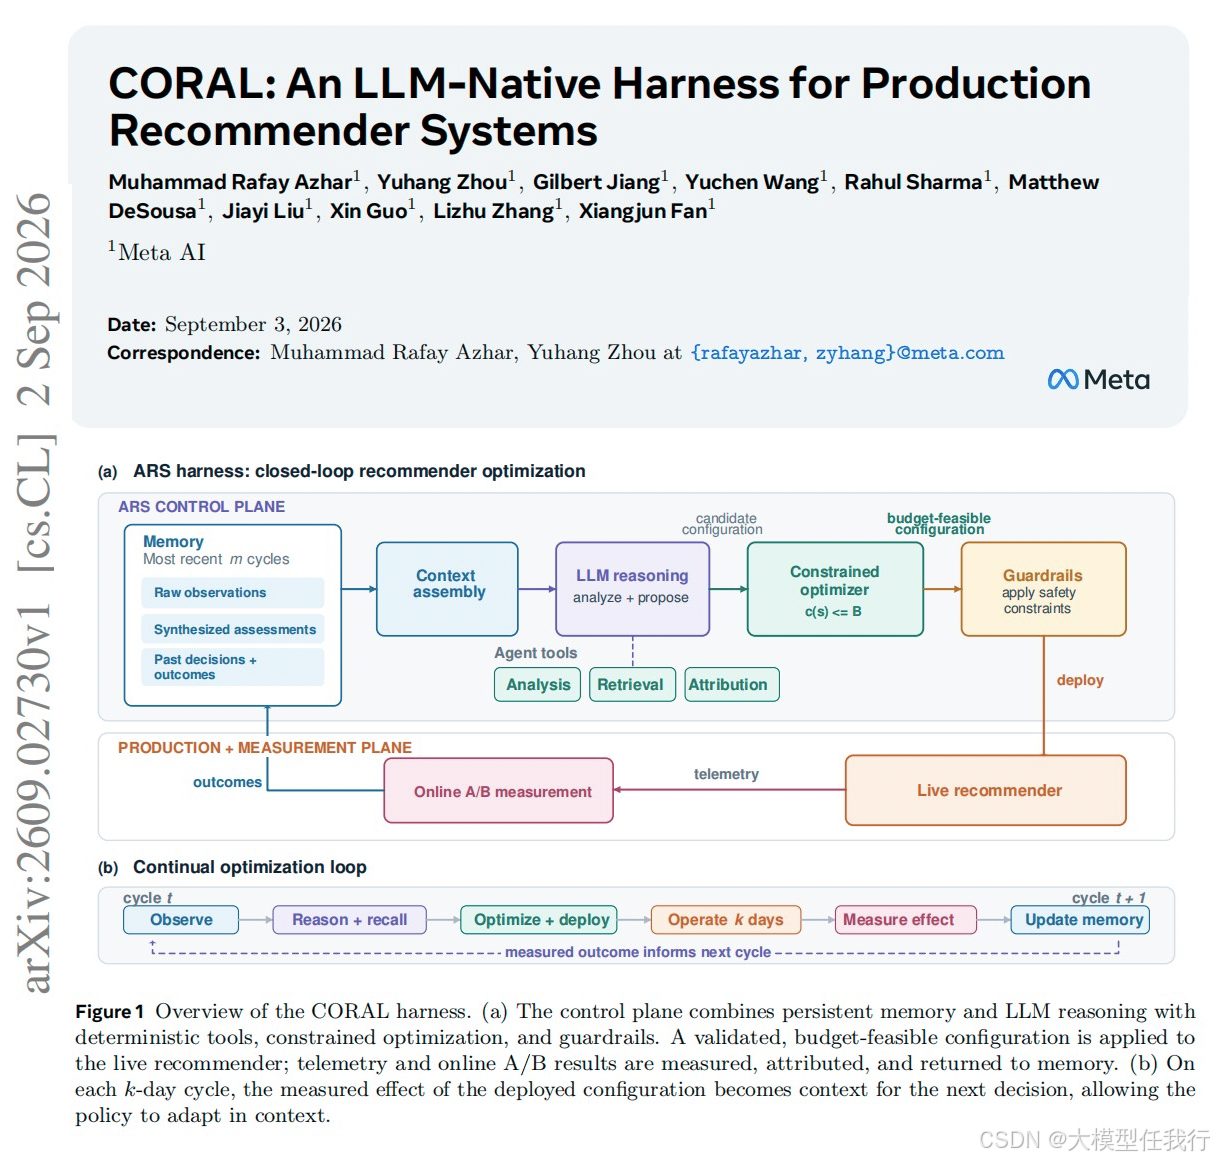
📖标题:CORAL: An LLM-Native Harness for Production Recommender Systems
🌐来源:arXiv, 2609.02730v1
🛎️文章简介
🔸研究问题:传统推荐系统的参数调整依赖工程师手动实验,反应慢且受限于人力,如何让它像自动驾驶一样实时自我优化?
🔸主要贡献:论文提出了CORAL框架,利用大语言模型构建闭环代理,自动观察数据、调整推荐系统配置并从结果中学习,无需重新训练模型。
📝重点思路
🔸构建闭环代理架构:CORAL将通用大语言模型置于一个包含记忆、工具和固定节奏的闭环中。每个周期,代理观察系统运行信号,结合过去的决策记忆进行推理,提出配置更改建议。
🔸引入约束优化工具:为确保建议可行,系统配备数值优化器作为工具。LLM负责定性分析和策略提出,优化器负责将建议投影到满足预算限制的可行范围内,保证每次变更都符合运营成本约束。
🔸建立持久化记忆机制:系统维护观察存储、评估存储和决策存储。代理不仅看当前数据,还回顾过去几个周期的决策及其归因效果,从而在上下文中不断修正策略,适应非平稳的环境变化。
🔸定义部分可观测优化问题:将推荐系统调优建模为部分可观测、非平稳的约束优化问题。代理的目标不是寻找单一最优解,而是通过最小化累积差距,使配置始终跟随动态变化的最佳操作点。
🔎分析总结
🔸提升参与度且零额外成本:在视频推荐场景中,CORAL通过重新分配检索预算,在不增加服务成本的情况下,使所有用户的观看会话增加了0.16%,总观看时长增加0.15%。
🔸改善低信号用户体验:针对新用户和行为数据稀疏的低信号用户,代理能自动调整策略,将预算倾斜至更依赖当前上下文而非历史数据的检索源,使这类用户的会话量提升0.23%。
🔸显著节省计算资源:在服务容量分配场景中,代理通过降低低收益用户段的计算强度,在保持参与度不变的前提下,大幅节省了年度计算支出,并能在后续迭代中进一步扩大节省范围。
🔸决策能力随迭代进化:实验显示,代理的决策并非一开始就完美,但能通过A/B测试反馈自我修正。从零样本提议到经过几轮循环后的部署配置,效果逐步提升,证明了其在线学习能力。
💡个人观点
论文没有让LLM直接去生成推荐内容或训练模型,而是让LLM扮演"系统管理员"的角色,"人在回路"逐渐转向"自动护栏"的模式。