本系列博客基于一个真实可运行的电商评论舆情分析项目。
上一篇:《第1篇:电商评论舆情分析系统:从 0 到 1 的架构设计与数据流》
一、痛点开场
让模型"返回 JSON"很容易,但让模型稳定返回字段齐全、枚举合法、类型正确的 JSON 很难。
新手常见的做法是:
python
result = llm.invoke("请分析这条评论的情感,返回 JSON")
text = result.content
data = json.loads(text)   # 祈祷它真的是合法 JSON
sentiment = data["sentiment_label"]   # 祈祷字段名真的叫这个
然后你就会遇到:输出里混着解释文字、字段名从 sentiment_label 漂移成 label、情感值变成 "Positive" 而不是 "positive"、score 变成字符串......每个问题都在运行时爆炸。
这篇讲我的解法:Pydantic Schema + with_structured_output(method="function_calling") + 统一模型工厂。
二、核心思路:把输出契约变成代码
结构化输出的本质是:先定义"模型必须返回什么",再让模型按这个契约输出。
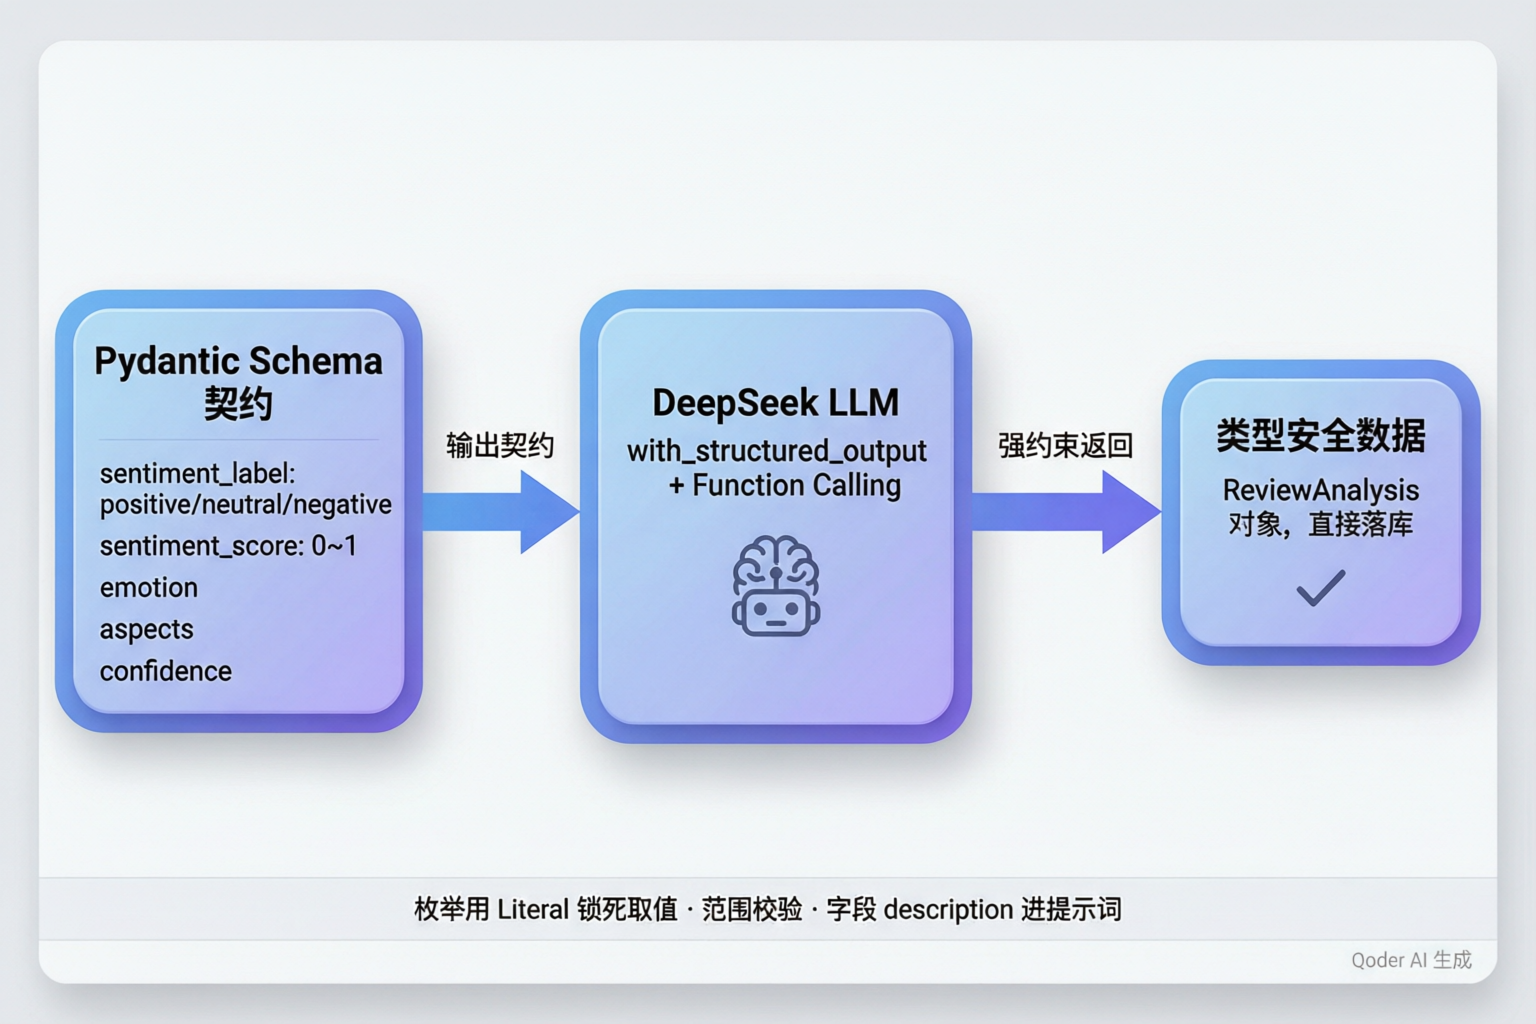
在 LangChain 中,llm.with_structured_output(schema, method="function_calling") 会把 Pydantic Schema 转成函数调用参数,强制模型按 schema 输出,返回的就是 BaseModel 对象------不需要再手写 JSON 解析。
三、Schema 设计:ReviewAnalysis
这是情感分析的目标输出结构(backend/schemas/review.py):
python
from pydantic import BaseModel, Field
from typing import Literal, List


class AspectScore(BaseModel):
    name: str = Field(description="属性名,如 物流/价格/质量/客服")
    sentiment: Literal["positive", "neutral", "negative"]
    score: float = Field(ge=0.0, le=1.0)
    mentions: List[str] = Field(default_factory=list, description="原文证据片段")


class ReviewAnalysis(BaseModel):
    sentiment_label: Literal["positive", "neutral", "negative"]
    sentiment_score: float = Field(ge=0.0, le=1.0)
    emotion: Literal["angry", "disappointed", "regret", "satisfied", "praising", "neutral"]
    aspects: List[AspectScore] = Field(default_factory=list)
    summary: str = Field(description="一句话摘要")
    confidence: float = Field(default=0.9, ge=0.0, le=1.0)
关键点:
- 枚举用
Literal:情感、情绪都锁死取值,模型想输出"Positive"都会校验失败 - 分数用
Field(ge=0, le=1):范围越界直接报错 mentions保留原文证据片段:为后续"验证模型没说谎"留了钩子- 字段都有
description:这部分会进提示词,指导模型理解每个字段含义
四、统一模型工厂:LLMFactory
如果每个 Agent 各自 init_chat_model,后面切模型、统一超时、统一熔断都会失控。所以项目用 LLMFactory 收口(backend/core/llm_factory.py):
python
class LLMFactory:
    _instances: dict[str, BaseChatModel] = {}
    _failure_count: dict[str, int] = {}
    _circuit_open_until: dict[str, datetime] = {}
    _lock = threading.Lock()

    @classmethod
    def get_structured_llm(cls, agent_type, output_schema, temperature=0):
        llm = cls.get_llm(agent_type, temperature=temperature, thinking="disabled")
        return llm.with_structured_output(output_schema, method="function_calling")
模型按 (agent_type → model_key, temperature, streaming) 缓存实例,避免每次请求重复初始化:
python
cache_key = f"{model_key}_{temperature}_{streaming}"
if cache_key not in cls._instances:
    llm = init_chat_model(**kwargs)
    cls._instances[cache_key] = llm
return cls._instances[cache_key]工厂还内置了熔断保护 :某个 agent_type 连续失败达到阈值后,临时拒绝调用(llm_circuit_breaker_threshold),给外部 LLM 服务喘息时间,避免雪崩:
python
def _check_circuit(cls, agent_type):
    until = cls._circuit_open_until.get(agent_type)
    if until and until > now:
        raise RuntimeError(f"LLM circuit open for {agent_type}, retry in {remaining}s")
五、在 Agent 节点里使用
情感分析节点(backend/agents/sentiment/nodes.py)的调用方式:
python
from backend.core.llm_factory import get_structured_llm
from backend.schemas.review import ReviewAnalysis

# 获取绑定 Schema 的结构化模型
structured_llm = get_structured_llm("sentiment", ReviewAnalysis)

# 每条评论调用
messages = [
    SystemMessage(content=SYSTEM_PROMPT),
    HumanMessage(content=build_user_prompt(review)),
]
try:
    result = await structured_llm.ainvoke(messages)   # result 是 ReviewAnalysis 对象
    analysis = result.model_dump()
    analysis["model_name"] = "deepseek"               # 标记来源
except Exception as e:
analysis = _heuristic_analyze(review) # 降级词典规则注意这里没有 json.loads ------ainvoke 返回的就是 ReviewAnalysis 实例,model_dump() 直接得到字典。模型输出与 Python 类型之间由 LangChain 的 function calling 桥接。
六、为什么 "请返回 JSON" 不可靠
| 问题 | 现象 | 结构化输出解法 |
|---|---|---|
| 输出混入解释文字 | "好的,分析结果如下:{...}" |
function calling 只取工具参数 |
| 字段名漂移 | sentiment_label 变 label |
Schema 锁定字段名 |
| 枚举不合法 | "Positive" / "负面" |
Literal 校验 |
| 类型错误 | score 是字符串 | Pydantic 强类型 |
| 字段缺失 | 没返回 summary | Schema 必填字段校验 |
七、重要提醒:Schema 通过 ≠ 语义正确
结构化输出只解决"长得像不像",不解决"说得对不对"。
- Schema 校验通过,不代表
mentions真的来自原文 - 不代表
sentiment_label真的符合评论语义 - 不代表根因、摘要没有幻觉
所以项目里做了三层防线:
- Schema 层:字段、类型、枚举、范围
- 业务层 :
mentions需在原文中出现、簇大小与统计一致、数字与数据库核对 - HITL 层:低置信度(< 0.75)结果进人工复核队列
这也是下一篇的主题。
八、踩坑记录
- cache key 维度 :早期把
thinking也放进 cache key,导致实例漂移;后来简化成(model_key, temperature, streaming),thinking通过extra_body传入 max_retries=0:工厂层故意关闭自动重试,把重试策略交给上层统一控制(避免重试风暴)trust_env=False:关闭代理环境变量干扰,保证base_url精确可控- HTTP client 共享 :
_HTTP_ASYNC_CLIENT全局复用,注意应用关闭时要释放
九、总结
- 用 Schema 定义输出契约,把"模型输出"变成"类型安全的数据"
- 用工厂统一模型,路由、缓存、熔断、超时一处管理
- 结构化 ≠ 正确,业务校验和 HITL 必须跟上
下一篇预告:《大模型系统的保命设计:LLM 失败降级 + HITL 人工复核闭环》