文章目录
-
- 一、痛点场景:凌晨三点的服务器惊魂夜
- 二、解决方案:psutil登场
- 三、psutil是什么
-
- [3.1 官方定义](#3.1 官方定义)
- [3.2 核心能力矩阵](#3.2 核心能力矩阵)
- [3.3 一个最简单的例子](#3.3 一个最简单的例子)
- 四、为什么选择psutil
-
- [4.1 跨平台一致性](#4.1 跨平台一致性)
- [4.2 结构化数据,告别正则](#4.2 结构化数据,告别正则)
- [4.3 可编程性强,可嵌入业务系统](#4.3 可编程性强,可嵌入业务系统)
- [4.4 轻量高效,资源消耗极低](#4.4 轻量高效,资源消耗极低)
- 五、psutil的演进历程
-
- [5.1 诞生期(2009年)](#5.1 诞生期(2009年))
- [5.2 跨平台期(2010-2013年)](#5.2 跨平台期(2010-2013年))
- [5.3 API重构期(2014年)](#5.3 API重构期(2014年))
- [5.4 生态成熟期(2015-2020年)](#5.4 生态成熟期(2015-2020年))
- [5.5 现代化期(2021年至今)](#5.5 现代化期(2021年至今))
- 六、psutil怎么用
-
- [6.1 安装](#6.1 安装)
- [6.2 获取主机信息](#6.2 获取主机信息)
- [6.3 获取开机时间和开机时长](#6.3 获取开机时间和开机时长)
- [6.4 获取当前登录用户](#6.4 获取当前登录用户)
- [6.5 CPU监控详解](#6.5 CPU监控详解)
- [6.6 内存监控详解](#6.6 内存监控详解)
- [6.7 磁盘监控详解](#6.7 磁盘监控详解)
- [6.8 网络监控详解](#6.8 网络监控详解)
- [6.9 进程管理](#6.9 进程管理)
- 七、企业项目实战:自动巡检告警系统
-
- [7.1 项目结构](#7.1 项目结构)
- [7.2 配置文件](#7.2 配置文件)
- [7.3 数据采集模块](#7.3 数据采集模块)
- [7.4 告警通知模块](#7.4 告警通知模块)
- [7.5 主程序入口](#7.5 主程序入口)
- [7.6 定时调度](#7.6 定时调度)
- [八、竞品对比:psutil vs Glances vs top/htop](#八、竞品对比:psutil vs Glances vs top/htop)
- 九、常用场景汇总
-
- [9.1 服务器健康检查接口](#9.1 服务器健康检查接口)
- [9.2 进程守护与自动重启](#9.2 进程守护与自动重启)
- [9.3 资源限流与降级](#9.3 资源限流与降级)
- [9.4 日志文件大小监控](#9.4 日志文件大小监控)
- [9.5 Docker容器资源监控](#9.5 Docker容器资源监控)
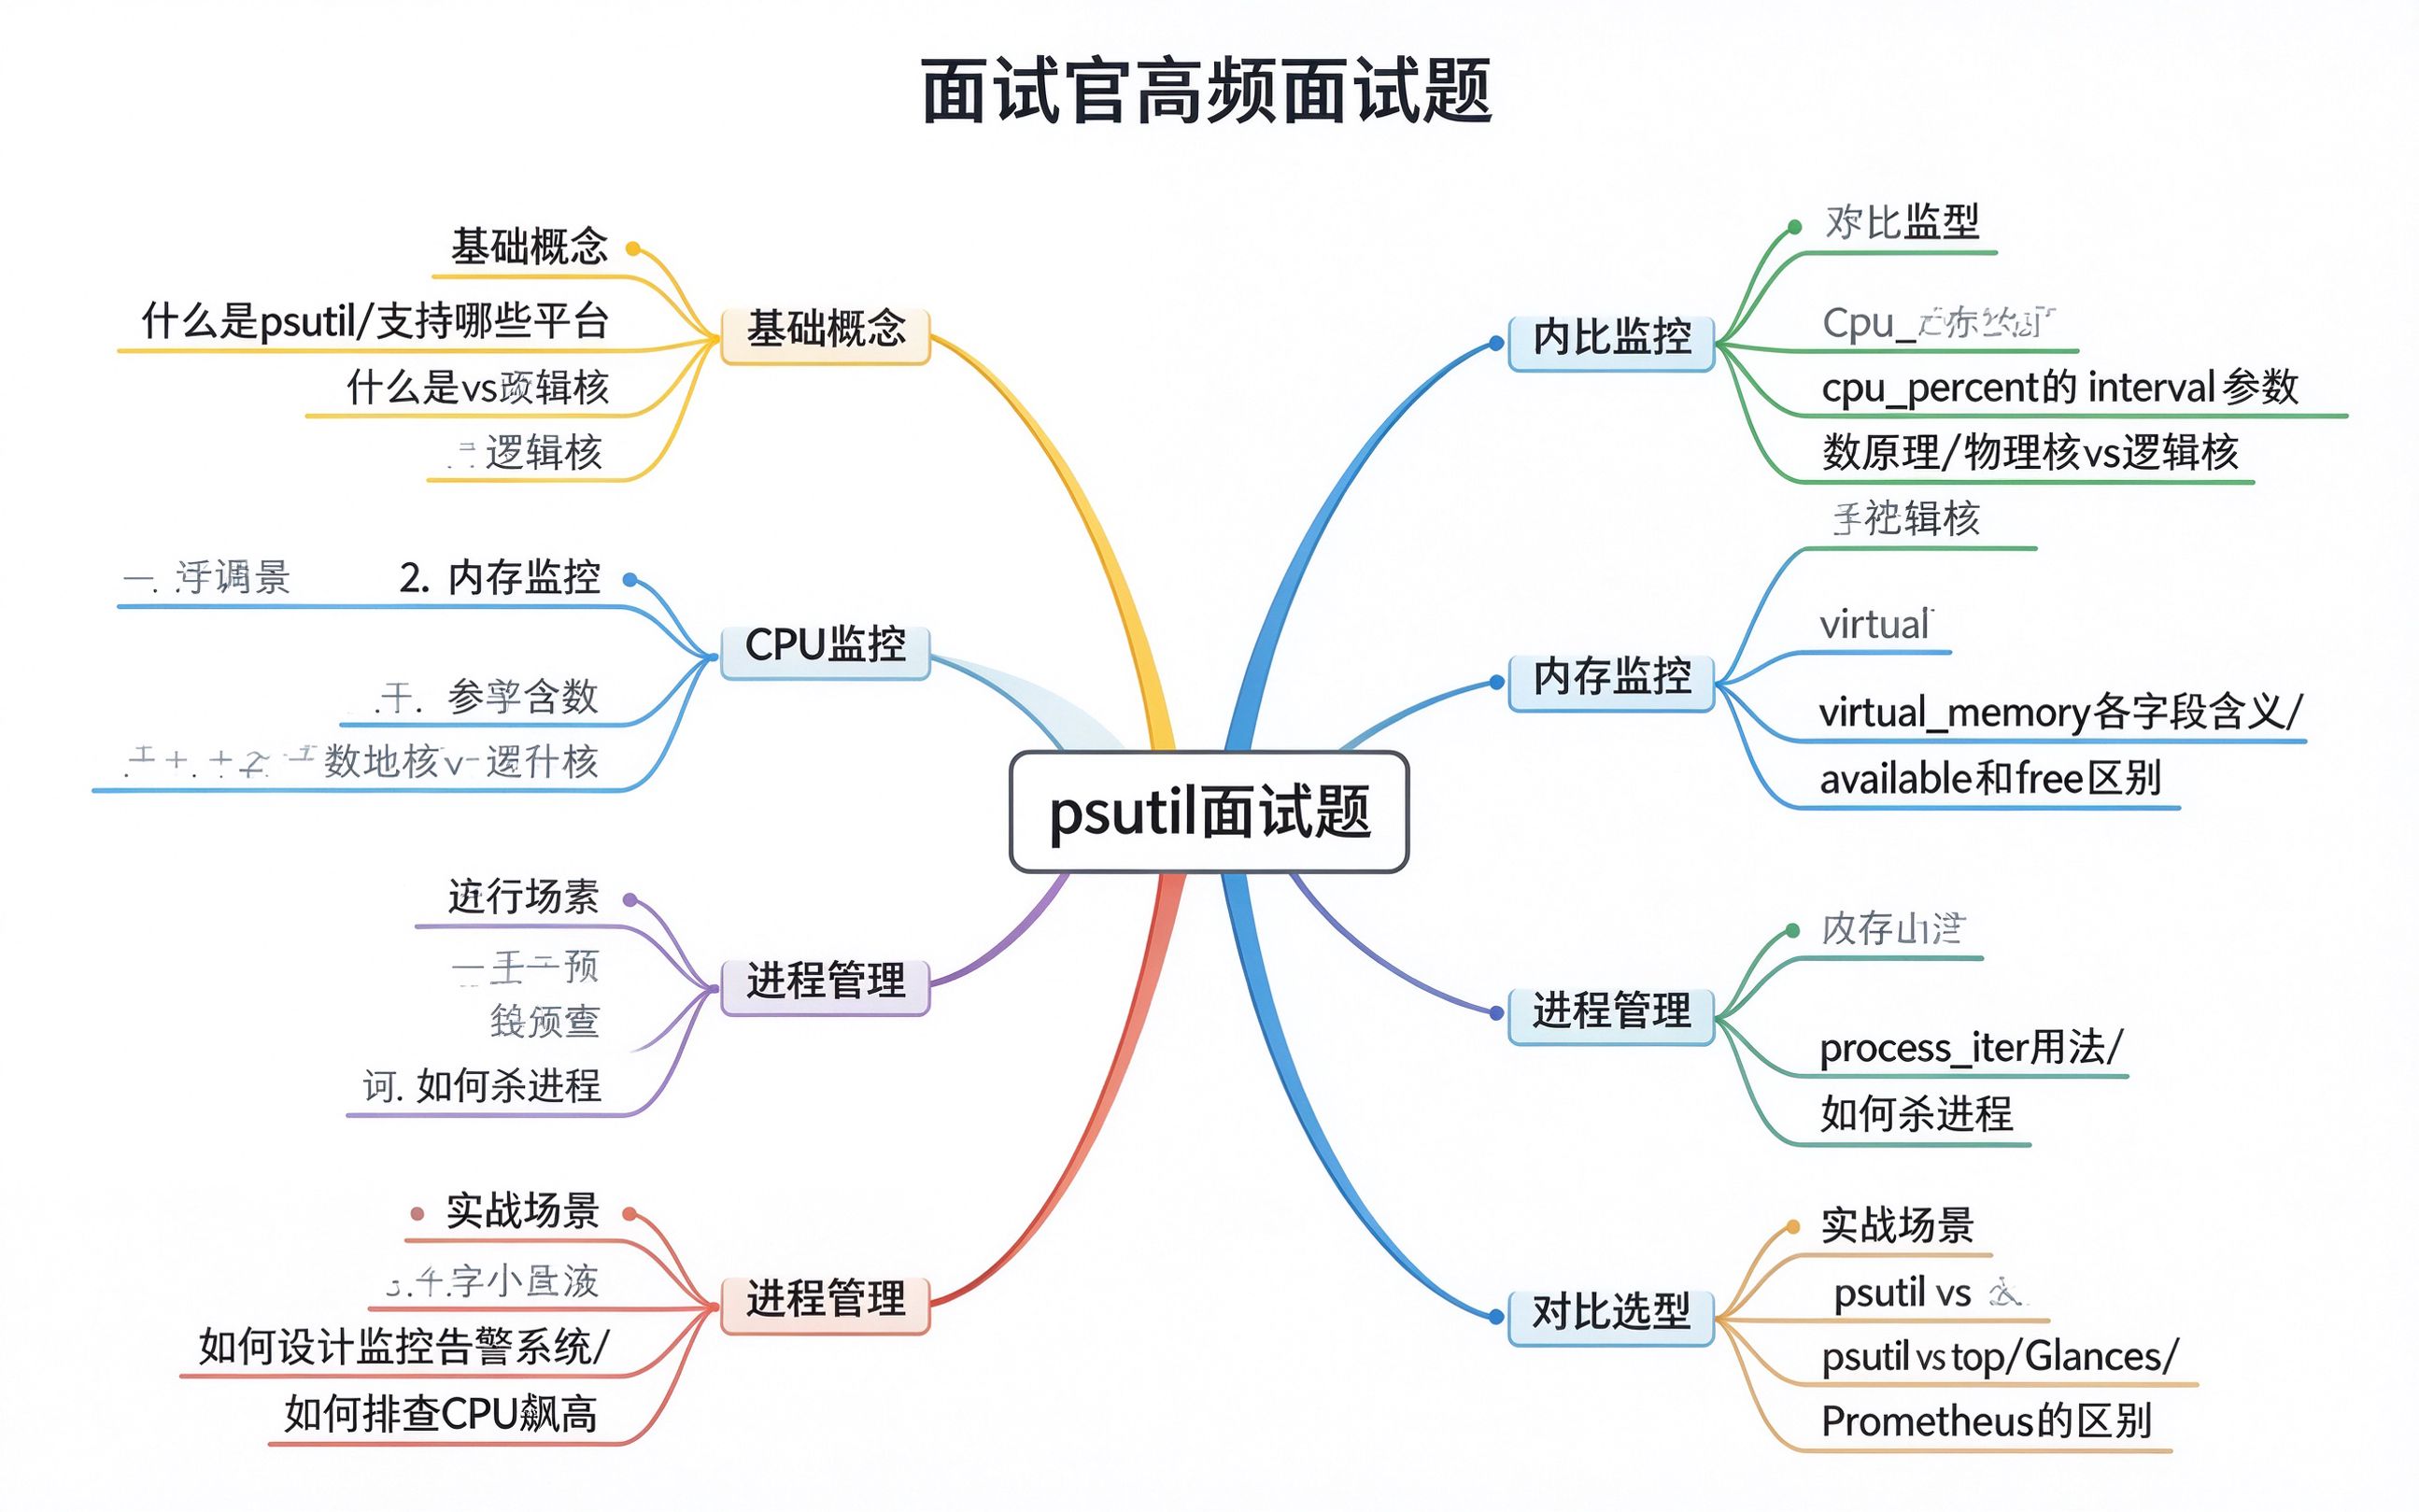
- 十、面试官高频面试题
-
- 面试题一:psutil是什么?它支持哪些平台?
- 面试题二:`cpu_percent(interval=1)`中的interval参数是什么原理?为什么第一次调用返回0.0?
- 面试题三:`virtual_memory()`中的`available`和`free`有什么区别?
- 面试题四:如何用psutil排查CPU使用率飙高的问题?
- 面试题五:psutil和top、Glances、Prometheus有什么区别?各自的适用场景是什么?
- 面试题六:如何设计一个基于psutil的服务器监控告警系统?
- 面试题七:`process_iter()`和`pids()`有什么区别?为什么推荐用`process_iter()`?
- 面试题八:监控磁盘时只看`disk_usage().percent`够吗?还有什么容易忽略的点?
- 十一、总结
一、痛点场景:凌晨三点的服务器惊魂夜
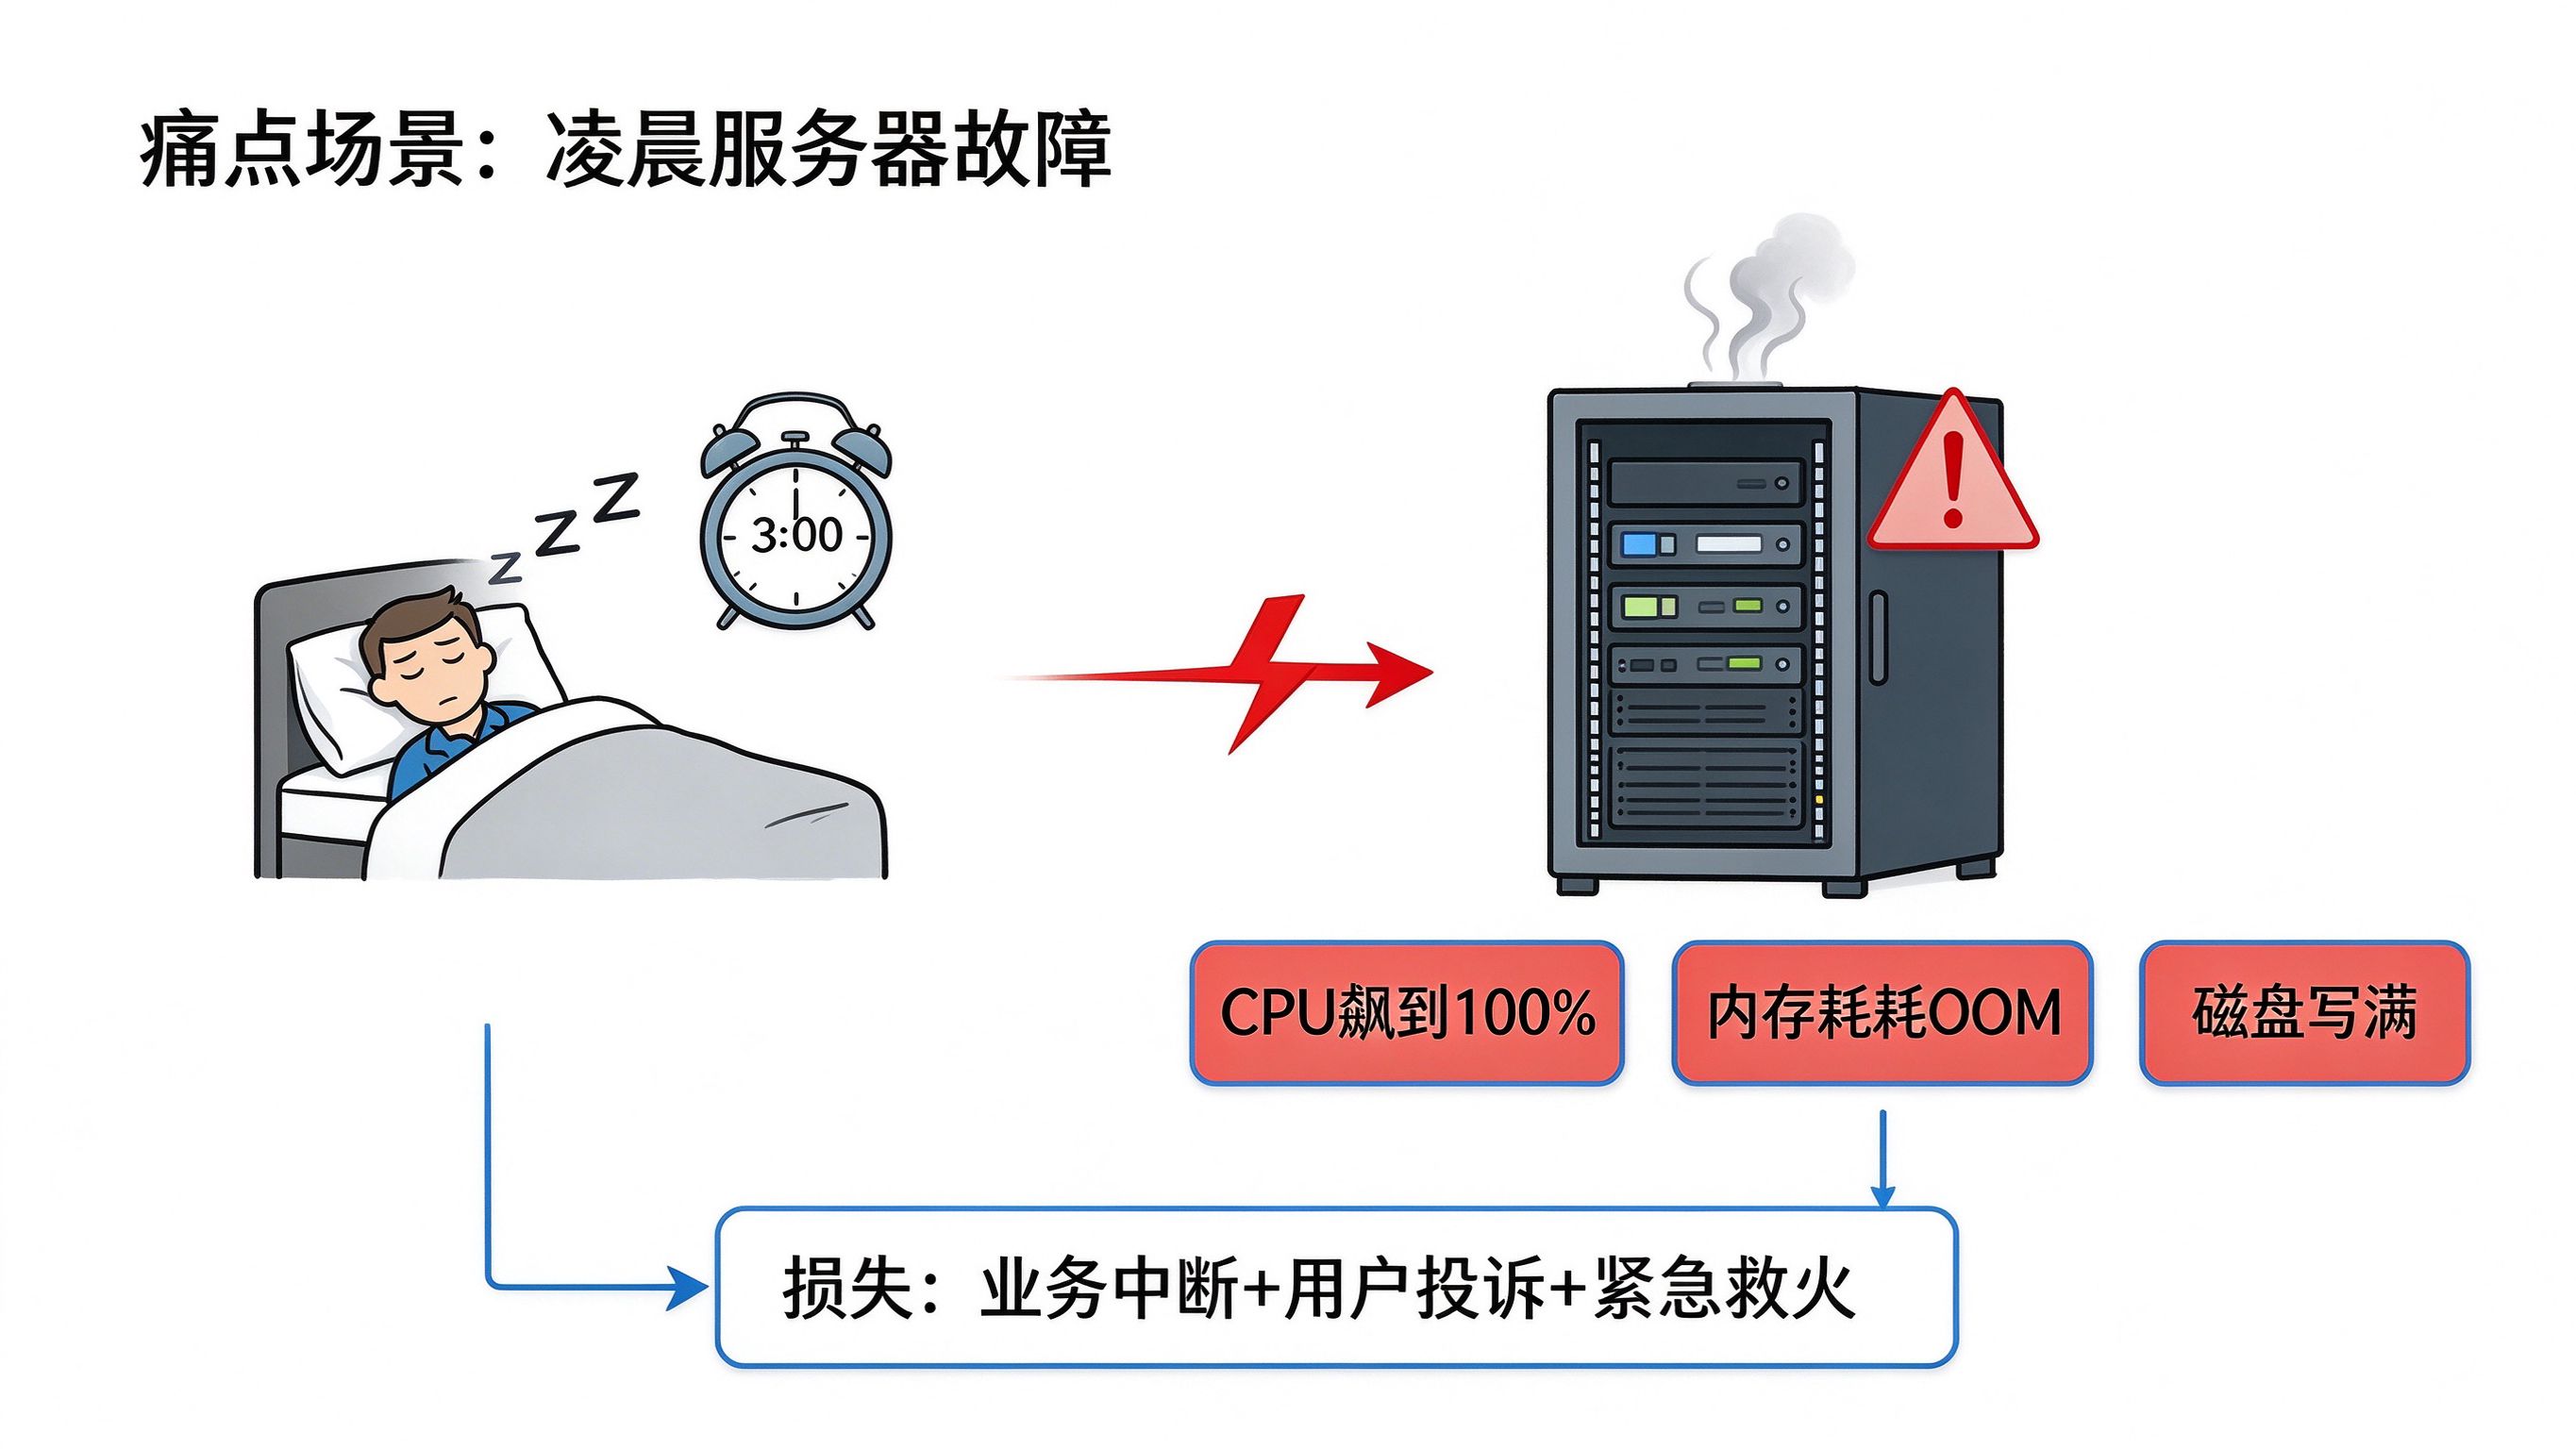
你有没有经历过这样的夜晚?凌晨三点,手机突然响起钉钉告警,你睡眼惺忪地爬起来,发现线上一台核心API服务器已经处于半瘫痪状态。CPU使用率飙到百分之百,内存被吃干耗尽触发了OOM Killer,根分区磁盘也被日志写满,连ls命令都开始报错。业务接口大面积超时,用户投诉像雪片一样飞来,你一边救火一边暗骂:为什么没有一个靠谱的监控系统能提前告诉我这些?
这不是个例。在企业运维场景中,以下几个痛点几乎是每个团队的噩梦:
痛点一:发现即晚期。 传统的人工巡检往往是每天早上看一眼服务器状态,等发现问题时业务已经受损。就像古代守城的士兵,等敌人已经爬上城墙才敲警钟,为时已晚。
痛点二:命令碎片化。 查CPU用top,查内存用free,查磁盘用df,查网络用netstat,查进程用ps。十几个命令来回切换,输出格式各不相同,想把数据汇总到一个报表里简直是一场灾难。
痛点三:无法自动化。 Shell脚本虽然能做一些简单的采集,但解析命令输出、处理异常、跨平台兼容,每一项都是坑。想写一个自动告警的脚本,往往比写业务代码还费劲。
痛点四:历史数据丢失。 top和htop只能看实时状态,关掉终端数据就没了。想回溯昨天凌晨两点CPU为什么飙高,只能靠猜。
正如《黄帝内经》所言:"上工治未病,不治已病。" 监控的最高境界,是在故障发生之前就发现端倪,而不是等服务挂了再去救火。那么,有没有一把瑞士军刀,能把这些痛点一次性解决?答案就是------psutil。
二、解决方案:psutil登场
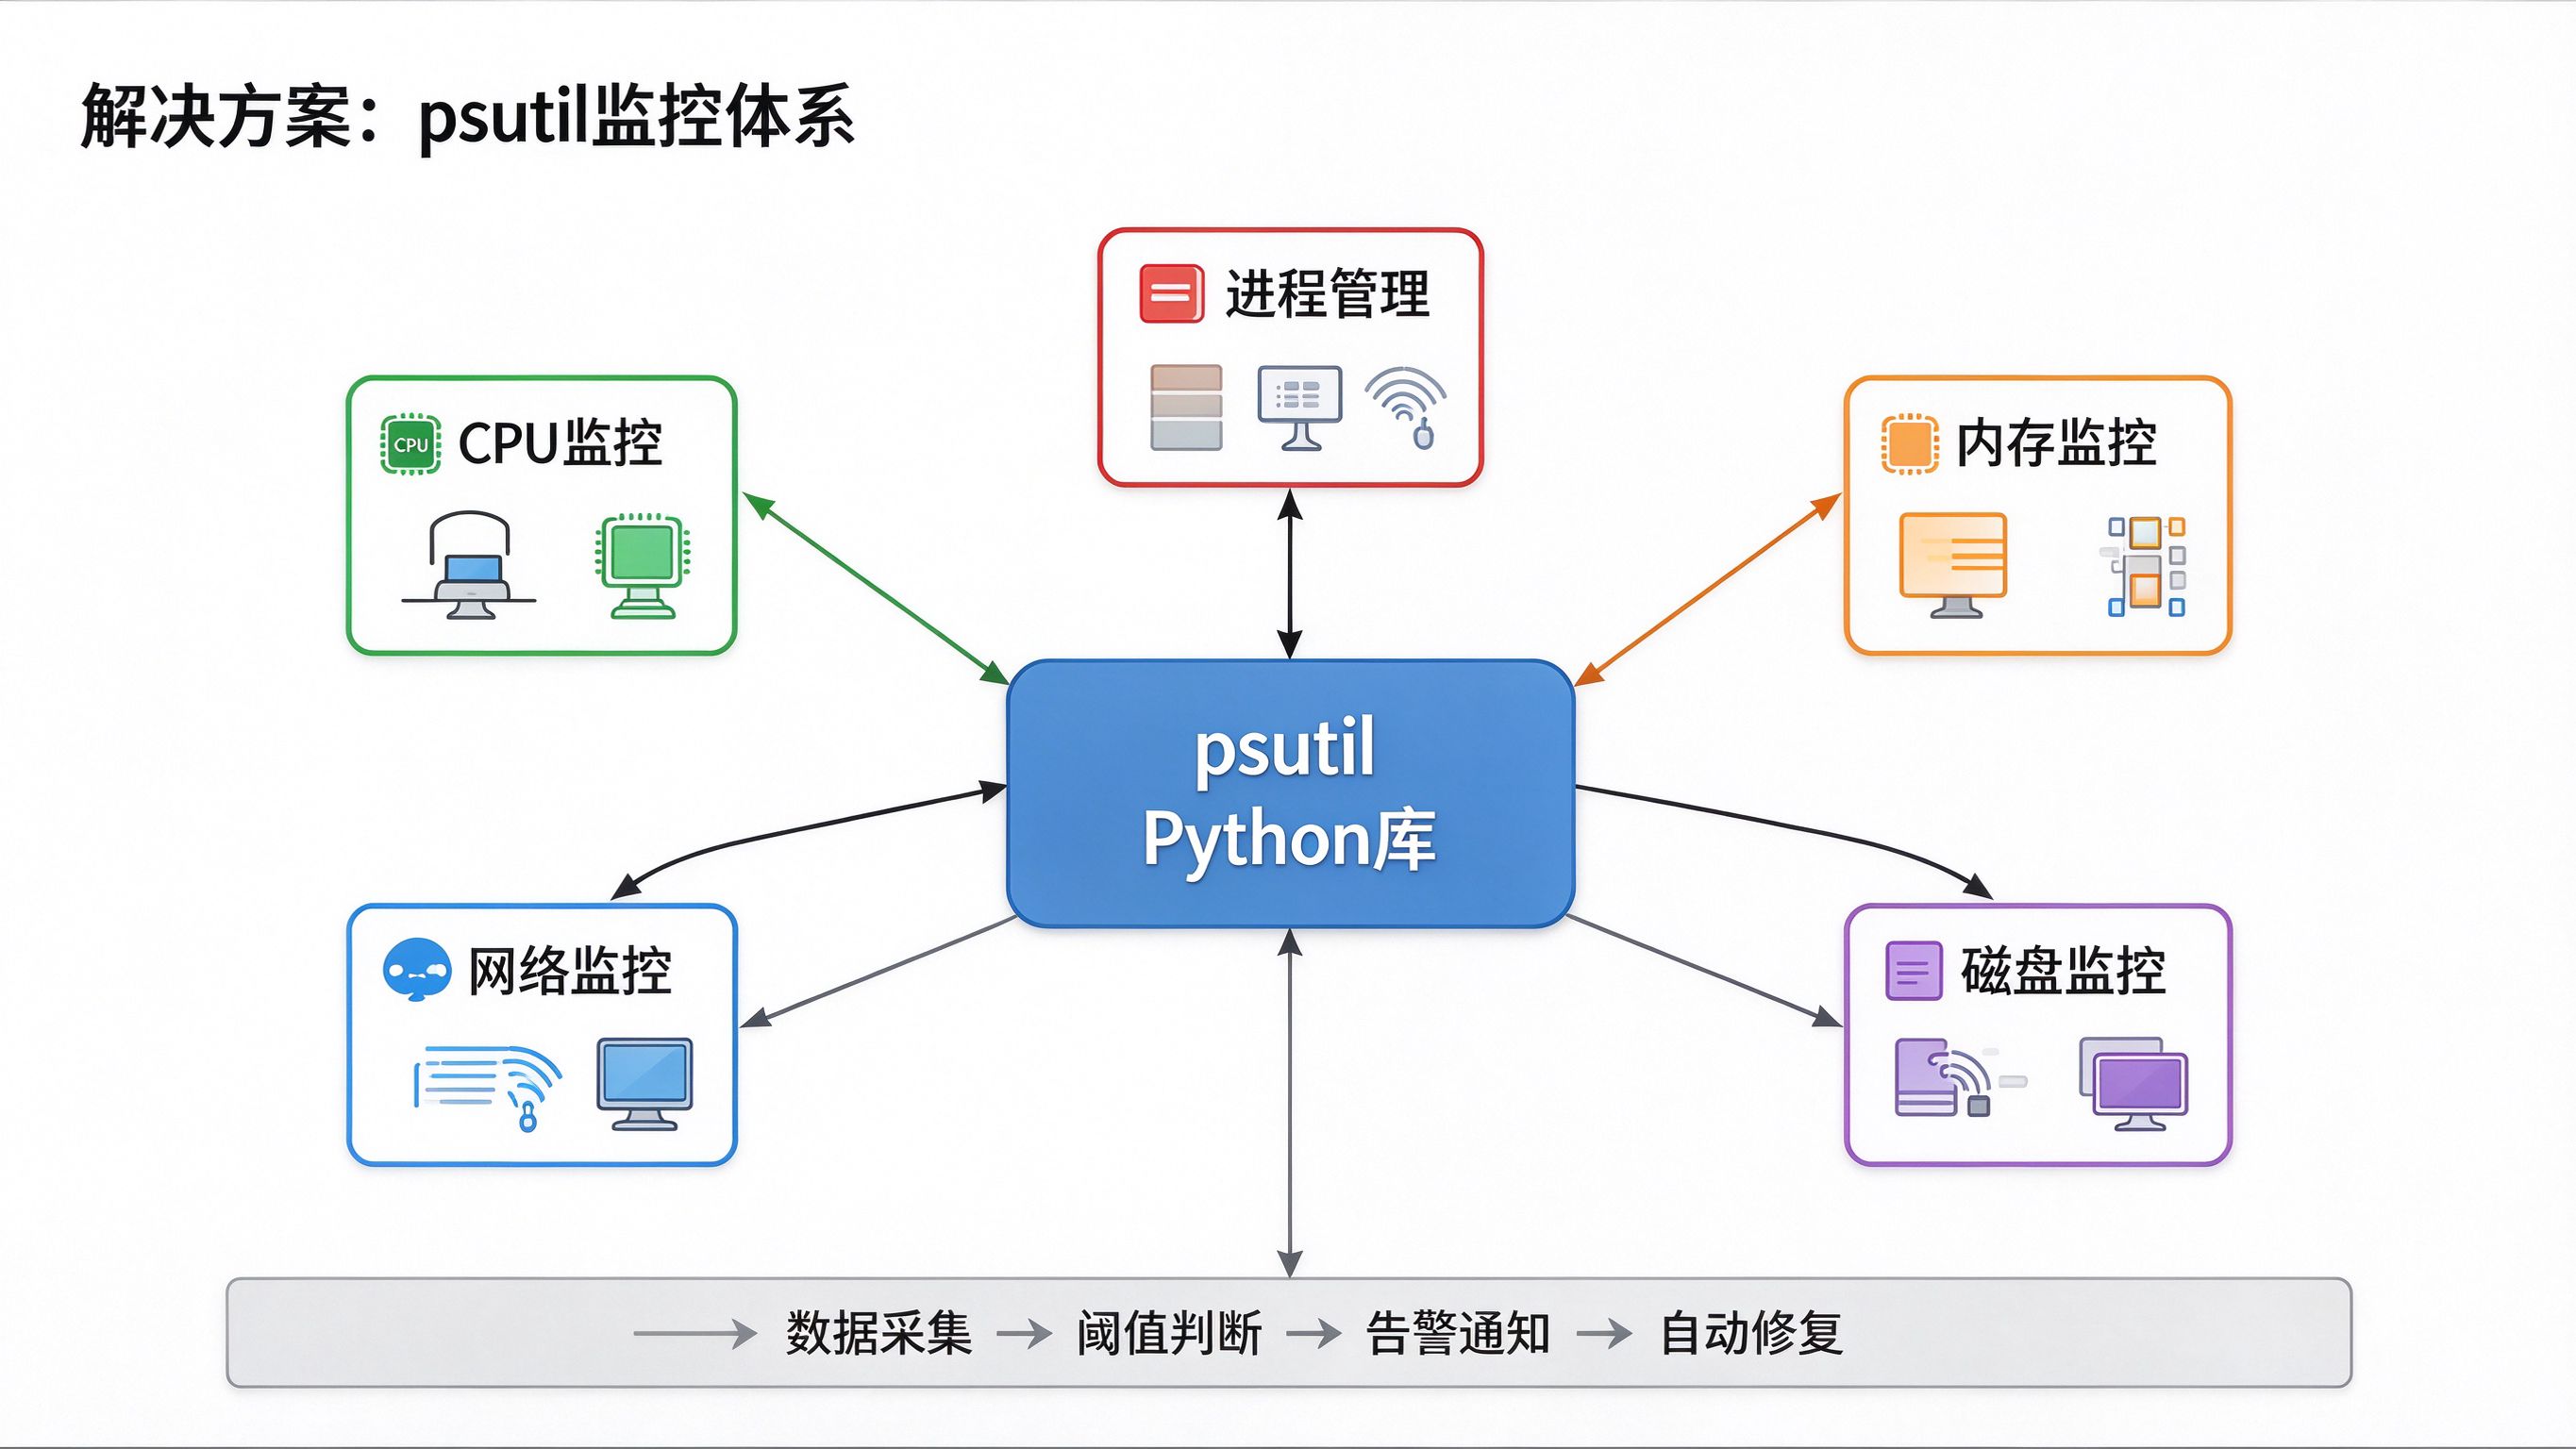
psutil(Process and System Utilities)是一个Python第三方库,它的核心价值可以用一句话概括:用统一的Python接口,获取系统运行的一切关键指标。
它就像给服务器装了一个全面的"体检仪",CPU、内存、磁盘、网络、进程,所有数据都能通过几行Python代码拿到,而且返回的是结构化的数据对象,不是需要正则解析的文本输出。
专业解释
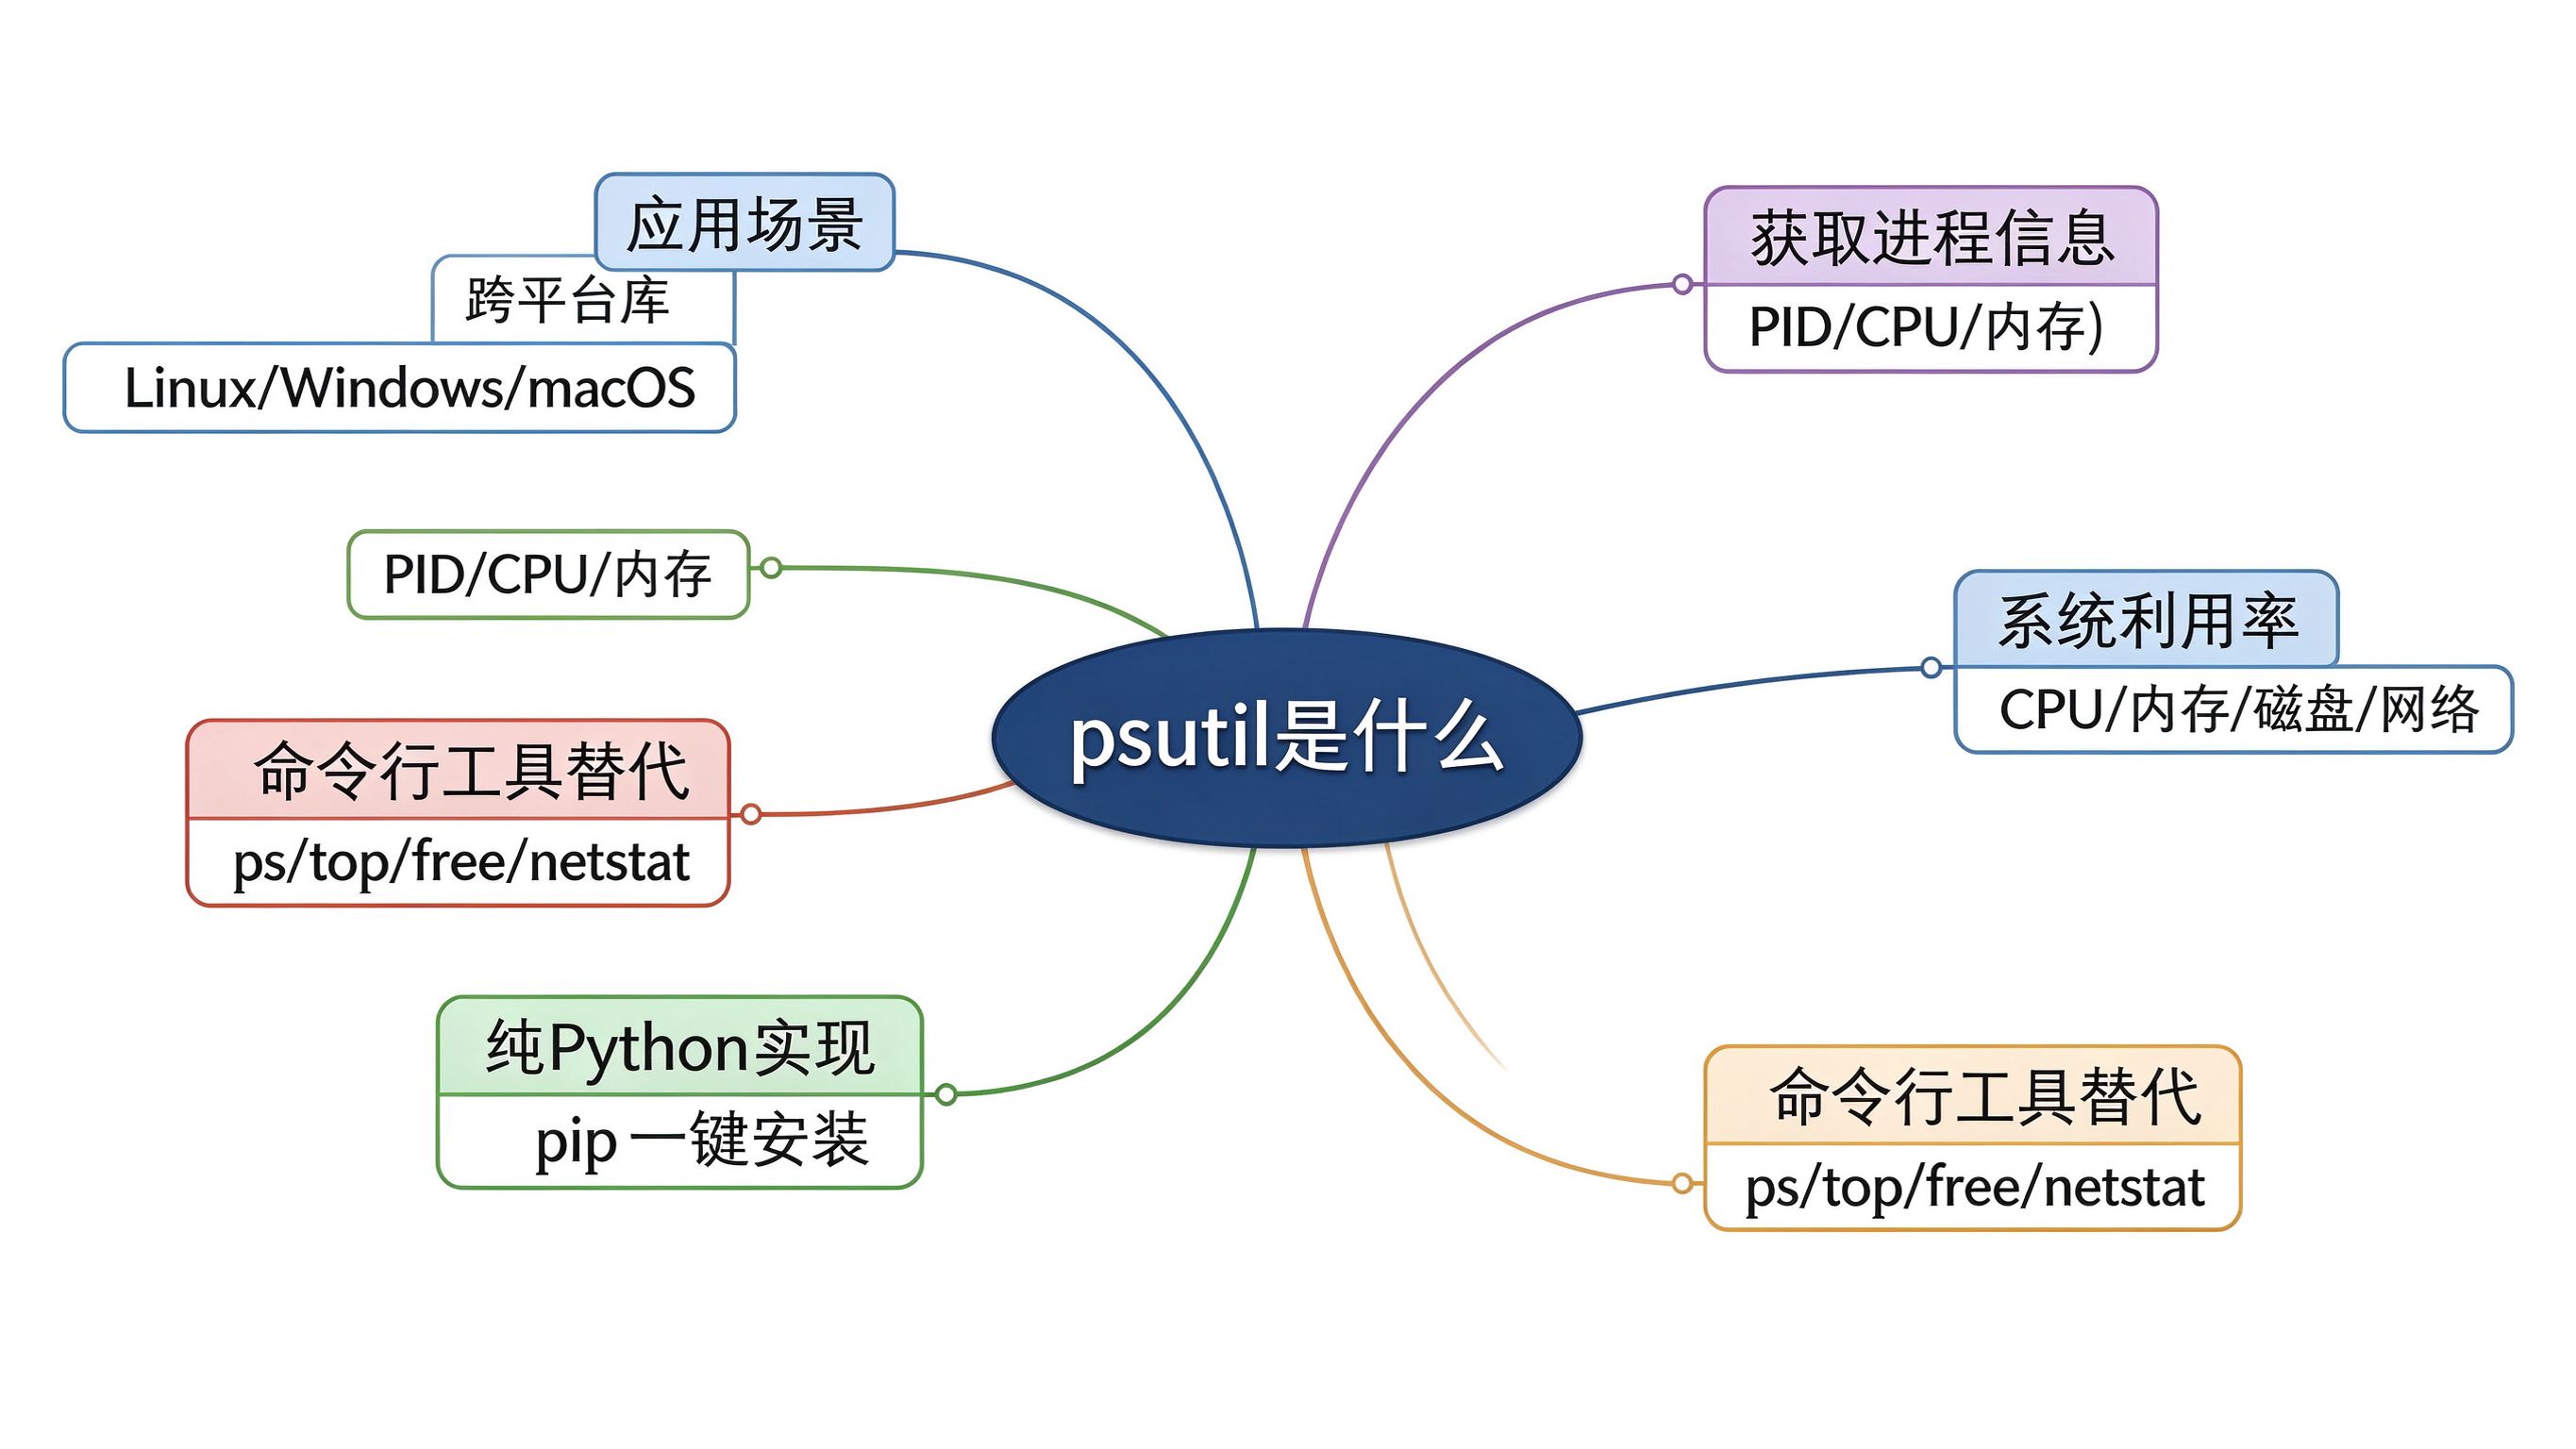
psutil是一个跨平台的Python库,用于检索运行中进程的信息和系统利用率(CPU、内存、磁盘、网络、传感器)。它主要用于系统监控、性能分析、限制进程资源和管理运行中的进程。它实现了经典UNIX命令行工具(如ps、top、iotop、lsof、netstat、ifconfig、free等)提供的许多功能,目前支持Linux、Windows、macOS、FreeBSD、Solaris等主流平台。
大白话
你就把psutil想象成一个"全能翻译官"。以前你要跟Linux操作系统打听服务器状态,得学会十几种方言(top、free、df、netstat......),每种方言的语法还不一样。现在有了psutil这个翻译官,你只用说Python这一种语言,它就能帮你把所有信息都问回来,而且整理得清清楚楚,直接给你结构化的数据,不用你自己再去抠文本。
生活案例
就像你去医院做体检。以前的方式是:测血压去一个科室,抽血去另一个科室,做B超再换一个楼,每个科室给你一张不同格式的报告单,你得自己拼起来看。而psutil就像一个高端体检中心,抽一次血、做一次全身扫描,所有指标(CPU、内存、磁盘、网络)都在一张报告里,数据格式统一,还能自动跟正常范围对比,异常项直接标红。
古代典故
三国时期,诸葛亮北伐中原,最头疼的就是粮草运输和军情传递。蜀道难行,各路斥候回报的消息格式不一、时间不一,常常导致决策延误。如果当时有psutil这样的"统一情报系统",所有前线的粮草消耗、兵力部署、道路状况都用统一格式实时汇总,诸葛亮的北伐或许会是另一番局面。这就是统一接口的力量。
三、psutil是什么
3.1 官方定义
根据psutil官方文档的定义,psutil是一个跨平台库,能够轻松实现获取系统运行的进程和系统利用率信息。它的名字来源于"process and system utilities"的缩写,直译就是"进程与系统工具集"。
3.2 核心能力矩阵
psutil的能力可以分为五大维度:
| 维度 | 核心API | 对应命令行工具 | 能获取什么 |
|---|---|---|---|
| CPU | cpu_percent(), cpu_times(), cpu_count() |
top, mpstat | 使用率、核心数、负载、频率 |
| 内存 | virtual_memory(), swap_memory() |
free, vmstat | 总量、已用、可用、交换分区 |
| 磁盘 | disk_usage(), disk_io_counters(), disk_partitions() |
df, iostat | 分区使用、IO读写、挂载信息 |
| 网络 | net_io_counters(), net_connections(), net_if_addrs() |
netstat, ifconfig, ss | 流量统计、连接状态、网卡地址 |
| 进程 | process_iter(), Process() |
ps, kill, lsof | PID、名称、资源占用、终止进程 |
3.3 一个最简单的例子
先来看一段代码,感受一下psutil的简洁:
python
import psutil

# 获取CPU使用率
cpu_percent = psutil.cpu_percent(interval=1)
print(f"CPU使用率: {cpu_percent}%")

# 获取内存信息
mem = psutil.virtual_memory()
print(f"内存总量: {mem.total / 1024**3:.2f} GB")
print(f"内存已用: {mem.used / 1024**3:.2f} GB")
print(f"内存使用率: {mem.percent}%")

# 获取磁盘使用情况
disk = psutil.disk_usage("/")
print(f"磁盘使用率: {disk.percent}%")
运行输出:
text
CPU使用率: 12.5%
内存总量: 16.00 GB
内存已用: 8.32 GB
内存使用率: 52.0%
磁盘使用率: 67.3%
看到了吗?三行代码拿到三个核心指标,返回的都是可以直接使用的数值,不需要任何文本解析。这就是psutil的魅力。
四、为什么选择psutil
4.1 跨平台一致性
psutil最大的优势之一是跨平台。同样一段代码,在Linux、Windows、macOS上都能运行,返回的数据结构完全一致。对于需要管理混合环境的企业来说,这意味着一套监控代码可以覆盖所有服务器,不用为每个操作系统写不同的逻辑。
python
import psutil
import platform

print(f"当前系统: {platform.system()}")
print(f"CPU核心数: {psutil.cpu_count()}")
print(f"内存总量: {psutil.virtual_memory().total / 1024**3:.2f} GB")
这段代码在任何支持的平台上都能正常工作,这是Shell脚本永远做不到的。
4.2 结构化数据,告别正则
用Shell脚本做监控,最痛苦的部分就是解析命令输出。比如解析free命令的输出:
bash
# Shell方式:需要awk来提取字段
free -m | awk 'NR==2{print "内存使用率: "$3/$2*100"%"}'
而psutil直接返回对象属性:
python
# Python方式:直接访问属性
mem = psutil.virtual_memory()
print(f"内存使用率: {mem.percent}%")
没有正则,没有awk,没有字段偏移,代码可读性和可维护性提升了一个量级。
4.3 可编程性强,可嵌入业务系统
psutil是一个库,不是一个独立工具。这意味着你可以把它直接嵌入到你的Python应用中,在业务代码里实时获取系统状态。比如在一个Web服务中,你可以在每次请求处理时检查当前服务器负载,如果负载过高就自动降级或限流。
python
from flask import Flask, jsonify
import psutil

app = Flask(__name__)

@app.route("/api/health")
def health_check():
    return jsonify({
        "cpu_percent": psutil.cpu_percent(interval=0.5),
        "memory_percent": psutil.virtual_memory().percent,
        "disk_percent": psutil.disk_usage("/").percent,
        "status": "healthy" if psutil.cpu_percent() < 80 else "warning"
    })
4.4 轻量高效,资源消耗极低
psutil本身是用Python加C扩展实现的,采集数据时的资源开销非常小。相比Glances这类完整的监控工具,psutil只做数据采集这一件事,把展示和告警的灵活性完全交给开发者。
五、psutil的演进历程
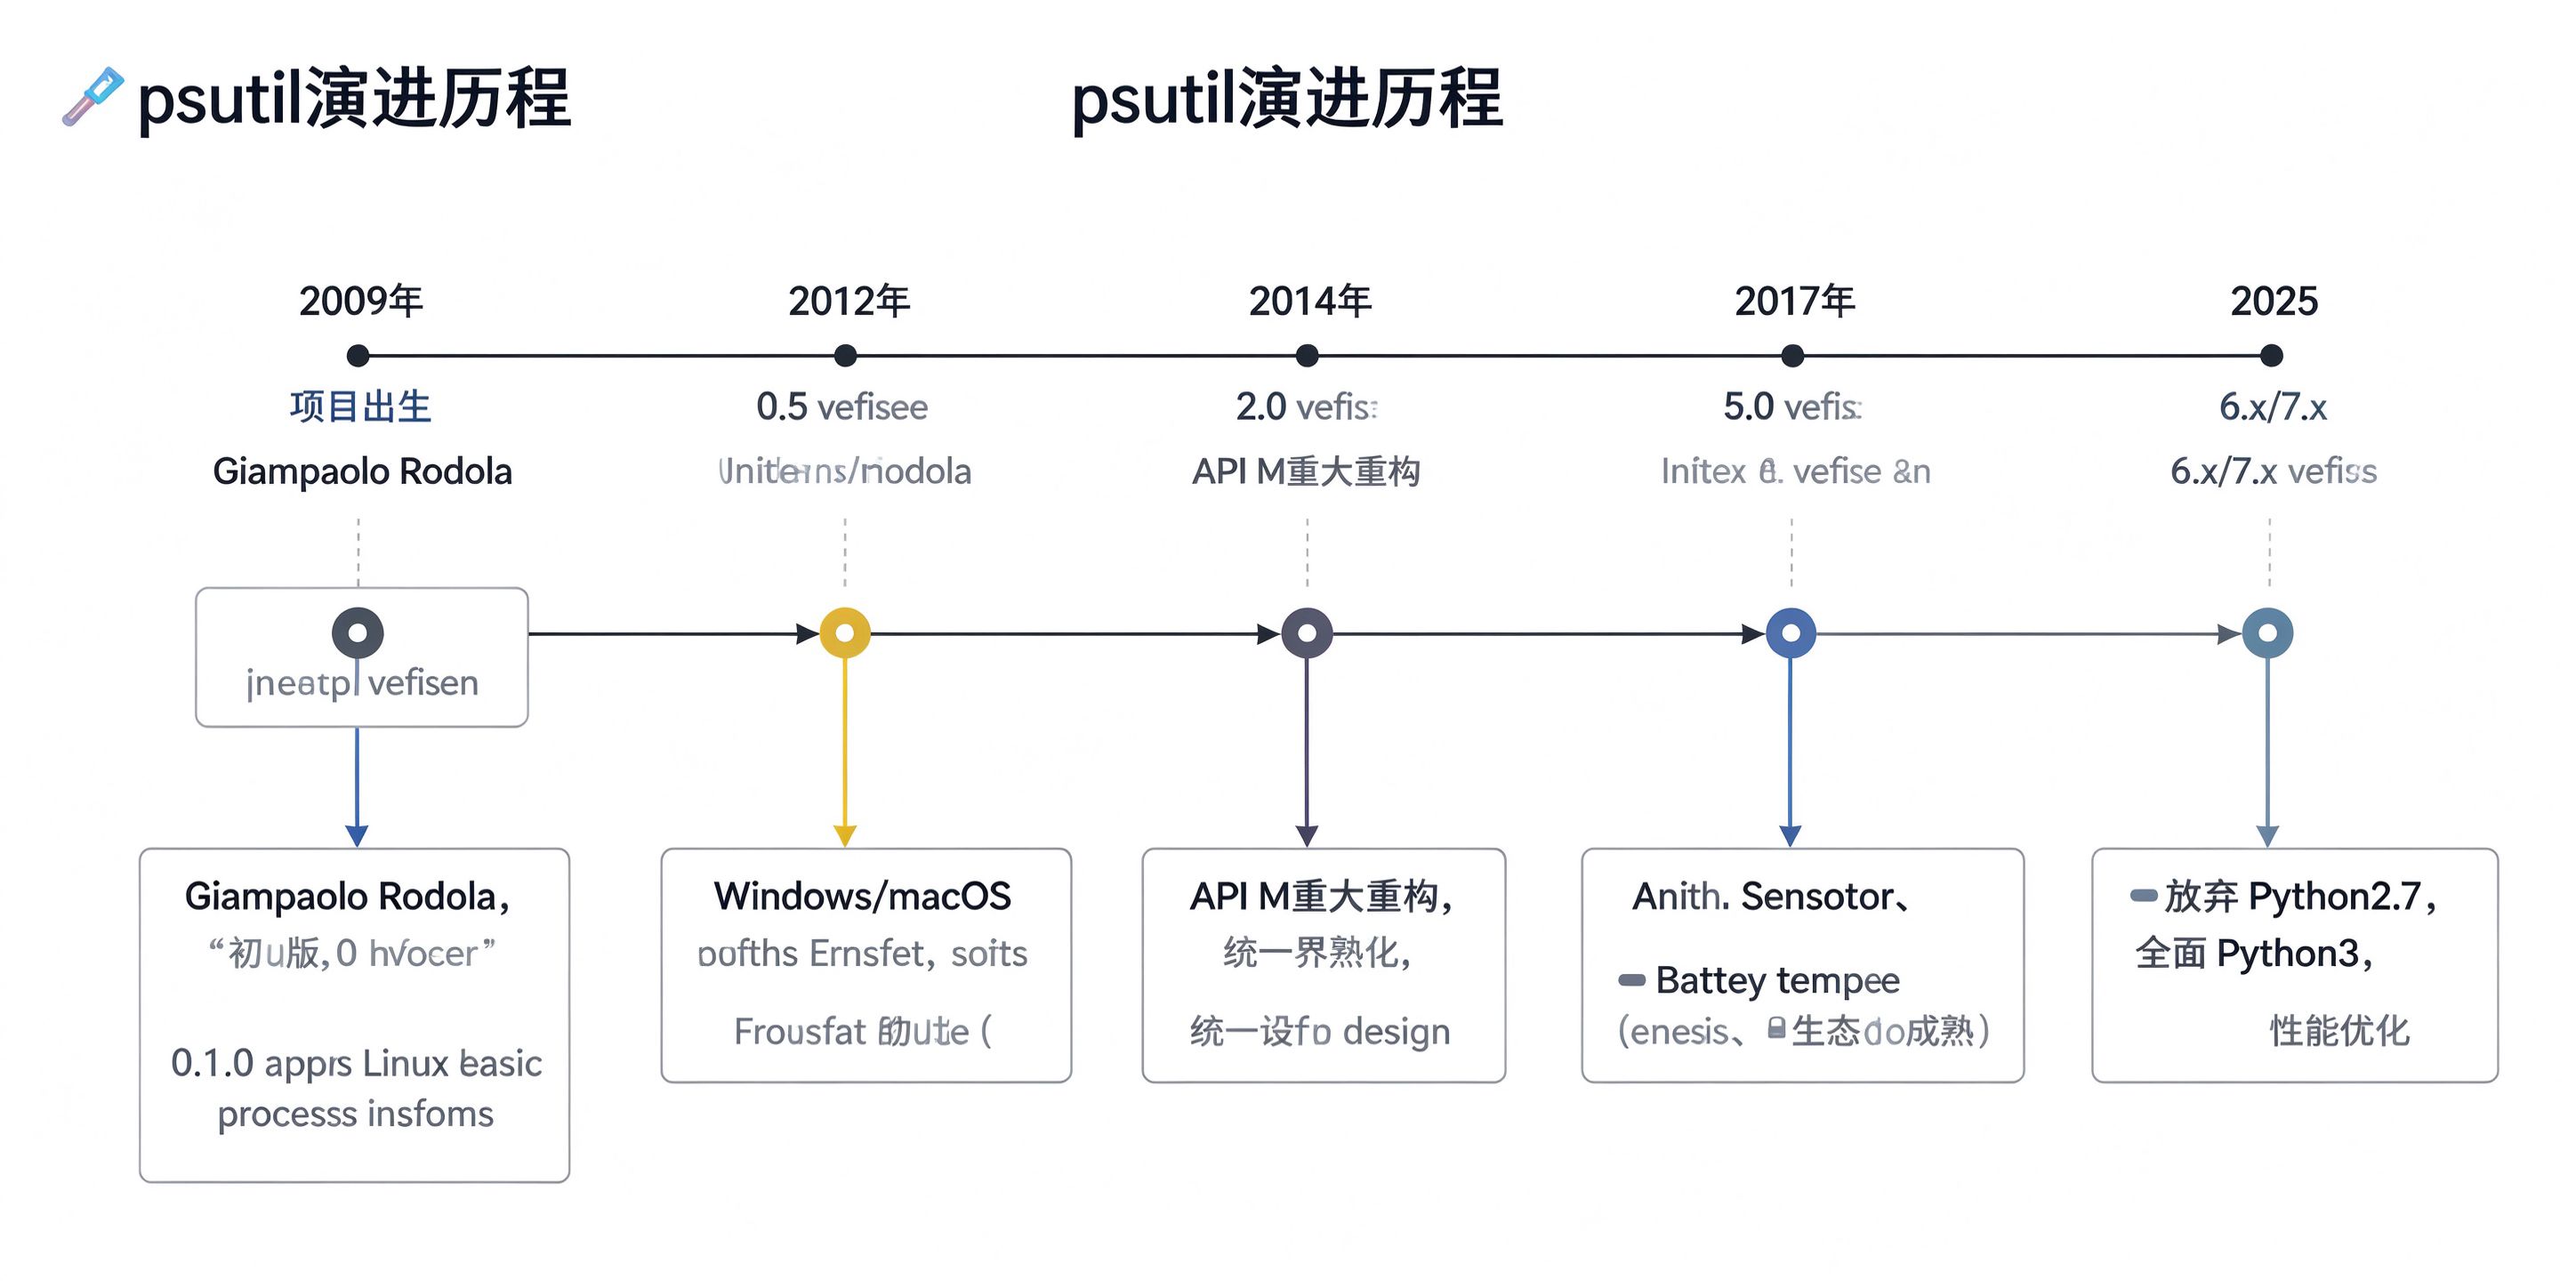
了解一个工具的历史,能帮助我们更好地理解它的设计哲学。psutil的发展可以分为几个关键阶段:
5.1 诞生期(2009年)
psutil由意大利开发者Giampaolo Rodola于2009年创建。最初的动机很简单:作者需要一个能在Python中获取进程和系统信息的库,但当时没有一个令人满意的解决方案。早期版本(0.1.0到0.4.x)主要聚焦Linux平台,提供了基本的进程信息获取功能。
5.2 跨平台期(2010-2013年)
从0.5版本开始,psutil逐步加入了Windows和macOS的支持,开始向真正的跨平台库演进。这个阶段的核心工作是为不同操作系统实现统一的API接口,把底层的系统调用差异封装起来。到2012年的0.5.1版本,psutil已经支持Linux、Windows、OS X和FreeBSD四大平台。
5.3 API重构期(2014年)
2014年发布的psutil 2.0是一个里程碑版本。作者对API进行了重大重构,目标是一致性和易用性。很多旧的方法名被重命名,比如get_cpu_percent()改为cpu_percent(),get_memory_info()改为memory_info()。这次重构虽然造成了不兼容,但奠定了后续版本的API基础,让psutil的接口变得更加统一和直觉化。
5.4 生态成熟期(2015-2020年)
从3.0到5.x版本,psutil进入了功能丰富和生态成熟阶段。新增了传感器支持(温度、电池)、进程网络连接监控、磁盘IO统计、Windows服务管理等功能。5.0版本之后,psutil成为Python生态中系统监控领域的事实标准,被Glances、Ansible、SaltStack等众多知名项目使用。
值得一提的是,psutil的一些设计甚至反哺了Python标准库。2011年,psutil的disk_usage()功能启发了Python 3.3中shutil.disk_usage()的加入;同样在Python 3.3中,os.getpriority()和os.setpriority()的加入也受到了psutil的影响。
5.5 现代化期(2021年至今)
2025年,psutil 7.0版本正式放弃了对Python 2.7的支持,全面转向Python 3。最新的6.x/7.x版本在性能上做了大量优化,比如Windows平台上某些API调用速度提升了百分之五十到百分之百。同时继续完善对新操作系统版本的适配。
从2009年到今天,psutil已经走过了十七年的历程,GitHub星标超过一万,是Python生态中最活跃、最可靠的系统工具库之一。
六、psutil怎么用
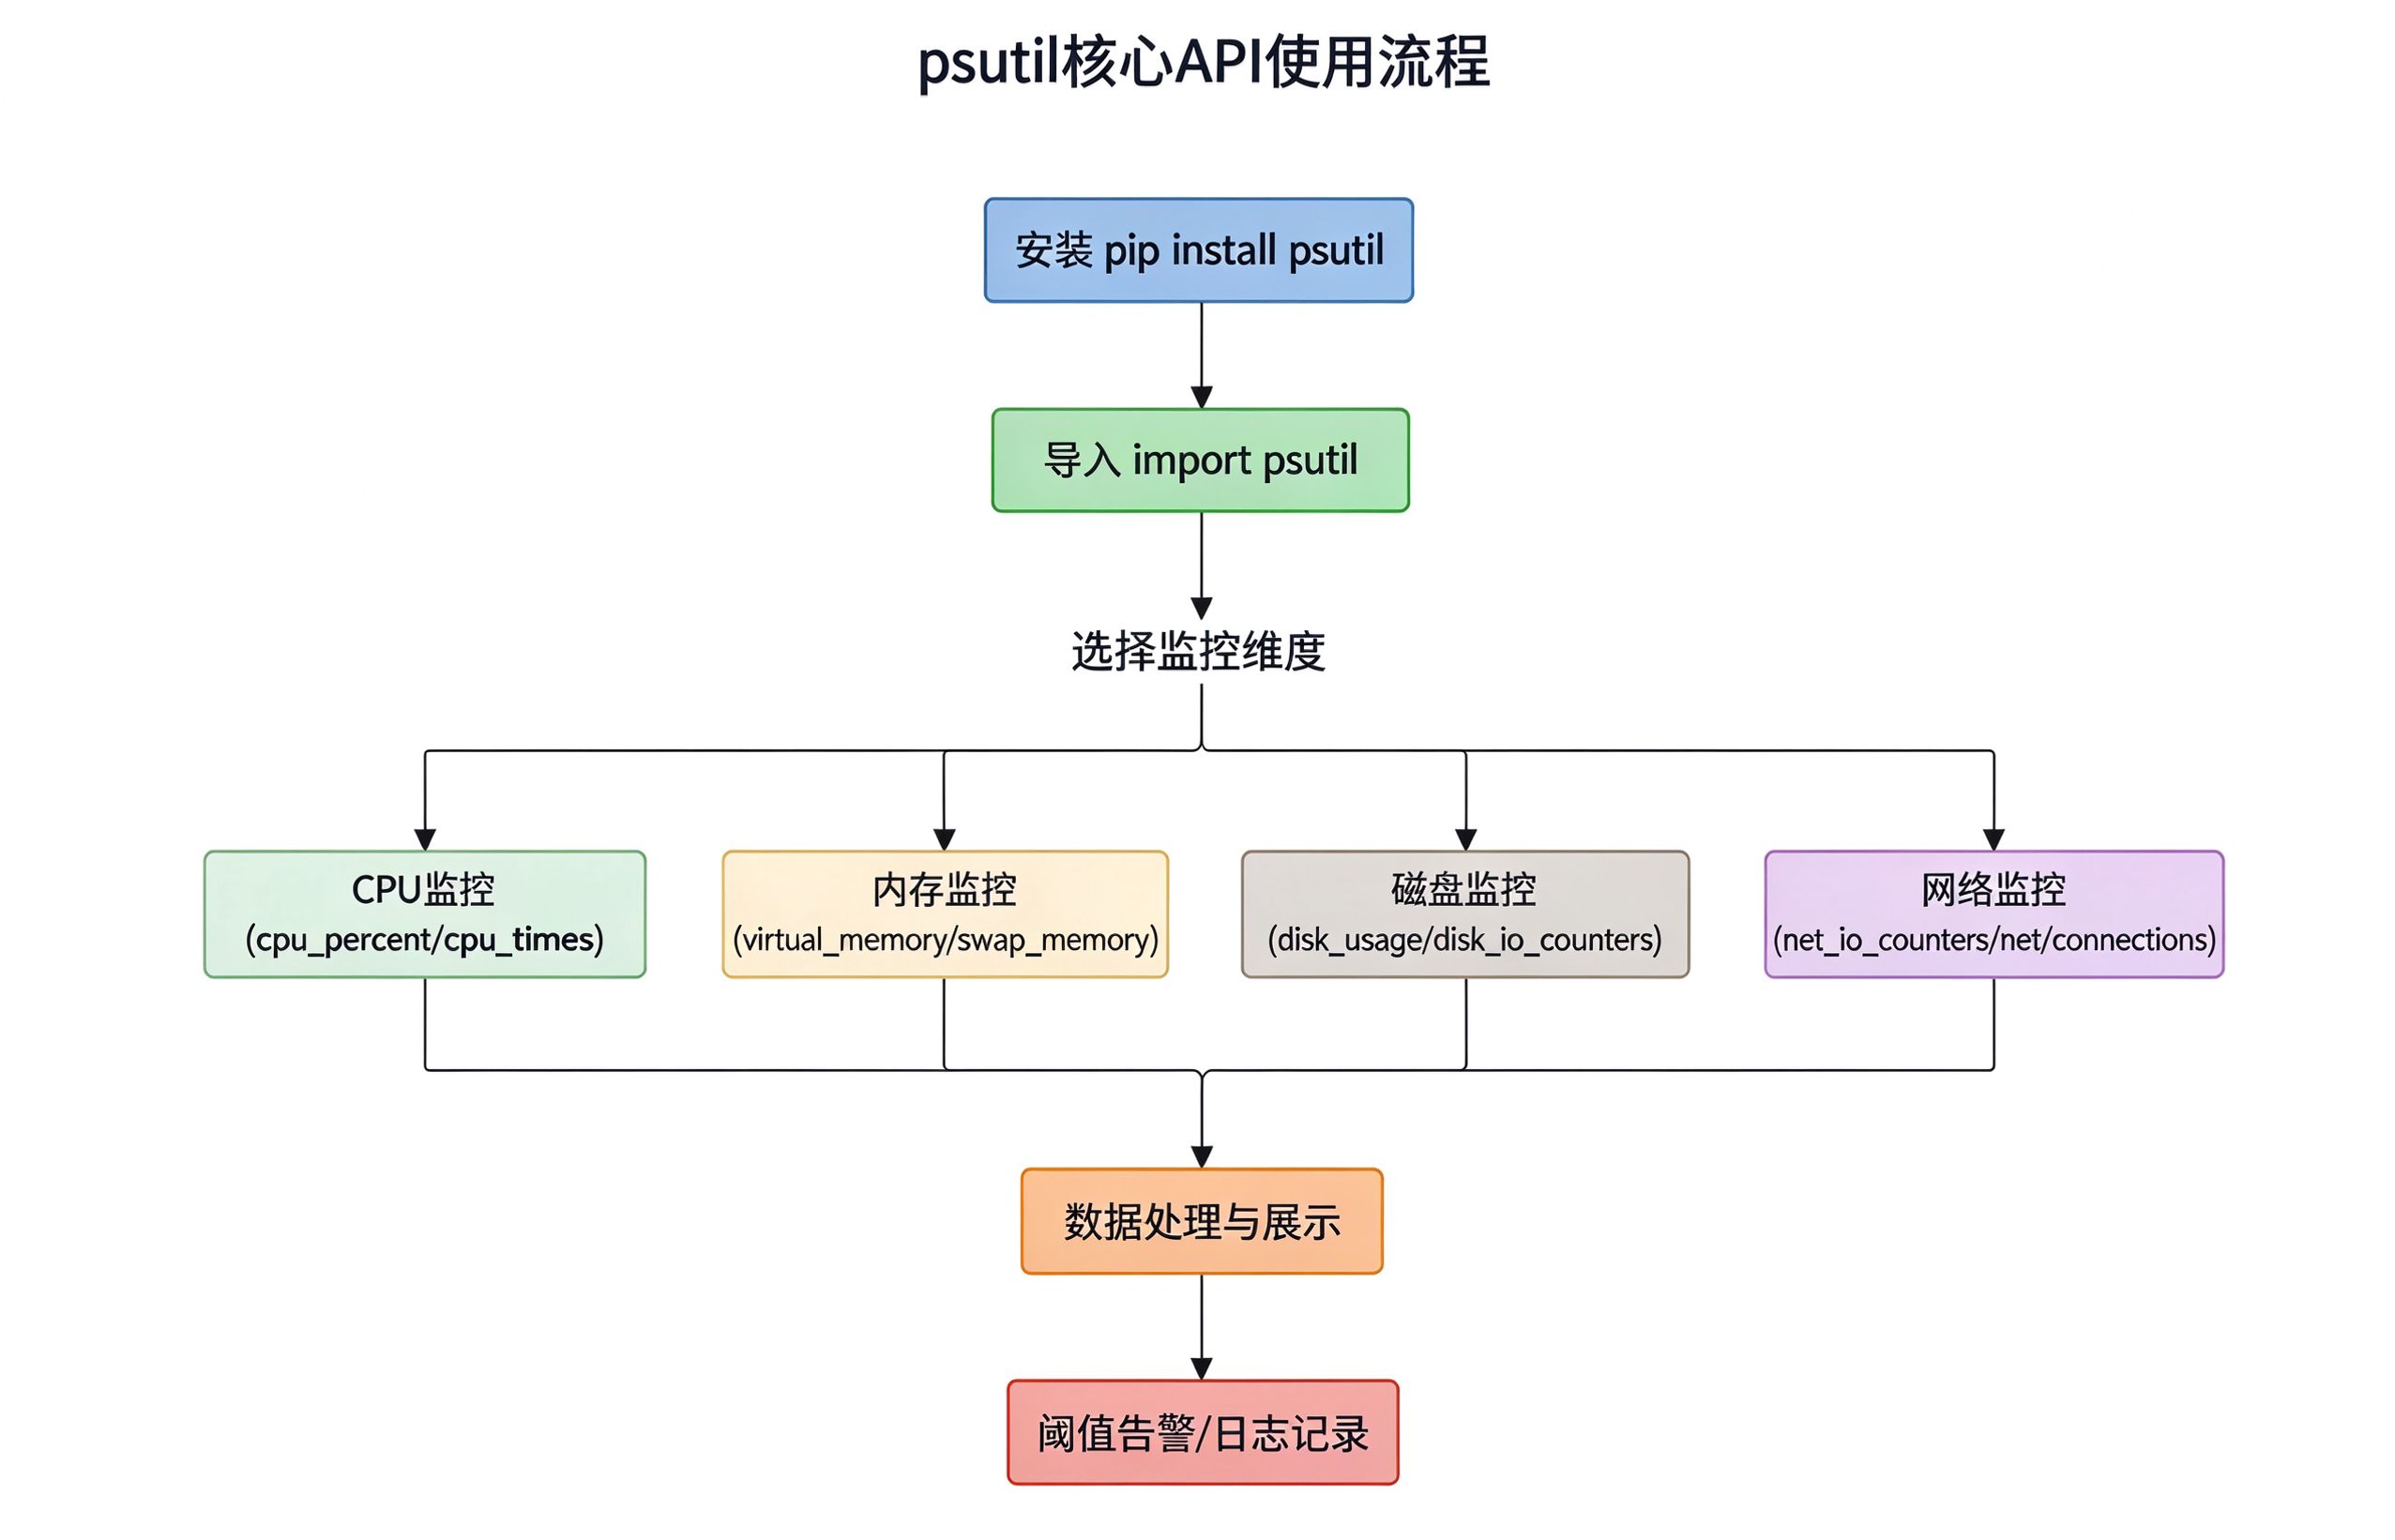
6.1 安装
psutil的安装非常简单,一条命令搞定:
bash
pip install psutil如果是在Linux系统上,也可以用系统包管理器安装:
bash
# Ubuntu/Debian
sudo apt-get install python3-psutil

# CentOS/RHEL
sudo yum install python3-psutil
验证安装:
python
import psutil
print(psutil.__version__)
6.2 获取主机信息
这是原教程中的核心案例,我们来详细讲解。获取当前主机信息,包含操作系统名、主机名、内核版本、硬件架构等:
python
import os
import psutil
from datetime import datetime

print('主机信息'.center(50, '*'))
info = os.uname()
print("""
    操作系统:%s
    主机名称:%s
    内核版本:%s
    硬件架构:%s
""" % (info.sysname, info.nodename, info.release, info.machine))
运行输出:
text
********************主机信息********************

    操作系统:Linux
    主机名称:web-server-01
    内核版本:5.15.0-91-generic
    硬件架构:x86_64
代码解析:
os.uname()是Python标准库提供的函数,返回一个包含系统信息的元组对象info.sysname:操作系统名称,如Linuxinfo.nodename:主机名info.release:内核版本号info.machine:硬件架构,如x86_64、aarch64
注意:os.uname()在Windows系统上不可用,如果需要跨平台获取主机信息,可以使用platform模块:
python
import platform

print(f"操作系统: {platform.system()}")
print(f"主机名称: {platform.node()}")
print(f"内核版本: {platform.release()}")
print(f"硬件架构: {platform.machine()}")
6.3 获取开机时间和开机时长
python
print('开机信息'.center(50, '*'))
# boot_time返回的是一个时间戳
boot_time = psutil.boot_time()
# 将时间戳转化为datetime类型的时间
boot_time_obj = datetime.fromtimestamp(boot_time)
now_time = datetime.now()
delta_time = now_time - boot_time_obj

print('开机时间:', boot_time_obj)
# str是为了将时间对象转换为字符串,实现分离
print('当前时间:', str(now_time).split('.')[0])
print('开机时长:', str(delta_time).split('.')[0])
运行输出:
text
********************开机信息********************
开机时间: 2026-09-28 08:15:32
当前时间: 2026-10-02 14:30:45
开机时长: 4 days, 6:15:13
代码解析:
psutil.boot_time()返回系统开机时间的时间戳(Unix时间戳,单位秒)datetime.fromtimestamp()将时间戳转换为人类可读的datetime对象now_time - boot_time_obj得到一个timedelta对象,表示已经运行了多长时间str(delta_time).split('.')[0]是为了去掉微秒部分,让输出更整洁
6.4 获取当前登录用户
python
print('当前登陆用户'.center(50, '*'))
login_user = psutil.users()
print(login_user)
info = psutil.users()[0]
print(info.name)
运行输出:
text
******************当前登陆用户******************
[suser(name='root', terminal='pts/0', host='192.168.1.100', started=1727834567.0, pid=12345)]
root
代码解析:
psutil.users()返回当前登录用户的列表,每个元素是一个suser命名元组name:用户名terminal:登录终端,如pts/0表示远程终端,tty1表示本地终端host:远程登录的来源IPstarted:登录时间的时间戳pid:对应登录进程的PID
6.5 CPU监控详解
CPU监控是psutil最常用的功能之一,涉及多个API:
python
import psutil

# 1. CPU使用率(interval=1表示统计1秒内的平均值)
cpu_percent = psutil.cpu_percent(interval=1)
print(f"CPU总使用率: {cpu_percent}%")

# 2. 每个核心的使用率
cpu_percent_per_core = psutil.cpu_percent(interval=1, percpu=True)
print(f"各核心使用率: {cpu_percent_per_core}")

# 3. CPU核心数
print(f"逻辑核心数: {psutil.cpu_count()}")
print(f"物理核心数: {psutil.cpu_count(logical=False)}")

# 4. CPU时间统计
cpu_times = psutil.cpu_times()
print(f"用户态时间: {cpu_times.user:.1f}s")
print(f"系统态时间: {cpu_times.system:.1f}s")
print(f"空闲时间: {cpu_times.idle:.1f}s")
print(f"IO等待时间: {cpu_times.iowait:.1f}s")

# 5. 系统负载(1/5/15分钟)
load_avg = psutil.getloadavg()
print(f"1分钟负载: {load_avg[0]:.2f}")
print(f"5分钟负载: {load_avg[1]:.2f}")
print(f"15分钟负载: {load_avg[2]:.2f}")

# 6. CPU频率
cpu_freq = psutil.cpu_freq()
print(f"当前频率: {cpu_freq.current:.0f} MHz")
print(f"最小频率: {cpu_freq.min:.0f} MHz")
print(f"最大频率: {cpu_freq.max:.0f} MHz")关键知识点:interval参数的原理
cpu_percent(interval=1)中的interval参数非常重要。当interval > 0时,psutil会先记录当前CPU时间,然后阻塞等待interval秒,再记录一次CPU时间,通过两次时间差计算出这段时间内的平均使用率。当interval = 0或None时,它会比较自上次调用以来的CPU时间,第一次调用会返回0.0。
这就是为什么在循环中调用时,第一次总是0.0的原因:
python
import psutil
import time

# 错误用法:第一次总是0.0
for i in range(3):
    print(psutil.cpu_percent())  # 第一次是0.0
    time.sleep(1)

# 正确用法:使用interval参数
for i in range(3):
    print(psutil.cpu_percent(interval=1))  # 每次都是准确的
6.6 内存监控详解
python
import psutil

# 物理内存
mem = psutil.virtual_memory()
print(f"内存总量: {mem.total / 1024**3:.2f} GB")
print(f"已用内存: {mem.used / 1024**3:.2f} GB")
print(f"可用内存: {mem.available / 1024**3:.2f} GB")
print(f"空闲内存: {mem.free / 1024**3:.2f} GB")
print(f"内存使用率: {mem.percent}%")
print(f"缓冲/缓存: {mem.buffers + mem.cached / 1024**3:.2f} GB")

# 交换分区
swap = psutil.swap_memory()
print(f"交换分区总量: {swap.total / 1024**3:.2f} GB")
print(f"交换分区已用: {swap.used / 1024**3:.2f} GB")
print(f"交换分区使用率: {swap.percent}%")关键知识点:available和free的区别
这是面试高频考点。free是真正完全空闲的内存,而available是应用程序实际可用的内存,它包含了可以被回收的缓存和缓冲区内存。Linux系统会尽量利用空闲内存做文件缓存,所以free通常很小,但available可能很大。判断内存是否紧张应该看available,而不是free。
6.7 磁盘监控详解
python
import psutil

# 磁盘分区信息
partitions = psutil.disk_partitions()
for p in partitions:
    print(f"设备: {p.device}, 挂载点: {p.mountpoint}, 文件系统: {p.fstype}")

# 指定分区的使用情况
disk = psutil.disk_usage("/")
print(f"根分区总量: {disk.total / 1024**3:.2f} GB")
print(f"根分区已用: {disk.used / 1024**3:.2f} GB")
print(f"根分区剩余: {disk.free / 1024**3:.2f} GB")
print(f"根分区使用率: {disk.percent}%")

# 磁盘IO统计
disk_io = psutil.disk_io_counters()
print(f"累计读字节: {disk_io.read_bytes / 1024**3:.2f} GB")
print(f"累计写字节: {disk_io.write_bytes / 1024**3:.2f} GB")
print(f"累计读次数: {disk_io.read_count}")
print(f"累计写次数: {disk_io.write_count}")
企业级注意事项:Inode监控
很多新手只监控磁盘空间,忽略了Inode使用率。在大量小文件的场景下(比如邮件服务器、缓存目录),磁盘空间还没满,但Inode已经耗尽,同样会导致无法写入文件。psutil没有直接提供Inode统计的API,需要用os.statvfs()补充:
python
import os

def get_inode_usage(path):
    stat = os.statvfs(path)
    total = stat.f_files
    free = stat.f_ffree
    used_percent = (total - free) / total * 100
    return total, free, used_percent

total, free, percent = get_inode_usage("/")
print(f"Inode总量: {total}")
print(f"Inode可用: {free}")
print(f"Inode使用率: {percent:.1f}%")
6.8 网络监控详解
python
import psutil

# 网络流量统计
net_io = psutil.net_io_counters()
print(f"累计发送字节: {net_io.bytes_sent / 1024**3:.2f} GB")
print(f"累计接收字节: {net_io.bytes_recv / 1024**3:.2f} GB")
print(f"累计发送包数: {net_io.packets_sent}")
print(f"累计接收包数: {net_io.packets_recv}")
print(f"收包错误数: {net_io.errin}")
print(f"丢包数: {net_io.dropin}")

# 网卡信息
net_if = psutil.net_if_addrs()
for name, addrs in net_if.items():
    for addr in addrs:
        if addr.family.name == 'AF_INET':
            print(f"网卡: {name}, IP: {addr.address}")

# 网络连接(需要root权限)
connections = psutil.net_connections(kind='tcp')
print(f"当前TCP连接数: {len(connections)}")
for conn in connections[:5]:  # 只看前5个
    print(f"  本地地址: {conn.laddr}, 远程地址: {conn.raddr}, 状态: {conn.status}")
6.9 进程管理
python
import psutil

# 遍历所有进程
for proc in psutil.process_iter(['pid', 'name', 'cpu_percent', 'memory_percent']):
    try:
        info = proc.info
        print(f"PID: {info['pid']}, 名称: {info['name']}, "
              f"CPU: {info['cpu_percent']}%, 内存: {info['memory_percent']:.1f}%")
    except (psutil.NoSuchProcess, psutil.AccessDenied):
        pass

# 获取Top 5 CPU占用进程
processes = []
for proc in psutil.process_iter(['pid', 'name', 'cpu_percent']):
    try:
        processes.append(proc.info)
    except (psutil.NoSuchProcess, psutil.AccessDenied):
        pass

top5 = sorted(processes, key=lambda x: x['cpu_percent'], reverse=True)[:5]
for p in top5:
    print(f"PID:{p['pid']} {p['name']} CPU:{p['cpu_percent']}%")

# 操作指定进程
pid = 12345
proc = psutil.Process(pid)
print(f"进程名: {proc.name()}")
print(f"进程状态: {proc.status()}")
print(f"进程创建时间: {proc.create_time()}")
# proc.terminate()  # 优雅终止
# proc.kill()       # 强制杀死
七、企业项目实战:自动巡检告警系统
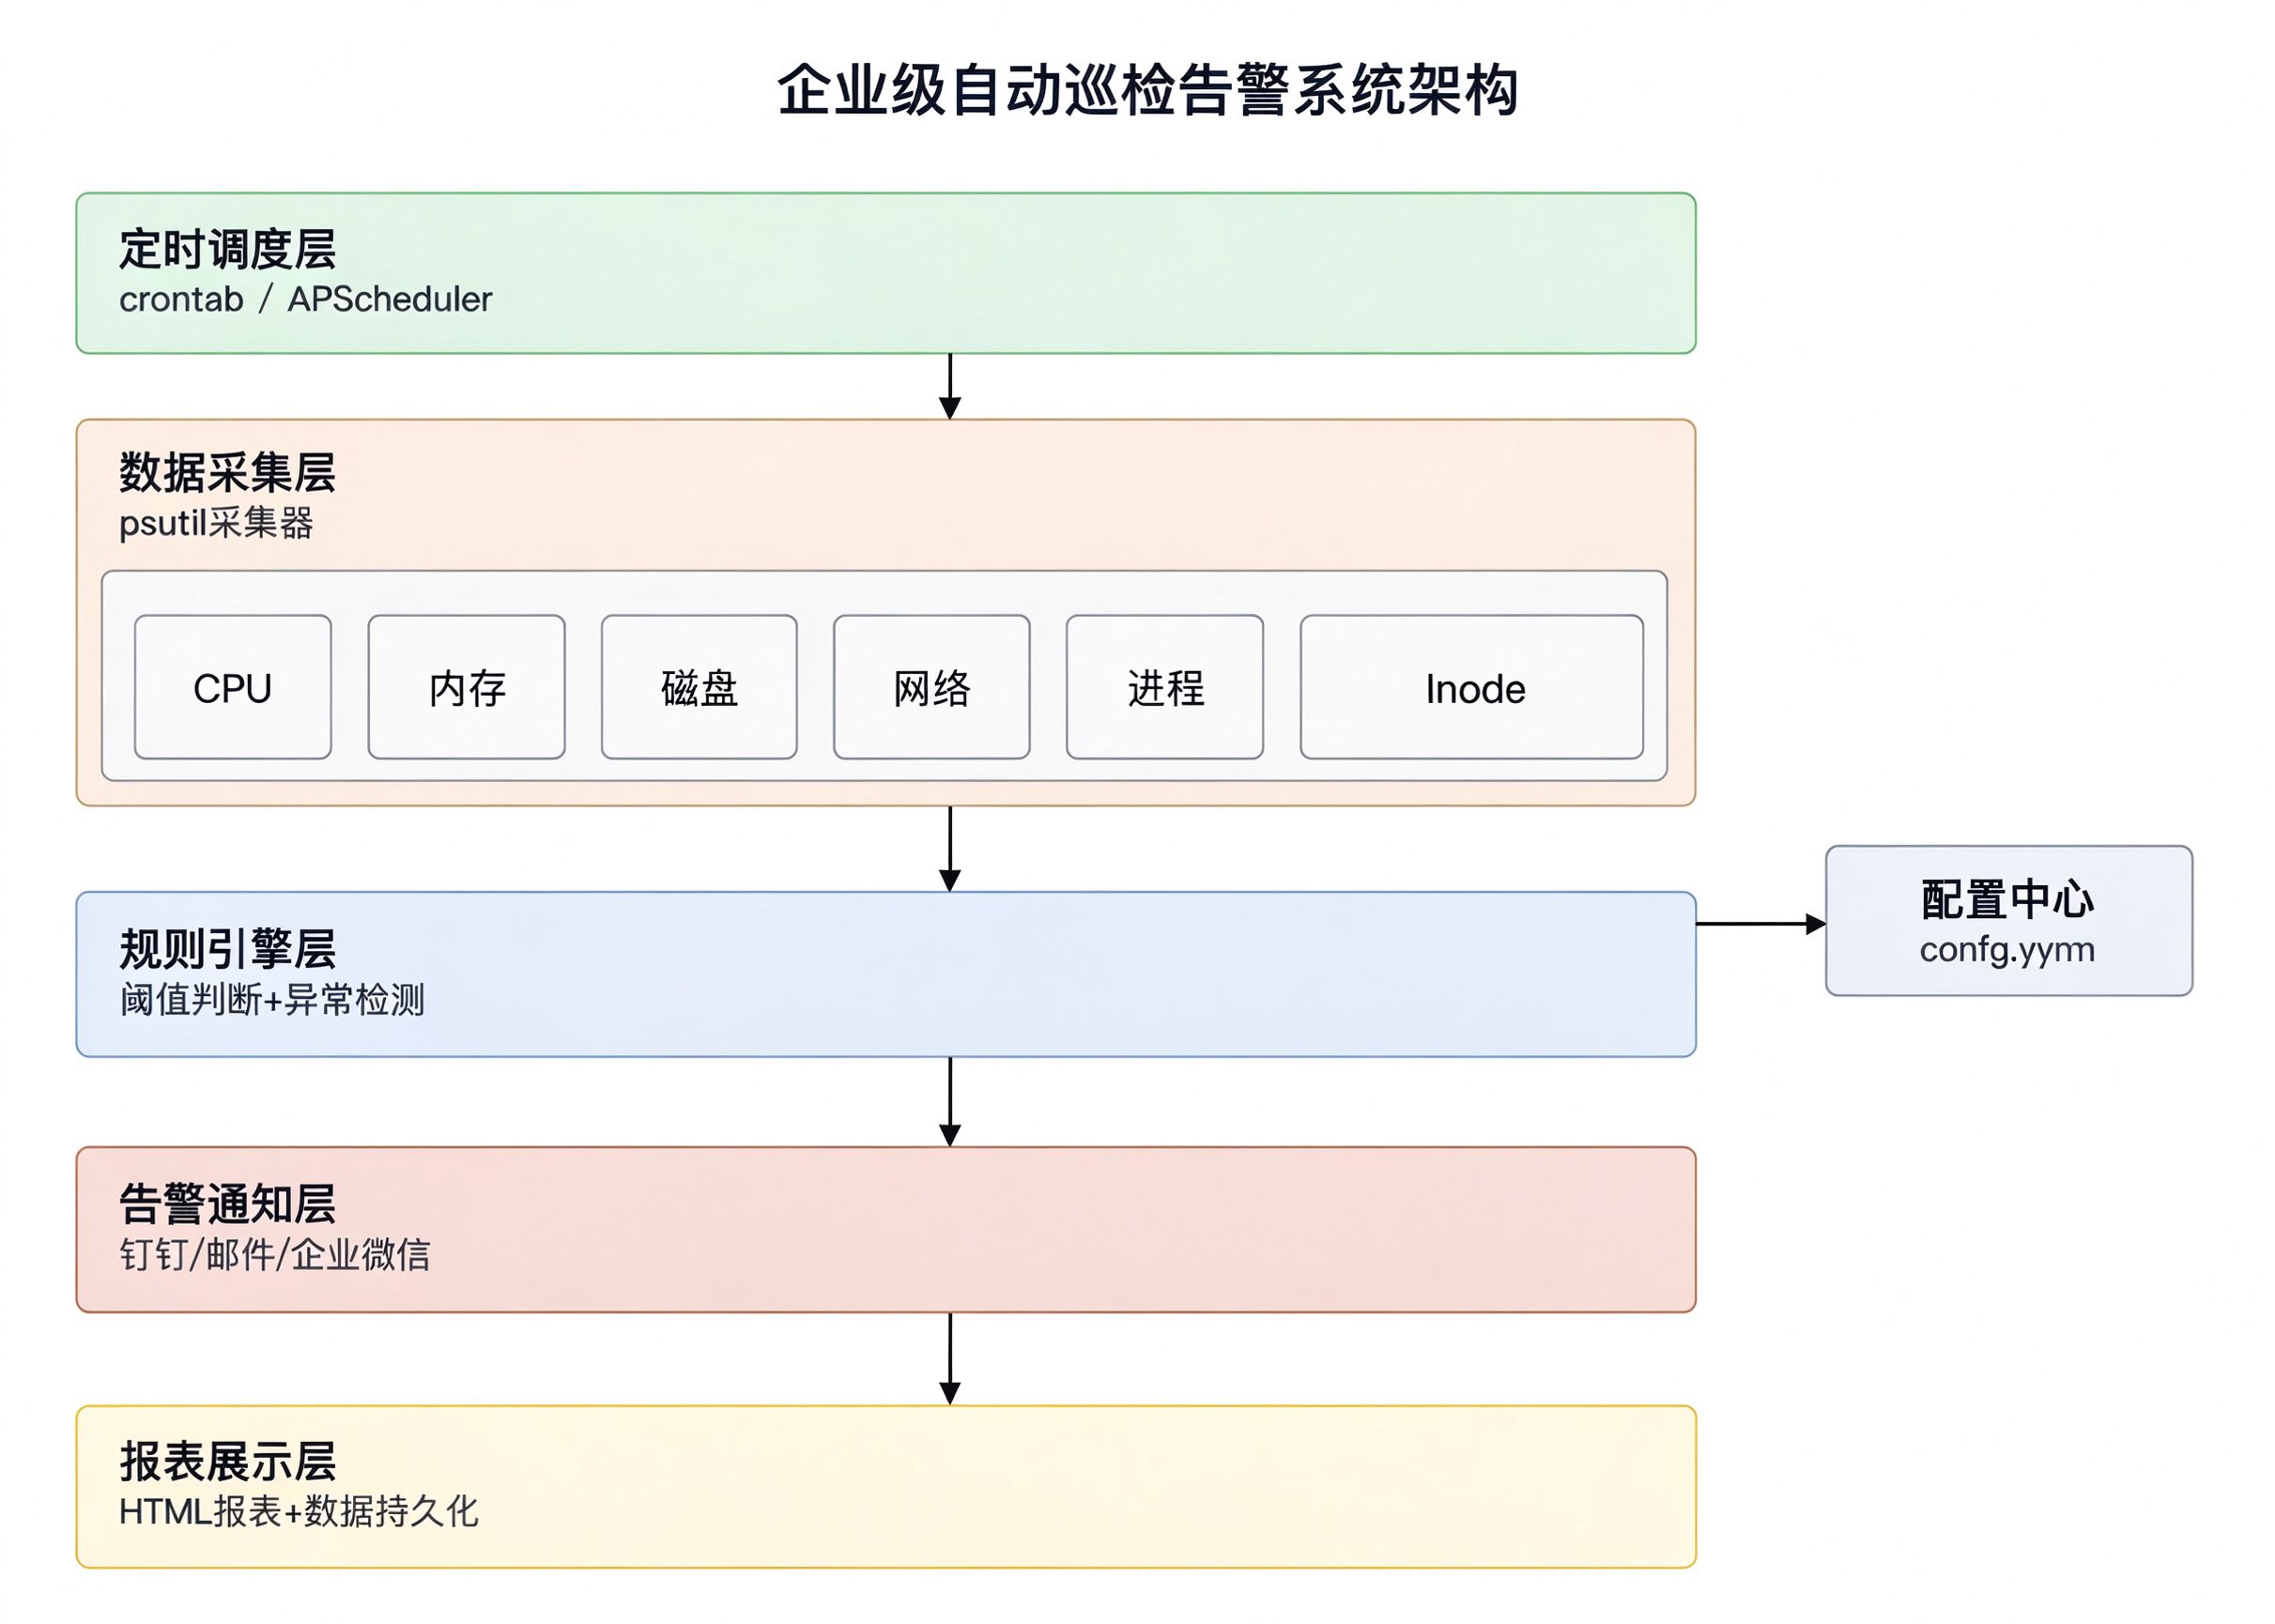
理论知识讲完了,现在来看一个真正能在企业中落地的项目。我们将从零构建一个工业级的Linux服务器自动巡检系统,具备以下功能:
- 定时采集CPU、内存、磁盘、Inode、网络、进程等指标
- 阈值判断,异常自动告警
- 钉钉机器人通知
- 生成HTML巡检报表
- crontab定时调度
7.1 项目结构
text
server_monitor/
├── config.yaml          # 配置文件
├── monitor.py           # 主程序
├── collector.py         # 数据采集模块
├── notifier.py          # 告警通知模块
├── report.py            # 报表生成模块
├── requirements.txt     # 依赖
└── reports/             # 报表输出目录
7.2 配置文件
yaml
# config.yaml
thresholds:
  cpu_percent: 85          # CPU使用率告警阈值
  memory_percent: 90       # 内存使用率告警阈值
  disk_percent: 85         # 磁盘使用率告警阈值
  inode_percent: 80        # Inode使用率告警阈值
  load_avg: 10             # 1分钟负载阈值

monitor:
  interval: 60             # 采集间隔(秒)
  check_processes:         # 需要监控的关键进程
    - nginx
    - mysql
    - redis
  check_ports:             # 需要监控的关键端口
    - 80
    - 443
    - 3306

alert:
  enabled: true
  dingtalk_webhook: "https://oapi.dingtalk.com/robot/send?access_token=你的token"
  dingtalk_secret: "你的加签密钥"

report:
  output_dir: "./reports"
  retain_days: 30
7.3 数据采集模块
python
# collector.py
import psutil
import os
import socket
import platform
from datetime import datetime


class SystemCollector:
    """系统指标采集器"""

    def collect_all(self):
        """采集所有指标"""
        return {
            "timestamp": datetime.now().strftime("%Y-%m-%d %H:%M:%S"),
            "hostname": socket.gethostname(),
            "os": platform.system(),
            "kernel": platform.release(),
            "cpu": self._collect_cpu(),
            "memory": self._collect_memory(),
            "disk": self._collect_disk(),
            "network": self._collect_network(),
            "process": self._collect_process(),
            "boot_time": self._collect_boot_time(),
        }

    def _collect_cpu(self):
        return {
            "percent": psutil.cpu_percent(interval=1),
            "percpu": psutil.cpu_percent(interval=0, percpu=True),
            "count_logical": psutil.cpu_count(),
            "count_physical": psutil.cpu_count(logical=False),
            "load_avg": psutil.getloadavg(),
        }

    def _collect_memory(self):
        mem = psutil.virtual_memory()
        swap = psutil.swap_memory()
        return {
            "total_gb": round(mem.total / 1024**3, 2),
            "used_gb": round(mem.used / 1024**3, 2),
            "available_gb": round(mem.available / 1024**3, 2),
            "percent": mem.percent,
            "swap_total_gb": round(swap.total / 1024**3, 2),
            "swap_used_gb": round(swap.used / 1024**3, 2),
            "swap_percent": swap.percent,
        }

    def _collect_disk(self):
        disks = []
        for part in psutil.disk_partitions():
            try:
                usage = psutil.disk_usage(part.mountpoint)
                inode_total, inode_free, inode_percent = self._get_inode(part.mountpoint)
                disks.append({
                    "device": part.device,
                    "mountpoint": part.mountpoint,
                    "fstype": part.fstype,
                    "total_gb": round(usage.total / 1024**3, 2),
                    "used_gb": round(usage.used / 1024**3, 2),
                    "free_gb": round(usage.free / 1024**3, 2),
                    "percent": usage.percent,
                    "inode_percent": round(inode_percent, 1),
                })
            except (PermissionError, FileNotFoundError):
                continue
        return disks

    def _get_inode(self, path):
        stat = os.statvfs(path)
        total = stat.f_files
        free = stat.f_ffree
        used_percent = (total - free) / total * 100 if total > 0 else 0
        return total, free, used_percent

    def _collect_network(self):
        net = psutil.net_io_counters()
        return {
            "bytes_sent_gb": round(net.bytes_sent / 1024**3, 2),
            "bytes_recv_gb": round(net.bytes_recv / 1024**3, 2),
            "packets_sent": net.packets_sent,
            "packets_recv": net.packets_recv,
            "errin": net.errin,
            "errout": net.errout,
            "dropin": net.dropin,
            "dropout": net.dropout,
            "tcp_connections": len(psutil.net_connections(kind='tcp')),
        }

    def _collect_process(self):
        processes = []
        for proc in psutil.process_iter(['pid', 'name', 'cpu_percent', 'memory_percent', 'status']):
            try:
                info = proc.info
                info['memory_percent'] = round(info['memory_percent'], 1)
                processes.append(info)
            except (psutil.NoSuchProcess, psutil.AccessDenied):
                pass
        # 按CPU排序取Top10
        top_cpu = sorted(processes, key=lambda x: x['cpu_percent'], reverse=True)[:10]
        top_mem = sorted(processes, key=lambda x: x['memory_percent'], reverse=True)[:10]
        # 僵尸进程
        zombies = [p for p in processes if p['status'] == psutil.STATUS_ZOMBIE]
        return {
            "total_count": len(processes),
            "zombie_count": len(zombies),
            "top_cpu": top_cpu,
            "top_mem": top_mem,
        }

    def _collect_boot_time(self):
        boot_time = datetime.fromtimestamp(psutil.boot_time())
        uptime = datetime.now() - boot_time
        return {
            "boot_time": boot_time.strftime("%Y-%m-%d %H:%M:%S"),
            "uptime": str(uptime).split('.')[0],
        }
7.4 告警通知模块
python
# notifier.py
import time
import hmac
import hashlib
import base64
import urllib.parse
import requests
import json
class DingTalkNotifier:
"""钉钉机器人告警通知"""
def __init__(self, webhook, secret):
self.webhook = webhook
self.secret = secret
def _sign(self):
"""生成钉钉加签"""
timestamp = str(round(time.time() * 1000))
string_to_sign = f'{timestamp}\n{self.secret}'
hmac_code = hmac.new(
self.secret.encode('utf-8'),
string_to_sign.encode('utf-8'),
digestmod=hashlib.sha256
).digest()
sign = urllib.parse.quote_plus(base64.b64encode(hmac_code))
return f"{self.webhook}×tamp={timestamp}&sign={sign}"
def send_alert(self, title, alerts):
"""发送告警消息
alerts: list of dict, 每个包含 level, metric, value, threshold, message
"""
if not alerts:
return
text = f"### {title}\n\n"
text += f"**告警时间**: {time.strftime('%Y-%m-%d %H:%M:%S')}\n\n"
text += "**异常项**:\n\n"
for a in alerts:
emoji = "严重" if a['level'] == 'critical' else "警告"
text += f"- **[{emoji}]** {a['metric']}: 当前 {a['value']}, 阈值 {a['threshold']}\n"
text += f" - {a['message']}\n"
data = {
"msgtype": "markdown",
"markdown": {
"title": title,
"text": text
},
"at": {
"isAtAll": True
}
}
url = self._sign()
resp = requests.post(url, json=data, timeout=10)
return resp.json()7.5 主程序入口
python
# monitor.py
import yaml
import time
import logging
from collector import SystemCollector
from notifier import DingTalkNotifier
from report import ReportGenerator

logging.basicConfig(
    level=logging.INFO,
    format='%(asctime)s - %(levelname)s - %(message)s'
)
logger = logging.getLogger(__name__)


def load_config(config_path='config.yaml'):
    with open(config_path, 'r', encoding='utf-8') as f:
        return yaml.safe_load(f)


def check_thresholds(data, thresholds):
    """检查指标是否超过阈值,返回告警列表"""
    alerts = []

    # CPU检查
    if data['cpu']['percent'] > thresholds['cpu_percent']:
        alerts.append({
            'level': 'critical',
            'metric': 'CPU使用率',
            'value': f"{data['cpu']['percent']}%",
            'threshold': f"{thresholds['cpu_percent']}%",
            'message': 'CPU使用率过高,可能存在计算密集型任务或异常进程'
        })

    # 负载检查
    if data['cpu']['load_avg'][0] > thresholds['load_avg']:
        alerts.append({
            'level': 'warning',
            'metric': '系统负载(1分钟)',
            'value': f"{data['cpu']['load_avg'][0]:.2f}",
            'threshold': f"{thresholds['load_avg']}",
            'message': '系统负载过高,任务排队严重'
        })

    # 内存检查
    if data['memory']['percent'] > thresholds['memory_percent']:
        alerts.append({
            'level': 'critical',
            'metric': '内存使用率',
            'value': f"{data['memory']['percent']}%",
            'threshold': f"{thresholds['memory_percent']}%",
            'message': '内存使用率过高,可能触发OOM Killer'
        })

    # 磁盘检查
    for disk in data['disk']:
        if disk['percent'] > thresholds['disk_percent']:
            alerts.append({
                'level': 'critical',
                'metric': f"磁盘使用率({disk['mountpoint']})",
                'value': f"{disk['percent']}%",
                'threshold': f"{thresholds['disk_percent']}%",
                'message': f"分区 {disk['mountpoint']} 空间不足"
            })
        if disk['inode_percent'] > thresholds['inode_percent']:
            alerts.append({
                'level': 'warning',
                'metric': f"Inode使用率({disk['mountpoint']})",
                'value': f"{disk['inode_percent']}%",
                'threshold': f"{thresholds['inode_percent']}%",
                'message': f"分区 {disk['mountpoint']} Inode不足,可能无法创建新文件"
            })

    # 僵尸进程检查
    if data['process']['zombie_count'] > 0:
        alerts.append({
            'level': 'warning',
            'metric': '僵尸进程',
            'value': f"{data['process']['zombie_count']}个",
            'threshold': "0个",
            'message': '存在僵尸进程,父进程可能未正确回收子进程'
        })

    return alerts


def main():
    config = load_config()
    collector = SystemCollector()
    notifier = DingTalkNotifier(
        config['alert']['dingtalk_webhook'],
        config['alert']['dingtalk_secret']
    )
    reporter = ReportGenerator(config['report']['output_dir'])

    logger.info("开始采集系统指标...")
    data = collector.collect_all()

    logger.info("检查阈值...")
    alerts = check_thresholds(data, config['thresholds'])

    if alerts and config['alert']['enabled']:
        logger.warning(f"发现 {len(alerts)} 个异常项,发送告警...")
        notifier.send_alert(f"服务器告警 - {data['hostname']}", alerts)
    else:
        logger.info("所有指标正常")

    logger.info("生成巡检报表...")
    report_path = reporter.generate(data, alerts)
    logger.info(f"报表已生成: {report_path}")


if __name__ == '__main__':
    main()
7.6 定时调度
使用crontab实现每小时自动巡检:
bash
# 编辑crontab
crontab -e

# 添加以下内容(每小时第0分执行)
0 * * * * cd /opt/server_monitor && /usr/bin/python3 monitor.py >> /var/log/server_monitor.log 2>&1
这样,一个完整的企业级自动巡检告警系统就搭建完成了。它可以在无人值守的情况下,每小时自动检查服务器状态,发现异常立即通过钉钉通知运维人员,同时生成HTML报表留档。
八、竞品对比:psutil vs Glances vs top/htop
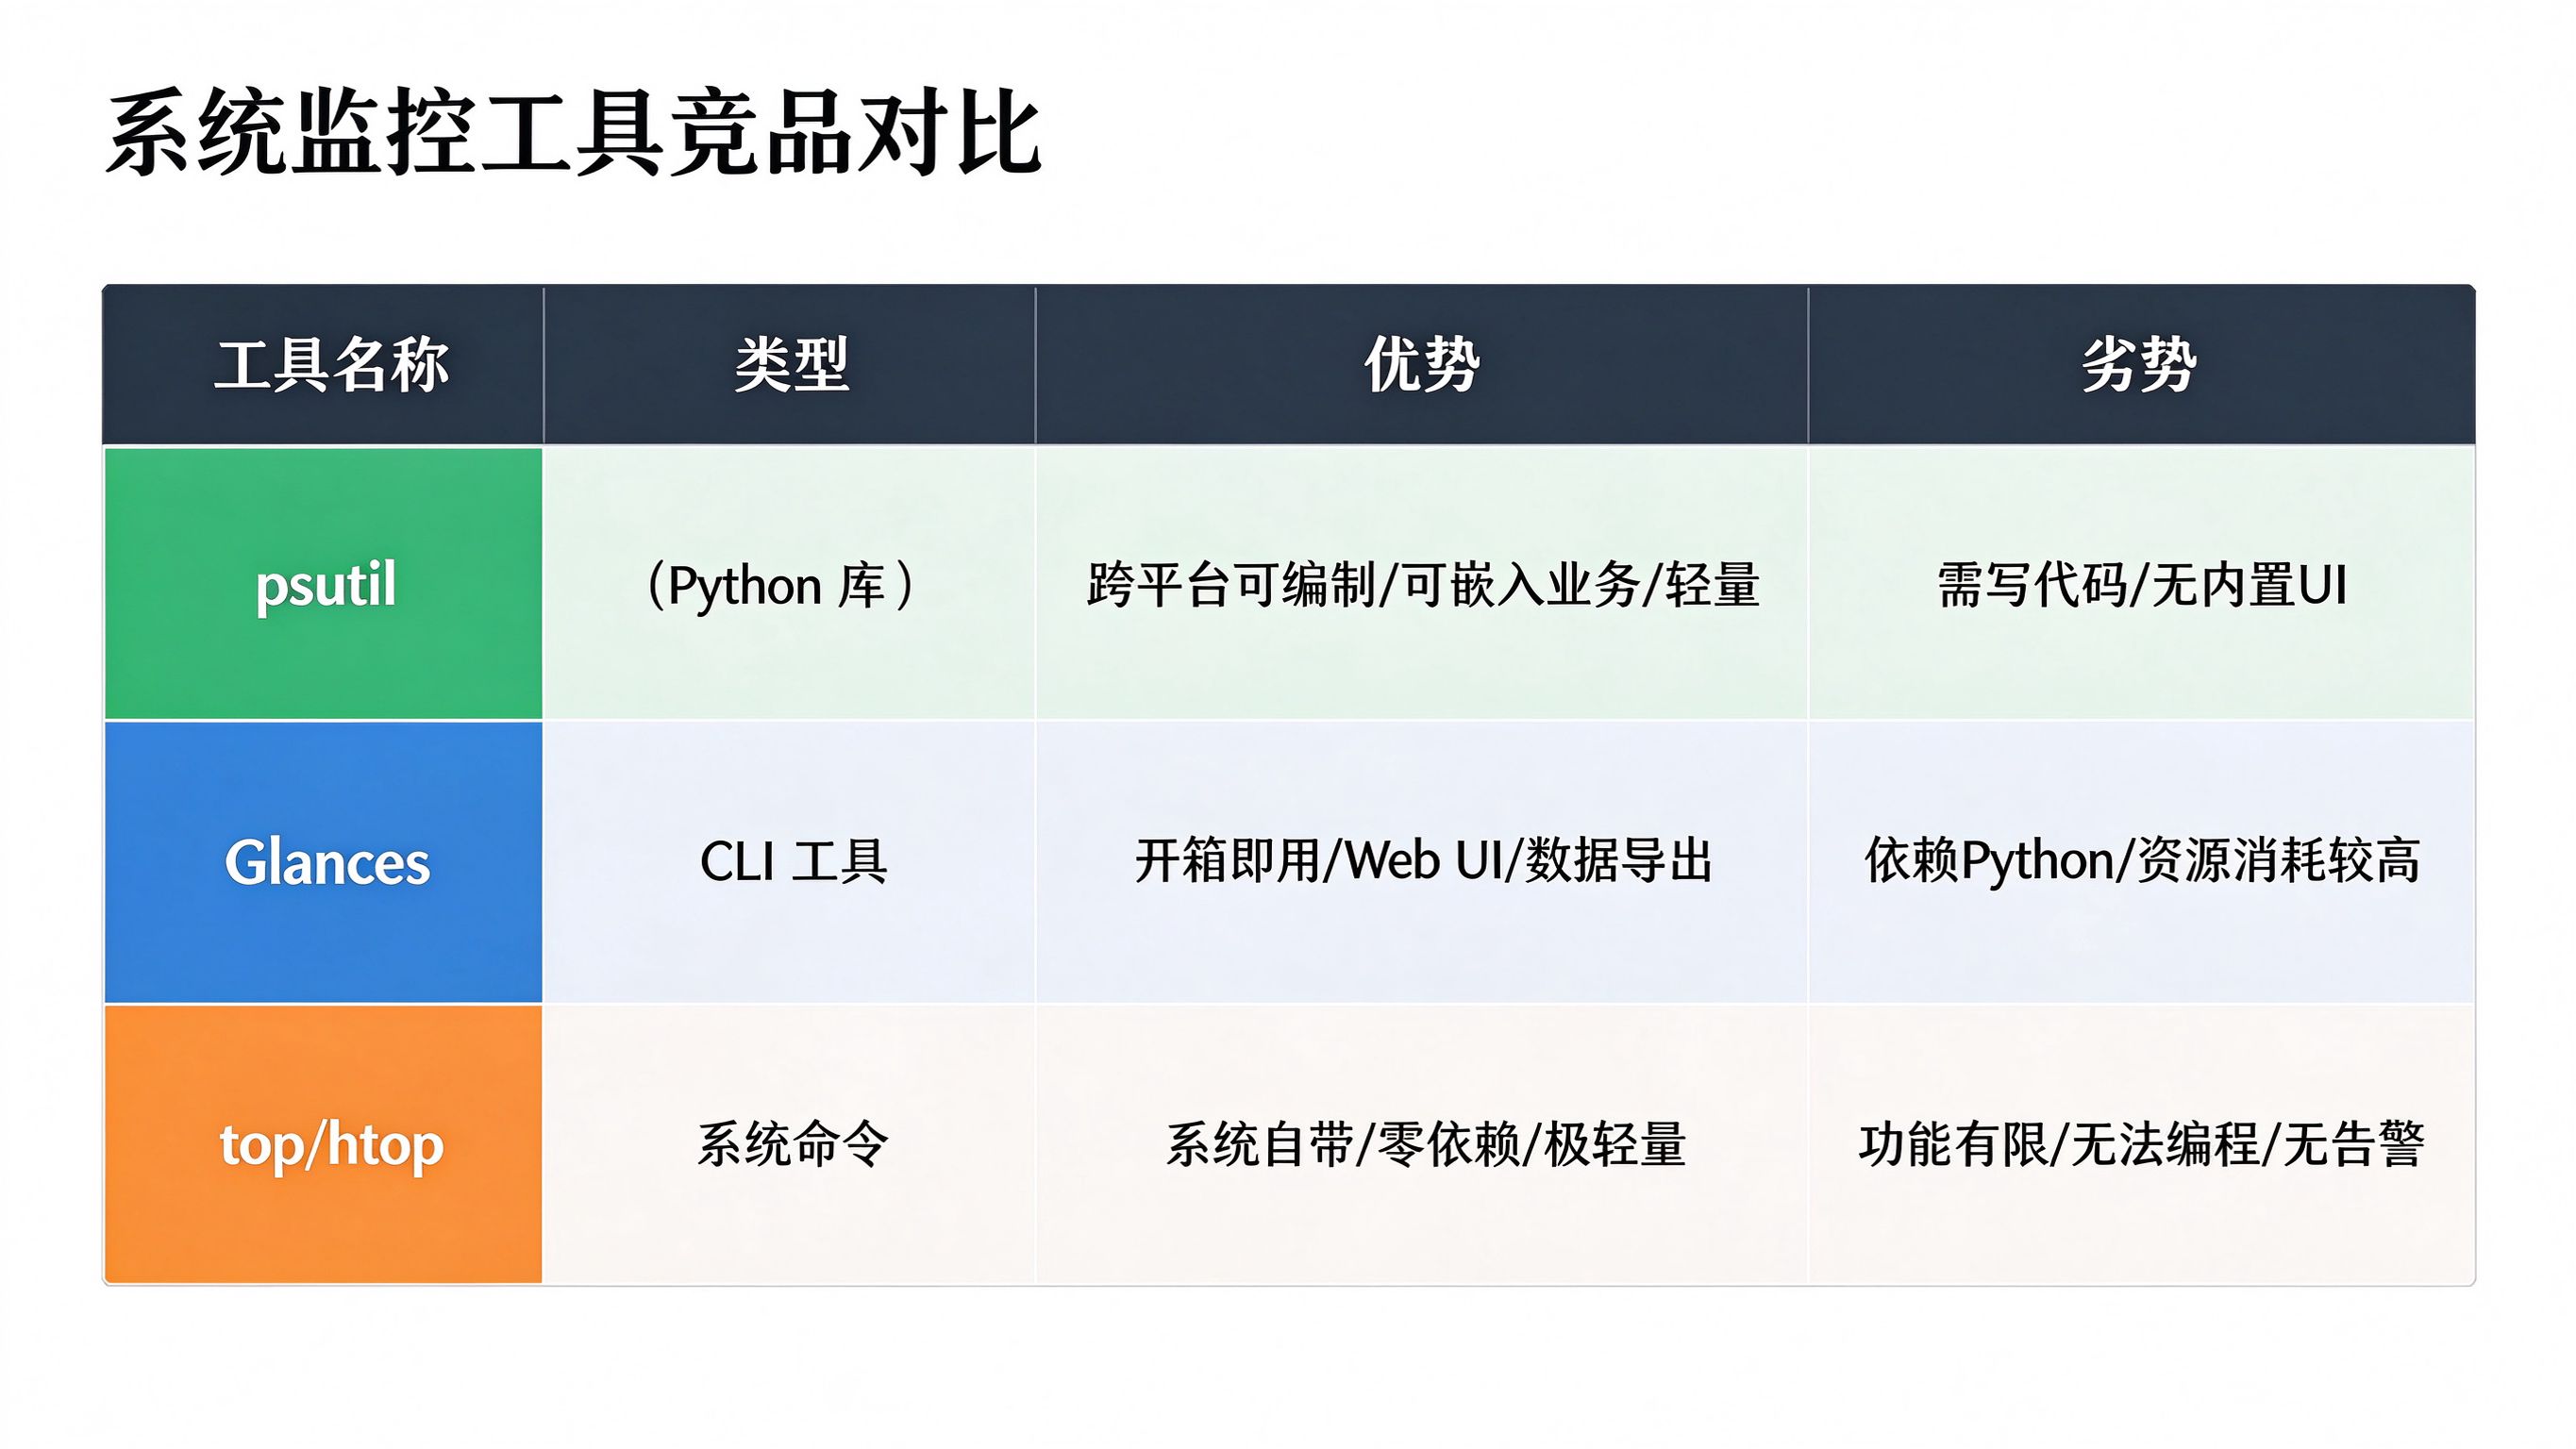
选择工具时,了解各方案的优劣势至关重要。下面从多个维度对最常用的几种监控方案进行对比:
| 对比维度 | psutil | Glances | top/htop | Prometheus + Node Exporter |
|---|---|---|---|---|
| 类型 | Python库 | CLI/Web工具 | 系统命令 | 完整监控系统 |
| 安装方式 | pip install | pip/apt | 系统自带 | 二进制部署 |
| 跨平台 | 支持Linux/Windows/macOS | 支持Linux/Windows/macOS | top全平台,htop主要Linux | 全平台 |
| 可编程性 | 极强,可嵌入业务代码 | 有限,通过API/插件 | 无,只能解析输出 | 通过PromQL查询 |
| 数据展示 | 需自行实现 | 内置CLI/Web UI | 终端实时展示 | Grafana仪表盘 |
| 告警能力 | 需自行实现 | 有限,需配合其他工具 | 无 | 内置Alertmanager |
| 历史数据 | 需自行存储 | 可导出到InfluxDB等 | 无,仅实时 | 内置时序数据库 |
| 资源消耗 | 极低(仅采集) | 中等 | 极低 | 较高 |
| 学习成本 | 低(Python API) | 低(命令即用) | 极低 | 高(整套体系) |
| 适用场景 | 嵌入式监控、自动化脚本、定制化 | 单机快速查看、远程监控 | 临时排查、极简环境 | 大规模集群、长期监控 |
各工具的适用场景分析
什么时候用psutil?
- 你需要在Python应用中嵌入系统监控逻辑
- 你需要写自动化运维脚本,对数据进行定制化处理
- 你需要跨平台的统一监控代码
- 你的监控需求比较特殊,现成工具满足不了
什么时候用Glances?
- 你需要一个开箱即用的全功能监控工具
- 你需要通过Web界面远程查看服务器状态
- 你需要快速把数据导出到InfluxDB/Prometheus
- 你不想写代码,但想要比top更丰富的信息
什么时候用top/htop?
- 你在一个最小化安装的服务器上,没有额外工具
- 你只是临时看一下进程和资源状态
- 你需要极快启动、零依赖的查看方式
- 资源极其有限的嵌入式环境
什么时候用Prometheus?
- 你管理的是大规模服务器集群
- 你需要长期存储历史数据并做趋势分析
- 你需要复杂的告警规则和多渠道通知
- 你需要和Kubernetes等容器编排平台集成
一句话总结:psutil是"零件",Glances是"成品工具",top是"瑞士军刀的小刀片",Prometheus是"整套工厂流水线"。根据你的需求选择合适的层级,不要用大炮打蚊子,也不要用螺丝刀拧螺丝帽。
九、常用场景汇总
psutil在实际工作中的应用场景非常广泛,以下是最常见的几类:
9.1 服务器健康检查接口
在微服务架构中,每个服务都应该提供健康检查端点。psutil可以让你的服务同时报告自身健康状态和服务器资源状态:
python
from fastapi import FastAPI
import psutil

app = FastAPI()

@app.get("/health")
def health():
    return {
        "status": "ok",
        "server": {
            "cpu": psutil.cpu_percent(interval=0.5),
            "memory": psutil.virtual_memory().percent,
            "disk": psutil.disk_usage("/").percent,
            "uptime": str(psutil.boot_time())
        }
    }
9.2 进程守护与自动重启
监控关键进程是否存活,如果挂了就自动重启:
python
import psutil
import subprocess
import time

def is_process_running(process_name):
    for proc in psutil.process_iter(['name']):
        try:
            if process_name.lower() in proc.info['name'].lower():
                return True
        except (psutil.NoSuchProcess, psutil.AccessDenied):
            pass
    return False

def restart_service(service_name):
    subprocess.run(['systemctl', 'restart', service_name], check=True)

while True:
    if not is_process_running('nginx'):
        print("nginx进程不存在,尝试重启...")
        restart_service('nginx')
    time.sleep(30)
9.3 资源限流与降级
在应用中根据系统资源动态调整行为,比如CPU过高时拒绝非核心请求:
python
import psutil
from functools import wraps

def system_guard(cpu_threshold=80, mem_threshold=85):
    """系统资源守卫装饰器"""
    def decorator(func):
        @wraps(func)
        def wrapper(*args, **kwargs):
            cpu = psutil.cpu_percent(interval=0.1)
            mem = psutil.virtual_memory().percent
            if cpu > cpu_threshold or mem > mem_threshold:
                return {"error": "系统繁忙,请稍后重试", "code": 503}
            return func(*args, **kwargs)
        return wrapper
    return decorator

@app.route("/api/heavy_task")
@system_guard(cpu_threshold=75, mem_threshold=80)
def heavy_task():
    # 执行计算密集型任务
    pass
9.4 日志文件大小监控
监控日志目录大小,超过阈值自动清理旧日志:
python
import psutil
import os
import glob
from datetime import datetime, timedelta

def cleanup_logs(log_dir, max_size_gb=10, retain_days=7):
    """清理过期日志,控制目录大小"""
    # 计算目录总大小
    total_size = 0
    log_files = []
    for f in glob.glob(os.path.join(log_dir, "**/*.log"), recursive=True):
        size = os.path.getsize(f)
        mtime = os.path.getmtime(f)
        total_size += size
        log_files.append((f, size, mtime))

    # 超过阈值则按修改时间删除最旧的
    if total_size > max_size_gb * 1024**3:
        log_files.sort(key=lambda x: x[2])
        for f, size, mtime in log_files:
            if total_size <= max_size_gb * 1024**3:
                break
            os.remove(f)
            total_size -= size
            print(f"已删除: {f}")

    # 删除超过保留天数的
    cutoff = (datetime.now() - timedelta(days=retain_days)).timestamp()
    for f, size, mtime in log_files:
        if mtime < cutoff:
            os.remove(f)
            print(f"已删除过期日志: {f}")
9.5 Docker容器资源监控
结合docker模块和psutil,可以监控容器的资源使用:
python
import docker
import psutil

client = docker.from_env()
for container in client.containers.list():
    stats = container.stats(stream=False)
    cpu_usage = stats['cpu_stats']['cpu_usage']['total_usage']
    memory_usage = stats['memory_stats']['usage']
    print(f"容器: {container.name}")
    print(f"  CPU使用: {cpu_usage / 1e9:.2f} 核秒")
    print(f"  内存使用: {memory_usage / 1024**3:.2f} GB")
十、面试官高频面试题
面试题一:psutil是什么?它支持哪些平台?
参考答案:
psutil(Process and System Utilities)是一个跨平台的Python第三方库,用于获取系统运行中进程的信息和系统利用率,包括CPU、内存、磁盘、网络、传感器等。它实现了ps、top、free、netstat、ifconfig等经典UNIX命令行工具的功能。
支持的平台包括Linux、Windows、macOS、FreeBSD、OpenBSD、NetBSD、Solaris等。它的最大优势是用统一的Python API屏蔽了不同操作系统的底层差异,让同一份监控代码可以在多个平台运行。
面试题二:cpu_percent(interval=1)中的interval参数是什么原理?为什么第一次调用返回0.0?
参考答案:
CPU使用率的计算原理是:在两个时间点分别采样CPU的总时间和各状态时间(用户态、系统态、空闲等),然后用非空闲时间的增量除以总时间增量,得到使用率百分比。
当interval > 0时,cpu_percent()会阻塞等待interval秒,在等待前后各采样一次,计算这段时间内的平均使用率。当interval = 0或None时,它会比较自上次调用以来的CPU时间。
第一次调用返回0.0的原因是:第一次调用时没有上一次的采样数据作为基准,只能记录当前时间点,无法计算差值,所以返回0.0。第二次调用时,用当前值减去第一次的值,才能算出真实的使用率。
面试题三:virtual_memory()中的available和free有什么区别?
参考答案:
这是最常考的内存概念题。
free:完全空闲、没有被使用的物理内存。Linux系统会尽量减少free内存,因为空闲内存是浪费,系统会用空闲内存做文件缓存(cached)和缓冲区(buffers)。available:应用程序实际可使用的内存,它等于free + 可回收的缓存 + 可回收的缓冲区。当应用需要内存时,系统可以立即回收这些缓存来满足需求。
判断服务器内存是否紧张,应该看available而不是free。一台健康的Linux服务器,free可能很小(因为都拿去做缓存了),但available应该比较充足。如果available也很低,才说明内存真的不够用了。
面试题四:如何用psutil排查CPU使用率飙高的问题?
参考答案:
排查步骤如下:
- 先看整体CPU使用率和负载:
psutil.cpu_percent(interval=1)和psutil.getloadavg(),确认是CPU密集还是IO等待。 - 看每个核心的使用率:
psutil.cpu_percent(percpu=True),判断是单线程跑满一个核还是全核都高。 - 看CPU时间分布:
psutil.cpu_times(),如果iowait高说明是磁盘IO瓶颈,如果user高说明是计算密集,如果system高说明是系统调用过多。 - 找出占用CPU最高的进程:用
psutil.process_iter()遍历所有进程,按cpu_percent()排序取Top进程。 - 对可疑进程进一步分析:
proc.cpu_times()看用户态和内核态时间,proc.num_threads()看线程数,proc.open_files()看打开的文件。
python
import psutil

# 找出Top 5 CPU进程
procs = []
for p in psutil.process_iter(['pid', 'name', 'cpu_percent', 'memory_percent']):
    try:
        procs.append(p.info)
    except (psutil.NoSuchProcess, psutil.AccessDenied):
        pass

top5 = sorted(procs, key=lambda x: x['cpu_percent'], reverse=True)[:5]
for p in top5:
    print(f"PID:{p['pid']} {p['name']} CPU:{p['cpu_percent']}% MEM:{p['memory_percent']:.1f}%")
面试题五:psutil和top、Glances、Prometheus有什么区别?各自的适用场景是什么?
参考答案:
这四个工具处于不同的抽象层级:
- top/htop:是操作系统自带的命令行工具,零依赖、启动快,但只能实时查看,无法编程、无法存储历史数据、无法告警。适合临时排查问题。
- psutil:是Python库,只负责数据采集,把展示和告警的灵活性交给开发者。适合嵌入应用、写自动化脚本、做定制化监控。
- Glances:是基于psutil构建的完整监控工具,内置CLI和Web UI,支持数据导出。适合单机快速查看和远程监控,但不适合大规模集群。
- Prometheus + Node Exporter:是完整的企业级监控系统,包含数据采集、时序存储、查询引擎、告警管理。适合大规模集群的长期监控,但部署和维护成本高。
简单来说:临时排查用top,写脚本用psutil,单机看全貌用Glances,集群监控用Prometheus。
面试题六:如何设计一个基于psutil的服务器监控告警系统?
参考答案:
一个完整的监控告警系统应该包含以下模块:
- 数据采集层:用psutil定时采集CPU、内存、磁盘、网络、进程等指标,采集间隔根据需求设置(如60秒)。
- 数据存储层:将采集到的数据存入时序数据库(如InfluxDB)或简单的SQLite/CSV,用于历史趋势分析。
- 规则引擎层:定义阈值规则(CPU>85%、内存>90%、磁盘>85%),支持连续N次超过阈值才告警,避免抖动。
- 告警通知层:支持钉钉、企业微信、邮件、短信等多渠道通知,支持告警分级(警告/严重)和告警聚合。
- 报表展示层:生成HTML巡检报表或对接Grafana做可视化仪表盘。
- 调度层:用crontab或APScheduler做定时调度,保证程序异常退出后能自动恢复。
关键设计要点:采集本身不能影响系统性能(psutil很轻量)、告警要有去重和抑制机制、要监控Inode而不仅是磁盘空间、要处理僵尸进程和关键进程存活检测。
面试题七:process_iter()和pids()有什么区别?为什么推荐用process_iter()?
参考答案:
psutil.pids()返回当前所有进程PID的列表,然后你需要逐个用Process(pid)去获取信息。psutil.process_iter()直接返回Process对象的迭代器,可以在迭代时指定需要的属性(如attrs=['pid', 'name', 'cpu_percent']),一次性获取。
推荐用process_iter()的原因:
- 避免竞态条件 :在
pids()返回列表到你逐个Process(pid)之间,进程可能已经退出,导致大量NoSuchProcess异常。process_iter()在迭代时处理了这种情况。 - 性能更好 :指定
attrs参数后,psutil会一次性获取所需属性,减少系统调用次数。 - 代码更简洁:直接迭代Process对象,不需要手动构造。
面试题八:监控磁盘时只看disk_usage().percent够吗?还有什么容易忽略的点?
参考答案:
不够。只监控磁盘空间使用率有两个常见的盲区:
- Inode使用率 :在大量小文件的场景(如邮件服务器、会话存储、缓存目录),磁盘空间还很充足,但Inode可能已经耗尽,导致无法创建新文件。需要用
os.statvfs()补充监控Inode。 - 磁盘IO性能 :空间充足不代表磁盘正常。磁盘可能出现IO等待过高(iowait)、读写速度骤降、坏道等问题。需要用
psutil.disk_io_counters()监控读写速率和IO等待时间。
另外还要注意:disk_partitions()默认不包含虚拟文件系统(如proc、sysfs),如果需要完整列表要传all=True参数;某些挂载点可能因为权限问题无法读取,需要异常处理。
十一、总结
psutil是Python生态中系统监控领域的基石级库。它用简洁统一的API,把原本需要十几个命令行工具才能获取的系统信息,封装成了几行Python代码就能搞定的结构化数据。
回顾本文的核心内容:
- 是什么:psutil是跨平台的进程与系统工具库,支持CPU、内存、磁盘、网络、进程五大维度的监控。
- 为什么用:跨平台一致性、结构化数据无需解析、可编程可嵌入、轻量高效。
- 演进历程:从2009年诞生到今天,十七年迭代,从Linux专用到全平台支持,甚至反哺了Python标准库。
- 怎么用:从安装到每个API的详细用法,再到企业级自动巡检系统的完整实现。
- 竞品对比:psutil是"零件",Glances是"成品",top是"小刀",Prometheus是"工厂",各有适用场景。
- 面试考点:interval原理、available vs free、CPU飙高排查、监控系统设计等。
正如《道德经》所言:"天下难事,必作于易;天下大事,必作于细。" 服务器监控看似是运维的基础工作,但真正做到精准、及时、自动化,需要对每一个细节都有深入的理解。psutil就是帮你把这些细节化繁为简的利器。
掌握了psutil,你就掌握了用Python对话操作系统的能力。无论是写自动化运维脚本、构建监控告警系统,还是在应用中嵌入资源保护逻辑,psutil都能成为你手中最可靠的工具。
本文为原创文章,如需转载,请联系作者获得授权,并注明出处。