欢迎加入开源鸿蒙 PC 社区:https://harmonypc.csdn.net/
欢迎在 PC 社区平台申请新建项目:https://atomgit.com/OpenHarmonyPCDeveloper
适配开源地址:https://atomgit.com/OpenHarmonyPCDeveloper/ohos_hive
环境搭建文章:https://blog.csdn.net/weixin_52908342/article/details/161343743
一、为什么要适配 Apache Hive
Apache Hive 是 Hadoop 生态中成熟的分布式 SQL 数据仓库组件。它用接近关系型数据库的 HiveQL 描述批处理与分析任务,通过 HiveServer2 向客户端提供统一入口,再把查询计划交给 Tez、MapReduce、Spark 等执行引擎。对于已经积累了大量离线数仓、数据治理规则和运维体系的团队来说,Hive 仍是访问历史数据资产的重要接口。
HarmonyOS PC 正在进入研发、数据分析和企业生产力场景。这里真正需要的并不是在一台个人电脑里启动一整套 Hadoop 集群,而是让使用者能够在鸿蒙桌面上完成高频工作:配置 HiveServer2、执行 HiveQL、查看查询结果、浏览库表字段,以及观察查询和会话状态。选择 Hive 做适配,也能验证一个比普通单机工具更有代表性的问题------传统 Java 大数据服务如何在不破坏集群边界的前提下,为 HarmonyOS PC 提供可维护的原生客户端。
本次适配在上游 Hive 工程之外新增 ohos/ 模块,应用包名为 org.apache.hive.ohos,版本为 4.3.0-ohos.1,支持 2in1 与 tablet,目标 ABI 为 arm64-v8a。鸿蒙端采用 Qt 5.15.12 Widgets 构建桌面界面,应用版本与服务端部署解耦,原有 HiveServer2、Metastore、存储与执行引擎继续按标准集群方式运行。
二、先确定适配边界:迁移的是客户端,不是把集群装进 HAP
Hive 不是单进程桌面软件。一个可用于生产的 Hive 环境通常还依赖 HiveServer2、Metastore 数据库、HDFS 或对象存储、YARN、执行引擎、认证授权系统以及大量服务端 Java 依赖。如果把"适配"理解为在 HAP 内启动这些组件,不仅会带来包体、JVM、后台进程和资源调度问题,也会破坏 Hive 本来就依赖的集群安全边界。
项目因此采用"鸿蒙原生客户端 + 服务端 Gateway + 既有 Hive 集群"的三层方案:
| 层次 | 原有 Hive 职责 | 鸿蒙适配后的处理方式 |
|---|---|---|
| 用户入口 | Beeline、JDBC/ODBC 或 Web UI | Qt Widgets 桌面客户端 |
| 应用宿主 | Java/桌面进程 | Stage 模型 EntryAbility + XComponent |
| 查询执行 | Hive JDBC 直连 HiveServer2 | 服务端 Gateway 将 HTTP/JSON 转为 JDBC |
| 查询监控 | HiveServer2 Web API | 客户端读取 active、historical、sessions 接口 |
| 元数据 | Hive JDBC DatabaseMetaData |
Gateway 返回 Schema、Table、Column JSON |
| 计算与存储 | Tez、MapReduce、LLAP、HDFS 等 | 保留在集群侧,不进入 HAP |
| 认证与授权 | Kerberos、LDAP、Ranger 等 | 继续由服务端体系承担 |
这个边界有两层实际意义。第一,鸿蒙客户端无需携带 Hadoop 和 Hive JDBC 的整套依赖,HAP 只负责交互与网络编排;第二,查询引擎、权限策略和数据访问仍处在运维人员管理的服务端信任域中,不会因为增加一个桌面入口而改变原有部署模型。
三、鸿蒙版本的整体架构
Stage 工程中的 ArkTS 代码只负责 Ability 生命周期和窗口承载。Index.ets 创建 NODE 类型 XComponent,Qt for OpenHarmony 的 QPA 插件由 EntryAbility 启动,随后加载 libentry.so。主窗口、网络请求、表格渲染和本地设置均在 Native Qt 层完成。
text
HarmonyOS PC
└── EntryAbility
    └── Index.ets / XComponent
        └── qopenharmony QPA
            └── libentry.so
                ├── Hive 连接配置
                ├── HiveQL 编辑与结果表格
                ├── Schema / Table / Column 浏览
                └── 活跃查询、历史查询与会话视图
                         │
                         ├── HiveServer2 Web API
                         └── Hive Gateway(HTTP/JSON)
                                  └── Hive JDBC
                                       └── HiveServer2 / Metastore / 执行集群
与鸿蒙相关的主要目录如下:
text
ohos_hive/
├── README.OpenHarmony_CN.md
└── ohos/
    ├── AppScope/                         # 应用名称、图标和包级配置
    ├── entry/
    │   └── src/main/
    │       ├── ets/                      # Ability 与 XComponent 宿主
    │       ├── resources/                # 模块图标和资源
    │       └── cpp/
    │           ├── hive_main_window.cpp  # Qt 主窗口与用户流程
    │           ├── hive_api_client.cpp   # Web API / Gateway 请求
    │           └── CMakeLists.txt         # Native 构建入口
    ├── hive-gateway/                     # HTTP/JSON 到 Hive JDBC 的服务端适配器
    ├── qtforharmony_sdk/                 # Qt for OpenHarmony SDK
    ├── docs/                              # 构建、部署和能力覆盖说明
    └── evidence/real-device/              # 真机截图、日志与闭环记录
客户端使用 QNetworkAccessManager 发起请求,并为单次请求设置 15 秒超时。HiveServer2 监控接口与 Gateway 接口分别处理:前者获取活跃查询、历史查询和会话;后者负责健康检查、HiveQL 执行和 JDBC 元数据读取。结果进入统一的 JSON 到表格转换逻辑,避免页面各自维护一套字段解析代码。
四、在真机上完成 Hive 客户端核心闭环
以下五张截图均来自签名 HAP 在 Huawei MateBook Pro HarmonyOS PC 真机上的实际运行画面,分辨率为 3120×2080。验收链路使用真实 HiveServer2、Derby Metastore 和 Hive JDBC Gateway,通过 HDC reverse 将设备访问的 127.0.0.1:10002 与 127.0.0.1:19090 转发到测试服务;截图中的数据库、表、字段和 queryId 都来自实际请求,不是静态占位数据或协议 Mock。
1. 连接 Gateway 并刷新 HiveServer2 状态
客户端顶部集中放置 HiveServer2 Web UI、Gateway、用户、数据库和 Token 等连接项。点击"连接 / 刷新"后,应用同时检查 Gateway 健康状态并请求 HiveServer2 监控接口。真机画面中状态已经变为"Hive Gateway 已连接",运行概览也完成了活跃查询刷新。
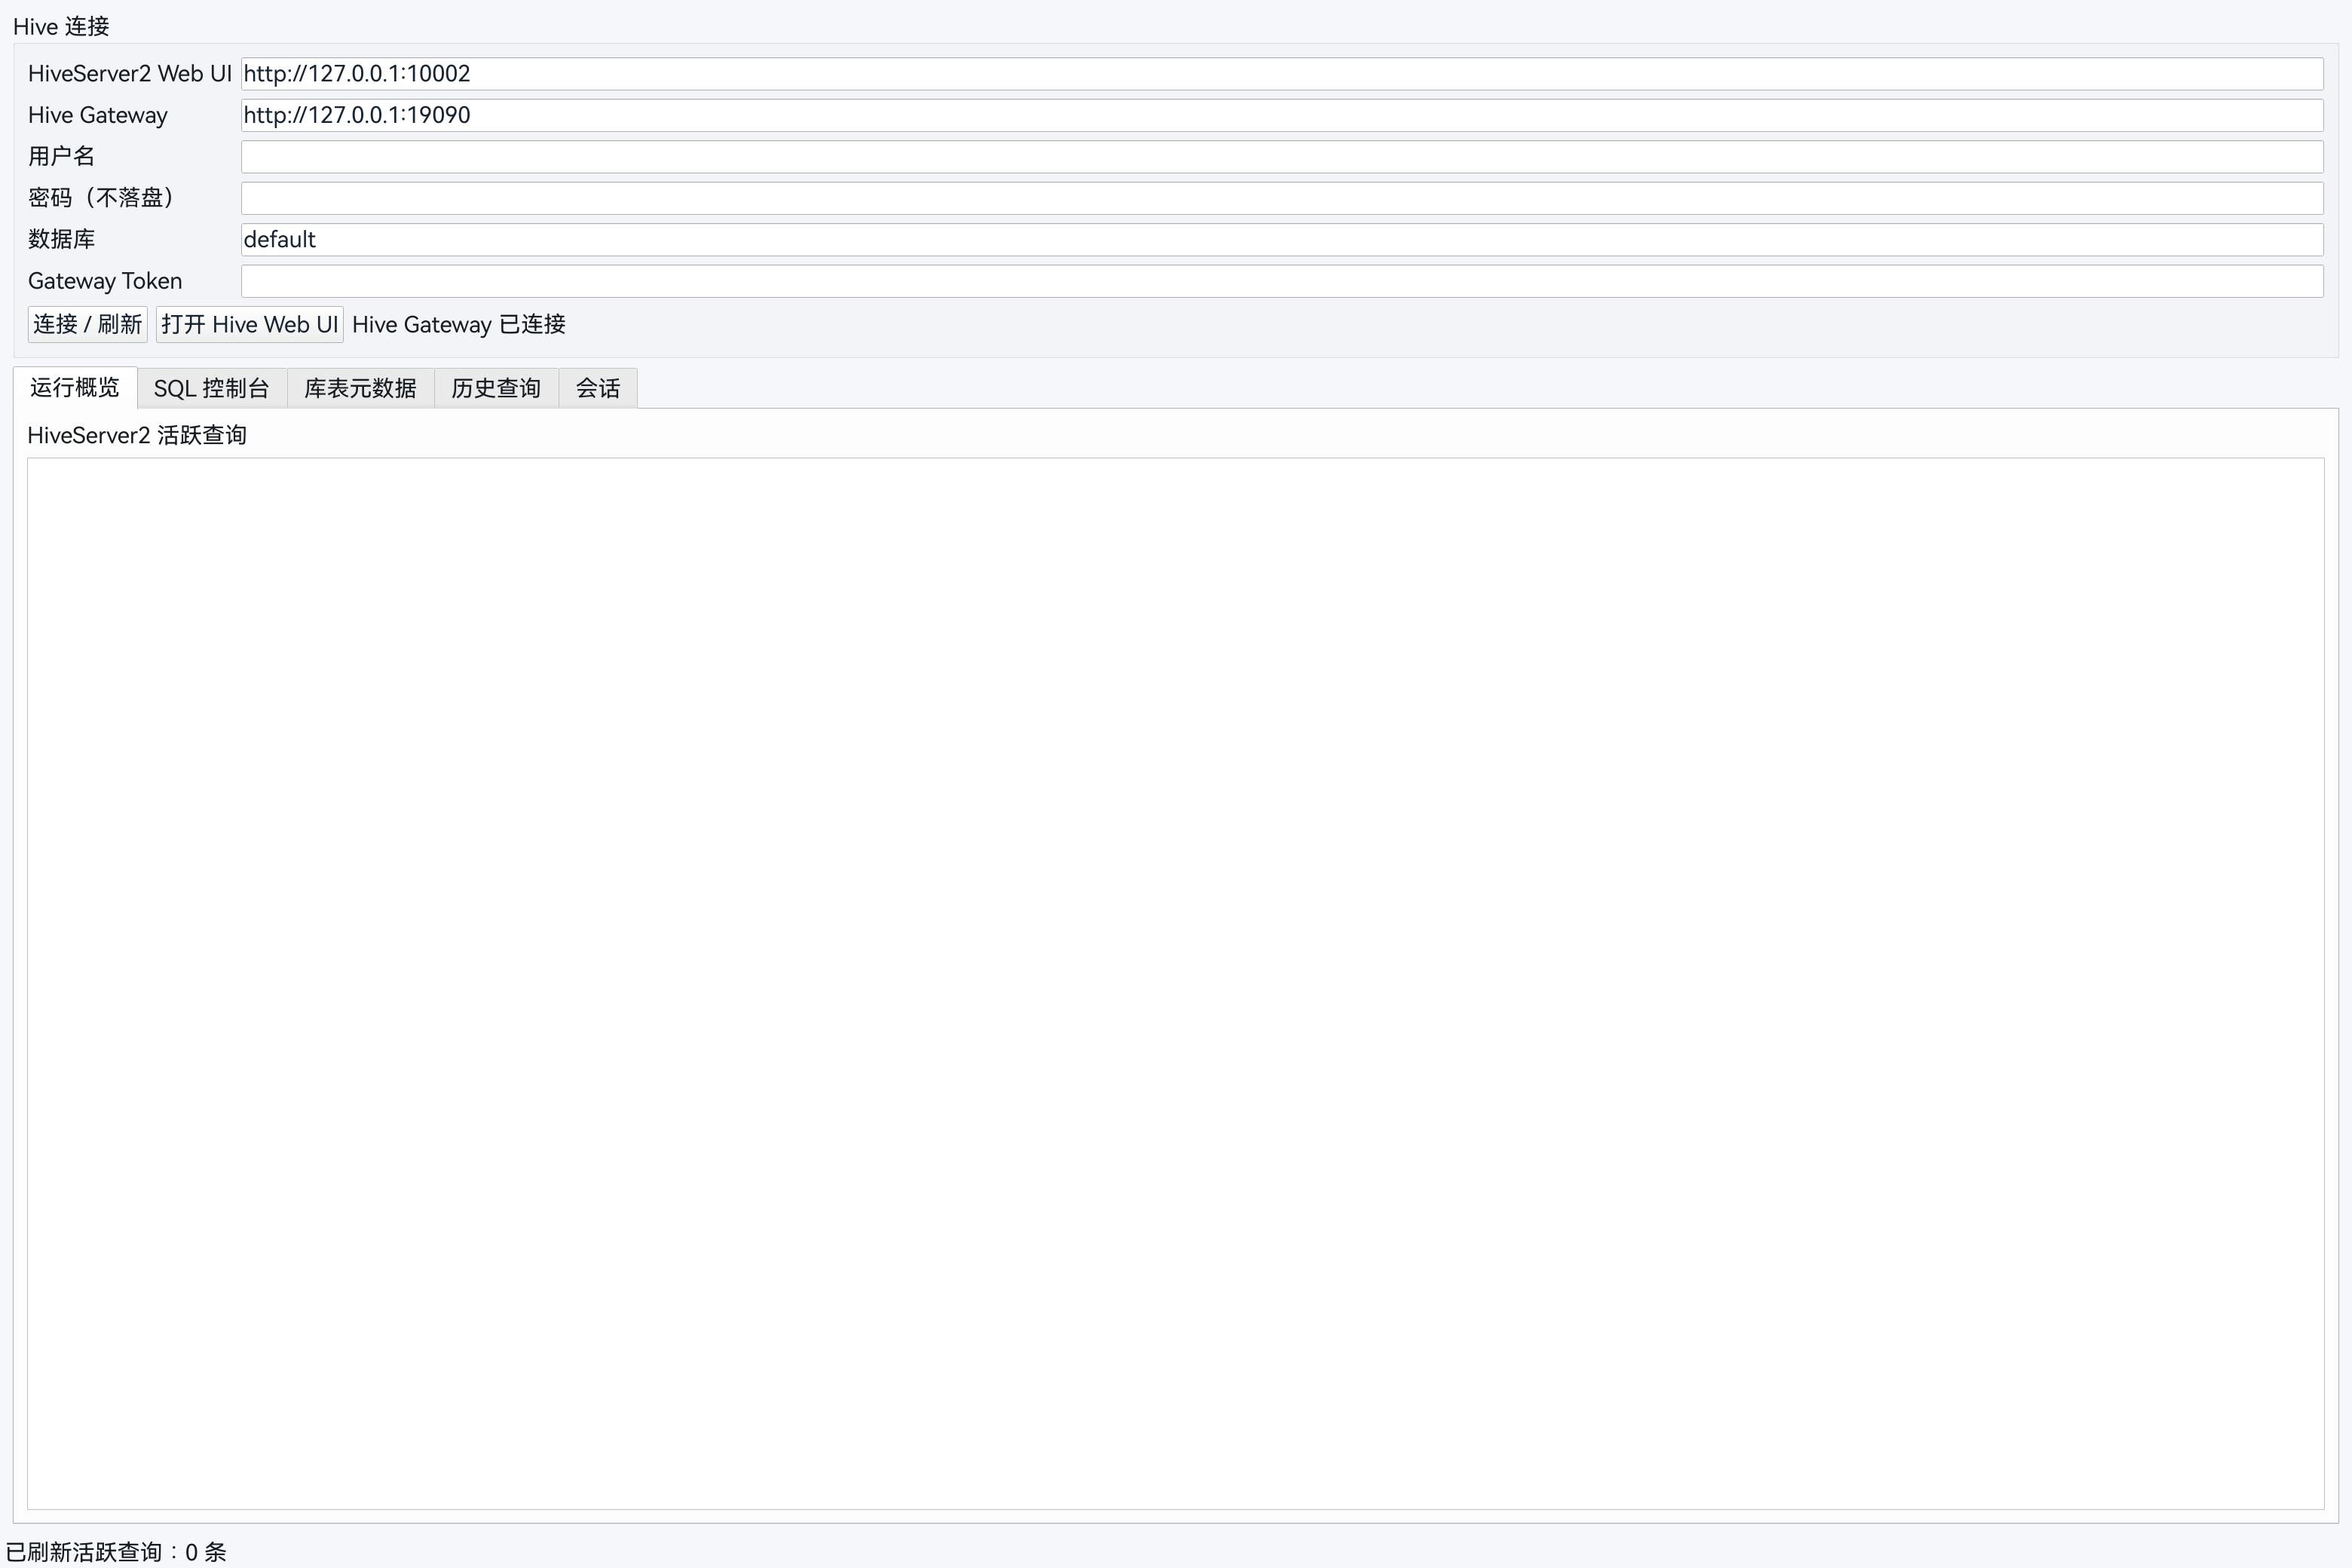
连接信息采用有意收敛的持久化策略:地址、用户名和数据库可以通过 QSettings 保存,密码和 Gateway Token 不落盘。这样既保留桌面客户端的便利性,也避免把敏感凭据写入普通应用设置文件。生产环境仍应使用 HTTPS、短期令牌以及既有身份系统保护链路。
2. 执行真实 HiveQL 并展示结构化结果
SQL 控制台提供多行编辑器、执行入口、结果表格和查询摘要。此次输入 SHOW DATABASES; 后,Gateway 通过 Hive JDBC 执行语句,返回列名 database_name、结果 default、查询标识和更新计数;客户端解析 JSON 后按列构造表格。
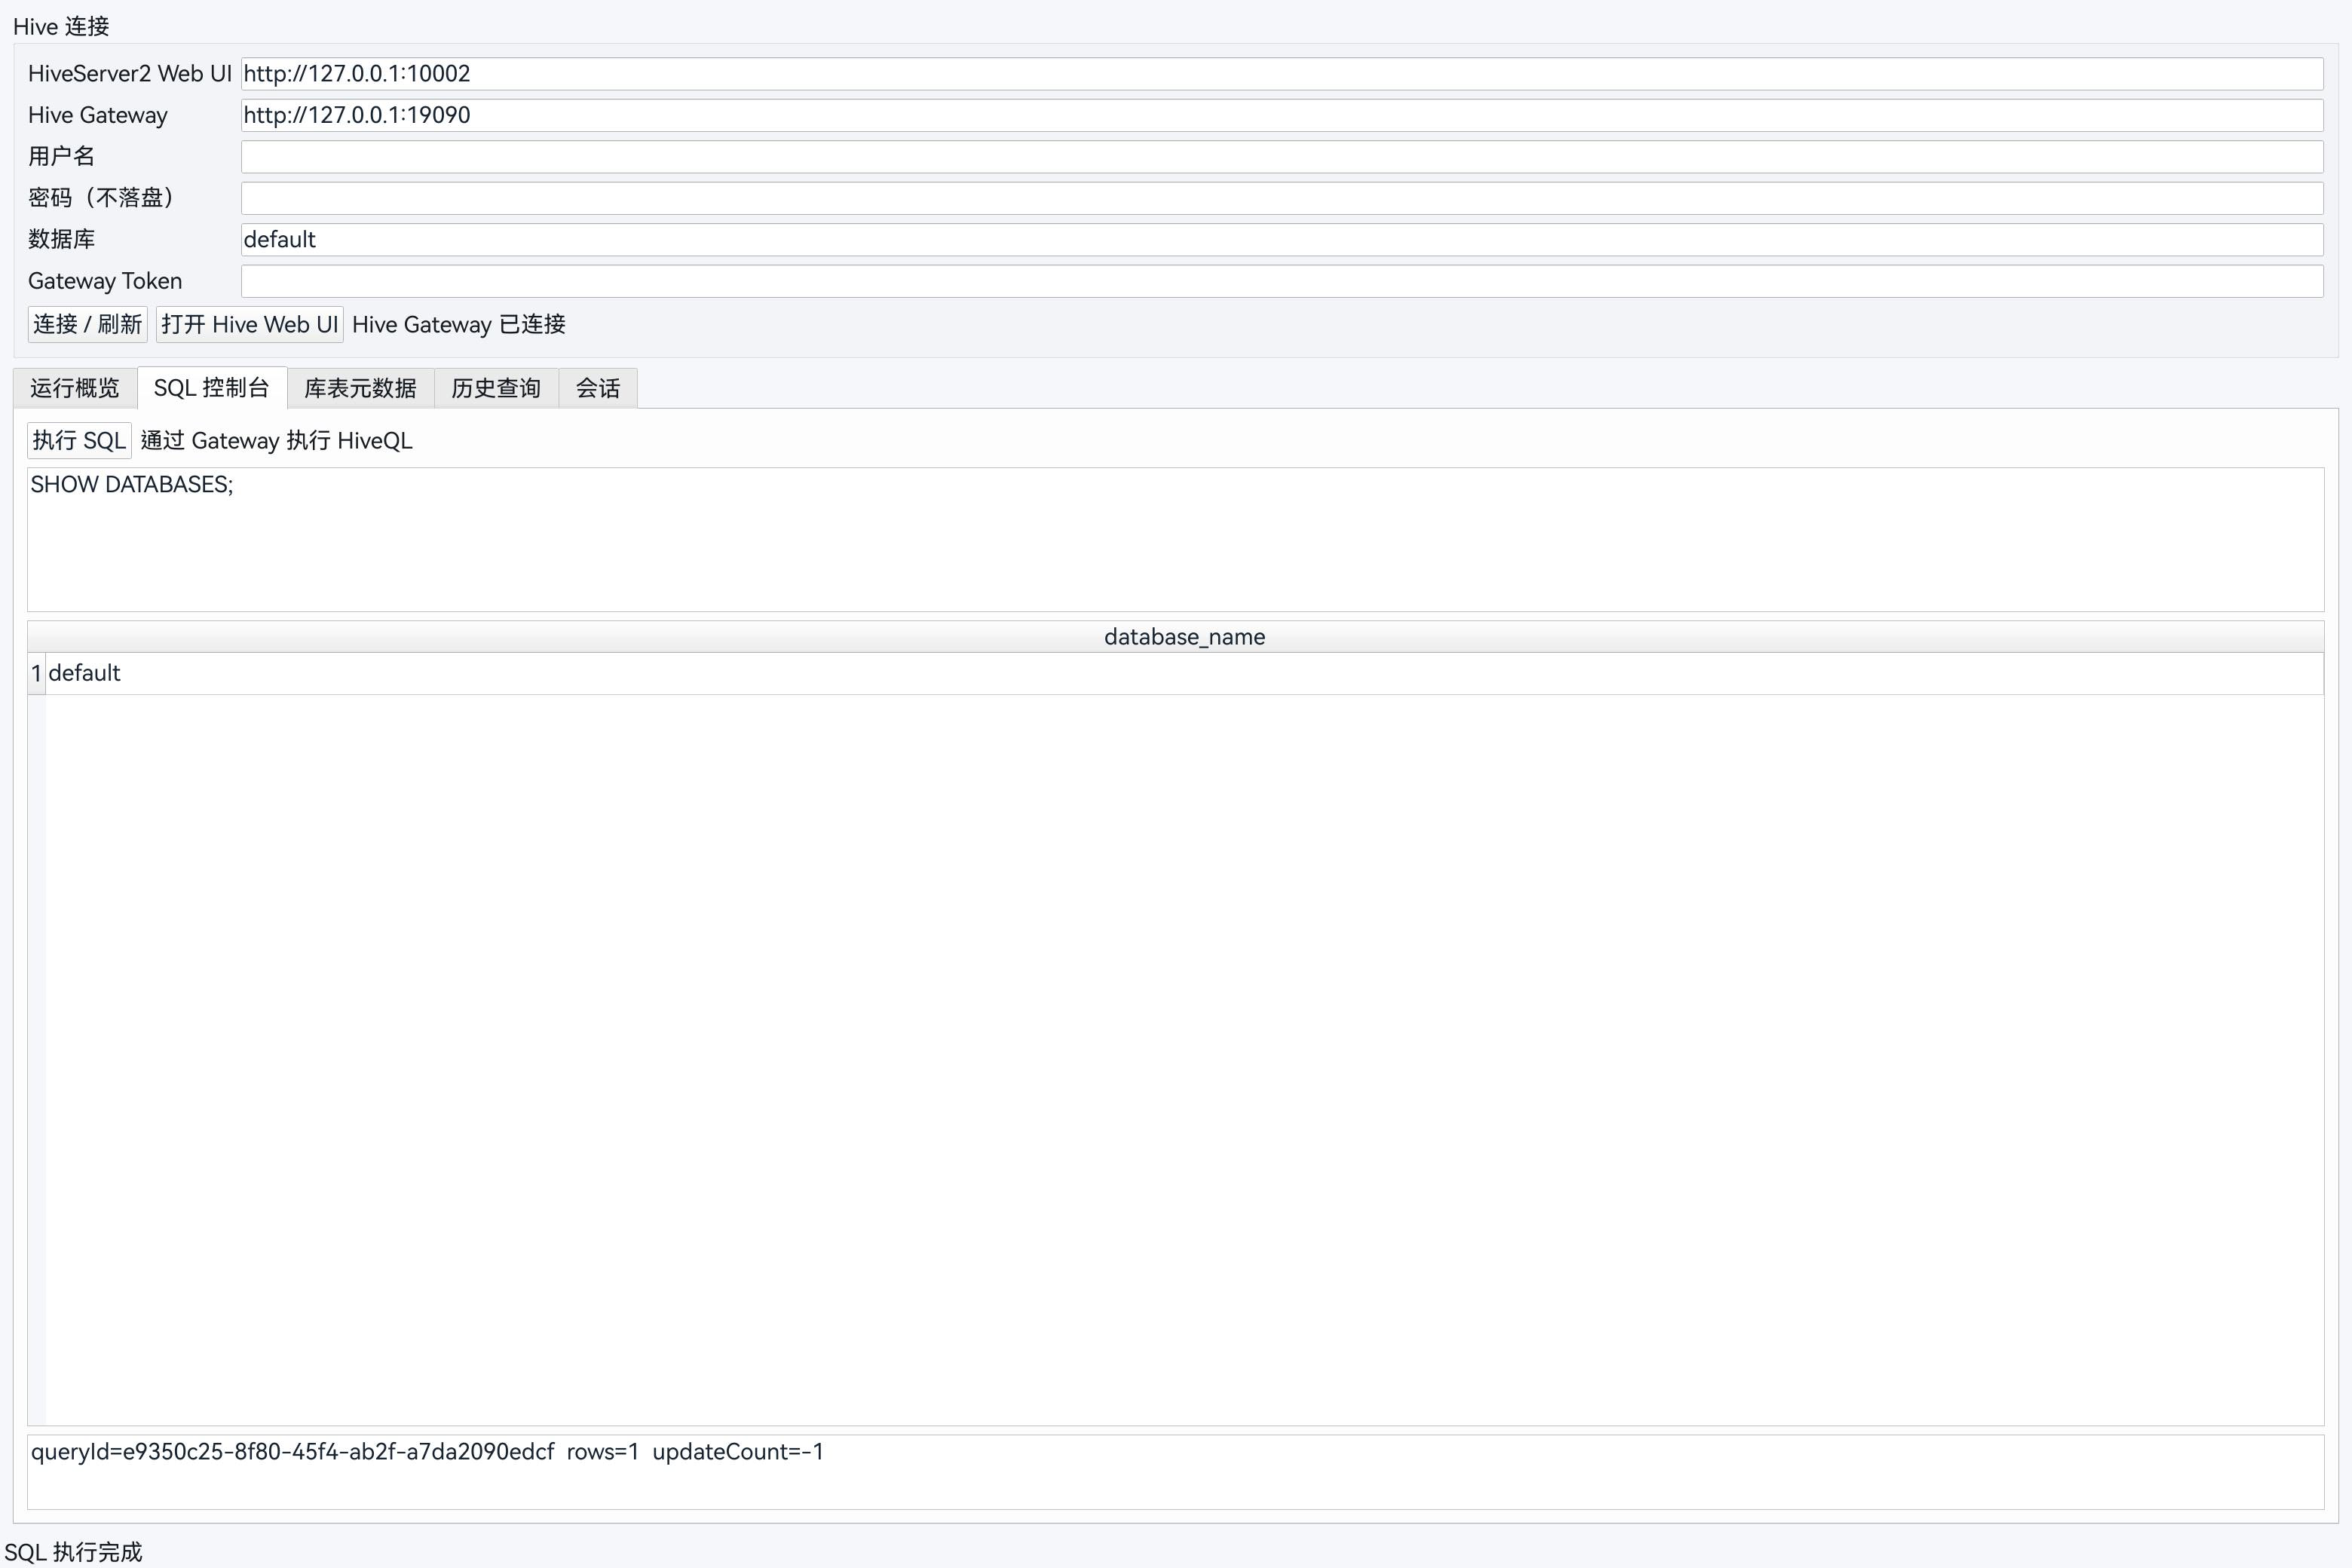
Gateway 使用 Statement.execute 同时兼容有结果集的查询和只返回更新计数的 DDL/DML。结果行数由服务端上限控制,查询超时也在 JDBC Statement 侧配置,避免桌面端一次加载无边界数据。客户端网络失败、超时和非法 JSON 会进入可见错误状态,不会因后端暂时不可用而退出窗口。
3. 从 JDBC 元数据读取 Schema
库表元数据页不是对 HiveQL 结果做字符串拼接,而是调用 JDBC DatabaseMetaData。选择 schemas 后,Gateway 读取 getSchemas() 并将 Schema 与 Catalog 转成 JSON。真机返回 default,说明客户端、Gateway、JDBC 与 Metastore 已经形成连续数据链。
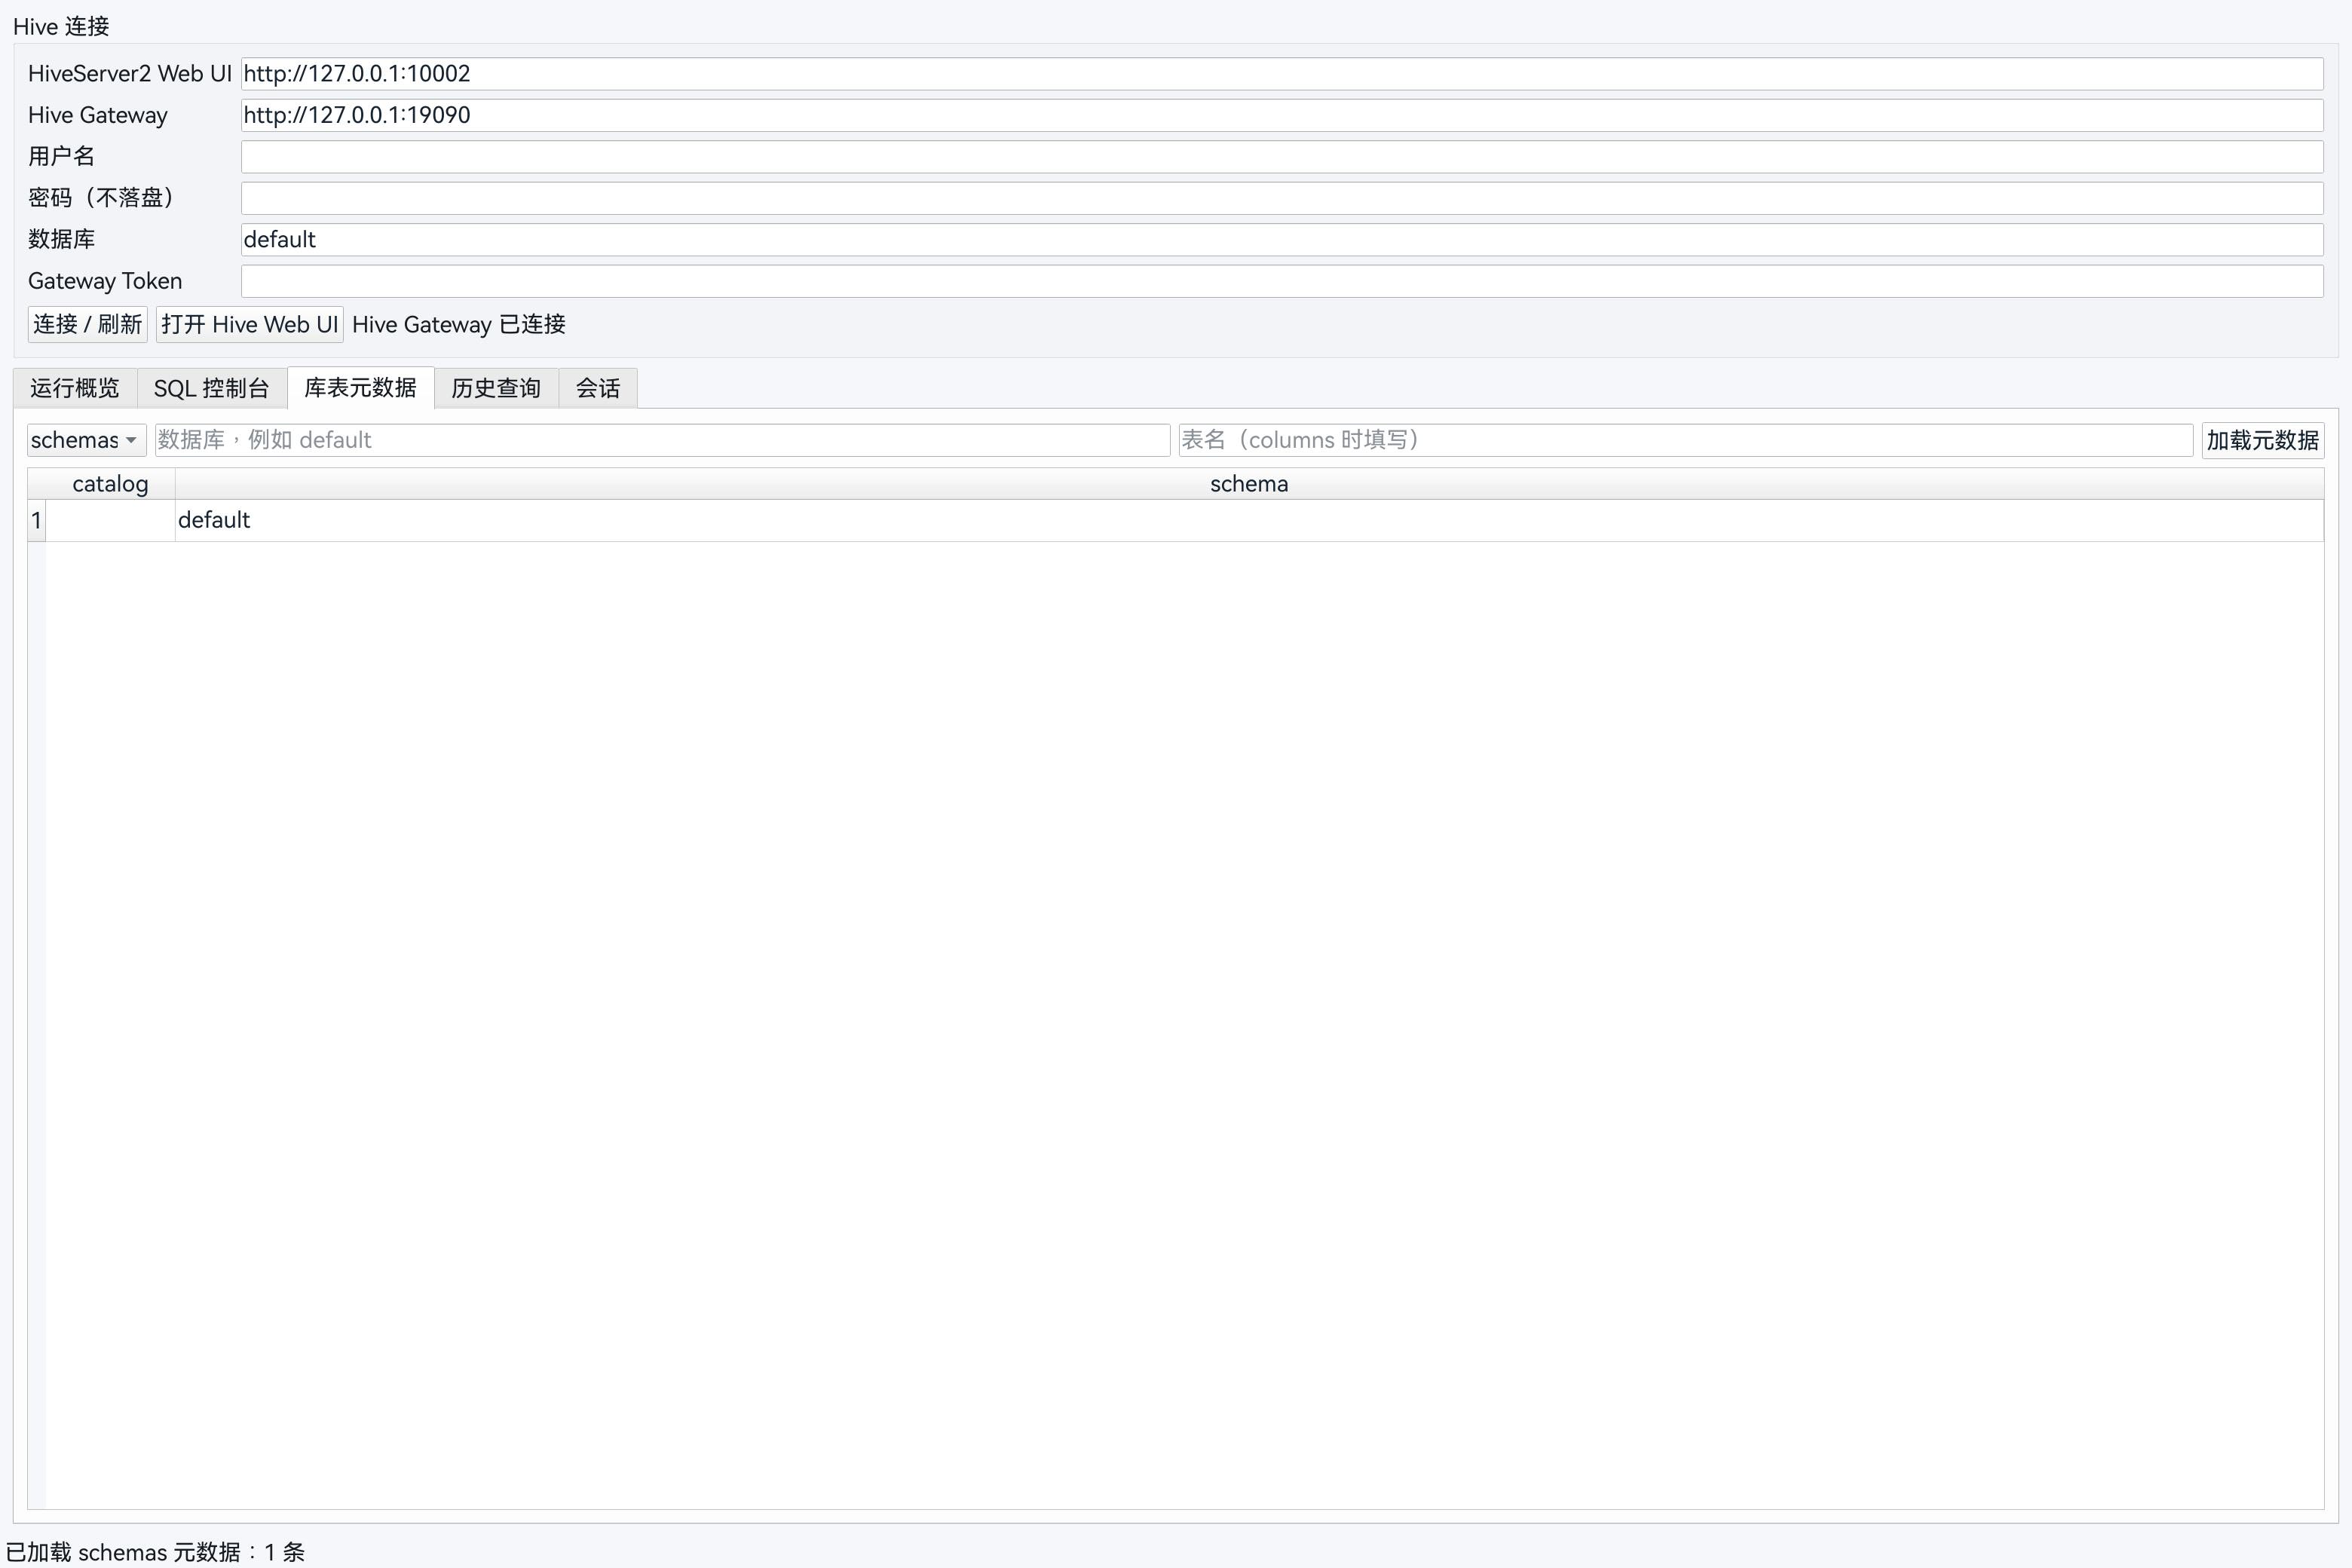
把元数据访问独立成接口后,客户端无需了解不同 Hive 版本的元数据库表结构,也不会直接连接 Metastore 数据库。元数据语义由 Hive JDBC 负责,鸿蒙侧只处理稳定的业务对象。
4. 浏览数据库中的真实表
在 tables 模式下指定 default 数据库,Gateway 调用 getTables() 获取表和视图。本次测试返回验收过程中创建的 ohos_qt_smoke,类型为 TABLE。这一结果与前一步的 Schema 选择保持同一数据库上下文。
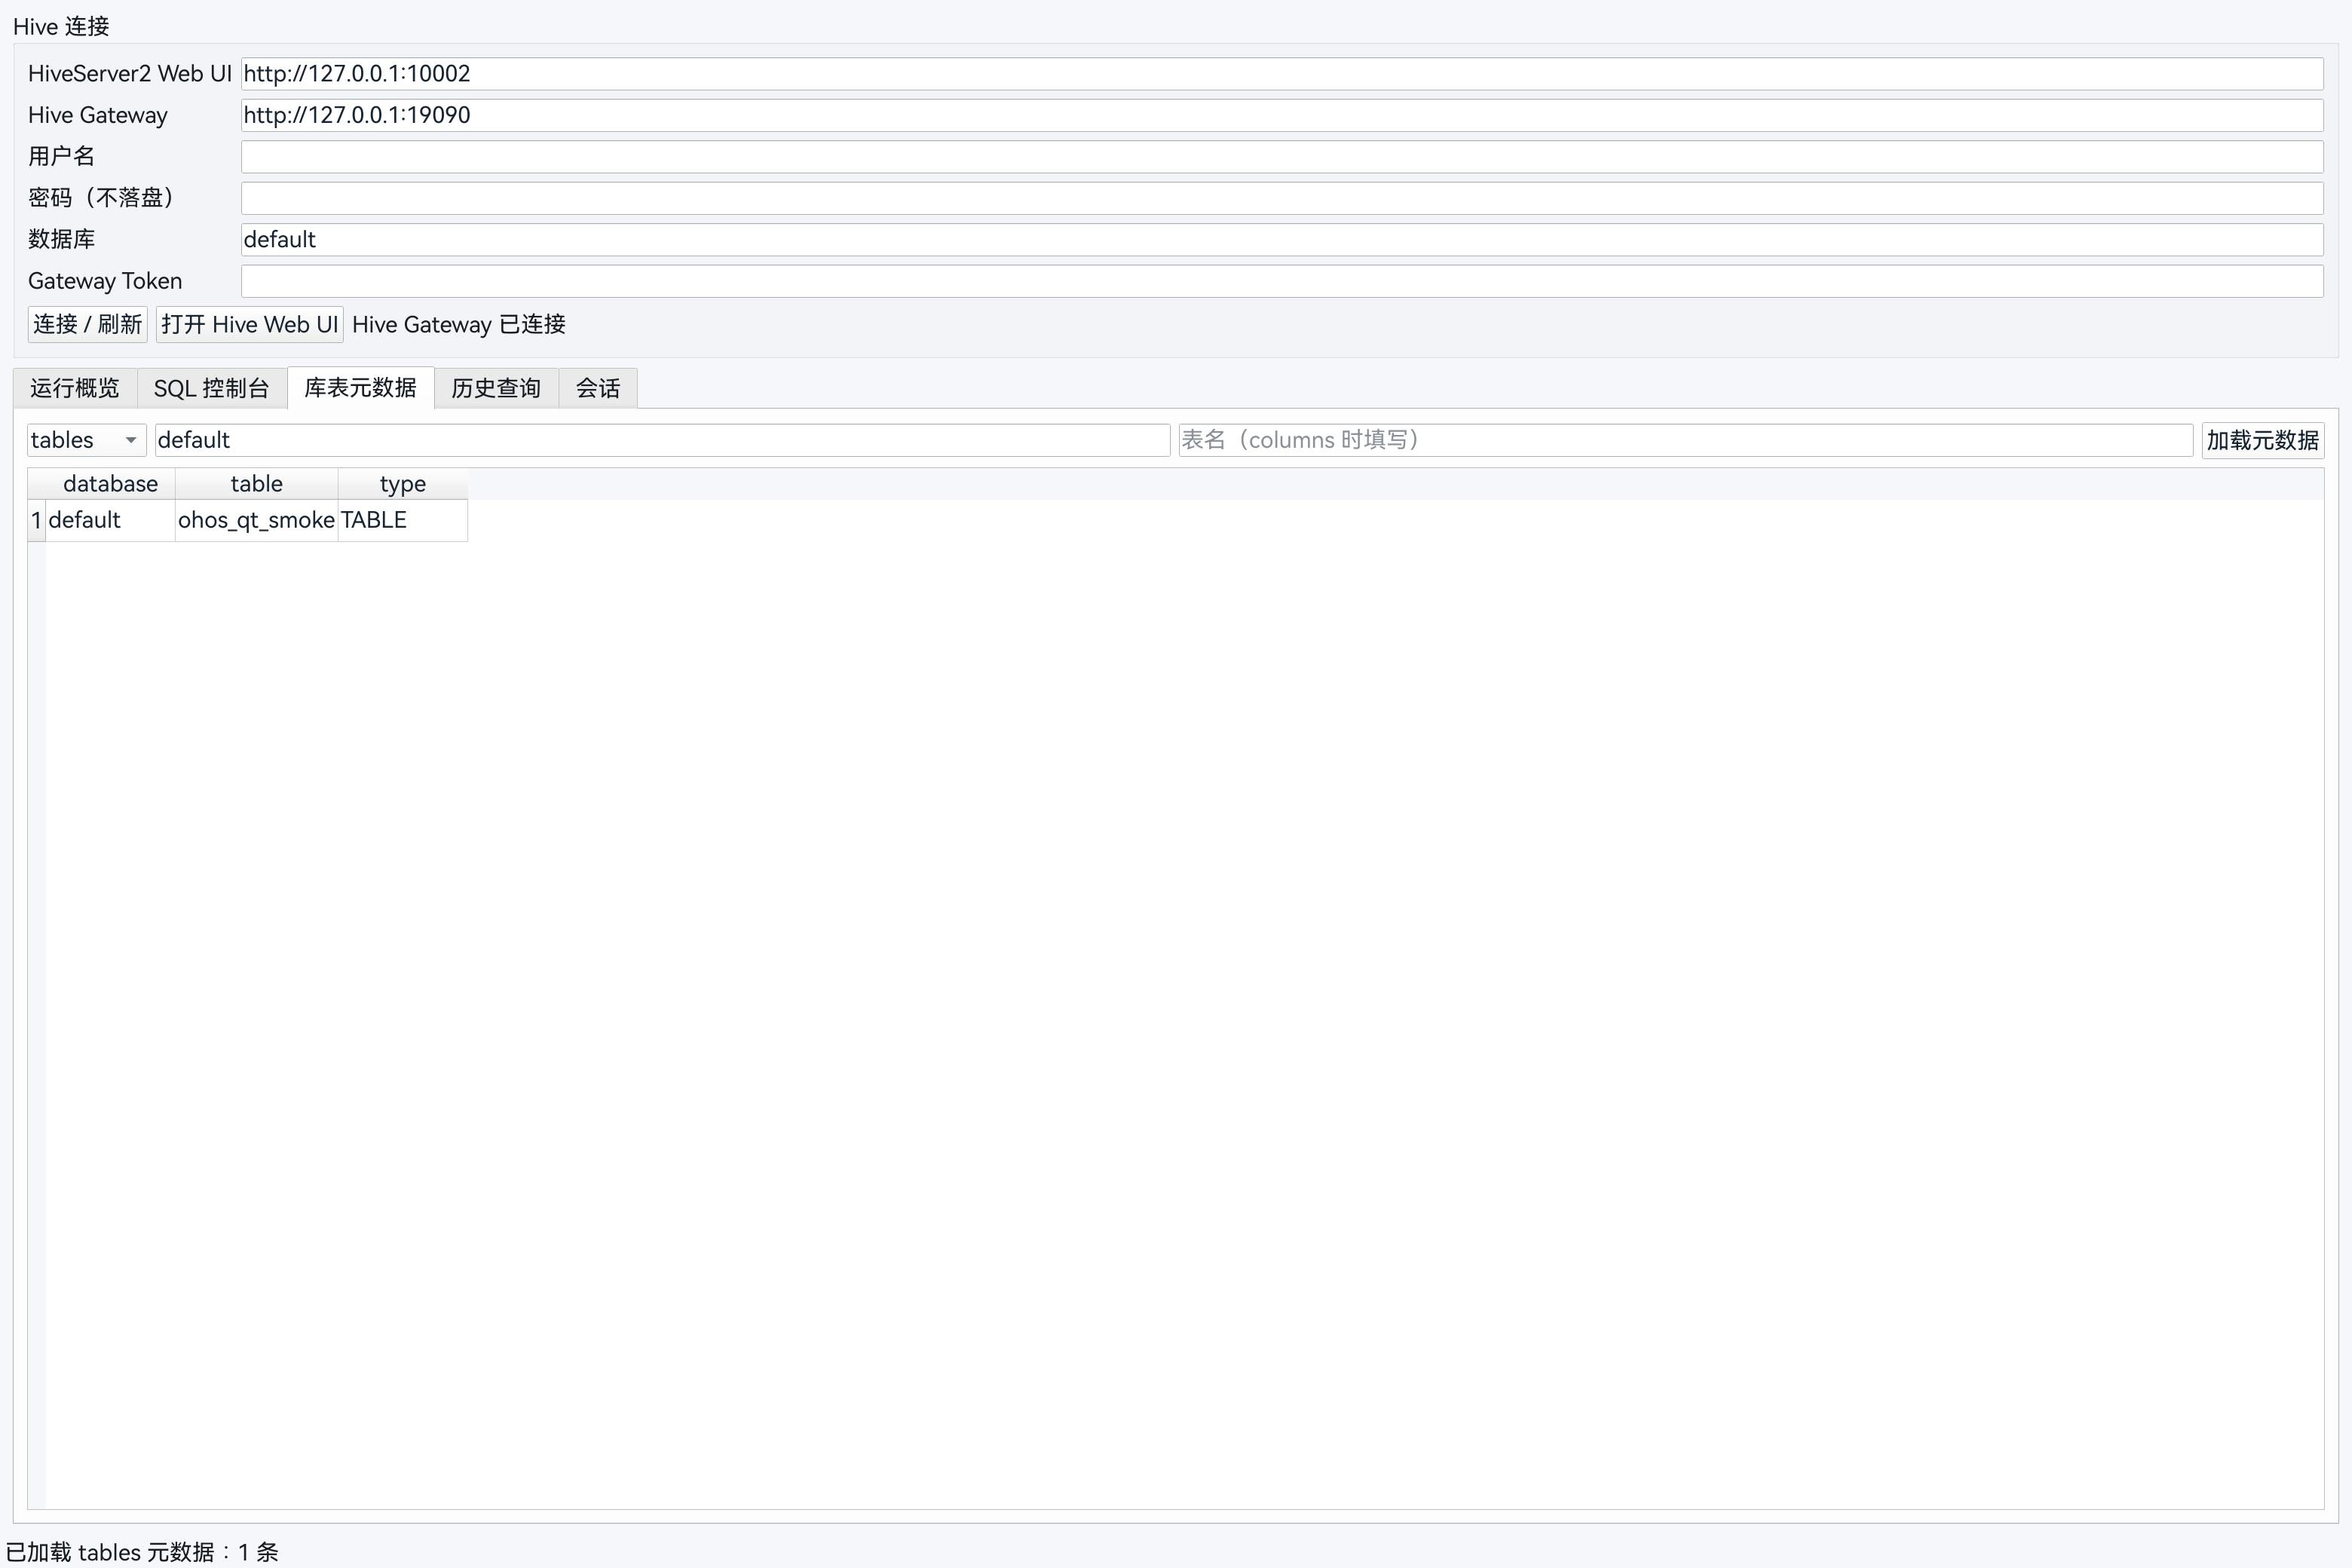
当前实现把数据库和表名作为明确参数传递,既便于后续加入库表联动,也能避免客户端通过拼接 SQL 模拟元数据浏览。表格列来自服务端 JSON 对象,新增字段时仍可在现有渲染逻辑中展示。
5. 下钻到字段名、顺序和类型
最后选择 columns,填写 default 与 ohos_qt_smoke。真机返回两列:id INT 和 name STRING,同时显示字段序号与长度信息。至此,从连接、SQL 执行到 Schema、Table、Column 浏览的主要操作已经闭环。
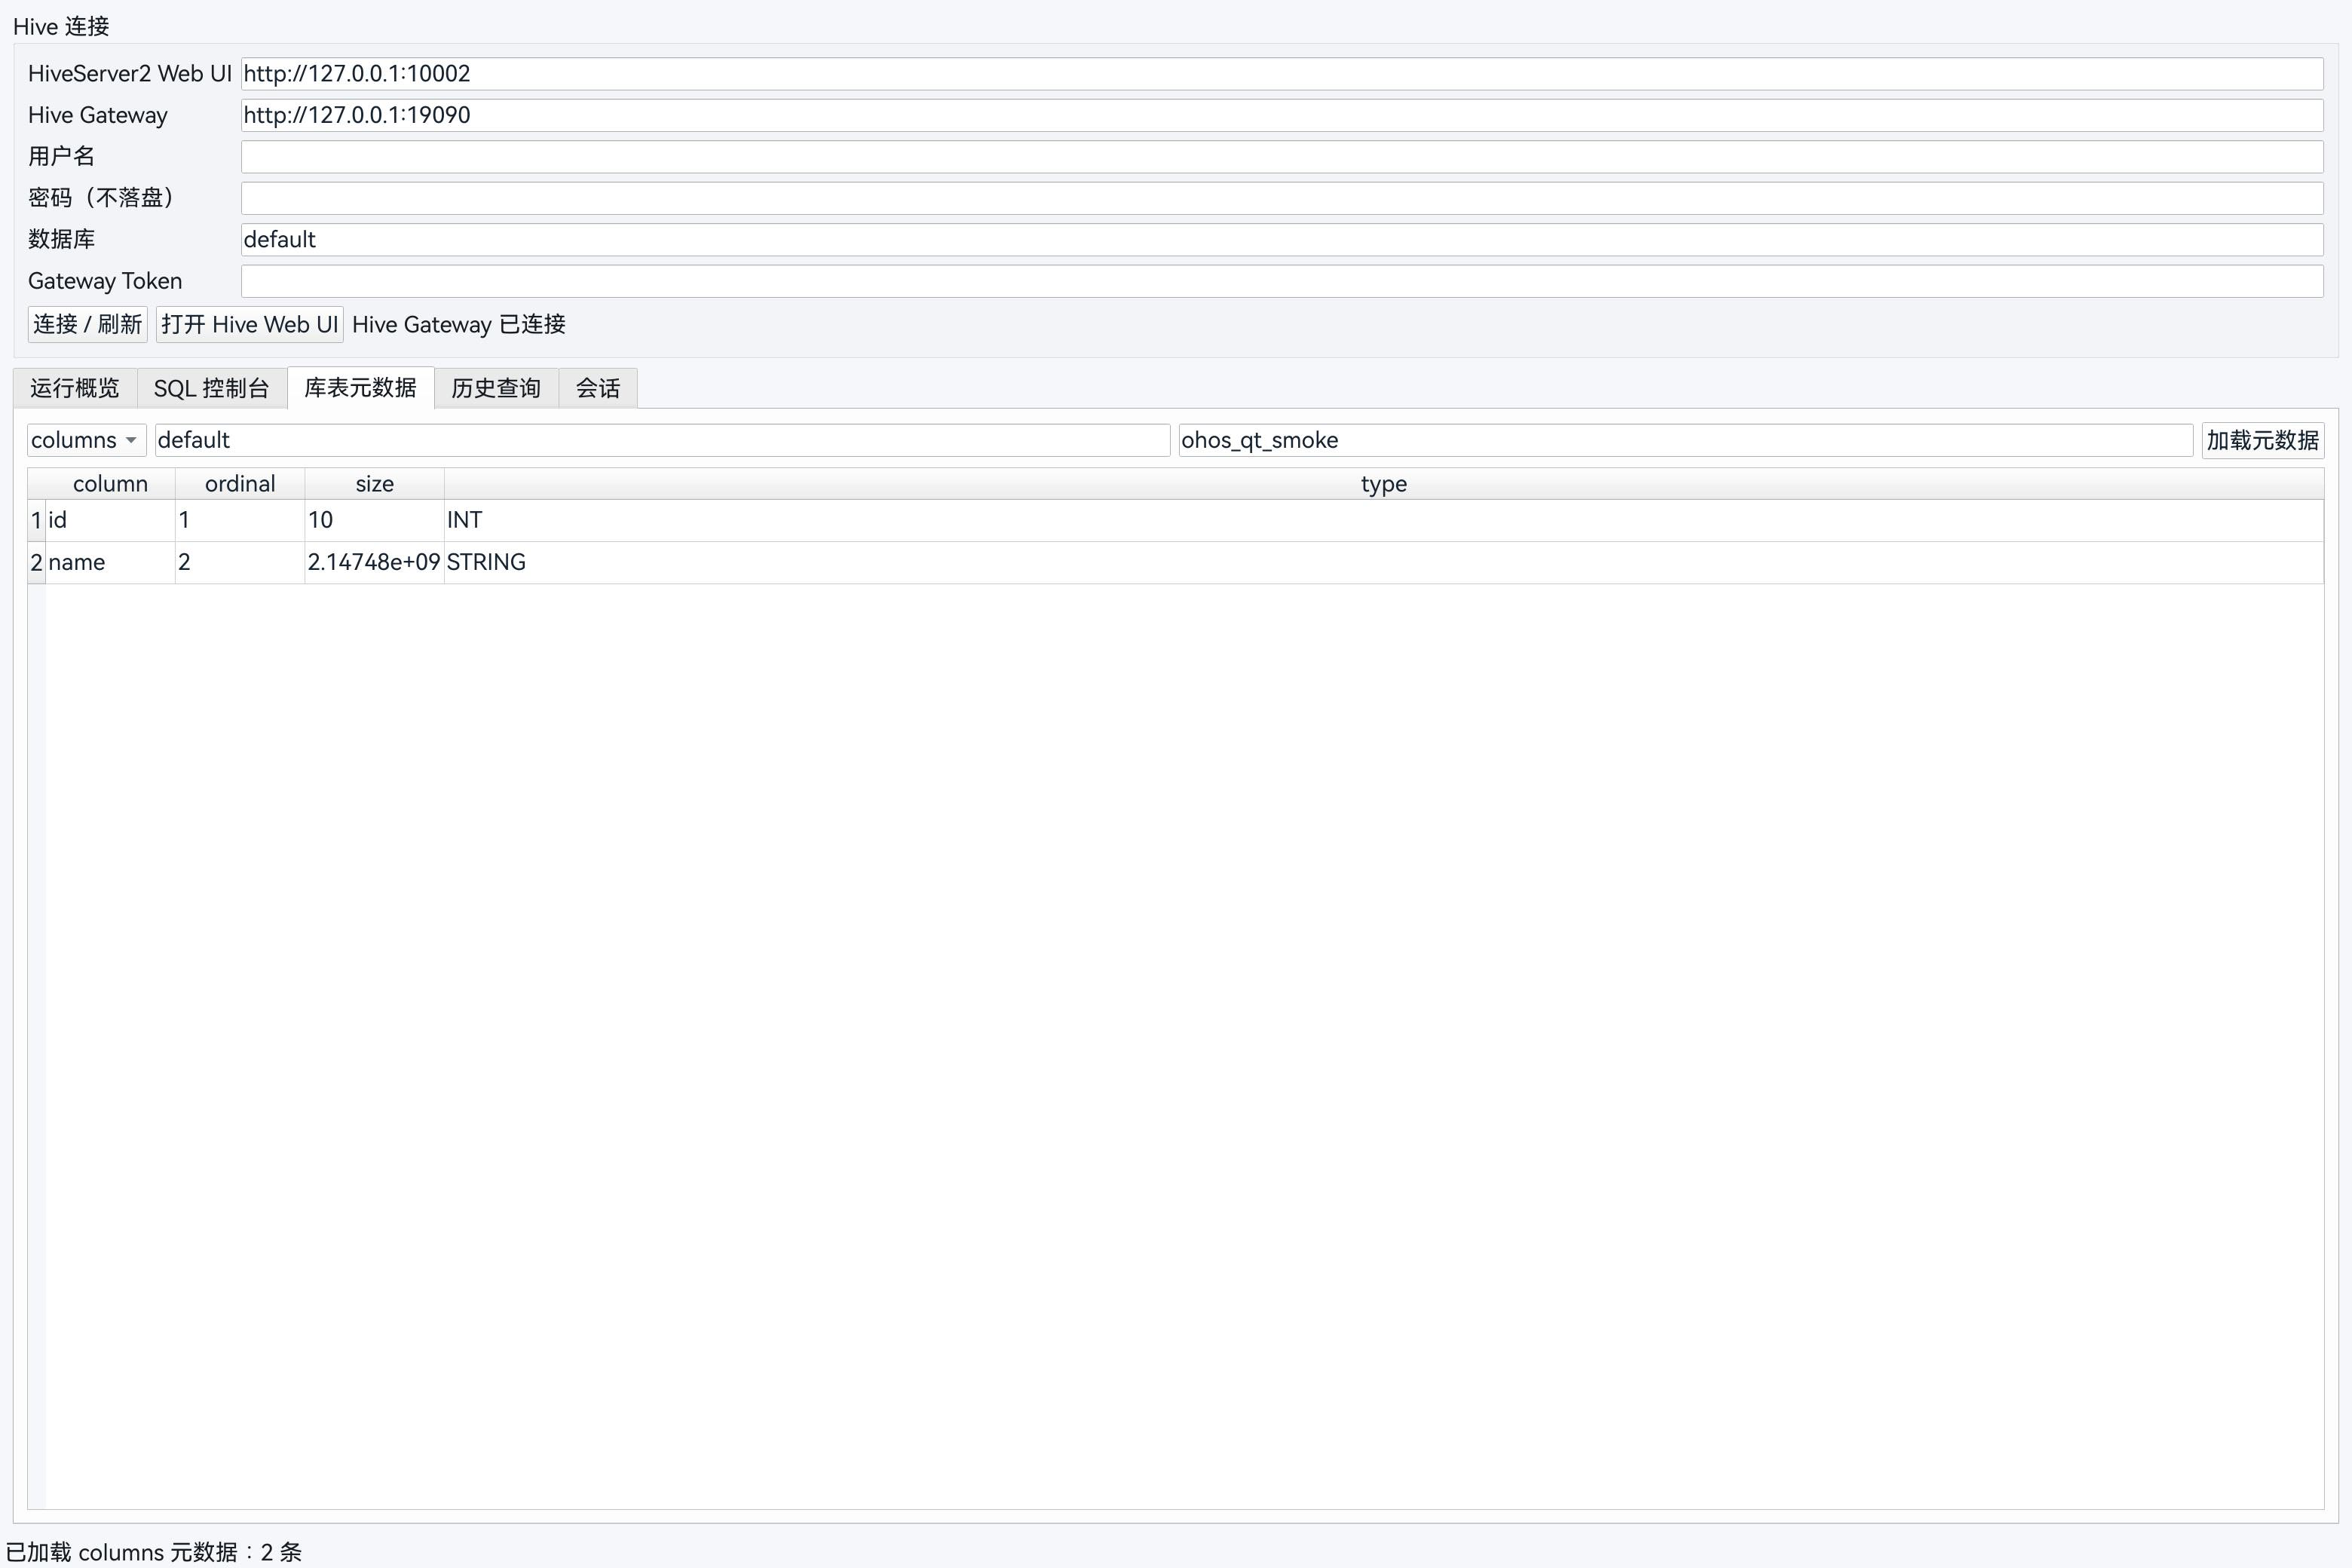
字段信息同样来自 DatabaseMetaData.getColumns(),而不是写死在客户端。对于日常数据分析,这种下钻能力可以在编写 HiveQL 前快速确认表结构;对于后续功能扩展,也可以继续承接字段搜索、SQL 辅助输入和结果列类型提示。
五、适配过程中最棘手的几个问题
难点一:必须先把"完整移植"拆成正确的系统边界
Hive 的主体是面向集群的 Java 服务,不适合按桌面应用的方式整体封装。若只追求在设备上启动进程,会很快陷入 JVM、Hadoop 依赖、后台服务、资源调度和存储拓扑等问题,而且得到的也不是生产环境里的 Hive。适配最终把高频交互放进 HAP,把计算、元数据和权限留在服务端;这不是削减功能,而是尊重 Hive 的原始运行模型。
难点二:Qt 窗口需要进入 Stage 与 XComponent 生命周期
传统 Qt 程序通常由 main() 创建窗口并进入事件循环,HarmonyOS 应用则由 Ability 管理启动与销毁。工程通过 ArkTS 创建 XComponent,再由 qopenharmony QPA 把 Qt 窗口挂载到系统表面。真机调试中必须同时检查 ArkTS 生命周期日志、QPA 插件加载和 libentry.so 入口,任何一层未对齐都可能表现为空白窗口,而不是常规桌面端可直接看到的启动错误。
难点三:Hive JDBC 依赖不能直接压进鸿蒙客户端
Hive JDBC standalone 驱动及其依赖更适合运行在标准 Java 服务端环境,直接带入 HAP 会增加包体和兼容成本,也会迫使客户端处理 Kerberos、LDAP、JDBC URL 与集群内部网络。hive-gateway 因此成为边界适配器:向鸿蒙端提供小型 JSON 接口,向内保持标准 JDBC。客户端与 Hive 版本的耦合被集中在服务端部署单元中。
难点四:监控接口和查询接口属于两套数据模型
HiveServer2 Web API 返回查询、会话和运行状态,JDBC 则返回结果集、更新计数与数据库元数据。两者字段组织和错误形式都不同。客户端将监控请求和 Gateway 请求分开封装,再统一转成 QJsonArray 或 QJsonObject 交给界面;表格按优先字段顺序展示常用信息,同时保留服务端返回的其他键,减少版本差异导致的页面改动。
难点五:真机访问本机服务不能依赖桌面网络直觉
设备里的 127.0.0.1 指向设备自身,并不天然等于开发机。闭环测试使用 HDC reverse 映射 HiveServer2 Web UI 与 Gateway 端口,先在主机确认 JDBC 和 Web API 可用,再从签名 HAP 发起相同请求。只有看到真实数据库、表、字段和 queryId 返回,才能确认网络映射、Qt 网络栈、JSON 解析和表格渲染全部通过。
难点六:安全责任不能被桌面入口悄悄改写
客户端不保存密码与 Token,Gateway 在绑定非回环地址时要求配置 Token,并对返回内容设置 no-store。这些措施解决的是适配层自身可以控制的问题。生产环境的 TLS、认证方式、授权模型、网络隔离和凭据托管仍需由 Hive 运维体系负责;UDF、SerDe、执行引擎和底层存储也继续处于服务端受控环境中。
六、构建、安装与服务端部署
使用 DevEco Studio 打开仓库中的 ohos/ 目录,为 org.apache.hive.ohos 配置与目标设备匹配的调试签名。工程目标和兼容 SDK 均为 HarmonyOS 6.0.2(22),Native 编译器为 BiSheng,ABI 为 arm64-v8a。Qt SDK 由 ohos/qtforharmony_sdk/ 提供,CMake 参数为 -DQT_PREFIX=qtforharmony_sdk。
命令行构建如下:
bash
cd ohos
export DEVECO_SDK_HOME=/Applications/DevEco-Studio.app/Contents/sdk
export JAVA_HOME=/Applications/DevEco-Studio.app/Contents/jbr/Contents/Home

/Applications/DevEco-Studio.app/Contents/tools/hvigor/bin/hvigorw \
  --mode module -p module=entry assembleHap --no-daemon
成功后,签名产物位于:
text
entry/build/default/outputs/default/entry-default-signed.hap连接 HarmonyOS PC 真机后安装并启动:
bash
HDC=/Applications/DevEco-Studio.app/Contents/sdk/default/openharmony/toolchains/hdc

"$HDC" list targets
"$HDC" install -r entry/build/default/outputs/default/entry-default-signed.hap
"$HDC" shell aa start -a EntryAbility -b org.apache.hive.ohos
Gateway 应部署在可以访问 HiveServer2 的服务器或受控内网节点。构建时使用项目提供的 Maven 工程,运行时在 classpath 中加入 Hive JDBC standalone 驱动。下面只展示最小配置形式,生产环境的数据库密码应交给凭据服务或秘密管理系统,不应写入仓库、脚本和普通配置文件。
bash
cd ohos
mvn -f hive-gateway/pom.xml package

export HIVE_JDBC_URL='jdbc:hive2://hiveserver2.example.com:10000/default'
export HIVE_JDBC_USER='hive-user'
export HIVE_GATEWAY_TOKEN='replace-with-a-short-lived-token'
export HIVE_GATEWAY_BIND='127.0.0.1'

java -cp "hive-gateway/target/hive-ohos-gateway-1.0.0.jar:/srv/hive/hive-jdbc-standalone.jar" \
  org.apache.hive.ohos.gateway.HiveGatewayApplication
生产部署建议由 HTTPS 反向代理暴露 Gateway,并把访问范围限制在可信网络;HiveServer2 的 Kerberos、LDAP、Ranger 或其他授权配置继续按现有集群规范执行。开发调试使用的签名材料和本机绝对路径也应保留在个人环境,不作为可移植配置提交。
七、当前能力与明确边界
当前鸿蒙版本已经覆盖以下核心能力:
- 签名 HAP 构建、安装以及
2in1/tablet窗口启动; - Qt Widgets 主界面、文本输入、底部标签切换和设置恢复;
- HiveServer2 Web UI 与 Gateway 地址配置;
- Gateway 健康检查、请求超时和可见错误反馈;
- HiveQL 执行、列名与结果行展示、queryId 和更新计数展示;
- Schema、Table、Column JDBC 元数据浏览;
- HiveServer2 活跃查询、历史查询和会话接口接入;
- 查询最大返回行数与 JDBC 查询超时的服务端配置;
- 密码和 Gateway Token 不落盘。
当前版本没有把以下服务端或高级能力包装成已经完成:
- 在 HarmonyOS PC 本地启动 HiveServer2、Metastore、HDFS 或执行引擎;
- Ranger/SQL Standard Authorization 的图形化策略管理;
- Kerberos、LDAP 和证书生命周期的客户端管理界面;
- 大结果集完整分页、流式拉取和导出;
EXPLAIN执行计划、Tez DAG 与任务日志可视化;- Hive 配置全量编辑、服务启停和集群运维控制台;
- UDF、SerDe 或
TRANSFORM脚本的客户端沙箱。
因此,当前版本的准确定位是"Apache Hive HarmonyOS PC 图形客户端"。它已经可以承担连接、查询、结果查看和元数据浏览等日常入口,但不会替代 Hive 集群本体,也不会绕过集群侧的认证、授权与资源治理。
八、总结
Apache Hive 的鸿蒙适配说明,面向服务端集群的软件并不适合用"所有进程都搬到设备上"衡量完成度。真正有价值的迁移,是识别用户需要在桌面完成的操作,再为这些操作建立稳定、可审计且不破坏原系统边界的客户端通道。
本项目用 Stage 模型和 XComponent 接住 HarmonyOS PC 生命周期,以 Qt for OpenHarmony 重建桌面交互,通过 HiveServer2 Web API补充监控,再用独立 Gateway 把轻量 JSON 请求转换为标准 Hive JDBC。真机上的五个连续画面验证了连接、HiveQL、Schema、Table 和 Column 这条主线,说明适配已经越过"窗口能够显示"的阶段。
这套方式也适用于其他以 Java 服务或数据集群为主体的开源项目:保留服务端成熟实现,把平台差异收敛到清晰的边界适配器中;先打通最常用的数据流,再用真机上的真实输入和可反查结果完成验收。这样形成的鸿蒙版本更容易部署、升级和长期维护。