目录
前言
学习赵老师讲授的强化学习的数学原理视频,本篇文章记录第八讲 Part 1:值函数近似(例子-曲线拟合),记录个人学习笔记,和大家一起分享交流😄
1. Outline
这是我们的第八次课,这次课我们将会介绍 value function approximation,下面是我们的地图:
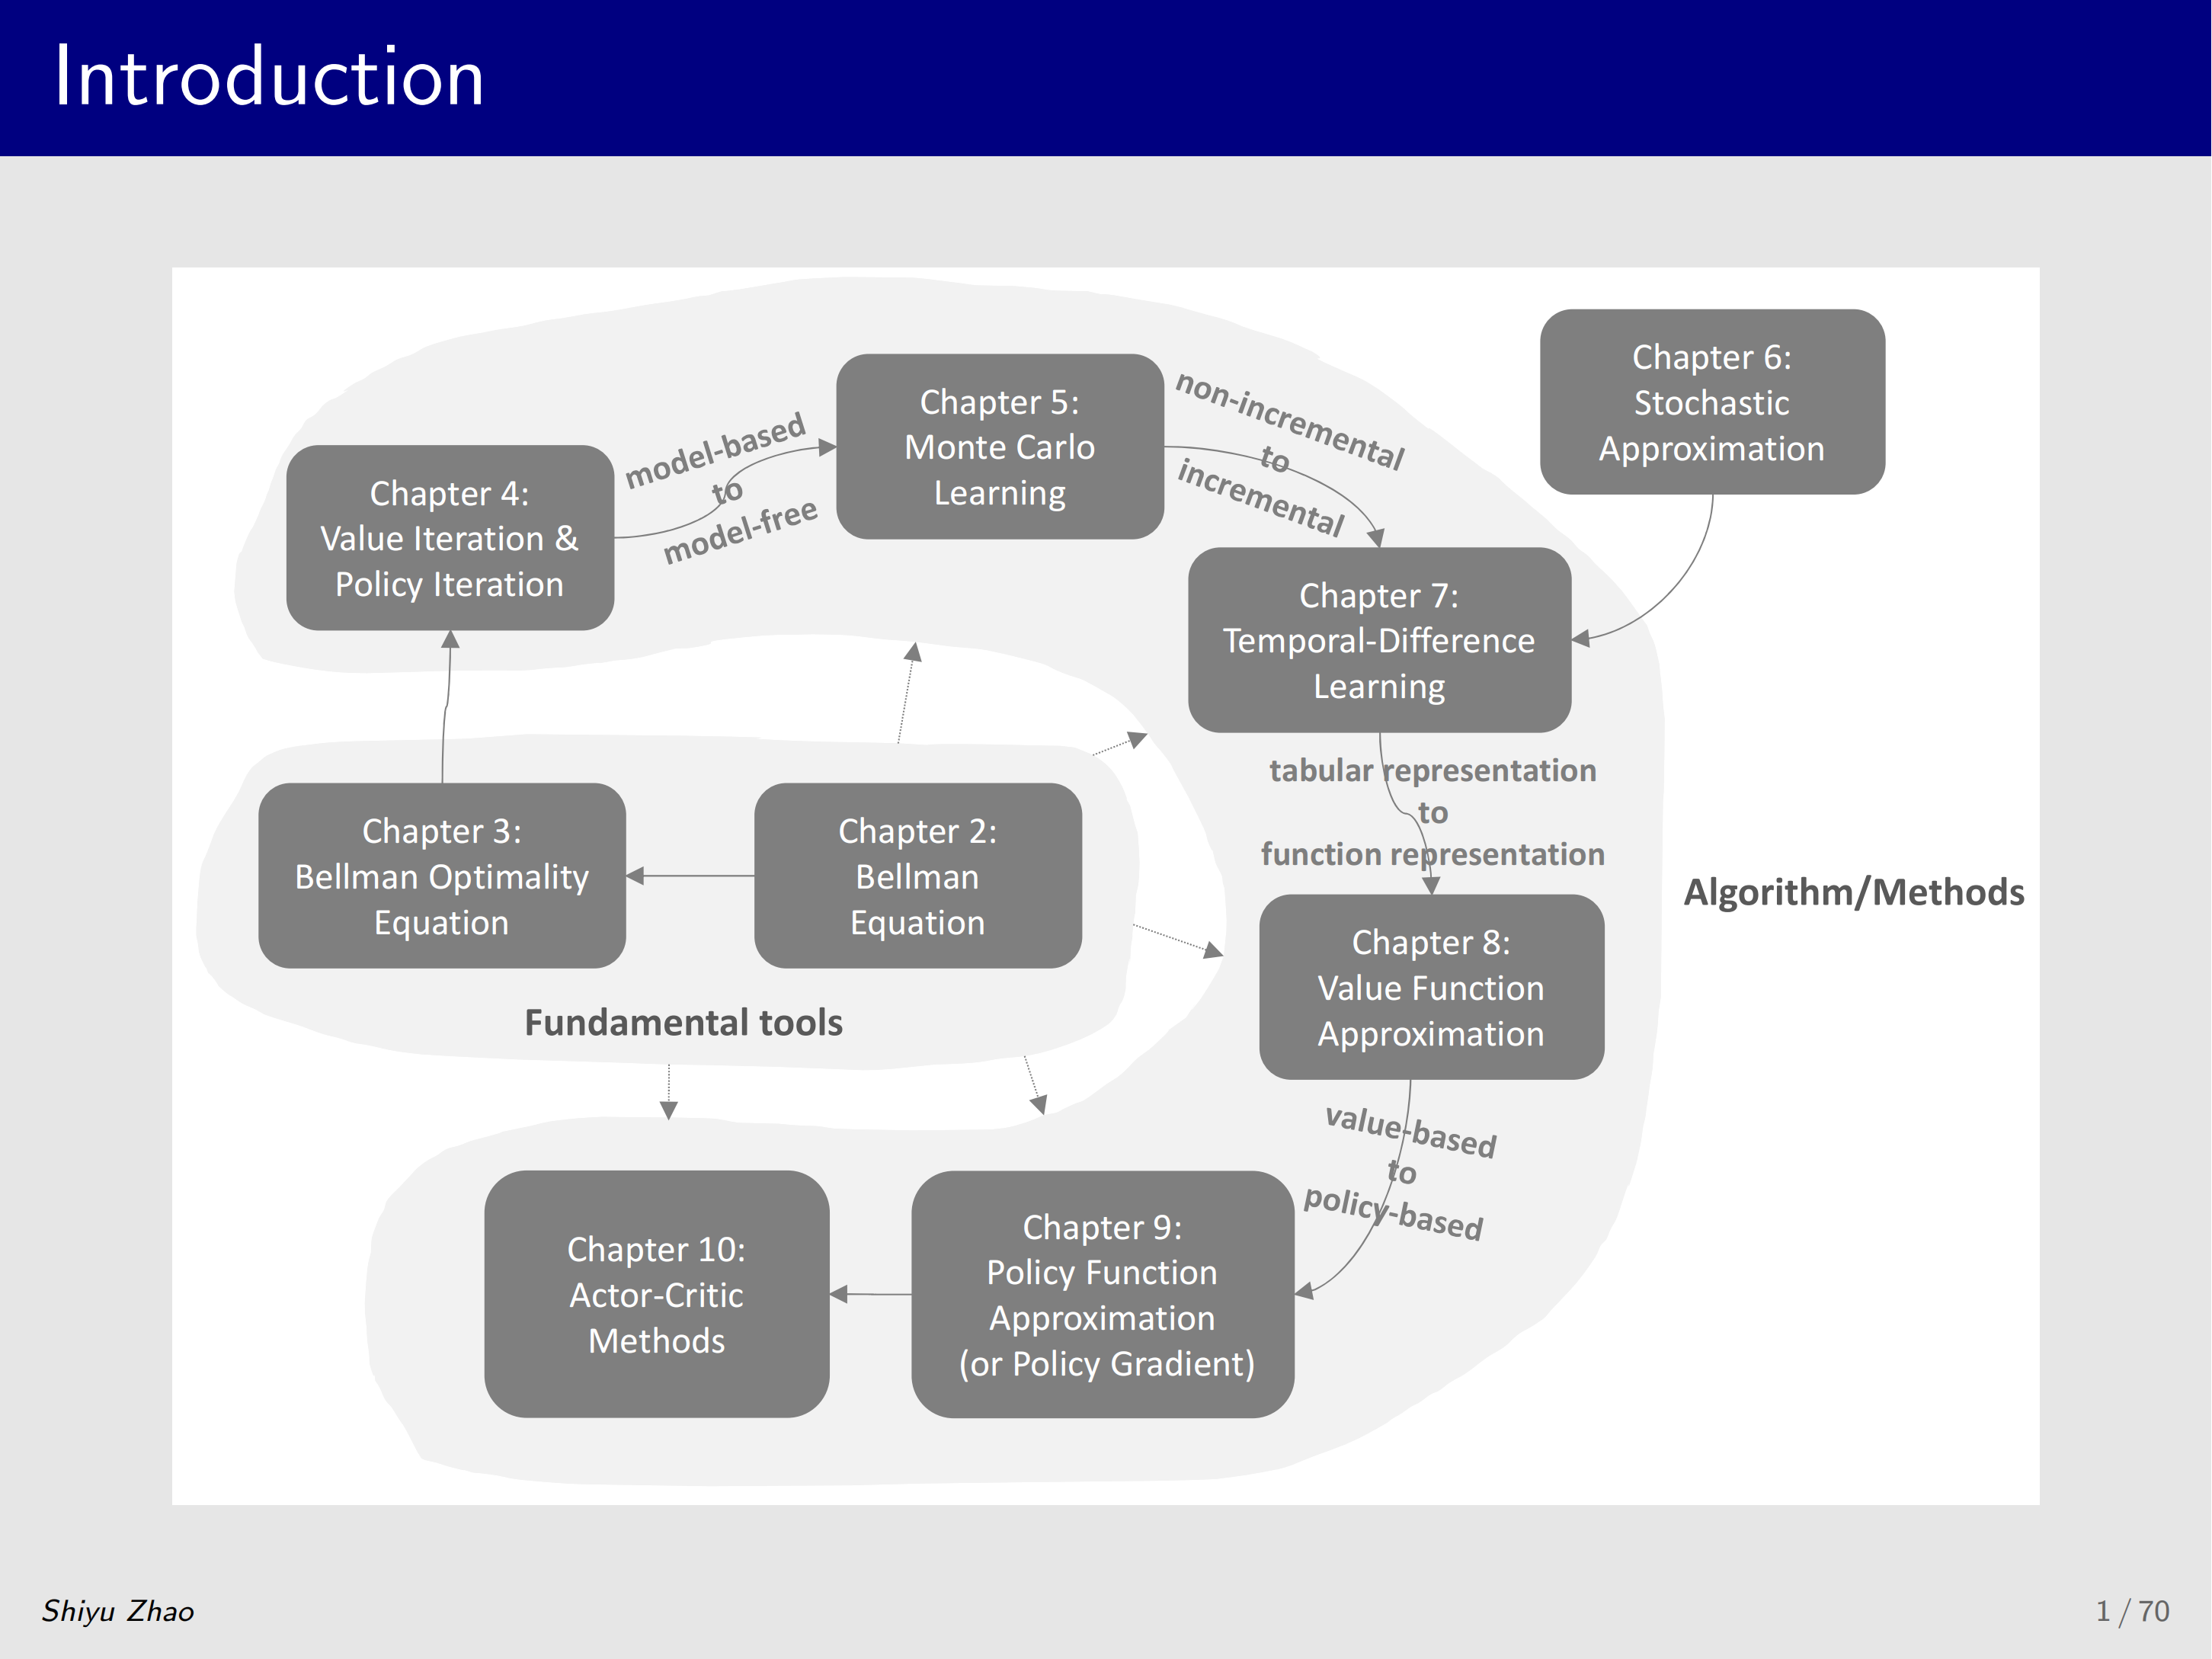
我们现在已经进入第八章,这次课和上次课有什么关系呢?上次课我们介绍了 Temporal-Difference Learning ,实际上这次课仍然会介绍 TD Learning,但上次用的是 tabular representation(基于表格) ,这次课我们将会介绍 基于函数的方式 。待会大家就会明白这是什么意思, 从表格到函数有一个较大的跳跃,算法本身不太难,比较难的是思路和想法,所以我希望大家能够注意一下。
另外非常关键的一点是:这次我们将会 引入神经网络 ,之前神经网络从未在课程中出现过,这是我们 第一次把神经网络引入到强化学习,神经网络究竟是怎么进来的、扮演什么角色,这次大家就会明白。
还有一个就是非常经典的 Deep Q-Learning ,这次大家也会学习到。简单预告下,我们下次将介绍 Policy Gradient 方法,从之前的方法跳到 Policy Gradient 也是一个比较大的跳跃,因为之前全都是基于值的,下次介绍基于策略的,大家也可以关注一下。
下面是我们这次课的大纲,我简要过一下。
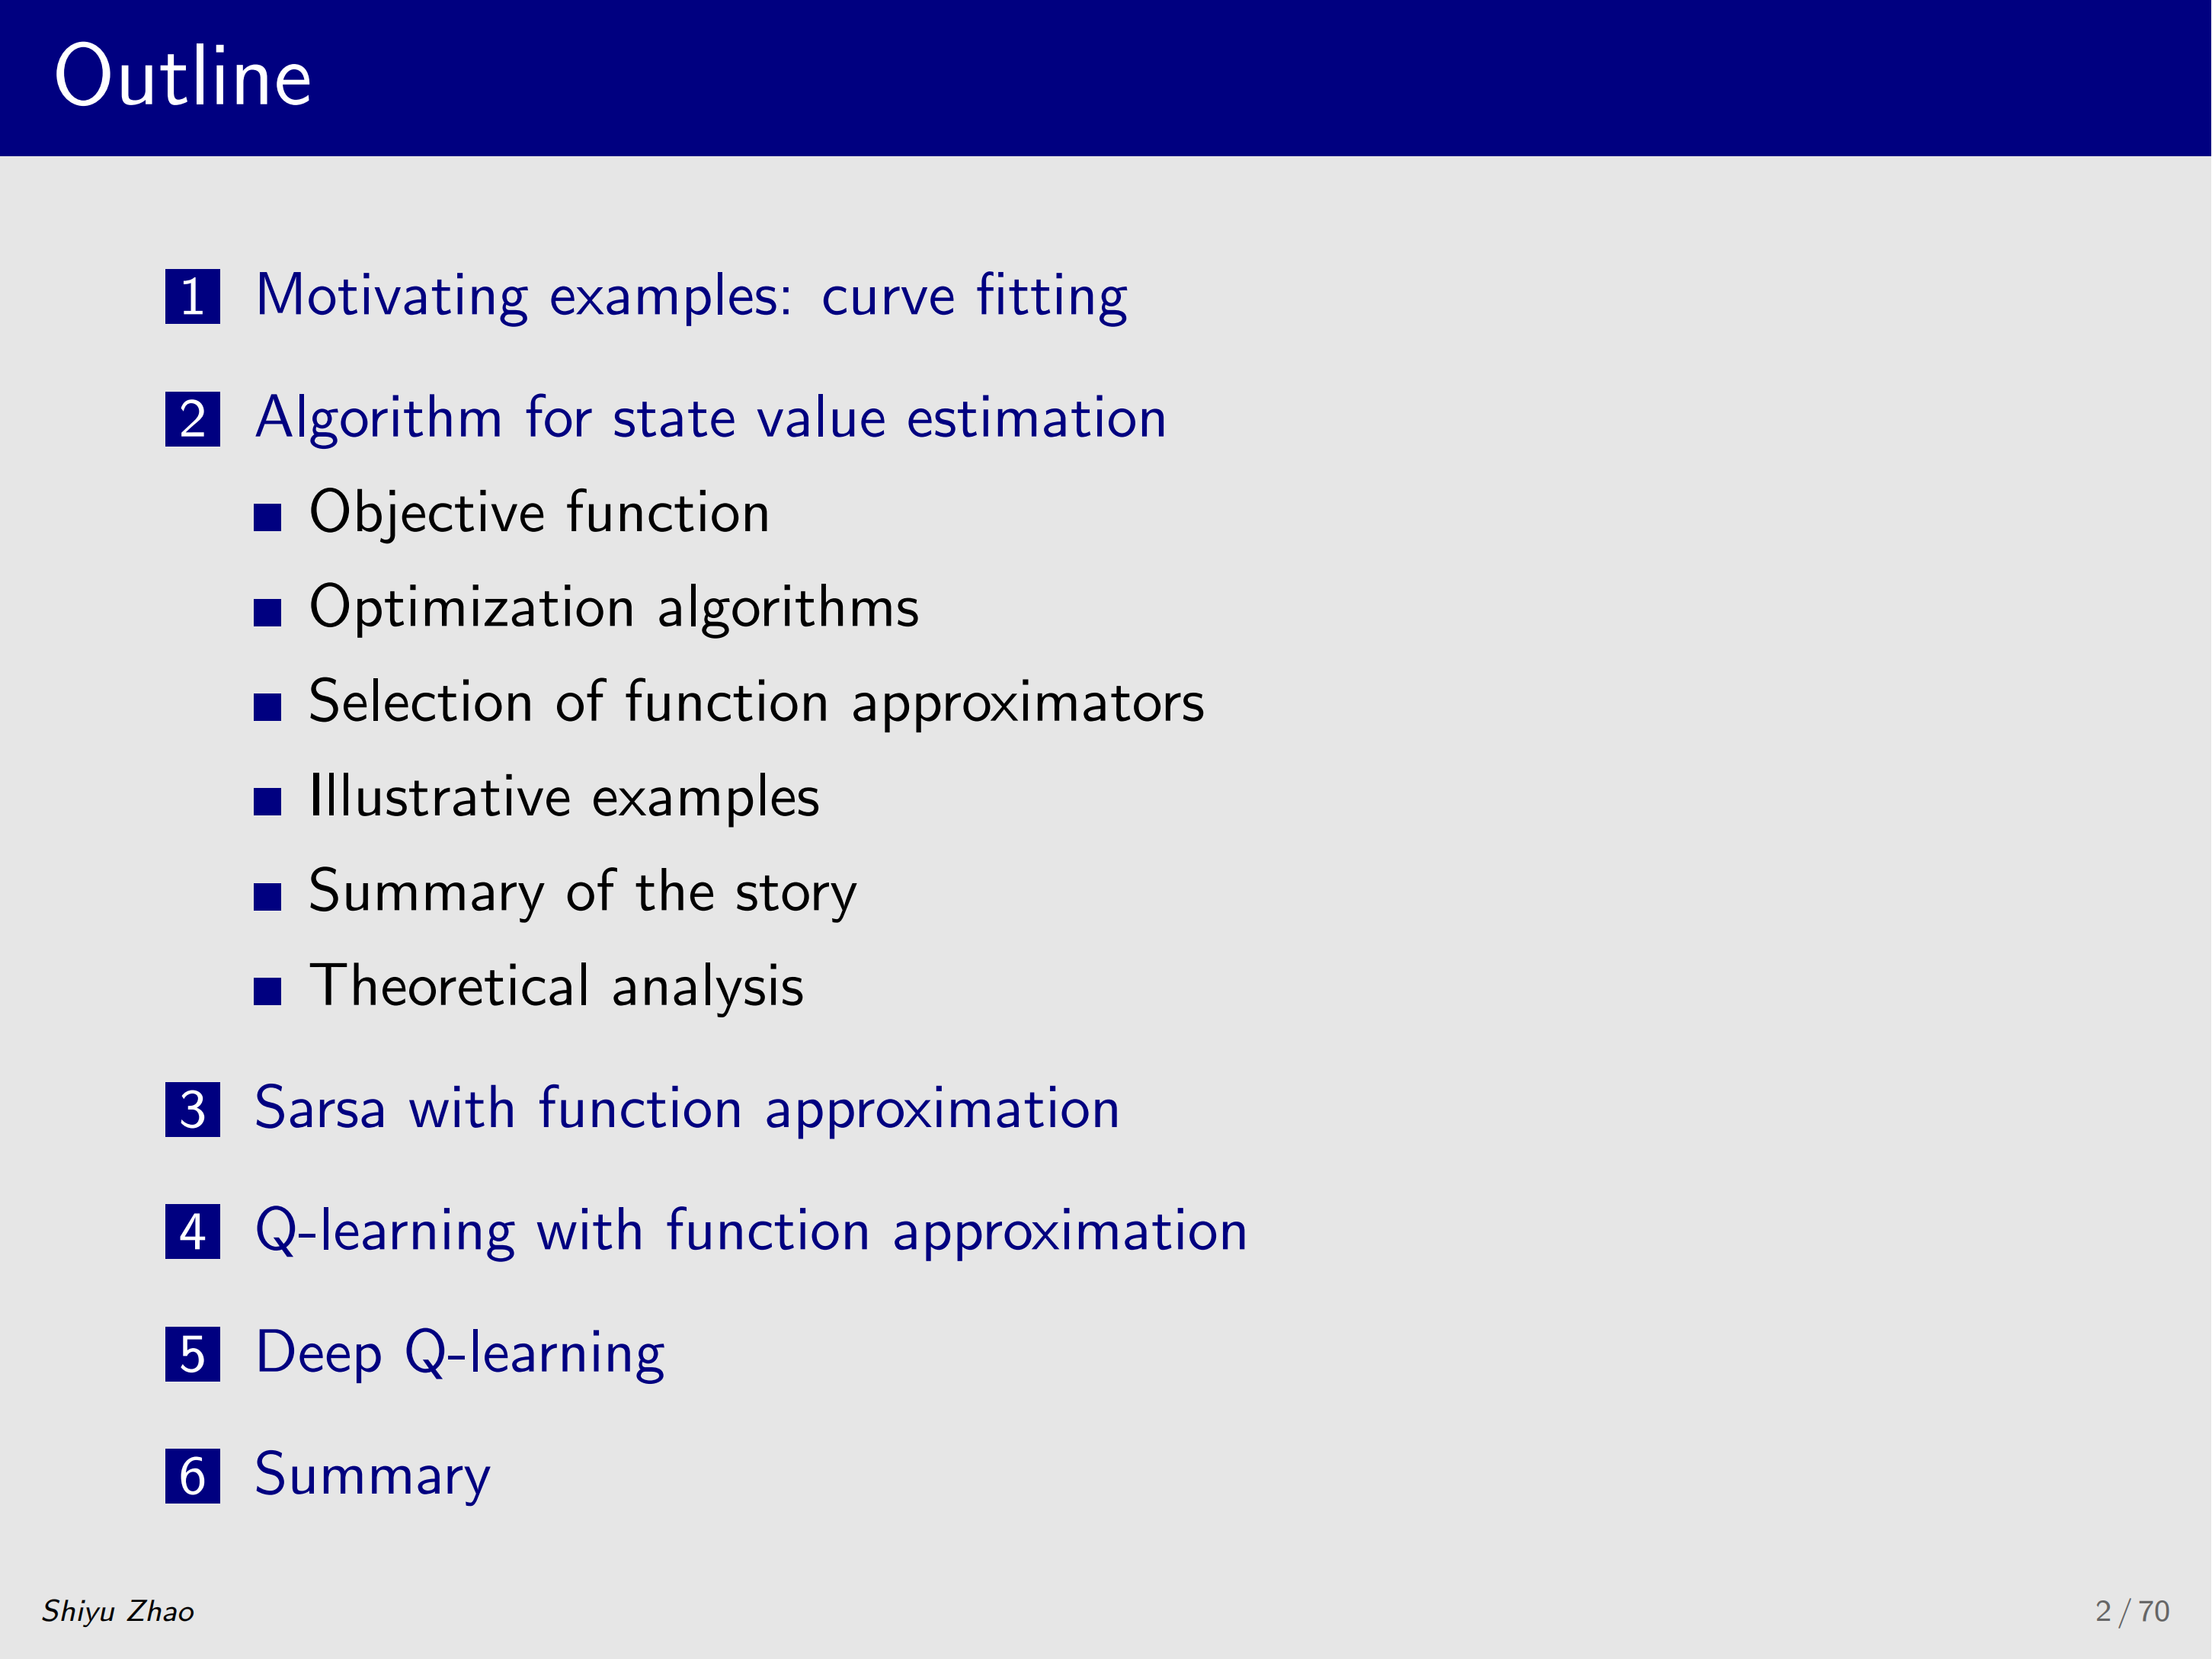
首先我们会介绍 Motivating example,然后通过一个 曲线拟合 的例子向大家展示:如何从表格形式引入函数近似。第二节虽然只是一小节,但非常关键。它讲的是:给定一个策略,怎么做 policy evaluation ---即估计它的 state value。
具体包括:怎么建立 objective function(目标函数) 、怎么优化、用什么函数近似等一系列内容。这一节不会介绍怎么估计 action value、怎么得到最优策略等等,但它的分量很重--- 它揭示了 value function approximation 最基本的思想;明白这个之后,后面的算法就很简单。
接下来会介绍三个算法,第一个是把之前的 Sarsa 与 value function approximation 结合,第二个是把 Q-Learning 与 value function approximation 结合,第三个是非常著名的 Deep Q-Learning,最后我会给一个小结。
2. Motivating examples: curve fitting
下面我们来看第一部分。到目前为止我们没有明说,但实际上,无论是在贝尔曼公式还是之前的所有算法中,state value 和 action value 都假设用表格形式表示,这是什么意思呢?
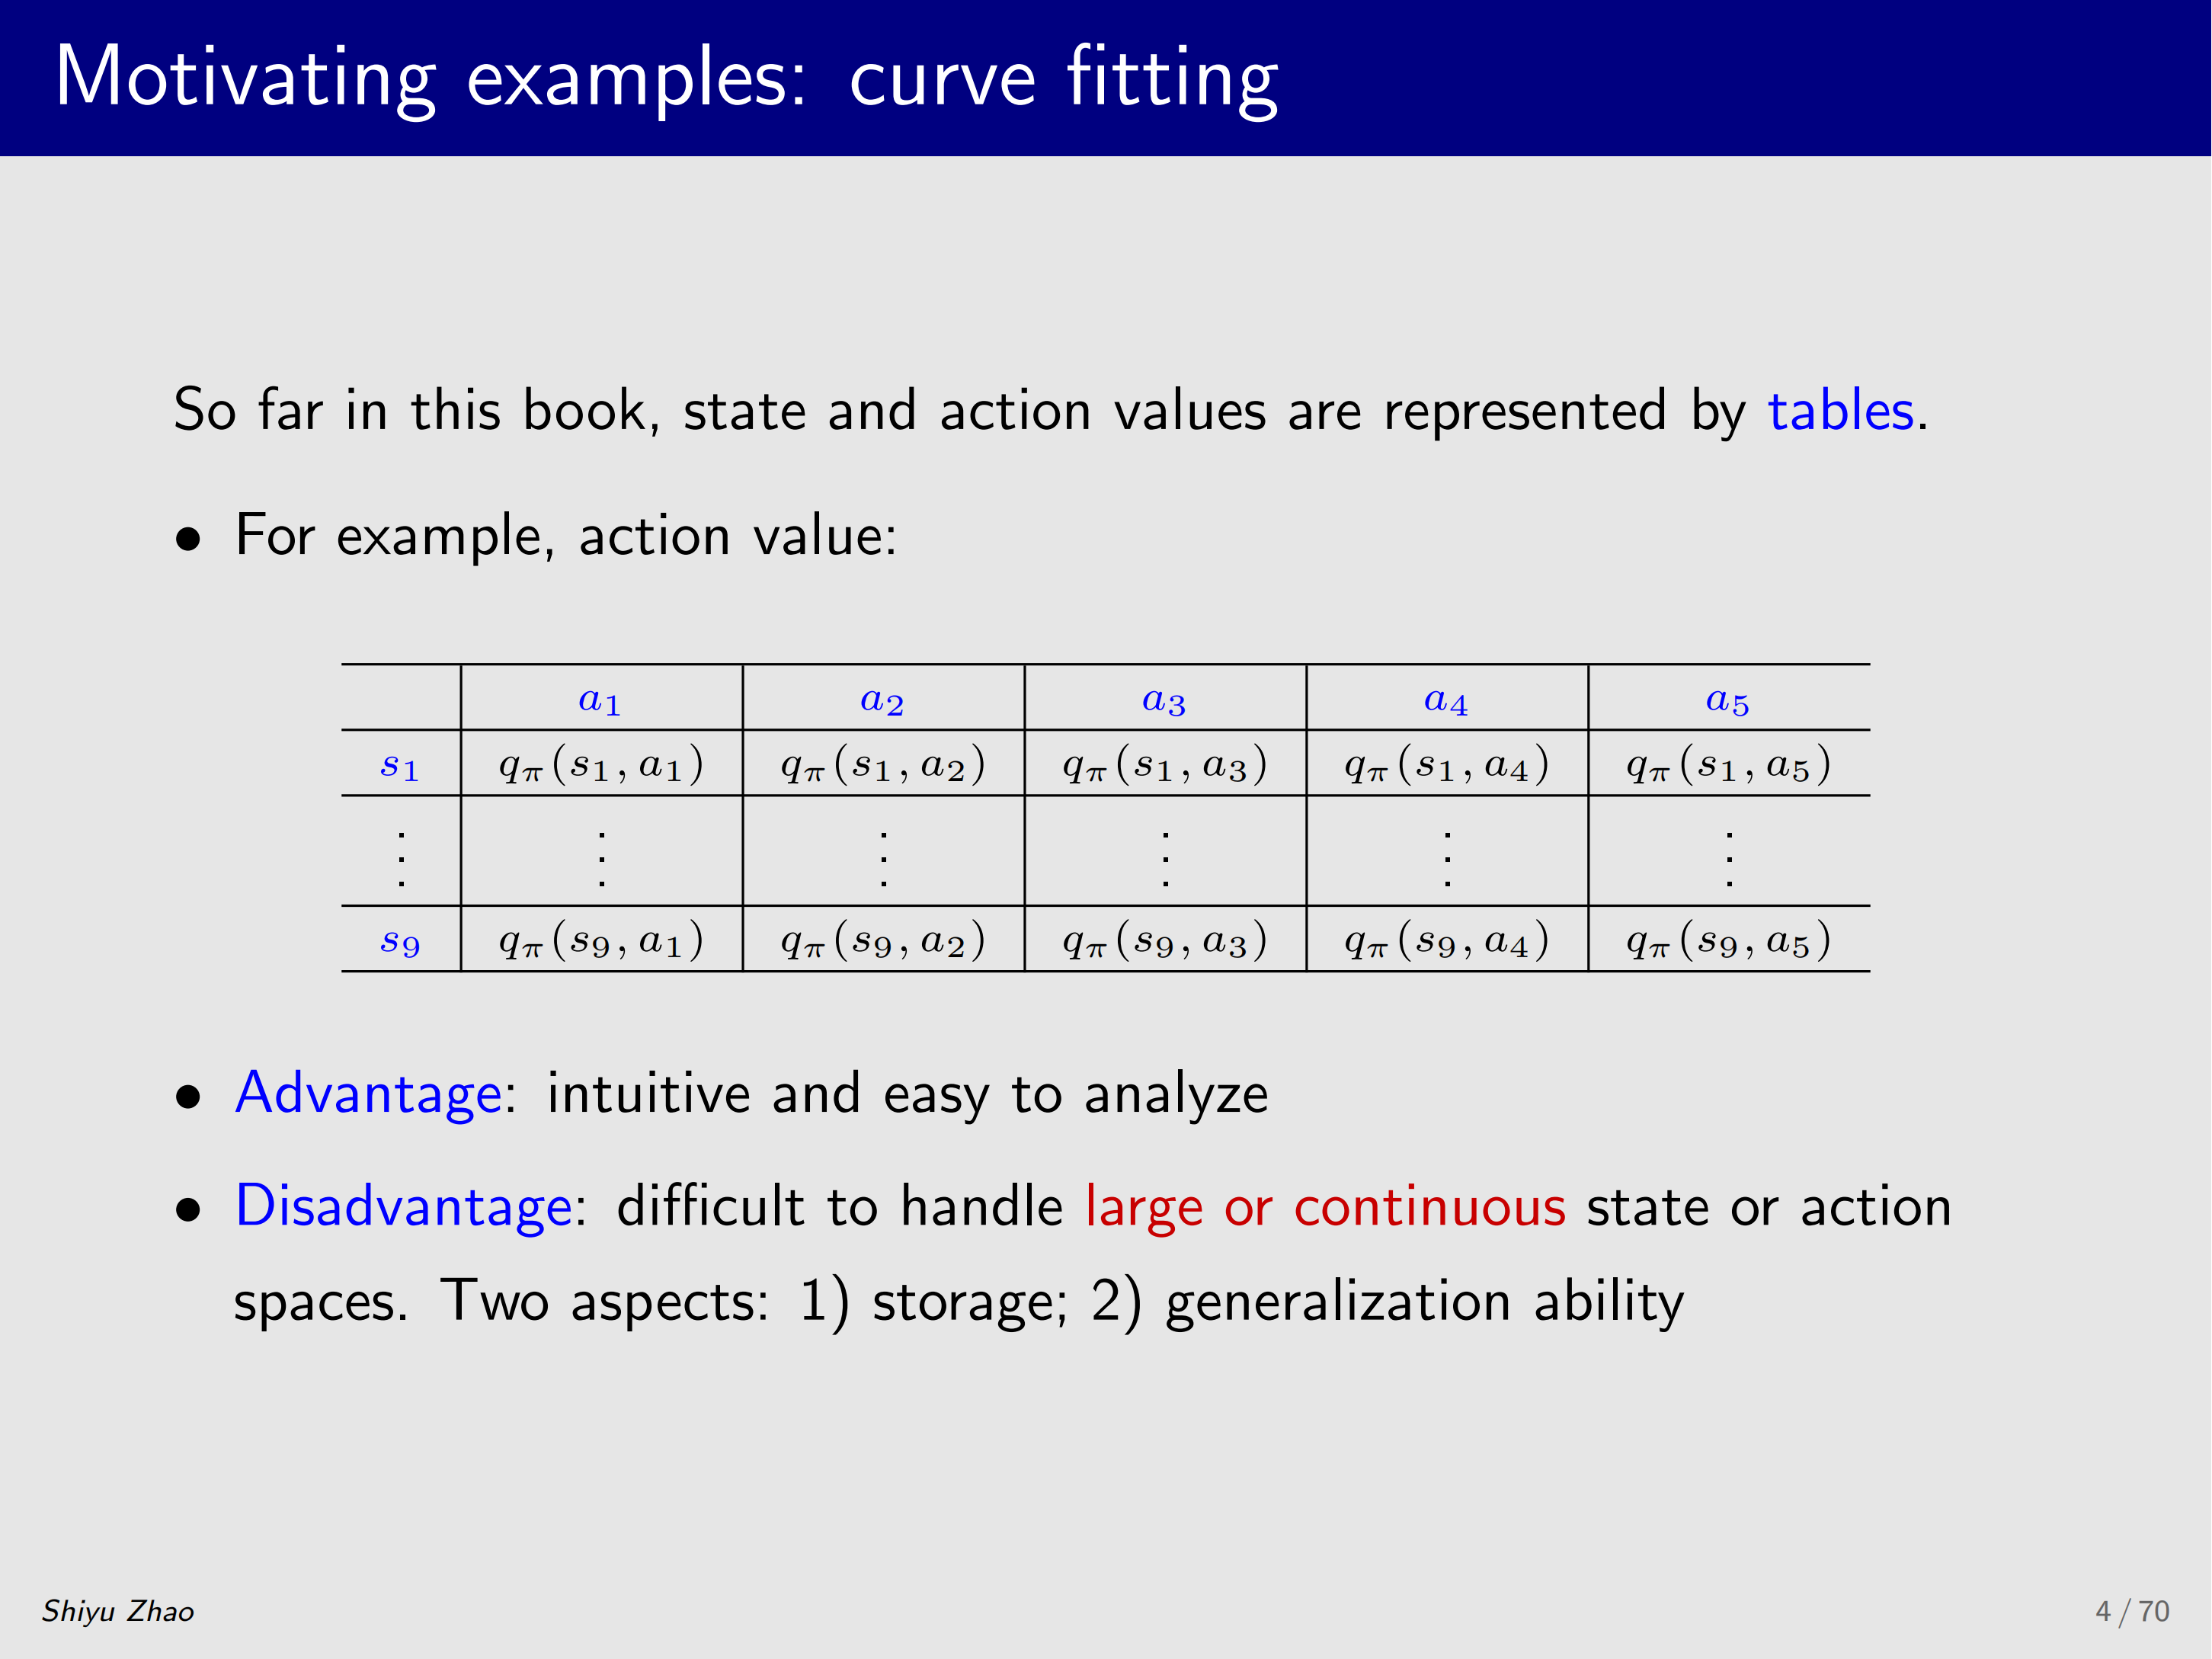
例如,action value:
| a 1 \color{blue}a_1 a1 | a 2 \color{blue}a_2 a2 | a 3 \color{blue}a_3 a3 | a 4 \color{blue}a_4 a4 | a 5 \color{blue}a_5 a5 | |
|---|---|---|---|---|---|
| s 1 \color{blue}s_1 s1 | q π ( s 1 , a 1 ) q_\pi(s_1, a_1) qπ(s1,a1) | q π ( s 1 , a 2 ) q_\pi(s_1, a_2) qπ(s1,a2) | q π ( s 1 , a 3 ) q_\pi(s_1, a_3) qπ(s1,a3) | q π ( s 1 , a 4 ) q_\pi(s_1, a_4) qπ(s1,a4) | q π ( s 1 , a 5 ) q_\pi(s_1, a_5) qπ(s1,a5) |
| ⋮ \vdots ⋮ | ⋮ \vdots ⋮ | ⋮ \vdots ⋮ | ⋮ \vdots ⋮ | ⋮ \vdots ⋮ | ⋮ \vdots ⋮ |
| s 9 \color{blue}s_9 s9 | q π ( s 9 , a 1 ) q_\pi(s_9, a_1) qπ(s9,a1) | q π ( s 9 , a 2 ) q_\pi(s_9, a_2) qπ(s9,a2) | q π ( s 9 , a 3 ) q_\pi(s_9, a_3) qπ(s9,a3) | q π ( s 9 , a 4 ) q_\pi(s_9, a_4) qπ(s9,a4) | q π ( s 9 , a 5 ) q_\pi(s_9, a_5) qπ(s9,a5) |
上面这个表格实际上对应一个 q table 也就是 q π ( s , a ) q_{\pi}(s,a) qπ(s,a) , q π ( s , a ) q_{\pi}(s,a) qπ(s,a) 有两个索引 s s s 和 a a a ,分别对应表格的行和列,然后把 q π q_{\pi} qπ 的值填入这个表格,类似地, v π v_{\pi} vπ 对应一个一维表格,在编程时,实际上就是把这些表格表示为向量、矩阵或数组。
使用表格的好处是什么呢?它 非常直观,分析起来也比较简单 ,但坏处是: 无法处理非常大的 state/action space,或连续的 state space。
当然有的同学可能会说,一个连续空间实际上可以通过网格的方式离散化,但 离散化总有问题:离散得很密时,网格太多,处理起来很吃力,当离散得很稀疏时,又不能很好地近似这样的连续空间。总之,state/action space 较大时,存储它们的值会面临问题。
同时还有一个问题是什么呢?就是 泛化能力,泛化能力是什么呢?当 state-action pair 很多时,必须全部访问到才能估计它们的值,但因为太多了,不可能全部访问到,这时怎么办?很多值就估计不出来了。
但 如果引入函数近似,这两个问题就能得到解决,下面我们通过一个例子来介绍 value function approximation 的基本思想。
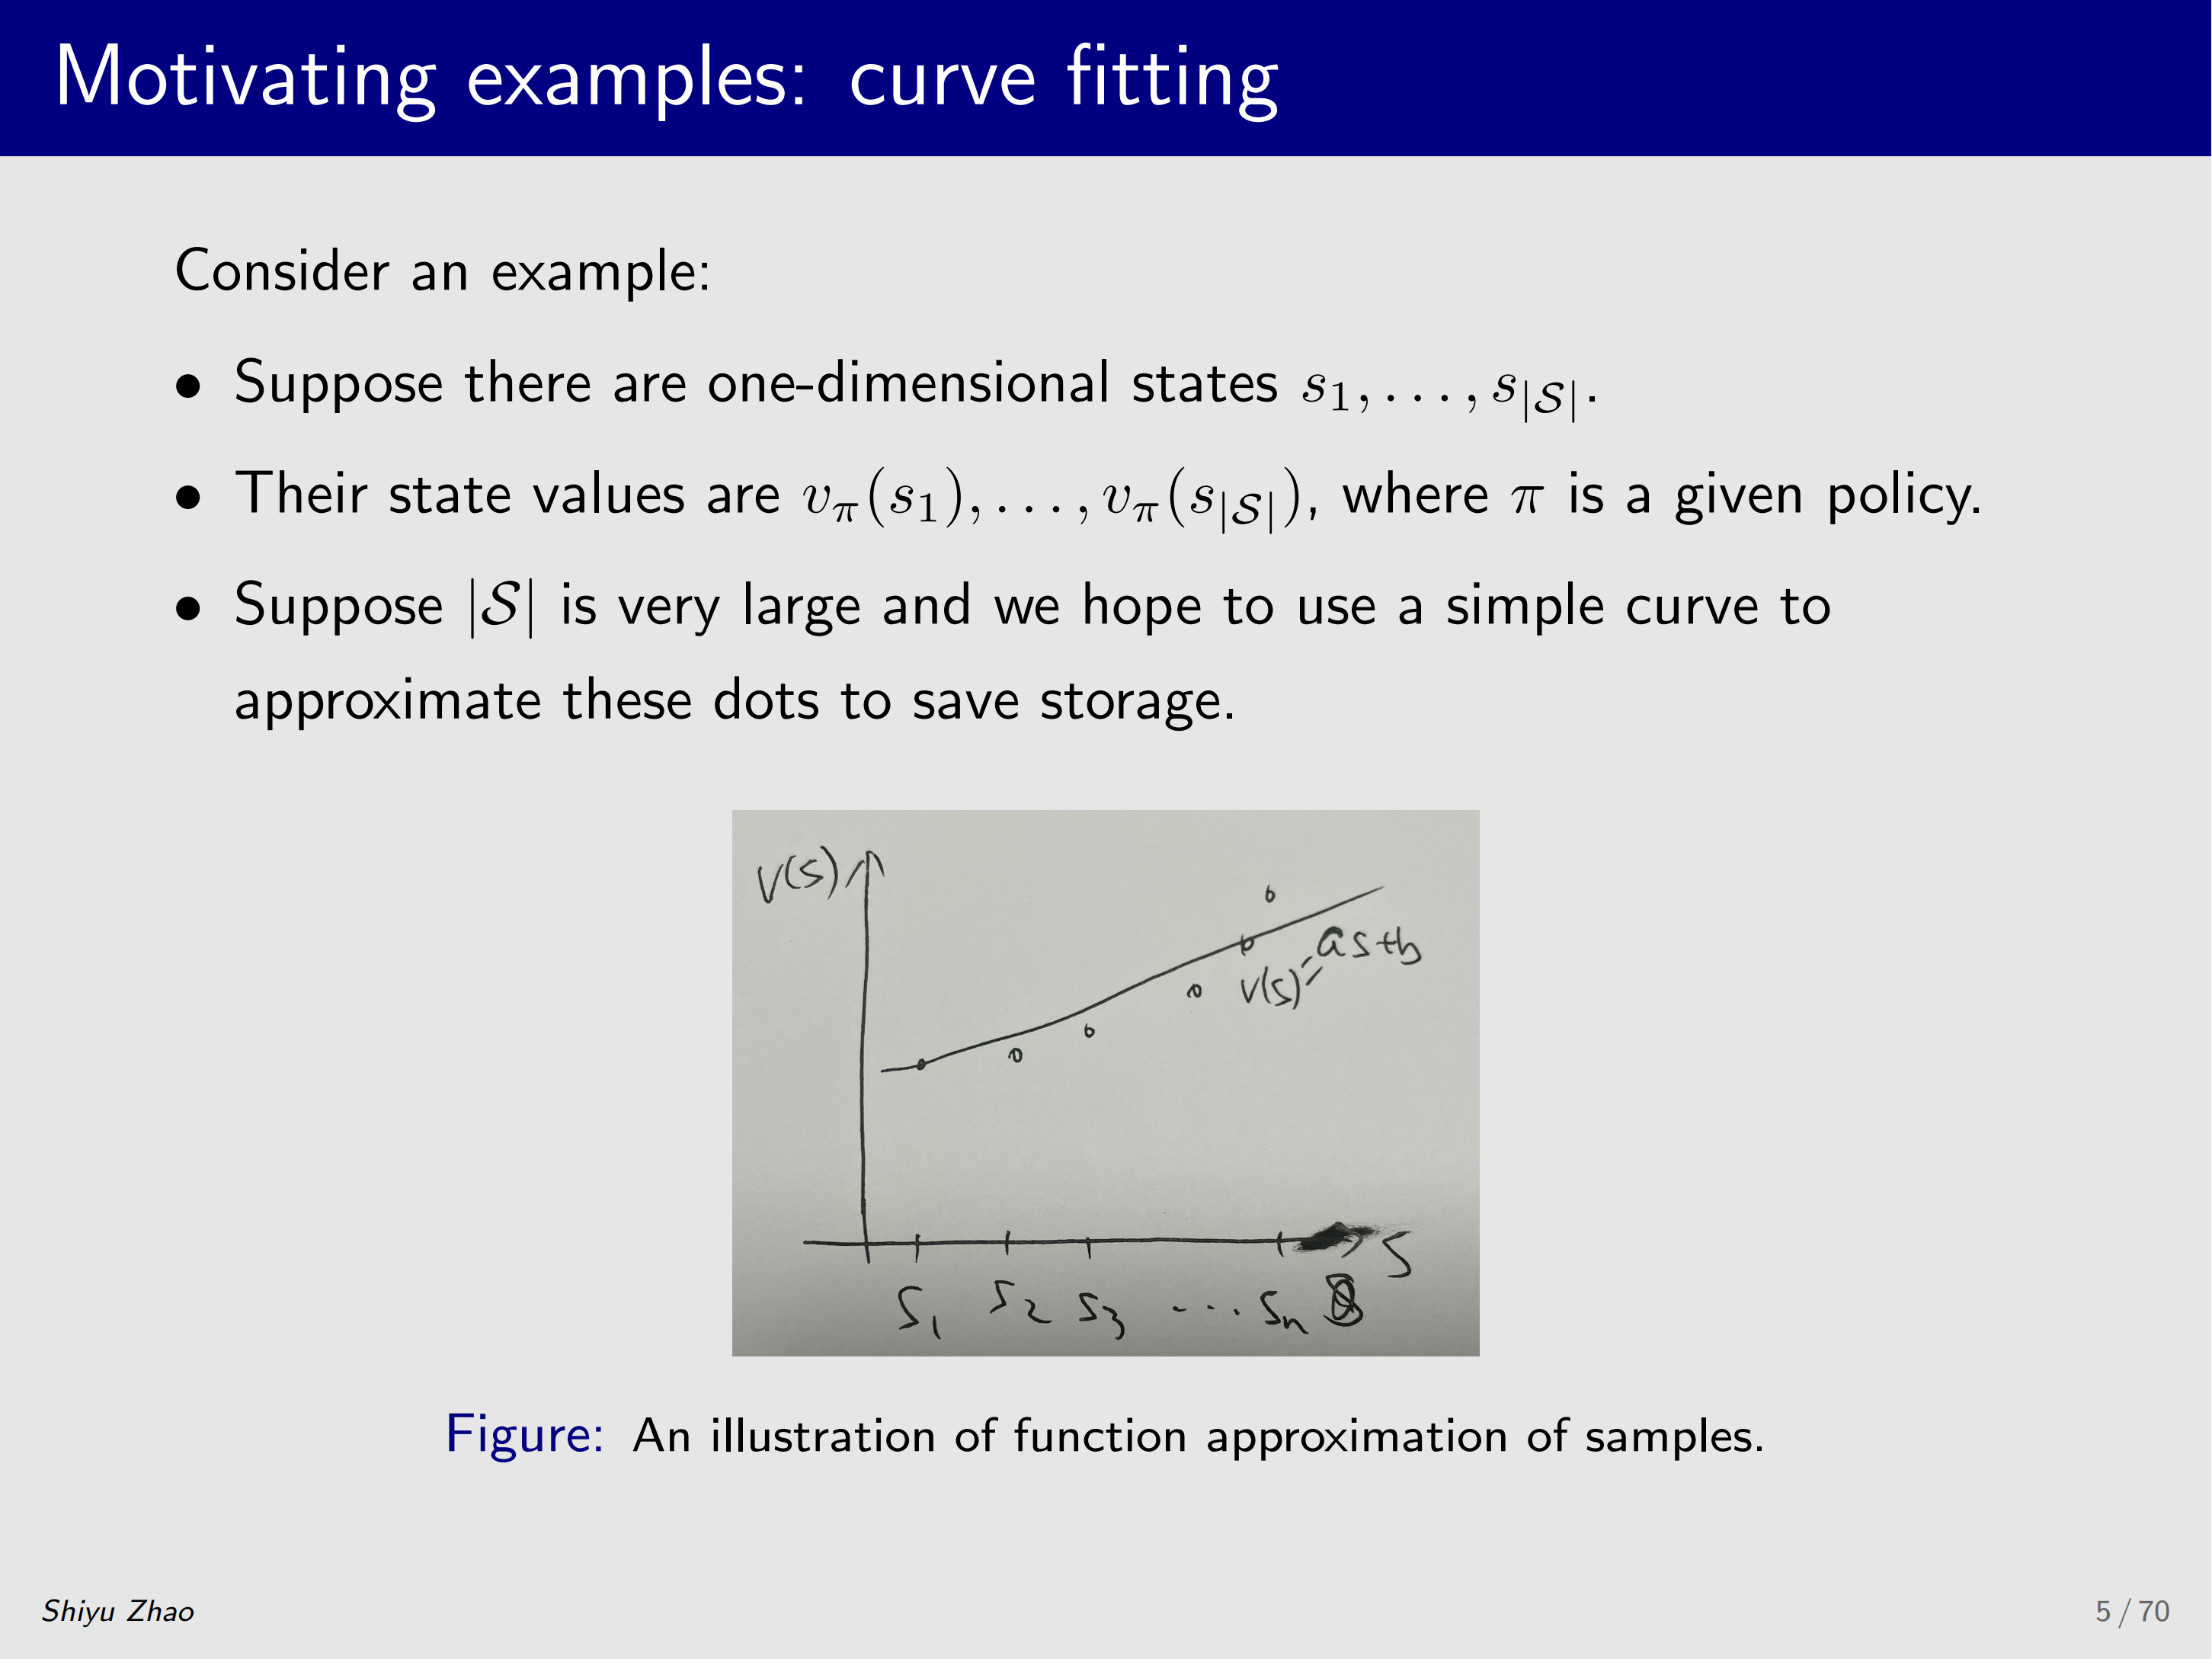
这个例子有 n n n 个状态 s 1 , ... , s ∣ S ∣ s_1,\dots,s_{|\mathcal{S}|} s1,...,s∣S∣( S \mathcal{S} S 是状态空间, ∣ S ∣ = n |\mathcal{S}|=n ∣S∣=n)。考虑简单情况:每个 s s s 对应一条直线(横轴)上的某个位置,且每个 s s s 有一个 state value。上图的纵轴就是 state value( v π ( s ) v_\pi(s) vπ(s)),这些 state value 分别对应那些离散圆点。
现在的问题是什么呢?状态的个数非常多,全部存储需要非常大的内存,有没有可能 用一条曲线把这些离散点串起来,然后用这条曲线来近似表示这些点 呢?为什么要用曲线呢?因为 曲线对应的参数个数很少,只要存储较少的参数就能表示所有状态的 state value。
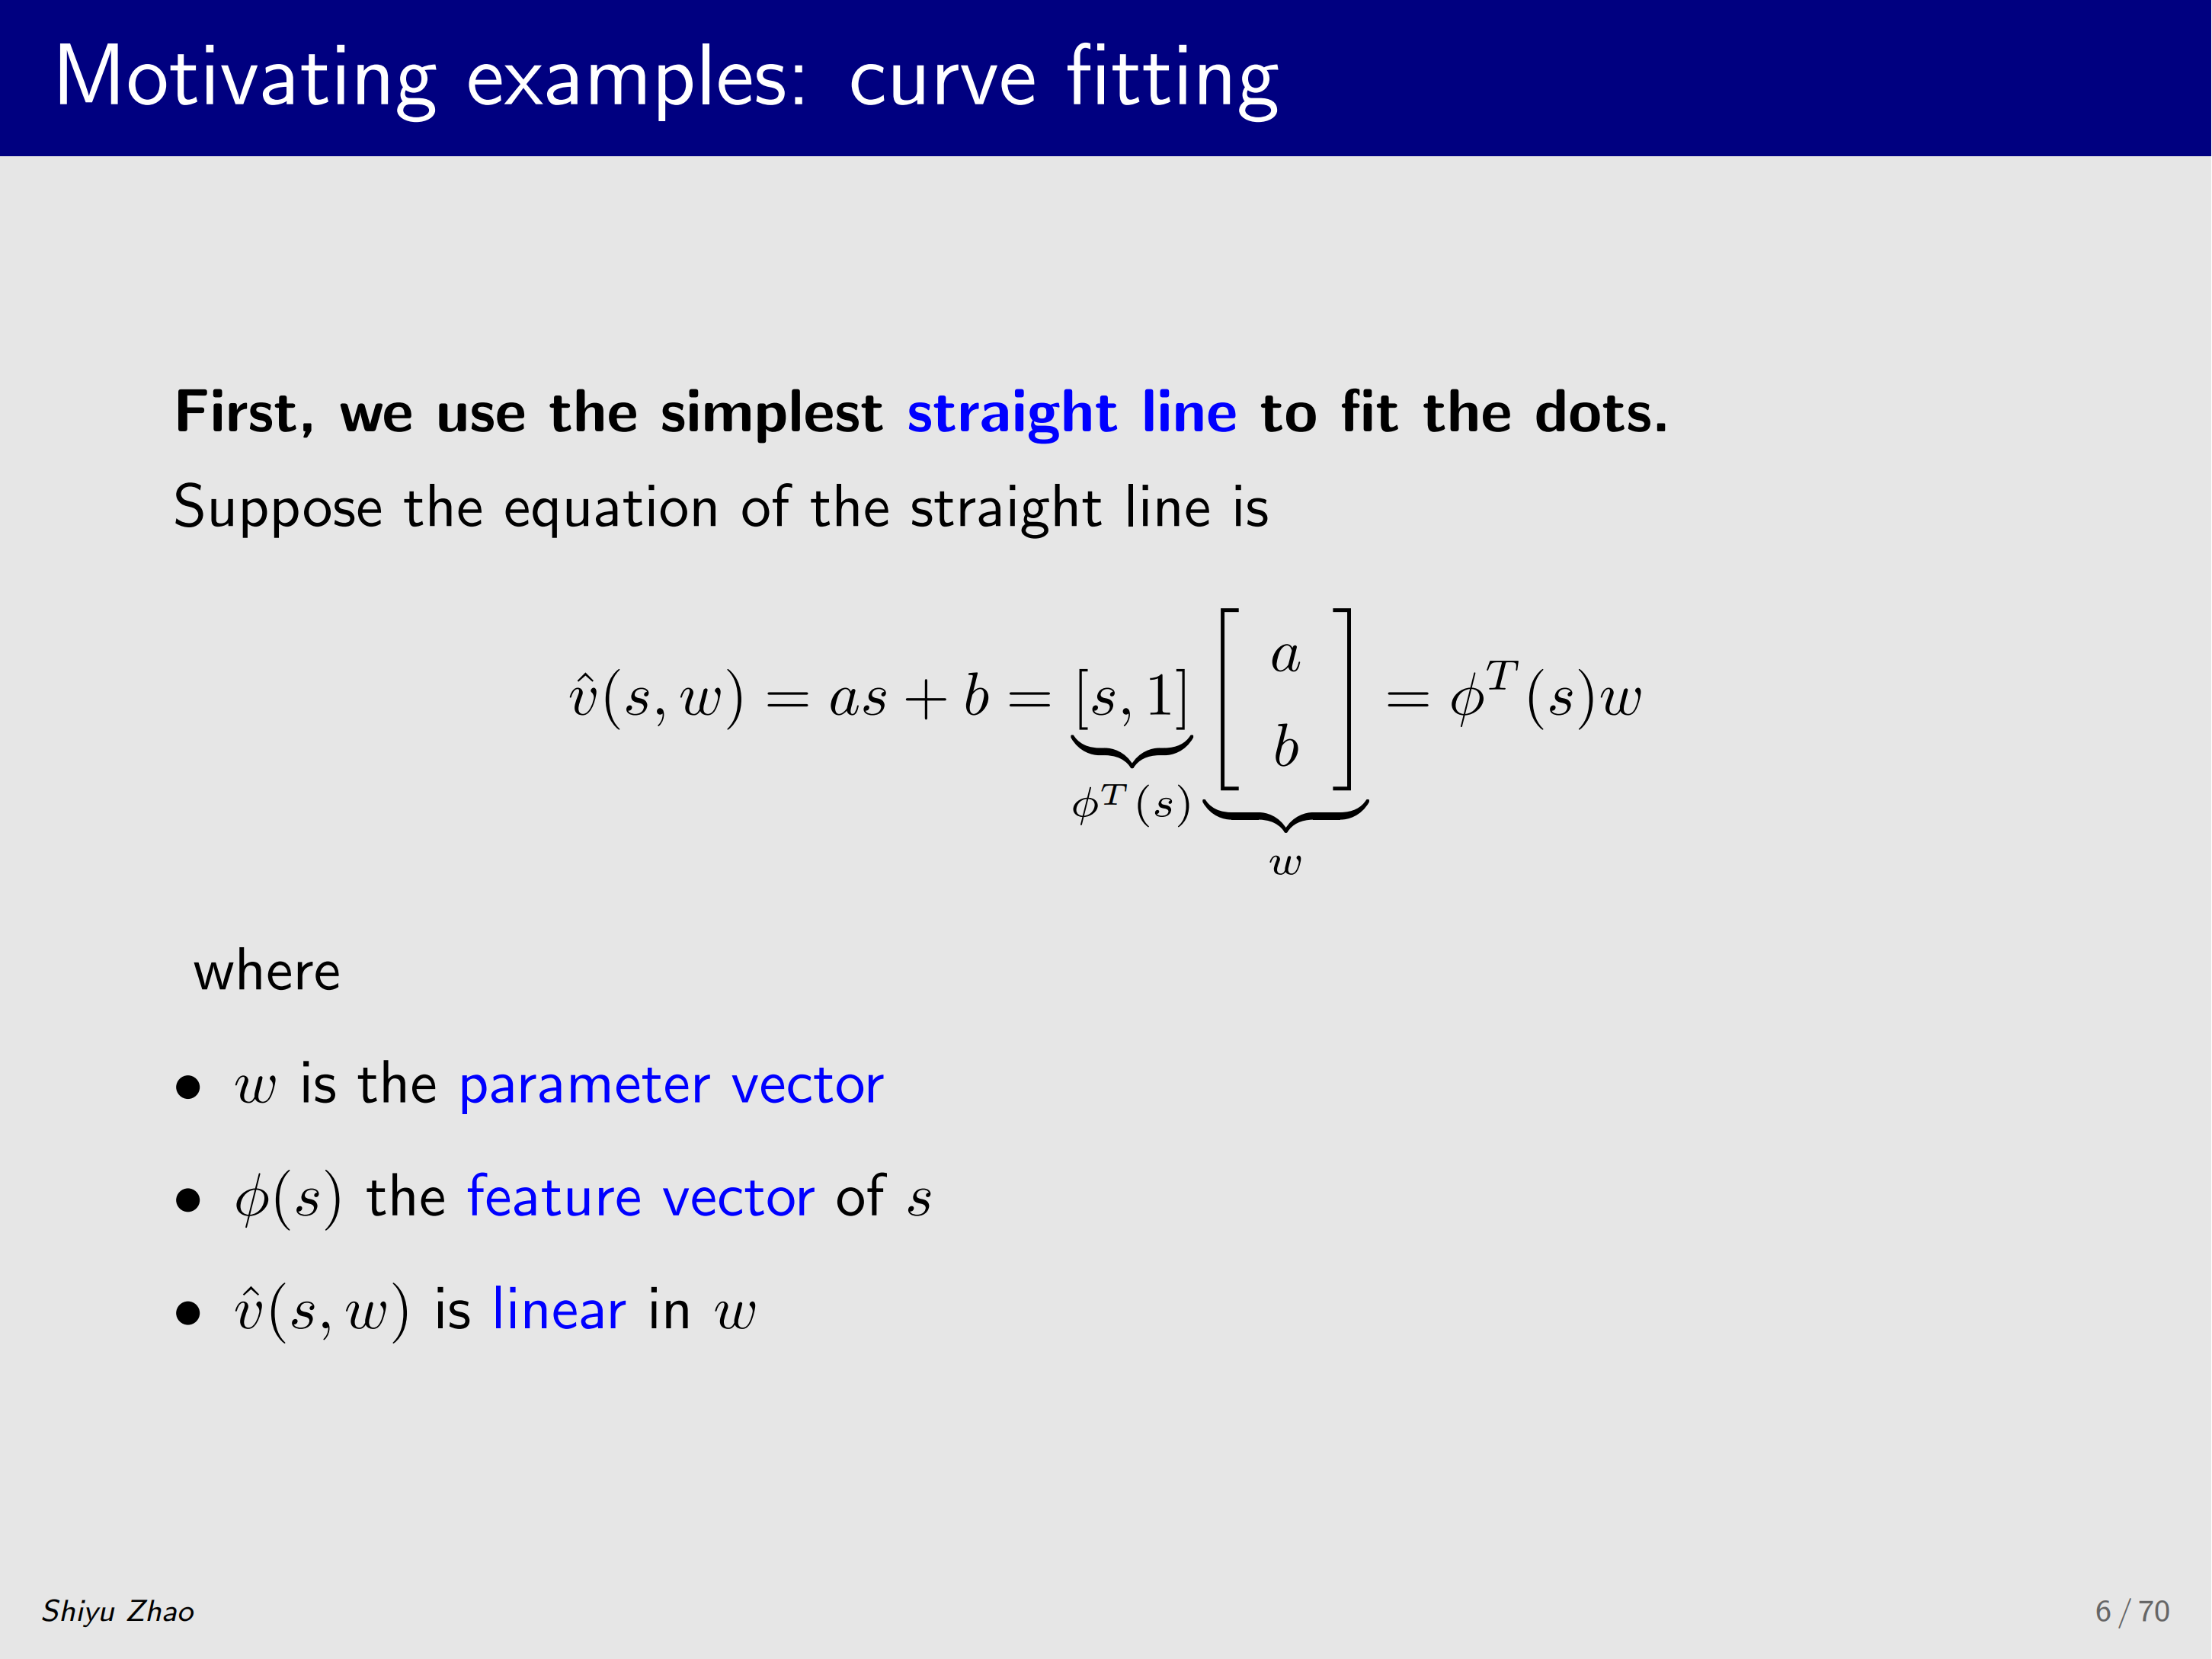
v ^ ( s , w ) = a s + b = s , 1 ⏟ ϕ T ( s ) a b ⏟ w = ϕ T ( s ) w \hat{v}(s, w) = as + b = \underbrace{s, 1}{\phi^T(s)} \, \underbrace{\begin{bmatrix} a \\2pt b \end{bmatrix}}{w} = \phi^T(s)w v^(s,w)=as+b=ϕT(s) s,1w ab=ϕT(s)w
答案肯定是可以的,最简单的情况是用一条直线拟合,直线的方程是什么呢?横坐标是 s s s ,直线方程就是 a s + b as+b as+b , a a a 和 b b b 是两个参数,函数用 v ^ \hat{v} v^ 表示,它代表对值的近似( ⋅ ^ \hat{\cdot} ⋅^ 一般表示估计量), v ^ \hat{v} v^ 是两个量的函数:状态 s s s 和参数 w w w 。
我们可以把 a s + b as+b as+b 写成两个向量相乘的形式,第一个向量包含 s s s ,记作 ϕ \phi ϕ ,第二个向量包含参数,记作 w w w ,显然这两个向量相乘仍得到 a s + b as+b as+b ,然后这个 v ^ \hat{v} v^ 最后就可以写成 ϕ T ( s ) w \phi^T(s)w ϕT(s)w。
这里的 w w w 和 ϕ \phi ϕ 有专门的名字, w w w 叫参数向量(parameter vector), ϕ \phi ϕ 叫 feature vector(特征向量) ,注意: v ^ \hat{v} v^ 对 w w w 是线性的,当然也可以是非线性关系,我们先从最简单的情况来考虑。
用直线拟合能带来哪些好处?
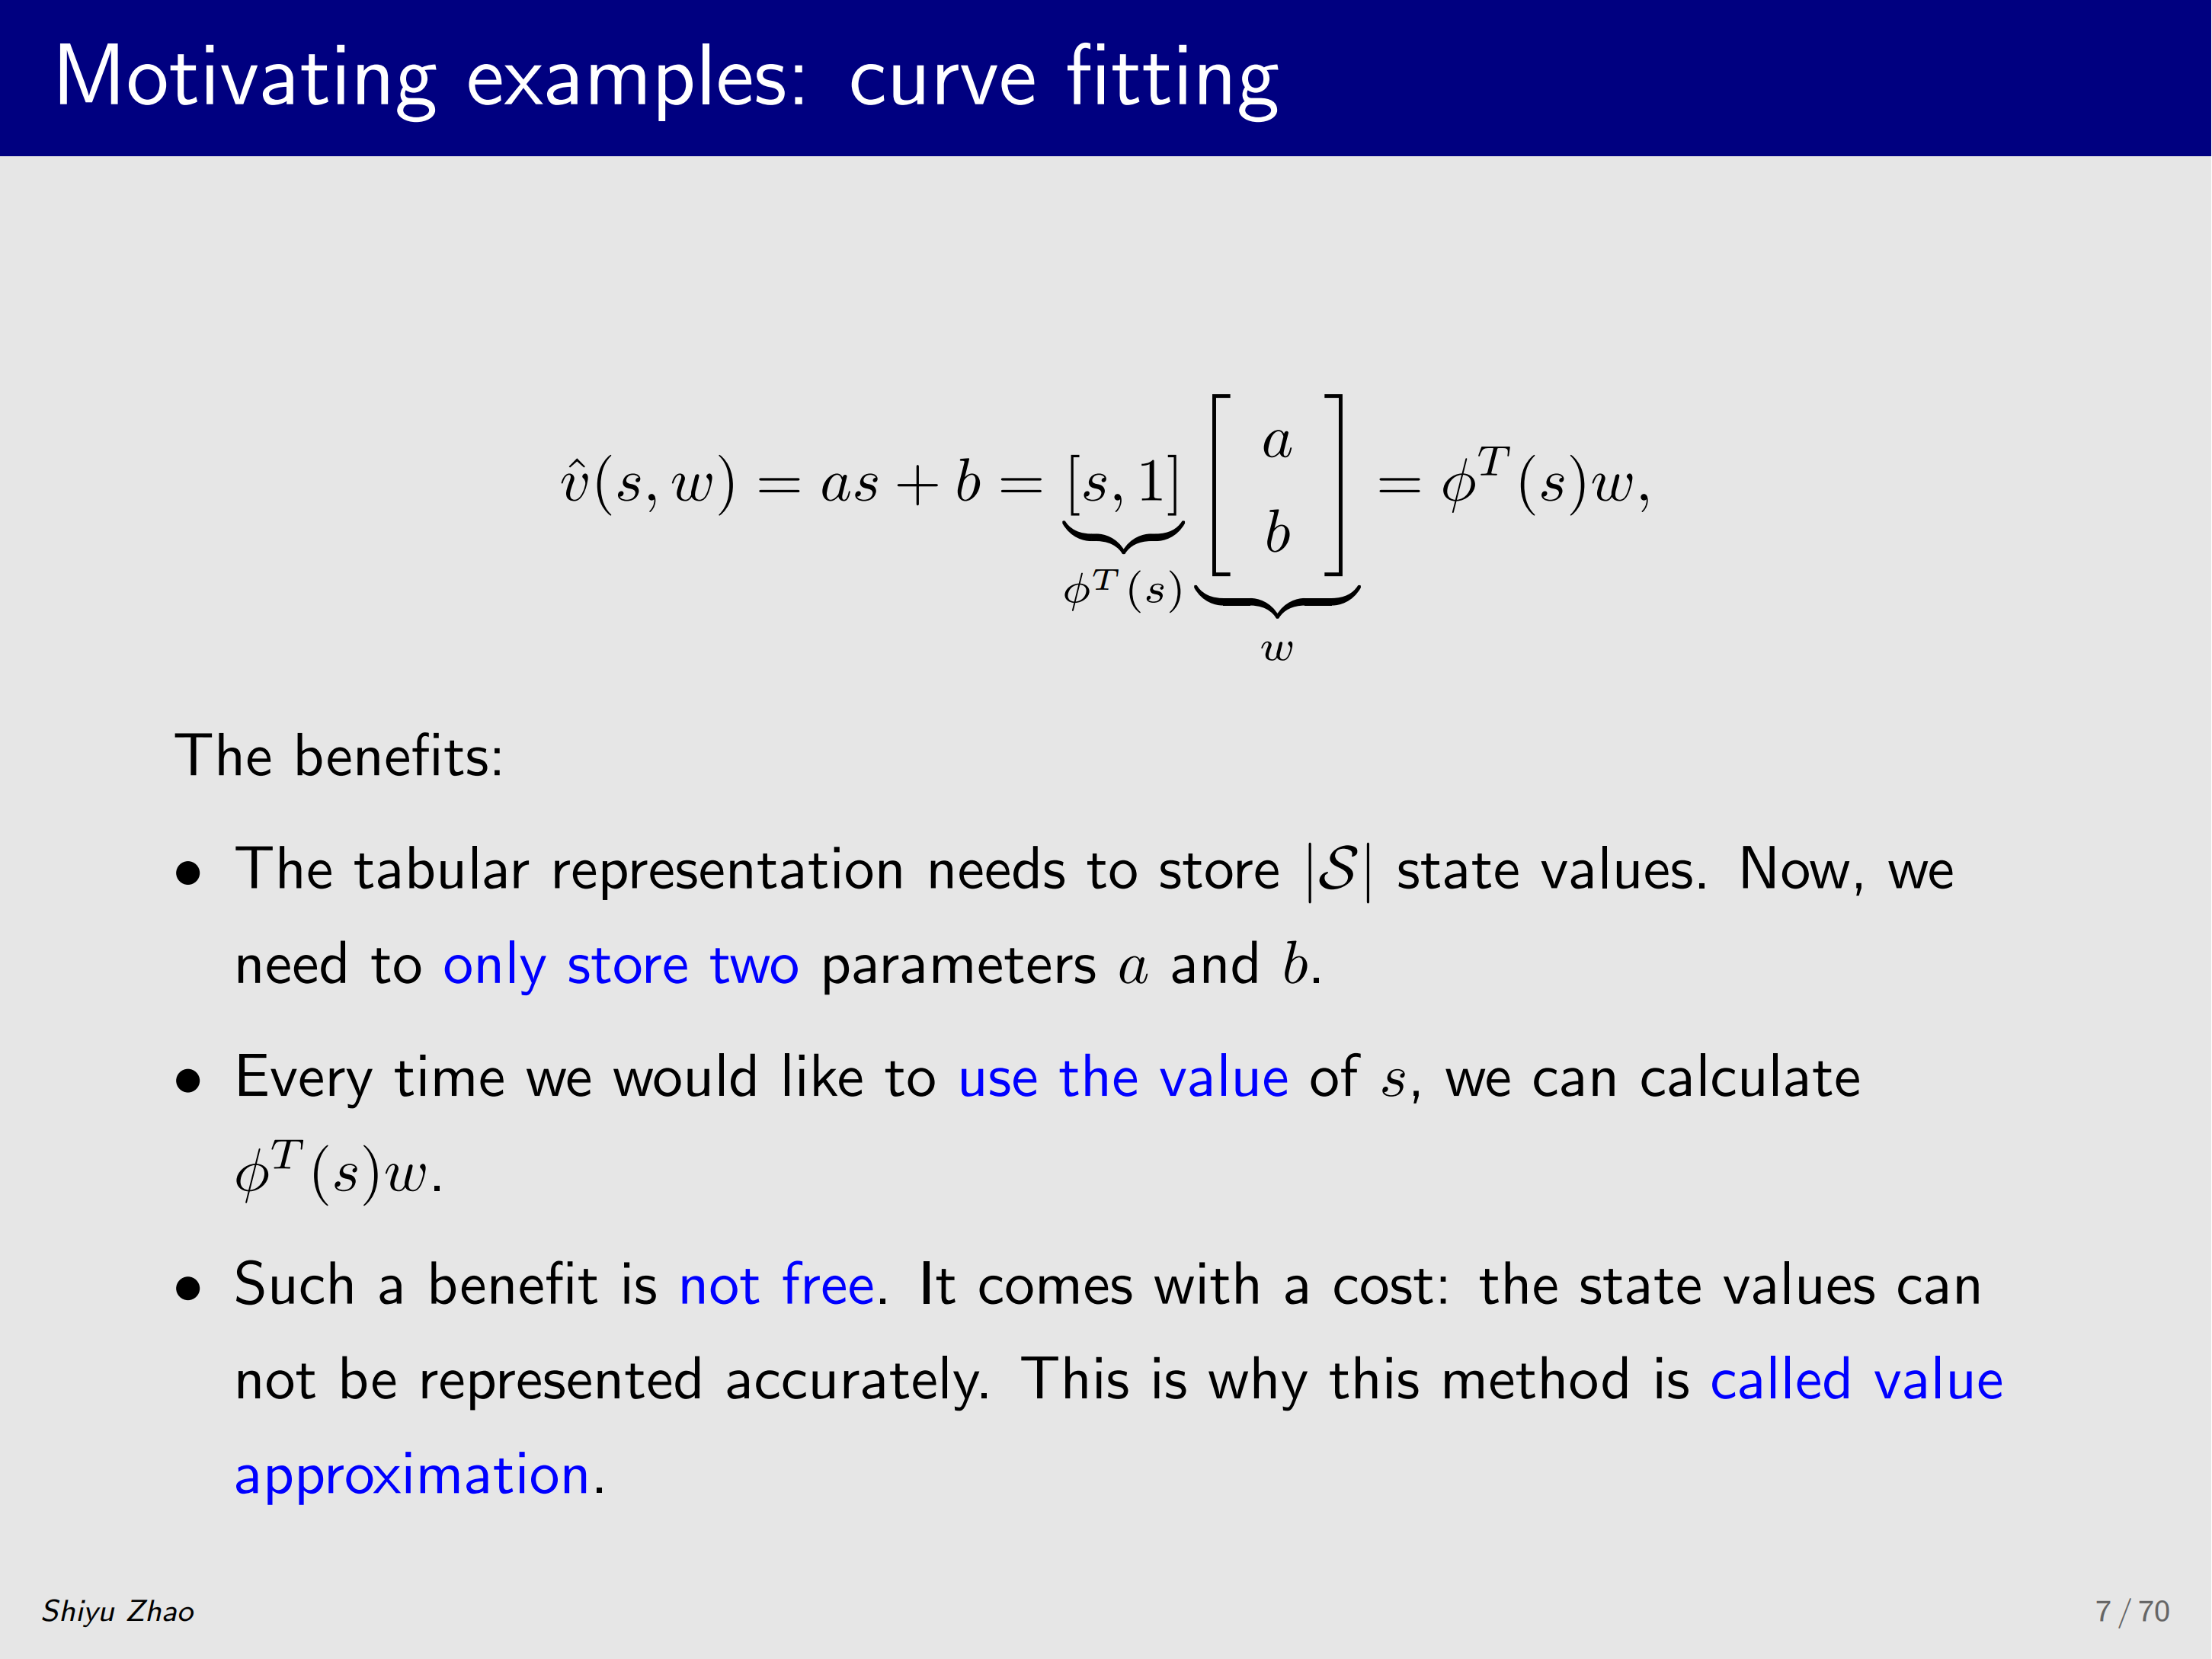
刚才如果用表格形式(不用曲线拟合),需要存储非常多的 state value;现在 只需存储两个值--- w w w 的两个分量 。为什么?想找 v π ( s ) v_\pi(s) vπ(s) 时,现在是近似 v ^ ( s , w ) \hat{v}(s,w) v^(s,w):第一步先算出特征向量 ϕ ( s ) \phi(s) ϕ(s) ,第二步用 ϕ T ( s ) \phi^T(s) ϕT(s) 乘 w w w 就得到 v ^ \hat{v} v^ 。所以只需保存 w w w ,这极大地节省了内存。
但好处不是免费的,代价是: 近似不那么精确 ,比如离散点并不严格在一条直线上,却非用直线拟合,在很多点上,估计出来的 v ^ \hat{v} v^ 与 v π ( s ) v_{\pi}(s) vπ(s) 还是有比较大的区别,这也是为什么叫 value function approximation,它是一种近似。
有的同学说:直线拟合不准确,那能不能用更高阶的曲线来拟合呢?答案当然是可以的,比如考虑二阶曲线。
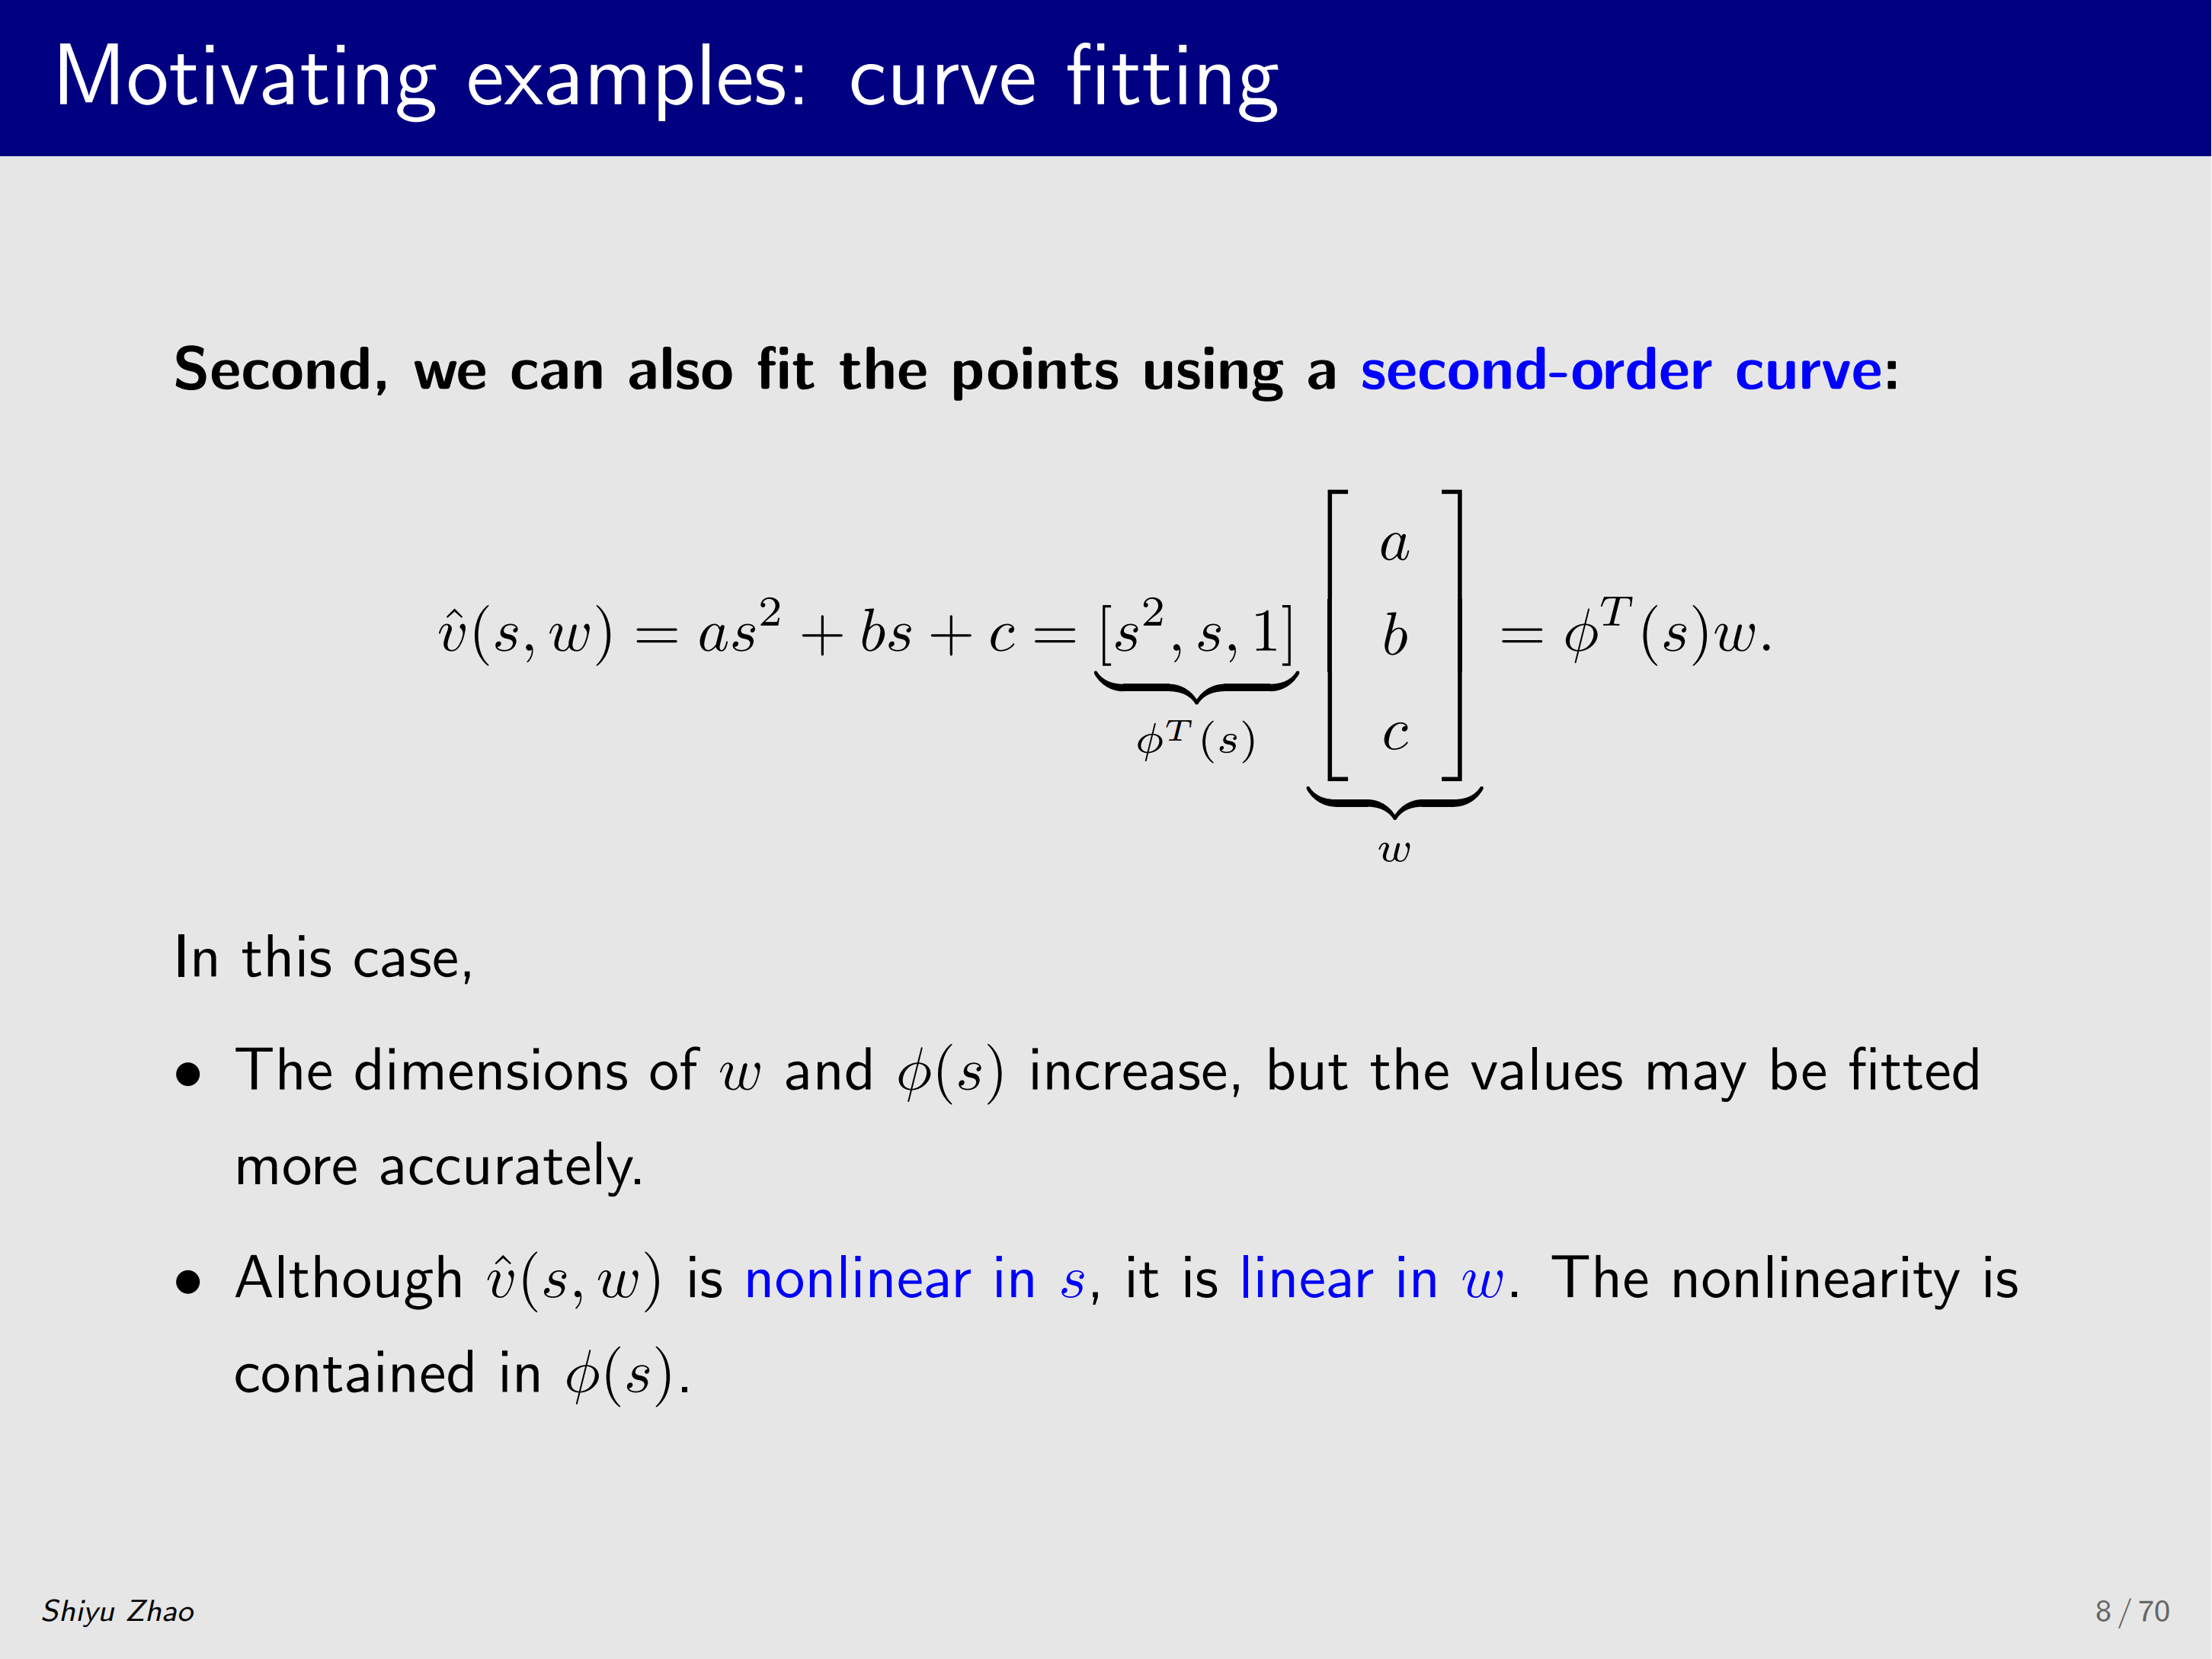
v ^ ( s , w ) = a s 2 + b s + c = s 2 , s , 1 ⏟ ϕ T ( s ) a b c ⏟ w = ϕ T ( s ) w . \hat{v}(s, w) = as^2 + bs + c = \underbrace{s\^2, s, 1}{\phi^T(s)} \, \underbrace{\begin{bmatrix} a \\2pt b \\2pt c \end{bmatrix}}{w} = \phi^T(s)w. v^(s,w)=as2+bs+c=ϕT(s) s2,s,1w abc =ϕT(s)w.
二阶曲线是什么呢?就是写成 v ^ = a s 2 + b s + c \hat{v}=as^2+bs+c v^=as2+bs+c 的形式,它同样可以写成 ϕ T ( s ) w \phi^T(s)w ϕT(s)w 的形式,此时 ϕ \phi ϕ 和 w w w 的维数增加,意味着需要存储更多的值,但好处是 拟合精度可能提高。
这里还想提出一点,此时 v ^ ( s , w ) \hat{v}(s,w) v^(s,w) 对 s s s 是非线性的,但对参数 a , b , c a,b,c a,b,c 是线性的,非线性都被吸收进 feature vector,所以 v ^ \hat{v} v^ 对 w w w 是线性的。
当然也可以用 神经网络 等做非线性拟合,那时函数对 w w w 就是 非线性 的,甚至可以继续增加曲线阶数,用更复杂的曲线来拟合这些点,好处是拟合更准确,坏处是需要更多参数。
通过刚才的这几个例子我们来做一个简单的总结。
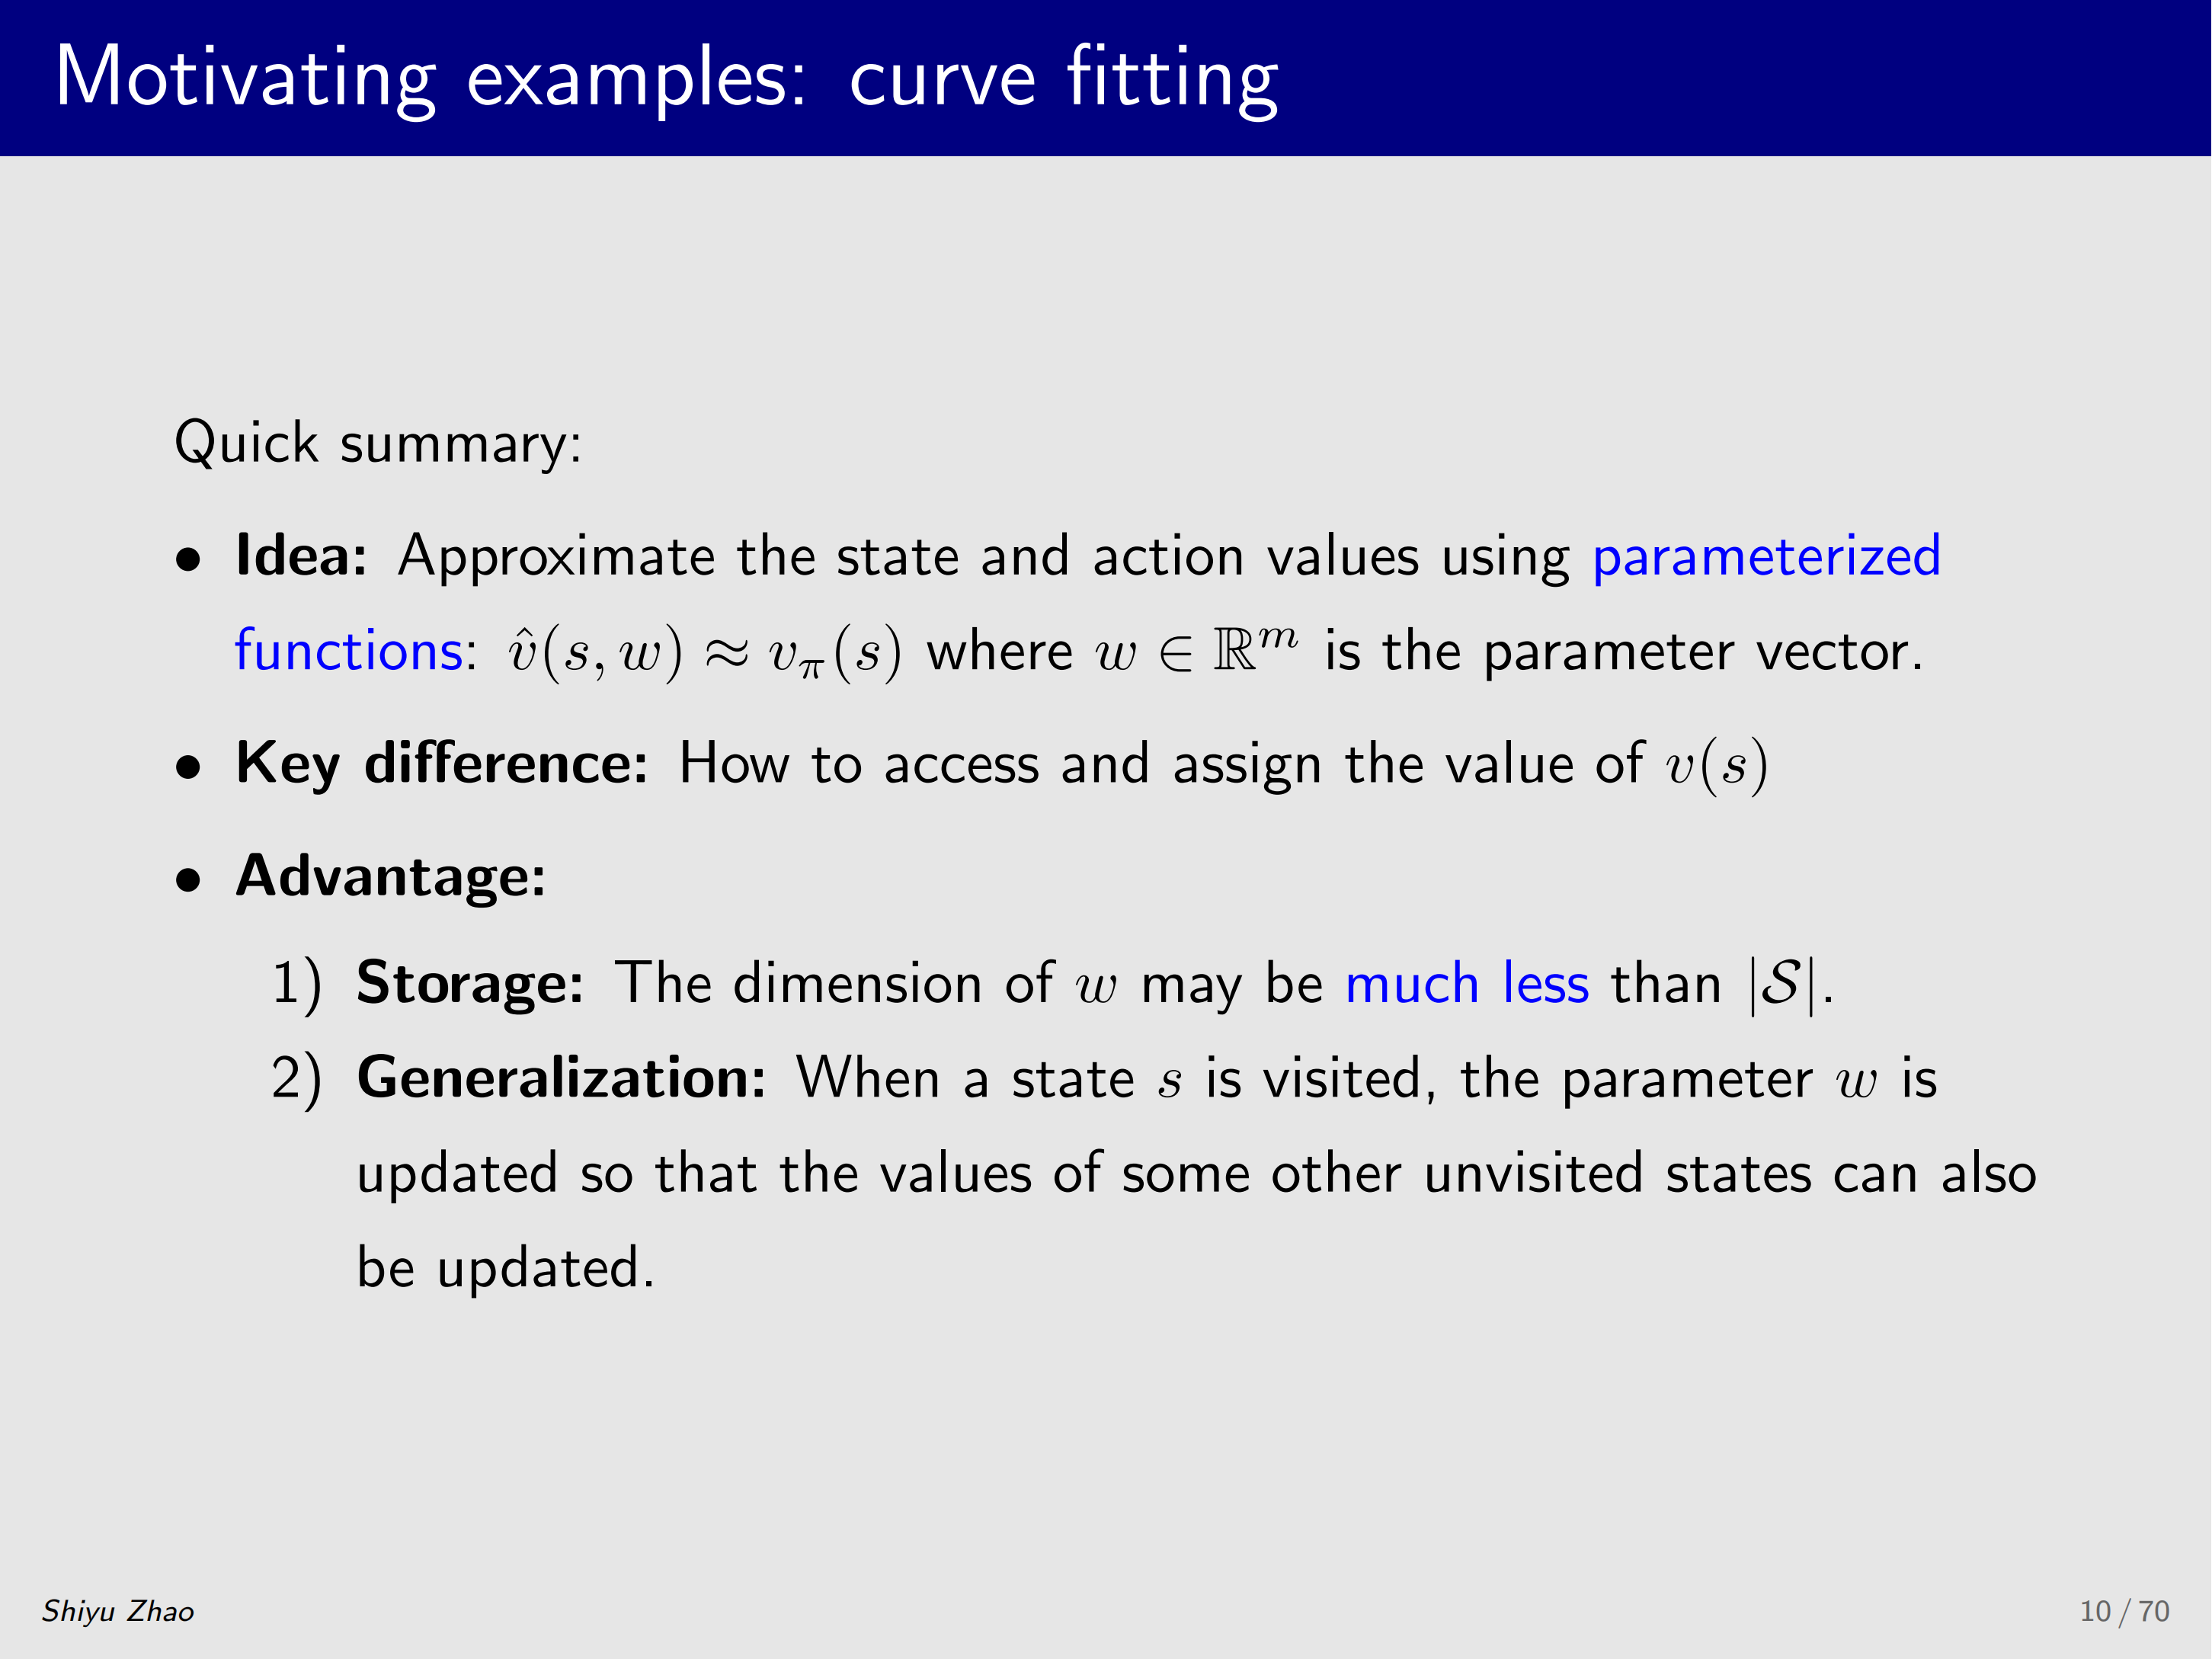
第一,value function approximation 的 idea 是什么?其实很简单,就是 用一个函数来拟合 v π ( s ) v_{\pi}(s) vπ(s),函数里有一个参数 w w w,所以叫 parameterized function , w w w 就是 parameter。
好处是什么?第一是 节省存储 ,如果状态非常多,就要存储非常多的 state value,但现在只需要存储 w w w , w w w 的维数可能非常低,所以能节省大量存储空间。
第二是 泛化能力 。简单说明一下:假如现在有三个相邻的状态 s 1 s_1 s1、 s 2 s_2 s2、 s 3 s_3 s3,第一种情况用 table 表示,最开始的时候它们的 value 全为 0,有一个 episode 访问到 s 2 s_2 s2 ,就可以更新 s 2 s_2 s2,更新后它的 value 变成 1,这就是表格表示的情况,注意: s 1 s_1 s1 和 s 3 s_3 s3 没被访问到,值保持不变。
而用函数后情况就变了。同样 s 1 s_1 s1、 s 2 s_2 s2、 s 3 s_3 s3 ,假设原函数是一条水平线;访问 s 2 s_2 s2 后发现它的值不应该是 0 而应该是 1,函数就会改变。改变方式是什么? 不是直接改 s 2 s_2 s2 的值,而是改 w w w ---一旦 w w w 改变,整个函数就变了,可能不再是水平线。
所以虽然 s 1 s_1 s1、 s 3 s_3 s3 没被访问, s 2 s_2 s2 的改变通过 w w w 使它们的值也发生了变化--- 这就是泛化能力。也就是说,不需要访问所有状态:访问其中一些,相邻状态的值也能被较准确地估计。这也是 value function approximation 非常重要的优势。
结语
本讲第一部分通过曲线拟合的例子,为 value function approximation 奠定了直观基础。面对大规模或连续的状态空间,表格表示遭遇了存储与泛化两大瓶颈:状态太多存不下,访问不全又估不准。而参数化函数 v ^ ( s , w ) = ϕ T ( s ) w \hat{v}(s,w) = \phi^T(s)w v^(s,w)=ϕT(s)w 提供了优雅的出路---只需存储低维的参数向量 w w w ,就能覆盖整个状态空间;并且由于更新 w w w 会牵动整个函数,被访问状态的更新会自动 "波及" 相邻的未访问状态,实现泛化。
拟合精度与参数数量之间的权衡也在此清晰呈现:直线只需 2 个参数但精度有限,高阶曲线参数更多、拟合更好,神经网络的引入则让 v ^ \hat{v} v^ 对 w w w 变为非线性,表达能力进一步提升。一个值得记住的技术细节是:无论 ϕ ( s ) \phi(s) ϕ(s) 多么非线性,只要函数形式为 ϕ T ( s ) w \phi^T(s)w ϕT(s)w ,它对参数 w w w 就是线性的---非线性全部被吸收进了 feature vector,这使得线性情形下的优化与分析格外简洁。接下来,我们将正式构建 policy evaluation 的目标函数并求解最优参数🤗。