PPO 会探索、CBF 会保命:RADAR-BPO 把复杂环境碰撞率压到 10.7%
原文:Risk-Aware Reinforcement Learning with Dynamic Safety Filter for Collision Risk Mitigation in Mobile Robot Navigation
作者:Bingbing Guo、Guina Wang、Yiyang Chen、Yue Gao(苏州大学机电工程学院)、Qian Xie(江苏易程科技股份有限公司)
期刊:Sensors 2025, 25, 5488(MDPI,2025-09-03 出版,DOI: 10.3390/s25175488)
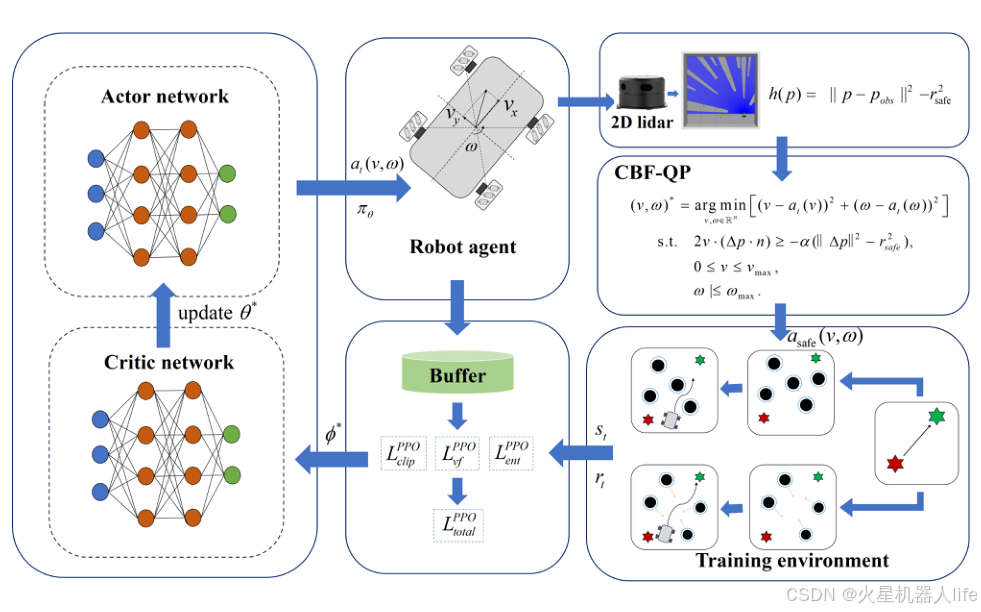
图注:左上 Actor / 左下 Critic 是标准的 PPO 结构,右侧才是本文的关键增量:策略输出的速度指令 (v,ω)(v,\omega)(v,ω) 不直接下发,而是先经过 CBF-QP 模块做一次"安全审查"------在满足控制屏障函数约束的前提下,找到离原动作最近的可行动作。整条链路就是"探索交给 PPO、安全交给 QP"。
强化学习会给机器人"敢冲"的探索精神,但不会给你任何不撞的承诺。这篇 Sensors 论文的思路非常直接:在 PPO 的动作和执行之间插一个基于控制屏障函数(CBF)的"安全阀",用二次规划(QP)实时把危险动作改造成安全动作。结果是在最复杂的混合障碍环境里,碰撞率从 PPO 的 30.67% 降到 10.67%,任务成功率接近 90%。
研究背景与现有方法不足
移动机器人在动态环境里躲避碰撞是刚需,但传统方法存在结构性矛盾:
- 基于规则的传统导航:依赖预定义规则(避障半径、优先级、状态机等),在复杂动态环境里难以做到"灵活、安全、实时"三者兼顾------规则写死了就不灵活,规则放宽了就不安全。
- 纯强化学习(PPO/DQN/DDPG 等) :探索效率低、策略波动大、安全性没有保证 。论文用实验数据把这一点量化了:在最复杂的混合环境(Env 3)中,PPO 的碰撞率高达 30.67% ;更值得注意的是环境切换时的崩溃现象------从多静态障碍环境切到混合环境后,PPO 策略"几乎失效",需要从极高碰撞率开始重新爬升,学习过程剧烈震荡。
- 单独使用 CBF:能给出形式化的安全保证,但 CBF 本身只是一个约束层,不具备"要去哪儿、怎么走更高效"的决策能力。
作者的判断是:"会探索"和"不撞"应该由两个不同的模块分别负责,而不是指望一个端到端策略同时具备。于是问题变成:如何在保留 PPO 探索能力的同时,把安全性从策略里"拆出来",做成一层的实时滤波?
核心创新点
1)RADAR-BPO:把 PPO 与 CBF 做深度集成。 命名拆开就是这套方法的全部内容------R isk-A ware、D ynamic、A daptive R egulation B arrier P olicy O ptimization。它在每个训练迭代中:先用当前策略 πθ\pi_\thetaπθ 与环境交互收集轨迹(探索),用 PPO + GAE 更新策略与价值网络(学习),然后在动作下发前做一次安全滤波(CBF),最后才把安全动作交给机器人。
2)CBF-QP 安全滤波器:用"最小改动"实现"安全"。 每步求解一个二次规划:
minv,ω ∥a−atPPO∥2s.t. 2v⋅(Δp⋅i) ≥ −α(∥Δp∥2−rsafe2), 0≤v≤vmax, ∣ω∣≤ωmax\min_{v,\omega}\ \|a - a^{PPO}t\|^2 \quad \text{s.t.}\ 2v\cdot(\Delta p\cdot i)\ \ge\ -\alpha(\|\Delta p\|^2 - r{safe}^2),\ 0\le v\le v_{max},\ |\omega|\le \omega_{max}v,ωmin ∥a−atPPO∥2s.t. 2v⋅(Δp⋅i) ≥ −α(∥Δp∥2−rsafe2), 0≤v≤vmax, ∣ω∣≤ωmax
其中 Δp\Delta pΔp 是机器人相对最近障碍的位置向量,rsafer_{safe}rsafe 是安全距离。这个形式的含义很工程化:在保证"离障碍足够远"的前提下,尽量别改变 PPO 原本想做的事。因此它既能拦住危险动作,又不会让策略"失去学习方向"------论文强调这种设计让策略改进与安全保障互相强化。
3)风险感知的自适应多目标奖励。 奖励由四项相加:
| 项 | 形式 | 作用 |
|---|---|---|
| 方向奖励 rhr_hrh | 1+cos(θdiff)1+\cos(\theta_{diff})1+cos(θdiff) | 朝向目标方向(取值 0,2) |
| 距离奖励 rdr_drd | 5exp(−2dt/d0)5\exp(-2 d_t/d_0)5exp(−2dt/d0) | 鼓励向目标推进 |
| 障碍惩罚 robr_{ob}rob | rriskr_{risk}rrisk(当 dmin<rsafed_{min} < r_{safe}dmin<rsafe)否则 rnormalr_{normal}rnormal | 把"离得太近"直接变成负反馈 |
| 速度奖励 rvr_vrv | exp(−(vt−vdes)2/2σ2)\exp(-(v_t-v_{des})^2/2\sigma^2)exp(−(vt−vdes)2/2σ2),vdes=0.25min(1.0,dt)v_{des}=0.25\min(1.0,d_t)vdes=0.25min(1.0,dt),σ=0.1\sigma=0.1σ=0.1 | 远时快、近时慢,兼顾效率与精度 |
四项设计成量级相当并直接相加,作者明确说这是为了"简单、可解释、少调参"。
4)三阶段课程式训练。 环境按复杂度递增:动态行人环境(150 回合)→ 多静态障碍(200 回合)→ 静态+动态混合的复杂环境(300 回合)。训练回合在"到达目标 / 碰撞 / 达到最大步数"时结束。这一设计让 agent 先夯实基础避障能力,再挑战难环境------也正是"环境切换后仍能稳定微调"的基础。
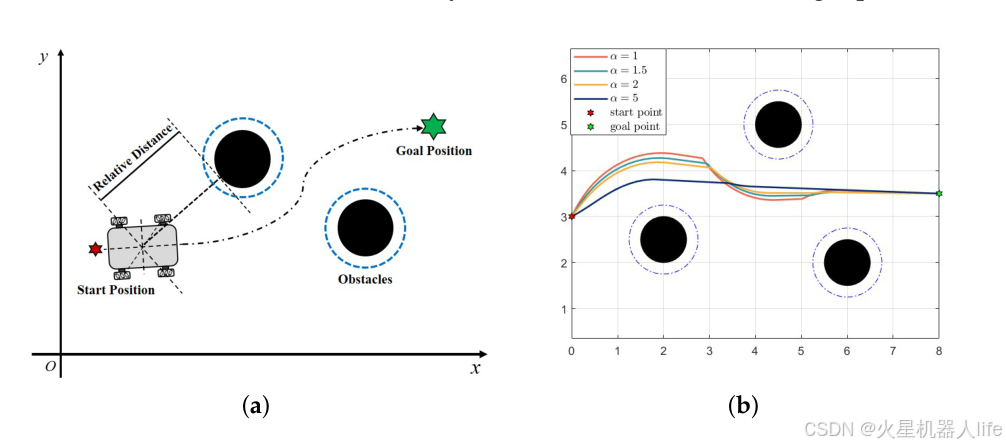
图注:这张图展示的是安全滤波器在真实运行中的效果:机器人依次穿过动态行人与障碍(蓝色射线为激光扇区),路径平滑没有"贴脸"的瞬间。它的意义在于证明 CBF 不是纸面约束,而是在每一步都在改变控制量的"活"机制。
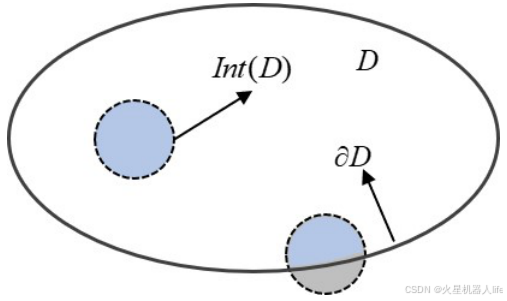
图注:理解 CBF 最省力的图:集合 D 是安全区,内部 Int(D) 是"随便走",边界 ∂D 就是 CBF 约束起作用的地方------一旦靠近边界,QP 就会开始修正动作,把机器人"推回"安全区内。
实验平台
- 仿真环境: 全部实验在 ROS Gazebo 平台完成,机器人为麦克纳姆轮全向移动底盘 (论文给出四轮速度与 vx,vy,ωv_x, v_y, \omegavx,vy,ω 的完整运动学关系;车体半长 Wa=0.195W_a=0.195Wa=0.195 m、半宽 Wb=0.172W_b=0.172Wb=0.172 m、特征长度 d=Wa+Wb=0.367d=W_a+W_b=0.367d=Wa+Wb=0.367 m)。
- 感知与安全参数: 2D 激光雷达,角度范围 0°, 360° ,扫描距离 0.08, 10 m ;安全距离 rsafe=0.5r_{safe}=0.5rsafe=0.5 m,屏障参数 α=1.0\alpha=1.0α=1.0,最大线速度 0.5 m/s、最大角速度 1.0 rad/s。
- 三个测试环境(递进式):
- Env 1:动态行人环境------两个行人以固定速度往返(论文用 Table 1 给出了具体轨迹坐标),另有两个静止行人;机器人从 (0.0, 0.0) 出发前往 (3.0, 3.0)。
- Env 2:多静态障碍环境------多个圆柱/立方障碍。
- Env 3:复杂混合环境------多个行人与多种静态障碍共存。
- 训练超参: 折扣因子 γ=0.99、GAE 参数 λ=0.95、裁剪阈值 ε=0.15、价值系数 c1c_1c1=0.5、熵系数 c2c_2c2=0.01;策略迭代次数 K 按环境取 150, 200, 300。
- 对比基线: PPO、DQN、DDPG;评估指标为成功次数、碰撞次数、平均奖励、碰撞率(同一环境下各跑完整训练回合:Env 1 共 150、Env 2 共 200、Env 3 共 300 回合)。
主要结果
与 PPO 的核心对比(Table 3):
| 环境 | 指标 | PPO | RADAR-BPO |
|---|---|---|---|
| Env 1(动态行人) | 成功 / 碰撞次数 | 27 / 123 | 47 / 103 |
| 碰撞率 | 82.00% | 68.67% | |
| Env 2(多静态障碍) | 成功 / 碰撞次数 | 134 / 66 | 164 / 36 |
| 碰撞率 | 33.00% | 18.00% | |
| 平均奖励 | 377.01 | 1070.09(约 2.8 倍) | |
| Env 3(复杂混合) | 成功 / 碰撞次数 | 208 / 92 | 268 / 32 |
| 碰撞率 | 30.67% | 10.67%(约为原来的 1/3) | |
| 平均奖励 | 399.38 | 762.66 |
- 任务成功率 :Env 3 中 RADAR-BPO 在 300 个回合里成功 268 次(≈89.3%,即摘要中"接近 90%"的避障成功率),PPO 为 208 次;Env 2 中为 164/200(82%)对 PPO 的 134/200。
- 碰撞率 :Env 3 从 30.67% 降到 10.67%,降幅约 2/3;Env 2 从 33.00% 降到 18.00%。
- 其他基线全面落后:Env 2 中 DDPG 平均奖励仅 58.02、碰撞率 87.50%;Env 1 中 DQN 碰撞率 100.00%(150 回合全撞),DDPG 88.67%------说明在动态避障任务上,朴素的价值/策略方法很难稳定工作。
训练稳定性(Figure 8 的奖励曲线):
- Env 2 阶段,RADAR-BPO 的奖励迅速突破 1000 并稳定在约 1100,而 PPO 缓慢爬到约 400,DQN/DDPG 明显更差;
- Env 3 阶段所有算法都因难度上升而性能回落,但 RADAR-BPO 依然稳定在约 760,曲线平滑抗震荡;PPO 则在 400 以下剧烈波动;
- 论文对此的解释很关键:环境切换后 PPO 需要从极高的碰撞率重新"痛苦学习",而 RADAR-BPO 依靠 CBF 提供的实时安全保证,保留了核心避障能力,之后的调整只是在高性能基线上的稳定微调。 换句话说,它牺牲了"看起来更陡的学习幅度",换来了更高、更稳、更安全的最终性能。
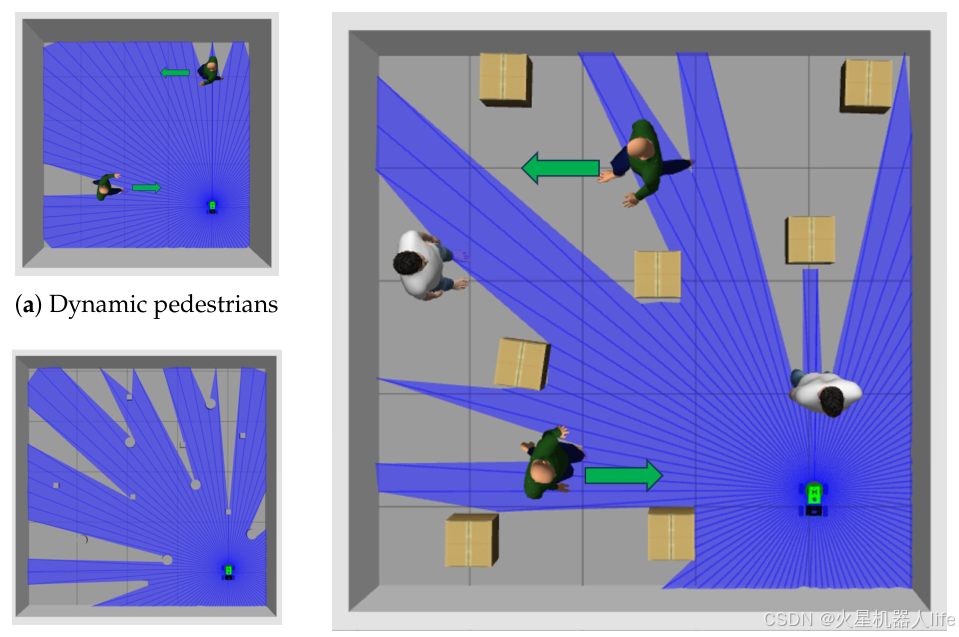
图注:从左到右是 Env 1(两个往返行人 + 两个静止行人)、Env 2(多静态障碍)、Env 3(静态与动态障碍共存的混合环境);蓝色射线是激光扇区可视化。三阶段的复杂度递增就是本文"课程式训练"的物理对应物。
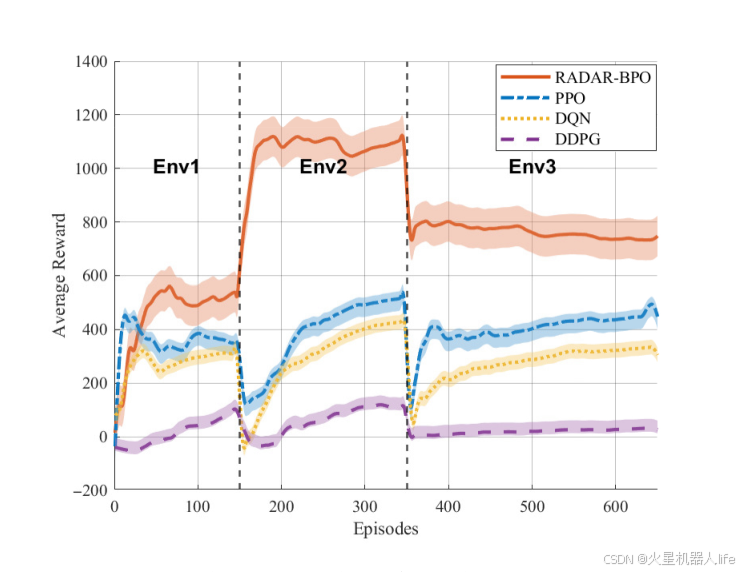
图注:虚线标出三次环境切换的位置。最值得看的是每次切换瞬间:PPO(蓝虚线)在 Env 2→Env 3 处出现明显震荡与下滑,而 RADAR-BPO(橙实线)平稳过渡------这就是"实时安全滤波保留住核心避障能力"的直接证据。
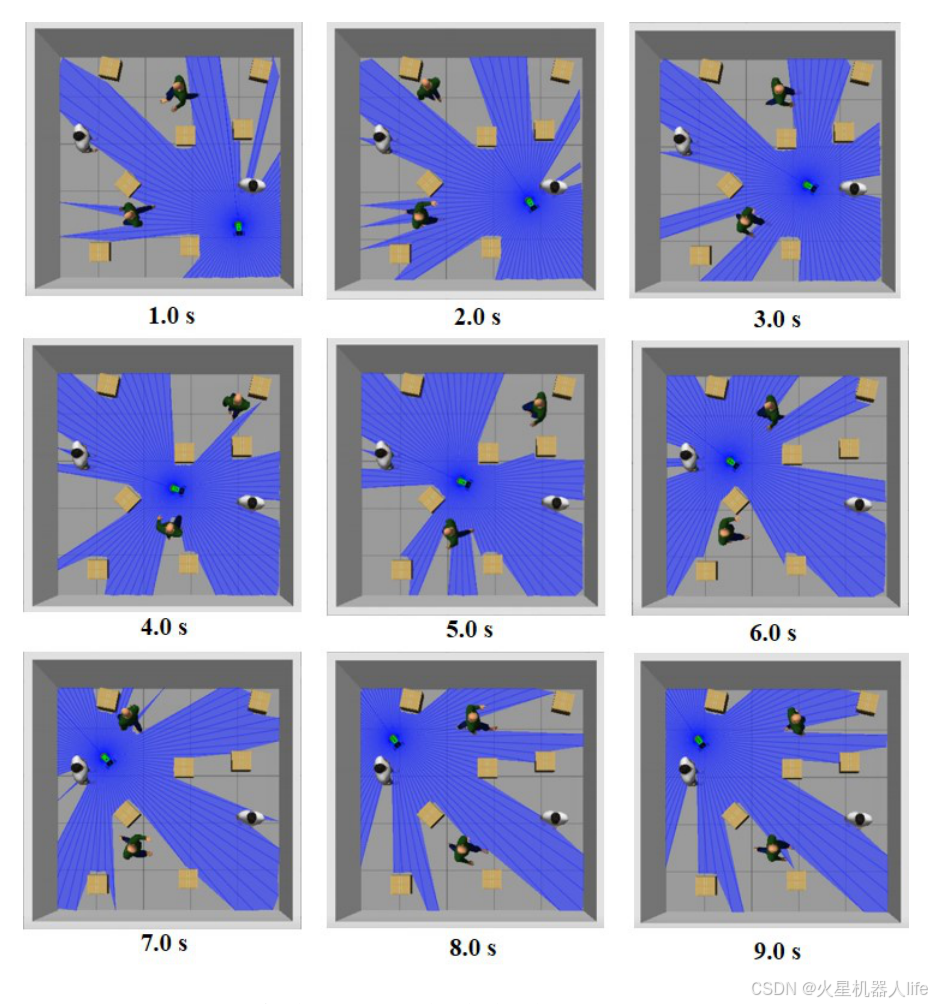
图注:九宫格展示了机器人如何在多行人、多障碍的混合环境里逐步穿过------每一帧都标出激光扇区(蓝色)与机器人、行人位置。这张图是"过程安全"最有说服力的可视化。
对机器人工程实践的启示
- 把安全从策略里"拆出来",是 sim-to-real 最省事的工程手段。 端到端策略要论证"不撞"几乎没有办法;而"策略 + 显式安全滤波层"可以让安全约束独立于网络权重,即使策略在新环境里退化,滤波层仍能兜住底线(Env 3 的碰撞率降幅就是证据)。
- 安全滤波的成本要算进控制周期。 每一步都要解一个 QP(含 360° 激光带来的多个障碍约束),因此工程部署时要评估最坏情况求解时间与降采样策略------这与"最坏耗时决定控制回路"的经验一致。
- 环境切换的稳定性比峰值性能更重要。 产线/仓库的场景是不断变化的,PPO 式"换环境就崩、重新学"的行为代价极高;RADAR-BPO 奖励曲线的平滑过渡提醒我们:在线运行中,策略退化的速度比它的最优性能更值得关注。
- 奖励函数不必复杂,量级对齐即可。 四项相加(方向、距离、障碍、速度)且刻意设计成量级相当,作者明确说是为了"可解释、少调参",这套写法可以直接借用。
- 课程式训练是低成本的泛化手段。 150 → 200 → 300 回合的渐进训练安排(回合数随环境复杂度增加)几乎不需要额外工程投入,却显著改善了难环境下的表现。
主要局限 + 未来方向
- 只有 Gazebo 仿真,没有真机实验。 论文的结论(近 90% 成功率、10.67% 碰撞率)全部来自 ROS Gazebo,真实底盘的打滑、定位漂移、行人真实行为都未验证。
- 人群行为过于理想化。 行人的运动轨迹是预先设定好的折返运动(论文 Table 1 直接给出坐标),不含随机性,也没有社会规范(如靠右通行、个人空间)建模------这与真实人群差距很大。
- 安全模型的表达能力有限。 CBF 采用静态屏障参数 α=1.0\alpha=1.0α=1.0 与"到最近障碍点"的几何约束,属于瞬时几何安全,不含速度障碍/轨迹预测;对于高速接近的障碍,几何上"当前够远"并不代表下一秒安全。
- 评估口径单一。 每格只有一轮完整训练(150/200/300 回合)的统计,没有多随机种子重复实验,也没有对 CBF 开关、rsafer_{safe}rsafe、α 等关键参数的敏感性分析。
- 未来方向: 向真实平台迁移、引入行人轨迹/意图预测与更动态的屏障函数(时间变化的 α)、多机器人协同与更多随机种子的统计验证。
总结
RADAR-BPO 的贡献可以用一句话概括:它把"探索"和"保命"这两件事拆给了两个模块 ------PPO 负责在环境里大胆试错并学习导航策略,CBF 负责在每一个控制周期用一次二次规划把危险动作拉回安全边界内。效果很直接:在最复杂的混合障碍环境中,碰撞率从 30.67% 降到 10.67%(约降 2/3),平均奖励从 399.38 提到 762.66,任务成功率接近 90%;在环境切换时,PPO 会出现"从高碰撞率重新学习"的崩溃式震荡,而 RADAR-BPO 能平稳过渡。对做移动机器人导航的团队来说,这篇论文给出的最具迁移价值的经验是:不要把安全性寄托在网络权重上,把它写成一个可以在线求解的约束层。