文章目录
简介
gymnasium是OpenAI的强化学习(Reinforcement Learning, RL)库,提供了一套统一的Python接口,用于定义和交互单智能体强化学习环境,并内置了大量经典参考环境。pip安装即可
pip install gymnasium -i https://pypi.tuna.tsinghua.edu.cn/simple安装成功后,简单示例如下
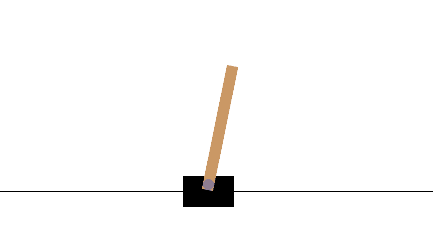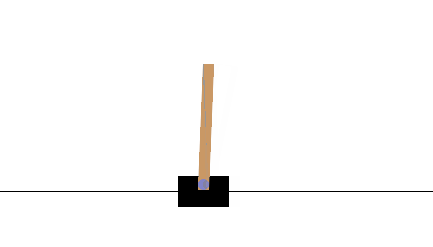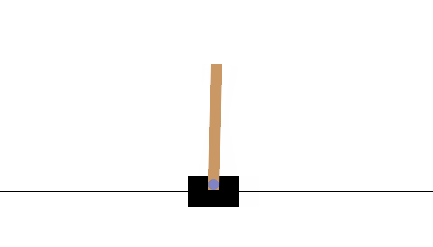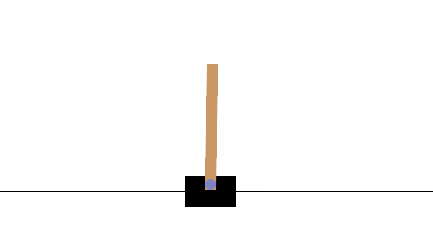
这是个小车推杆(CartPole)环境,是RL领域的Hello World任务,如图可见,一个小车(Cart)可以在一维轨道上左右移动,小车上铰接着一根杆子(Pole),智能体(Agent)需要控制小车在轨道边界内向左右移动,要求杆子尽可能长时间地保持直立。
代码如下
python
import gymnasium as gym

env = gym.make("CartPole-v1", render_mode="human")
obs, info = env.reset(seed=42)  # 重置环境获取初始观测

print(obs)  # [ 0.0273956  -0.00611216  0.03585979  0.0197368 ]

for _ in range(1000):
    action = env.action_space.sample()    # 策略选择动作 (此处为随机采样)
    obs, reward, terminated, truncated, info = env.step(action) # 执行状态转移
    # 检查回合结束条件
    if terminated or truncated:
        obs, info = env.reset()

env.close() # 释放资源
代码解析
gym.make用于创建环境,CartPole-v1是个小车推杆环境的ID,里面预置了上图中的倒立摆结构。render_mode为渲染模式,human表示在屏幕上弹出一个图形窗口,以人类可理解的帧率实时播放环境的画面。
reset用于重置环境,其输入为随机数种子,返回值为状态空间和信息。CartPole-v1环境中,状态空间包括四个值,分别是小车位置、小车速度、杆子角度、杆子角速度。
action_space是env的动作空间,在本例中,只包含 { 0 , 1 } \{0,1\} {0,1},表示向左和向右推车。sample为随机采样。在迭代过程中,这代表获取一次合法动作。
step(action)表示执行当前动作。其返回值包括
obs下一时刻的观测值reward即时奖励terminated自然终止标志,表示任务彻底失败或成功,在本例中,如果Pole倒了或者小车冲出轨道,则终止运行truncated人为截断标志,表示因为环境外部的非物理限制导致的云联阶数。info一些其他信息
环境
【Env】是Gymnasium的核心类,实现了马尔可夫决策过程 (markovian decision process, MDP) 的离散时间形式化,一个MDP通常由五元组 ( S , A , P , R , γ ) (S, A, P, R, \gamma) (S,A,P,R,γ)定义,参数与Env中的成员一一对应
| 参数 | 说明 | 成员或方法 |
|---|---|---|
| S S S | 状态空间(State Space) | observation_space |
| A A A | 动作空间(Action Space) | action_space |
| ( P , R ) (P,R) (P,R) | 状态转移和奖励 | step(action) |
其中,step执行动作 a t a_t at后,环境根据转移概率 P ( s t + 1 ∣ s t , a t ) P(s_{t+1}\vert s_t, a_t) P(st+1∣st,at)采样出下一状态,并计算奖励 R ( s t , a t ) R(s_t, a_t) R(st,at)。