作者 :昇腾实战派
知识地图:https://blog.csdn.net/Lumos_Lovegood/article/details/161601003
背景概述
在大语言模型的后训练阶段,如何高效利用教师模型的知识来提升学生模型性能,是一个核心挑战。传统强化学习(RL)信号稀疏,监督微调(SFT)存在分布偏移问题。On-Policy Distillation(OPD)结合两者优势:让学生从自身分布采样轨迹,同时由教师提供逐 token 的密集反馈,从而在避免分布偏移的同时大幅提升信号密度。
本文从原理、变体到工程实现,系统解析 OPD 的设计思路与落地细节。
昇腾平台当前已支持On-Policy Distillation后训练
1. 后训练三种路线的对比
训练一个强大的语言模型,后训练阶段通常面临三条路:
- 纯 RL(Reinforcement Learning):让模型自己生成轨迹,对完整序列打一个结果奖励(sparse reward),用 PPO 或 GRPO 更新参数。DeepSeek-R1 和 Qwen3 旗舰都涉及此路线。但问题在于信号密度极低------无论一条轨迹有多少 token,总共只得到一个 reward 信号。而 OPD 的信号密度可以为纯 RL 的 50-100 倍。
- Off-Policy 蒸馏(静态数据集蒸馏):用一个强教师模型生成高质量轨迹,收集成静态数据集,对学生做 SFT 或 logit 对齐。这是 DeepSeek-R1-Distill 系列的路线。问题是经典的 exposure bias:学生在测试时生成的 token 序列与训练时接受监督的教师轨迹分布是错位的。一旦学生偏离教师轨迹,后续 token 的监督信号就失真了,泛化能力因此受限。
- On-Policy Distillation:两者取长补短------像 RL 一样,让学生从自己当前的分布采样轨迹(on-policy);像蒸馏一样,由教师模型对每一个采样 token 给出 per-token 的 dense 反馈,具体形式是教师在该 token 上的 log 概率。学生通过最小化与教师之间的 reverse KL 散度来更新:
| Method | Sampling | Reward signal |
|---|---|---|
| Reinforcement learning | on-policy | sparse |
| Supervised finetuning | off-policy | dense |
| On-policy distillation | on-policy | dense |
LOPD(θ)=Ey∼πθlogπθ(y∣x)πteacher(y∣x)=DKL(πθ∣πteacher) \mathcal{L}\text{OPD}(\theta) = \mathbb{E}{y \sim \pi_\theta}\Big log \\frac{\\pi_{\\theta}(y\|x)}{\\pi_{teacher}(y\|x)} \\Big = D_{KL}(\pi_{\theta}|\pi_{teacher}) LOPD(θ)=Ey∼πθlogπteacher(y∣x)πθ(y∣x)=DKL(πθ∣πteacher)
- πθ\pi_\thetaπθ:student;πteacher\pi_{teacher}πteacher:teacher;
- yyy 在更新时被视作固定的(已经采样出来);
- 实际DDD 既可以是"分布级散度",也可以是"单 sample 估计器"(k1/k3 等)。
上述公式的梯度方向,是让学生在自己已经采样出的 token 上,向教师的概率靠近。因为轨迹来自学生自身,不存在 distribution shift;因为教师给出 per-token 信号,每次更新的信息量远超稀疏 RL。OPD 天然具有 unhackable性质:低 KL 总是对应着学生在模仿教师的好行为,不像 RL 的 reward function 可以被模型找到捷径绕过。
2. OPD的两种形式
2.1 Forward KL 和 Reverse KL
Reverse KL: DKL(πθ∣πteacher)D_{KL}(\pi_{\theta}|\pi_{teacher})DKL(πθ∣πteacher)
Forward KL: DKL(πteacher∣πθ)D_{KL}(\pi_{teacher}|\pi_{\theta})DKL(πteacher∣πθ)
| forward KL ∑vν(v)logν(v)πθ(v){\sum_v \nu(v) \log\frac{\nu(v)}{\pi_\theta(v)}}∑vν(v)logπθ(v)ν(v) | reverse KL ∑vπθ(v)logπθ(v)ν(v){\sum_v \pi_\theta(v) \log\frac{\pi_\theta(v)}{\nu(v)}}∑vπθ(v)logν(v)πθ(v) | |
|---|---|---|
| 权重分布 | teacher ν\nuν | student πθ\pi_\thetaπθ |
| 自然的 top-k 截断方式 | teacher 的 top-k(权重大的位置) | student 的 top-k(权重大的位置) |
| 实现可行性 | ✅ teacher server 主动告诉你它的 top-k 就够 | ❌ 需要 student 先选 top-k,再反过来问 teacher 在这些 id 上的 logprob --- API 不支持 |
选择 reverse KL 的话。Reverse KL 具有 mode-seeking 性质:当学生概率为零的地方,KL 项也为零,梯度消失;因此学生会集中学习教师的某一个高概率 " 模式 ",而不是平均覆盖教师所有可能的输出。
这对推理任务很合适。数学推理题有正确解题路径,不需要模型均匀地模仿所有可能的推导风格。Mode-seeking 的 OPD 让学生 " 找到一条教师认可的路并坚定地走下去 ",比 forward KL(试图覆盖教师所有输出)的效果更好。
forward KL 的好处在于:截断哪些 token 由 teacher 自己说了算,teacher infer server 可以直接把这些信息附带返回。
reverse KL 的痛点在于:截断哪些 token 应该由 student 说了算,但 student 在训练 GPU 上,teacher 在另一个推理池里,跨进程 没有"按 id 查 logprob"的接口。
"current inference servers ... do not support gathering log-probabilities at arbitrary token IDs"。
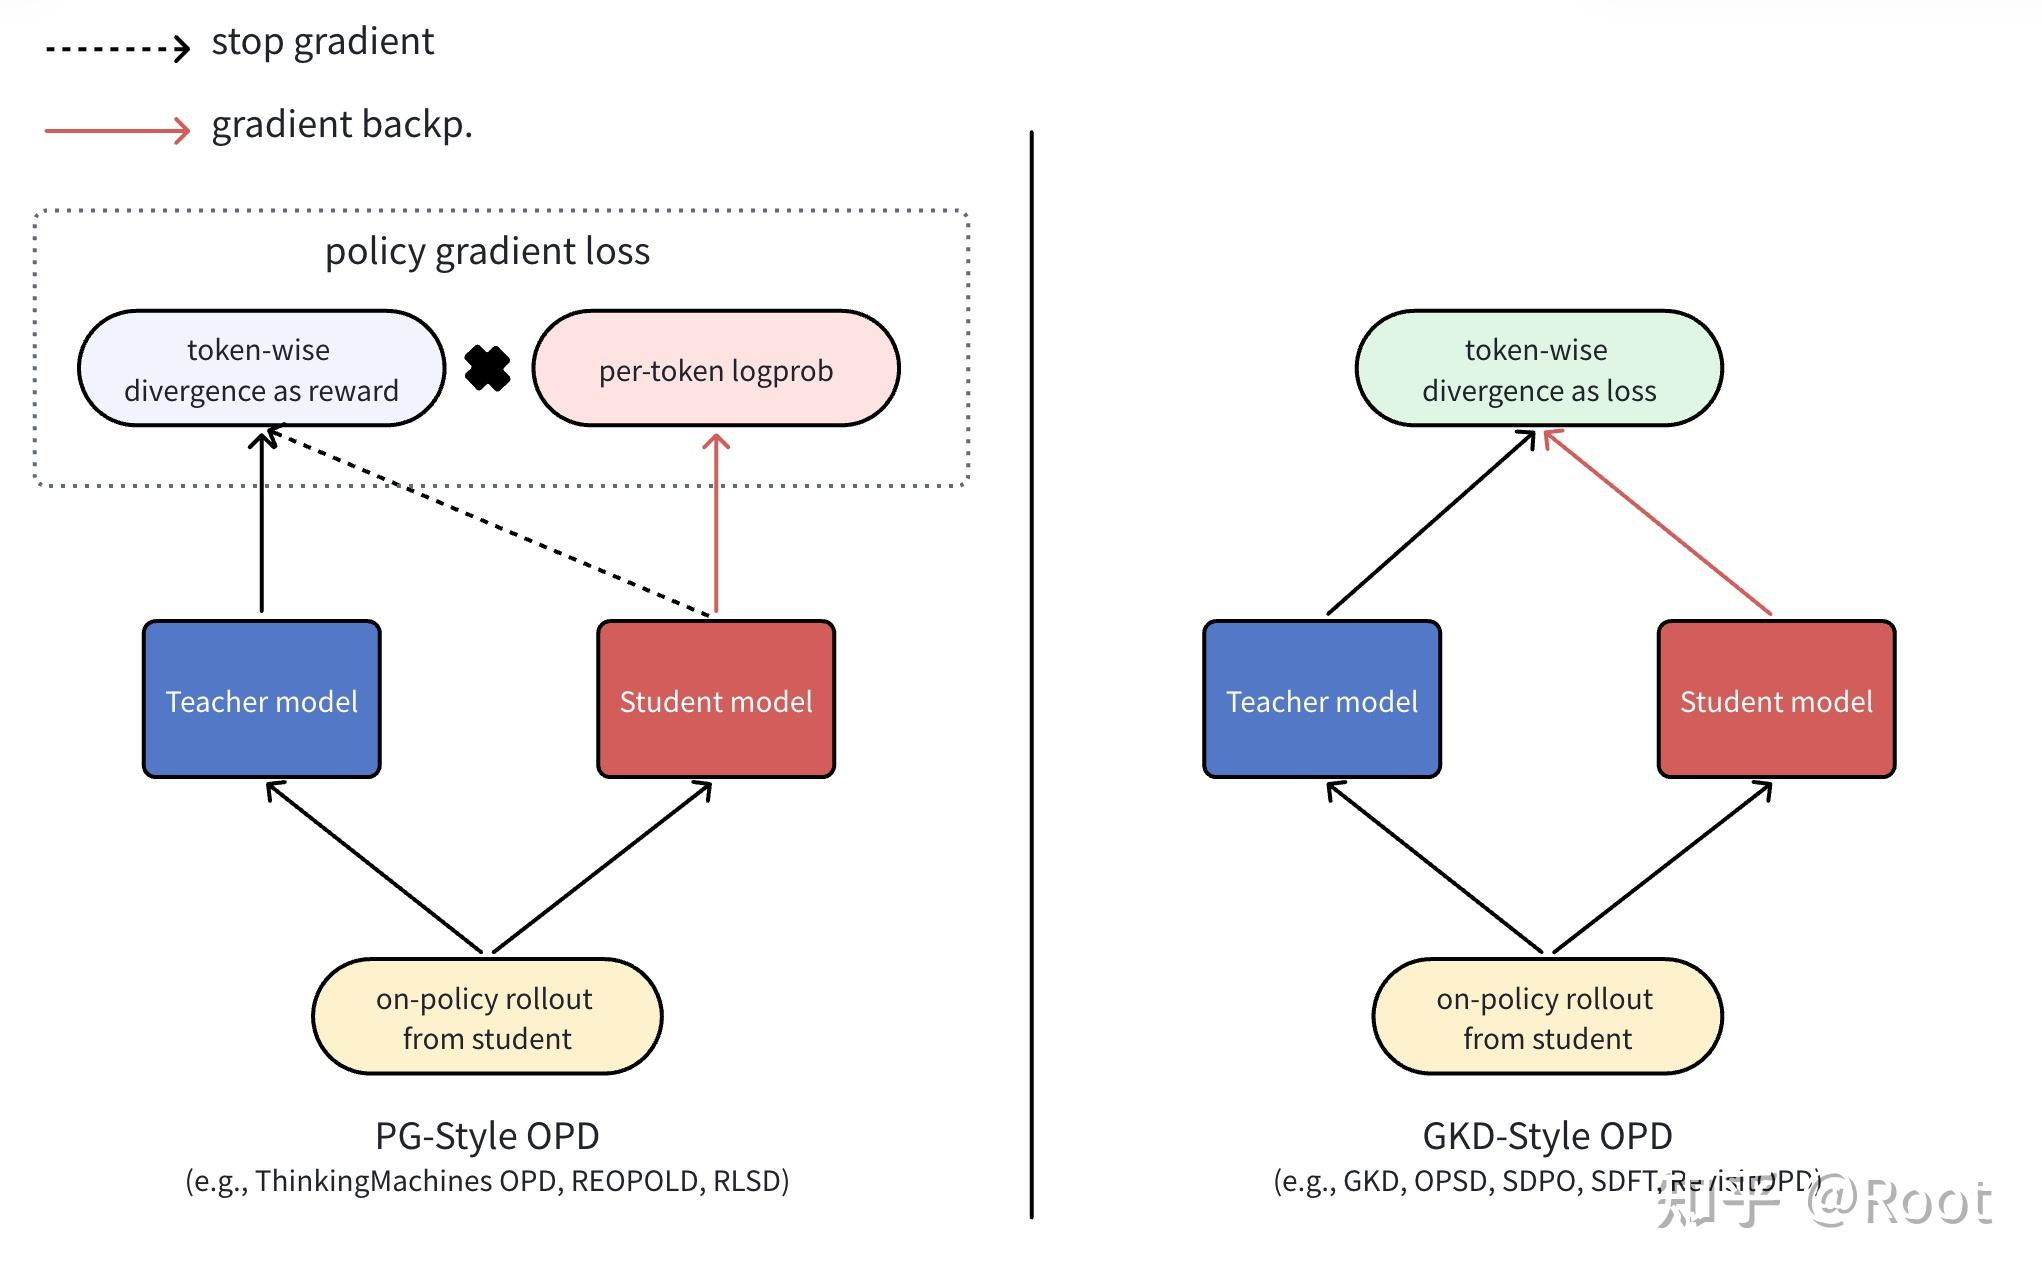
2.2 变体一:GKD OPD(top-k forward KL)
D=∑v∈Vν(v∣st) logν(v∣st)πθ(v∣st) D = \sum_{v \in V} \nu(v|s_t)\,\log\frac{\nu(v|s_t)}{\pi_\theta(v|s_t)} D=v∈V∑ν(v∣st)logπθ(v∣st)ν(v∣st)
工程上 inference server 只能返回 teacher 的 top-k logprob ,所以实际做的是 teacher top-k 截断的 forward KL:
LGKD(k)(st)=∑v∈TopK(ν(⋅∣st))ν(v∣st)logν(v∣st)−logπθ(v∣st) \mathcal{L}^{(k)}\text{GKD}(s_t) = \sum{v \in \text{TopK}(\nu(\cdot|s_t))} \nu(v|s_t)\big\\log\\nu(v\|s_t) - \\log\\pi_\\theta(v\|s_t)\\big LGKD(k)(st)=v∈TopK(ν(⋅∣st))∑ν(v∣st)logν(v∣st)−logπθ(v∣st)
特点:用 teacher 的分布做监督,直接作为 loss 反传梯度 。对应 loss_mode=forward_kl_topk + use_policy_gradient=False。
2.3 变体二:PG OPD(reverse KL + policy gradient)
reverse KL:
KL(πθ∥ν)=Eyt∼πθlogπθ(yt∣st)−logν(yt∣st) \mathrm{KL}(\pi_\theta\|\nu) = \mathbb{E}{y_t \sim \pi\theta}\\log\\pi_\\theta(y_t\|s_t) - \\log\\nu(y_t\|s_t) KL(πθ∥ν)=Eyt∼πθlogπθ(yt∣st)−logν(yt∣st)
因为 yty_tyt 是从 student 自己采的,可以直接做 single-sample 蒙特卡洛估计(即 k1 sample-level估计,可以作为单独议题):
D^tk1=sg(logπθ(yt∣st)−logν(yt∣st)) \hat D_t^\text{k1} = \mathrm{sg}\big(\log\pi_\theta(y_t|s_t) - \log\nu(y_t|s_t)\big) D^tk1=sg(logπθ(yt∣st)−logν(yt∣st))
把 −D^tk1-\hat D_t^\text{k1}−D^tk1 当作 token reward,套用 PPO clipped objective 更新。注意必须 stop-gradient,否则梯度传递会有问题(后文有稍微展开介绍)。
下附 verl 提供的KL计算single-sample估计方法:
| 名称 | 公式 | 备注 |
|---|---|---|
k1 / kl |
logp−logq\log p - \log qlogp−logq | 无偏,但方差大且可能为负 |
abs |
∣logp−logq∣\lvert \log p - \log q\rvert∣logp−logq∣ | 简单粗暴 |
k2 / mse |
12(logp−logq)2\tfrac12(\log p - \log q)^221(logp−logq)2 | 总为正、低方差,但有偏 |
k3 / low_var_kl |
(q/p−1)−(logq−logp)(q/p - 1) - (\log q - \log p)(q/p−1)−(logq−logp) ≈ er−r−1e^{r}-r-1er−r−1 | 总为正、低方差、几乎无偏 |
2.4 vLLM 推理引擎返回结果(为什么只返回 Top-K 信息)
参考 verl/experimental/teacher_loop/teacher_manager.py:30 构造的请求:
python
def _get_teacher_sampling_params(teacher_model_config, distillation_loss_config):
    num_logprobs = distillation_loss_config.topk if distillation_loss_config.loss_settings.use_topk else 0
    return {
        "max_tokens": 1,
        "temperature": teacher_model_config.inference.temperature,
        "prompt_logprobs": num_logprobs,   # ← 只能传 int(top 多少)
    }
prompt_logprobs 是 vLLM 对输入 prompt 上每个位置做一次 forward,然后返回这个位置上的概率信息。
具体到 prompt_logprobs 这个 int 参数的语义:
| 取值 | 每个位置返回 |
|---|---|
None |
啥都不返回 |
0 |
只返回那个 prompt 位置上实际坐着的 token 的 logprob(dict 里只有 1 条 entry) |
K (>0) |
返回 teacher 自认为 top-K 的候选 + 它们的 logprob;如果实际 prompt token 不在 top-K 里,会额外塞一条(dict 长度 K 或 K+1) |
3. 工程实现(OPD GD)
参考verl PR 5041细拆。PG OPD 复用 PPO 的实质就一句话:把 reverse-KL 的逐 token 估计取负,塞到 PPO 的 advantages 那一格,剩下的 importance ratio、clip、dual-clip 全部按 PPO 跑就行。下面按调用栈一层一层剥开。
3.1 调用入口:把"蒸馏 loss"替换成"advantage"
verl/trainer/distillation/losses.py:257 的 distillation_loss 函数,use_policy_gradient=True 分支:
python
if loss_config.use_policy_gradient:
    # Use negative distillation loss as reward, as done by
    # https://thinkingmachines.ai/blog/on-policy-distillation/
    policy_loss_fn = get_policy_loss_fn(loss_config.policy_loss_mode)   # "vanilla" → compute_policy_loss_vanilla
    for k, v in config.global_batch_info.items():
        loss_config.global_batch_info[k] = v

    log_prob     = no_padding_2_padding(model_output["log_probs"], data)   # ← 当前 student 的 log π_new(y_t|s_t)
    old_log_prob = data["old_log_probs"]                                   # ← rollout 时的 log π_old(y_t|s_t)
    ...

    distillation_loss, pg_metrics = policy_loss_fn(
        old_log_prob   = old_log_prob,
        log_prob       = log_prob,
        advantages     = -distillation_losses.detach(),                    # ★ 关键这一行
        response_mask  = response_mask,
        loss_agg_mode  = loss_agg_mode,
        config         = loss_config,
        rollout_is_weights = rollout_is_weights,
    )
三个核心参数怎么落到 PG OPD 上:
| PPO 视角的字段 | PG OPD 的实际内容 | 形状 |
|---|---|---|
old_log_prob |
logπθold(yt∣st)\log\pi_{\theta_\text{old}}(y_t \mid s_t)logπθold(yt∣st),rollout 时记录的 student logprob | (B, T) |
log_prob |
logπθ(yt∣st)\log\pi_\theta(y_t \mid s_t)logπθ(yt∣st),当前这个 minibatch 训练时的 student forward | (B, T) |
advantages |
−D^t=logν(yt∣st)−logπθ(yt∣st)-\hat D_t = \log\nu(y_t \mid s_t) - \log\pi_\theta(y_t \mid s_t)−D^t=logν(yt∣st)−logπθ(yt∣st),detach | (B, T) |
distillation_losses 是上一步 compute_distillation_loss_reverse_kl_estimator 算出来的,本质就是 kl_penalty(student_log_probs, teacher_log_probs, "k1") = logπθ−logν\log\pi_\theta - \log\nulogπθ−logν。取负号 + detach 之后正好是 token-level 的 advantage。
3.2 "取负 + detach"
你可以把 PG OPD 看成一个**"每个 token 都给一份 reward"的 GRPO**。GRPO 里普通 task reward 的处理路径:
rollout 出 y₁...y_T → 计算每 token reward → GAE/group-norm → advantages → PPO clipped lossPG OPD 把中间换掉:
rollout 出 y₁...y_T → teacher 算 log ν(y_t|s_t) →
    r_t = log ν(y_t|s_t) - log π_θ(y_t|s_t)   ← 就是 -k1 reverse KL 估计
                        ↓
              直接当 advantage(不走 GAE,按 token 用)
                        ↓
PPO clipped objective- 取负 (
-distillation_losses):因为 distillation loss 是要"最小化"的散度,所以"做得越好 D̂_t 越小、负号之后 advantage 越大",跟 PPO 里 reward 越大 advantage 越大对齐。 - detach (
.detach()) :这一步对应 OPD 公式里的 stop-gradient sg(⋅)\mathrm{sg}(\cdot)sg(⋅)。如果不 detach,PyTorch 会把 advantage 里的 −logπθ(yt∣st)-\log\pi_\theta(y_t|s_t)−logπθ(yt∣st) 也算进梯度,那 PPO loss 关于 logπθ\log\pi_\thetalogπθ 的梯度就变成 −At∇logπθ−ratio⋅∇logπθ-A_t\nabla\log\pi_\theta - \mathrm{ratio}\cdot\nabla\log\pi_\theta−At∇logπθ−ratio⋅∇logπθ 这种乱七八糟的东西------teacher 信号被淹没。detach 之后 advantage 被当作纯常数,梯度只能从log_prob那一路流出来,正好对应 policy gradient 的标准形式:
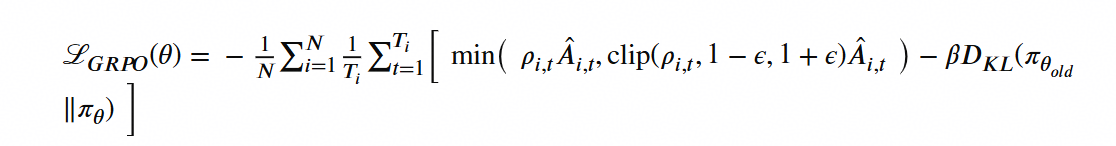
∇θLPG-OPD=−Eratio∗t⋅(−D\^t)⋅∇θlogπθ(yt∣st) \nabla_\theta\mathcal L_\text{PG-OPD} = -\mathbb{E}\big\\mathrm{ratio}\*t\\cdot(-\\hat D_t)\\cdot\\nabla_\\theta\\log\\pi_\\theta(y_t\|s_t)\\big ∇θLPG-OPD=−Eratio∗t⋅(−D\^t)⋅∇θlogπθ(yt∣st)
总结
On-Policy Distillation 通过结合 on-policy 采样与 dense 教师信号,有效解决了纯 RL 信号稀疏和 Off-Policy 蒸馏分布偏移的问题。本文从理论对比出发,详细介绍了 Forward KL 与 Reverse KL 两种形式及其工程变体(GKD OPD 和 PG OPD),并深入剖析了 PG OPD 在 verl 框架中的实现细节,包括如何将 reverse KL 估计转化为 PPO 的 advantage 以及 stop-gradient 的关键作用。理解这些原理与实现,有助于在实际训练中更灵活地选择和应用 OPD 方法。