前言
- 上一期我们借助开源项目
rsl_rl,从单轮step到完整训练完全解构了整个PPO算法的流程。 - 恰逢最近有个开源项目MicroDuck很火,本系列我们来借助这个项目,浅浅入门一下PPO如何运用到一个简单机器人上。
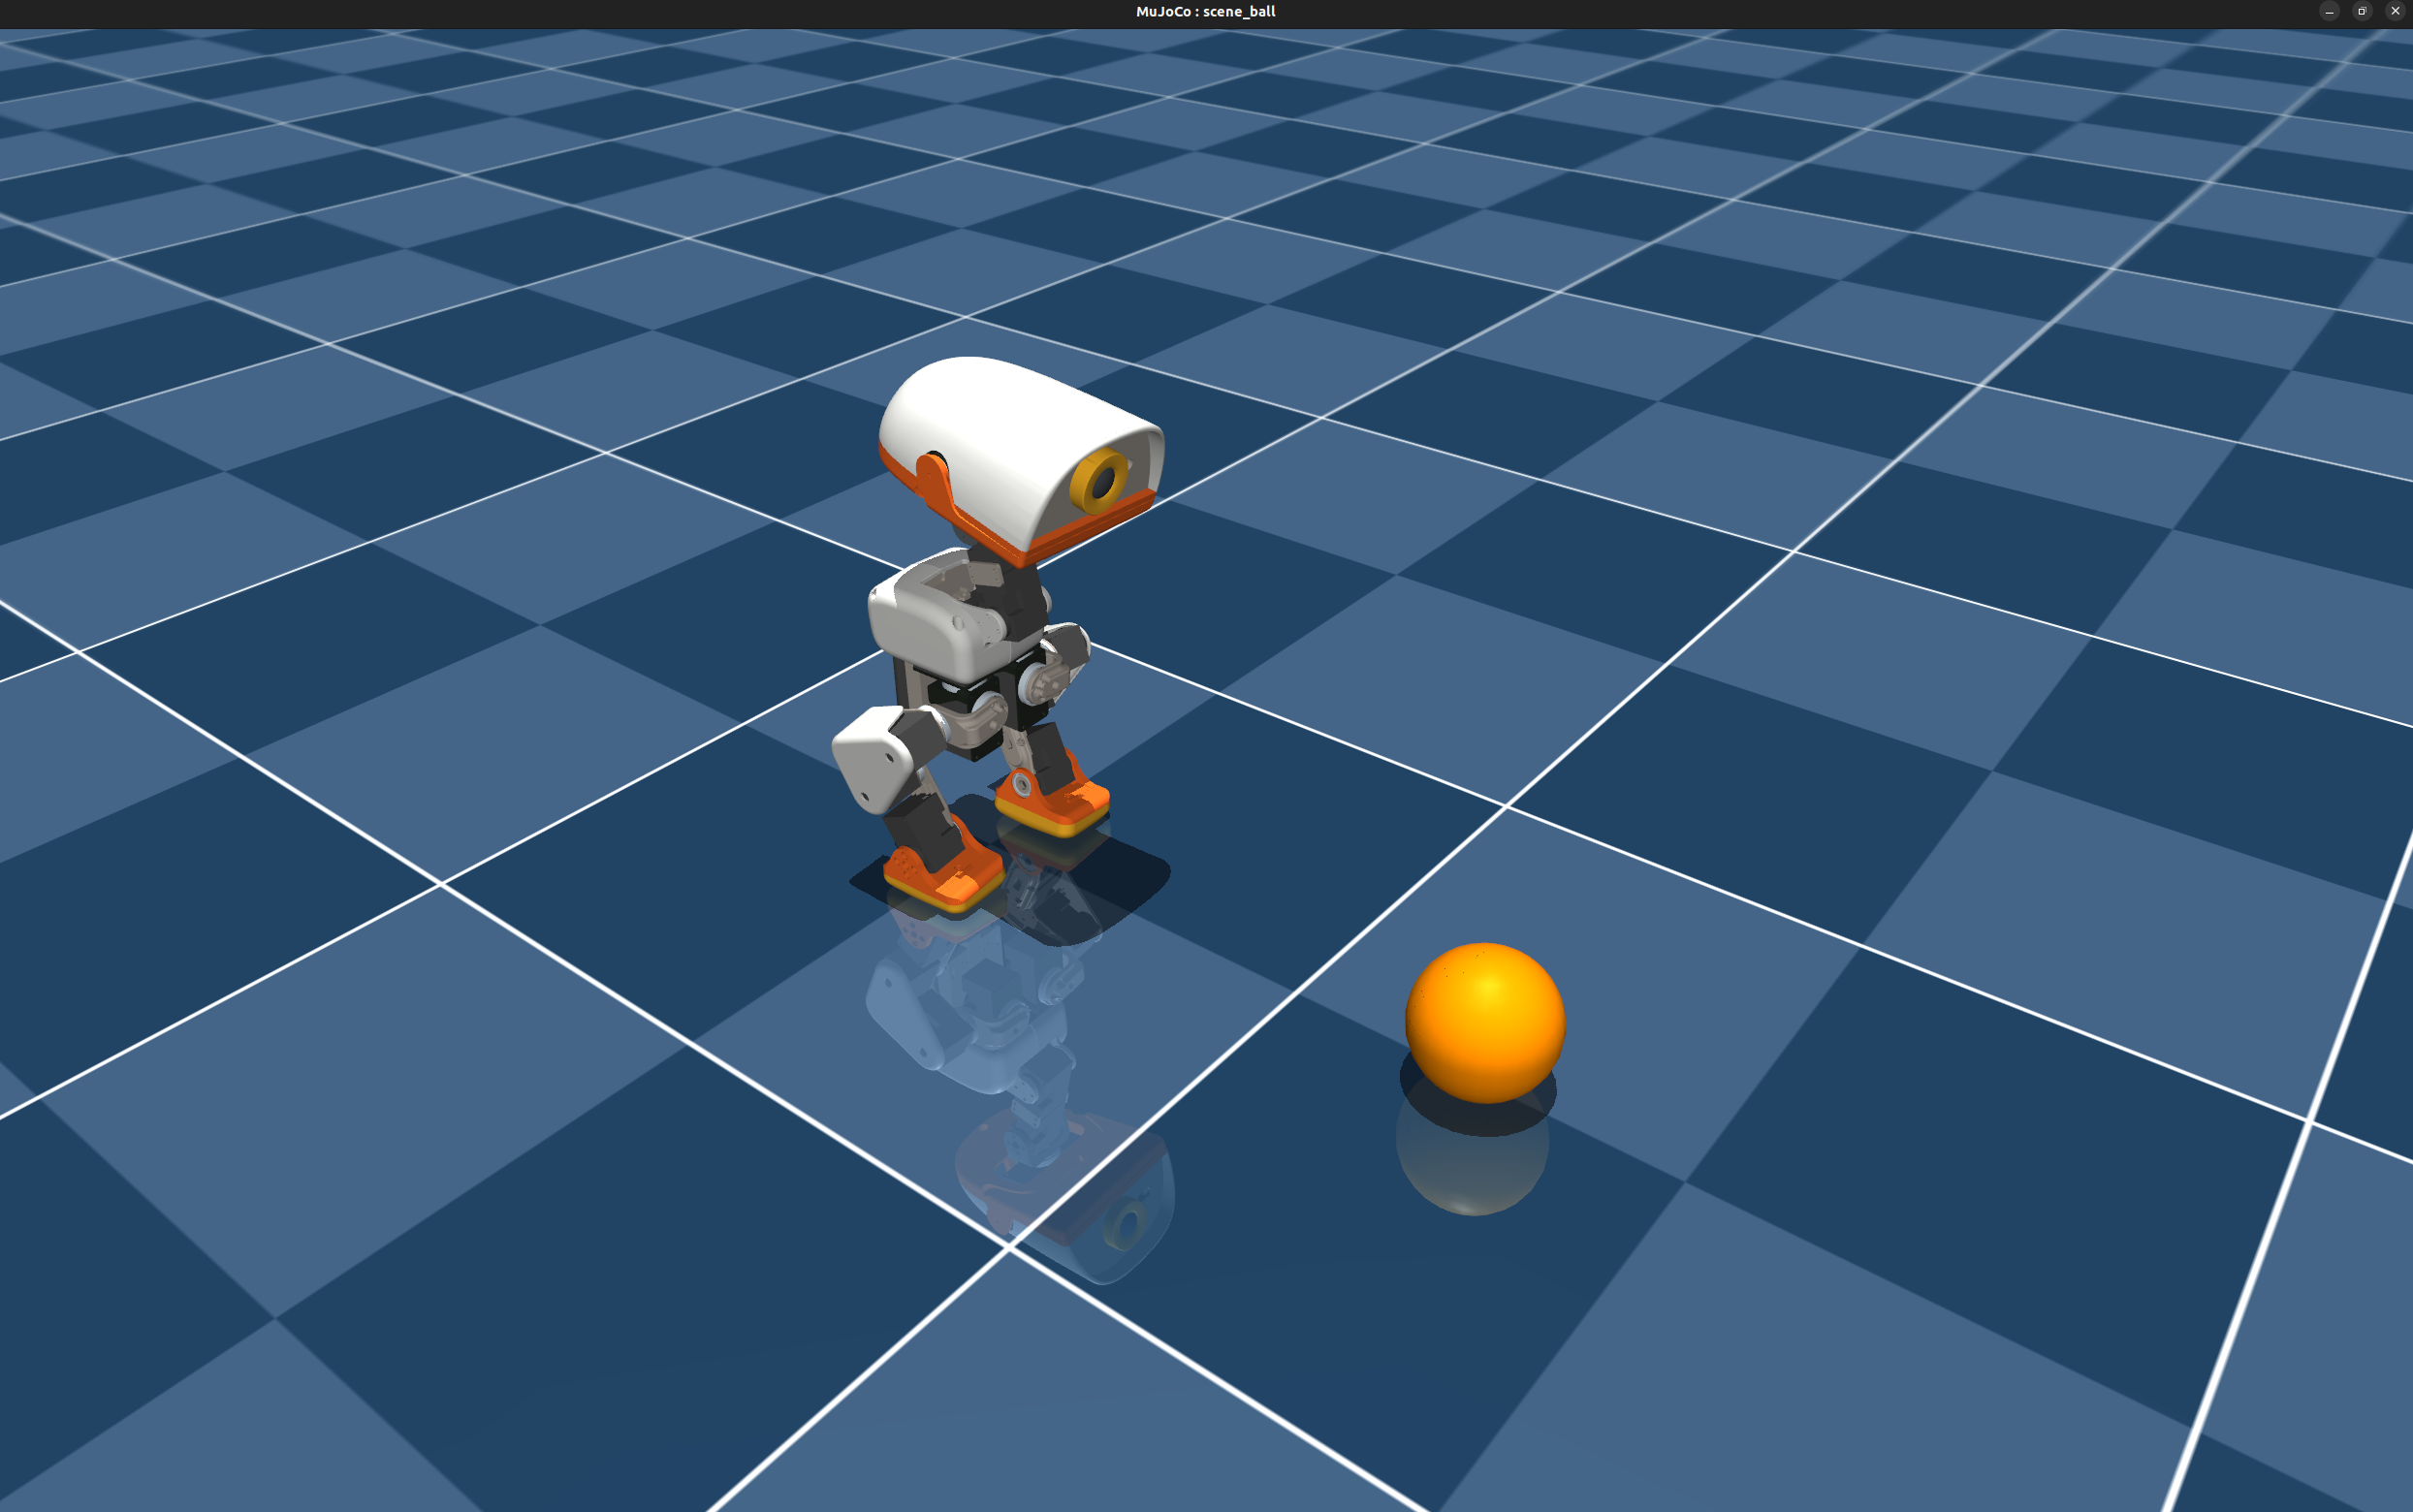
- 本期我们将简单入门MicroDuck机器人,同时解读其对应的PPO的核心算法中的几个重要部分。
文章目录
-
- 前言
- [1 MicroDuck](#1 MicroDuck)
-
-
- [1-1 介绍](#1-1 介绍)
- [1-2 硬件描述](#1-2 硬件描述)
-
- [1-2-1 关节模块](#1-2-1 关节模块)
- [1-2-2 感知模块](#1-2-2 感知模块)
- [1-3 目前开源的硬件和软件方案](#1-3 目前开源的硬件和软件方案)
-
- [1-3-1 软件](#1-3-1 软件)
- [1-3-2 硬件](#1-3-2 硬件)
- [1-4 安装部署](#1-4 安装部署)
- [1-5 测试](#1-5 测试)
-
- [2 项目整体分析](#2 项目整体分析)
-
-
- [2-1 整体分析](#2-1 整体分析)
- [2-2 src](#2-2 src)
- [2-3 scripts](#2-3 scripts)
- [2-4 policies](#2-4 policies)
-
- [3 MicroDuck的PPO](#3 MicroDuck的PPO)
-
-
- [3-1 介绍](#3-1 介绍)
- [3-2 Task](#3-2 Task)
-
- [3-2-1 理解Task](#3-2-1 理解Task)
- [3-2-2 公用MDP零件库](#3-2-2 公用MDP零件库)
- [3-2-3 任务切换](#3-2-3 任务切换)
- [3-3 Command](#3-3 Command)
-
- [3-3-1 介绍](#3-3-1 介绍)
- [3-3-2 分类](#3-3-2 分类)
- [3-3-2-1 第一类:占位类](#3-3-2-1 第一类:占位类)
- [3-3-2-2 第二类:相位类](#3-3-2-2 第二类:相位类)
- [3-3-2-3 第三类:状态标志类](#3-3-2-3 第三类:状态标志类)
- [3-3-2-4 第四类:速度类](#3-3-2-4 第四类:速度类)
- [3-3-2-5 第五类:其他](#3-3-2-5 第五类:其他)
- [3-3-3 Command流程](#3-3-3 Command流程)
- [3-4 Observation](#3-4 Observation)
-
- [3-4-1 介绍](#3-4-1 介绍)
- [3-4-2 非对称 actor-critic](#3-4-2 非对称 actor-critic)
- [3-4-3 Actor观测-61D](#3-4-3 Actor观测-61D)
- [3-4-4 Critic观测-76D](#3-4-4 Critic观测-76D)
- [3-4-5 网络结构](#3-4-5 网络结构)
- [3-5 Action-14D](#3-5 Action-14D)
- [3-6 Reward](#3-6 Reward)
-
- [3-6-1 总览](#3-6-1 总览)
- [3-6-2 Command Tracking](#3-6-2 Command Tracking)
- [3-6-3 `foot_air_time`](#3-6-3
foot_air_time) - [3-6-4 姿态稳定 Reward](#3-6-4 姿态稳定 Reward)
- [3-6-5 Action Rate](#3-6-5 Action Rate)
- [3-6-6 Joint / Torque Limit](#3-6-6 Joint / Torque Limit)
- [3-6-7 Termination / Alive](#3-6-7 Termination / Alive)
- [3-6-8 官方建议](#3-6-8 官方建议)
- [3-7 PPO的完整流程](#3-7 PPO的完整流程)
-
- [3-7-1 一次迭代的全链路](#3-7-1 一次迭代的全链路)
- [3-7-2 三个时间尺度](#3-7-2 三个时间尺度)
- [3-7-3 配置文件](#3-7-3 配置文件)
- [3-7-4 前文各节与配置的对应](#3-7-4 前文各节与配置的对应)
-
- 总结
1 MicroDuck
1-1 介绍
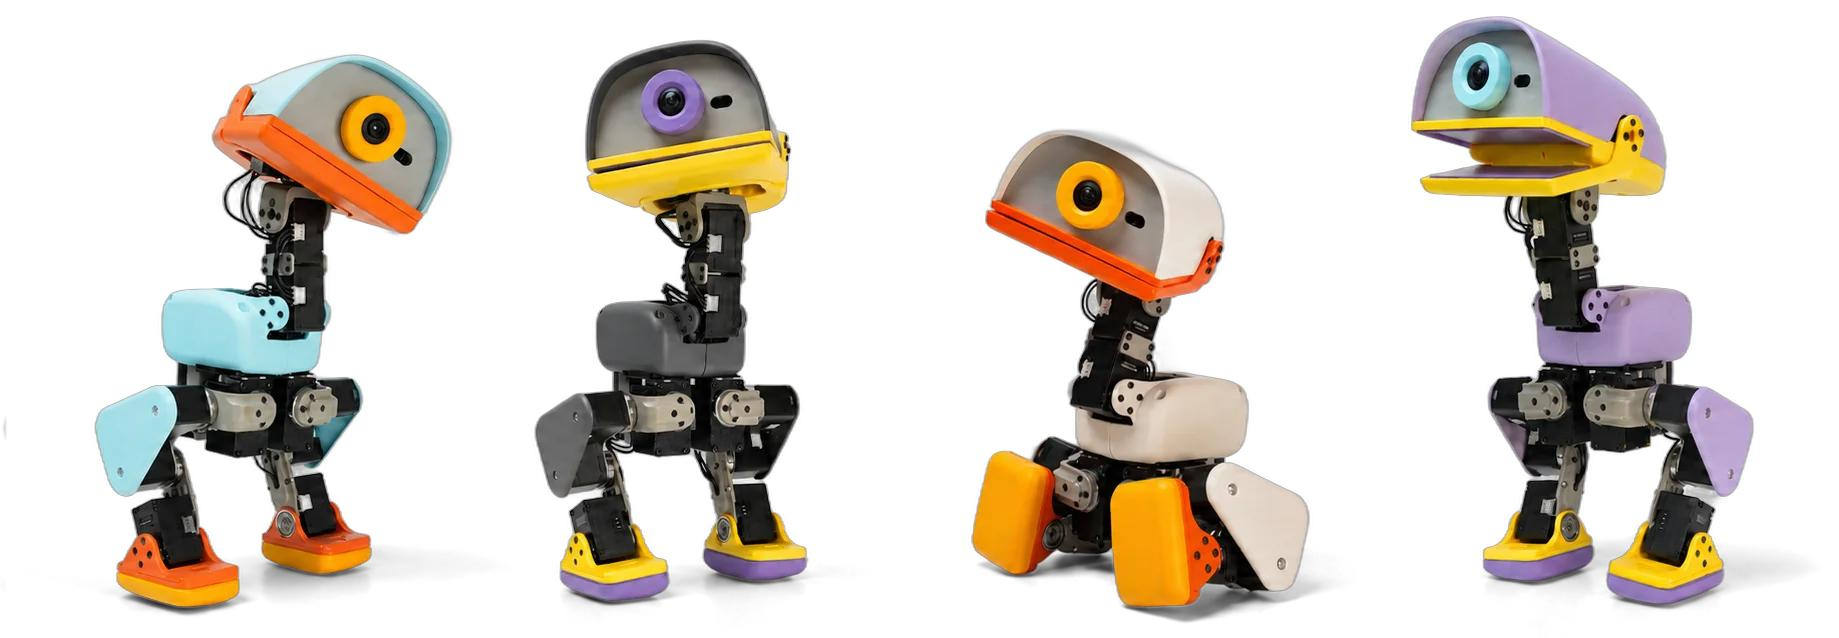
- MicroDuck 是一个开源的小型双足机器人 ,由 Pollen Robotics 推出,定位不是工业机器人,而是一个用于 机器人学习、强化学习、Physical AI 和开发者实验的平台。
- 官网链接:https://pollen-robotics.com/microduck/blog/introducing-microduck/
1-2 硬件描述
1-2-1 关节模块
- MicroDuck 采用双足机器人结构,共包含 15 个关节,其中 14 个为电机驱动关节,分别分布于左右腿以及颈部/头部;另有 1 个嘴部关节。RL(Reinforcement Learning,强化学习)策略实际控制 14 个舵机,因此策略的 Action 维度为 14。
txt
左腿:5
├─ hip_yaw
├─ hip_roll
├─ hip_pitch
├─ knee
└─ ankle

颈部/头部:4
├─ neck_pitch
├─ head_pitch
├─ head_yaw
└─ head_roll

右腿:5
├─ hip_yaw
├─ hip_roll
├─ hip_pitch
├─ knee
└─ ankle

总计:14 个电机驱动关节- 特别注意:当前 MicroDuck 的机器人模型代码仍定义了 15 个 joint/motor slot ,但 RL 策略的
action是 14 维,其中嘴部关节不参与策略控制。 - 对应的说明原文如下:
txt
- **Joint layout** (14 servos, ctrl idx = joint idx on walk/groundcontact
  models): 0--4 left leg (hip_yaw, hip_roll, hip_pitch, knee, ankle), 5--8
  neck/head (neck_pitch, head_pitch, head_yaw, head_roll), 9--13 right leg.
  On roller/backlash models, passive joints INTERLEAVE --- never hardcode joint
  indices in mdp functions; use the `_servo_joint_ids` / `_servo_joint_pos`
  helpers in mdp.py (identity on plain models, correct everywhere else).
1-2-2 感知模块
- 目前官方资料显示 MicroDuck 配备:
- Camera:头部摄像头
- LiDAR(Light Detection and Ranging,激光雷达)/ ToF(Time of Flight,飞行时间)深度传感器 :官方产品页称为 LiDAR,源码中对应
tofd,提供 8×8 深度矩阵 - 2 个 IMU(Inertial Measurement Unit,惯性测量单元):身体和头部各一个
- 麦克风、扬声器等交互传感器
- 但是需要注意的是,当前软件仓库里的算法仍采用的是典型的本体感觉运动控制策略(proprioceptive locomotion policy),也就是说没有通过感知外部环境来进行 RL。
1-3 目前开源的硬件和软件方案
1-3-1 软件
- 软件方面,可以直接参考 Pollen Robotics 官方开源项目。目前官方已经公开了 MicroDuck 的机器人运行软件和强化学习训练环境,因此从仿真训练到实际部署的完整软件链路都有较好的参考价值。
- 官方强化学习仓库:pollen-robotics/microduck_rl
- 基于 MuJoCo / mjlab 构建训练环境;
- 使用 PPO 训练策略;
- 包含 MicroDuck 的 MJCF 模型和相关 STL 几何资源;
- 包含 Command、Observation、Reward、Domain Randomization 等完整 RL 任务配置;
- 训练得到的策略可以导出为 ONNX,再由官方机器人运行时加载到真实机器人上。
- 官方机器人运行时仓库:pollen-robotics/microduck
- 主要负责真实机器人上的策略推理、控制循环、舵机通信以及其他机器人功能;
- 因此如果希望进一步研究 "训练好的 RL Policy 是如何真正部署到机器人上的",这个仓库同样非常值得阅读。
1-3-2 硬件
- 硬件方面,需要注意的是,MicroDuck 的硬件并不是"完全不开源",而是不同部分的开放程度不同 。
- 官方已经公开了
RPI_Robot_HAT的 KiCad 工程以及 Gerber、BOM、贴片坐标等生产资料; - 但
imu_to_dxl电路板、完整的可编辑机械 CAD、整机 BOM 和完整装配文档等仍没有由官方完整公开。
- 官方已经公开了
- 如果希望自己尝试复刻 MicroDuck,可以参考第三方项目:
- fanhao375/microduck-replica
- 该项目通过分析官方公开的 MJCF 模型、STL 模型以及 Rust 运行时源码,对 MicroDuck 的机械结构和电子系统进行了逆向整理;
- 项目提供了装配关系、爆炸图、CAD 装配体以及电控方案等资料,对于理解 MicroDuck 的硬件结构与软件之间如何对应非常有参考价值。
1-4 安装部署
- 官方仓库的 README 已经给出了 Quickstart,这里我们结合本机的实际踩坑,把"从零到能跑通"整理一遍
- 环境要求一共三条:
- 训练阶段需要一块支持 CUDA 的 NVIDIA 显卡,因为仿真是跑在 MuJoCo Warp 上的;只做下一节的推理测试则不需要,那部分是 CPU MuJoCo
- Python 3.12,工程在
pyproject.toml里把版本卡死在>=3.12, <3.13,原因是执行器模型bam依赖的上界是 3.13 - 包管理器
uv,官方用它来管理虚拟环境与依赖
- 先拉取源码:
bash
git clone https://github.com/pollen-robotics/microduck_rl
cd microduck_rl- 然后同步依赖:
bash
uv sync- 第一次
uv sync会下载约 2 GB 的 CUDA 相关 wheel。如果机器是 ARM 架构(DGX Spark、GB10、Jetson 这一类),uv默认 30 秒的 HTTP 超时经常会在半途中断下载,需要先把超时调大再同步:
bash
export UV_HTTP_TIMEOUT=600
uv sync- 到这里有一个本机踩了很久的坑值得单独说。如果终端里
source过 ROS 2,PYTHONPATH会指向 ROS 自带的那套 Python 3.10 的site-packages,而这个工程的虚拟环境是 Python 3.12。两者一撞,pytest在加载插件阶段就会去 import ROS 的launch包,而它依赖的lark并不在虚拟环境里,于是用例还没开始收集就直接崩掉:
txt
ModuleNotFoundError: No module named 'lark'- 解决办法是在运行前把
PYTHONPATH清掉:
bash
env -u PYTHONPATH uv run ...- 这个前缀不好记,工程里干脆封装了一层
run.sh,把清理动作固定下来,参数原样转发给uv run:
bash
#!/usr/bin/env bash
# 本机 shell 里 source 了 ROS 2 Humble,PYTHONPATH 指向 python3.10,与本 venv 的 3.12 冲突
export PATH="$HOME/.local/bin:$PATH"
cd "$(dirname "$(readlink -f "${BASH_SOURCE[0]}")")"
exec env -u PYTHONPATH uv run "$@"- 之后的命令统一走它,比如查看任务注册表:
bash
./run.sh list-envs- 这条命令会打印出当前工程注册的全部 RL 任务。能正常输出,就说明环境已经就绪,可以进入下一节的测试
说人话:安装本身不复杂,
uv sync一条命令就够。真正花时间的是两处环境冲突:ARM 机器上第一次下载容易被超时打断,终端里残留的 ROS 环境变量会污染这个 Python 3.12 的虚拟环境。前者把超时调大,后者用run.sh绕开。
1-5 测试
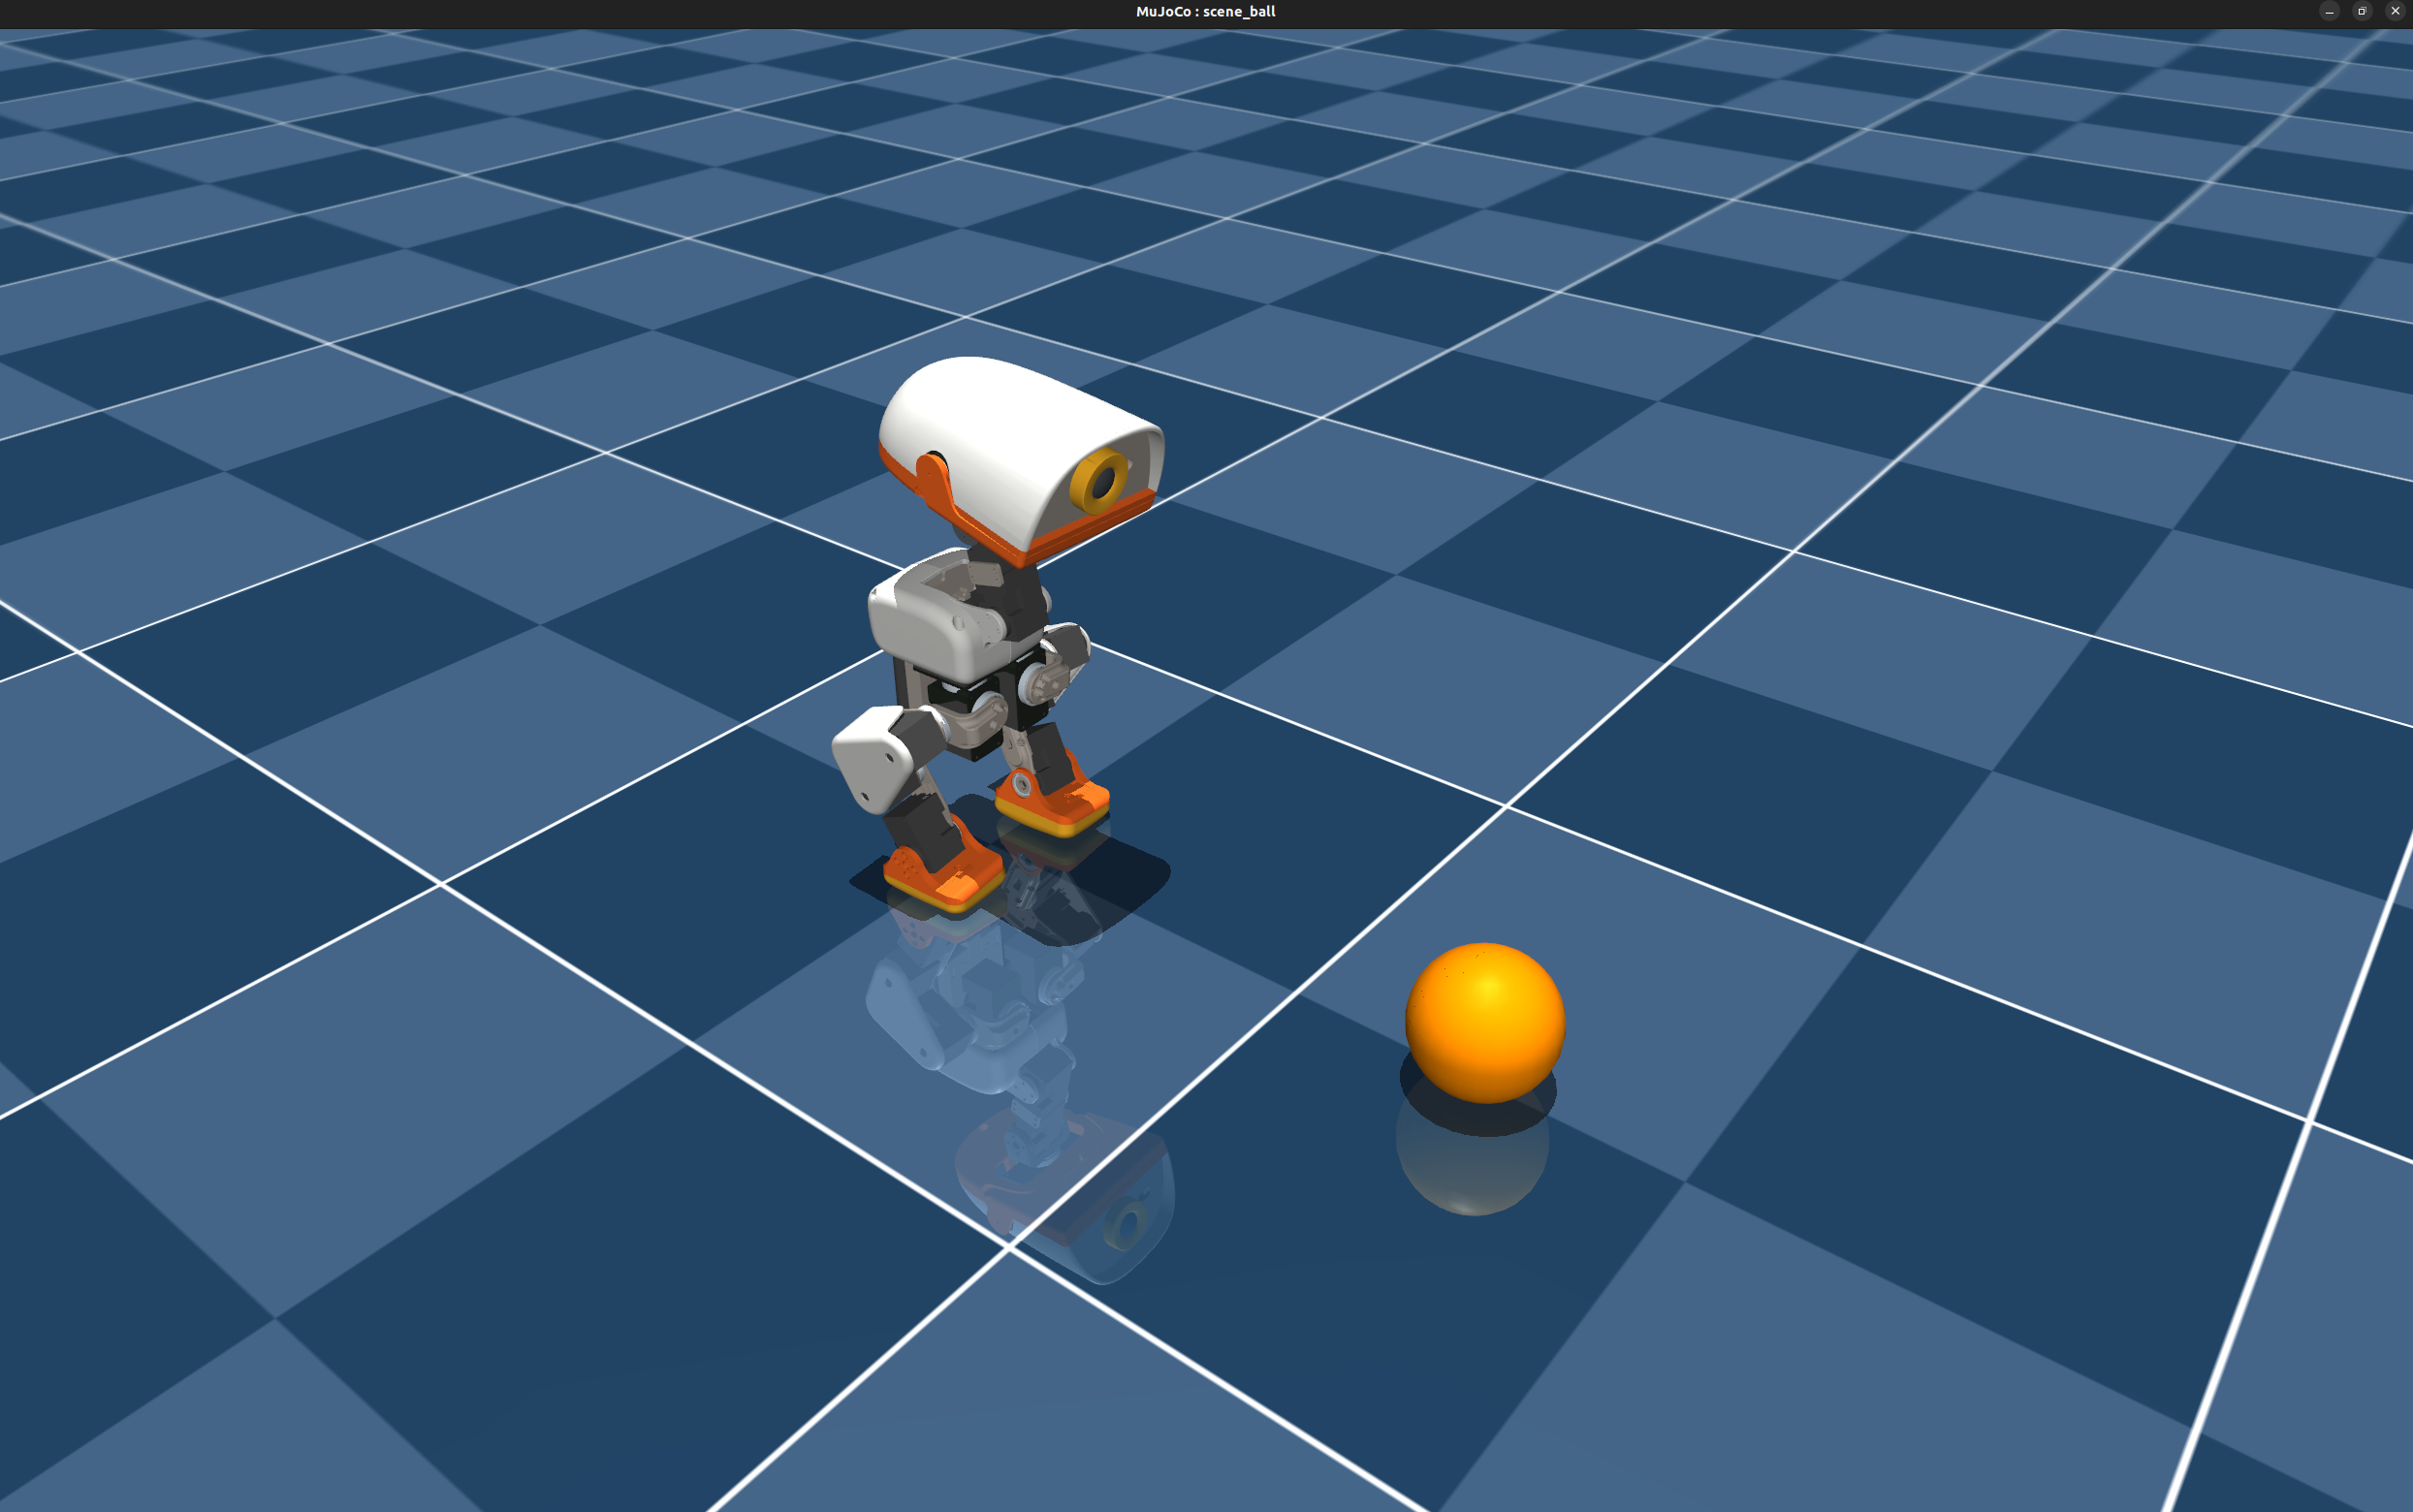
- 下载环境后,我们加载全部的策略
bash
./run.sh scripts/infer_policy.py \
  --walking   policies/velstand.onnx \
  --standing  policies/alpha_stand.onnx \
  --sitstand  policies/alpha_sitstand.onnx \
  --roulade   policies/roulade.onnx \
  --kick-left  policies/ball_kick_left.onnx \
  --kick-right policies/ball_kick_right.onnx \
  --ground-pick policies/alpha_ground_pick.onnx \
--new-cmd-obs- 根据提示,仿真窗口支持以下键盘操作:
txt
Keyboard controls (type in THIS terminal --- the viewer window no longer captures keys):
  [ Velocity mode (default) ]
  UP arrow:         increase lin_vel_x (push/accelerate)
  DOWN arrow:       decrease lin_vel_x (0=coast, negative=brake)
  LEFT/RIGHT arrow: strafe left/right (lin_vel_y)
  A / E:            turn left/right (ang_vel_z)
  SPACE:            coast (zero all commands)
  T:                toggle policy inference on/off (paused = motors hold last target)
  G:                trigger ground pick (requires --ground-pick)
  Y:                toggle sit (with --sit/--sitstand) or slope mode (with --slope)
  K:                kick with LEFT foot (requires --kick-left)
  L:                kick with RIGHT foot (requires --kick-right)
  R:                roulade / forward roll (requires --roulade)
  P:                random push (trunk vel = 1.0 m/s in random direction)
  Q:                quit
  [ Body pose mode --- press B to toggle ]
  UP/DOWN arrow:    Δz ±10mm  (max ±30mm)
  LEFT/RIGHT arrow: Δpitch ±10°  (max ±30°)
  A / E:            Δroll ±10°  (max ±30°)
  Z / S:            Δyaw ±10°  (new_cmd_obs only, max ±30°)
  SPACE:            reset body pose to zero
  [ Head mode --- press H to toggle ]
  Z / S:            neck_pitch ±step
  UP/DOWN arrow:    head_pitch ±step
  LEFT/RIGHT arrow: head_yaw ±step
  A / E:            head_roll ±step
SPACE: reset head offset to zero- 我们可以根据提示遥控鸭子进行任务
2 项目整体分析
2-1 整体分析
- 我们使用
tree命令查看拉取下来的源码结构
txt
└── microduck_rl
    ├── AGENTS.md
    ├── CLAUDE.md
    ├── docs
    ├── LICENSE
    ├── policies
    ├── pyproject.toml
    ├── README.md
    ├── scripts
    ├── src
    ├── tests
└── uv.lock- 核心部分:
policies/:已训练好的策略/ONNX等scripts/:训练、评估、导出等入口脚本src/:核心源码,环境、机器人、PPO等
2-2 src
bash
./src/
└── mjlab_microduck
    ├── actuator
    ├── export.py
    ├── hf_jobs.py
    ├── __init__.py
    ├── publish
    ├── __pycache__
    ├── robot
    ├── sim
    ├── tasks
    ├── train_cli.py
└── train_hook.py- 其中:
actuator/:执行器模型robot/:MicroDuck机器人模型sim/:仿真相关tasks/:RL任务、观测、奖励、命令等train_cli.py:训练入口train_hook.py:训练过程Hookexport.py:Policy 到 ONNXhf_jobs.py:Hugging Face训练任务publish/:发布模型/策略
2-3 scripts
txt
./scripts/
	├── crouch_pose_editor.py
	├── export.py
	├── hf
	├── infer_policy.py
	├── odom_anchor_points.py
	├── odom_anchor_sets.json
	├── play_latest.py
	├── plot_observations_comparison_plotly.py
	├── __pycache__
	├── testbench_sim2real.py
	├── validate_bam_testbench.py
	├── view_slope_terrain.py
└── wandb_utils.py- 其中:
crouch_pose_editor.py:编辑和调整机器人下蹲姿态export.py:将训练好的 Policy 导出为 ONNXhf/:Hugging Face 相关训练与任务脚本infer_policy.py:加载 ONNX Policy 进行策略推理odom_anchor_points.py:里程计锚点相关工具odom_anchor_sets.json:保存里程计锚点集合配置play_latest.py:加载最新训练策略并进行仿真测试plot_observations_comparison_plotly.py:使用 Plotly 对观测数据进行对比可视化testbench_sim2real.py:Sim2Real 测试与验证validate_bam_testbench.py:BAM Testbench 验证view_slope_terrain.py:查看和可视化坡地地形wandb_utils.py:Weights & Biases(W&B)训练日志与实验管理工具
2-4 policies
txt
./policies/
	├── alpha_ground_pick.onnx
	├── alpha_sitstand.onnx
	├── alpha_stand.onnx
	├── alpha_walking.onnx
	├── ball_kick_left.onnx
	├── ball_kick_right.onnx
	├── manifest.json
	├── roller_crouch.onnx
	├── roller.onnx
	├── roulade.onnx
└── velstand.onnx- 其中:
alpha_ground_pick.onnx:地面物体拾取策略alpha_sitstand.onnx:坐下与站立动作策略alpha_stand.onnx:站立策略alpha_walking.onnx:行走策略ball_kick_left.onnx:左脚踢球策略ball_kick_right.onnx:右脚踢球策略manifest.json:策略清单与相关元数据配置roller_crouch.onnx:滚动动作前的下蹲策略roller.onnx:滚动动作策略roulade.onnx:翻滚动作策略velstand.onnx:基于速度指令的站立/行走策略
3 MicroDuck的PPO
3-1 介绍
- 如1-3所说,本文使用的PPO就是
rsl_rl的PPO - 本章我们将从本项目的PPO算法开始,先看看这个环境的PPO是如何运行的
3-2 Task
- 我们展开
task目录
bash
/src/
└── mjlab_microduck
    ├── tasks
    │   ├── backlash.py
    │   ├── distill.py
    │   ├── __init__.py
    │   ├── mdp.py
    │   ├── microduck_ball_kick_env_cfg.py
    │   ├── microduck_ground_pick_env_cfg.py
    │   ├── microduck_roller_crouch_env_cfg.py
    │   ├── microduck_roller_slope_env_cfg.py
    │   ├── microduck_roller_standup_env_cfg.py
    │   ├── microduck_roulade_env_cfg.py
    │   ├── microduck_sitstand_env_cfg.py
    │   ├── microduck_spin_env_cfg.py
    │   ├── microduck_standup_env_cfg.py
    │   ├── microduck_velocity_env_cfg.py
    │   ├── microduck_velocity_rollers_env_cfg.py
    │   ├── microduck_velocity_swizzle_env_cfg.py
    │   ├── microduck_velstand_env_cfg.py
    │   ├── __pycache__
    │   ├── slope_terrain.py
    │   ├── symmetry.py
│ └── testbench_env_cfg.py- 其中:
mdp.py:定义各个 Task 共用的观测、奖励、指令、终止条件等 MDP 函数。microduck_velocity_env_cfg.py:配置基于速度指令的行走 Task。microduck_velstand_env_cfg.py:配置速度控制与站立相关的 Task。microduck_standup_env_cfg.py:配置机器人起立 Task。microduck_sitstand_env_cfg.py:配置坐下与站立切换 Task。microduck_ball_kick_env_cfg.py:配置踢球 Task。microduck_ground_pick_env_cfg.py:配置地面物体拾取 Task。microduck_roulade_env_cfg.py:配置翻滚 Task。microduck_spin_env_cfg.py:配置旋转 Task。
3-2-1 理解Task
- 与我们之前训练的机器人导航任务 不同,MicroDuck 官方将不同的机器人行为拆分为多个独立的 Task,例如行走、站立、坐立切换、踢球、翻滚等。
bash
./policies/
	├── alpha_ground_pick.onnx
	├── alpha_sitstand.onnx
	├── alpha_stand.onnx
	├── alpha_walking.onnx
	├── ball_kick_left.onnx
	├── ball_kick_right.onnx
	├── manifest.json
	├── roller_crouch.onnx
	├── roller.onnx
	├── roulade.onnx
└── velstand.onnx- 这里的 Task 本质上就是强化学习中的"任务定义(Task Definition)",用于规定智能体需要完成什么目标,以及在训练过程中能够获得什么观测、执行什么动作和获得什么奖励。
- 在一个具体的 Task 中,我们会定义机器人的观测空间(Observation)、动作空间(Action)、指令(Command)、奖励函数(Reward)、终止条件(Termination)以及环境重置和随机化方式等内容,从而完整描述一个强化学习问题。
3-2-2 公用MDP零件库
- 为了避免不同Task存在公用的 观测、奖励、终止条件、事件、命令等等,官方采用了类似组件复用 的思路将所有可能用到的 MDP 具体"零件库"统一放在了
/microduck_rl/src/mjlab_microduck/tasks/mdp.py - 函数很长,我们不展开说明,以后我们讲解核心的几个部分。
3-2-3 任务切换
- MicroDuck 中不同 Task 主要通过不同的
*_env_cfg.py配置文件进行区分,而不是通过修改 PPO 算法本身来切换任务。- 每个配置文件会根据任务需求,对 Observation、Action、Command、Reward、Termination、Event 等内容进行组合和配置。
- 因此,当我们切换 Task 时,本质上是更换了一套强化学习环境配置,而 PPO 算法仍然可以保持不变。
说人话:
mdp.py提供公共的 MDP 零件,*_env_cfg.py负责将这些零件组合成具体 Task,而 PPO 则负责学习对应 Task 的策略。
- 关于运行时候切换的代码,我们后面几个章节会具体说明
3-3 Command
3-3-1 介绍
- Command 可以理解为强化学习任务给机器人下达的目标
- 如果你是之前跟着我们的PPO文件你可能会疑惑,这部分内容之前在我们的导航里头并没有出现,这是因为这里我们的MicroDuck需要接受来自外部的指令然后随时调整自己的姿态来达到目标指令,为此我们需要编写对应的训练和奖励函数来达到如下的效果
- 训练时,环境在预先定义的 Command 范围内随机采样目标,使策略学习"不同 Command 对应 Action"的映射;
- 部署时,不再由训练环境随机采样,而是由用户、上层控制器或其他模块提供 Command,模型根据该输入生成对应的 Action。
需要注意的是,Command需要作为观测的一部分输入到网络中,而在MicroDuck中,不同 Task 使用统一的 Observation 结构(下面会解释)
- 所有的 Command 采用统一的接口
c t = c t v e l , c t h e a d , c t b o d y \boxed{ c_t = c_t\^{vel},\\ c_t\^{head},\\ c_t\^{body} } ct=ctvel, cthead, ctbody
- 其中:
- c t v e l ∈ R 3 , c t h e a d ∈ R 4 , c t b o d y ∈ R 6 c_t^{vel}\in\mathbb R^3,\qquad c_t^{head}\in\mathbb R^4,\qquad c_t^{body}\in\mathbb R^6 ctvel∈R3,cthead∈R4,ctbody∈R6
3-3-2 分类
- 在MircoDuck中,代码把不同任务的 Command 归纳成五类:
| Command 编码/语义 | 代表任务 | 含义 |
|---|---|---|
twist ≈ [0,0,0] |
standup、ball_kick、roulade、roller_standup 等 |
不需要外部速度目标,twist 槽位占位 |
[cos(2πφ), sin(2πφ), 0] |
ground_pick、spin、roller_crouch |
相位编码,用 2D 单位圆表示动作阶段 |
[sit_flag, 0, 0] |
sitstand |
离散状态/模式编码,表示 sit 到 stand |
[v_x,v_y,\cdots] |
velocity、velocity_rollers |
速度控制 Command |
velocity_swizzle 等 |
需要单独检查其 twist 的生成方式 |
不能直接归入上面几类 |
- 全部的command使用latex进行描述为(顺序与上表一致):
3-3-2-1 第一类:占位类
- 任务包括:
standup、ball_kick、roulade、roller_standup - 核心为:
c t v e l : v x ∈ − 0.01 , 0.01 , v y ∈ − 0.01 , 0.01 , ω z ∈ − 0.05 , 0.05 c_t^{vel}:\quad v_x\in-0.01,0.01,\quad v_y\in-0.01,0.01,\quad \omega_z\in-0.05,0.05 ctvel:vx∈−0.01,0.01,vy∈−0.01,0.01,ωz∈−0.05,0.05
- 因为 MicroDuck 希望不同 Task 使用统一的 Observation 结构,因此占位类用来填补
- 重采样窗口被拉长到整条 episode: T r e s a m p l e ∼ U T e p i s o d e , 2 T e p i s o d e T_{resample}\sim U\\,T_{episode},\\,2T_{episode}\\, Tresample∼UTepisode,2Tepisode,这样就能保证一个 episode 内基本不会重新采样
3-3-2-2 第二类:相位类
- 任务包含:
ground_pick、spin、roller_crouch - 注意这里不是在"改变速度命令" ,而是在借用原本 c t v e l = v x , v y , w z c_t^{vel}=v_x,v_y,w_z ctvel=vx,vy,wz 这个 Command 槽位,来编码一个周期相位 ϕ \phi ϕ。
- 其中:周期相位 ϕ \phi ϕ 用来表示"当前动作进行到哪个阶段"
- 且之所以不直接采取 ϕ \phi ϕ作为输入的原因是:
- 相位本身是周期变量,直接用一个标量 ϕ \phi ϕ 表示会在周期边界产生不连续;用 sin / cos \sin/\cos sin/cos 编码可以把这个周期变量变成连续的二维表示。
- 因此这里采用单位圆编码对动作阶段 Phase 进行表示
- 核心为:
ϕ ( t ) = ( t T ) m o d 1 , c t v e l = cos ( 2 π ϕ ) , sin ( 2 π ϕ ) , 0 \phi(t)=\left(\frac{t}{T}\right)\bmod 1,\qquad c_t^{vel}=\left\\cos(2\\pi\\phi),\\ \\sin(2\\pi\\phi),\\ 0\\right ϕ(t)=(Tt)mod1,ctvel=cos(2πϕ), sin(2πϕ), 0
- 这样实际上是把动作阶段编码成了连续的二维向量,三个任务只在周期 T T T 与初始相位 ϕ 0 \phi_0 ϕ0 上不同
T g r o u n d _ p i c k = 4.0 s , ϕ 0 ∼ U [ 0 , 1 ) ; T s p i n = 4.0 s , ϕ 0 = 0 ; T c r o u c h = 5.0 s , ϕ 0 = 0 T_{ground\pick}=4.0\ \mathrm{s},\ \phi_0\sim U[0,1);\qquad T{spin}=4.0\ \mathrm{s},\ \phi_0=0;\qquad T_{crouch}=5.0\ \mathrm{s},\ \phi_0=0 Tground_pick=4.0 s, ϕ0∼U[0,1);Tspin=4.0 s, ϕ0=0;Tcrouch=5.0 s, ϕ0=0
说人话:每次 episode 从随机动作阶段开始,这样机器人就知道在不同阶段的时候,我应该采取什么样的策略
3-3-2-3 第三类:状态标志类
- 任务包含:
sitstand - 这里同样是服用了速度输入的框架,来表示离散状态 Command,也就是站着还是坐着
- 核心公式为
c t v e l = sit_flag , 0 , 0 , sit_flag ∼ B e r n o u l l i ( 0.5 ) , T d w e l l ∼ U 3.5 , 6.5 s c_t^{vel}=\\,\\text{sit\\_flag},\\ 0,\\ 0\\,,\qquad \text{sit\flag}\sim \mathrm{Bernoulli}(0.5),\qquad T{dwell}\sim U3.5,6.5\,\mathrm{s} ctvel=sit_flag, 0, 0,sit_flag∼Bernoulli(0.5),Tdwell∼U3.5,6.5s
- sit_flag = 1 \text{sit\_flag}=1 sit_flag=1 是坐下、 0 0 0 是站立------全零即站姿,正好等于部署时的 idle 状态
dwell:表示机器人不会刚刚坐下就立刻要求站起来,这样可以学习到目标状态保持
3-3-2-4 第四类:速度类
- 任务包含:
velocity、velstand、velocity_rollers - 这里就是真正意义上的 c t v e l = v x , v y , ω z c_t^{vel} = v_x,v_y,\\omega_z ctvel=vx,vy,ωz
velocity(主行走任务)
c t v e l : v x ∈ − 0.4 , 0.4 , v y ∈ − 0.3 , 0.3 , ω z ∈ − 1.0 , 1.0 c_t^{vel}:\quad v_x\in-0.4,0.4,\quad v_y\in-0.3,0.3,\quad \omega_z\in-1.0,1.0 ctvel:vx∈−0.4,0.4,vy∈−0.3,0.3,ωz∈−1.0,1.0
velstand的 c t v e l c_t^{vel} ctvel 与velocity完全相同,差别在头部槽位(用来表示头部应该朝哪里):它把 curriculum 折叠到最终档位,所以直接取上限值
c t h e a d : neck_p ∈ − 1.10 , 1.10 , head_p ∈ − 1.10 , 1.10 , head_yaw ∈ − 1.40 , 1.40 , head_roll ∈ − 0.31 , 0.31 c_t^{head}:\quad \text{neck\_p}\in-1.10,1.10,\quad \text{head\_p}\in-1.10,1.10,\quad \text{head\_yaw}\in-1.40,1.40,\quad \text{head\_roll}\in-0.31,0.31 cthead:neck_p∈−1.10,1.10,head_p∈−1.10,1.10,head_yaw∈−1.40,1.40,head_roll∈−0.31,0.31
说人话:
velstand是在速度控制基础上进一步要求策略处理头部姿态 Command。
velocity_rollers只保留前进方向,且第三格的含义从"角速度"换成"朝向误差"
v x ∈ − 0.5 , 0.6 , v y = 0 , ω z = 0 ⇒ c m d 2 = heading error v_x\in-0.5,0.6,\qquad v_y=0,\qquad \omega_z= 0\ \Rightarrow\ \mathrm{cmd}2=\text{heading error} vx∈−0.5,0.6,vy=0,ωz=0 ⇒ cmd2=heading error
- 其中 v x = 0 v_x=0 vx=0 是滑行、 v x > 0 v_x>0 vx>0 是加速、 v x < 0 v_x<0 vx<0 是刹车
说人话:
velocity_rollers在仅保留前后运动的基础上,将原本表示角速度的cmd[2]改为目标朝向误差,使策略根据"期望前后速度 + 当前与目标朝向的误差"学习运动与转向。
3-3-2-5 第五类:其他
- 不能直接归入上面几类
velocity_swizzle:构建在 rollers 之上, c t v e l c_t^{vel} ctvel 的生成方式仍是RelativeHeadingVelocityCommand,只是把范围重新打开
v x ∈ − 0.6 , 0.6 , v y = 0 , c m d 2 = c l i p ( heading error , ± 0.5 ) v_x\in-0.6,0.6,\qquad v_y=0,\qquad \mathrm{cmd}2=\mathrm{clip}(\text{heading error},\ \pm 0.5) vx∈−0.6,0.6,vy=0,cmd2=clip(heading error, ±0.5)
- 这里 ± 0.5 \pm0.5 ±0.5 是朝向误差的饱和上限而不是"要转多快":误差可以饱和,但转向速率被压缓,所以它仍能转到任意朝向,只是转得更平滑
说人话:当朝向误差超过 ±0.5 rad 时,策略看到的误差信号保持在 ±0.5,不再随着实际误差继续增大。
roller_slope:命令被整体中和,位姿完全由地形(斜坡)驱动
v x = 0 , v y = 0 , ω z = 0 , rel_standing_envs = 1.0 v_x=0,\qquad v_y=0,\qquad \omega_z=0,\qquad \texttt{rel\_standing\_envs}=1.0 vx=0,vy=0,ωz=0,rel_standing_envs=1.0
说人话:机器人在斜坡这种地形条件下能不能保持稳定。
- 附: c t h e a d c_t^{head} cthead 与 c t b o d y c_t^{body} ctbody 两个槽位
- 初始范围在速度、起身、坐站任务里是一致的(对应
head_pose的 stage-0)
c t h e a d ∈ − 0.05 , 0.05 × − 0.05 , 0.05 × − 0.07 , 0.07 × − 0.015 , 0.015 c_t^{head}\in-0.05,0.05\times-0.05,0.05\times-0.07,0.07\times-0.015,0.015 cthead∈−0.05,0.05×−0.05,0.05×−0.07,0.07×−0.015,0.015
- c t b o d y c_t^{body} ctbody 只有
standup真正使用;主行走任务里它全程是小范围占位(只保活、不驱动策略)
c t b o d y ∣ v e l o c i t y ∈ − 0.005 , 0.005 3 × − 0.05 , 0.05 3 , c t b o d y ∣ s t a n d u p : z ∈ − 0.04 , 0.03 , r o l l , p i t c h ∈ − 15 ∘ , 15 ∘ c_t^{body}\Big|{velocity}\in-0.005,0.005^{3}\times-0.05,0.05^{3},\qquad c_t^{body}\Big|{standup}:\ z\in-0.04,0.03,\ \ roll,pitch\in-15\^\\circ,15\^\\circ ctbody velocity∈−0.005,0.0053×−0.05,0.053,ctbody standup: z∈−0.04,0.03, roll,pitch∈−15∘,15∘
- 相位类与轮式任务不使用这两个槽位,直接补零
c t h e a d = 0 4 , c t b o d y = 0 6 c_t^{head}=\mathbf{0}_4,\qquad c_t^{body}=\mathbf{0}_6 cthead=04,ctbody=06
3-3-3 Command流程
- Command 的核心可以概括为:
#mermaid-svg-5caXqah9EhhMoFaH{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-5caXqah9EhhMoFaH .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-5caXqah9EhhMoFaH .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-5caXqah9EhhMoFaH .error-icon{fill:#552222;}#mermaid-svg-5caXqah9EhhMoFaH .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-5caXqah9EhhMoFaH .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-5caXqah9EhhMoFaH .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-5caXqah9EhhMoFaH .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-5caXqah9EhhMoFaH .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-5caXqah9EhhMoFaH .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-5caXqah9EhhMoFaH .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-5caXqah9EhhMoFaH .marker{fill:#333333;stroke:#333333;}#mermaid-svg-5caXqah9EhhMoFaH .marker.cross{stroke:#333333;}#mermaid-svg-5caXqah9EhhMoFaH svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-5caXqah9EhhMoFaH p{margin:0;}#mermaid-svg-5caXqah9EhhMoFaH .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-5caXqah9EhhMoFaH .cluster-label text{fill:#333;}#mermaid-svg-5caXqah9EhhMoFaH .cluster-label span{color:#333;}#mermaid-svg-5caXqah9EhhMoFaH .cluster-label span p{background-color:transparent;}#mermaid-svg-5caXqah9EhhMoFaH .label text,#mermaid-svg-5caXqah9EhhMoFaH span{fill:#333;color:#333;}#mermaid-svg-5caXqah9EhhMoFaH .node rect,#mermaid-svg-5caXqah9EhhMoFaH .node circle,#mermaid-svg-5caXqah9EhhMoFaH .node ellipse,#mermaid-svg-5caXqah9EhhMoFaH .node polygon,#mermaid-svg-5caXqah9EhhMoFaH .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-5caXqah9EhhMoFaH .rough-node .label text,#mermaid-svg-5caXqah9EhhMoFaH .node .label text,#mermaid-svg-5caXqah9EhhMoFaH .image-shape .label,#mermaid-svg-5caXqah9EhhMoFaH .icon-shape .label{text-anchor:middle;}#mermaid-svg-5caXqah9EhhMoFaH .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-5caXqah9EhhMoFaH .rough-node .label,#mermaid-svg-5caXqah9EhhMoFaH .node .label,#mermaid-svg-5caXqah9EhhMoFaH .image-shape .label,#mermaid-svg-5caXqah9EhhMoFaH .icon-shape .label{text-align:center;}#mermaid-svg-5caXqah9EhhMoFaH .node.clickable{cursor:pointer;}#mermaid-svg-5caXqah9EhhMoFaH .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-5caXqah9EhhMoFaH .arrowheadPath{fill:#333333;}#mermaid-svg-5caXqah9EhhMoFaH .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-5caXqah9EhhMoFaH .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-5caXqah9EhhMoFaH .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-5caXqah9EhhMoFaH .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-5caXqah9EhhMoFaH .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-5caXqah9EhhMoFaH .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-5caXqah9EhhMoFaH .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-5caXqah9EhhMoFaH .cluster text{fill:#333;}#mermaid-svg-5caXqah9EhhMoFaH .cluster span{color:#333;}#mermaid-svg-5caXqah9EhhMoFaH div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-5caXqah9EhhMoFaH .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-5caXqah9EhhMoFaH rect.text{fill:none;stroke-width:0;}#mermaid-svg-5caXqah9EhhMoFaH .icon-shape,#mermaid-svg-5caXqah9EhhMoFaH .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-5caXqah9EhhMoFaH .icon-shape p,#mermaid-svg-5caXqah9EhhMoFaH .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-5caXqah9EhhMoFaH .icon-shape .label rect,#mermaid-svg-5caXqah9EhhMoFaH .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-5caXqah9EhhMoFaH .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-5caXqah9EhhMoFaH .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-5caXqah9EhhMoFaH :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 预先定义 Command 范围
根据当前 Task 随机采样
得到当前时刻的 Command
通过 generated_commands 加入 Observation
Actor 根据 Observation + Command 生成 Action
环境执行 Action
根据实际状态与 Command 的匹配程度计算 Reward
- 我们拿
head_pose举例:
python
cfg.commands["head_pose"] = microduck_mdp.UniformPoseCommandCfg(
    resampling_time_range=HEAD_POSE_CMD_RESAMPLE_S,
    ranges=(
        (-0.05, 0.05),
        (-0.05, 0.05),
        (-0.07, 0.07),
        (-0.015, 0.015),
    ),
)- 环境会在上述范围内随机生成:
c h e a d ∈ R 4 c^{head}\in\mathbb{R}^{4} chead∈R4
- 其中四个维度分别对应 1-2-1 描述的关节模块:
python
[neck_pitch,
 head_pitch,
 head_yaw,
head_roll]- 随后通过:
python
ObservationTermCfg(
    func=mdp.generated_commands,
    params={"command_name": "head_pose"},
)- 将当前 Command 加入 Actor 和 Critic 的 Observation。
3-4 Observation
3-4-1 介绍
- 正如上述所说,MicroDuck 不同 Task 尽量使用统一的 Observation 接口与结构 。在此基础上,根据具体 Task 的需求填充对应的 Observation/Command 内容;对于当前 Task 不需要的部分,则通过置零或占位的方式保持接口结构的一致性。
- 这样可以使不同 Task 的策略具有相对统一的输入接口,同时又能够通过复用不同的 Command 槽位表达速度、相位、状态标志、朝向误差等不同语义。
3-4-2 非对称 actor-critic
- 我们在上一篇ppo中提到过,实际在训练中使用actor-critic架构的模型常常会引入一种非对称观测的设计来提高训练的效果。
- 这就是非对称 actor-critic:指的是训练时 Actor 和 Critic 使用不同的信息:Actor 只使用真实机器人部署时能够获得的观测,而 Critic 可以使用训练阶段额外可获得的完整状态信息。这样 Critic 能提供更准确的价值估计和训练信号,同时不增加 Actor 部署时的感知与计算负担。
3-4-3 Actor观测-61D
- actor的观测如下
o t a c t o r = o t p r o p ⏟ 48 维 , c t v e l ⏟ 3 维 , c t h e a d ⏟ 4 维 , c t b o d y ⏟ 6 维 ∈ R 61 \boxed{ \mathbf{o}_t^{actor} = \left \\underbrace{\\mathbf{o}_t\^{prop}}_{48\\text{维}}, \\underbrace{\\mathbf{c}_t\^{vel}}_{3\\text{维}}, \\underbrace{\\mathbf{c}_t\^{head}}_{4\\text{维}}, \\underbrace{\\mathbf{c}_t\^{body}}_{6\\text{维}} \\right \in\mathbb{R}^{61} } otactor= 48维 otprop,3维 ctvel,4维 cthead,6维 ctbody ∈R61
- 其中:
- o t p r o p ∈ R 48 \mathbf{o}_t^{prop}\in\mathbb{R}^{48} otprop∈R48 表示机器人自身的本体感知(Proprioception)信息,共 48 维,主要描述机器人当前的运动状态
o t p r o p = ω t b a s e , g t p r o j , q t , q ˙ t , a t − 1 ∈ R 48 \boxed{ \mathbf{o}_t^{prop} = \left \\mathbf{\\omega}_t\^{base}, \\mathbf{g}_t\^{proj}, \\mathbf{q}_t, \\dot{\\mathbf q}_t, \\mathbf a_{t-1} \\right \in\mathbb{R}^{48} } otprop=ωtbase,gtproj,qt,q˙t,at−1∈R48
-
其中:
- ω t b a s e ∈ R 3 \mathbf{\omega}_t^{base}\in\mathbb{R}^{3} ωtbase∈R3:机体角速度
- g t p r o j ∈ R 3 \mathbf g_t^{proj}\in\mathbb{R}^{3} gtproj∈R3:重力方向在机体坐标系下的投影
- q t ∈ R 14 \mathbf q_t\in\mathbb{R}^{14} qt∈R14:14 个关节的位置
- q ˙ t ∈ R 14 \dot{\mathbf q}_t\in\mathbb{R}^{14} q˙t∈R14:14 个关节的速度
- a t − 1 ∈ R 14 \mathbf a_{t-1}\in\mathbb{R}^{14} at−1∈R14:上一时刻策略输出的 Action
- c t v e l , c t h e a d , c t b o d y \mathbf{c}_t^{vel},\mathbf{c}_t^{head},\mathbf{c}_t^{body} ctvel,cthead,ctbody 表示前文所述的 Command 信息 ,分别对应 3D 的基础 Command、4D 的头部姿态 Command 和 6D 的身体姿态 Command 。
- c t v e l ∈ R 3 \mathbf{c}_t^{vel}\in\mathbb{R}^3 ctvel∈R3:通常表示速度 Command,但在部分 Task 中也会复用该槽位表示动作相位、状态标志或朝向误差;
- c t h e a d ∈ R 4 \mathbf{c}_t^{head}\in\mathbb{R}^4 cthead∈R4:头部姿态 Command;
- c t b o d y ∈ R 6 \mathbf{c}_t^{body}\in\mathbb{R}^6 ctbody∈R6:身体位姿 Command。
-
值得一提的是,这里的观测输入了上一时刻策略输出的 Action,这是为了对连续动作控制更稳定,避免相邻之间的动作变化过大
-
原文描述为:
- Obs layout is 61D (actor) and shared across the whole policy family so
policies are hot-swappable in the runtime: 48 base proprioception +
13D command block[twist(3), head_pose(4), body_pose(6)], in that order.
An env that doesn't use a command slot ZERO-PADS it (keep the obs term,
sample tiny ranges) --- never delete a slot.
- Obs layout is 61D (actor) and shared across the whole policy family so
-
这种主要依靠机器人自身状态感知,而不依赖摄像头、LiDAR 等外部环境感知传感器 的观测信息,被称为 Proprioception(本体感知)。
| 类型 | 典型传感器/信息 | 回答的问题 |
|---|---|---|
| Proprioception | 关节编码器、IMU | "我现在是什么姿态、怎么运动?" |
| Exteroception | 相机、LiDAR、深度相机 | "周围有什么、地形是什么?" |
- 后续我们会继续开一个系列接着宇树机器狗来探讨如何训练Exteroception带感知的强化学习。
3-4-4 Critic观测-76D
- 就如非对称 actor-critic设计的一样,Critic 可以使用训练阶段额外可获得的完整状态信息,因此具备更多维度观测信息:
- 这里我们不多对上述 actor 观测有的部分展开,我们只关注特权信息
o t c r i t i c = o t a c t o r ⏟ Actor已有信息 , v t b a s e ⏟ 3 , h t f o o t ⏟ 2 , t t a i r ⏟ 2 , c t c o n t a c t ⏟ 2 , f t c o n t a c t ⏟ 6 ∈ R 76 \mathbf{o}_t^{critic}=\left\\underbrace{\\mathbf{o}_t\^{actor}}_{\\text{Actor已有信息}},\\ \\underbrace{\\mathbf{v}_t\^{base}}_{3},\\ \\underbrace{\\mathbf{h}_t\^{foot}}_{2},\\ \\underbrace{\\mathbf{t}_t\^{air}}_{2},\\ \\underbrace{\\mathbf{c}_t\^{contact}}_{2},\\ \\underbrace{\\mathbf{f}_t\^{contact}}_{6}\\right\in\mathbb{R}^{76} otcritic= Actor已有信息 otactor, 3 vtbase, 2 htfoot, 2 ttair, 2 ctcontact, 6 ftcontact ∈R76
- 其中,Critic 相比 Actor 主要额外获得:
- v t b a s e ∈ R 3 \mathbf{v}_t^{base}\in\mathbb{R}^{3} vtbase∈R3:机器人机体的线速度;
- h t f o o t ∈ R 2 \mathbf{h}_t^{foot}\in\mathbb{R}^{2} htfoot∈R2:两个足端的离地高度;
- t t a i r ∈ R 2 \mathbf{t}_t^{air}\in\mathbb{R}^{2} ttair∈R2:两个足端的腾空时间(Foot Air Time);
- c t c o n t a c t ∈ R 2 \mathbf{c}_t^{contact}\in\mathbb{R}^{2} ctcontact∈R2:两个足端的接触状态,表示足端是否与地面接触;
- f t c o n t a c t ∈ R 6 \mathbf{f}_t^{contact}\in\mathbb{R}^{6} ftcontact∈R6:两个足端的接触力,每个足端包含 (x,y,z) 三个方向的力。
- 值得一说的是,Foot Air Time(足端腾空时间) 是腿式机器人强化学习中常见的运动状态量,同时也经常被用于奖励函数或约束,以鼓励足端形成合理的摆动周期、避免拖脚等不自然运动。
3-4-5 网络结构
- 有了对应的观测输入,我们来分别看看非对称 actor-critic到底采用了什么网络结构,二者的网络结构一致,只是输入和输出不同。
| 输入 | 层序列 | 输出 | |
|---|---|---|---|
| actor | 61 | Linear(61, 512)+ELU、Linear(512, 256)+ELU、Linear(256, 128)+ELU、Linear(128, 14) |
14(动作均值) |
| critic | 76 | Linear(76, 512)+ELU、Linear(512, 256)+ELU、Linear(256, 128)+ELU、Linear(128, 1) |
1(价值) |
3-5 Action-14D
- 从上述网络结构不难看出,MircoDuck的动作定义就对应的自己的14个舵机
| action 槽 | 关节 |
|---|---|
| 0--4 | left_hip_yaw, left_hip_roll, left_hip_pitch, left_knee, left_ankle |
| 5--8 | neck_pitch, head_pitch, head_yaw, head_roll |
| 9--13 | right_hip_yaw, right_hip_roll, right_hip_pitch, right_knee, right_ankle |
- 同样的配合actor输出模式为
GaussianDistribution(我们在PPO完全解构说到过,action输出只有mean,std为独立外部参数),action的输出为无量纲的,会根据不同任务的设置进行scale缩放。
3-6 Reward
3-6-1 总览
- 有了观测输入、网络设计、动作定义,下一步就到了我们的奖励函数编写了。
- MicroDuck 的奖励函数可以大致分为:
R t = R task + R stability + R smoothness + R constraint R_t = R_{\text{task}} + R_{\text{stability}} + R_{\text{smoothness}} + R_{\text{constraint}} Rt=Rtask+Rstability+Rsmoothness+Rconstraint
其中包含了任务、稳定、动作变化、约束与惩罚等等。
- 函数库
MicroDuck/microduck_rl/src/mjlab_microduck/tasks/mdp.py包含大量 MDP 函数,其中相当一部分用于奖励或惩罚。 - 其他各个任务还会在对应的
microduck_*_env_cfg.py中进一步组合和配置奖励项。 - 由于这里篇幅限制,我们无法一一讲解全部的奖励函数,这里选几个最重要的来解读。
3-6-2 Command Tracking
- 对于给定的速度任务: v x c m d , v y c m d , ω z c m d v_x\^{cmd},v_y\^{cmd},\\omega_z\^{cmd} vxcmd,vycmd,ωzcmd 对比机器人实际速度 v x , v y , ω z v_x,v_y,\\omega_z vx,vy,ωz,根据二者之间的误差给予奖励
exp ( − ∣ v t − c t v e l ∣ 2 σ 2 ) \exp\left(-\frac{|\mathbf v_t-\mathbf c_t^{vel}|^2}{\sigma^2}\right) exp(−σ2∣vt−ctvel∣2)
- 因此,实际速度越接近 Command,误差越小,奖励越高;反之奖励快速下降。
3-6-3 foot_air_time
- 这个对应我们上面讲到的,非对称 Actor-Critic 网络中 Critic 引入的特权观测:
t t a i r ∈ R 2 \mathbf t_t^{air}\in\mathbb R^2 ttair∈R2
foot_air_time实际上是一个事件型奖励 ,并不是每一步简单地根据连续误差计算。- 它主要关注足端离地持续时间,当机器人完成一次合理的抬脚---摆动---落脚过程时,根据对应的腾空时间给予奖励。
- 因此它并不是简单地要求"脚抬得越高越好",而是鼓励机器人形成更加合理的周期性步态。
- 对于行走任务来说,这能够帮助策略避免出现双脚始终拖地、滑行等不理想的运动方式。
3-6-4 姿态稳定 Reward
- 姿态稳定 Reward 主要关注机器人机体当前姿态是否合理。
- 例如可以利用机体坐标系下的重力投影: g x , g y , g z g_x,g_y,g_z gx,gy,gz,当机器人保持正常站立姿态时,重力方向应该与期望方向接近;
- 如果机器人发生较大的前后、左右倾斜,则对应的误差增大,Reward 降低。
3-6-5 Action Rate
- Action Rate 主要约束相邻两个时刻 Action 的变化
r t a c t i o n r a t e ∝ − ∣ a t − a t − 1 ∣ 2 r_t^{action_rate}\propto -\left|\mathbf a_t-\mathbf a_{t-1}\right|^2 rtactionrate∝−∣at−at−1∣2
- 如果策略在相邻时刻输出的 Action 变化过大,就会受到惩罚。
- 这样可以避免策略产生剧烈的控制抖动,使输出动作更加平滑。
- 这也解释了为什么 Actor 的观测中需要加入上一时刻 Action
a t − 1 \mathbf a_{t-1} at−1
- 策略不仅能够知道机器人当前处于什么状态,还能够知道自己上一时刻做了什么,从而更容易学习连续、平滑的控制策略
3-6-6 Joint / Torque Limit
- 这一类 Reward 更准确地说属于约束/惩罚项,用于避免机器人超过机械系统允许的工作范围。
- 对于关节位置,可以限制:
q i m i n ≤ q i ≤ q i m a x q_i^{min} \leq q_i \leq q_i^{max} qimin≤qi≤qimax
- 对于关节力矩,则需要满足
∣ τ i ∣ ≤ τ i m a x |\tau_i|\leq \tau_i^{max} ∣τi∣≤τimax
- 当机器人接近甚至超过这些限制时,对策略进行惩罚。
- 它的核心目的不是让机器人完成某个具体任务,而是告诉策略动作可以完成任务,但不能把机械结构"用坏",也就是物理限制
3-6-7 Termination / Alive
- 最后是 Episode 是否应该继续的问题。
- 当机器人发生严重失败,例如摔倒、姿态超过允许范围或触发其他终止条件时,可以提前结束当前 Episode。
- 可以简单理解为
{ r f a i l , 发生失败 0 , 正常运行 \begin{cases} r_{fail}, & \text{发生失败}\\ 0, & \text{正常运行} \end{cases} {rfail,0,发生失败正常运行
- 其中通常
r f a i l < 0 r_{fail}<0 rfail<0
- 与此同时,一些任务还会使用 Alive Reward,即机器人只要保持正常运行,就持续获得一个较小的正奖励
r t a l i v e > 0 r_t^{alive}>0 rtalive>0
- 两者结合后,策略不仅需要完成任务,还需要尽可能避免摔倒和提前结束 Episode。
3-6-8 官方建议
- 官方在
MicroDuck/microduck_rl/AGENTS.md给出了部分奖励设置的建议:- 不给 jackpot:任何"到达 X"都要限速或斜坡,否则提前到目标还每步拿钱,换来的是任意暴力动作。
- 绝不把正奖励挂在坏状态上 (摔倒、低姿),策略会赖在最省力的合格姿势里刷分。改用势函数塑形,比如付
Δcos(tilt):抬升给钱、保持给零,刷不了。 - 别用瞬时紧 std 去修无法避免的抖动 :头占整机 38% 质量,走路时必然摆动。历史上收紧
head_pose_tracking的 std 到 0.1,走路在 300 iter 内整个崩掉(air_time1.01 掉到 0.02)。可逃的部分(重力下垂的 DC 偏置)才该定价------于是有了head_pose_bias(1 s EMA 上的 L1)。 - 正则分两类 :动作阻断型(
body_ang_vel、angular_momentum、posestd)会惩罚动态动作必需的成分,动态任务要压低;平滑型(action_rate、joint_torque_rate)只压抖动,可以给,但要等技能学会再上。 - 比奖励质量,不比权重 :PPO 只看相对优势,同样的
action_rate权重放在 4 倍大的正向任务栈下面就弱 4 倍。 - 跟踪高斯 std ≈ 你还在意的误差,不是最大误差。
- obs 一旦被重映射到传感器视角(backlash encoder、bias),同一个量的跟踪奖励必须量同一个视角,否则等于在惩罚策略"修正它看到的偏差"。
3-7 PPO的完整流程
3-7-1 一次迭代的全链路
- 综上我们已经了解了整个算法的流程
- 接下来我们把它接回
rsl_rl的训练主循环,看看一次迭代(iteration)从头到尾发生了什么 - 主循环的骨架在
on_policy_runner.py的learn()里,一共就三件事:先跑num_steps_per_env步收集数据,再算优势与回报,最后做一次参数更新 - 把每一步展开,完整链路如下:
#mermaid-svg-S2LNmlBGAi913Qhq{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-S2LNmlBGAi913Qhq .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-S2LNmlBGAi913Qhq .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-S2LNmlBGAi913Qhq .error-icon{fill:#552222;}#mermaid-svg-S2LNmlBGAi913Qhq .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-S2LNmlBGAi913Qhq .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-S2LNmlBGAi913Qhq .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-S2LNmlBGAi913Qhq .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-S2LNmlBGAi913Qhq .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-S2LNmlBGAi913Qhq .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-S2LNmlBGAi913Qhq .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-S2LNmlBGAi913Qhq .marker{fill:#333333;stroke:#333333;}#mermaid-svg-S2LNmlBGAi913Qhq .marker.cross{stroke:#333333;}#mermaid-svg-S2LNmlBGAi913Qhq svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-S2LNmlBGAi913Qhq p{margin:0;}#mermaid-svg-S2LNmlBGAi913Qhq .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-S2LNmlBGAi913Qhq .cluster-label text{fill:#333;}#mermaid-svg-S2LNmlBGAi913Qhq .cluster-label span{color:#333;}#mermaid-svg-S2LNmlBGAi913Qhq .cluster-label span p{background-color:transparent;}#mermaid-svg-S2LNmlBGAi913Qhq .label text,#mermaid-svg-S2LNmlBGAi913Qhq span{fill:#333;color:#333;}#mermaid-svg-S2LNmlBGAi913Qhq .node rect,#mermaid-svg-S2LNmlBGAi913Qhq .node circle,#mermaid-svg-S2LNmlBGAi913Qhq .node ellipse,#mermaid-svg-S2LNmlBGAi913Qhq .node polygon,#mermaid-svg-S2LNmlBGAi913Qhq .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-S2LNmlBGAi913Qhq .rough-node .label text,#mermaid-svg-S2LNmlBGAi913Qhq .node .label text,#mermaid-svg-S2LNmlBGAi913Qhq .image-shape .label,#mermaid-svg-S2LNmlBGAi913Qhq .icon-shape .label{text-anchor:middle;}#mermaid-svg-S2LNmlBGAi913Qhq .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-S2LNmlBGAi913Qhq .rough-node .label,#mermaid-svg-S2LNmlBGAi913Qhq .node .label,#mermaid-svg-S2LNmlBGAi913Qhq .image-shape .label,#mermaid-svg-S2LNmlBGAi913Qhq .icon-shape .label{text-align:center;}#mermaid-svg-S2LNmlBGAi913Qhq .node.clickable{cursor:pointer;}#mermaid-svg-S2LNmlBGAi913Qhq .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-S2LNmlBGAi913Qhq .arrowheadPath{fill:#333333;}#mermaid-svg-S2LNmlBGAi913Qhq .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-S2LNmlBGAi913Qhq .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-S2LNmlBGAi913Qhq .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-S2LNmlBGAi913Qhq .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-S2LNmlBGAi913Qhq .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-S2LNmlBGAi913Qhq .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-S2LNmlBGAi913Qhq .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-S2LNmlBGAi913Qhq .cluster text{fill:#333;}#mermaid-svg-S2LNmlBGAi913Qhq .cluster span{color:#333;}#mermaid-svg-S2LNmlBGAi913Qhq div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-S2LNmlBGAi913Qhq .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-S2LNmlBGAi913Qhq rect.text{fill:none;stroke-width:0;}#mermaid-svg-S2LNmlBGAi913Qhq .icon-shape,#mermaid-svg-S2LNmlBGAi913Qhq .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-S2LNmlBGAi913Qhq .icon-shape p,#mermaid-svg-S2LNmlBGAi913Qhq .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-S2LNmlBGAi913Qhq .icon-shape .label rect,#mermaid-svg-S2LNmlBGAi913Qhq .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-S2LNmlBGAi913Qhq .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-S2LNmlBGAi913Qhq .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-S2LNmlBGAi913Qhq :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 否
是
Command 管理器按 Task 采样当前目标
Observation 管理器拼装观测
Actor 拿到 61 维观测
Critic 拿到 76 维观测
Actor 前向得到 14 维均值
GaussianDistribution 按 std 采样出 Action
乘 scale 并加 HOME 位姿偏置
MuJoCo 按 timestep 推进 4 个物理步
Reward 管理器加权求和并乘 dt
Termination 管理器判定是否提前结束
obs、reward、done 存入 rollout buffer
已收集 24 个控制步
计算优势函数与回报
PPO 更新,4 个小批量各训练 5 轮
按 KL 散度自适应调整学习率
写日志并保存 checkpoint
- 这段链路可以分三段来读
- 采样段(
A到J):策略只负责与环境交互,梯度一次都不算。外面套的torch.inference_mode()就是为了不让计算图在这里堆积 - 缓冲段(
I到K):24 个控制步的数据凑成一个 batch,用广义优势估计(GAE,Generalized Advantage Estimation)算出每一步的优势与回报 - 更新段(
L到N):把 batch 切成 4 个小批量、每个小批量训练 5 轮,也就是一次迭代做 20 次梯度下降,最后按新旧策略之间的 KL 散度决定学习率是升还是降
- 采样段(
K和L的先后顺序是有讲究的:优势必须在旧策略的参数下算完,才能动参数。这也是 PPO 被称作同策略(on-policy)算法的原因,采一批、更新一次,旧数据立刻作废
说人话:把机器人放到场上走 24 步,沿途看到什么、拿到多少奖励全记下来,回家算一遍账,改一次脑子里的参数,再上场走 24 步。它不能像打游戏那样把昨天的录像反复看,因为参数一改,昨天的录像就不是"自己"演的了。
3-7-2 三个时间尺度
- 这套代码里同时存在三个不同的"时间",初看容易混
- 物理步:
timestep = 0.005 s,MuJoCo 每推进一步的时间 - 控制步:策略每输出一次 Action,环境要推进
decimation = 4个物理步,因此控制周期是 0.02 s,也就是 50 Hz - 回合:
episode_length_s = 20.0,折算成控制步是 1000 步
- 物理步:
- 三个尺度与配置里的参数对应如下:
| 尺度 | 配置项 | 值 | 含义 |
|---|---|---|---|
| 物理步 | sim.mujoco.timestep |
0.005 s | MuJoCo 积分一步 |
| 控制步 | decimation |
4 | 一次 Action 对应的物理步数 |
| 控制周期 | 由上两项决定 | 0.02 s | 策略输出频率 50 Hz |
| 训练批量 | num_steps_per_env |
24 | 一次迭代收集的控制步数 |
| 回合长度 | episode_length_s |
20.0 s | 一个 Episode 的控制步数 1000 |
| 训练总长 | max_iterations |
50000 | 一次完整训练的迭代次数 |
- 其中两个式子值得单独记一下:
T c t r l = t i m e s t e p × d e c i m a t i o n = 0.005 × 4 = 0.02 s T_{ctrl} = \mathrm{timestep} \times \mathrm{decimation} = 0.005 \times 4 = 0.02\ \mathrm{s} Tctrl=timestep×decimation=0.005×4=0.02 s
N e p i s o d e = e p i s o d e _ l e n g t h _ s T c t r l = 20.0 0.02 = 1000 N_{episode} = \frac{\mathrm{episode\_length\s}}{T{ctrl}} = \frac{20.0}{0.02} = 1000 Nepisode=Tctrlepisode_length_s=0.0220.0=1000
- 训练进度是按控制步推进的,换算关系是环境步数 =
iteration × num_steps_per_env,所以max_iterations = 50000对应 50000 × 24 = 1.2 × 10 6 50000 \times 24 = 1.2 \times 10^{6} 50000×24=1.2×10⁶个控制步,折算成机器人时间是六个多小时 - 奖励在每一步乘以
dt(也就是控制周期)再累加,因此Episode_Reward/<term>记录的是每秒速率,不是整段 Episode 的总量。看曲线时如果觉得数值偏小,先确认量纲再怀疑权重
说人话:物理步是"游戏引擎的帧",控制步是"我们按手柄的频率"。手柄一秒按 50 次,引擎一秒跑 200 帧,中间那 4 帧是引擎自己补的。奖励记的是每次按键之后发生的事,所以记账频率与按键频率一致,是 50 次每秒。
3-7-3 配置文件
- 上面那条链路里的每一个开关,最后都落在
RslRlOnPolicyRunnerCfg上。速度任务用的是MicroduckRlCfg,定义在microduck_velocity_env_cfg.py中,关键字段如下:
python
MicroduckRlCfg = RslRlOnPolicyRunnerCfg(
    # 网络结构,对应 3-4-5 网络结构一节
    actor=RslRlModelCfg(
        hidden_dims=(512, 256, 128),
        activation="elu",
        obs_normalization=True,
        # 动作分布,对应 3-5 的 Action 定义
        distribution_cfg={
            "class_name": "GaussianDistribution",
            "init_std": 1.0,
            "std_type": "scalar",
        },
    ),
    critic=RslRlModelCfg(
        hidden_dims=(512, 256, 128),
        activation="elu",
        obs_normalization=True,
    ),
    # PPO 的超参数
    algorithm=PpoWithSymmetryCfg(
        value_loss_coef=1.0,
        use_clipped_value_loss=True,
        clip_param=0.2,
        entropy_coef=0.01,
        num_learning_epochs=5,
        num_mini_batches=4,
        learning_rate=1.0e-3,
        schedule="adaptive",
        gamma=0.99,
        lam=0.95,
        desired_kl=0.01,
        max_grad_norm=1.0,
        # 镜像损失,默认关闭
        symmetry_cfg=SYMMETRY_CFG if ENABLE_SYMMETRY else None,
    ),
    # 训练与日志
    wandb_project="mjlab_microduck",
    experiment_name="velocity",
    run_name="velocity",
    save_interval=250,
    num_steps_per_env=24,
    max_iterations=50_000,
)- 逐个对上前面几节:
actor.hidden_dims与critic.hidden_dims:网络结构,对应 3-4-5 的三层 MLP(Multi-Layer Perceptron,多层感知机)distribution_cfg:动作分布。GaussianDistribution的标准差是独立可学习参数,网络只输出均值,对应 3-5 的 Action 定义num_learning_epochs乘num_mini_batches:一次迭代的梯度下降次数,5 乘 4 等于 20 次schedule="adaptive"配合desired_kl:学习率不手动调,而是看新旧策略之间的 KL(Kullback-Leibler,相对熵)散度,超过 0.01 就降、低于就升save_interval=250:每 250 次迭代存一个 checkpoint,max_iterations=50000意味着最多存 200 个
symmetry_cfg这一行值得单独说。ENABLE_SYMMETRY默认是False,所以这里拿到的是None,镜像损失并不生效。它打开之后会在原本的 PPO 损失上追加一项左右对称的约束,强度由mirror_loss_coeff控制。左右腿本来是对称的,这一项理论上能加快收敛;而 MicroDuck 的任务里还有头部、嘴部这些不对称的部件,所以默认没有开
说人话:这个文件就是训练的全部旋钮。网络多大、动作怎么采、学得多快、多久存一次档,都写在这一屏里,调参基本就是在改这里的数字。
3-7-4 前文各节与配置的对应
- 到这里,前面拆开讲的每一块都能在配置里找到落点:
| 前文小节 | 对应配置 | 作用 |
|---|---|---|
| Command | cfg.commands |
按 Task 采样目标,并决定重采样周期 |
| Observation | cfg.observations |
Actor 61 维与 Critic 76 维的拼装规则 |
| Action | cfg.actions["joint_pos"] |
14 个舵机的位置目标,scale 决定输出缩放 |
| Reward | cfg.rewards |
13 项基础奖励与各任务的增删 |
| Termination | cfg.terminations |
Episode 何时提前结束 |
| 本节训练流程 | MicroduckRlCfg |
采样步数、更新轮数、日志与存档 |
- 其中 Termination 最容易被跳过,但它直接决定了策略"怕什么"。速度任务一共接了四个终止条件:
time_out:走满 20 s 正常结束,带time_out=True,因此不算失败fell_over:机体倾角超过 70 度判定摔倒,是真正意义上的失败终止out_of_terrain_bounds:走出地形边界,同样按超时处理nan_state:状态出现 NaN 立即终止,是给传感器数值兜底的安全阀,不带time_out=True,所以会被当作失败
- 值得留意的是,四个条件里只有
fell_over是策略自己的锅。如果训练早期看到 Episode 长度异常短,先去查nan_state的触发计数,而不是急着改奖励
说人话:
time_out是"时间到了",fell_over是"摔了",out_of_terrain_bounds是"跑出场了",nan_state是"算崩了"。四种里面只有"摔了"是策略的问题,另外"算崩了"是代码的问题。
总结
- 本期我们从 MicroDuck 这台双足机器人出发,走完了它一个 PPO 训练任务的全部构成:硬件与关节布局、工程目录、Command、Observation、Action、Reward,最后把这几块接回
rsl_rl的训练主循环,逐一对上配置文件里的旋钮 - 核心要点回顾:
- 统一的观测接口:Actor 61 维(48 维本体加 13 维 Command 块),Critic 76 维并额外带特权观测;用不到的槽位一律置零占位,绝不删除,这样不同任务训练出来的策略才能在真机上热插拔
- 非对称 Actor-Critic:Actor 只拿真机上也能得到的量,Critic 在训练时多吃足端高度、接触力这类只有仿真里才有的信息,用来压低优势估计的方差
- Command 的五种编码:速度、头部姿态、机体姿态等目标统一采样成固定长度的向量,塞进观测的固定槽位
- 动作与分布 :14 维舵机位置,网络只输出均值,标准差是独立可学习参数,采样之后按任务的
scale缩放并叠加 HOME 位姿 - 奖励的分层 :任务项、稳定项、平滑项、约束项四类,配合
reward_weight按环境步分阶段放权重;符号约定是这一节最容易翻车的地方 - 一次迭代的闭环:采样 24 个控制步、算优势、切 4 个小批量各训练 5 轮、按 KL 散度自适应调学习率
- 下一期我们将讲解如何训练和部署MircoDuck
- 如有错误,欢迎指出!
- 感谢观看!