(一).介绍Seata
Seata是一款开源的分布式事务 解决方案,致力于提供高性能和简单易用的分布式事务服务。Seata为用户提供了AT TCC SEGA 和 XA事务模式,打造了一站式的分布式解决方案,
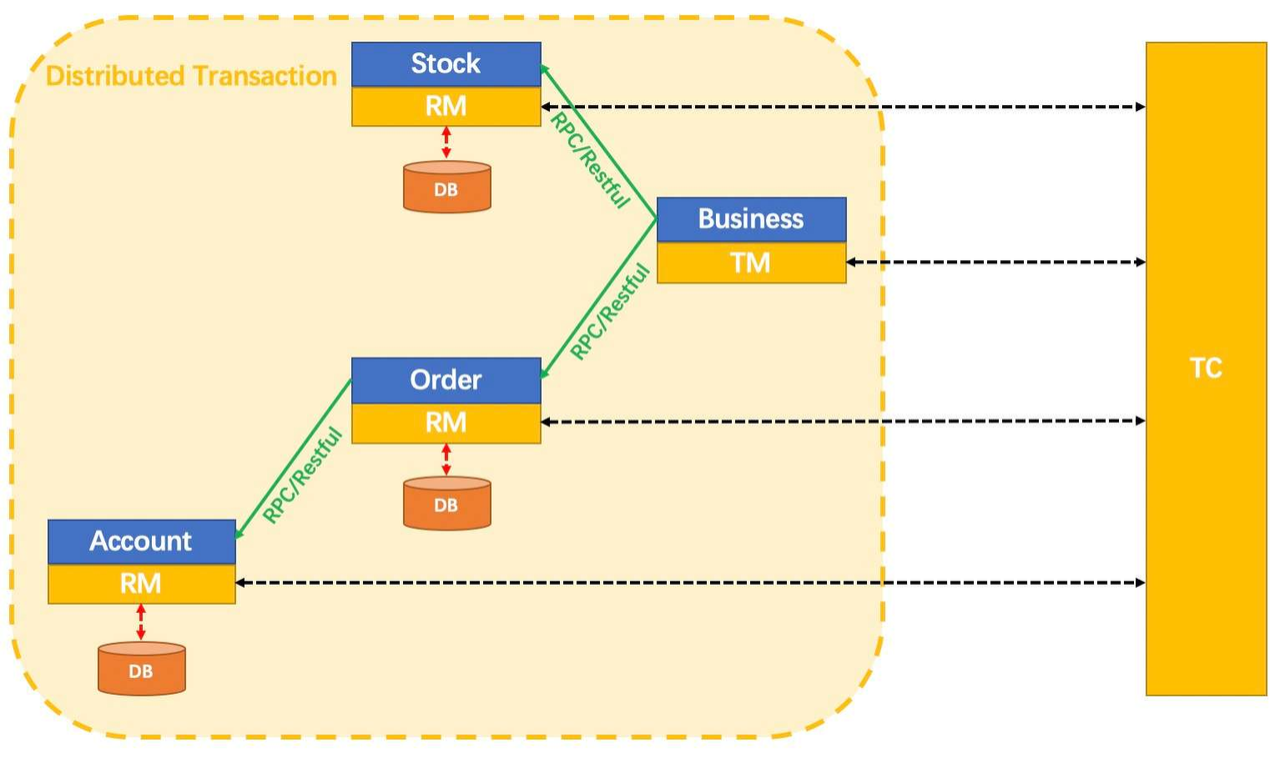
在介绍Seata之前,先要介绍一下什么是分布式事务。
(二).介绍分布式事务
1.回顾事务
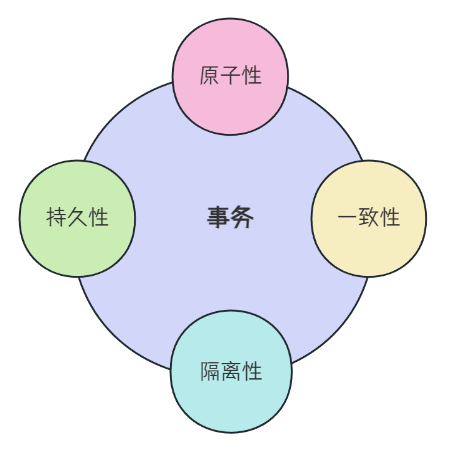
在之前介绍MYSQL的时候,我们就介绍到过事务的概念。关于数据库事务的概念,指的就是把一组SQL语句打包成一个整体,在执行这组SQL的过程中,要么全部成功,要么全部失败。也就是说,事务必须满足ACID的特性。
2.介绍分布式事务
所谓的"分布式事务",指的就是在分布式系统中,为了保证数据的一致性和完整性,对多个节点上的数据进行操作的事务。当一个事务涉及到多个不同的数据库,服务,实例的时候就构成了分布式事务。
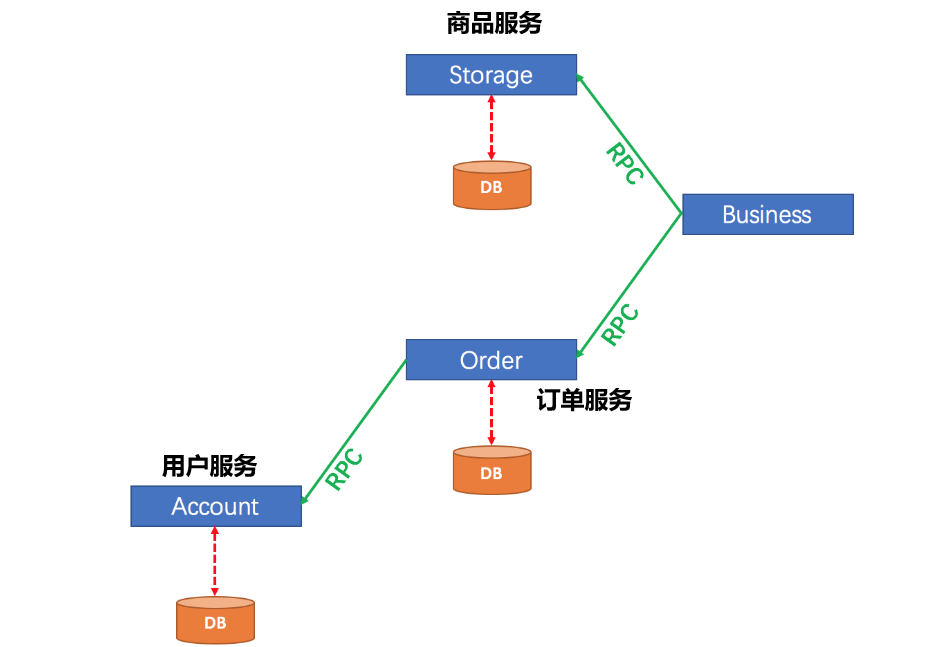
就像上图,订单服务和商品服务分别独立成了两个数据库,当一个客户端下单时的时候,需要在订单服务对应的数据库中创建订单,同时需要调用库存服务完成商品库存的扣减。订单服务进行操作的时候,订单服务的数据操作和库存服务的数据操作保持一致,此时这个就是"分布式事务"。总的来说,分布式数据一致性问题,就是如何在分布式场景中保证多个节点数据的一致性问题。
(三).分布式事务存在的问题
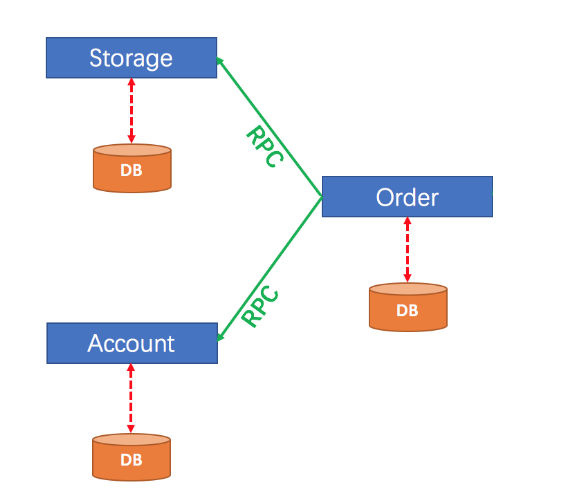
这是我们将要演示分布式事务存在的问题的测试环境
Account服务,用户服务,管理用户的资金账户,提供扣减余额的接口
Storage服务,库存服务,管理商品禄存,提供扣减库存的接口
Order服务,订单服务,负责管理订单,创建订单的时候,会调用Account服务和Storage服务
sql
CREATE DATABASE IF NOT EXISTS seata_test;

use seata_test;

DROP TABLE IF EXISTS `storage_tbl`;
CREATE TABLE `storage_tbl` (
  `id` int(11) NOT NULL AUTO_INCREMENT,
  `commodity_code` varchar(255) DEFAULT NULL,
  `count` int(11) DEFAULT 0,
  PRIMARY KEY (`id`),
  UNIQUE KEY (`commodity_code`),
  CONSTRAINT `count_chk` CHECK (`count` >= 0)
) ENGINE=InnoDB DEFAULT CHARSET=utf8;


DROP TABLE IF EXISTS `order_tbl`;
CREATE TABLE `order_tbl` (
  `id` int(11) NOT NULL AUTO_INCREMENT,
  `user_id` varchar(255) DEFAULT NULL,
  `commodity_code` varchar(255) DEFAULT NULL,
  `count` int(11) DEFAULT 0,
  `money` int(11) DEFAULT 0,
  PRIMARY KEY (`id`),
  CONSTRAINT `count_chk_2` CHECK (`count` >= 0),
  CONSTRAINT `money_chk` CHECK (`money` >= 0)
) ENGINE=InnoDB DEFAULT CHARSET=utf8;


DROP TABLE IF EXISTS `account_tbl`;
CREATE TABLE `account_tbl` (
  `id` int(11) NOT NULL AUTO_INCREMENT,
  `user_id` varchar(255) DEFAULT NULL,
  `money` int(11) DEFAULT 0,
  PRIMARY KEY (`id`),
  CONSTRAINT `money_chk_2` CHECK (`money` >= 0)
) ENGINE=InnoDB DEFAULT CHARSET=utf8;

-- 数据
INSERT INTO `storage_tbl` VALUES (1, '2001', 160);
INSERT INTO `storage_tbl` VALUES (2, '2002', 1000);
INSERT INTO `storage_tbl` VALUES (3, '2003', 500);
INSERT INTO `storage_tbl` VALUES (4, '2004', 400);
INSERT INTO `storage_tbl` VALUES (5, '2005', 600);

INSERT INTO `account_tbl` VALUES (1, '1001', 800);
INSERT INTO `account_tbl` VALUES (2, '1002', 2000);
INSERT INTO `account_tbl` VALUES (3, '1003', 1400);
INSERT INTO `account_tbl` VALUES (4, '1004', 2800);
INSERT INTO `account_tbl` VALUES (5, '1005', 3000);

CREATE TABLE `undo_log` (
  `id` bigint(20) NOT NULL AUTO_INCREMENT,
  `branch_id` bigint(20) NOT NULL,
  `xid` varchar(100) NOT NULL,
  `context` varchar(128) NOT NULL,
  `rollback_info` longblob NOT NULL,
  `log_status` int(11) NOT NULL,
  `log_created` datetime NOT NULL,
  `log_modified` datetime NOT NULL,
  `ext` varchar(100) DEFAULT NULL,
  PRIMARY KEY (`id`),
  UNIQUE KEY `ux_undo_log` (`xid`,`branch_id`)
) ENGINE=InnoDB AUTO_INCREMENT=1 DEFAULT CHARSET=utf8;
上图是我们对应该项目使用的SQL脚本,同时可以看到,针对一些特殊的字段进行了一些特殊的限制,例如,对一些字段进行了check校验,必须大于0
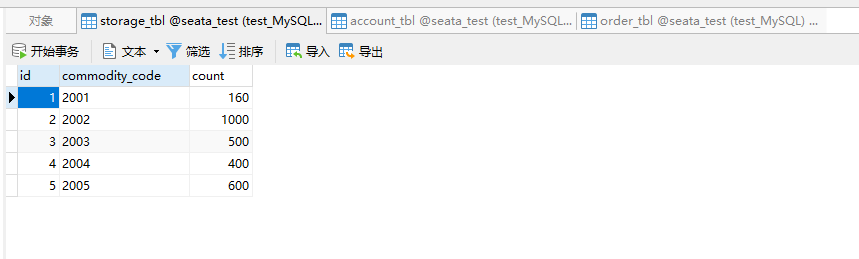
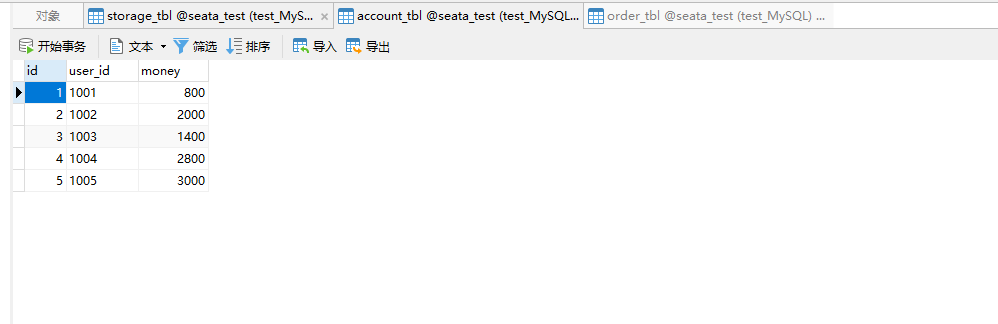
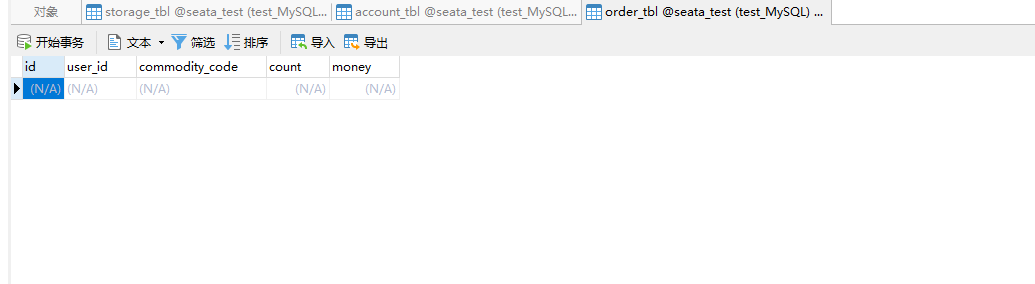
这是测试之前的状态
当进行正常的测试的时候
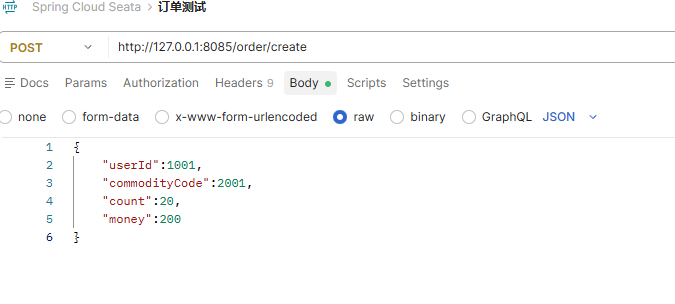
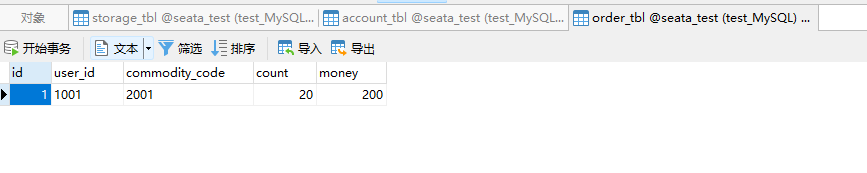
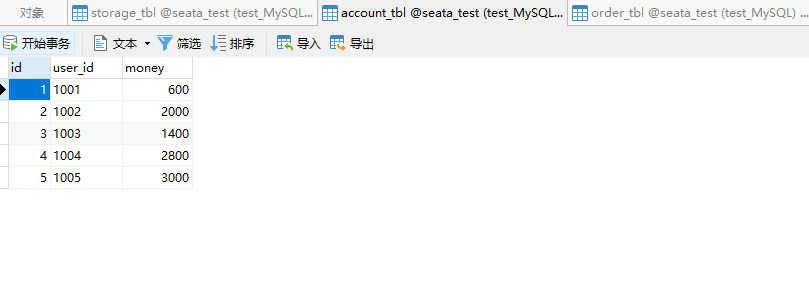
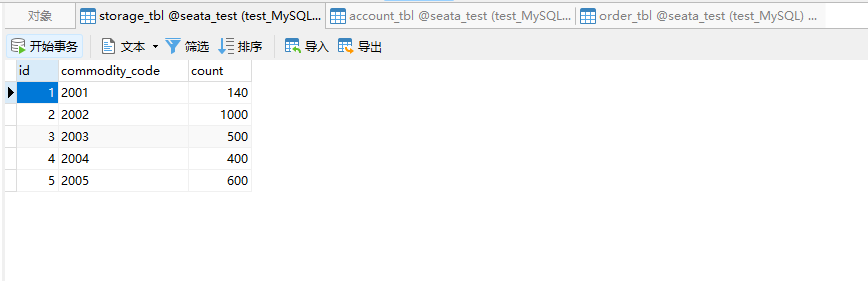
可以发现,是可以测试成功的
但是当我进行错误测试的时候
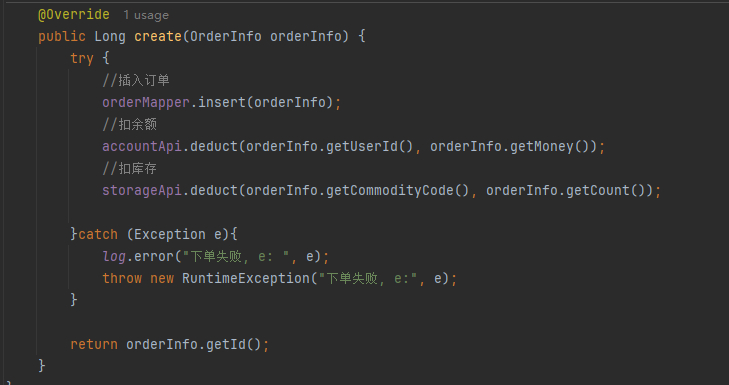
在订单服务中,先进行了扣余额的操作,再进行了扣库存的操作
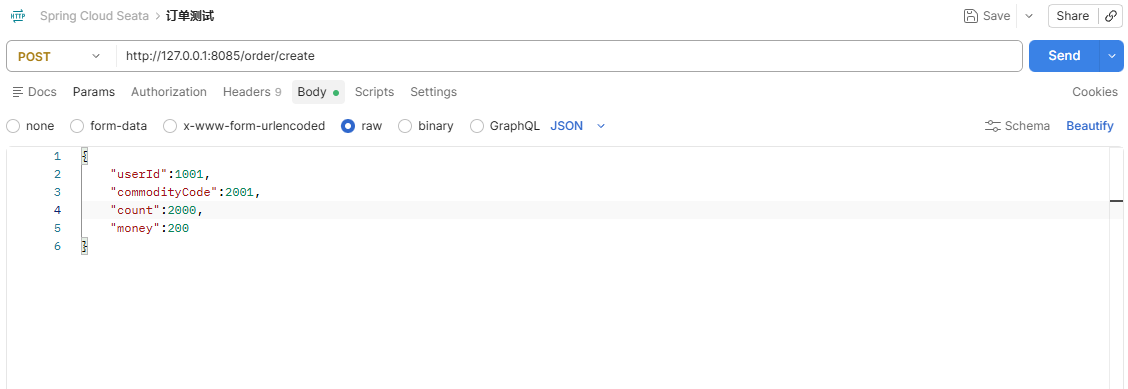
此时,我们将库存增加到了200,那么显然是不符合标准的
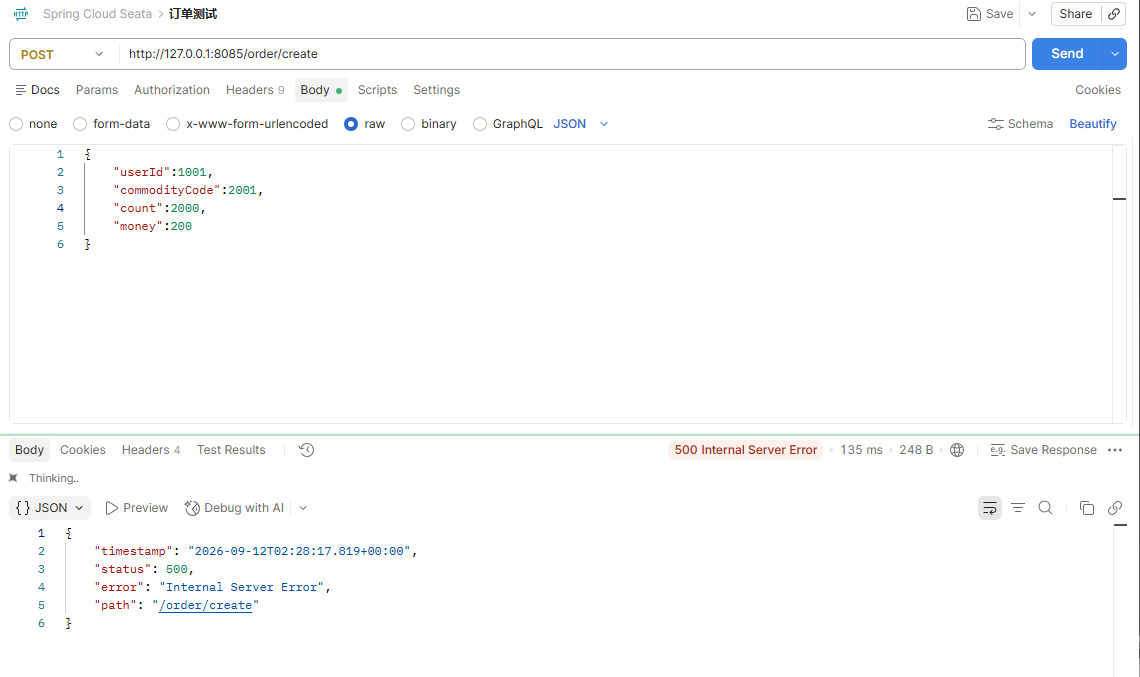
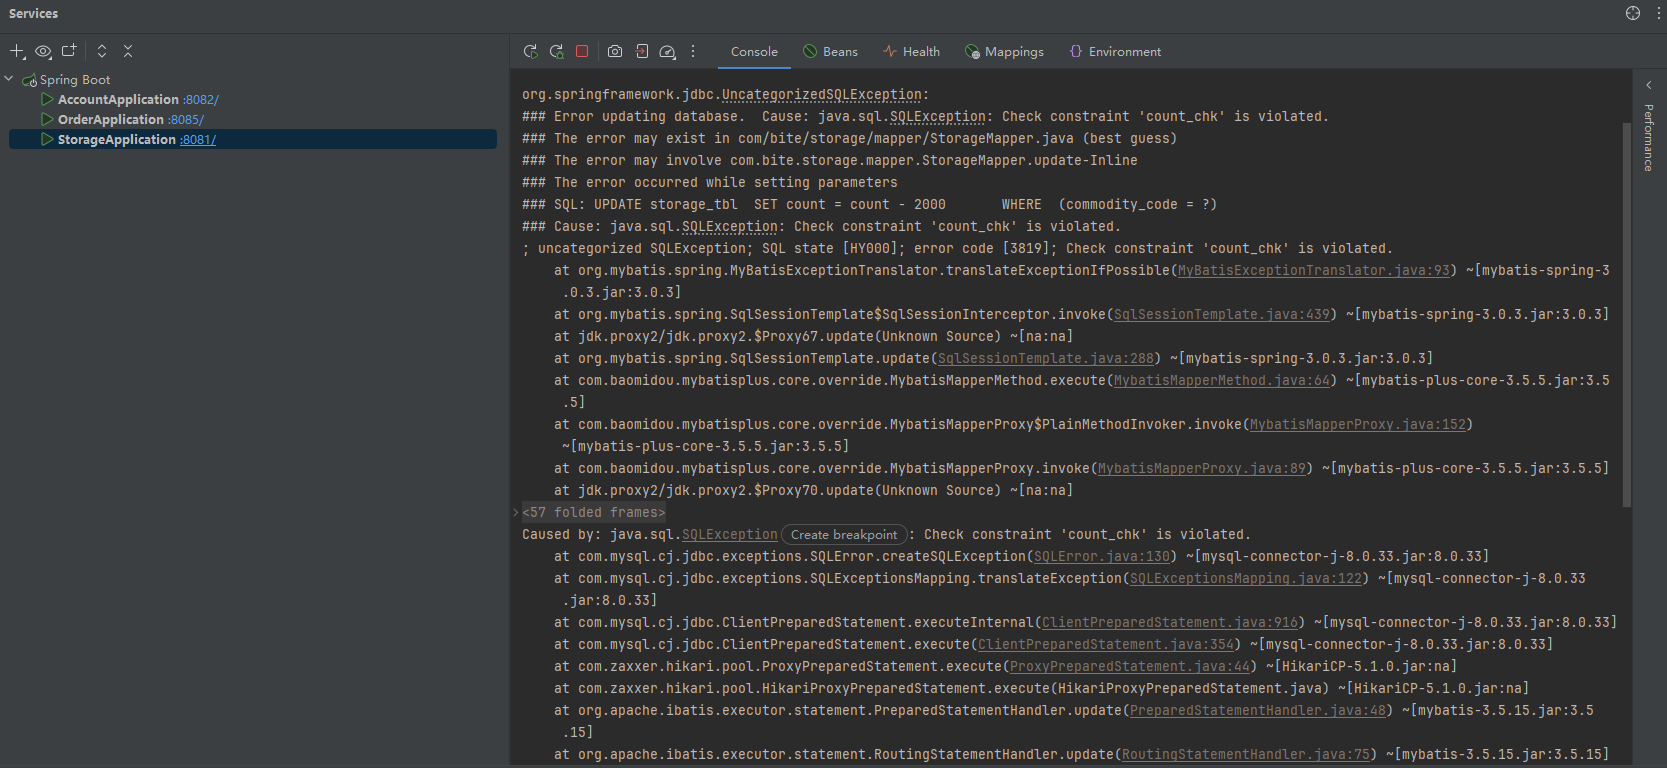
在StorageApplication中报错了,
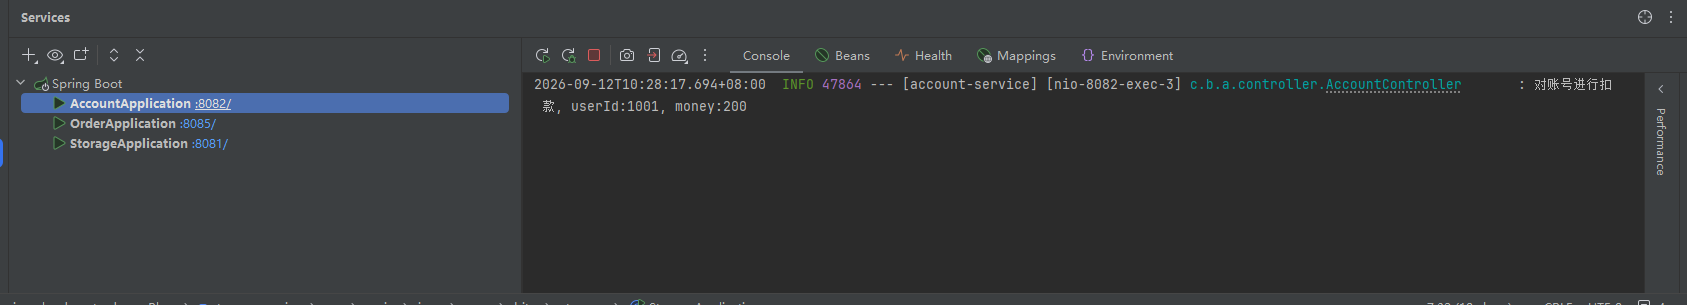
但是对应余额来说,已经扣除完成了
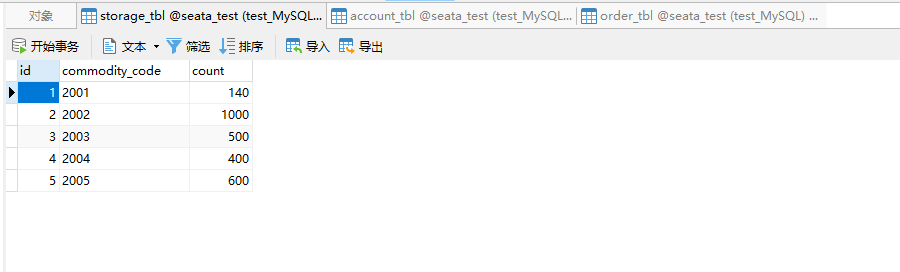
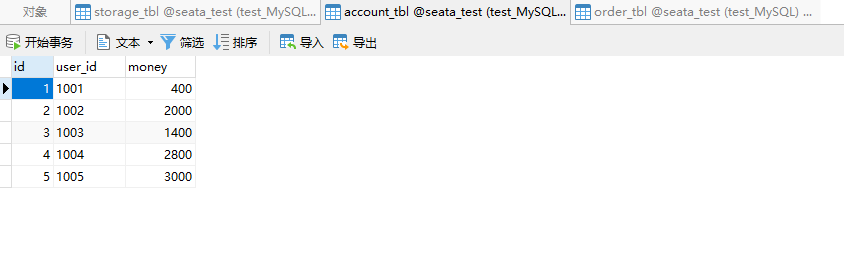
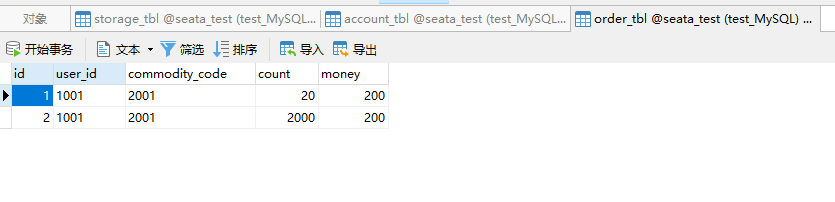
可以看到,订单服务和用户服务都已经操作成功了,唯独库存服务没有执行成功。按照正常的思维,整个事务是需要进行回滚的,但是现在并没有进行回滚。这就是有问题的,这个问题就是分布式事务问题
(四).分布式事务存在问题的理论模型
分布式事务问题也叫做分布式数据一致性问题,即如何在分布式场景中保证多个节点数据的一致性问题。分布式事务问题产生的核心原因在于存储资源的分布性,例如不同的数据库如何保证数据一致性问题。接下来就来介绍分布式事务问题的常见解决方案,在介绍之前,我们需要先了解一些基础理论。
1.CAP理论
在前面介绍Eureka,Nacos等注册中心的时候,就介绍到过CAP理论
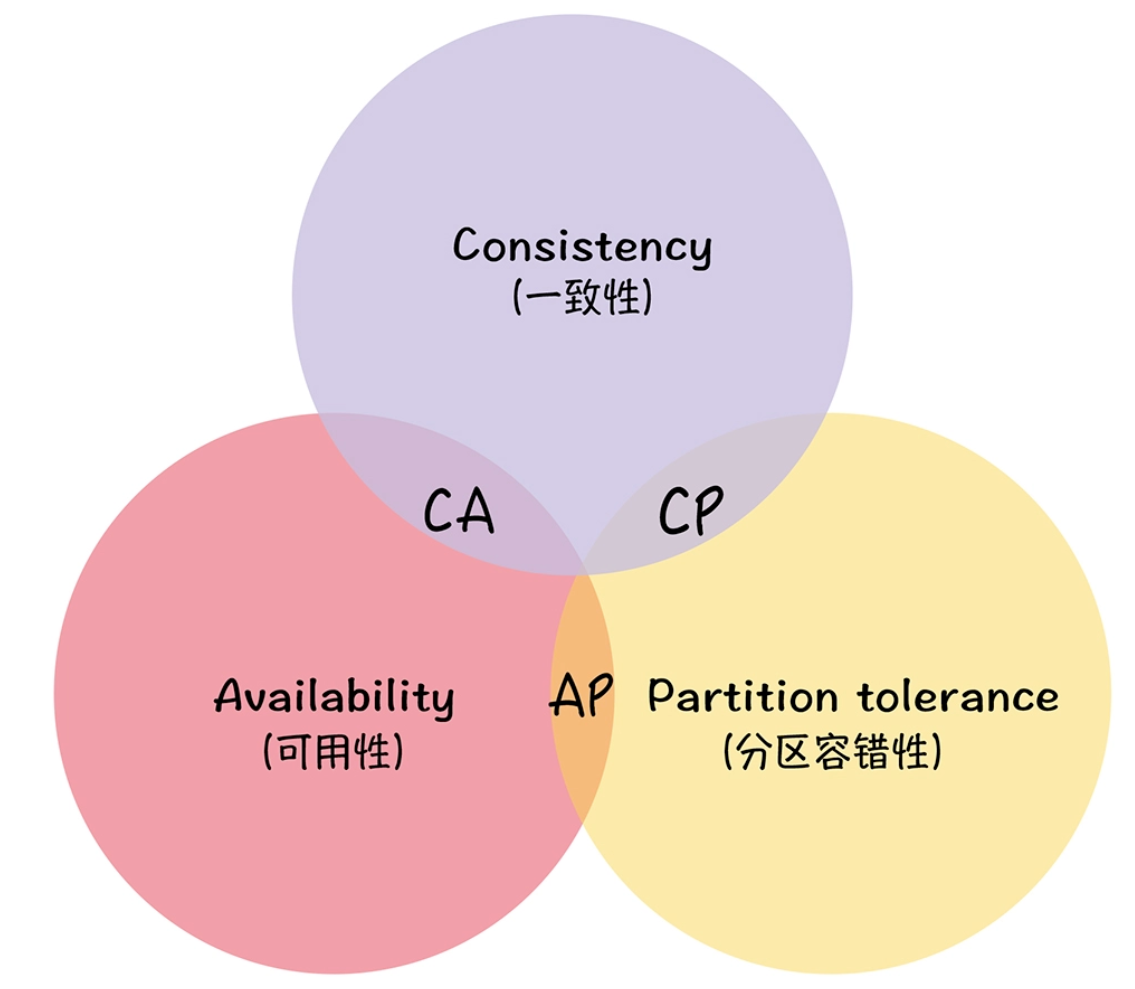
CAP理论是分布式系统设计中最基础,也是最关键的理论。
C:一致性,这里指的是"强一致性",所有节点都在同一时间具有相同的数据
A:可用性,保证每个请求都有响应,但是响应的结果可能不对
P:分区容错性,当网络出现分区后,系统仍然能够对外提供服务
在一个分布式系统中,不可能同时满足数据一致性,服务可用性和分区容错性这三个基本需求,最多只能满足其中的两个。这是因为,在分布式系统中,系统网络不可能100%保证健康,服务又必须对外保证服务,所以分区容错性(P)是不可少的,那么就只能在C和A中选一个,即CP架构或者AP架构。
CP架构:为了保证分布式系统对外的数据一致性,所以不返回数据。
AP架构:为了保证分布式系统的可用性,返回当前的数据,即使这个数据不正确。
2.BASE理论
BASE理论是由于CAP中一致性和可用性不可兼得而衍生出来的一种新的思想,BASE理论的思想是通过牺牲数据的强一致性来获得高可用性。
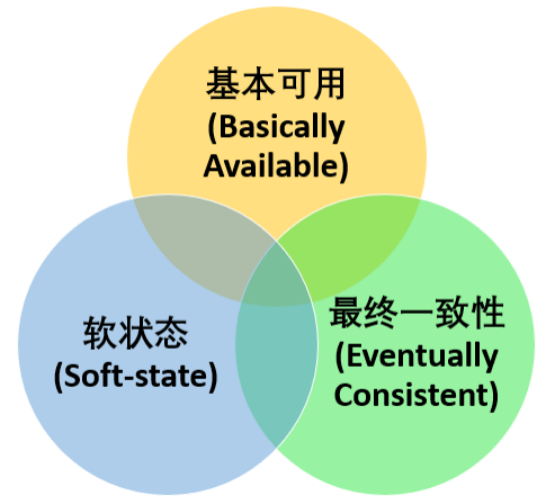
Basically Available (基本可用):在分布式系统出现故障的时候,允许损失一部分功能的可用性,保证核心功能的可用。
Soft-state (软状态):允许系统中的数据存在中间状态,即允许系统中不同节点的数据副本之间的同步存在演示,这个状态不影响系统的可用性。
Eventually Consistent (最终一致性):中间状态的数据在经过一段时间之后,会达到一个最终的数据一致性。
例如,在某宝双十一的时候,此时处于流量的高峰期,那么某宝就可以放弃一些广告推广的功能,来保证双十一的正常可用。这就是 Basically Available。
例如,用户A,用户B和用户C,三个用户互为好友,当A发了一个朋友圈,B看到了,C没有看到,但是过段时间之后,C才看到。对于"B看到了,C没有看到"这个操作就是 Soft-state ;对于"过段时间之后,C才看到"这个操作就是 Ecentually Consistent。
BASE理论不要求数据的一致性,它允许数据在一段时间内是不一致的,但是数据最终会在某个时间点实现一致。
BASE理论和CAP理论的对比
CAP理论:一个分布式系统不可能同时满足一致性,可用性,分区容错性三个特性。
BASE理论:BASE理论是对CAP理论的补充,通过放宽对一致性的要求,换取系统更高的可用性和灵活性。如果不是必须的话,不推荐使用事务或强一致性,允许在牺牲一定一致性的前提下获得更高的可用性。
3.X/Open分布式事务模型
X/Open是一个组织,X/Open DTP 是X/Open这个组织定义的一套分布式事务的标准 ,这个标准提出了两阶段提交(2PC,Two-Phase-Commit)来保证分布式事务的完整性。
X/Open包含了三种角色:
AP:Application,应用程序
RM:Resource Manager,资源管理器,例如数据库。应用程序可以通过资源管理器对相应的资源进行有效的控制。
TM:Transaction Manager,事务管理器,事务协调者,负责协调和管理各个子事务,即管理RM
TM出现的场景:·在分布式系统中,会有多个节点,每一个节点都知道自己的事务结果是成功或者失败的,但是获取不到其他节点的事务操作结果 。所以当一个事务跨越了多个分布式节点的时候,为了保证事务的ACID特性,就需要一个"协调者(TM)"来统一调度所有分布式节点的执行逻辑 ,这些被调度的节点被称为"参与者"(RM)",TM负责调度RM的行为,并最终决定这些参与者是否要把事务真正提交。
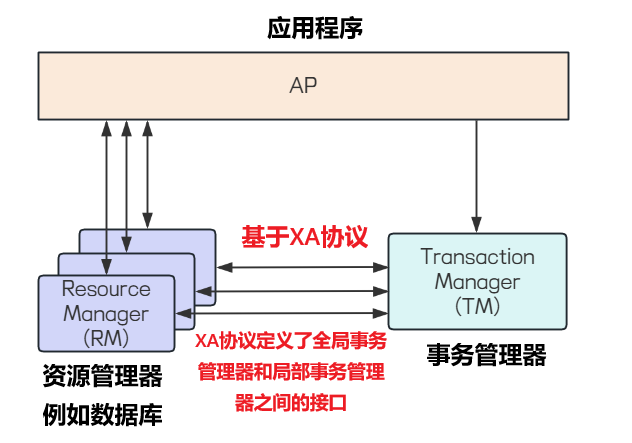
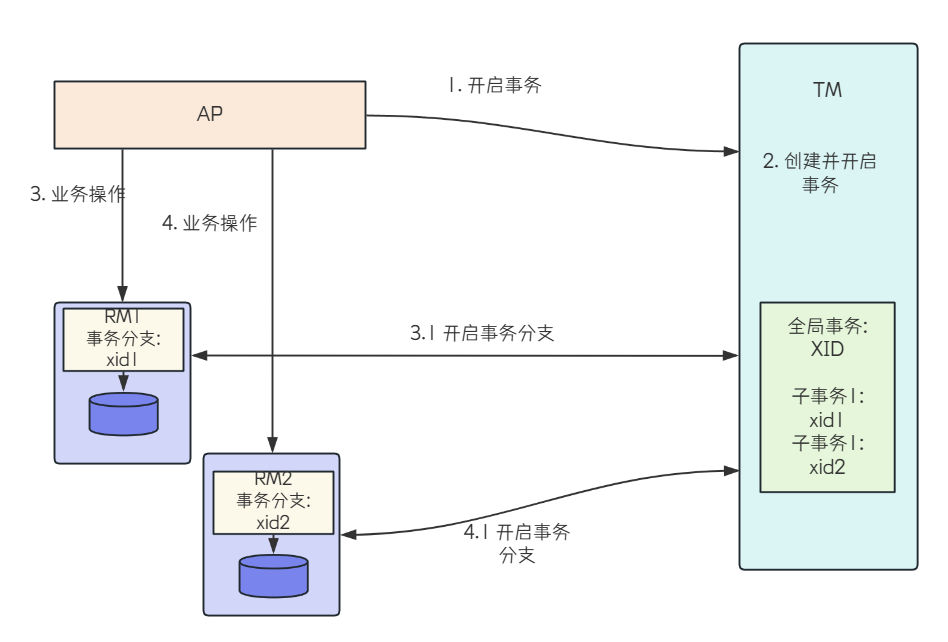
X/Open DTP模型的执行步骤:
①.配置TM,把多个RM注册到TM
②.AP从TM管理的RM中获取连接,例如JDBC
③.AP向TM发起一个全局事务,申城全局事务XID,XID会通知各个RM
④.AP通过第二获得的连接直接操作RM完成数据操作。AP在每次操作的时候都会把XID传递给RM
⑤.AP结束全局事务,TM会通知各个RM全局事务结束。根据各个RM的事务执行结果,执行提交或者回滚。
4.两阶段提交
(1).概念
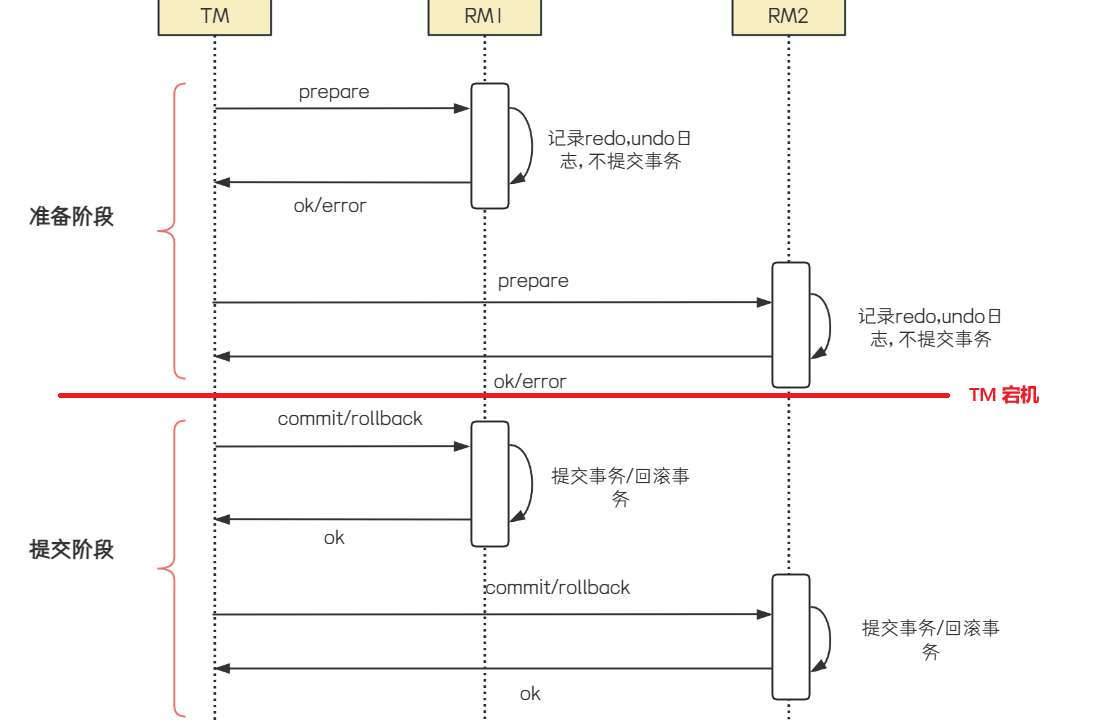
对于两阶段提交,X/Open DTP标准就是使用了两阶段提交来保证分布式事务的完整性,TM对多个RM事务的管理,就会涉及到两个阶段的提交。第一阶段是事务的准备阶段,第二阶段是事务的提交或者回滚阶段。
(2).执行步骤
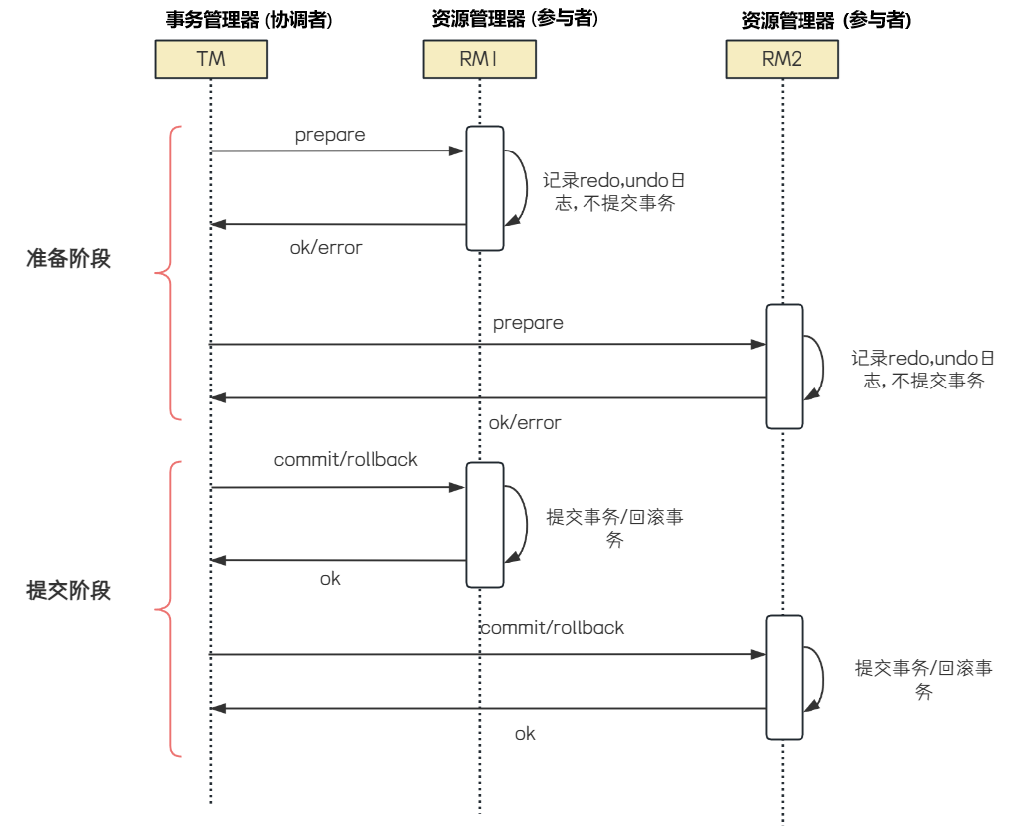
准备阶段:
①.协调者发送请求:协调者向所有的参与者发送prepare请求 ,询问他们是否准备提交事务。在请求中,包含了事务的详细信息,要求参与者对事务进行预处理,并准备好回滚或者提交事务所需要的所有资源。
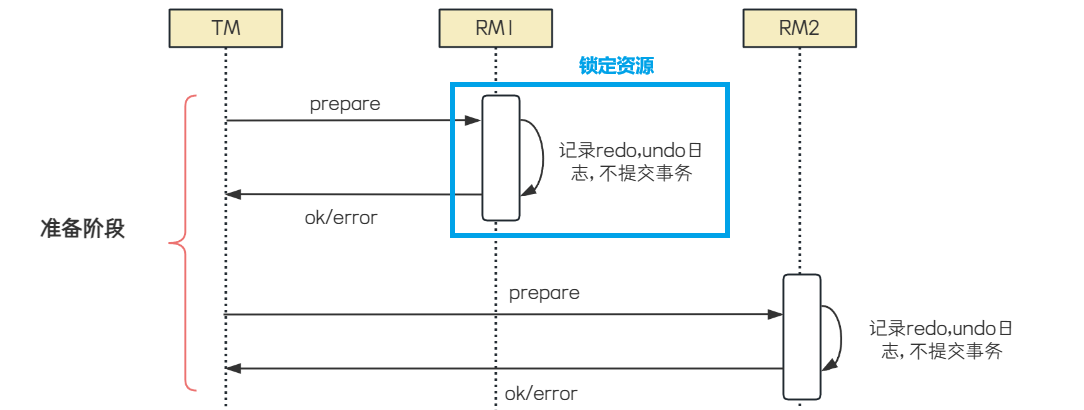
②.参与者响应请求:参与者收到prepare请求后,会执行事务操作(锁定资源),但不提交。如果参与者执行事务成功了,此时会将事务的执行结果和准备状态记录在本地日志中,并向协调者发送ready消息,表示已经准备好了提交事务;如果执行失败或者无法准备,则向协调者发送abort消息。
提交阶段:
①.协调者根据准备阶段的反馈进行决策:当协调者收到所有参与者的相应之后,会根据反馈的结果做出决策,如果所有参与者都返回ready,则协调者提交事务;如果有任何一个参与者返回abort,则协调者决定回滚事务。注意:这里指的是回滚整个全局事务,全局事务包含了多个子事务。
②.协调者发送提交或回滚事务:A.提交事务:协调者向所有的参与者发送commit请求。参与者接收到请求之后,会正式提交事务,并释放所有资源,然后向协调者发送ack消息,表示事务已成功提交。
B.回滚事务:协调者向所有的参与者发送rollback请求。参与者接收到请求之后,会回滚事务,并释放所有的资源,然后向协调者发送ack消息,表示事务已成功回滚。
(3).优缺点
优点:
①.保证了事务的原子性,通过两个阶段的严格控制,确保了事务要么全部提交,要么全部回滚,从而保证了事务的原子性
②.实现相对简单:相对于其他分布式事务协议,实现相对简单,易于理解和实现。
缺点:
①.阻塞问题:两个阶段都是事务阻塞型的,对于每一个指令都有明确的响应,如果在这个过程中,TM宕机或者网络出现故障,则会一直处于阻塞状态。"三阶段提交"解决了这个问题
②.资源占用:参与者收到preprare请求后,会执行事务,锁定相关资源来保证事务的原子性。在整个两个阶段提交过程中,这些资源一直被锁定,直到提交或者回滚完成。导致资源利用率第,其他事务可能因为无法获取所需资源而等待。
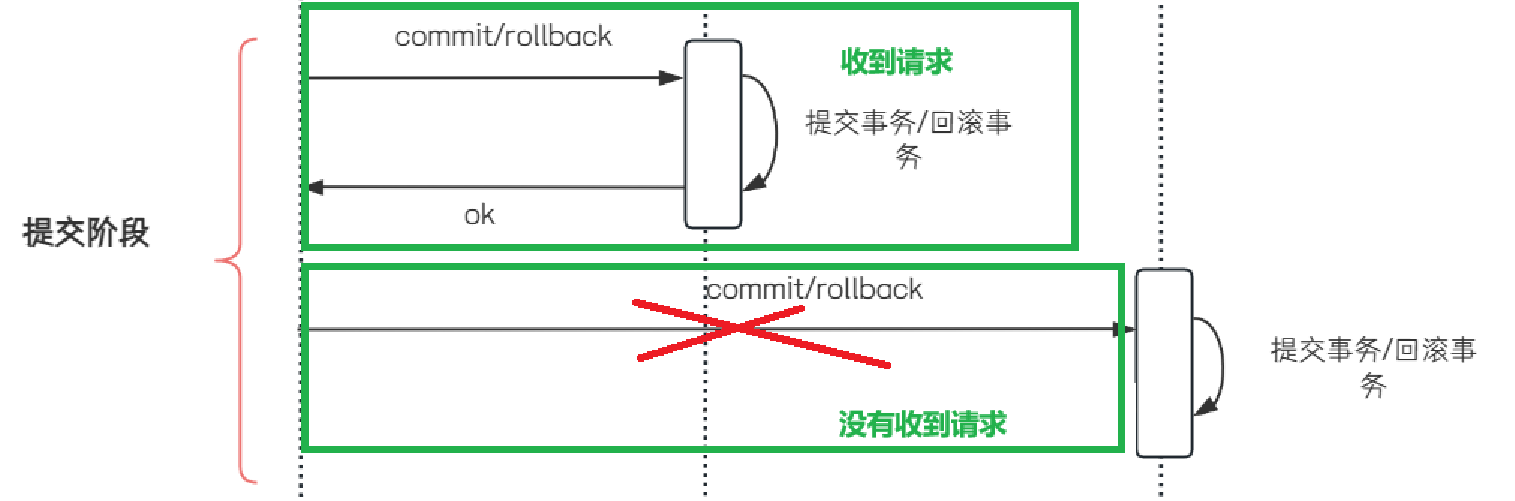
③.数据不一致:第二阶段中,TM向所有的RM发送commit请求,由于网络异常,可能会导致一部分RM没有收到commit请求,所以事务无法提交,出现数据不一致的情况
5.三阶段提交
(1).概念
3PC(Three-Phase-Commit),是2PC的改进版本,分为CanCommit,PreCommit和DoCommit三个阶段。
(2).执行步骤
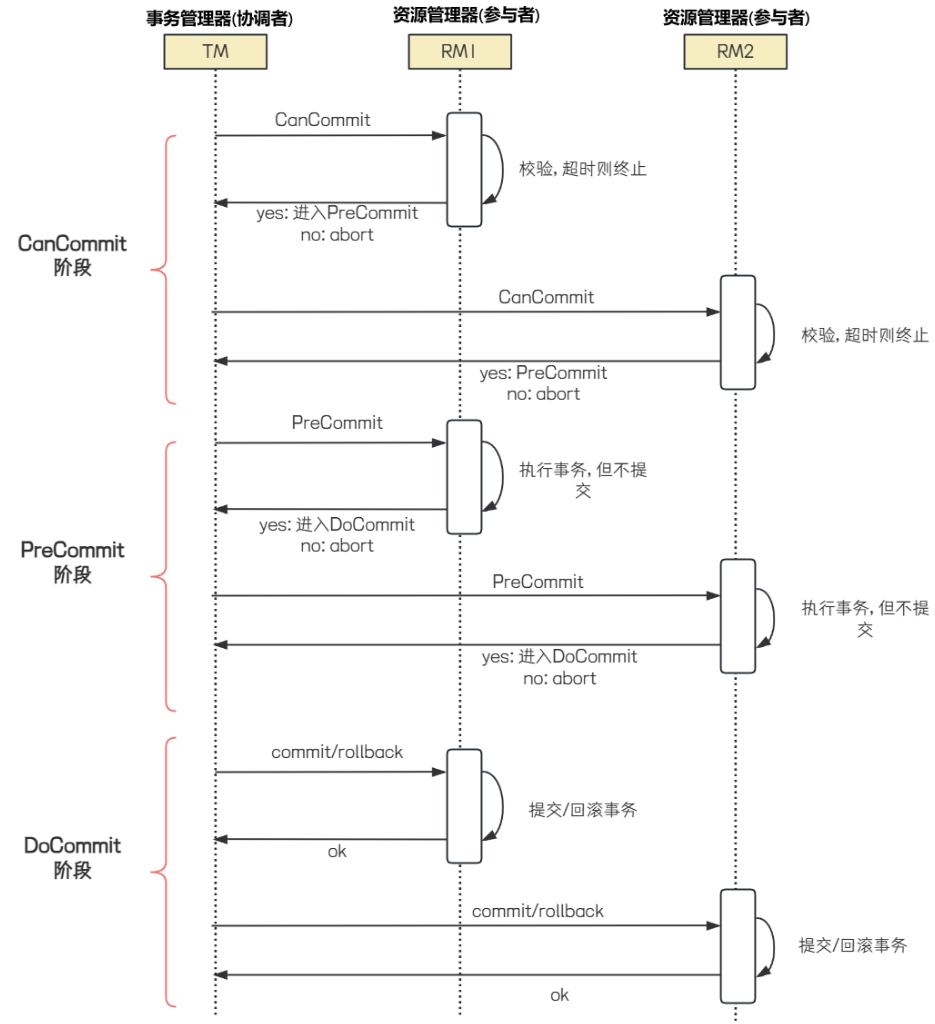
CanCommit阶段:
①.协调者发送请求:协调者向所有的参与者发送CanCommit请求,询问他们是否可以执行事务提交操作,这个阶段不涉及到实际的数据修改,只用来确认每个参与者是否有足够的资源和条件来完成事务。
②.参与者响应:参与者根据自身情况返回Yes或No,如果所有的参与者都返回Yes,则进入PreCommit阶段;只要有一个返回No,则全局事务发生回滚。
PreCommit阶段:
①.协调者发送PreCommit请求:协调者向所有的参与者发送PreCommit请求,询问是否可以进行事务的预处理操作。
②.参与者准备事务:参与者执行事务操作,并将事务的执行结果和准备状态(Yes/No)发送给协调者。参与者会记录预提交日志,并确保这些日志是持久化的。
③.协调者收集反馈并决策:如果所有参与者都返回Yes,则进入DoCommit阶段,如果有任何一个参与者返回No或超时未响应,协调者会发送abort请求,通知所有参与者回滚事务。
DoCommit阶段:
①.协调者发送DoCommit请求:协调者向所有参与者发送DoCommit请求,指示他们正式提交事务。
②.参与者执行提交:参与者收到DoCommit请求后,执行事务提交操作,并向协调者发送Ack消息,表示事务已提交。
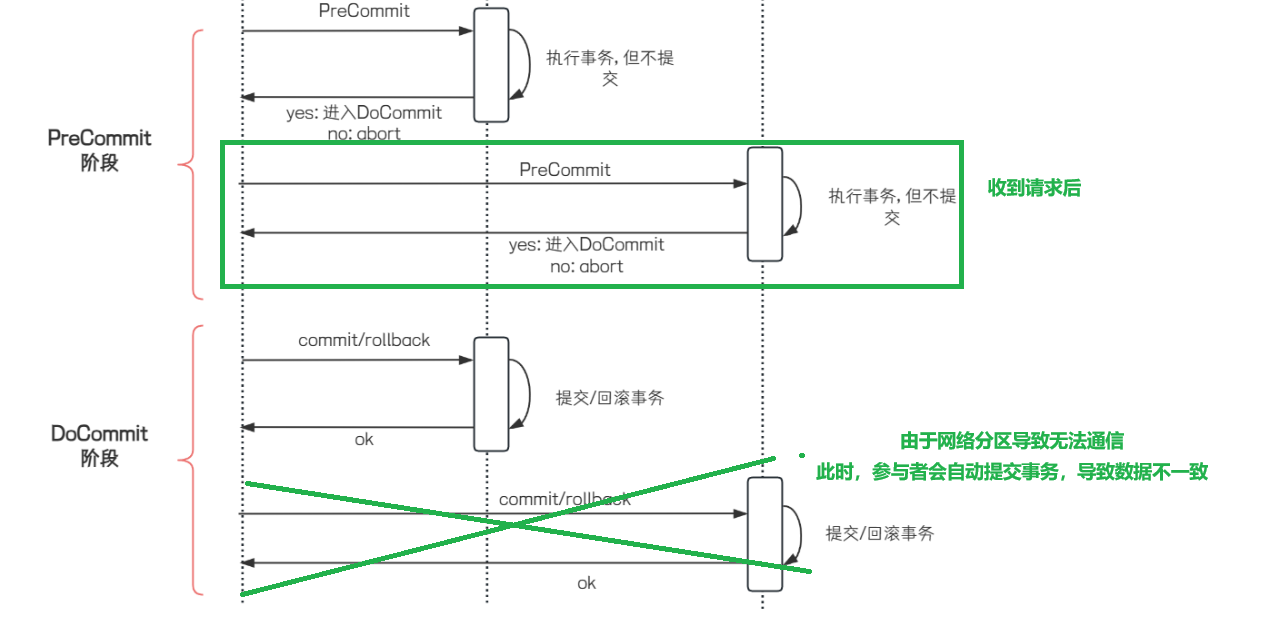
③.超时机制:如果参与者在等待DoCommit请求时超时,会默认执行提交操作。
(3).优缺点
优点:
①.减少阻塞:三阶段提交通过引入了超时机制,减少了二阶段提交的阻塞问题,避免了资源被永久锁定。
②.增强容错能力:及时协调者在DoCommit阶段之前出现故障,参与者也可以基于其预提交的状态自主决定继续提交或回滚事务,从而减少了对协调者的依赖。
缺点:
①.实现复杂度高:三阶段提交的实现比二阶段提交更复杂,增强了系统的开发和维护成本
②.数据不一致风险:在某些情况下,例如网络分区。参与者收到PreCommit消息后,如果网络出现故障,协调者和参与者无法进行后续通信,参与者在超时后可能会自动提交事务,导致数据不一致。
6.TCC事务
(1).概念
TCC(Try-Confirm-Cancel)是一种分布式事务方案。TCC事务相对于传统的两阶段提交,其特征在于它不依赖资源管理器(RM)对XA的支持,而是通过对业务逻辑(有业务系统提供)的接口调用来实现分布式系统。
(2).执行步骤
TCC通过将事务操作拆分为3个阶段:Try阶段,Confirm阶段,Cancel阶段
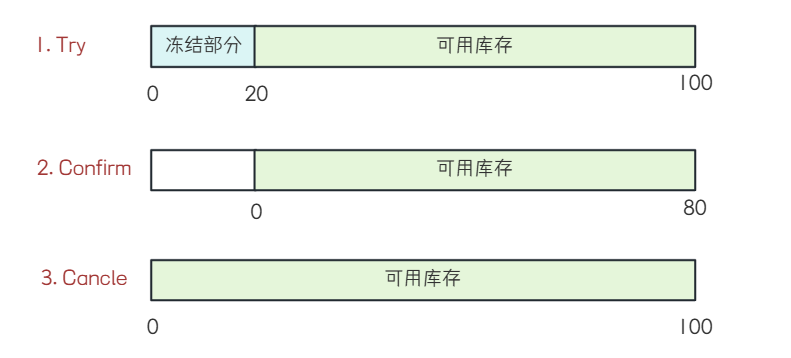
Try阶段:
尝试执行业务操作,完成所有业务的检查,并预留必要的业务资源,这个阶段不真正执行事务,只是进行资源的预占。
Confirm阶段:
如果所有参与者在Try阶段都成功,那么进入Confirm阶段,正式完成操作,使用之前预留的资源。
Cancel阶段:如果任何一个参与者在Try阶段失败,那么进入Cancel阶段,所有参与者回滚在Try阶段的操作,释放预留的资源。
例如"库存扣减"操作,假设库存数量为100个,本次购买20个
Try阶段:对库存数量进行冻结
Confirm阶段:把Try阶段冻结的库存数量进行实际的扣减
Cancel阶段:把Try阶段冻结的库存数量进行解冻
(3).优缺点
优点:
①.无需依赖第三方中间件或数据库来实现分布式事务,降低了系统复杂度和成本
②.无需锁定全局资源,提高了系统的并发性能和利用性
③.适用于各种类型的业务场景,只要能够定义出清晰的Try,Confirm和Cancel逻辑
缺点:
①.需要手动编写三个阶段的业务逻辑,并保证其正确性和一致性,增加了开发难度和维护成本
②.需要考虑各种异常情况和边界情况,并提供响应的补偿策略和重试机制,增加了系统的复杂度和风险。
(五).初识Seata
1.Seata术语
TC(Transaction Coordinator):事务协调者,维护全局和分支事务的状态,驱动全局事务提交或回滚
TM(Transaction Manager):事务管理器,定义全局事务的范围:开启全局事务,提交或回滚全局事务
RM(Resource Manager):资源管理器,管理分支事务处理的资源,与TC交谈以注册分支事务和报告分支事务的状态,并驱动分支事务提交或回滚
Seata分为TC TM RM三个角色,TC 为单独服务端部署,TM和 RM 由业务系统集成
2.微服务集成Seata
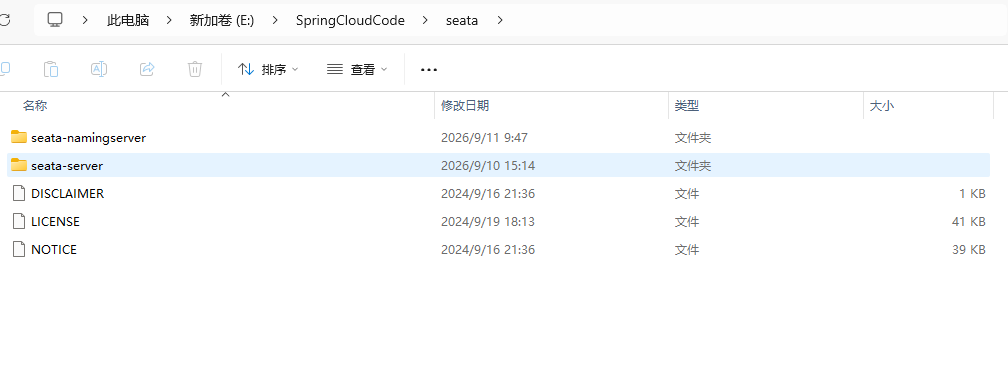
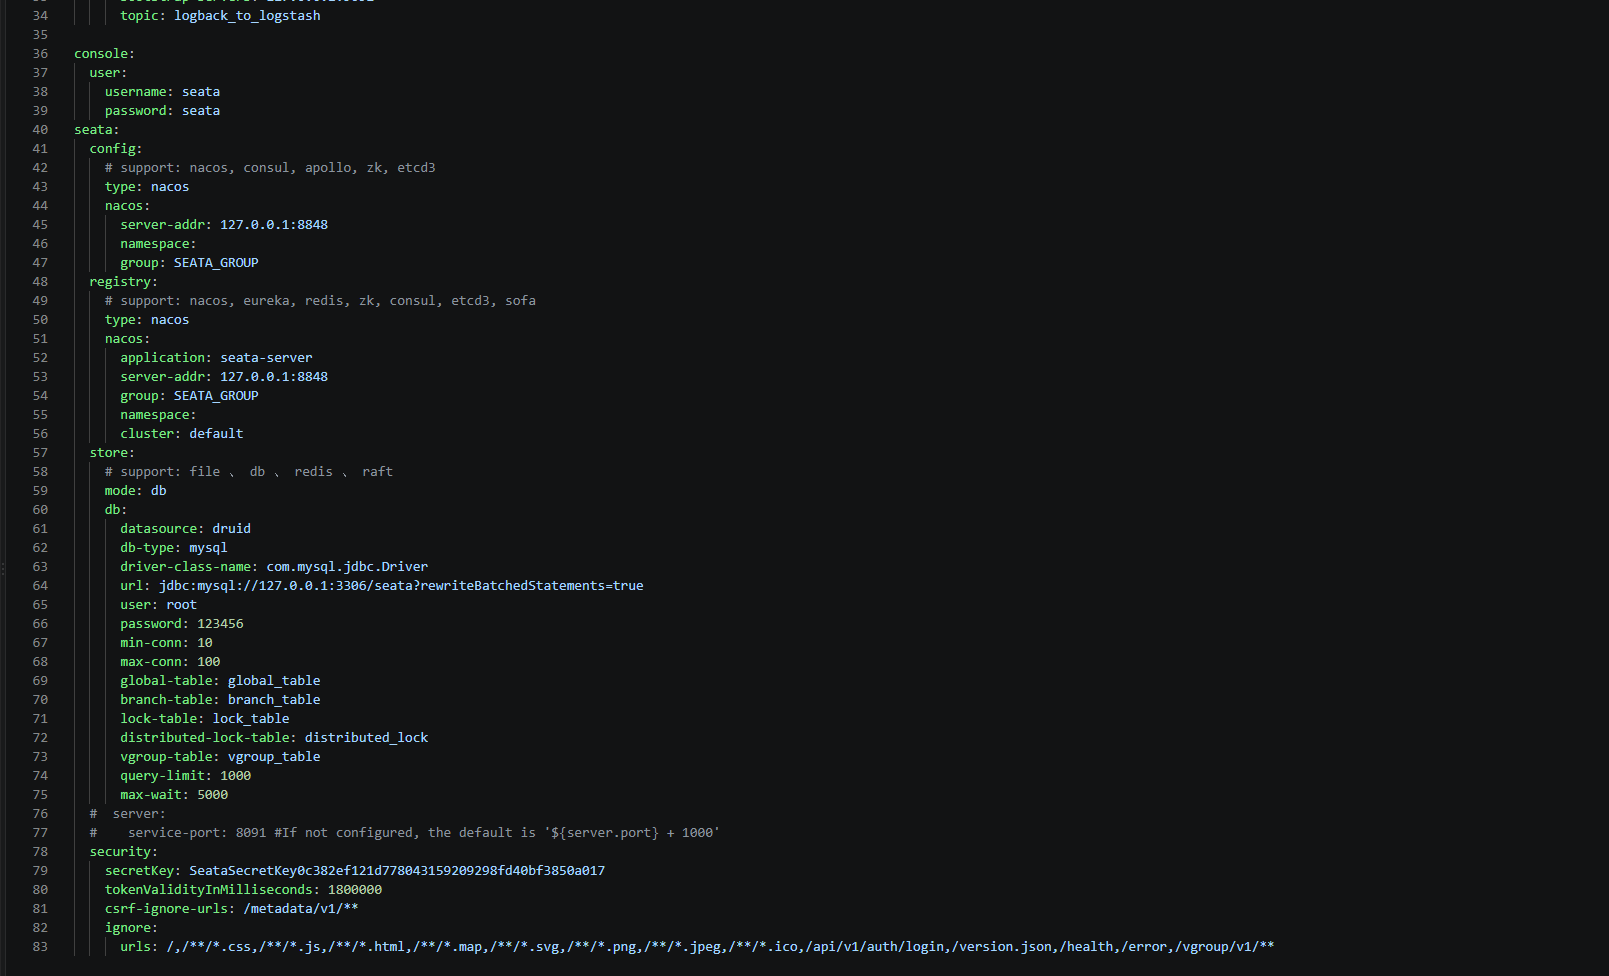
这里我已经将Seata下载好了,并修改了配置文件,我使用的是Nacos
(1).引入依赖
在需要的微服务中引入Seata依赖
XML
        <!--   添加seata依赖     -->
        <dependency>
            <groupId>com.alibaba.cloud</groupId>
            <artifactId>spring-cloud-starter-alibaba-seata</artifactId>
        </dependency>
(2).修改配置文件
在application.yml中添加Seata相关配置。根据配置信息,确定的那个TC服务地址
XML
#Seata的相关配置,通过这些配置,使得account-service客户端能够找到Nacos上的seata-service配置,前提是seata-service要注册到注册中心Nacos上
seata:
  registry: #定义了Seata Server的注册中心配置,微服务根据配置信息去注册中心获取tc服务地址
    type: nacos  #指定注册中心的类型
    nacos:
      application: seata-server  #Seata Server在Nacos中的应用名称
      server-addr: 127.0.0.1:8848  #Nacos服务器地址
      group: "SEATA_GROUP"  #Seata Server在Nacos中的分组名称
      namespace: ""  #Nacos的命名空间,设置为空,表示使用默认的命名空间public
  tx-service-group: default_tx_group  #定义事务服务组的名称
  service:
    vgroup-mapping:
      default_tx_group: default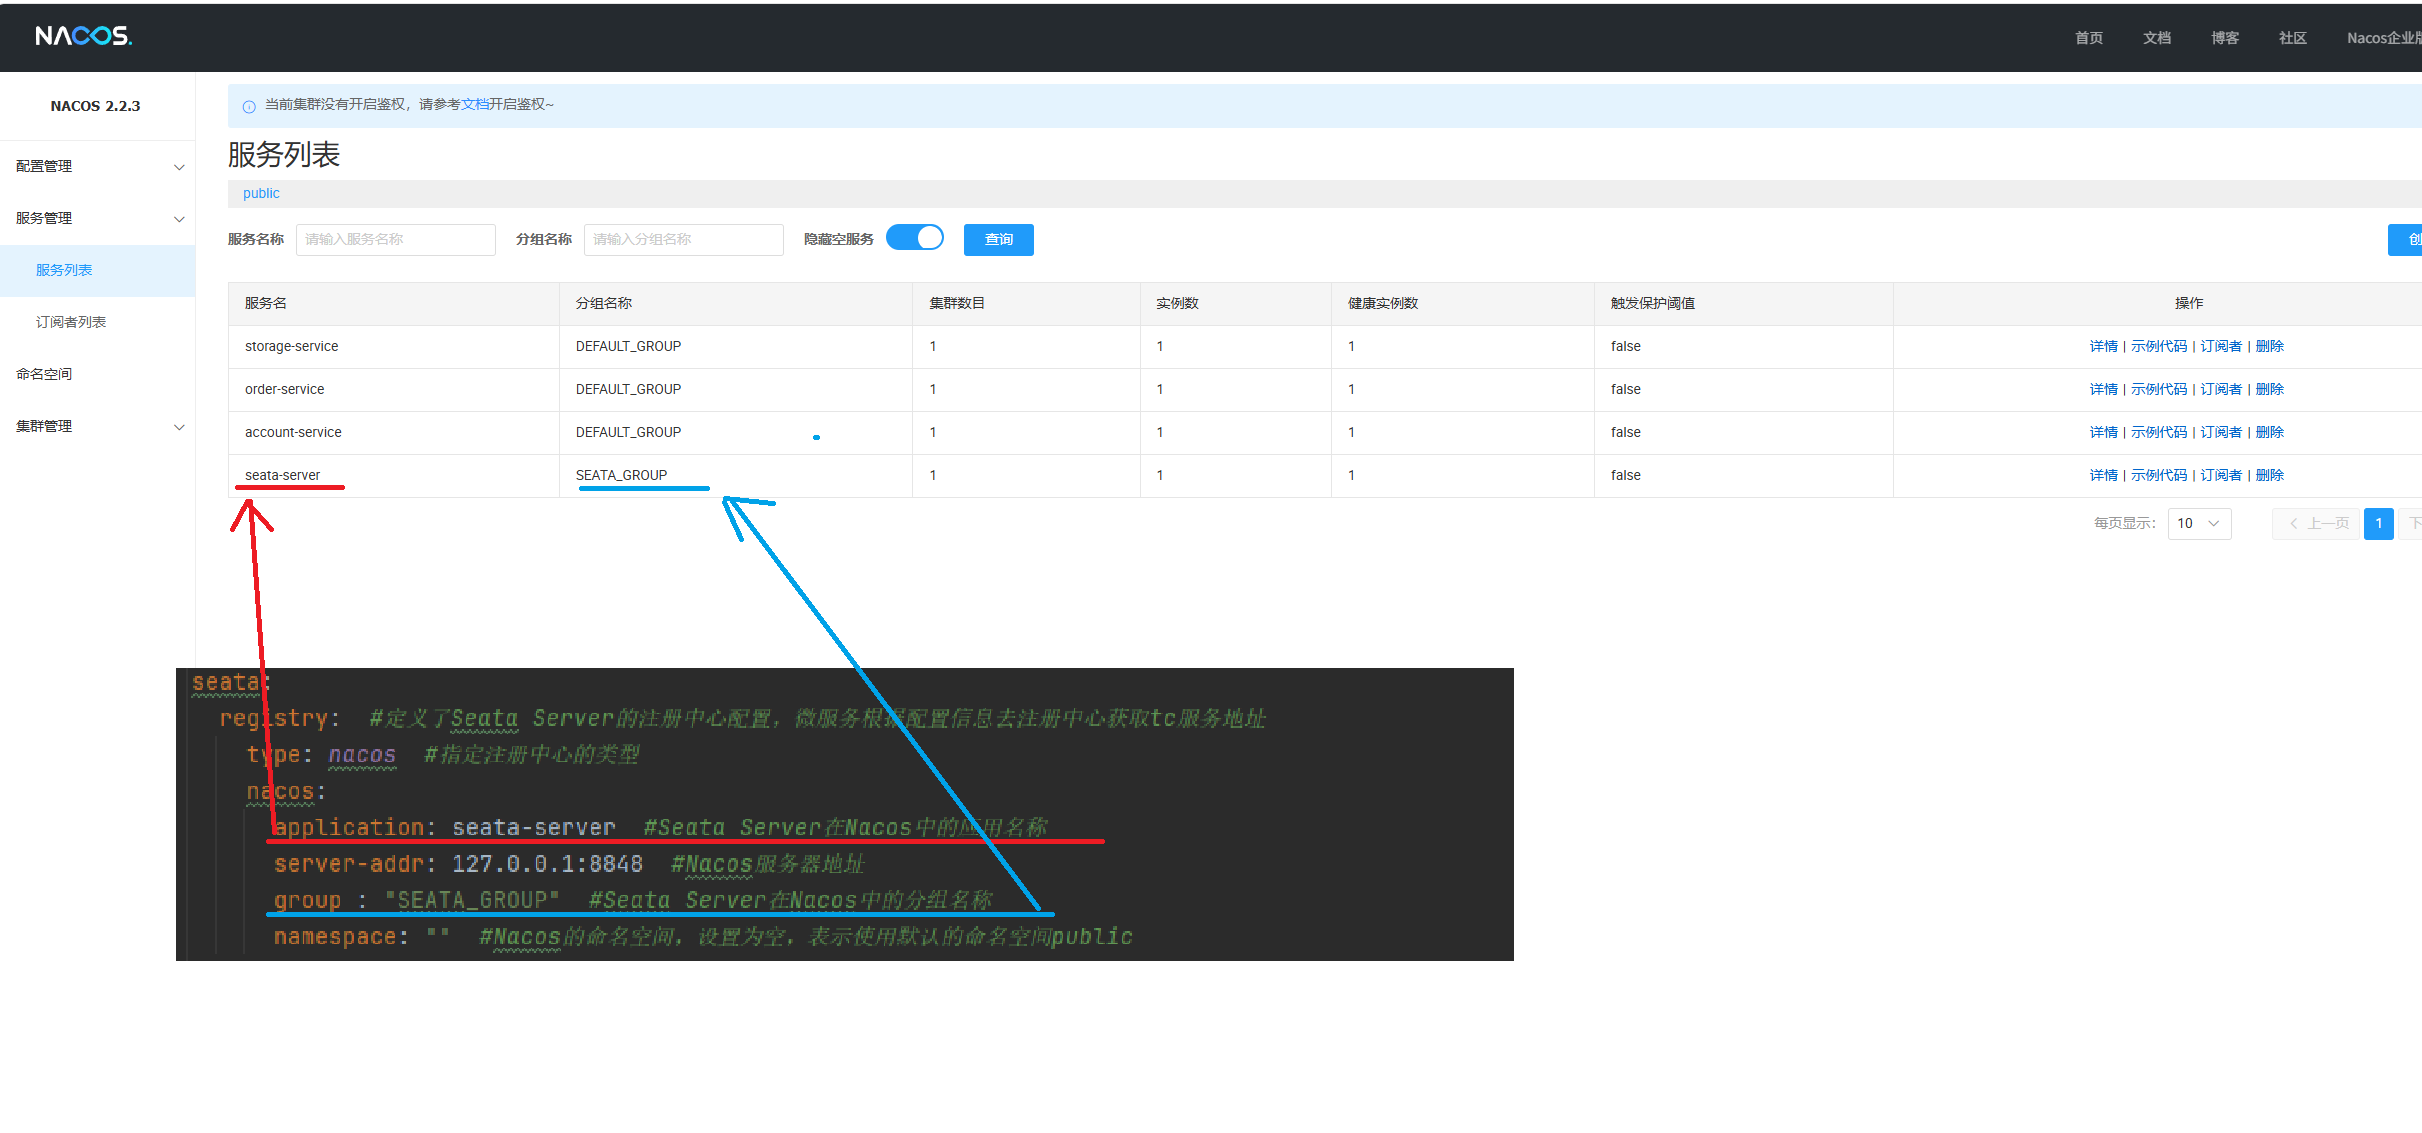
配置文件中的配置要和Nacos中的服务列表对应起来的
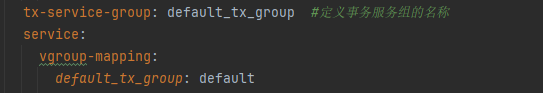
下面主要来介绍这部分配置信息,这些配置信息就使事务分组找到了后端Seata集群
seata.tx-service-group:定义了事务服务组的名称,这里设置为default_tx_group。事务服务组用于将Seata Server 和Seata Client进行分组管理,确保他们能够正确的发现和通信。
seata.service.vgroup-mapping.事务分组名:定义了Seata Server的服务配置,事务服务组到Seata Server集群的映射关系,这里将defalut_tx_group 映射到default集群,这里的default指的是Seata Server的集群名称
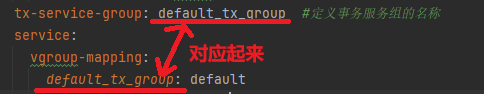
上面的配置信息。在微服务启动时,会根据default_tx_group查找Seata Server。Seata Server在启动时会注册到Nacos的SEATA_GROUP分组中,应用名称为 seata-server,并映射到default集群,这样,Seata Client可以通过Nacos发现并连接到Seata Server,进行事务协调和管理。
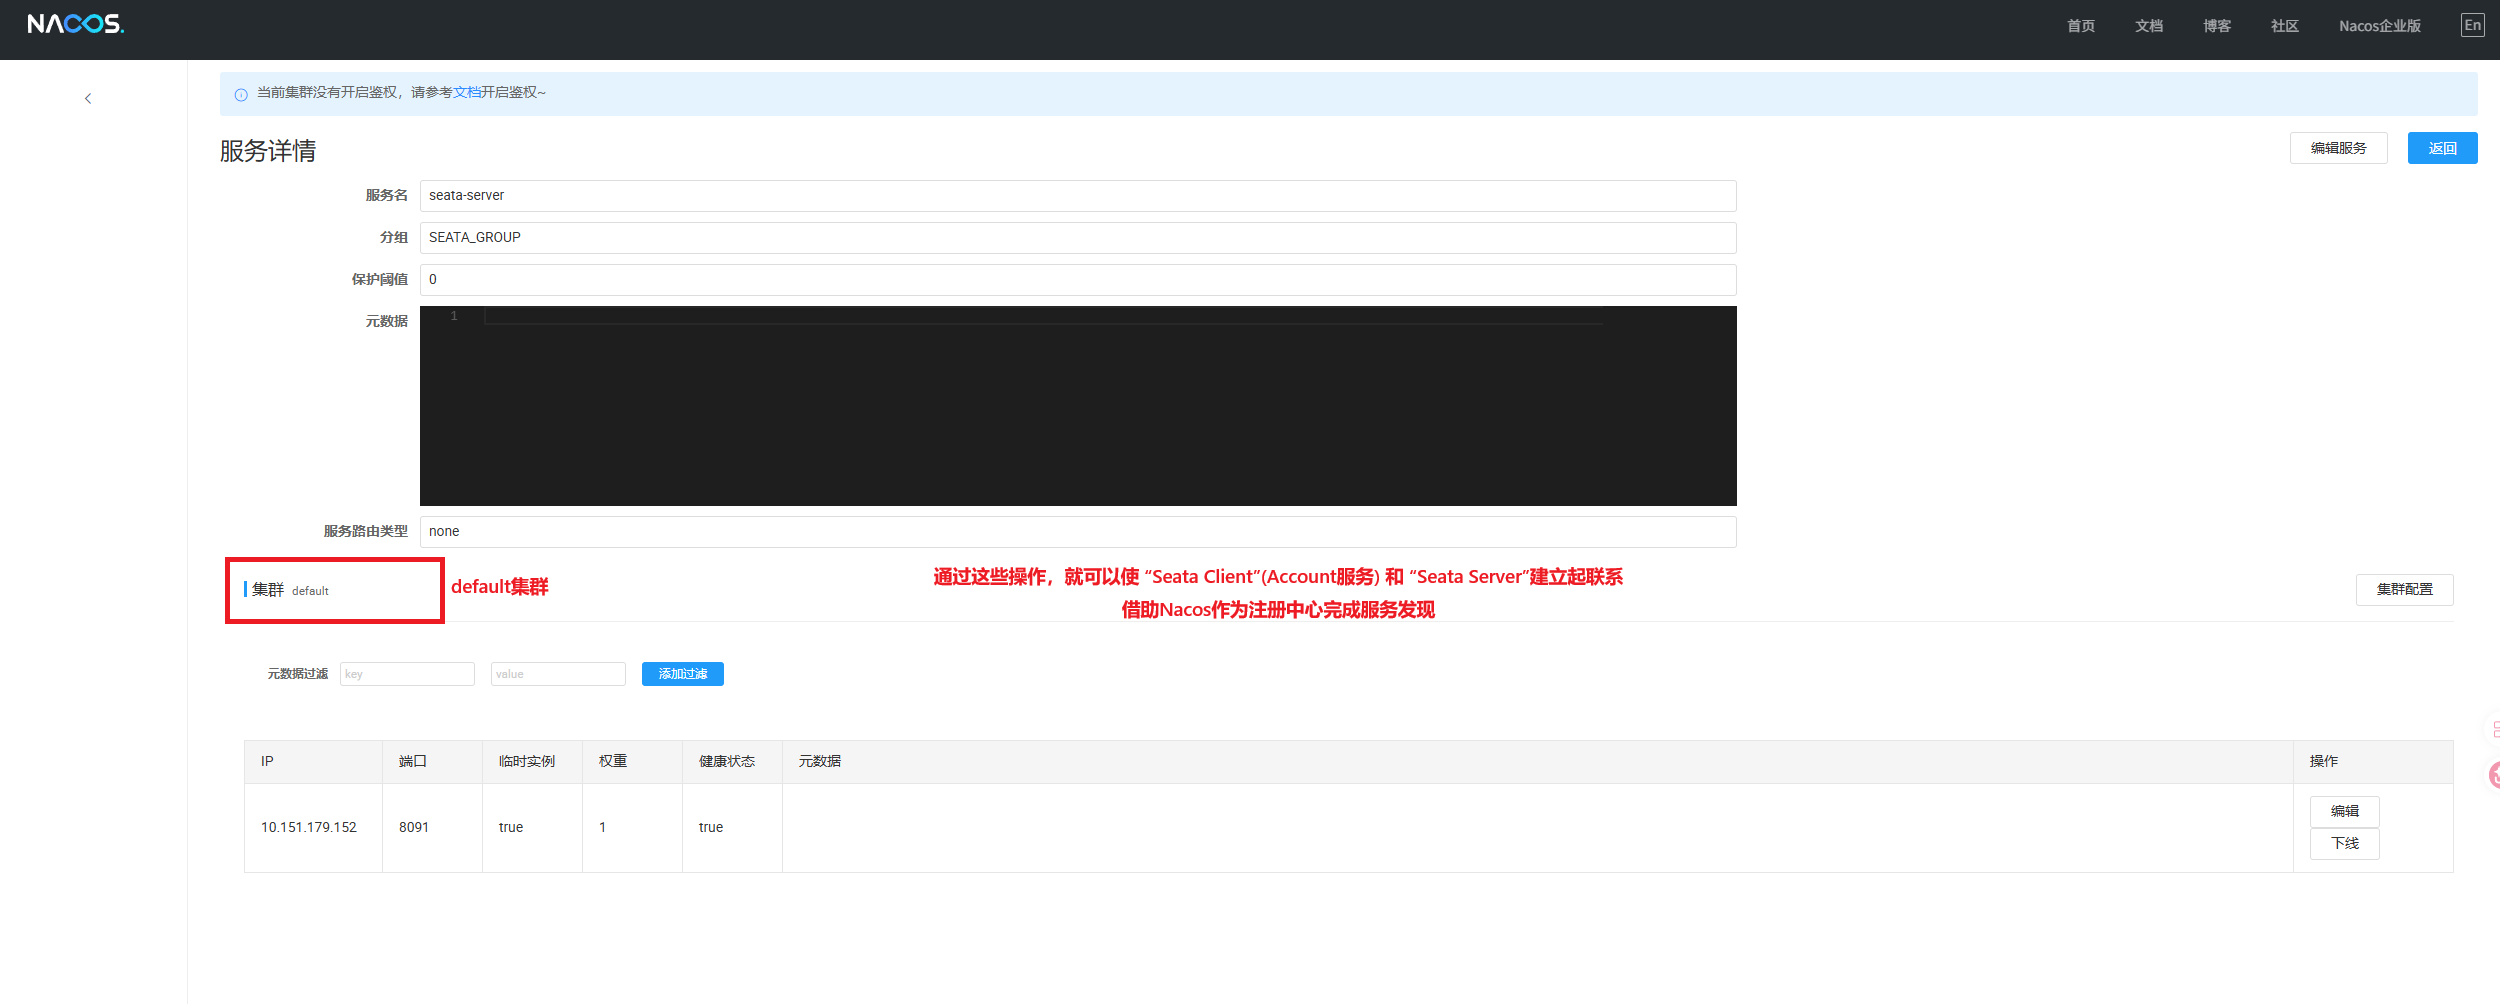
这里,指定的集群是default集群中的机器,因为,在Nacos上,我们可以设置多个集群,所以我们需要指定一下特定的集群
(六).Seata的各种事务模式
Seata提供了多种事务模式,为开发者提供了一站式的分布式事务解决方案。
1.XA模式
(1).模式介绍
XA模式是利用事务资源(数据库等)对XA协议的支持,以XA协议的机制来管理分支事务的一种十五模式。XA实现的原理是基于两阶段提交实现的。
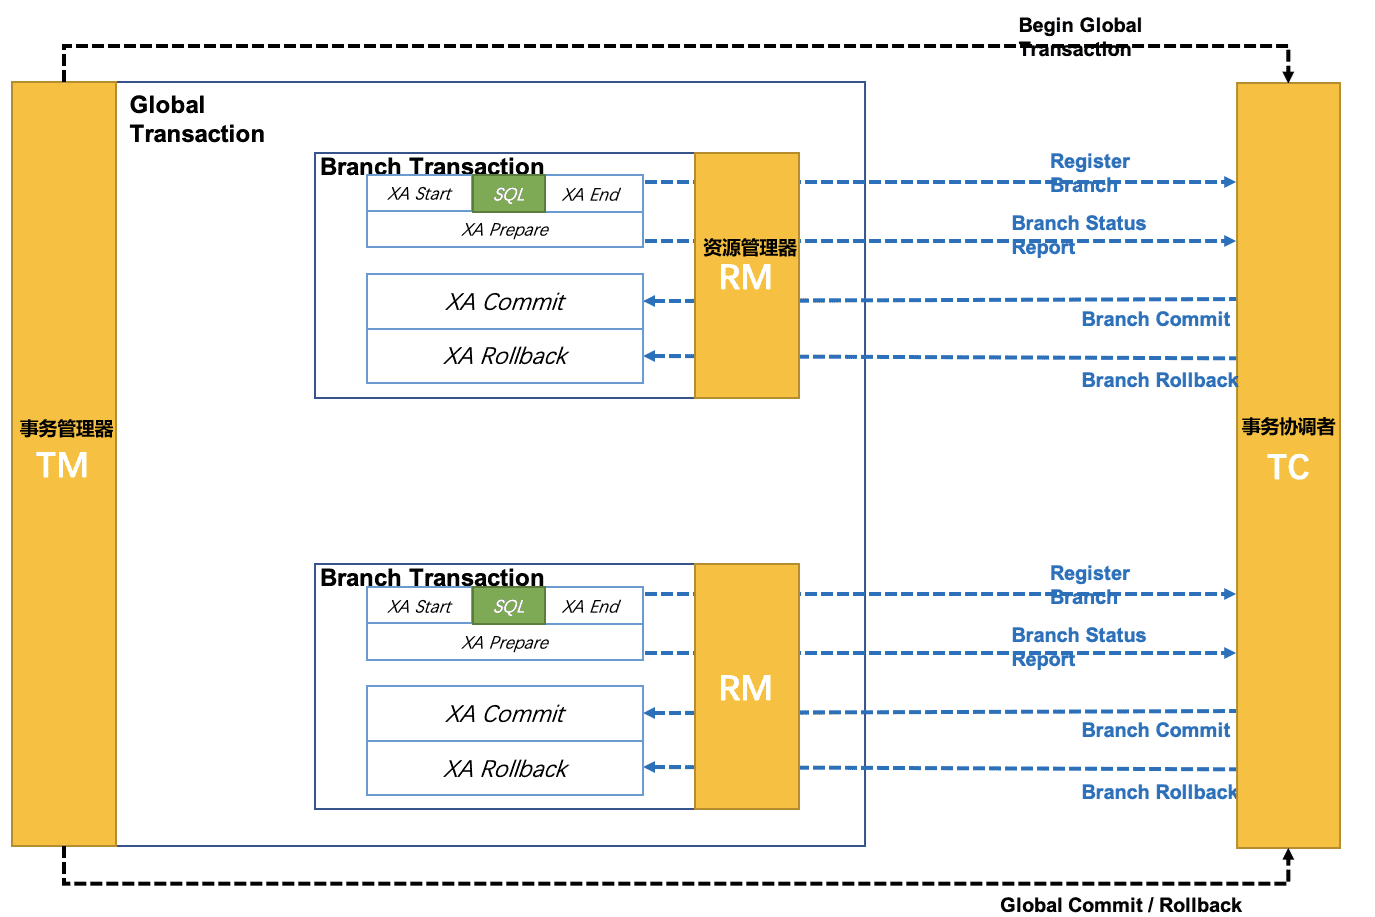
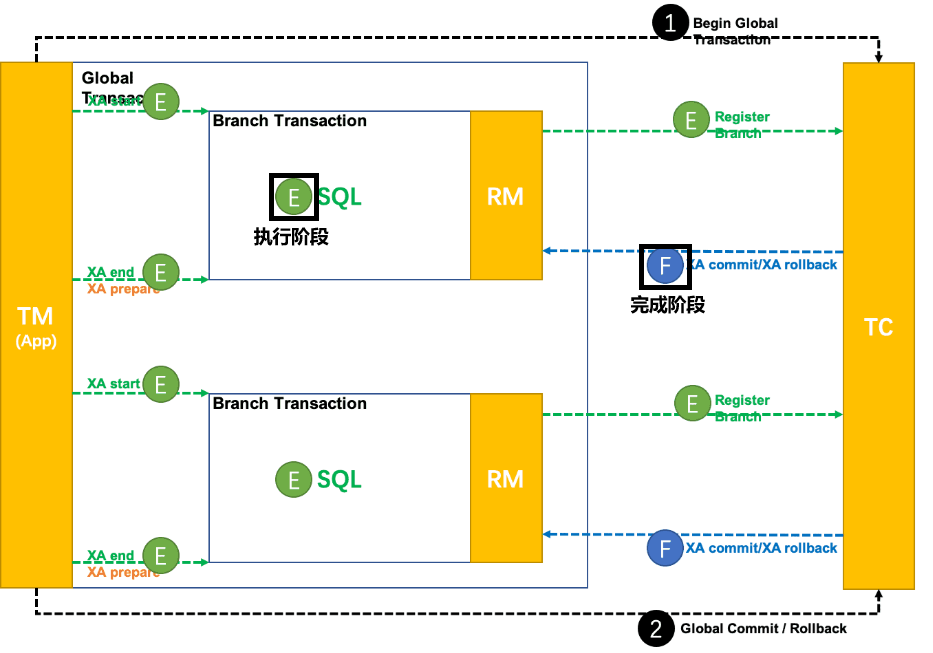
执行步骤:
①.开启事务:TM开启一个全局事务,并与TC建立连接,TC返回一个全局事务ID(XID)给TM
②.分支事务注册与执行:RM收到业务操作请求后,会向TC注册分支事务,执行业务SQL,并携带XID来保证事务的一致性
③.分支事务状态报告:RM执行完分支事务后,向TC报告分支事务的执行状态
④.事务提交或回滚决策:TM在所有分支事务执行完毕后,会通知TC事务结束。TC接收到事务结束通知后,会检查各分支事务的执行状态,如果所有分支事务都执行成功,则TC通知所有RM提交事务;如果有任意一个分支事务执行失败,则TC通知所有RM回滚事务
⑤.分支事务提交或回滚:RM接收到TC的提交或回滚指令后,执行响应的commit或rollback操作
(2).配置和使用
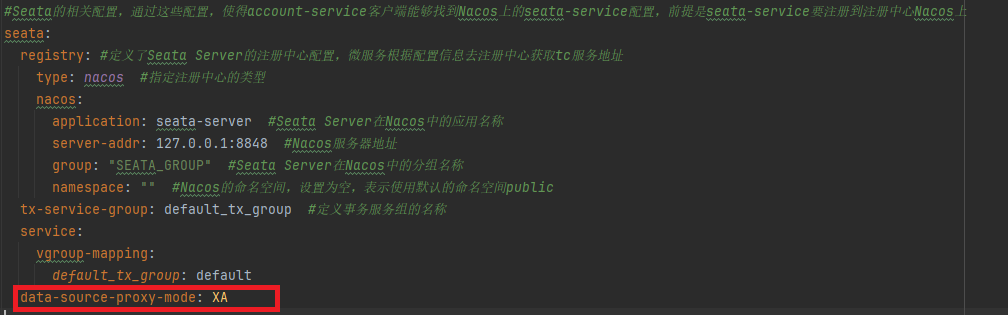
Ⅰ.在application.yml中配置Seata的事务模式
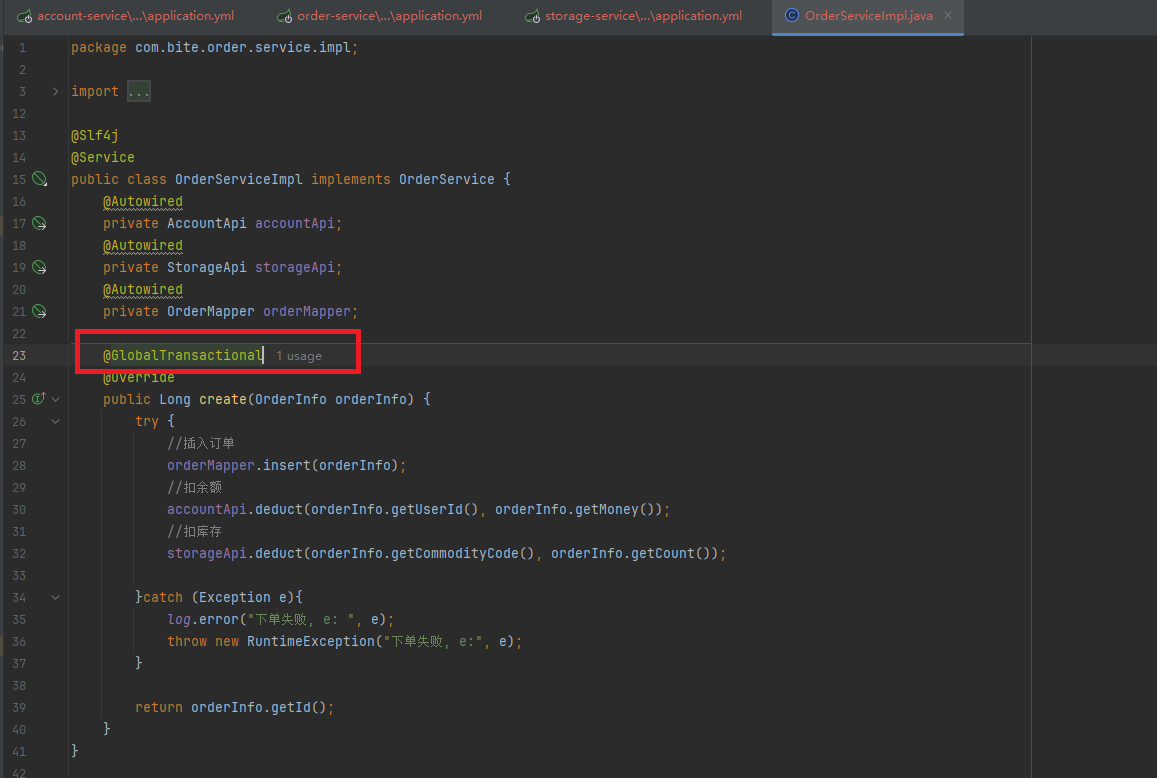
Ⅱ.给发起全局事务的入口方法添加 @GlobalTransactional注解
Ⅲ.进行测试
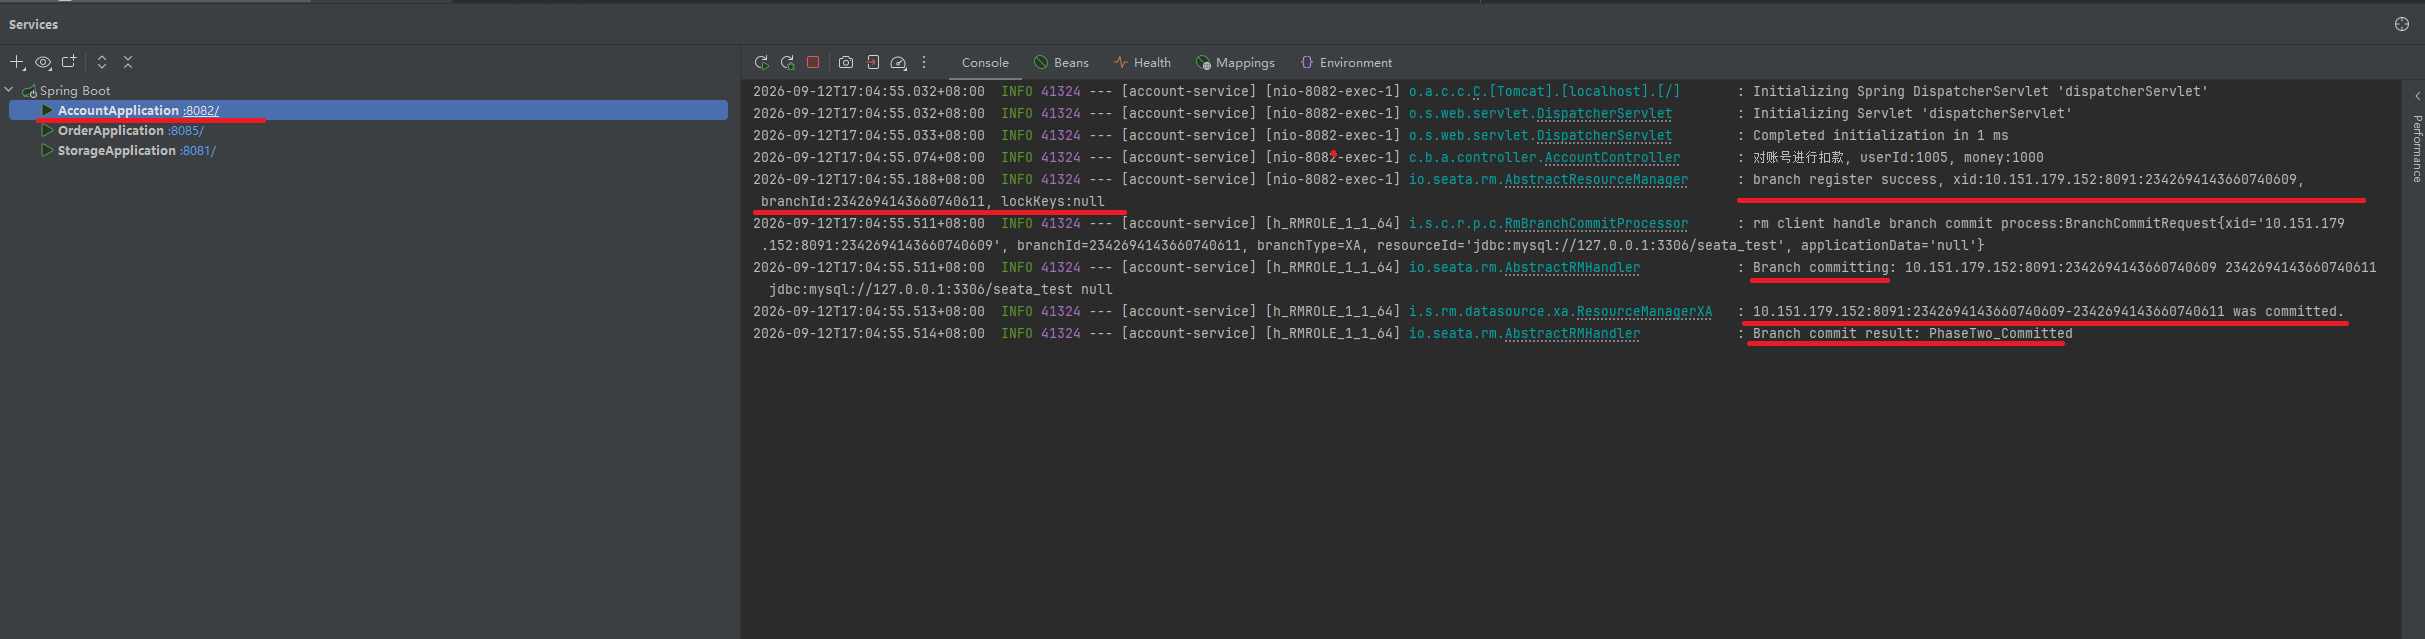
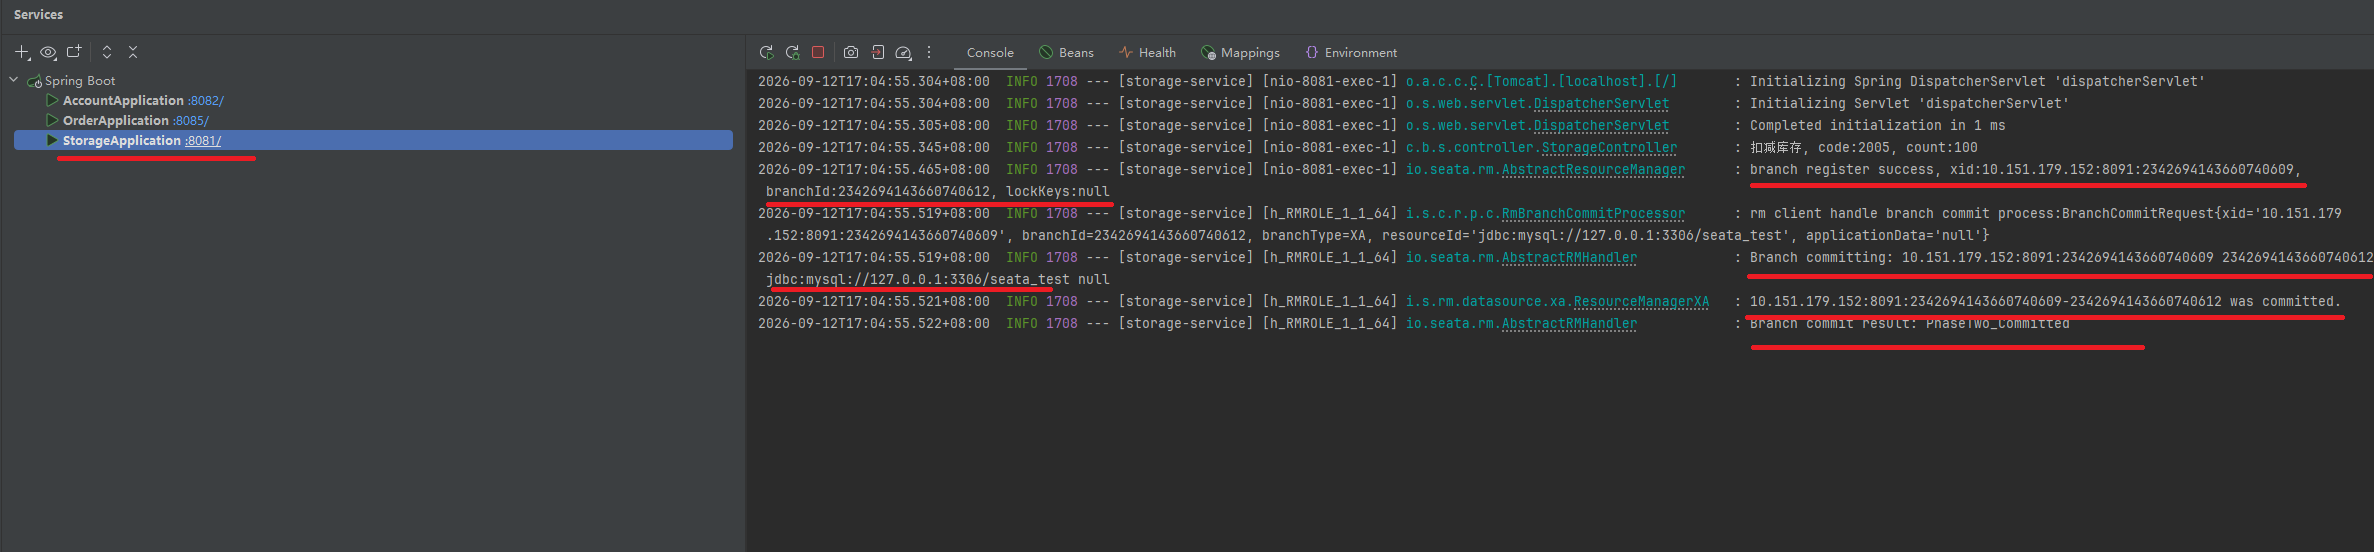
当进行正常的测试的时候
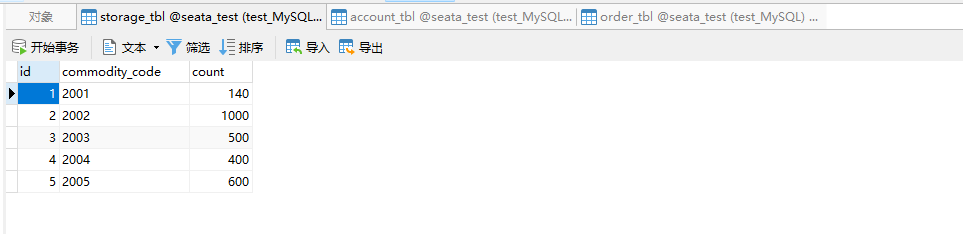
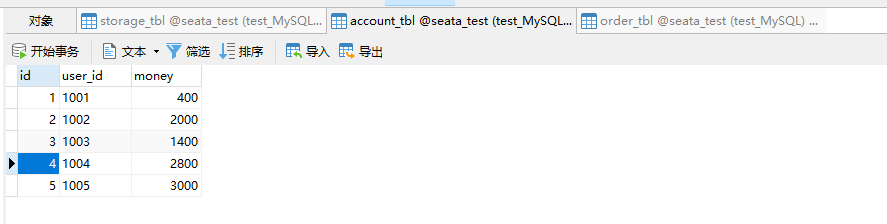
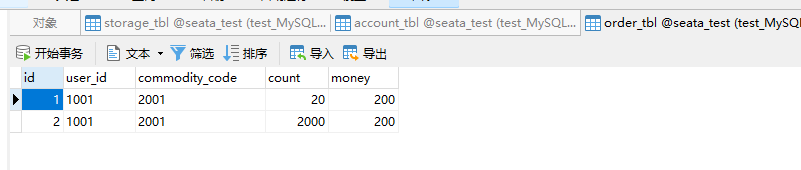
这是测试之前的数据库截图
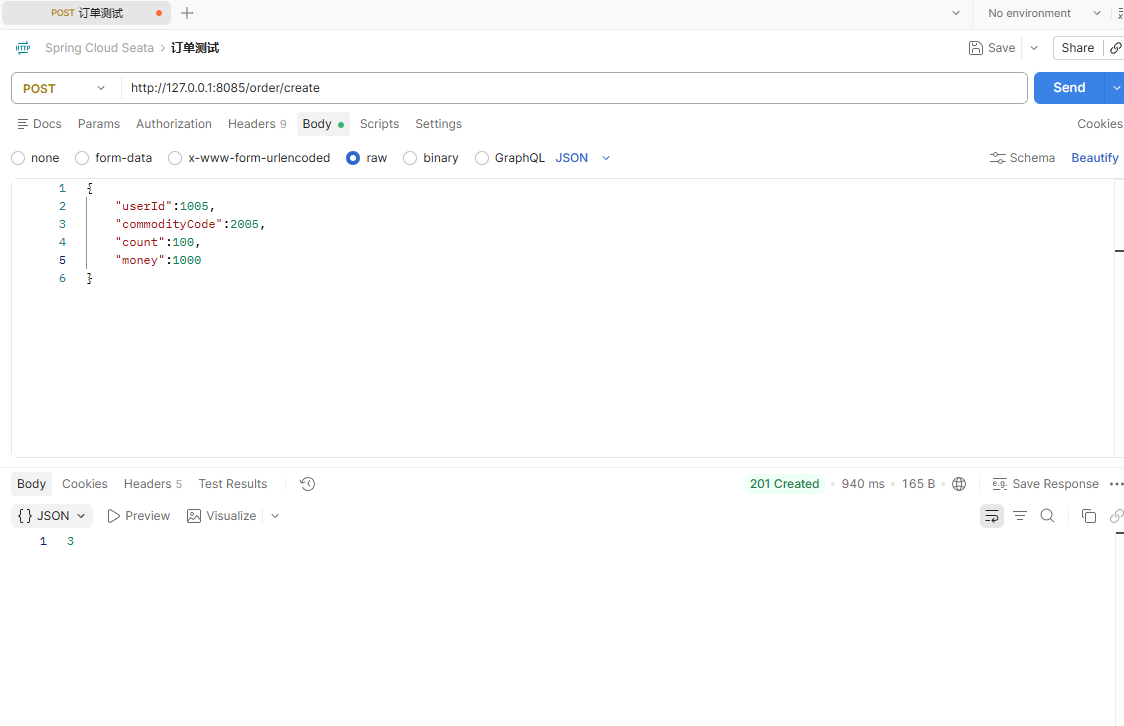
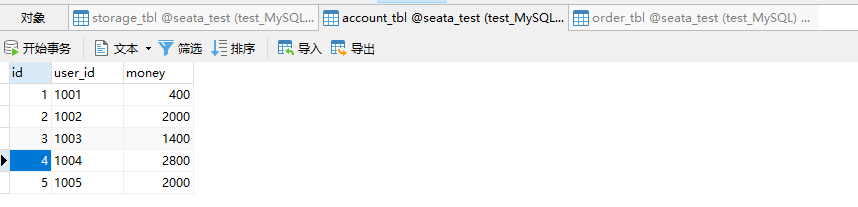
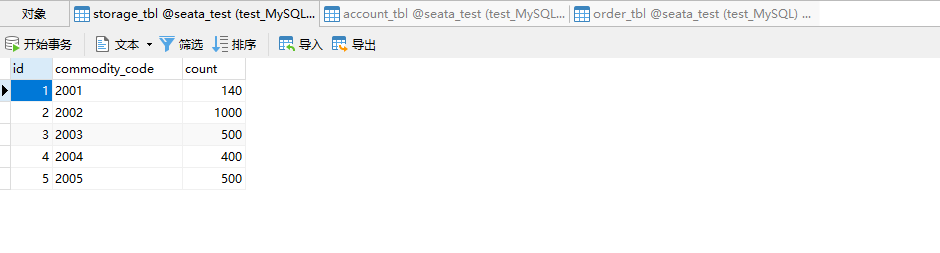
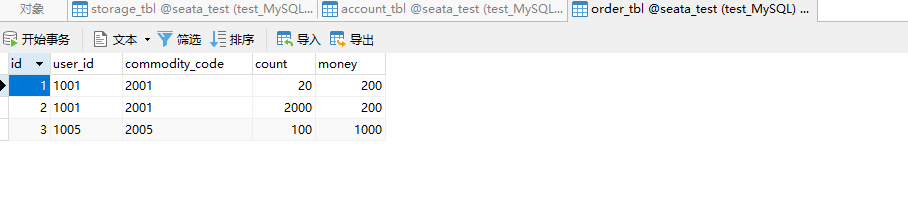
这是测试之后的数据库截图
下面看后端日志
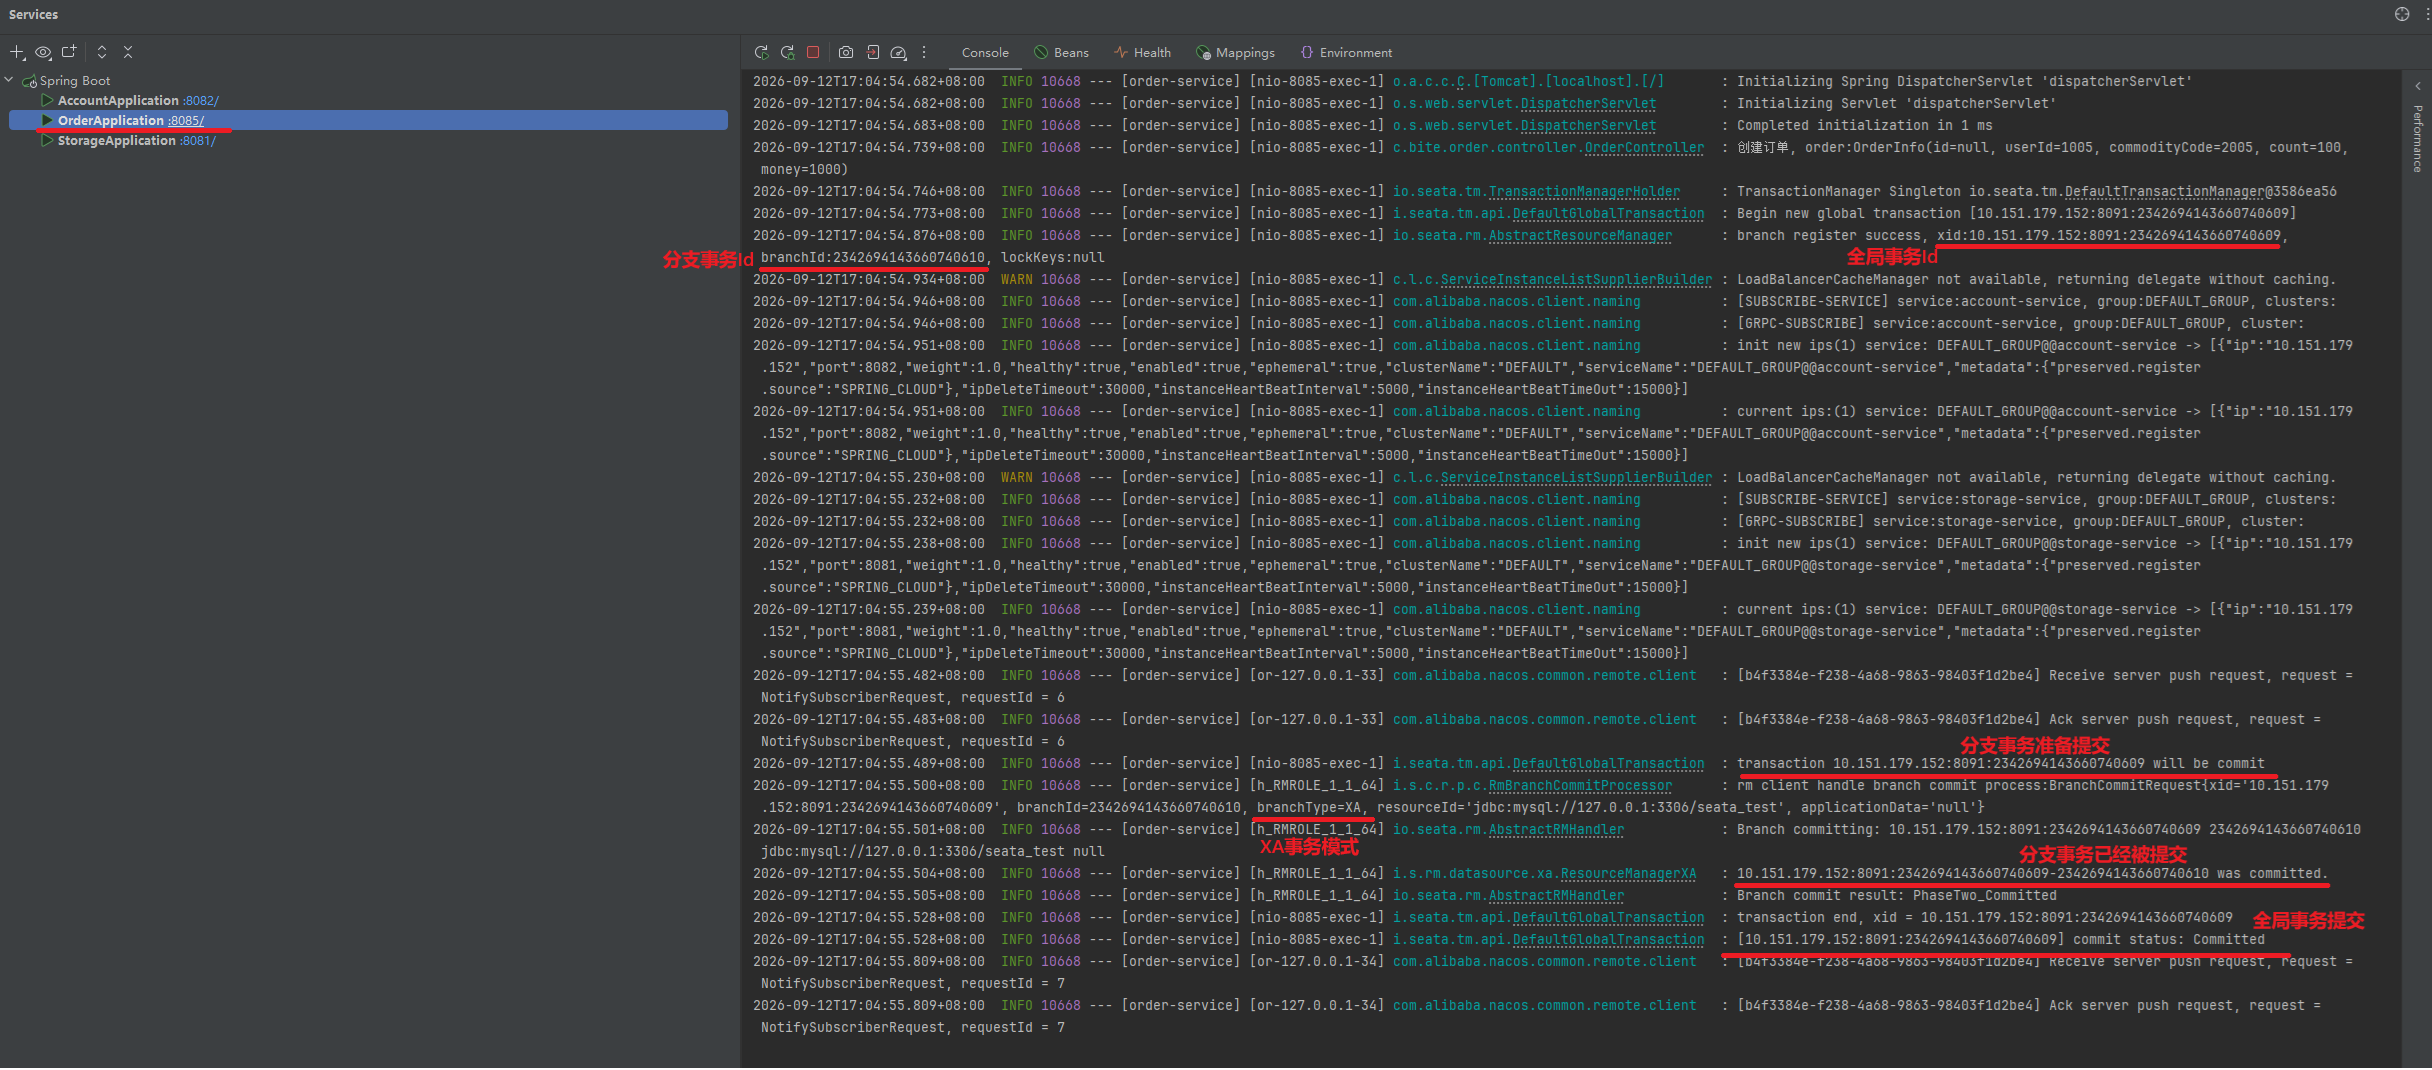
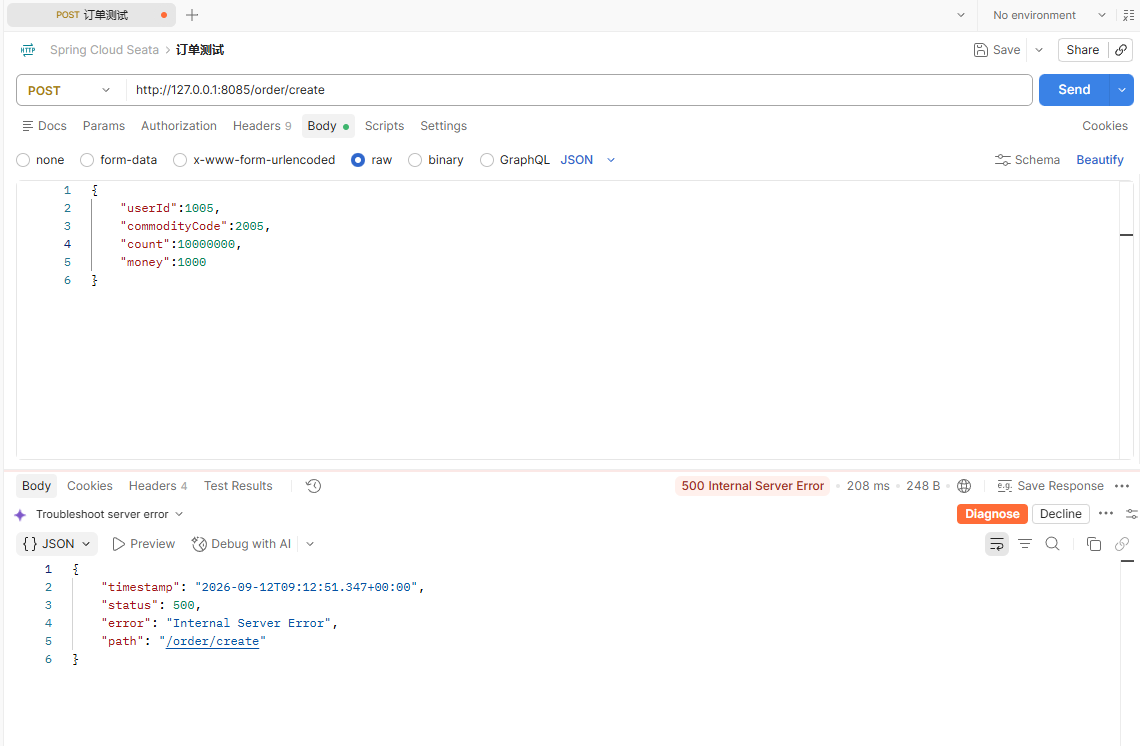
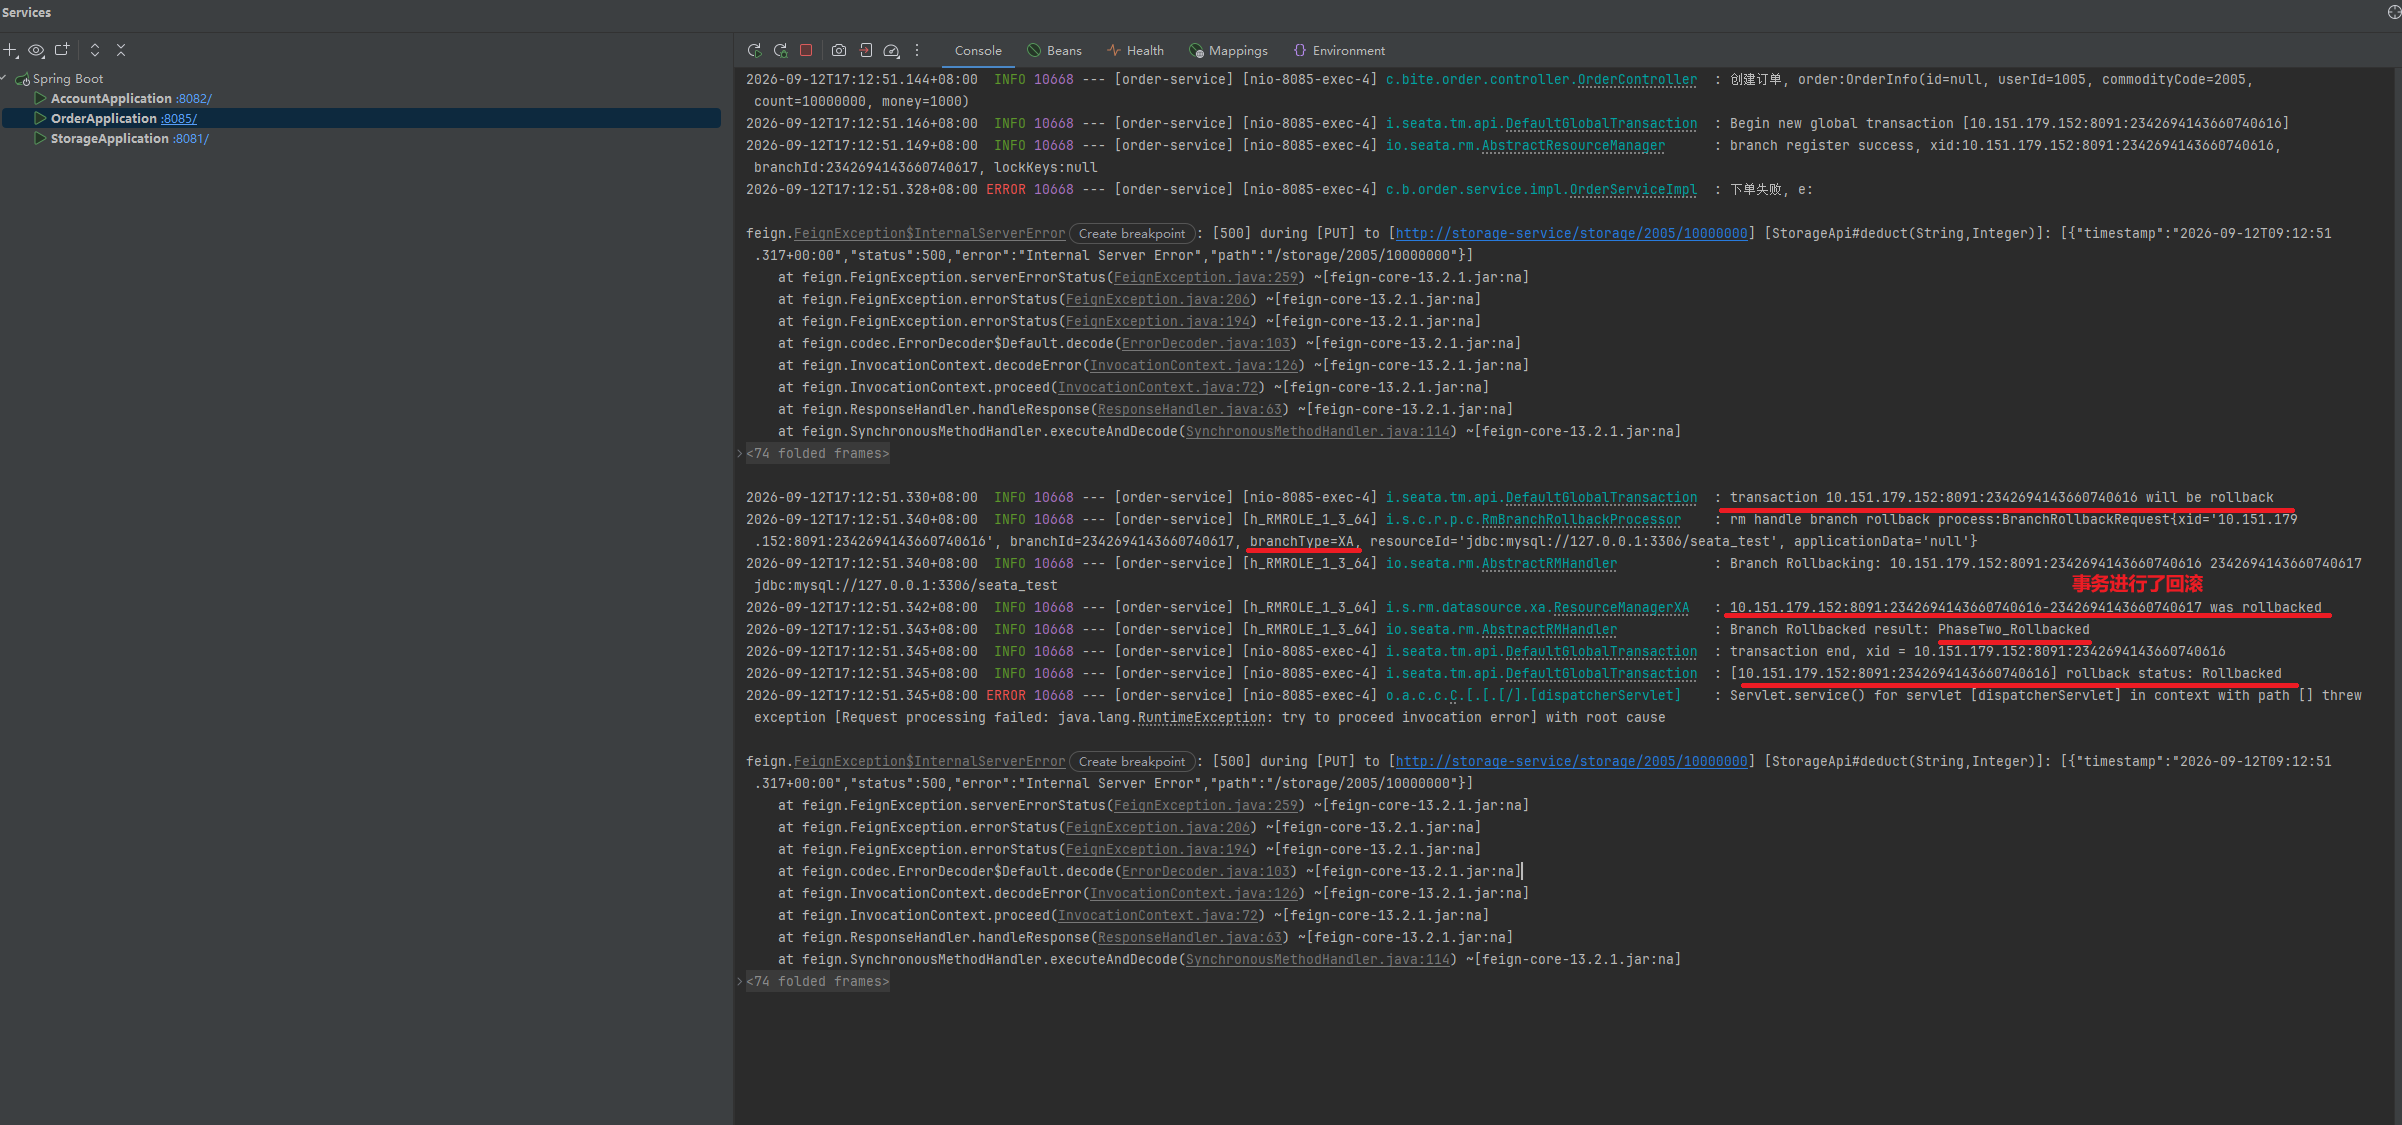
当进行异常的测试的时候
这是测试之前的数据库截图
这是测试之后的数据库截图
下面看后端日志
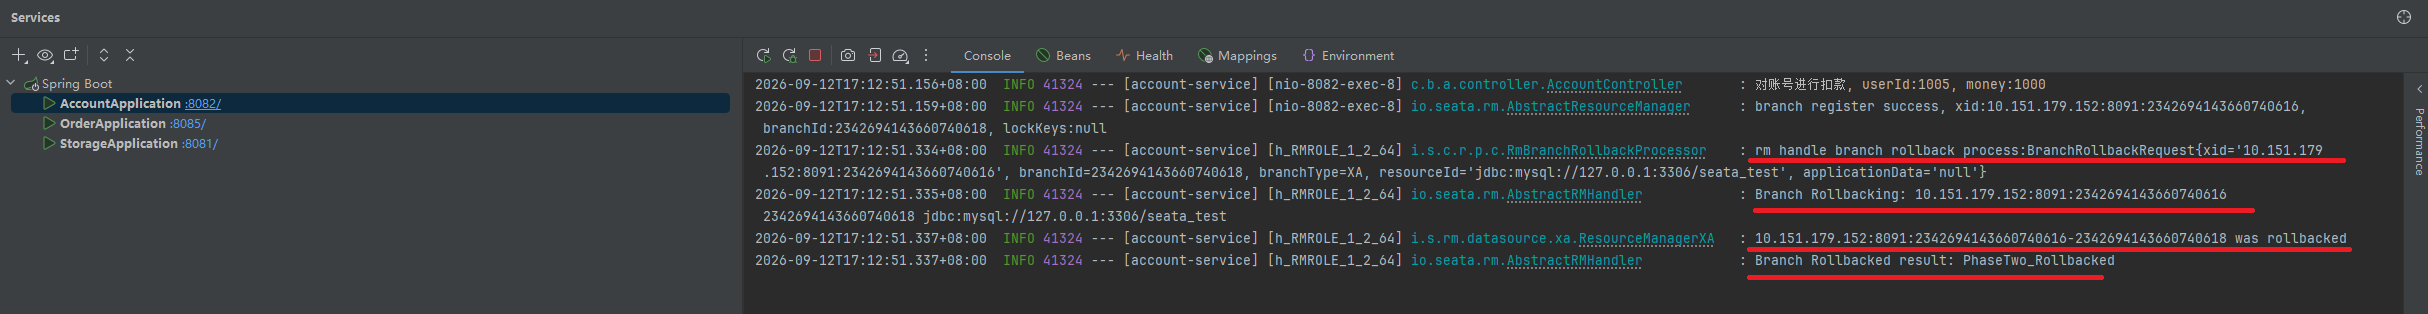
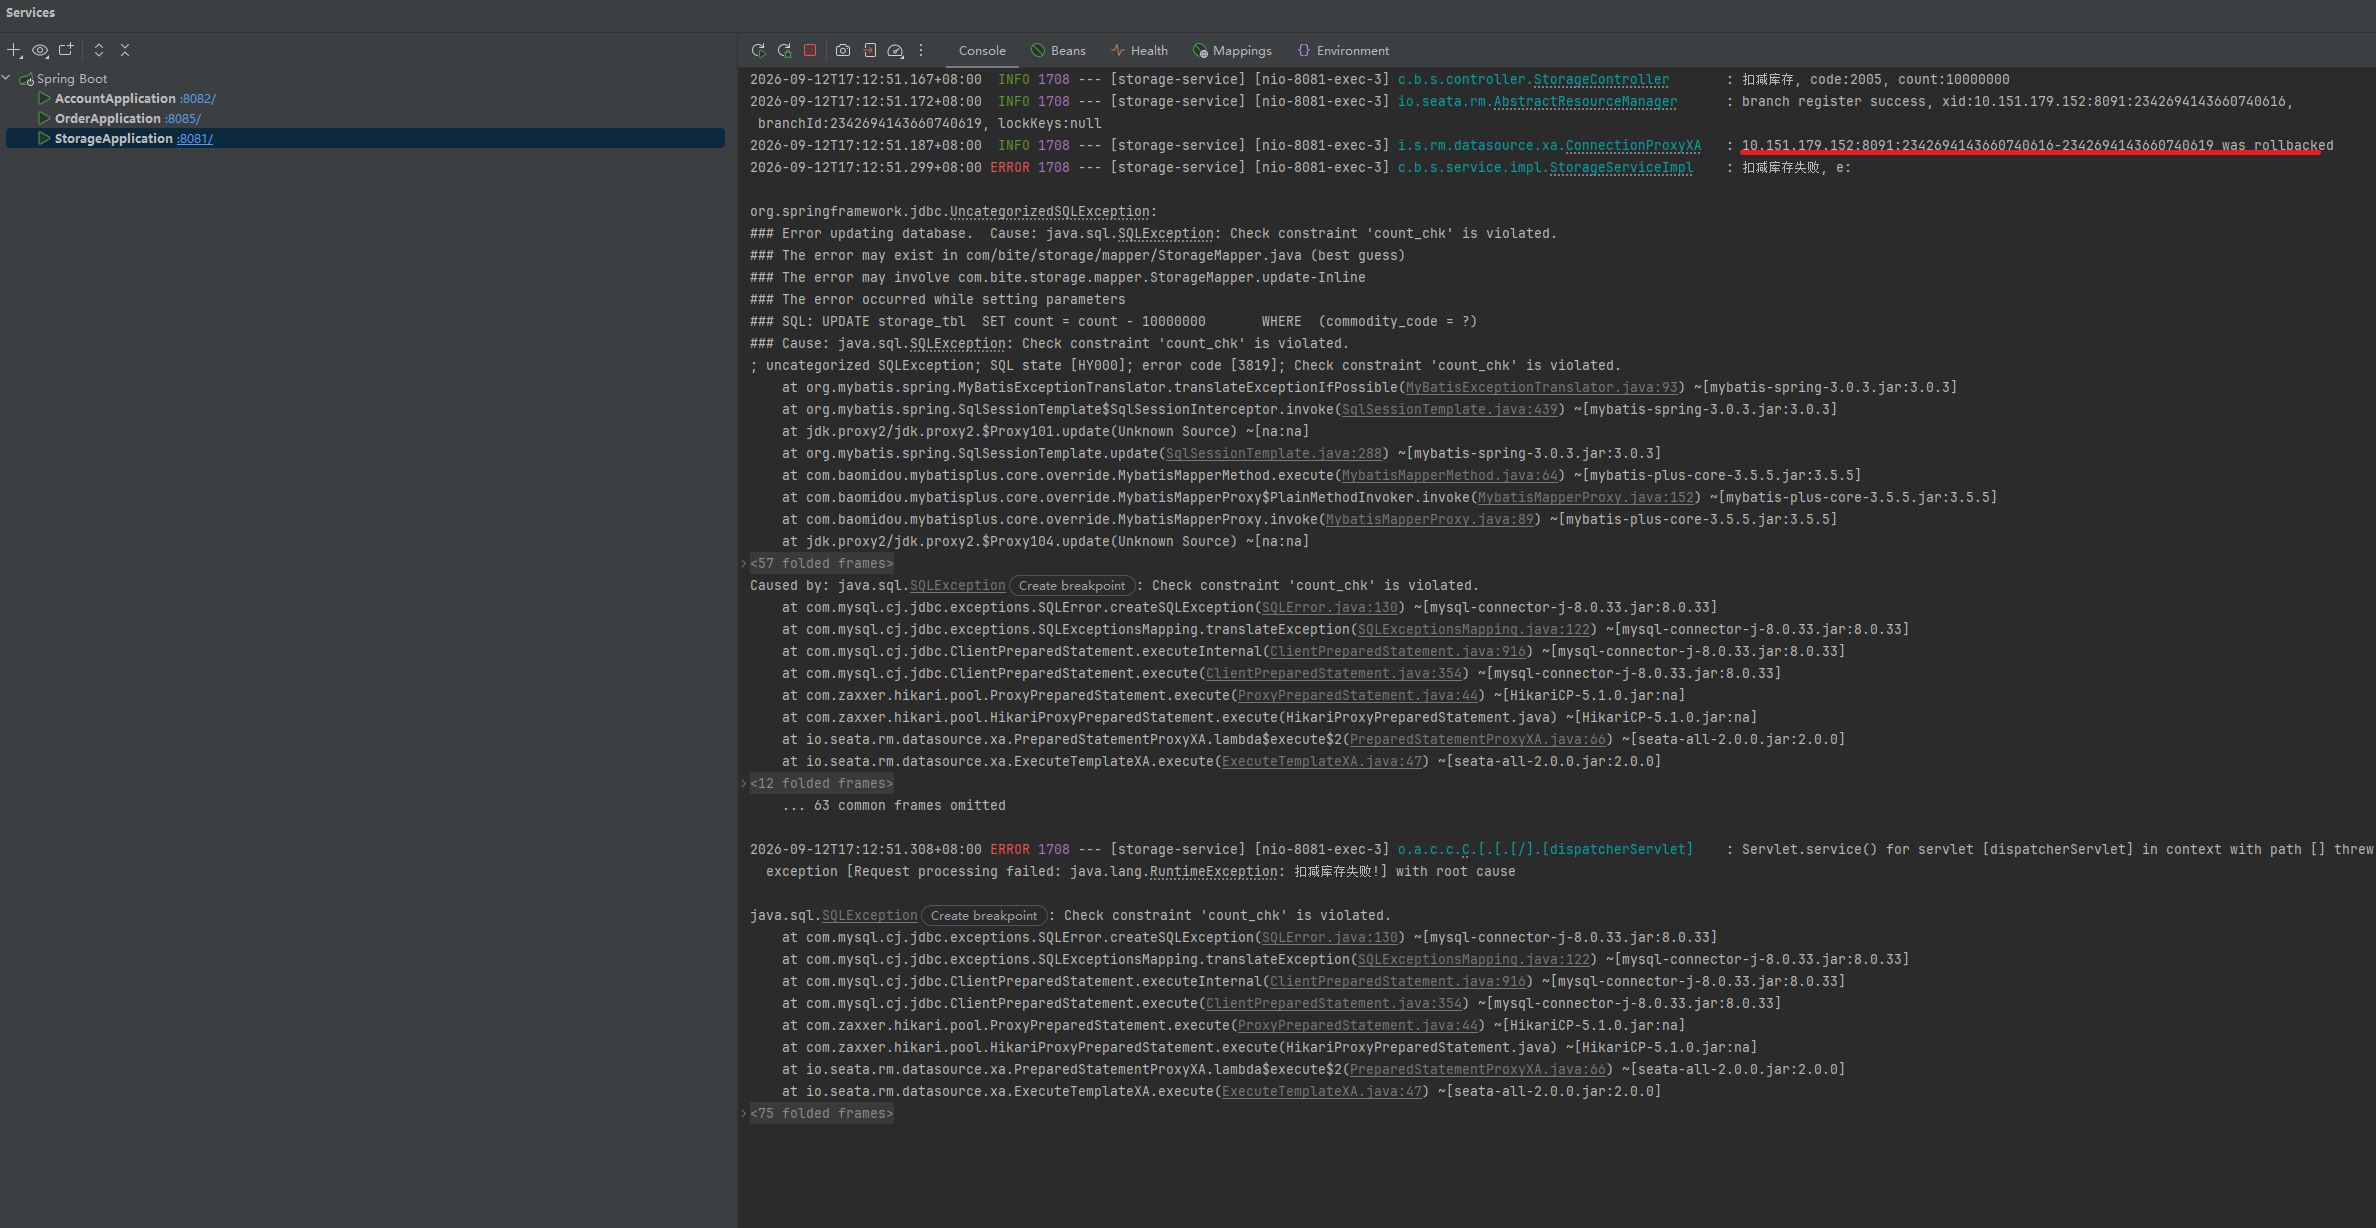
(3).优缺点
优点:
①.事务强一致性:XA模式能够满足ACID原则,确保分布式事务的强制一性
②.实现简单并且无代码侵入:常用数据库都支持XA协议,使用Seata的XA模式无需修改业务代码,只需要进行简单的配置即可
缺点:
①.性能较差:一阶段需要锁定数据库资源,等待二阶段结束才释放,导致事务资源长时间得不到释放,锁定周期长,从而影响性能
②.依赖关系数据库:XA模式依赖数据库实现事务,对于一些非关系型数据库或者不支持XA协议的数据库,无法使用
2.AT模式
(1).模式介绍
AT模式是Seata创新的一种非侵入方式的分布式事务解决方案。Seata在内部做了对数据库操作的代理层。在使用Seata 的AT模式时,实际上使用的是Seata自带的数据源代理DataSourceProxy,Seata在这层代理中加了很多逻辑,例如插入回滚undo_log日志,检查全局锁等等。
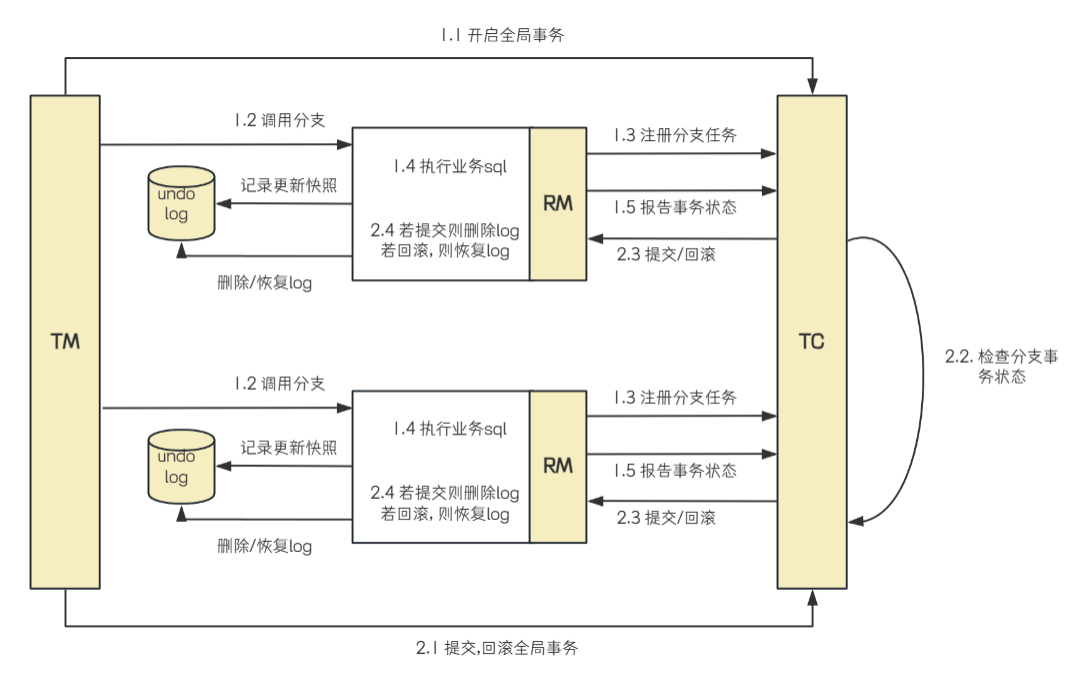
整体机制:
第一阶段:
①.注册分支事务:TM注册全局事务,RM向TC注册分支事务。
②.记录undo_log:RM在执行SQL操作之前,会先解析SQL语句,记录SQL更新前的快照和更新后的快照到undo_log日志表中。在undo_log表中,记录了足够的信息,来便于需要回滚时能够回复的数据。
③.执行SQL并提交本地事务:RM执行业务SQL操作,并直接提交本地事务,此时数据会真实的提交到数据库中
④.报告事务状态:RM向TC报告分支事务的执行状态,告知其本地事务已经提交。
第二阶段:
①.提交成功:如果所有的分支事务都提交成功,TC会通知RM清理undo_log相关的补偿信息,完成整个分布式事务的处理
②.提交失败:如果由任意一个分支事务失败,TC会通知RM进行回滚。RM根据undo_llog中的补偿信息对数据进行反向补偿,实现事务的回滚。
(2).读写隔离
Ⅰ.写隔离
当多个线程并发操作同一个数据的时候,可能会出现脏写问题
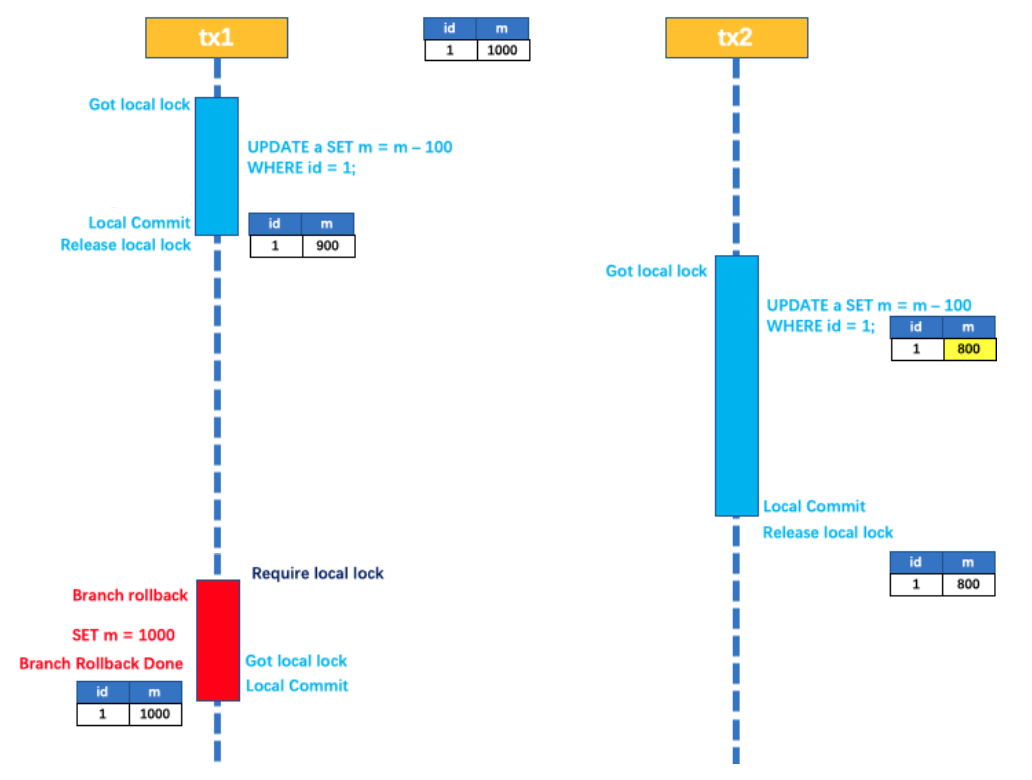
按道理来说,应该回滚到800,但是回滚到了1000
Seata的AT模式通过引入全局锁 来解决这个问题。在释放本地锁之前,先拿到全局锁,避免同一时刻有另一个事务来操作当前数据。如果拿不到全局锁,则不能提交本地事务。
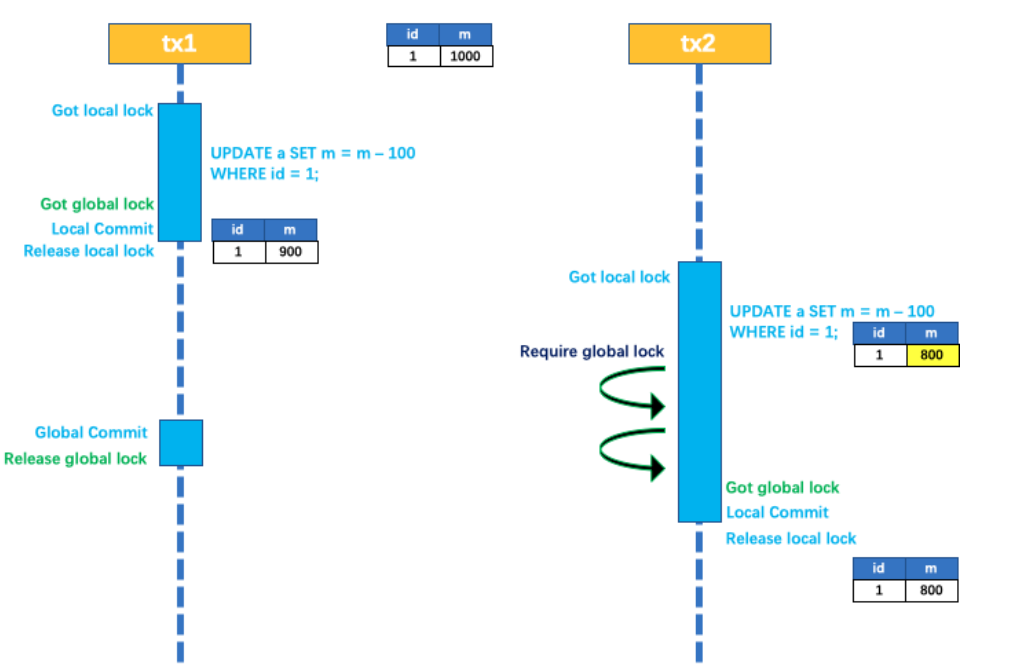
tx1先开始,开启本地事务,拿到了本地锁,然后执行了更新操作。在本地事务提交之前,先拿到了该记录的全局锁,然后本地提交释放本地锁。tx2后开始,tx2开启本地事务,拿到本地锁,然后执行了更新操作。tx2本地事务提交前,先要拿到该记录的全局锁,tx1全局事务提交前,该记录的全局锁被tx1持有,tx2需要重试等待全局锁 。只有当tx1二阶段全局提交,释放全局锁之后,tx2才能拿到全局锁,提交本地事务。
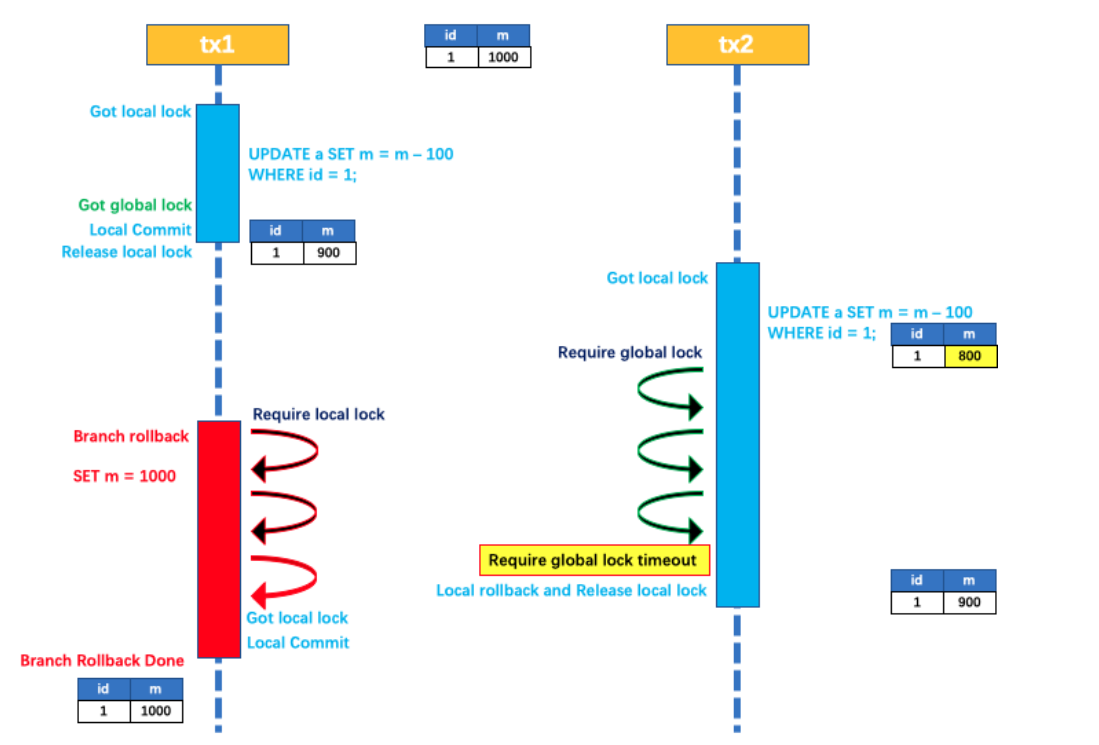
如果tx1的二阶段发生了回滚操作,那么tx1需要重新获取该数据的本地锁,进行反向补偿的更新操作,实现分支的回滚。但是,tx2仍然在等待该数据的全局锁,同时持有本地锁,则tx1的分支回滚会失败,分支的回滚会一直重试,一直等到tx2的全局锁超时,放弃全局锁并回滚本地事务释放本地锁,tx1的分支回滚最终成功。在整个过程中,全局锁在tx1结束前一直被tx1持有,不会发生脏写问题。
Ⅱ.读隔离
在数据库本地事务隔离级别"读已提交 "或以上的基础上,Seata的AT模式的默认全局事务隔离级别是"读未提交"。如果应用在特定场景下,必须要求全局的"读已提交",目前Seata的方式是通过SELECT FOR UPDATE语句的代理。
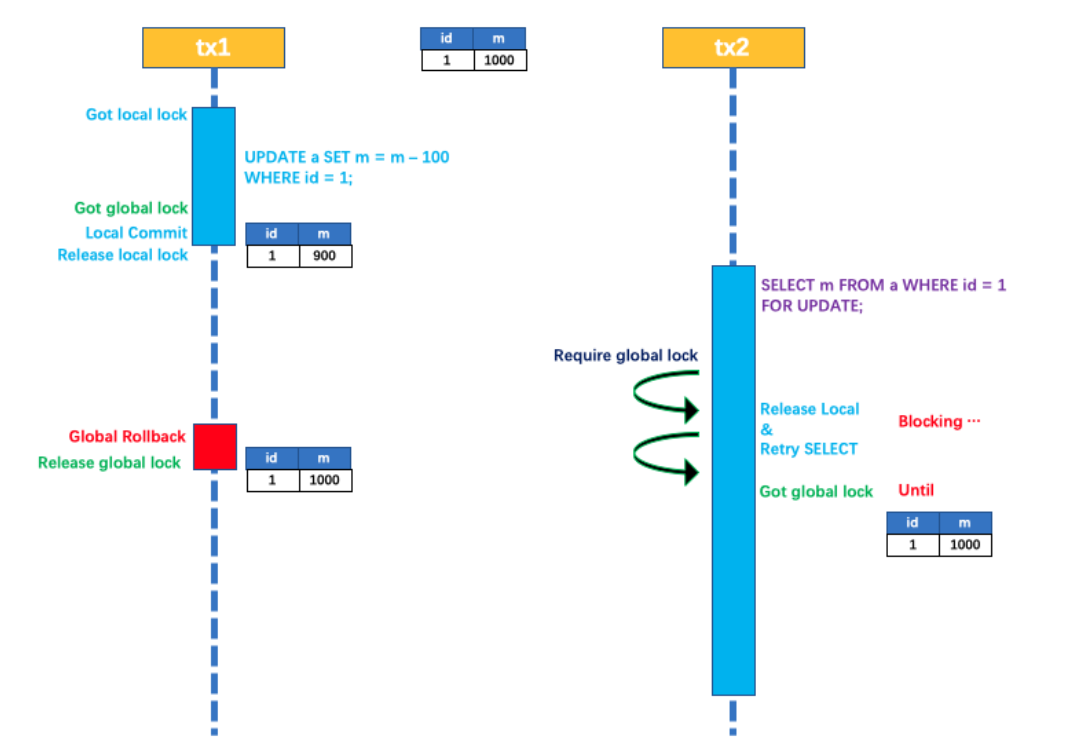
SELECT FOR UPDATE语句的执行会申请全局锁,如果全局锁被其他事务持有,则释放本地锁并重试,在这个过程中,查询是被block住的,直到全局锁拿到,即读取的相关数据是已提交的,才返回。
(3).工作机制
第一阶段:
①.解析SQL,AT模式会得到SQL的类型,操作的表以及条件语句等相关信息。
②.查询前镜像:根据解析得到的条件信息,生成查询语句,定位数据。
③.执行业务SQL:更新数据
④.查询后镜像:根据前镜像的结果,通过主键定位数据。
⑤.插入回滚日志:把前镜像和后镜像的数据以及业务SQL相关的信息组成一条回滚日志记录,插入到 undo_log表中
⑥.申请插入数据的表中,主键值等于该数据的全局锁
⑦.本地事务提交:业务数据的更新和前面步骤生成的undo_log表中的数据一并提交
⑧.将本地事务提交的结果上报给TC
第二阶段-回滚:
①.收到TC的分支回滚请求,开启一个本地事务,执行下面的操作
②.通过XID(全局事务ID)和Branch ID(分支事务ID)查找到相应的undo_log记录
③.数据校验:拿到undo_log中的后镜与当前数据进行比较,如果不相同,则说明数据被当前全局事务之外的动作做了修改,此时需要根据配置策略来做处理。
④.根据undo_log中的前镜像和业务SQL的相关信息生成并执行回滚的语句
⑤.提交本地事务,并把本地事务的执行结果上报给TC
第二阶段-提交:
①.收到TC的分支提交请求,把请求放入一个异步任务的队列中,马上返回提交成功的结果给TC
②.异步任务阶段的分支提交请求将异步和批量地删除相应的undo_log记录
(4).配置使用
Ⅰ.创建对应的数据库表
sql
CREATE TABLE `undo_log` (
  `id` bigint(20) NOT NULL AUTO_INCREMENT,
  `branch_id` bigint(20) NOT NULL,
  `xid` varchar(100) NOT NULL,
  `context` varchar(128) NOT NULL,
  `rollback_info` longblob NOT NULL,
  `log_status` int(11) NOT NULL,
  `log_created` datetime NOT NULL,
  `log_modified` datetime NOT NULL,
  `ext` varchar(100) DEFAULT NULL,
  PRIMARY KEY (`id`),
  UNIQUE KEY `ux_undo_log` (`xid`,`branch_id`)
) ENGINE=InnoDB AUTO_INCREMENT=1 DEFAULT CHARSET=utf8;
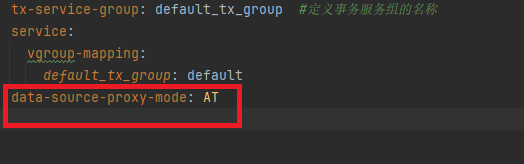
Ⅱ.配置事务模式为AT
Ⅲ.进行测试
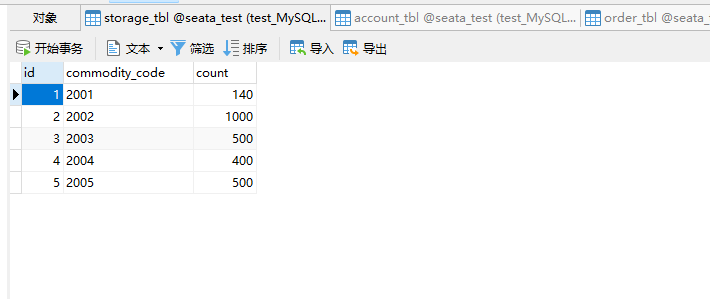
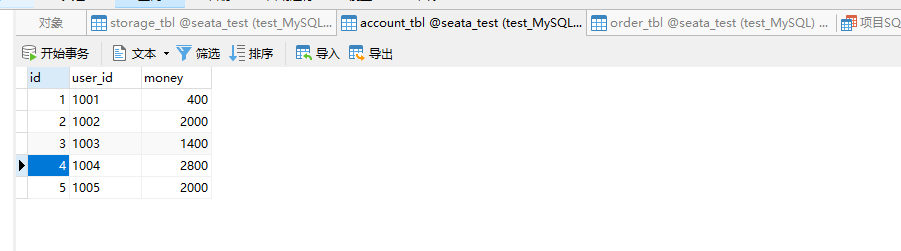
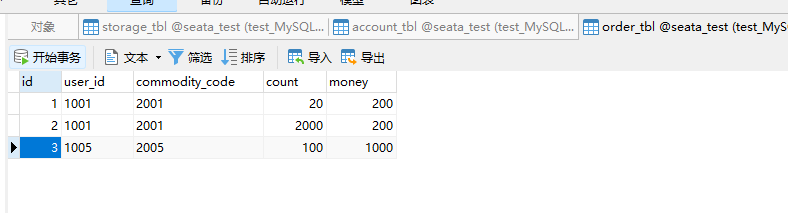
上面是测试之前的数据库表记录
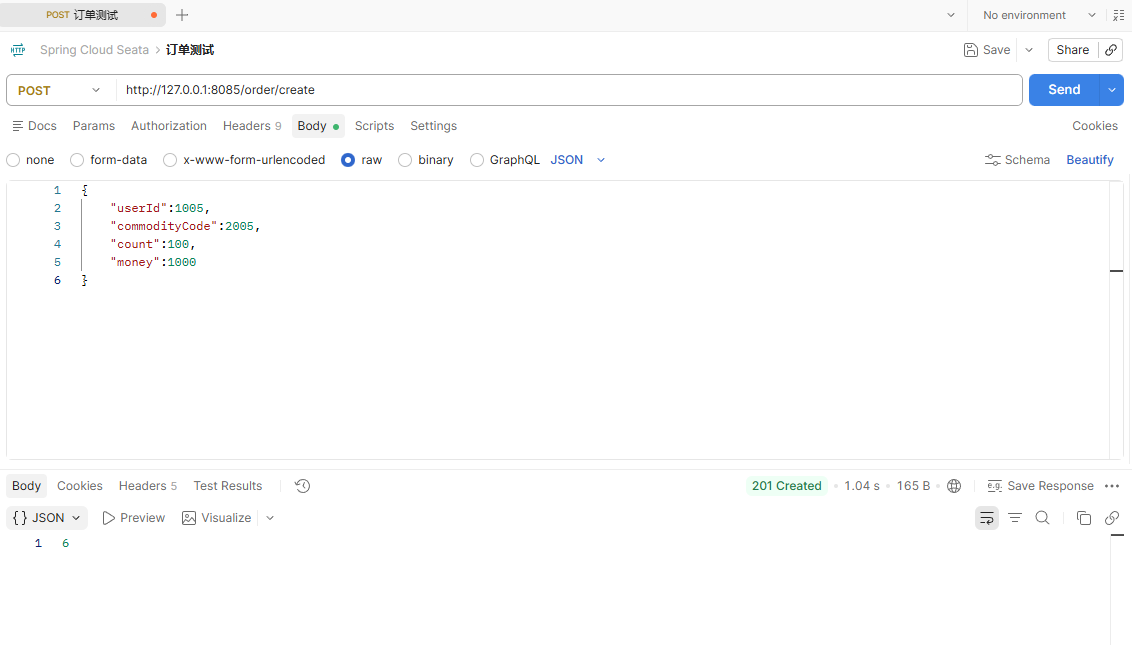
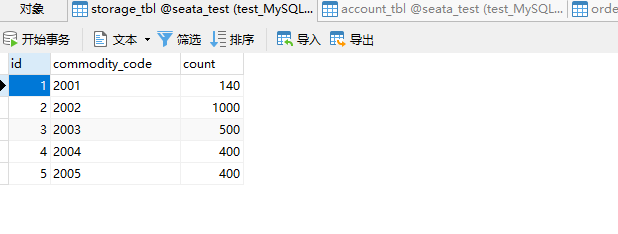
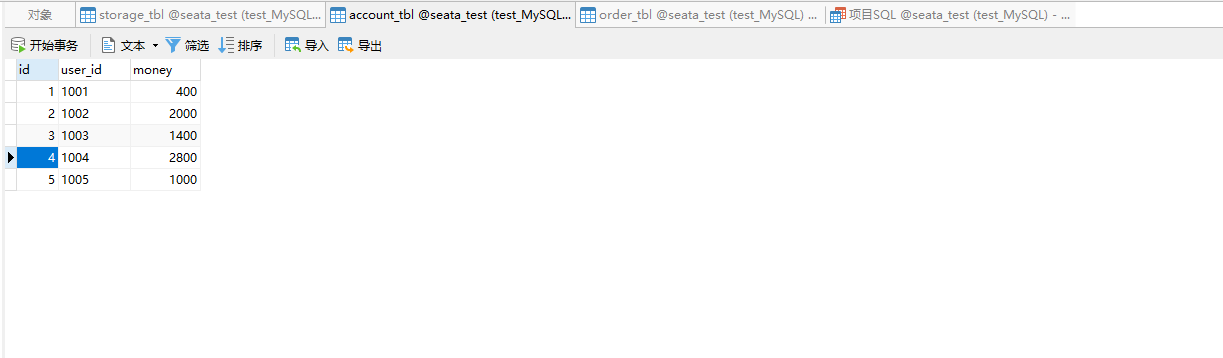
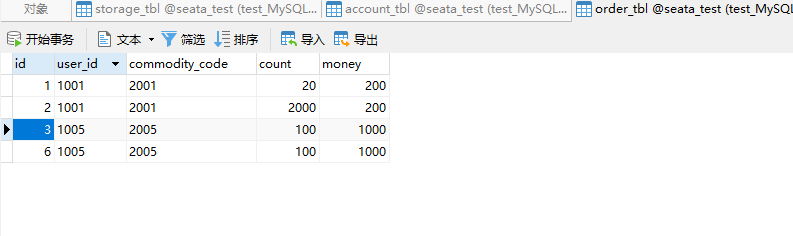
这是执行完成之后截图
下面看后端日志
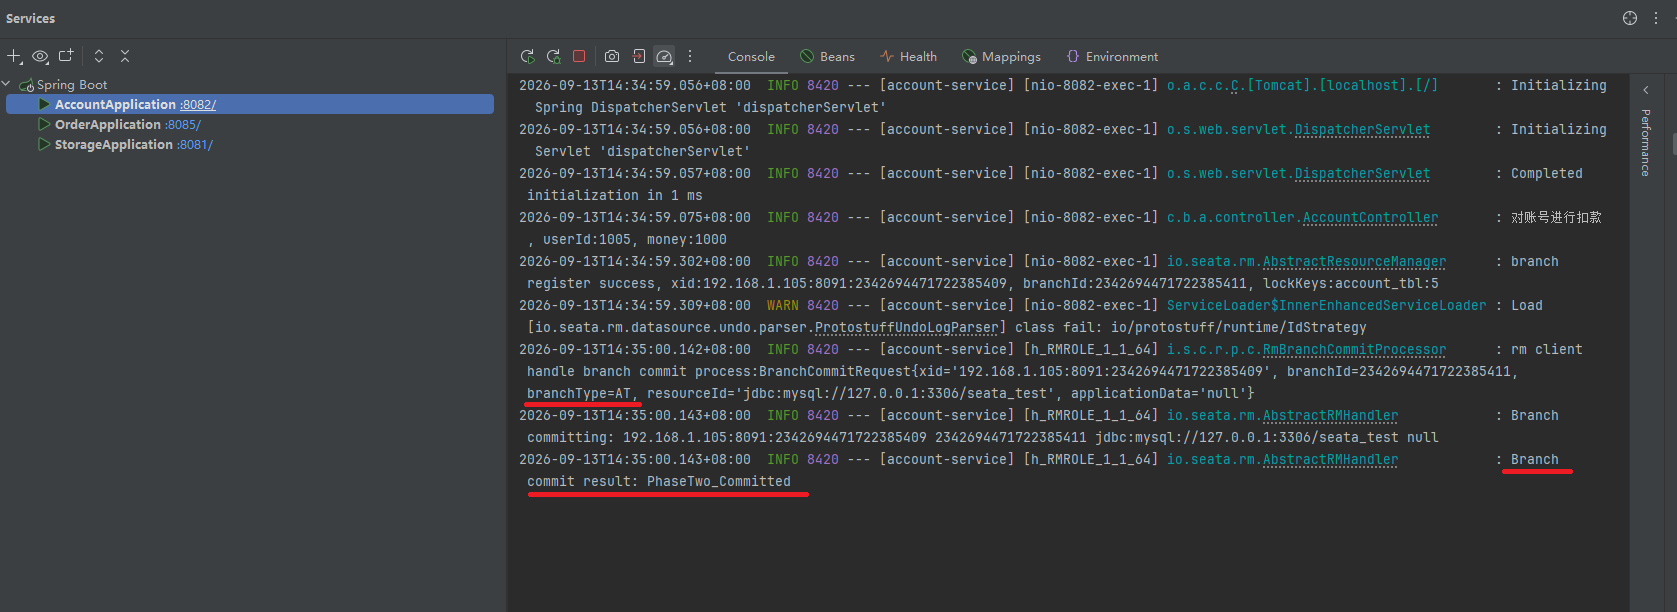
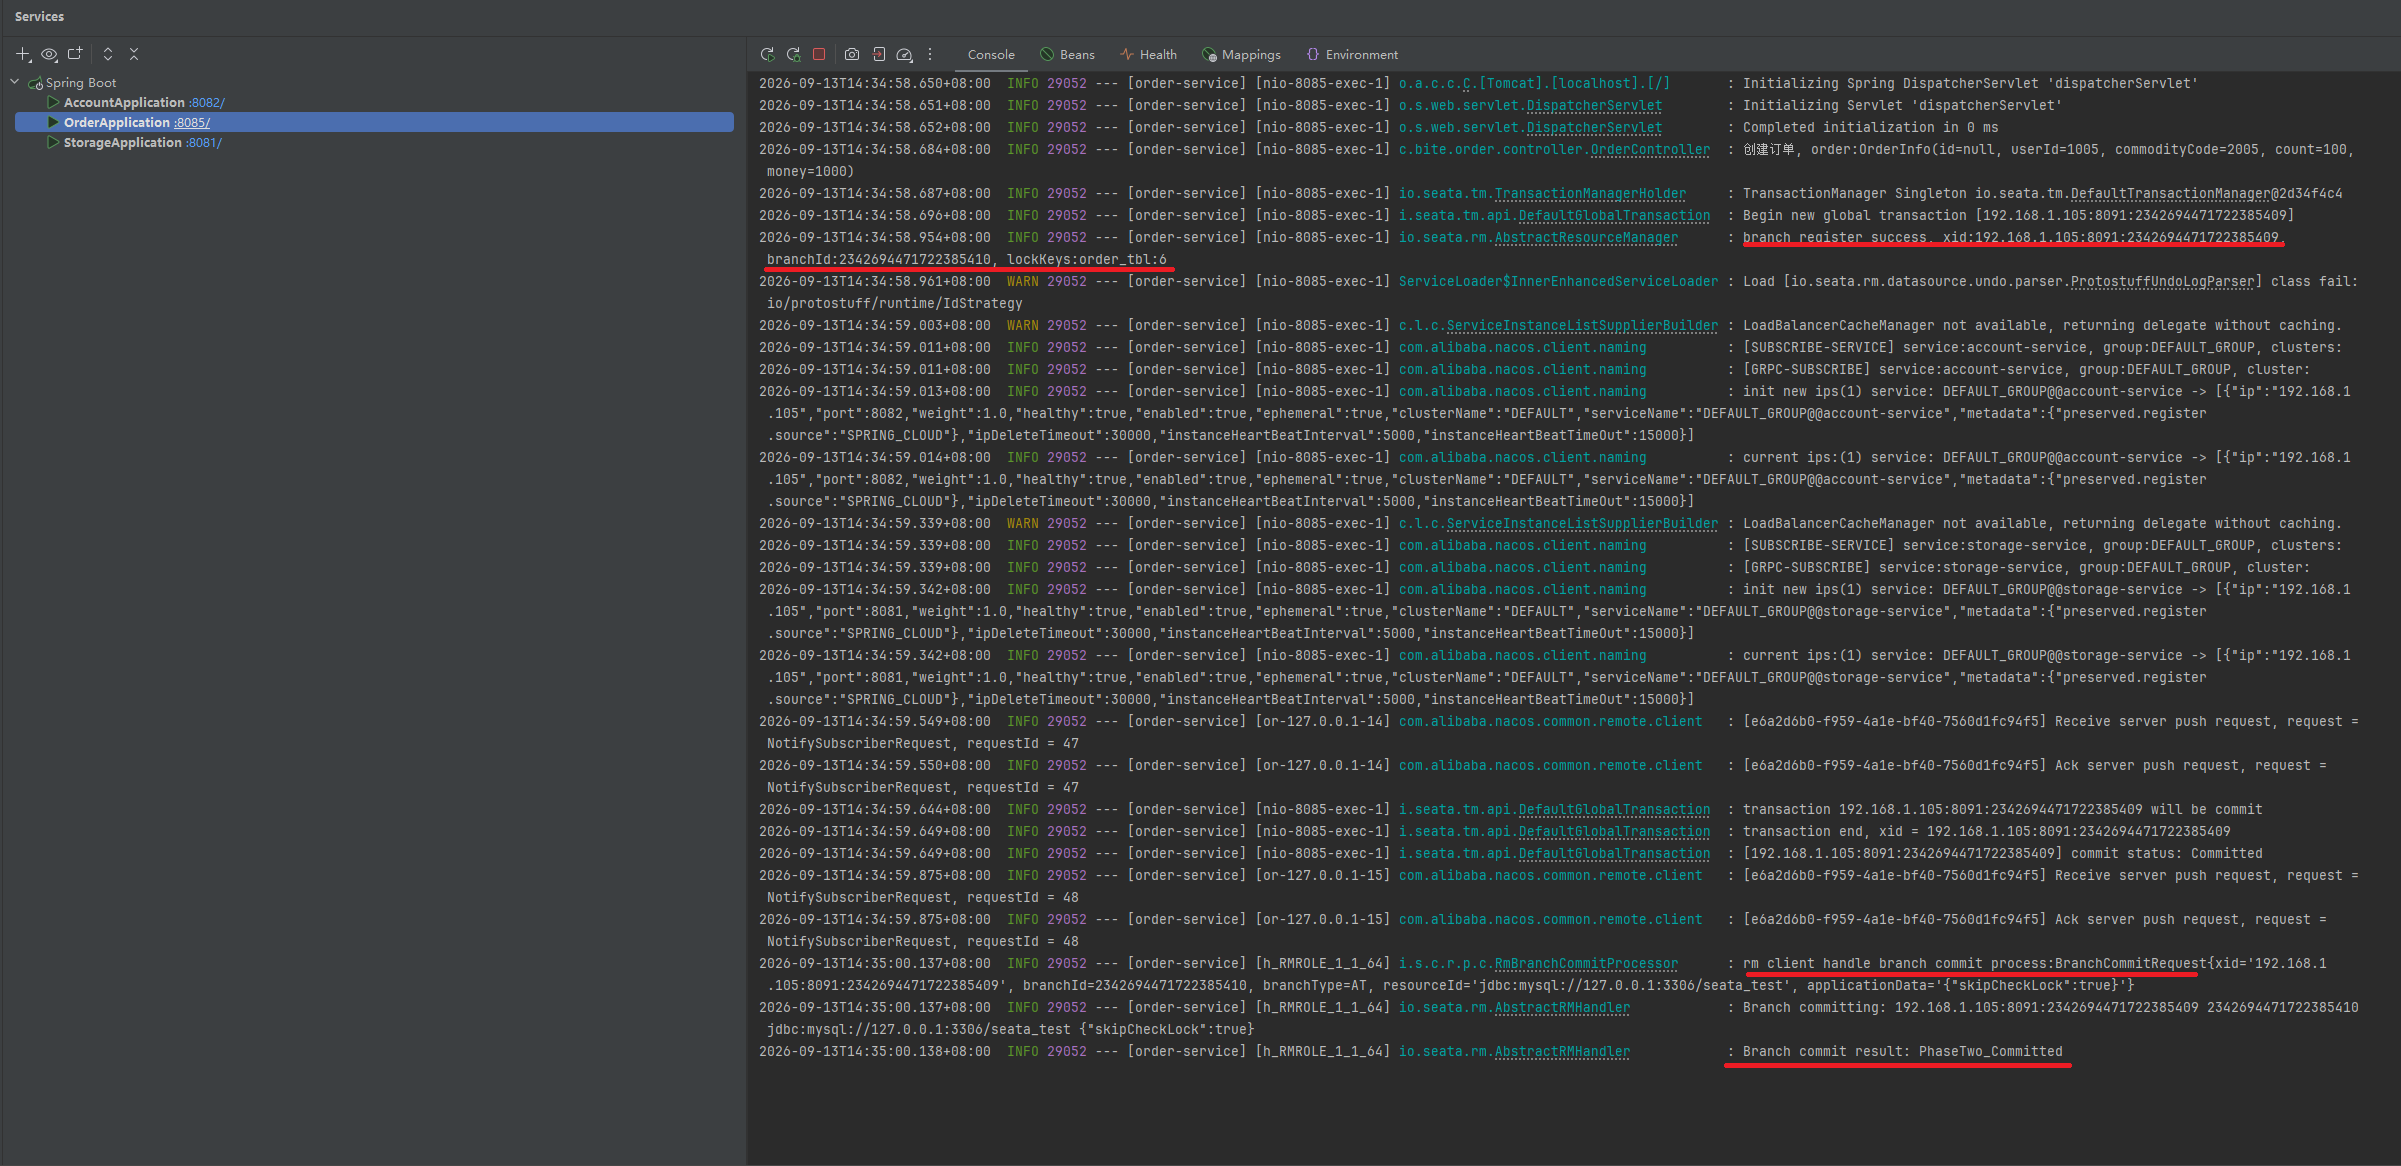
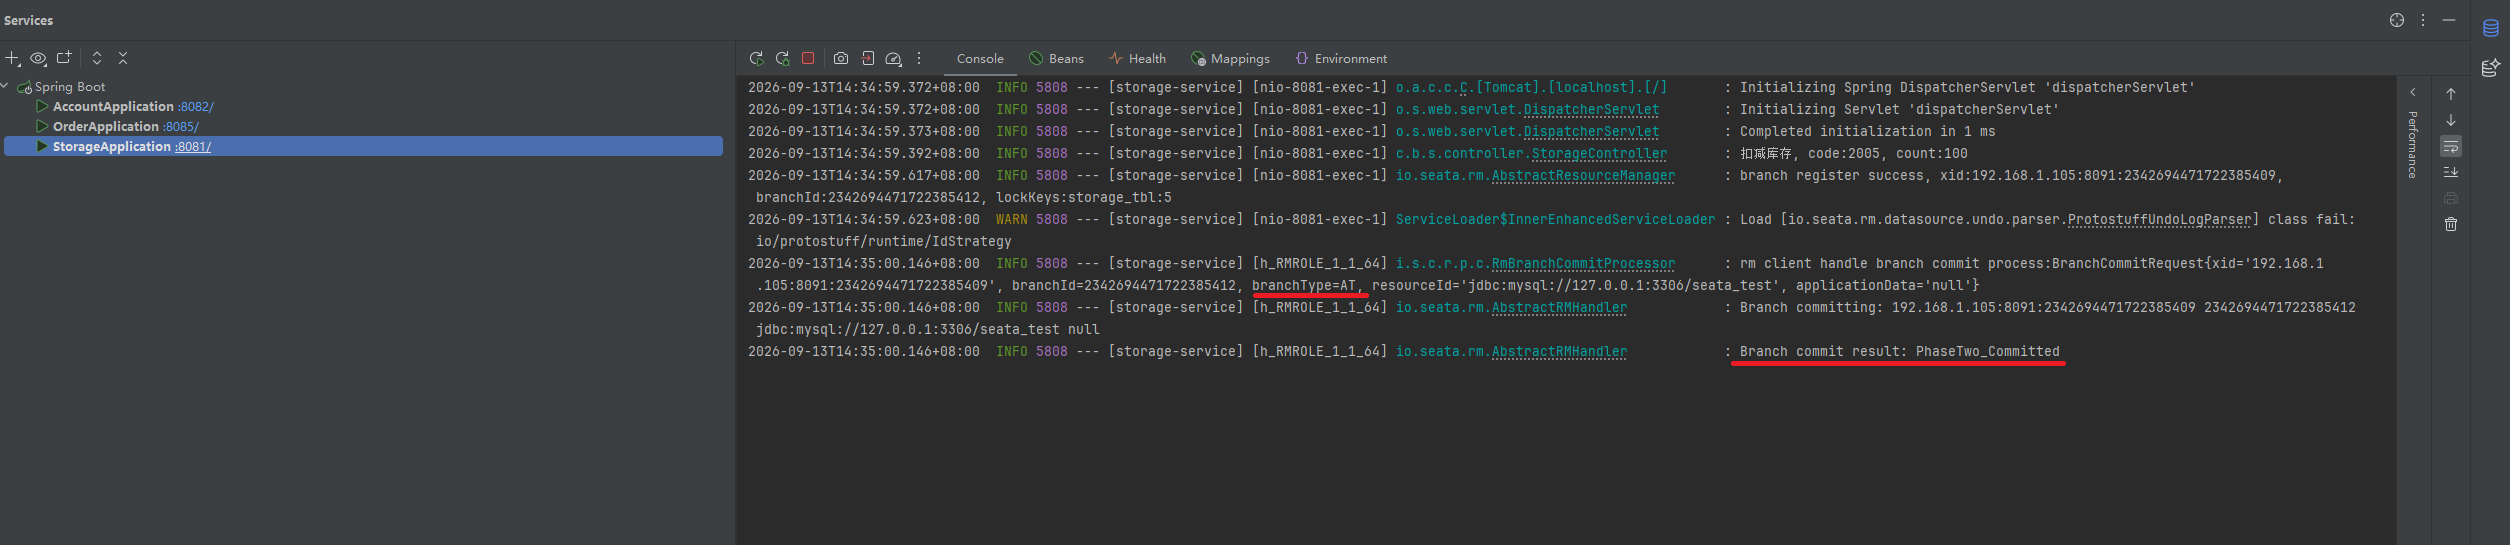
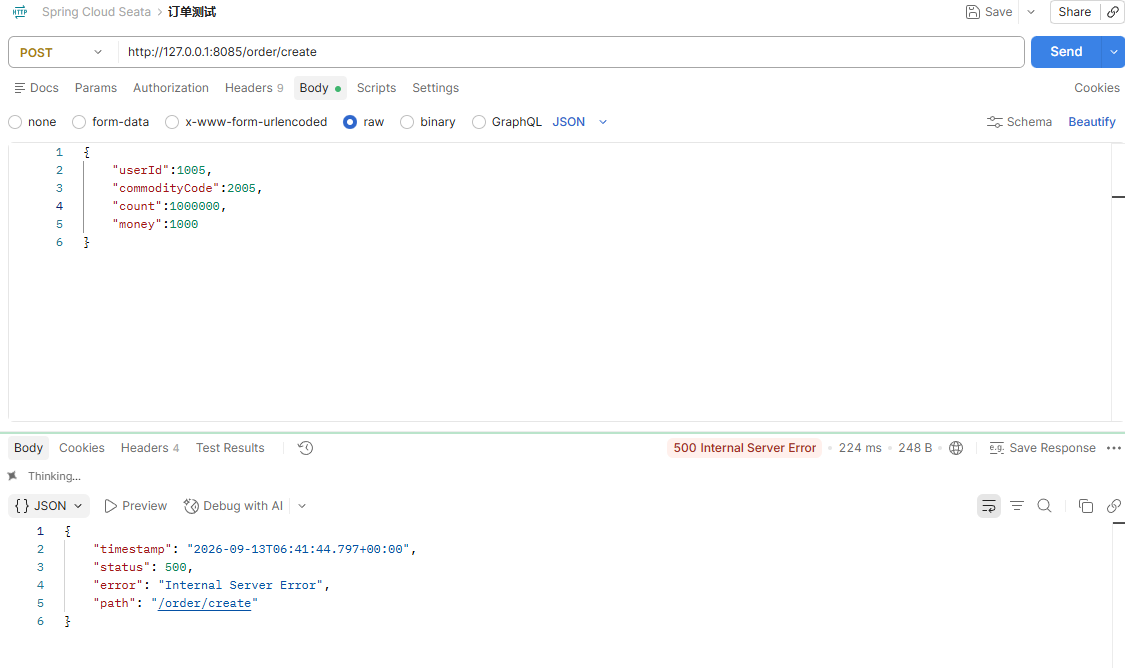
下面测试异常情况
这是执行之前的截图
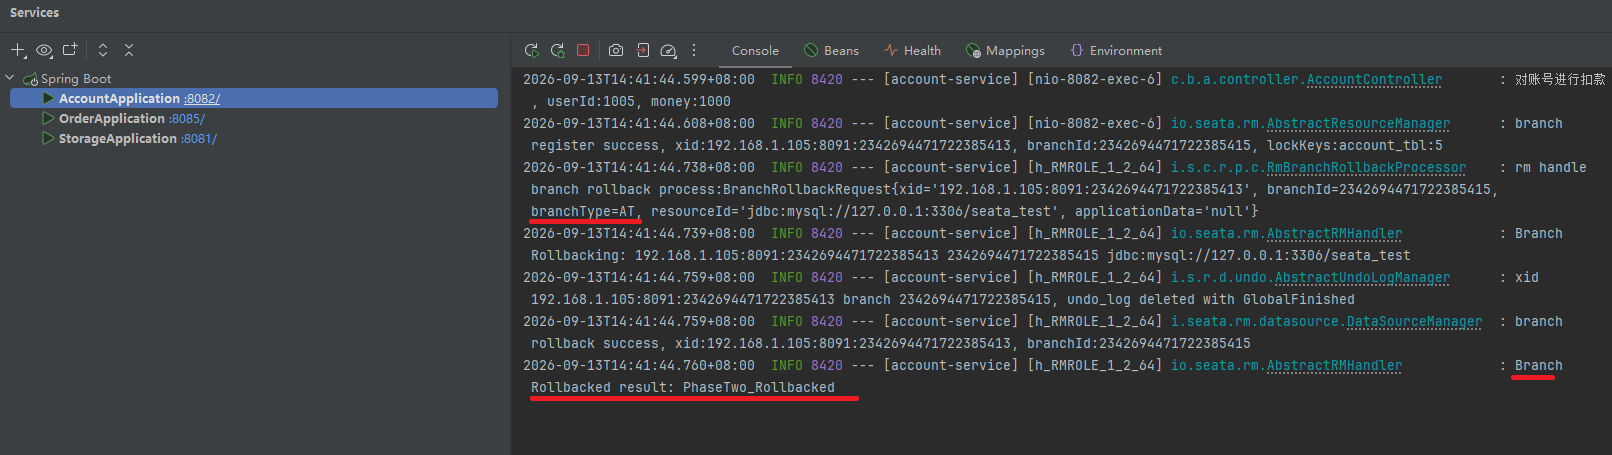
这是执行之后的截图
下面看后端日志
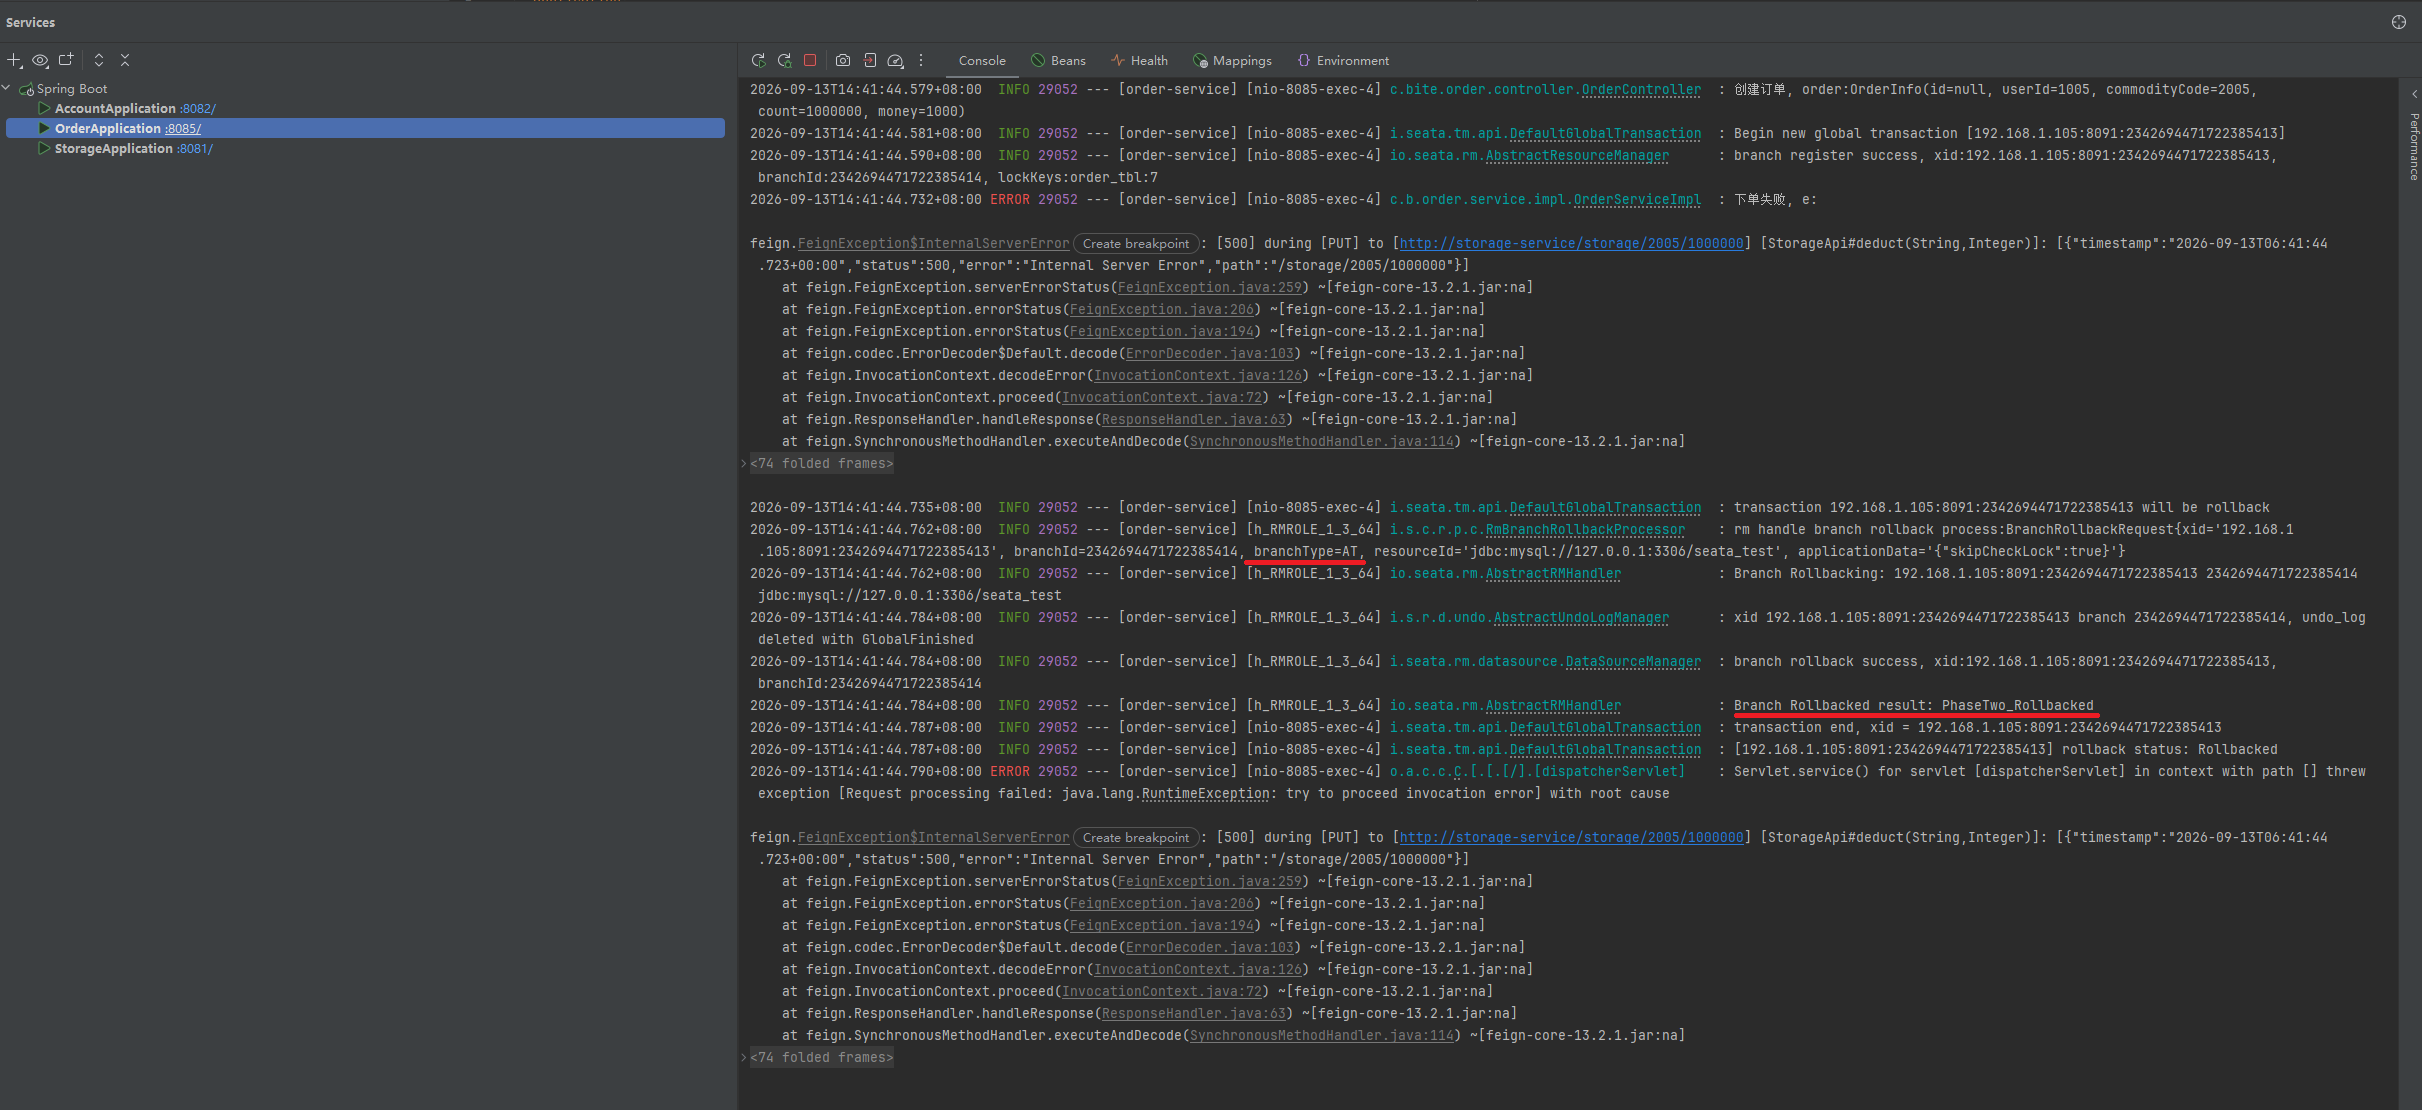
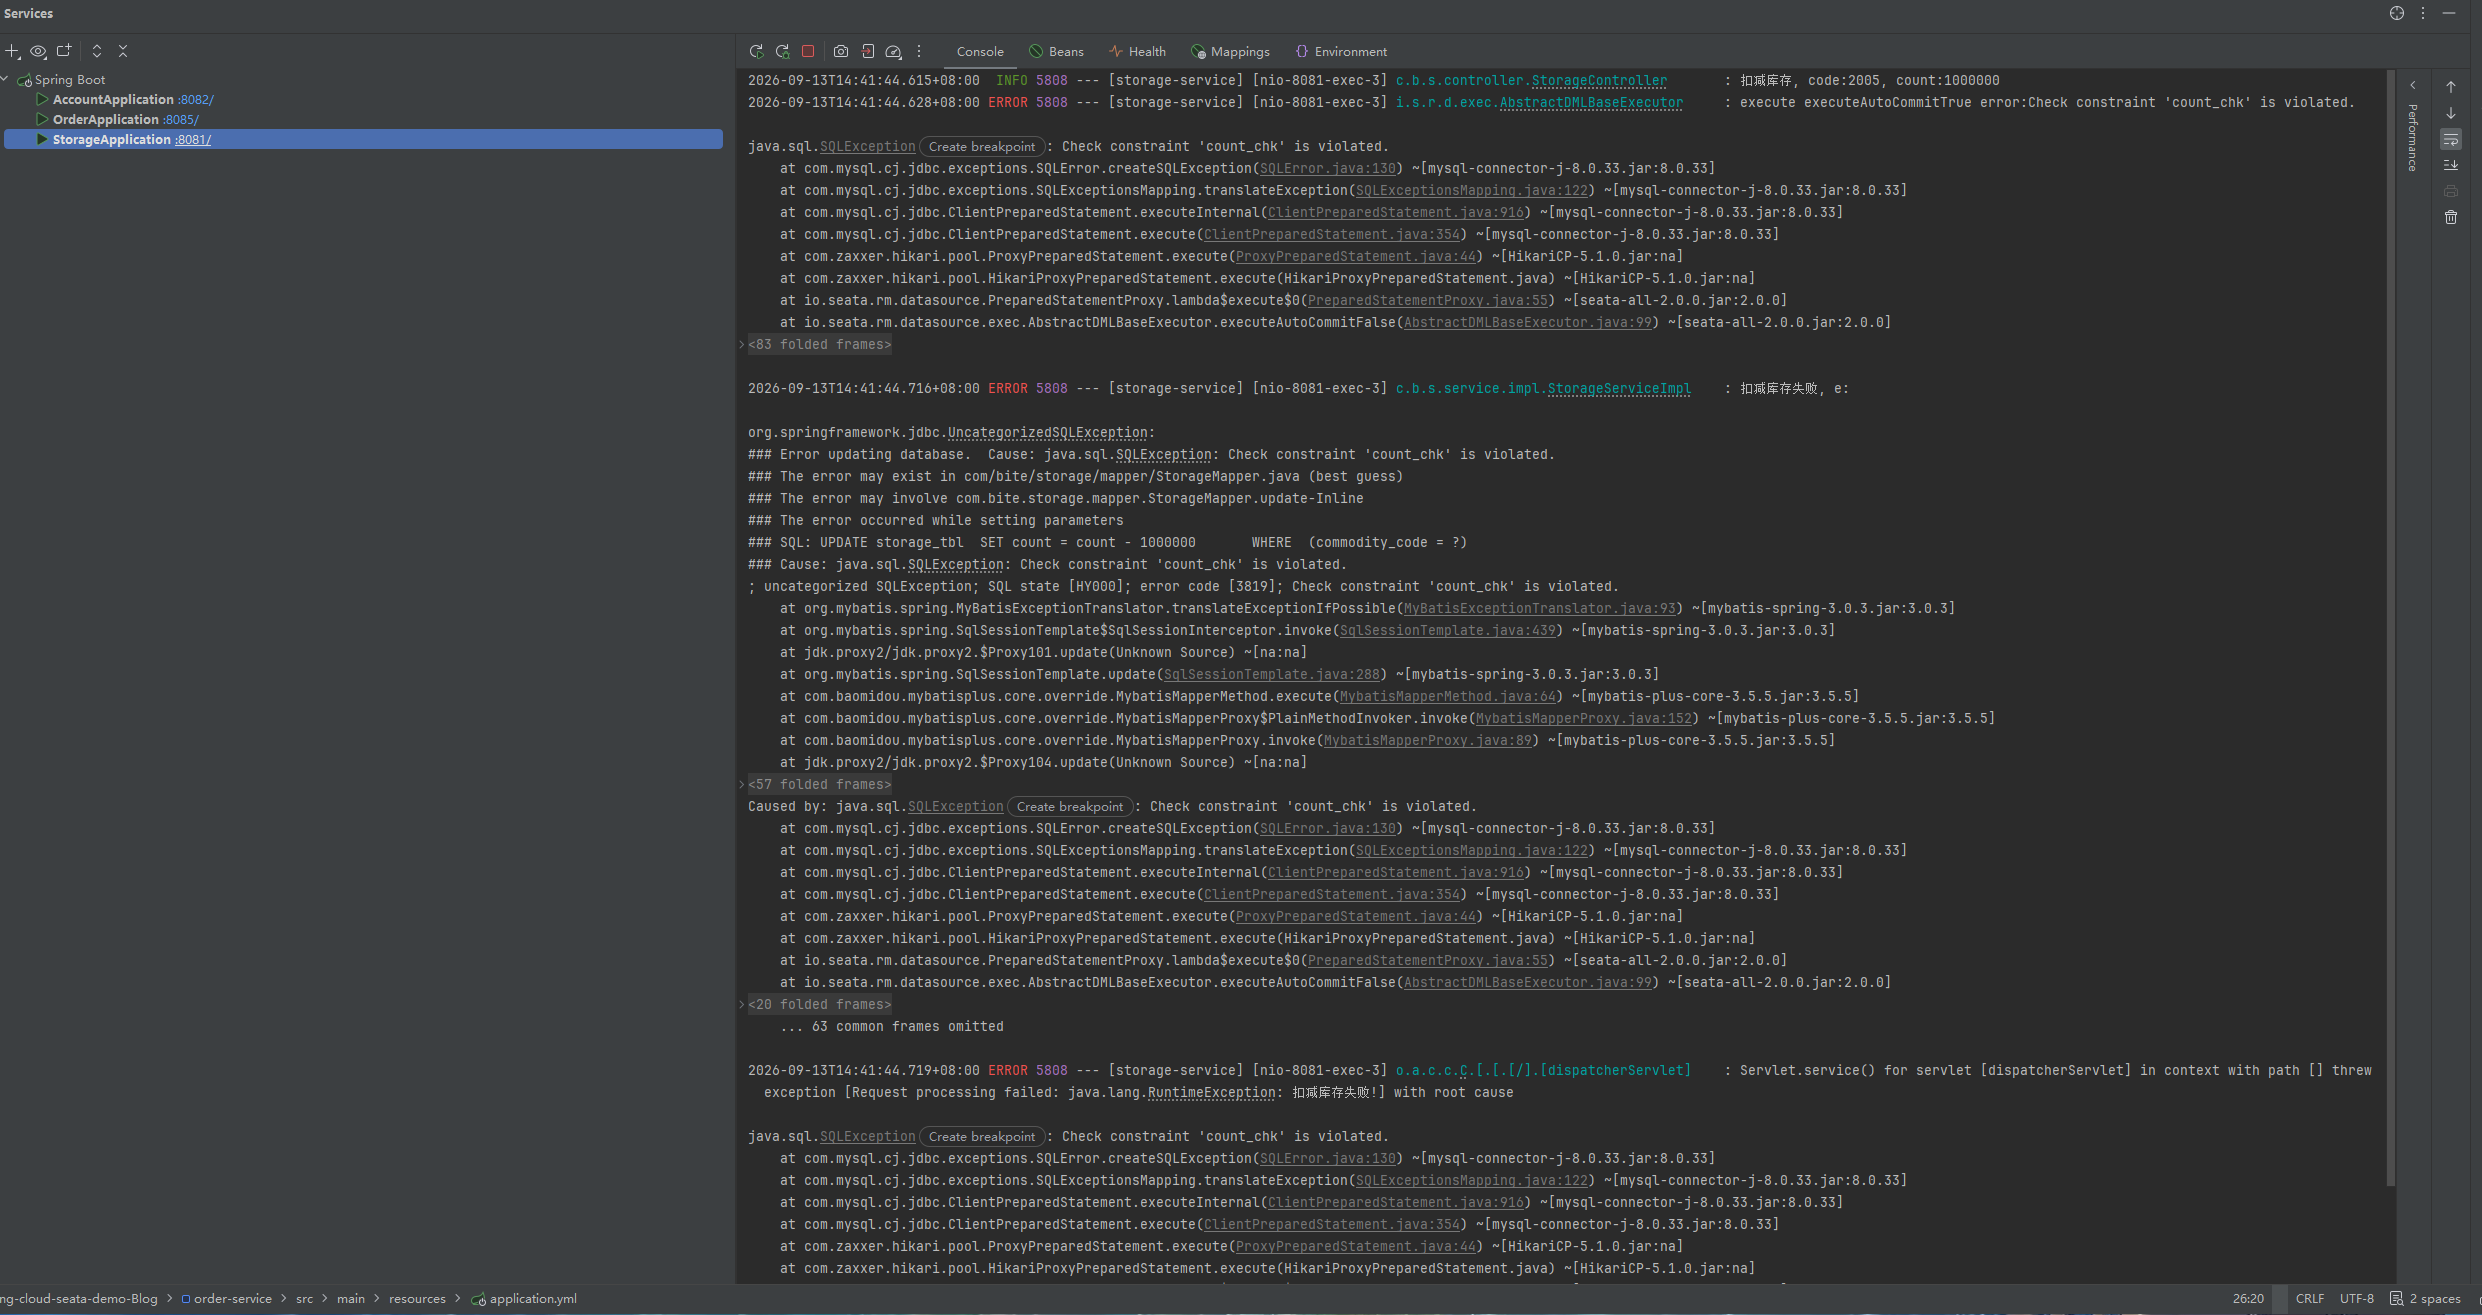
(5).AT和XA的区别
①.从实现方式上看,AT模式是通过记录数据快照来实现数据的回滚,适用于几乎所有的数据库,但是需要在业务库中创建undo_log表;XA模式依赖数据库对XA协议的支持,通过XA规范来实现事务的提交和回滚,XA模式不需要额外的undo_log表,但要求数据库支持XA协议
②.从一致性上看,AT模式是最终一致性,在事务的两阶段之间,数据可能处于中间状态;XA模式是强一致性,事务的中间状态对用户不可见
③.从性能上看,AT模式性能较好,一阶段直接提交,不锁定资源;XA模式性能较差,一阶段锁定资源,等待二阶段结束才释放
④.从代码侵入上看,AT模式和XA模式都没有代码侵入
⑤.从数据库支持上看,AT模式适用于几乎所有支持SQL的数据库;XA模式以来数据库对XA协议的支持
如果对业务对性能要求很高并且可以接受最终一致性,则使用AT模式
如果对业务对数据一致性要求极高且对性能要求不高,则使用XA模式
3.TCC模式
(1).模式介绍
TCC模式是Seata支持的一种由业务方细粒度控制的侵入式分布式事务的解决方案。其分布式事务模型直接作用于服务层,不依赖于底层数据库,可以灵活选择业务资源的额锁定粒度,减少资源锁持有时间,可扩展性好。
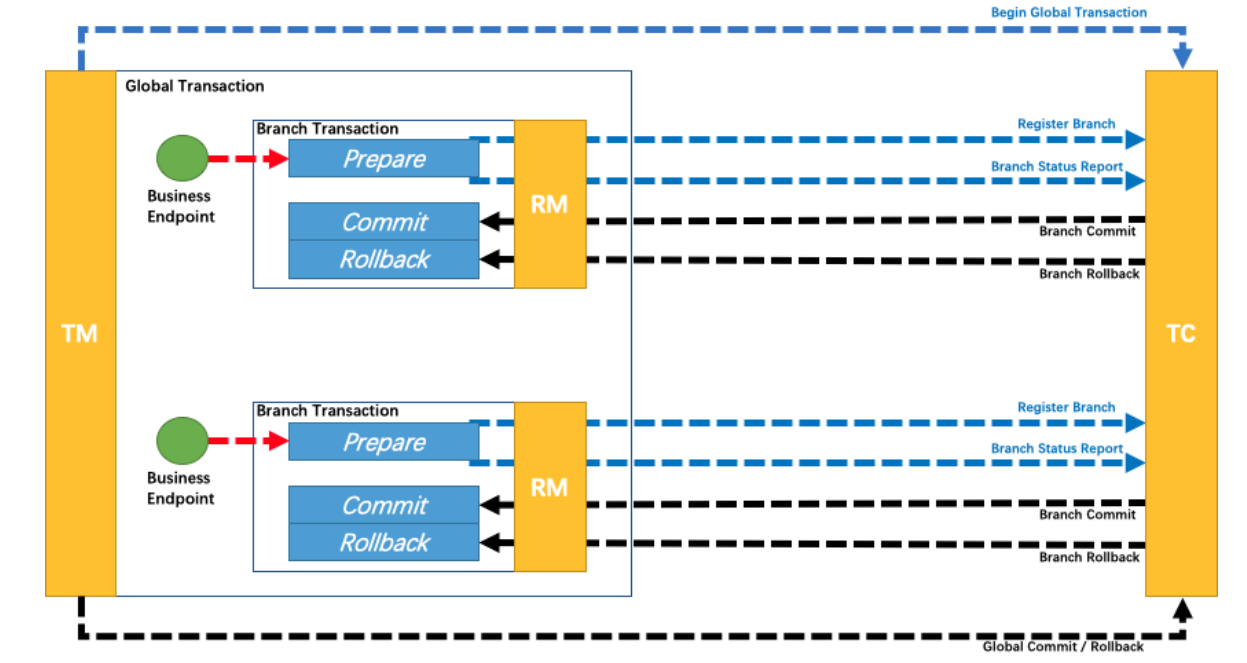
Seata的全局事务,整体是两阶段提交的模型。全局事务是由若干个分支事务组成,每个分支事务都需要具备自己的一阶段prepare行为和二阶段commit或rollback行为
TCC模式,不依赖于底层数据资源的事务支持:
一阶段prepare行为:调用自定义的prepare逻辑
二阶段commit行为:调用自定义的commit逻辑
三阶段rollback行为:调用自定义的rollback逻辑
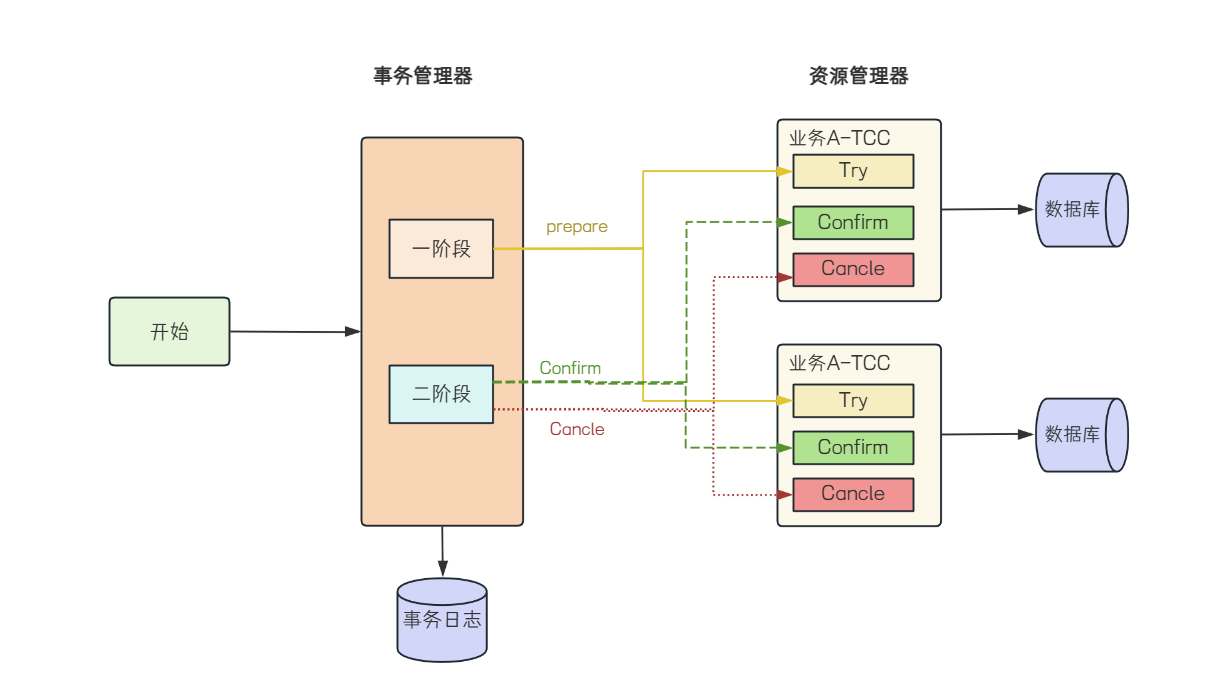
用户实现TCC服务之后,该TCC服务将作为分布式事务的其中一个资源,参与到整个分布式事务中。事务管理器二阶段协调TCC服务,在第一阶段调用所有的TCC服务的Try方法,在第二阶段执行所有TCC服务的Confirm或者Cancel方法,最终所有的TCC服务要么全部提交要么全部回滚
(2).TCC设计
Ⅰ.业务操作分析
这里,以库存扣减为例
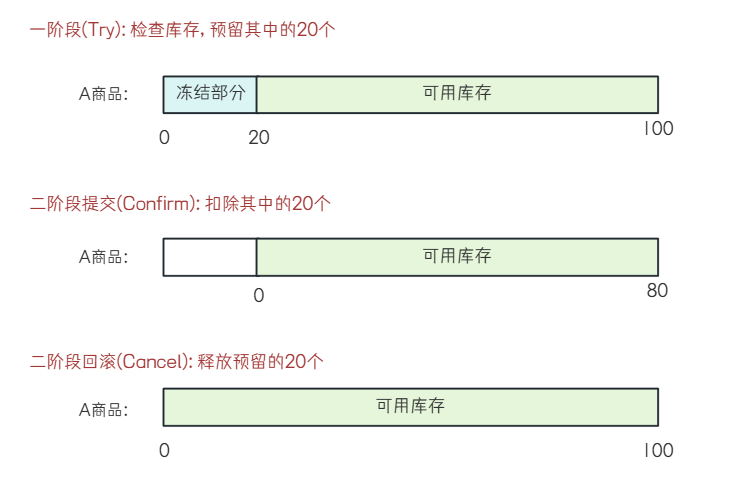
Try操作:进行资源查看和预留。先检查是否够,这个姐u但不发生真正的扣库存
Confirm操作:执行真正业务的提交
Cancel操作:预留资源的是否释放,让商品回到初始状态
Ⅱ.并发控制
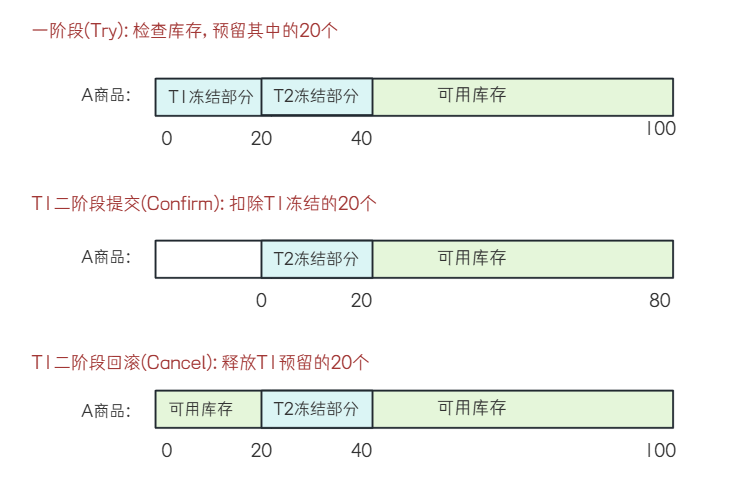
在一阶段Try操作,分布式事务T1和分布式事务T2分别冻结一部分资金,两者相互不干扰。这样,在第二阶段,无论T1是提交还是回滚,都不会对T2产生影响。
Ⅲ.允许空回滚
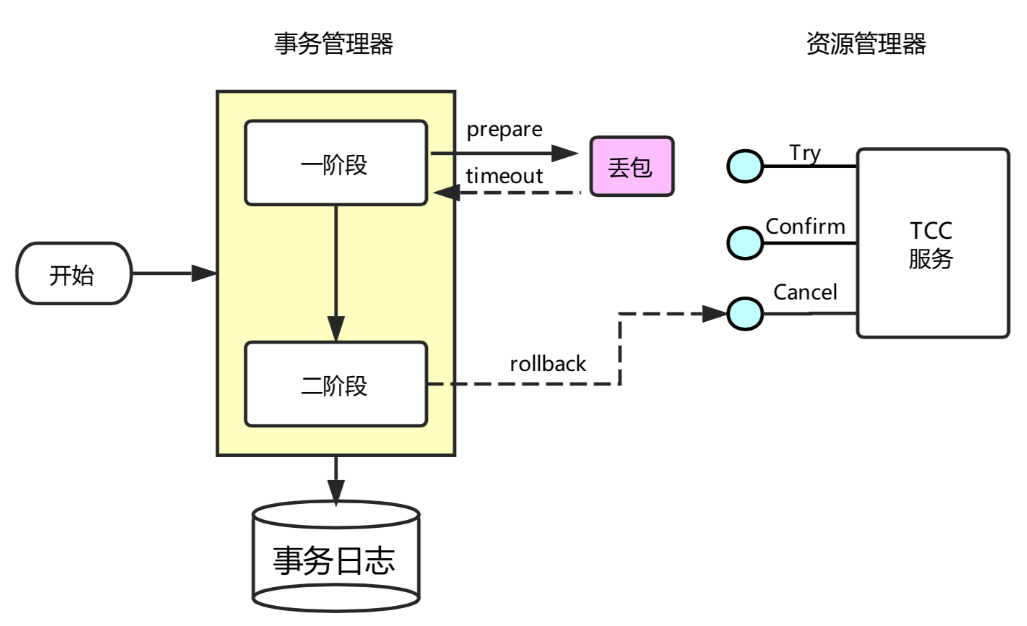
事务协调器在调用TCC服务的一阶段Try操作的时候,可能会出现因为丢包而导致的网络超时,此时事务管理器会触发二阶段回滚,调用TCC服务的Cancel操作,Cancel操作调用未发生超时,TCC服务在未收到Try请求的情况下收到Cancel请求,这种场景称为"空回滚"
Ⅳ.防悬挂控制
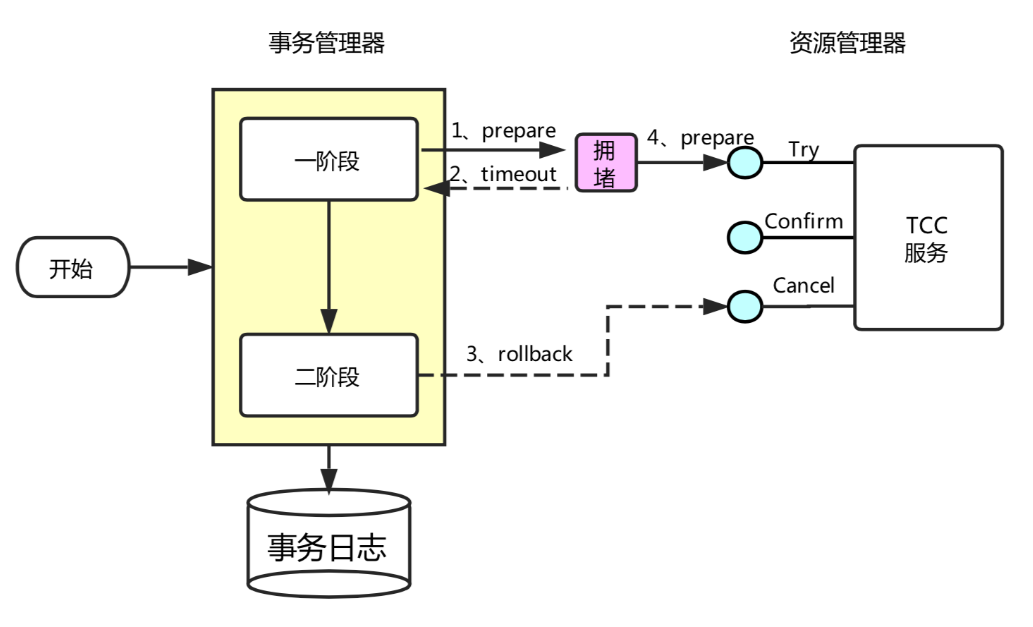
事务协调器在调用TCC服务的一阶段Try操作时,可能会出现因为网络拥堵而导致的超时,此时事务管理器会触发二阶段回滚,调用TCC服务的Cancel操作。在此之后,拥堵在网络上的一阶段Try数据包被TCC服务收到,出现了二阶段的Cancel请求比一阶段Try请求先执行的情况,此时TCC服务在执行晚到的Try之后,将永远不会再收到二阶段的Confirm或者Cancel,造成TCC服务悬挂
Ⅴ.幂等控制
无论是网络包重传,还是异常事务的补偿执行,都会导致TCC服务的Try,Confirm或者Cancel操作被重复执行。
Ⅵ.Seata的解决方式
在Seata1.5.1版本中,增加了一张事务控制表 "tcc_fence_log",包含事务的XID和RranchID信息,来解决这个问题。
sql
CREATE TABLE IF NOT EXISTS `tcc_fence_log`
(
    `xid`        VARCHAR(128) NOT NULL COMMENT 'global id',
    `branch_id`  BIGINT       NOT NULL COMMENT 'branch id',
    `action_name` VARCHAR(64)  NOT NULL COMMENT 'action name',
    `status`     TINYINT      NOT NULL COMMENT 'status(tried:1;committed:2;rollbacked:3;suspended:4)',
    `gmt_create` DATETIME(3)  NOT NULL COMMENT 'create time',
    `gmt_modified` DATETIME(3) NOT NULL COMMENT 'update time',
    PRIMARY KEY (`xid`, `branch_id`),
    KEY `idx_gmt_modified` (`gmt_modified`),
    KEY `idx_status` (`status`)
) ENGINE = InnoDB
DEFAULT CHARSET = utf8mb4;
空回滚:
在Try方法执行时插入一条记录,表示一阶段执行了,执行Cancel方法时读取这条记录,如果记录不存在,说明Try方法没有执行,以此来避免空回滚。
悬挂:
在Rollback阶段,如果查询事务控制表中没有记录,说明Cancel咸鱼Try执行了,因此插入一条status=4的状态记录。当执行Try阶段的时候,判断status=4,则说明有二阶段Cancel已经执行,并返回false来阻止一阶段的Try方法执行成功
幂等:
在TCC事务控制表中增加一个记录状态的字段status,该字段有4个值:
tired(1):表示Try阶段已经执行过
committed(2):表示二阶段Commit已经执行完成
rollbacked(3):表示二阶段Rollback已经执行完成
suspended(4):表示空回滚/悬挂/中止状态
二阶段Confirm/Cancel方法执行后,将状态修改为commited或者rollbacked状态,当重复调用二阶段Confirm/Cancel方法时,判断事务状态即可解决幂等问题
(3).TCC实现
以库存服务(storage-service)为例
Ⅰ.创建事务控制表
sql
CREATE TABLE IF NOT EXISTS `tcc_fence_log`
(
    `xid`        VARCHAR(128) NOT NULL COMMENT 'global id',
    `branch_id`  BIGINT       NOT NULL COMMENT 'branch id',
    `action_name` VARCHAR(64)  NOT NULL COMMENT 'action name',
    `status`     TINYINT      NOT NULL COMMENT 'status(tried:1;committed:2;rollbacked:3;suspended:4)',
    `gmt_create` DATETIME(3)  NOT NULL COMMENT 'create time',
    `gmt_modified` DATETIME(3) NOT NULL COMMENT 'update time',
    PRIMARY KEY (`xid`, `branch_id`),
    KEY `idx_gmt_modified` (`gmt_modified`),
    KEY `idx_status` (`status`)
) ENGINE = InnoDB
DEFAULT CHARSET = utf8mb4;
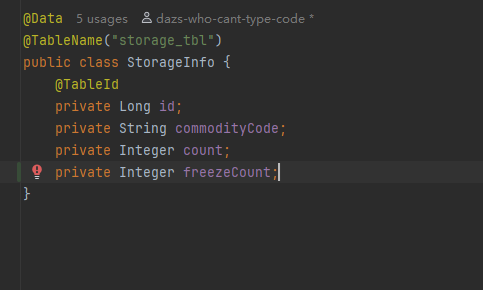
Ⅱ.添加冻结字段
为了完成一阶段Try资源的预检,以及T2阶段事务的提交或回滚,需要增加一个新的字段,表示冻结部分
sql
-- 添加冻结字段
ALTER TABLE storage_tbl ADD COLUMN freeze_count INT(11) unsigned DEFAULT 0
COMMENT '冻结库存';
同时,修改对应的实体类
Ⅲ.TCC接口定义与实现
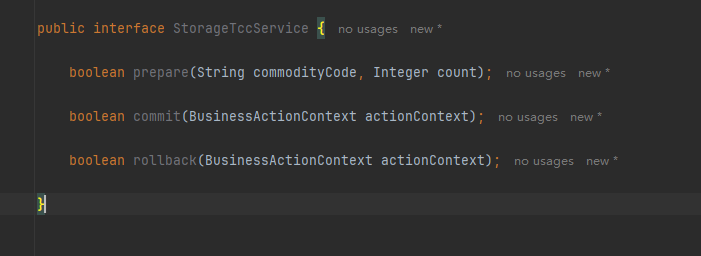
在库存服务中定义TCC接口
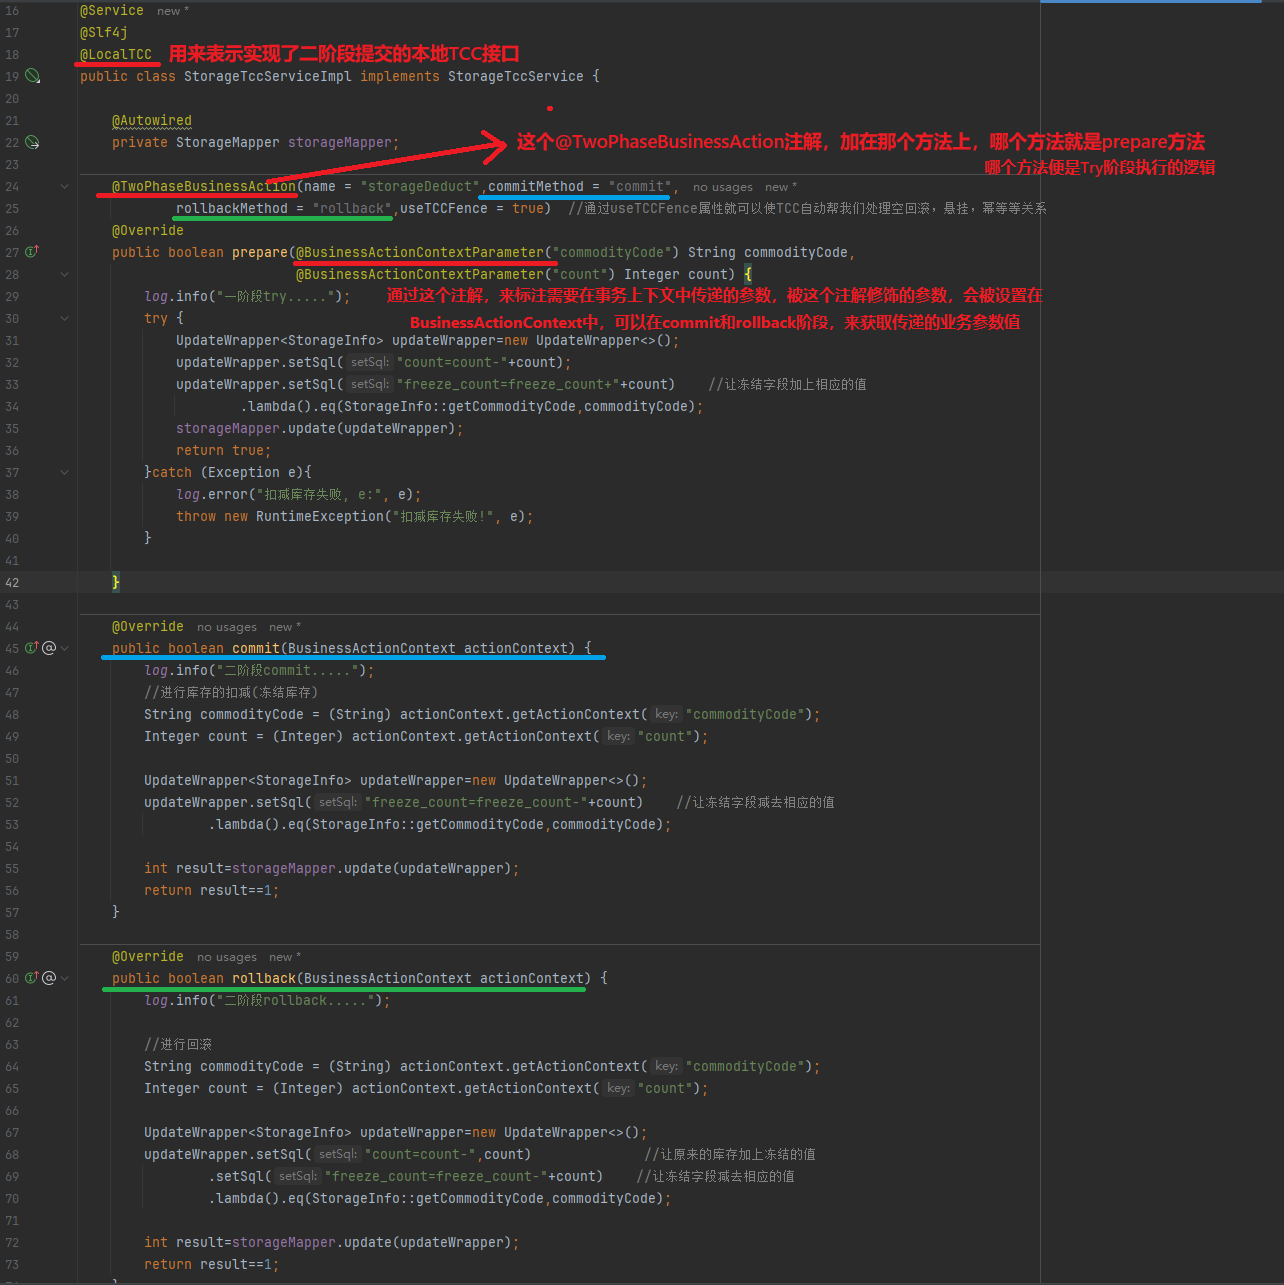
实现TCC接口
java
package com.bite.storage.service.impl;

import com.baomidou.mybatisplus.core.conditions.update.UpdateWrapper;
import com.bite.storage.entity.StorageInfo;
import com.bite.storage.mapper.StorageMapper;
import com.bite.storage.service.StorageTccService;
import io.seata.rm.tcc.api.BusinessActionContext;
import io.seata.rm.tcc.api.BusinessActionContextParameter;
import io.seata.rm.tcc.api.LocalTCC;
import io.seata.rm.tcc.api.TwoPhaseBusinessAction;
import lombok.extern.slf4j.Slf4j;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.stereotype.Service;


@Service
@Slf4j
@LocalTCC

public class StorageTccServiceImpl implements StorageTccService {

    @Autowired
    private StorageMapper storageMapper;

    @TwoPhaseBusinessAction(name = "storageDeduct",commitMethod = "commit",
            rollbackMethod = "rollback",useTCCFence = true)  //通过useTCCFence属性就可以使TCC自动帮我们处理空回滚,悬挂,幂等等关系
    @Override
    public boolean prepare(@BusinessActionContextParameter("commodityCode") String commodityCode,
                           @BusinessActionContextParameter("count") Integer count) {
        log.info("一阶段try.....");
        try {
            UpdateWrapper<StorageInfo> updateWrapper=new UpdateWrapper<>();
            updateWrapper.setSql("count=count-"+count);
            updateWrapper.setSql("freeze_count=freeze_count+"+count)    //让冻结字段加上相应的值
                    .lambda().eq(StorageInfo::getCommodityCode,commodityCode);
            storageMapper.update(updateWrapper);
            return true;
        }catch (Exception e){
            log.error("扣减库存失败, e:", e);
            throw new RuntimeException("扣减库存失败!", e);
        }

    }

    @Override
    public boolean commit(BusinessActionContext actionContext) {
        log.info("二阶段commit.....");
        //进行库存的扣减(冻结库存)
        String commodityCode = (String) actionContext.getActionContext("commodityCode");
        Integer count = (Integer) actionContext.getActionContext("count");

        UpdateWrapper<StorageInfo> updateWrapper=new UpdateWrapper<>();
        updateWrapper.setSql("freeze_count=freeze_count-"+count)    //让冻结字段减去相应的值
                .lambda().eq(StorageInfo::getCommodityCode,commodityCode);

        int result=storageMapper.update(updateWrapper);
        return result==1;
    }

    @Override
    public boolean rollback(BusinessActionContext actionContext) {
        log.info("二阶段rollback.....");

        //进行回滚
        String commodityCode = (String) actionContext.getActionContext("commodityCode");
        Integer count = (Integer) actionContext.getActionContext("count");

        UpdateWrapper<StorageInfo> updateWrapper=new UpdateWrapper<>();
        updateWrapper.setSql("count=count-"+count)              //让原来的库存加上冻结的值
                .setSql("freeze_count=freeze_count-"+count)    //让冻结字段减去相应的值
                .lambda().eq(StorageInfo::getCommodityCode,commodityCode);

        int result=storageMapper.update(updateWrapper);
        return result==1;
    }
}
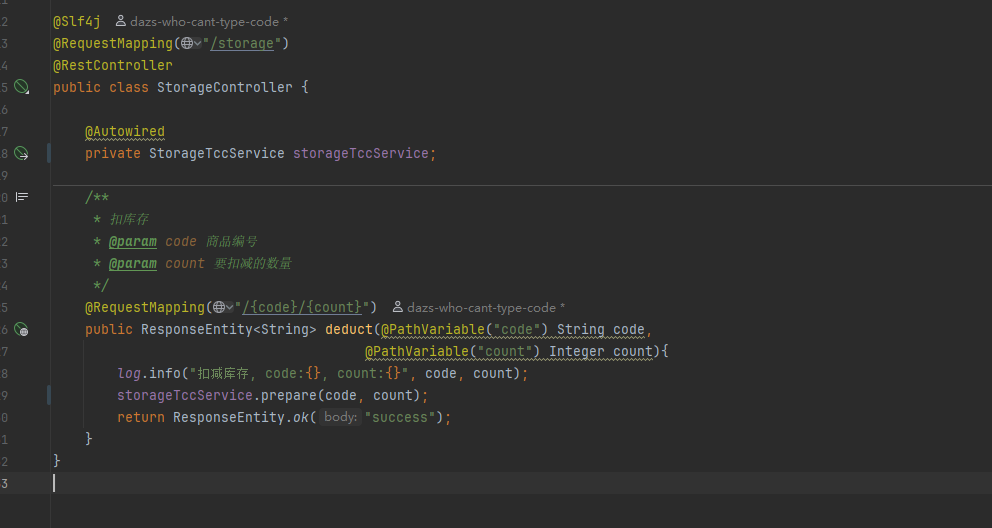
然后在Controller层中修改指向
下面进行测试
status=2的状态
status=2表示正常提交
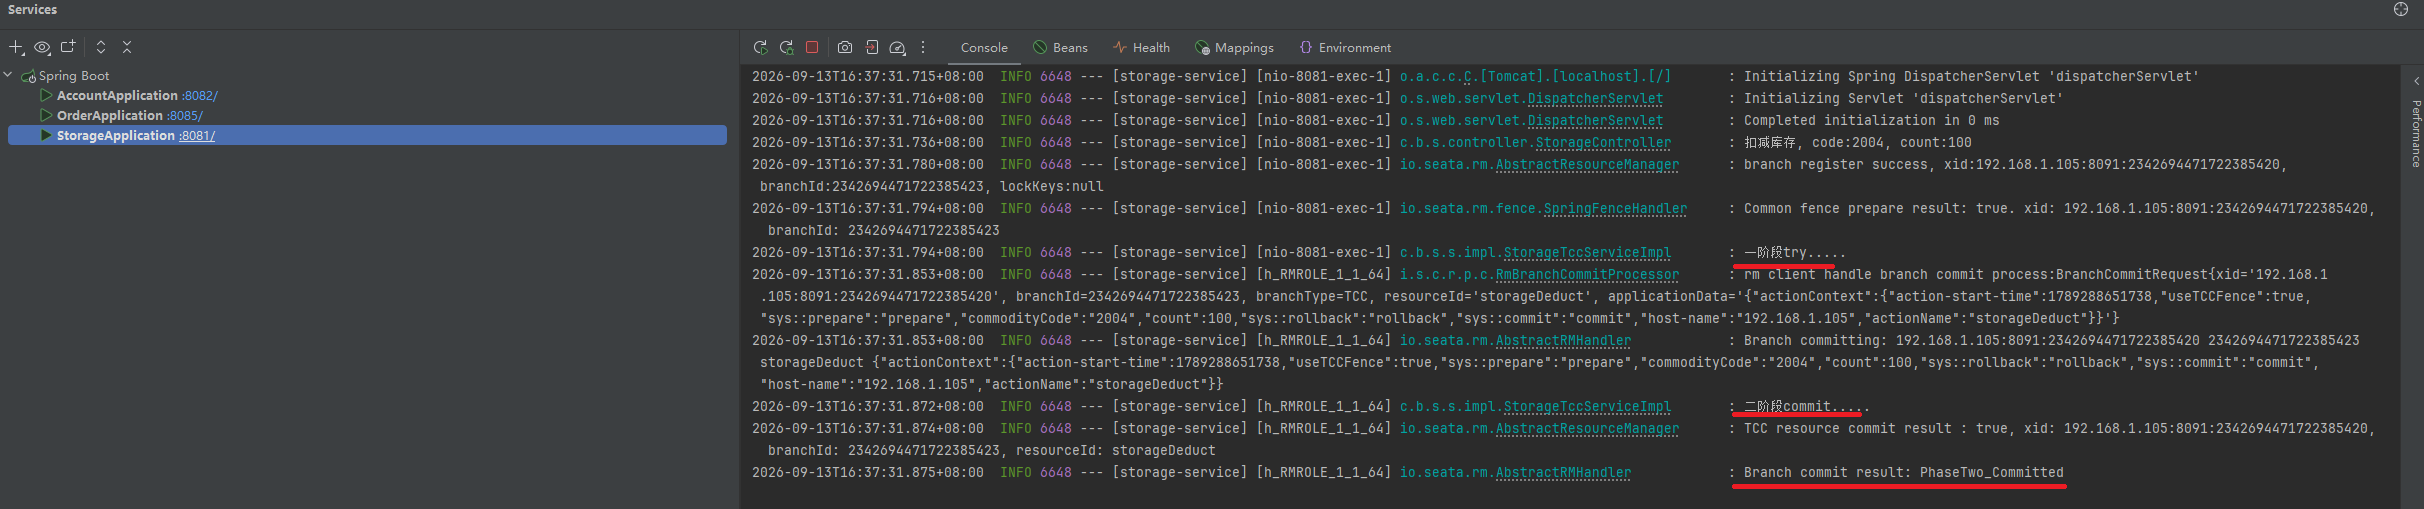
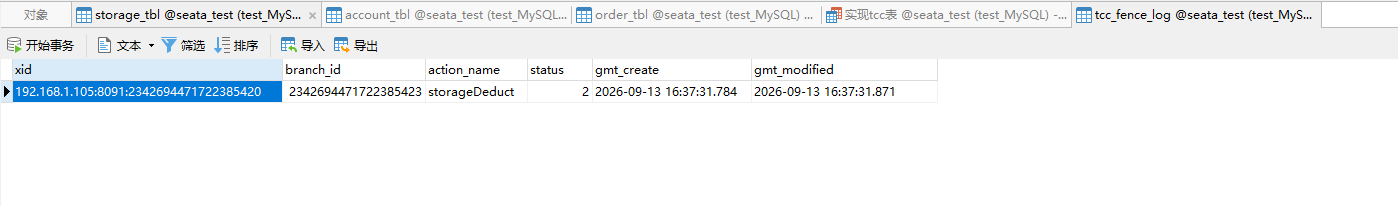
可以看到,status=2
status=1的状态
status=1表示Try阶段已经执行过了
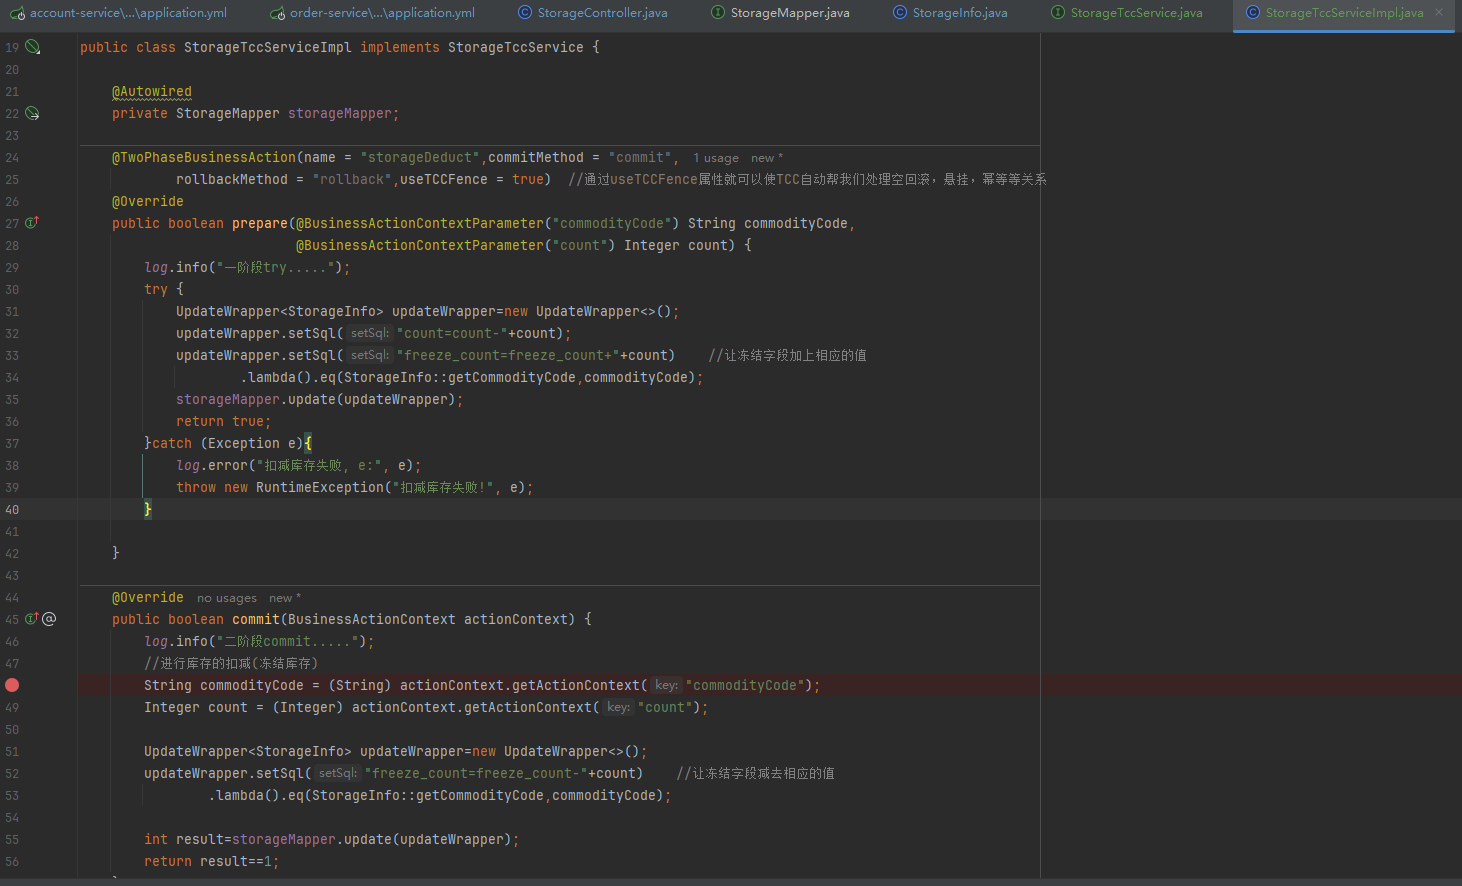
我们可以直接在第二阶段这里,打上断点,然后开始调试
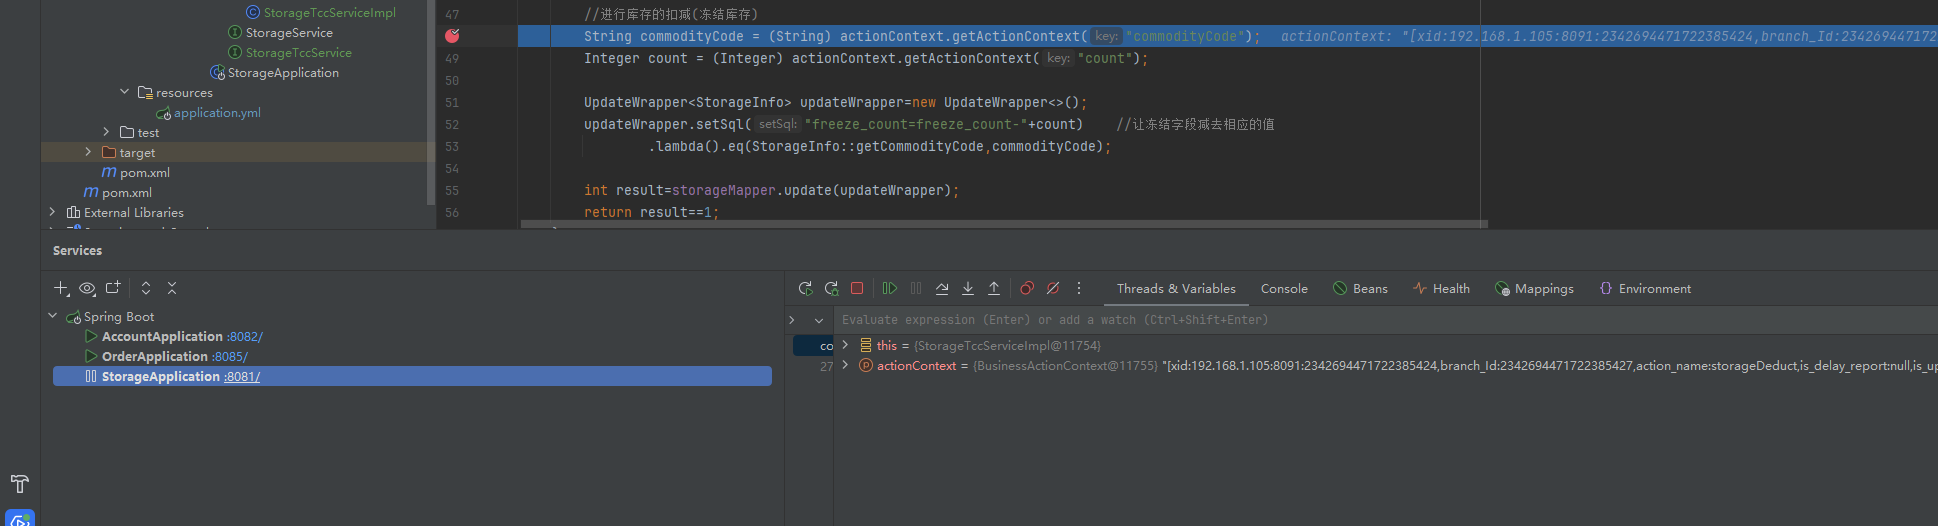
现在已经在调试了
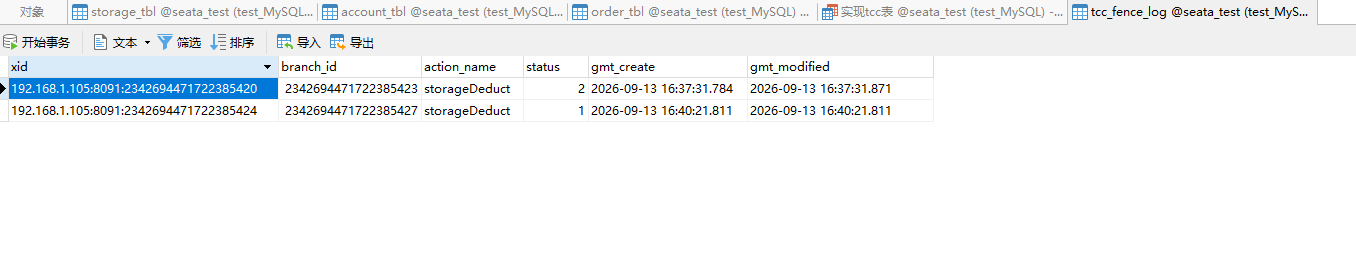
此时,可以发现,status就为1
status=4的状态
status=4是发生了空回滚/悬挂/中止状态
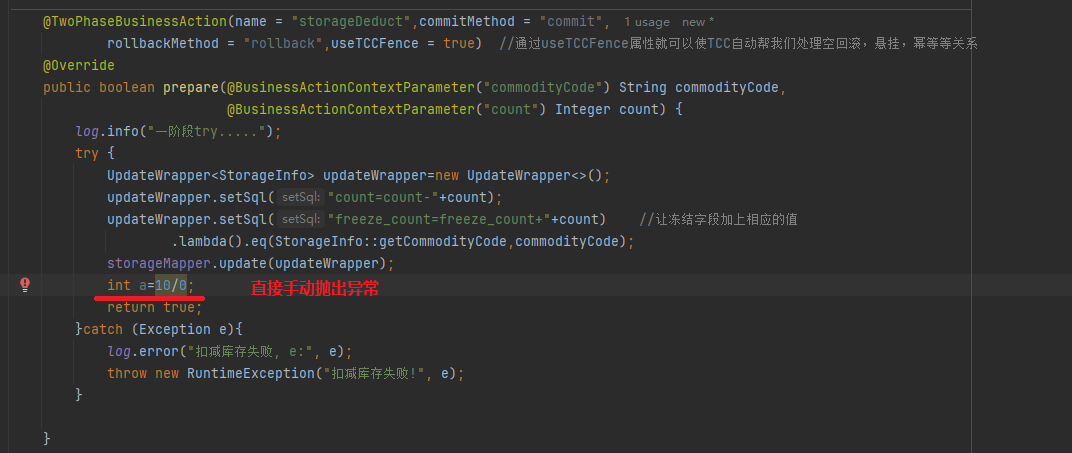
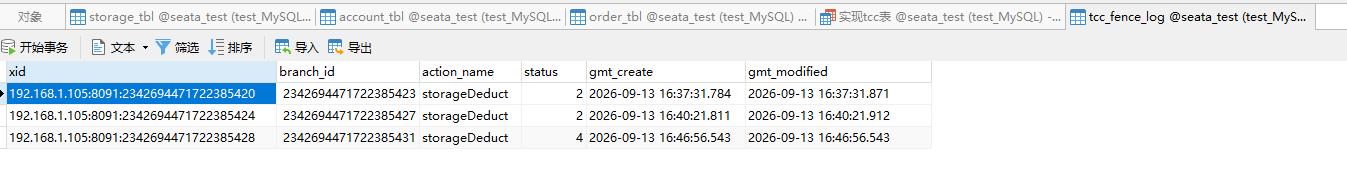
可以看到,status=4
status=3的状态
status=3是进行了回滚
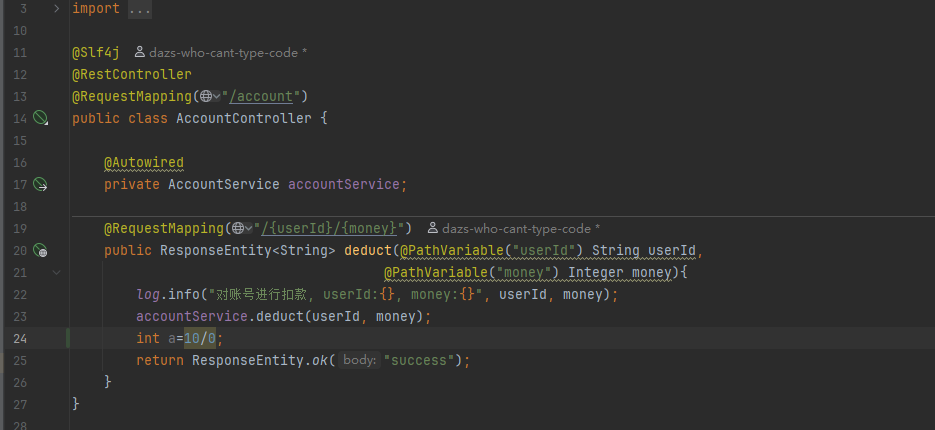
我在余额项目中手动抛异常
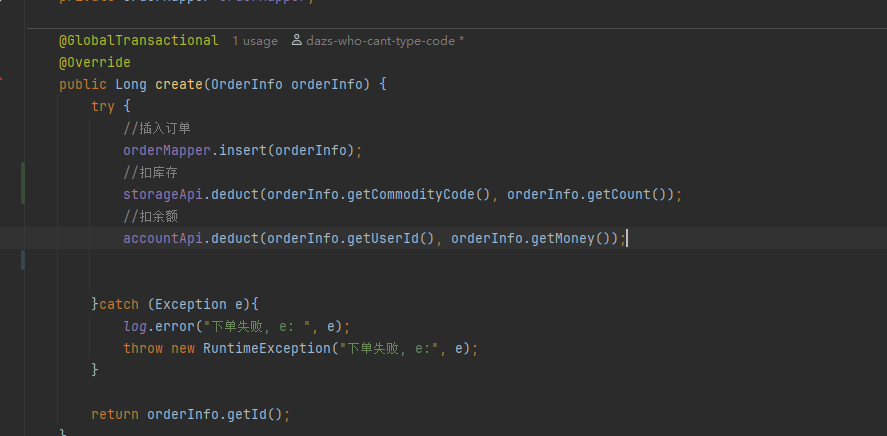
当余额抛出异常的时候,库存项目已经执行完成了,但是由于余额项目抛出异常,所以库存项目也不得不进行事务回滚操作
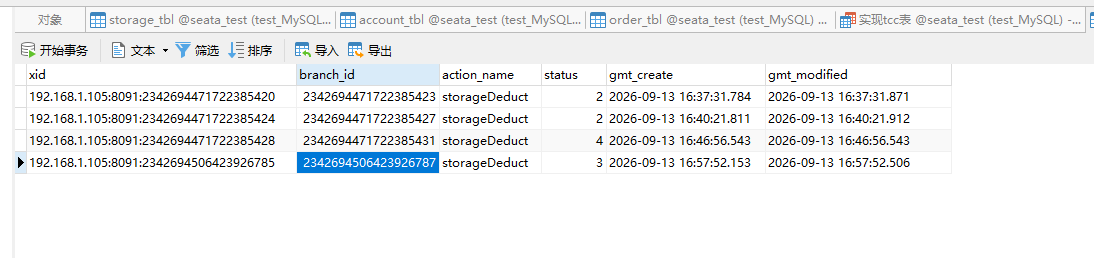
Ⅳ.优缺点:
优点:
①.性能高:TCC模式没有全局锁,事务的提交和回滚都是由应用代码实现,资源锁定时间短,性能较高;
②.灵活性强:可以自定义Try Confirm Cancel逻辑,适合复杂的业务场景
③.不依赖数据库事务:可以提供过更细粒度的控制,可以用非事务型数据库
缺点:
①.开发成本高,需要自己编写Try Confirm Cancel接口
②.适用场景有限:对于复杂的业务,补偿逻辑可能会非常复杂,补偿成本过高的业务不适合使用TCC模式
4.Saga模式
(1).介绍
Saga模式是Seata提供的长事务解决方案
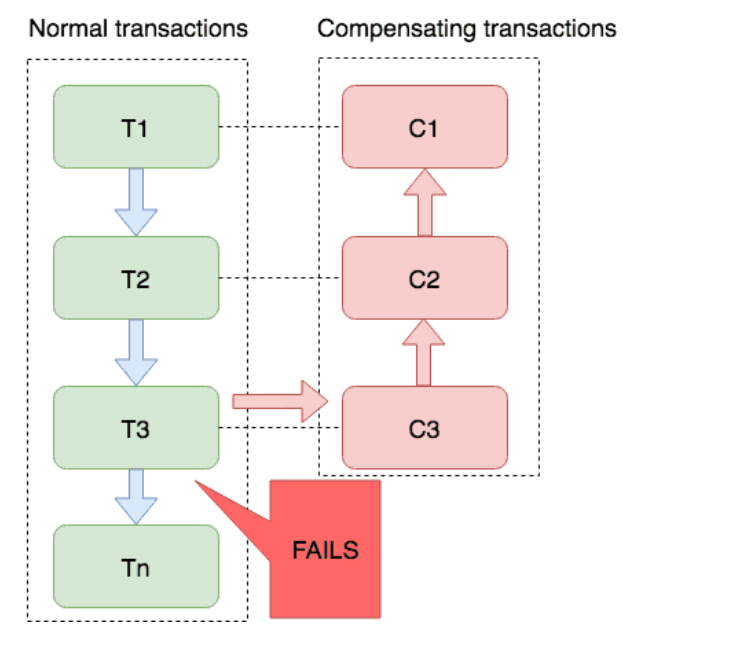
Saga由一系列sub-transaction Ti组成,每个Ti都有对应的补偿动作Ci,补偿动作用于撤销T造成的数据变更结果,它和TCC相比,少了Try这个预留动作,每个T操作都真实的影响数据库。
(2).适用场景
①.业务流程长,业务流程多
②.参与者包含其他公司或遗留系统服务,无法提供TCC模式要求的三个接口
(3).优缺点
优点:
①.一阶段提交本地事务,无锁,高性能
②.事务驱动架构,参与者可异步执行,高吞吐
③.补偿服务易于实现
缺点:
不保证隔离性
5.四种模式对比
|-------|------------------------------------------------------------------|--------------------------------------------------------|------------------------------|-----------------------------------------|
| | XA | AT | TCC | SEGA |
| 实现方式 | ①.依赖数据库对XA协议的支持,通过XA规范来实现事务的提交和回滚 ②.不需要额外的undo_log表,但要求数据库支持XA协议 | ①.通过记录数据快照来实现数据的回滚 ②.适用于几乎所有的数据库,但是需要在业务库中创建undio_log表 | 开发人员手动实现Try,Confirm,Cancel阶段 | ①.事件驱动,每个事务包含正向操作和逆向补偿操作 ②.失败时按顺序执行逆向补偿 |
| 一致性 | 强一致性,事务的中间状态对用户不可见 | 最终一致性 在事务的两阶段之间,数据可能处于中间状态 | 最终一致性(通过业务代码实现) | 最终一致性 |
| 性能 | 较差,一阶段锁定资源,等待二阶段结束后才释放资源 | 较好,一阶段直接提交,不锁定资源 | 较高,开发成本高,需要处理空回滚等 | 高,无锁,适合长事务 |
| 代码侵入 | 无(微小) | 无 | 有,需要手动编写三个接口 | 有,需要编写状态机和补偿业务 |
| 数据库支持 | 依赖数据库对XA协议的支持 | 适用于几乎所有支持MYSQL的数据库 | 不依赖底层数据库的事务机制 | 不依赖底层数据库的事务机制 |