目录
前言
学习赵老师讲授的强化学习的数学原理视频,本篇文章记录第七讲 Part 7:时序差分方法(Q-learning 伪代码与例子),记录个人学习笔记,和大家一起分享交流😄
1. Q-learning - Implementation
刚才我们介绍了 Q-learning 是 off-policy ,也就是它的 behavior policy 和 target policy 是可以不同的,可以不同意味着也可以相同---相同是不同的一种特殊情况。如果强行让 Q-learning 的 behavior policy 与 target policy 一致,就得到一个 on-policy 算法。
下面分别给出 Q-learning 的 on-policy 和 off-policy 两个版本。
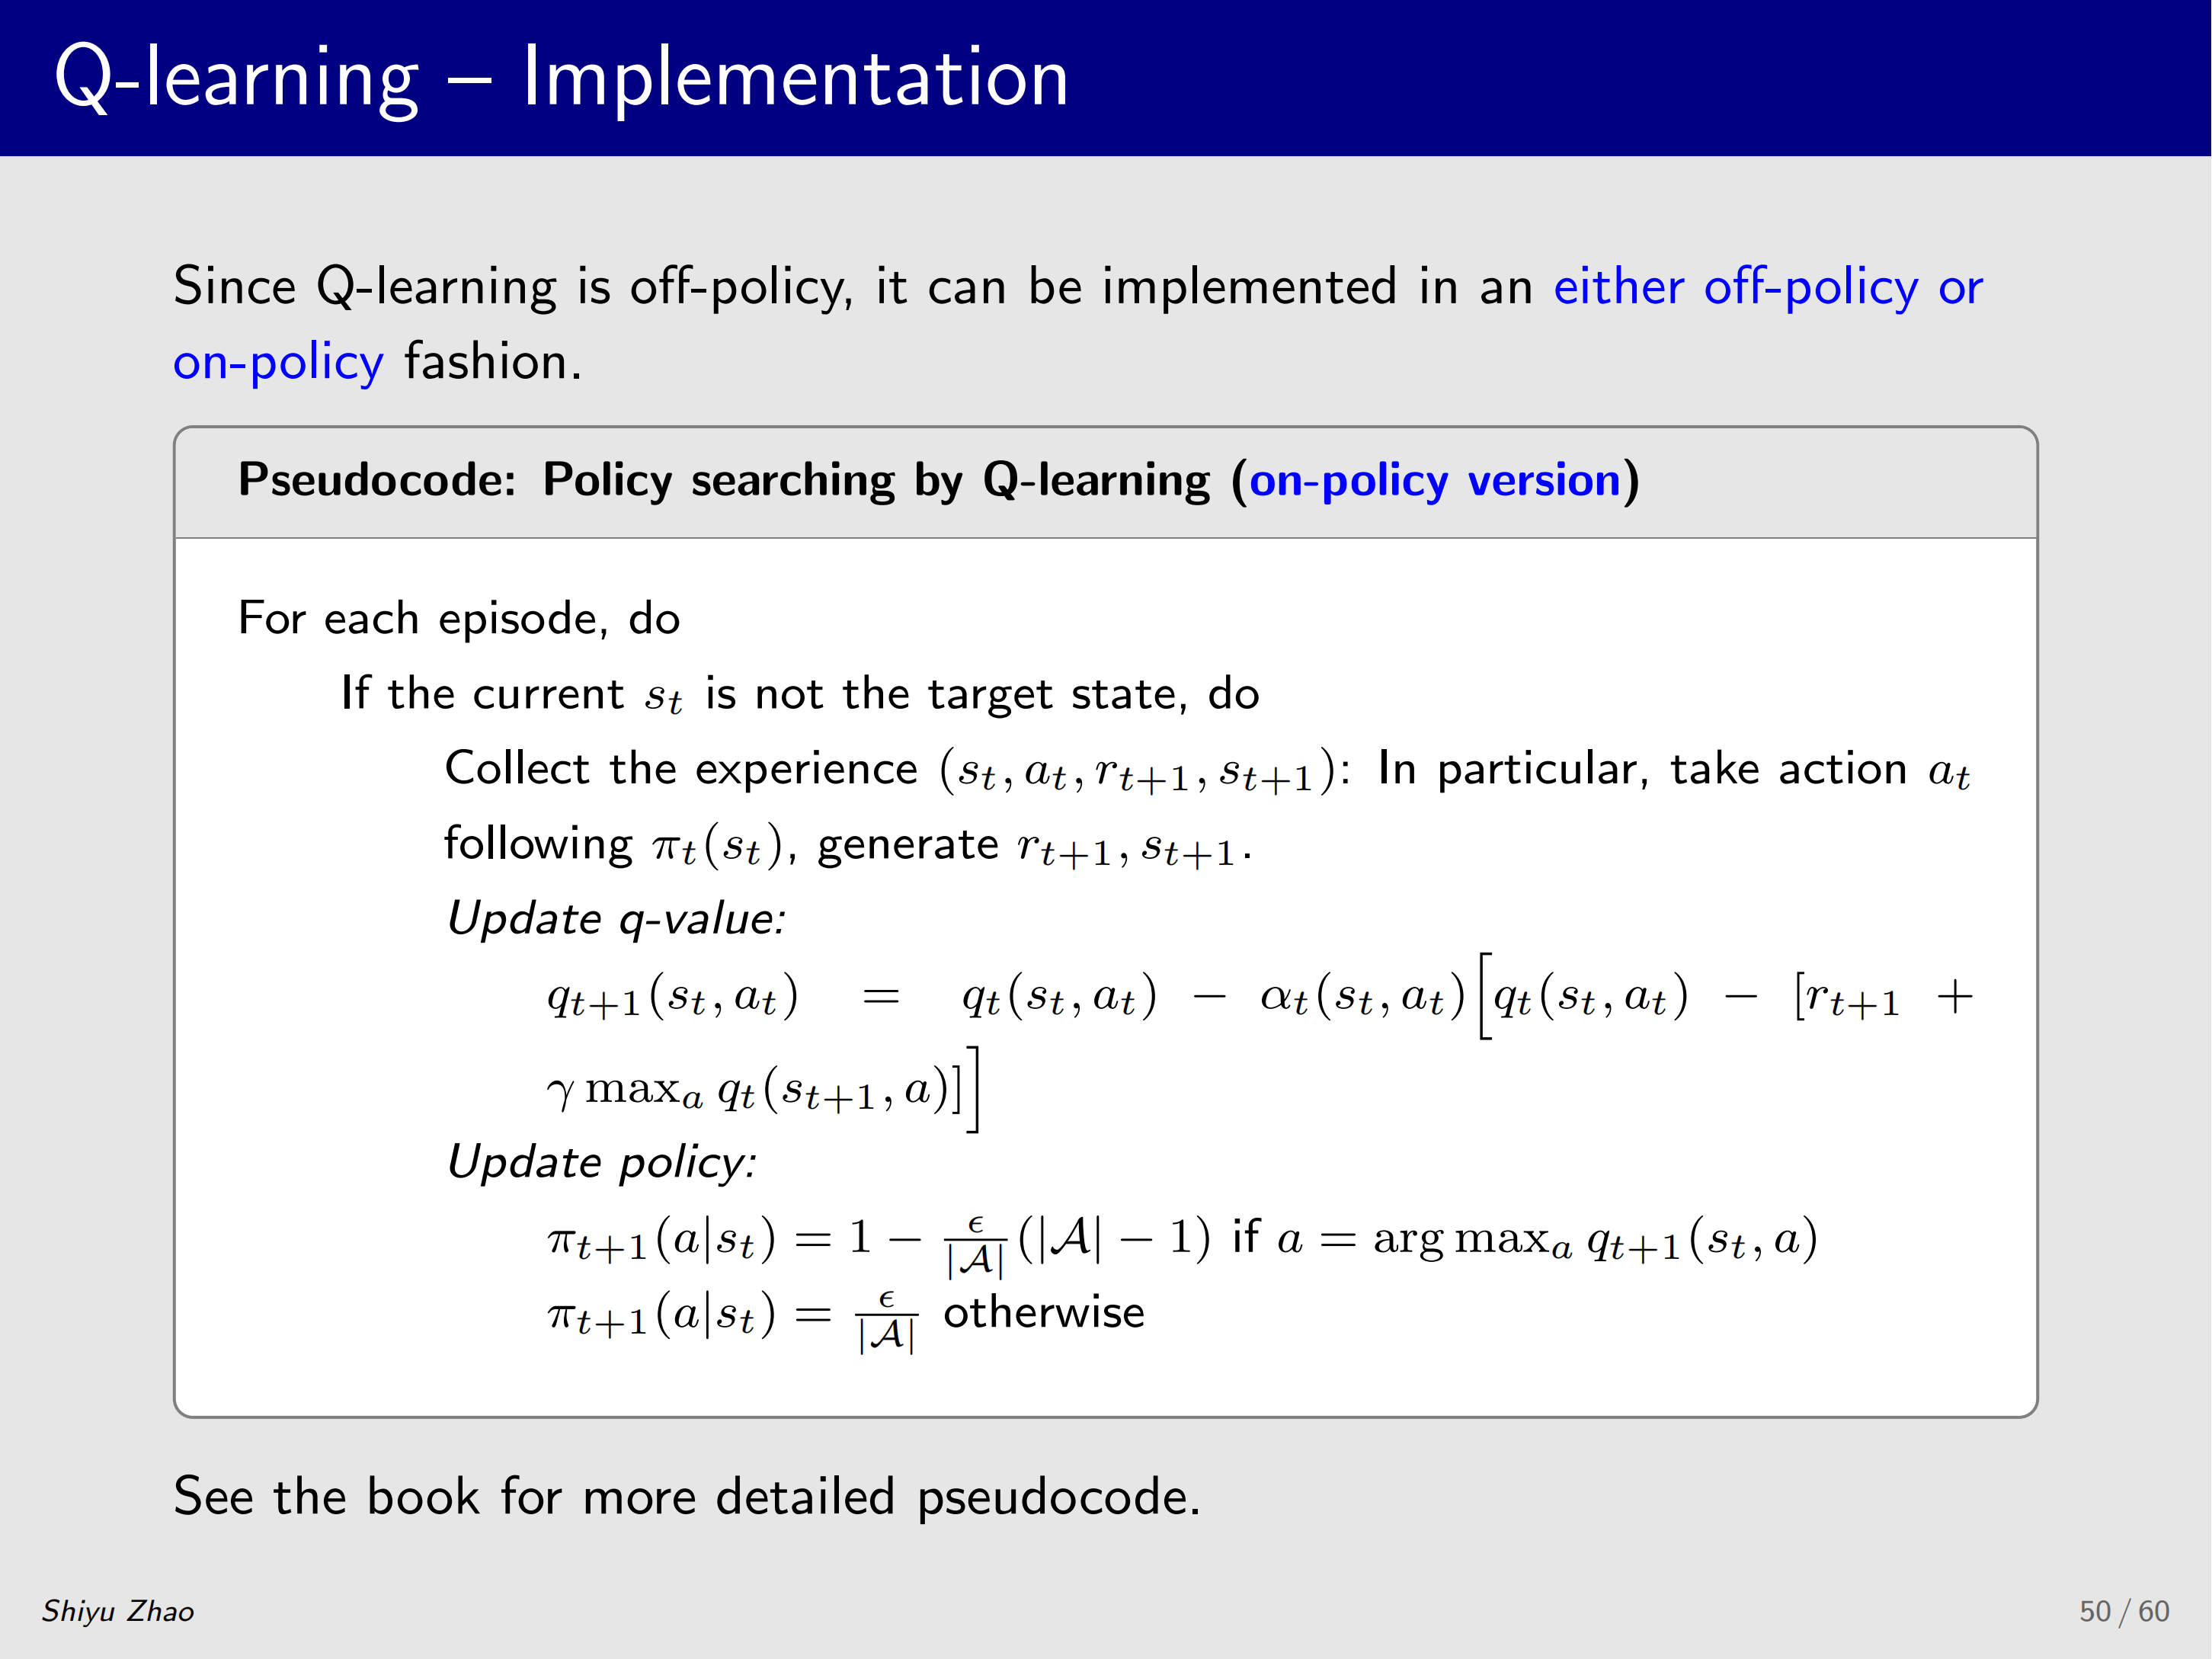
伪代码:通过 Q-learning 进行策略搜索(同策略版本)
对于每一个回合(episode),执行
如果当前 s t s_t st 不是目标状态,执行
收集经验 ( s t , a t , r t + 1 , s t + 1 ) (s_t, a_t, r_{t+1}, s_{t+1}) (st,at,rt+1,st+1):具体而言,根据 π t ( s t ) \pi_t(s_t) πt(st) 采取动作 a t a_t at ,生成 r t + 1 , s t + 1 r_{t+1}, s_{t+1} rt+1,st+1 。
更新 q 值:
q t + 1 ( s t , a t ) = q t ( s t , a t ) − α t ( s t , a t ) q t ( s t , a t ) − \[ r t + 1 + γ max a q t ( s t + 1 , a ) ] q_{t+1}(s_t, a_t) = q_t(s_t, a_t) - \alpha_t(s_t, a_t)\leftq_t(s_t, a_t) - \[r_{t+1} + \\gamma \\max_a q_t(s_{t+1}, a)\right] qt+1(st,at)=qt(st,at)−αt(st,at)qt(st,at)−\[rt+1+γamaxqt(st+1,a)]
更新策略:
π t + 1 ( a ∣ s t ) = 1 − ϵ ∣ A ∣ ( ∣ A ∣ − 1 ) if a = arg max a q t + 1 ( s t , a ) π t + 1 ( a ∣ s t ) = ϵ ∣ A ∣ otherwise \begin{align*} \pi_{t+1}(a|s_t) &= 1 - \frac{\epsilon}{|\mathcal{A}|}(|\mathcal{A}| - 1) \quad \text{if } a = \arg\max_a q_{t+1}(s_t, a) \\ \pi_{t+1}(a|s_t) &= \frac{\epsilon}{|\mathcal{A}|} \quad \text{otherwise} \end{align*} πt+1(a∣st)πt+1(a∣st)=1−∣A∣ϵ(∣A∣−1)if a=argamaxqt+1(st,a)=∣A∣ϵotherwise
Q-learning on-policy 的版本实际上和 Sarsa 一模一样 ,唯一区别在 q value 部分:Sarsa 算法中对应位置是 q t ( s t + 1 , a t + 1 ) q_t(s_{t+1},a_{t+1}) qt(st+1,at+1) ,现在替换成了 max a q t ( s t + 1 , a ) \max_a q_t(s_{t+1}, a) maxaqt(st+1,a) 这一项,其余部分(例如 policy update 用 ε \varepsilon ε-greedy)都一样。
算法流程是:开始有一个策略,用它得到数据;由数据得到 q value;由 q value 得到改进的策略;再用改进的策略得到新数据,如此循环迭代。显然 这个策略既用于生成数据(即 behavior policy),又被不断更新(即 target policy)---所以是 on-policy。
我们来看 Q-learning 的另外一个实现方式,即 off-policy 版本。它怎么实现呢?
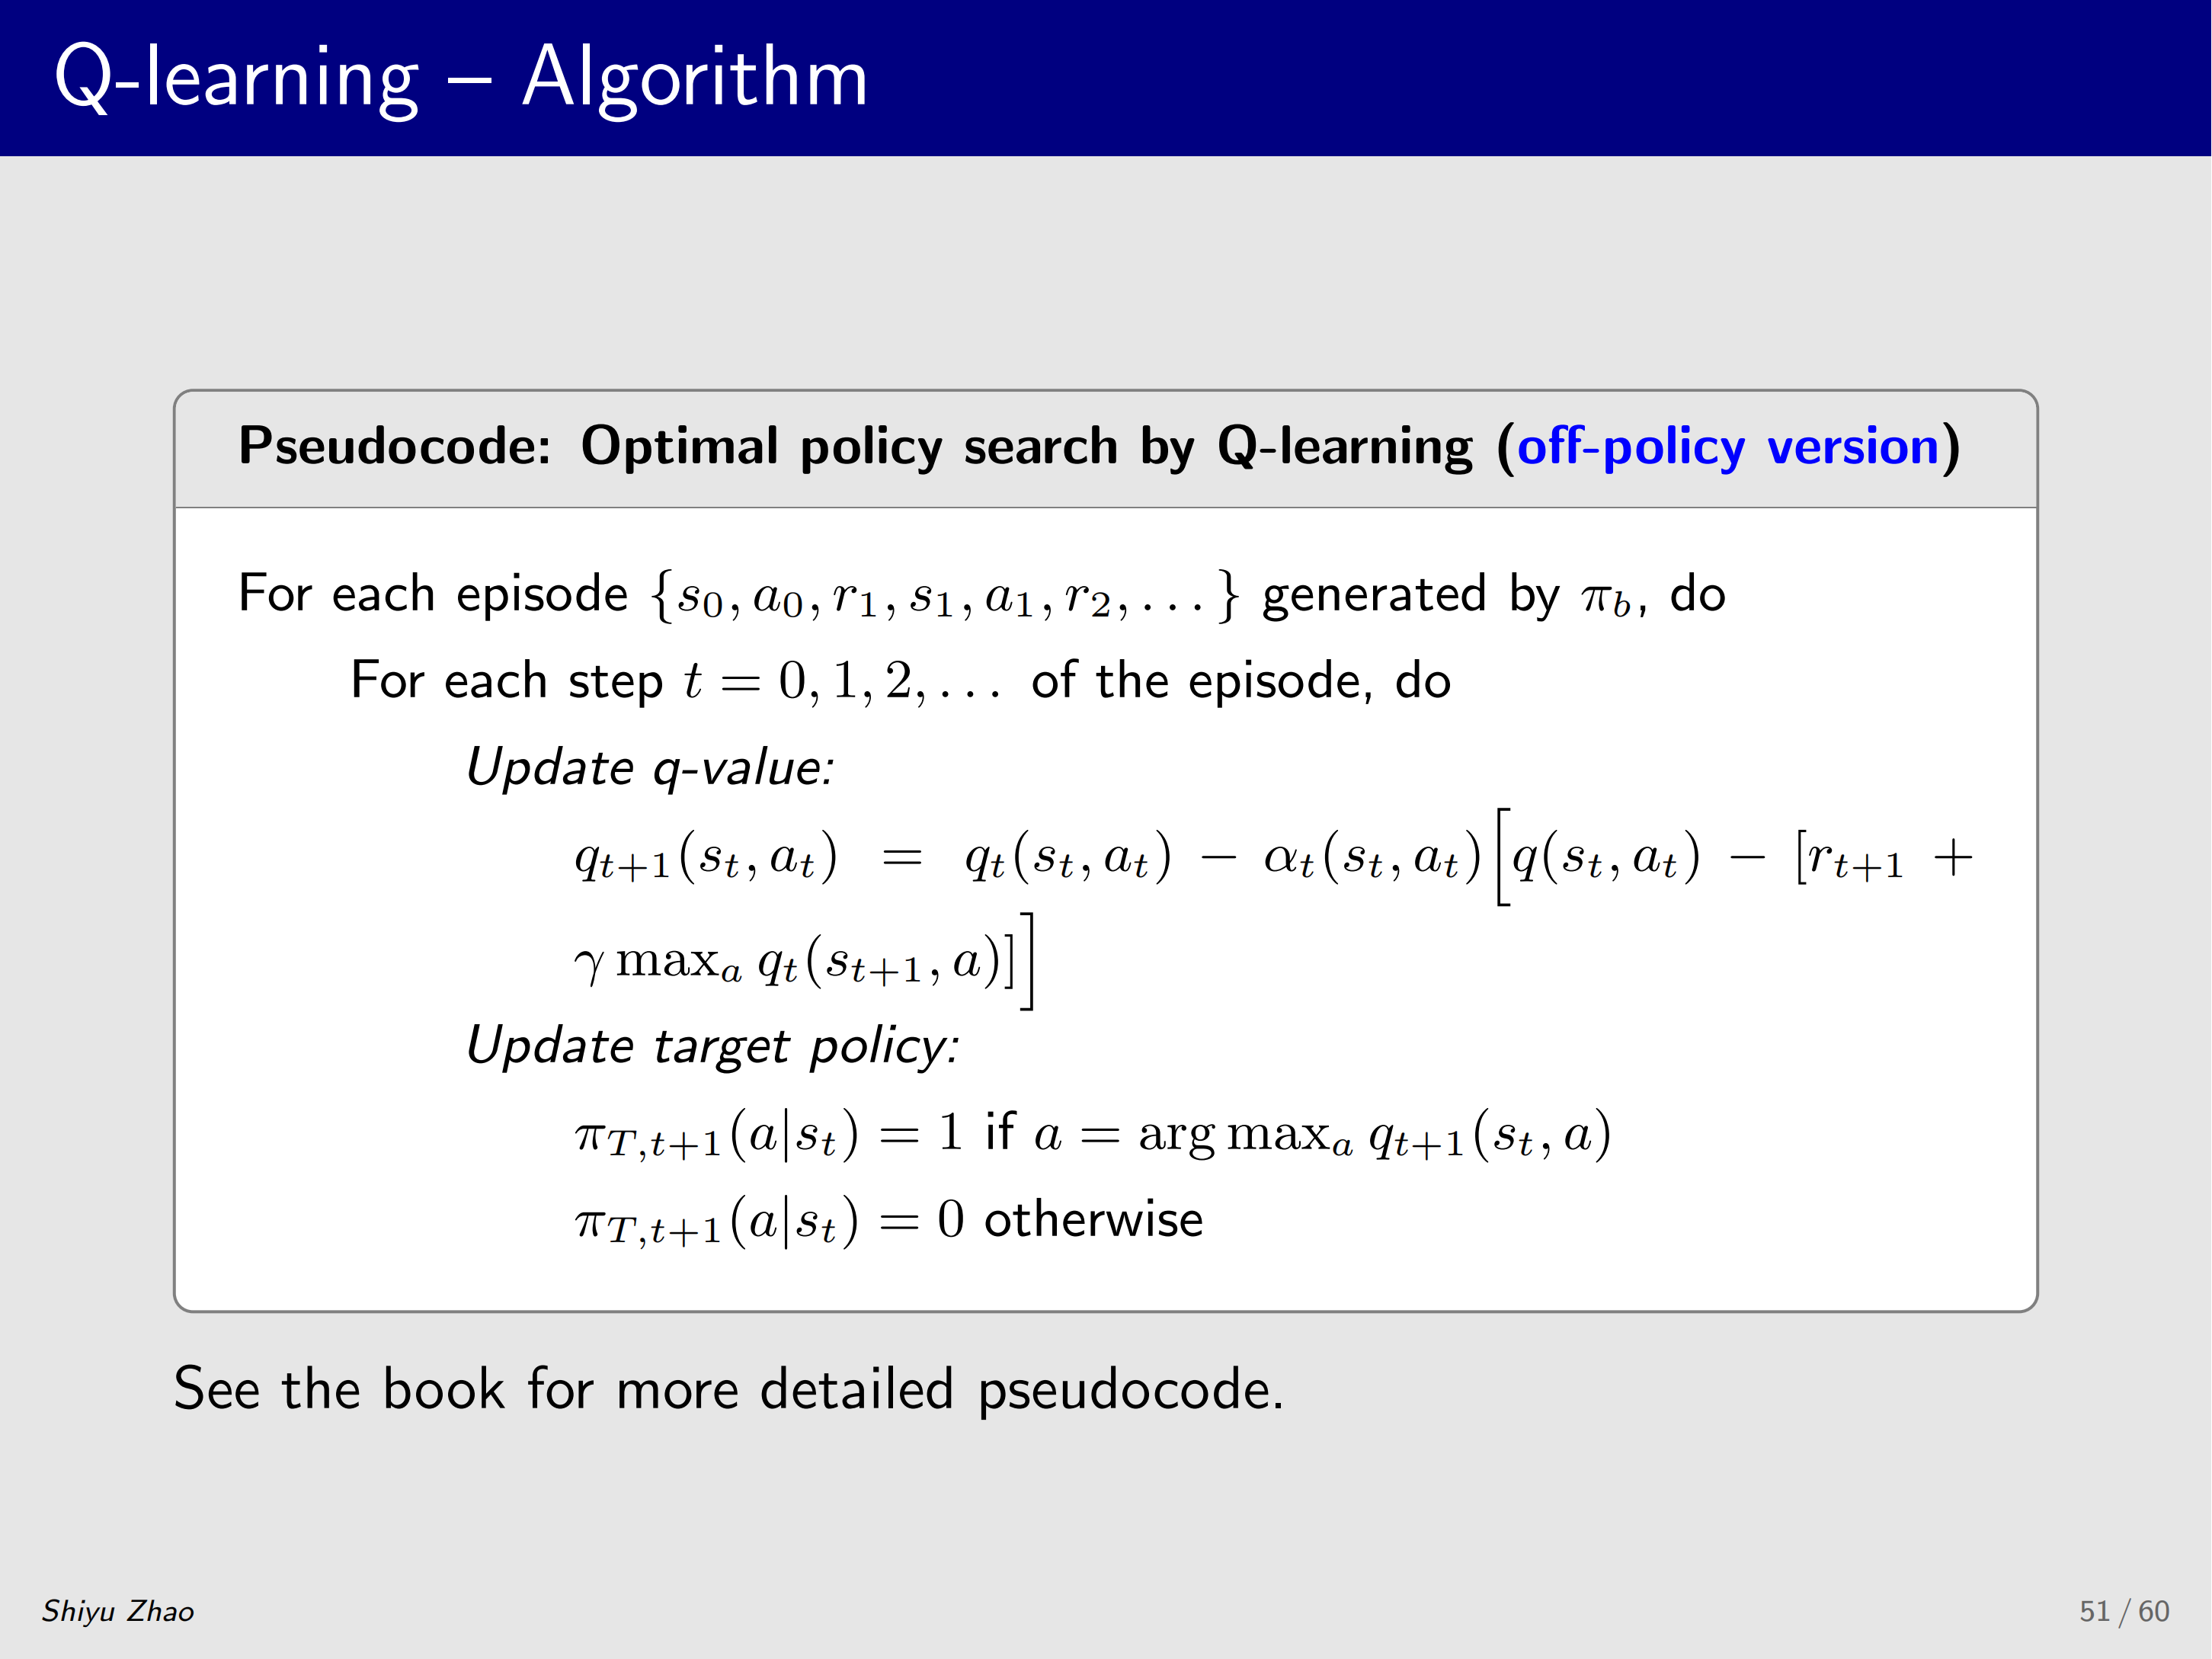
伪代码:通过 Q-learning 进行最优策略搜索(异策略版本)
对于每一个由 π b \pi_b πb 生成的回合 { s 0 , a 0 , r 1 , s 1 , a 1 , r 2 , ... } \{s_0, a_0, r_1, s_1, a_1, r_2, \dots\} {s0,a0,r1,s1,a1,r2,...} ,执行
对于该回合的每一步 t = 0 , 1 , 2 , ... t = 0, 1, 2, \dots t=0,1,2,...,执行
更新 q 值:
q t + 1 ( s t , a t ) = q t ( s t , a t ) − α t ( s t , a t ) q t ( s t , a t ) − \[ r t + 1 + γ max a q t ( s t + 1 , a ) ] q_{t+1}(s_t, a_t) = q_t(s_t, a_t) - \alpha_t(s_t, a_t)\leftq_t(s_t, a_t) - \[r_{t+1} + \\gamma \\max_a q_t(s_{t+1}, a)\right] qt+1(st,at)=qt(st,at)−αt(st,at)qt(st,at)−\[rt+1+γamaxqt(st+1,a)]
更新目标策略:
π T , t + 1 ( a ∣ s t ) = 1 if a = arg max a q t + 1 ( s t , a ) π T , t + 1 ( a ∣ s t ) = 0 otherwise \begin{align*} \pi_{T,t+1}(a|s_t) &= 1 \quad \text{if } a = \arg\max_a q_{t+1}(s_t, a) \\ \pi_{T,t+1}(a|s_t) &= 0 \quad \text{otherwise} \end{align*} πT,t+1(a∣st)πT,t+1(a∣st)=1if a=argamaxqt+1(st,a)=0otherwise
假设有一个策略 π b \pi_b πb ,下标 b b b 代表 behavior, π b \pi_b πb 用来生成一系列数据 experience,我们的任务是:根据已有的 experience 寻找最优策略,我们怎么做呢?来看一下。
首先,在 t t t 时刻,关注相应的状态、动作和 reward,我们进行下面两个步骤:第一个步骤就是 update q value ,这和 on-policy 版本中的一模一样,就是典型的 Q-learning 算法,这个没什么好讲的;第二步是 update target policy ---与刚才 on-policy 版本不同:on-policy 中是 ε \varepsilon ε-greedy,现在变成 greedy 。它仍根据刚才得到的 q value 更新策略,但不再是 ε \varepsilon ε-greedy 而是 greedy;这个策略记为 π T \pi_T πT 。
为什么此时用 greedy 而不是 ε \varepsilon ε-greedy 呢 ?on-policy 版本用 ε \varepsilon ε-greedy,是因为之后要用这个策略生成数据---希望它有一定探索性,以便访问到没被访问的 ( s , a ) (s,a) (s,a) 。但现在 π T \pi_T πT 根本不用来生成数据(生成数据是 π b \pi_b πb 的事) ,所以何必用它做 ε \varepsilon ε-greedy 呢,直接 greedy 即可--- greedy 策略才是最优的 。随着 q 的估计越来越准确, π T \pi_T πT 也会收敛到最优策略。显然这里有两个策略 π b \pi_b πb 与 π T \pi_T πT---这是 off-policy 的情况。
2. Q-learning - Examples
刚刚我们就介绍完了 Q-learning 算法 以及它的一些性质,下面给几个例子,更好地说明这个算法。
这个例子仍是之前一直考虑的网格世界,在这里面我们的任务是 要找到每个状态对应的最优策略,这与刚才 Sarsa 用的例子不同:那个例子从左上角固定状态出发,找一条到达目标的路径,不需要所有状态都找到最优策略,所以这里的任务和刚才那个任务不一样,也提醒大家关注任务究竟是什么。
下面是一些设置,包括 reward 和 γ \gamma γ 等:
r boundary = r forbidden = − 1 , r target = 1. γ = 0.9 , α = 0.1. r_{\text{boundary}} = r_{\text{forbidden}} = -1, \, r_{\text{target}} = 1. \\4pt \gamma = 0.9, \quad \alpha = 0.1. rboundary=rforbidden=−1,rtarget=1.γ=0.9,α=0.1.
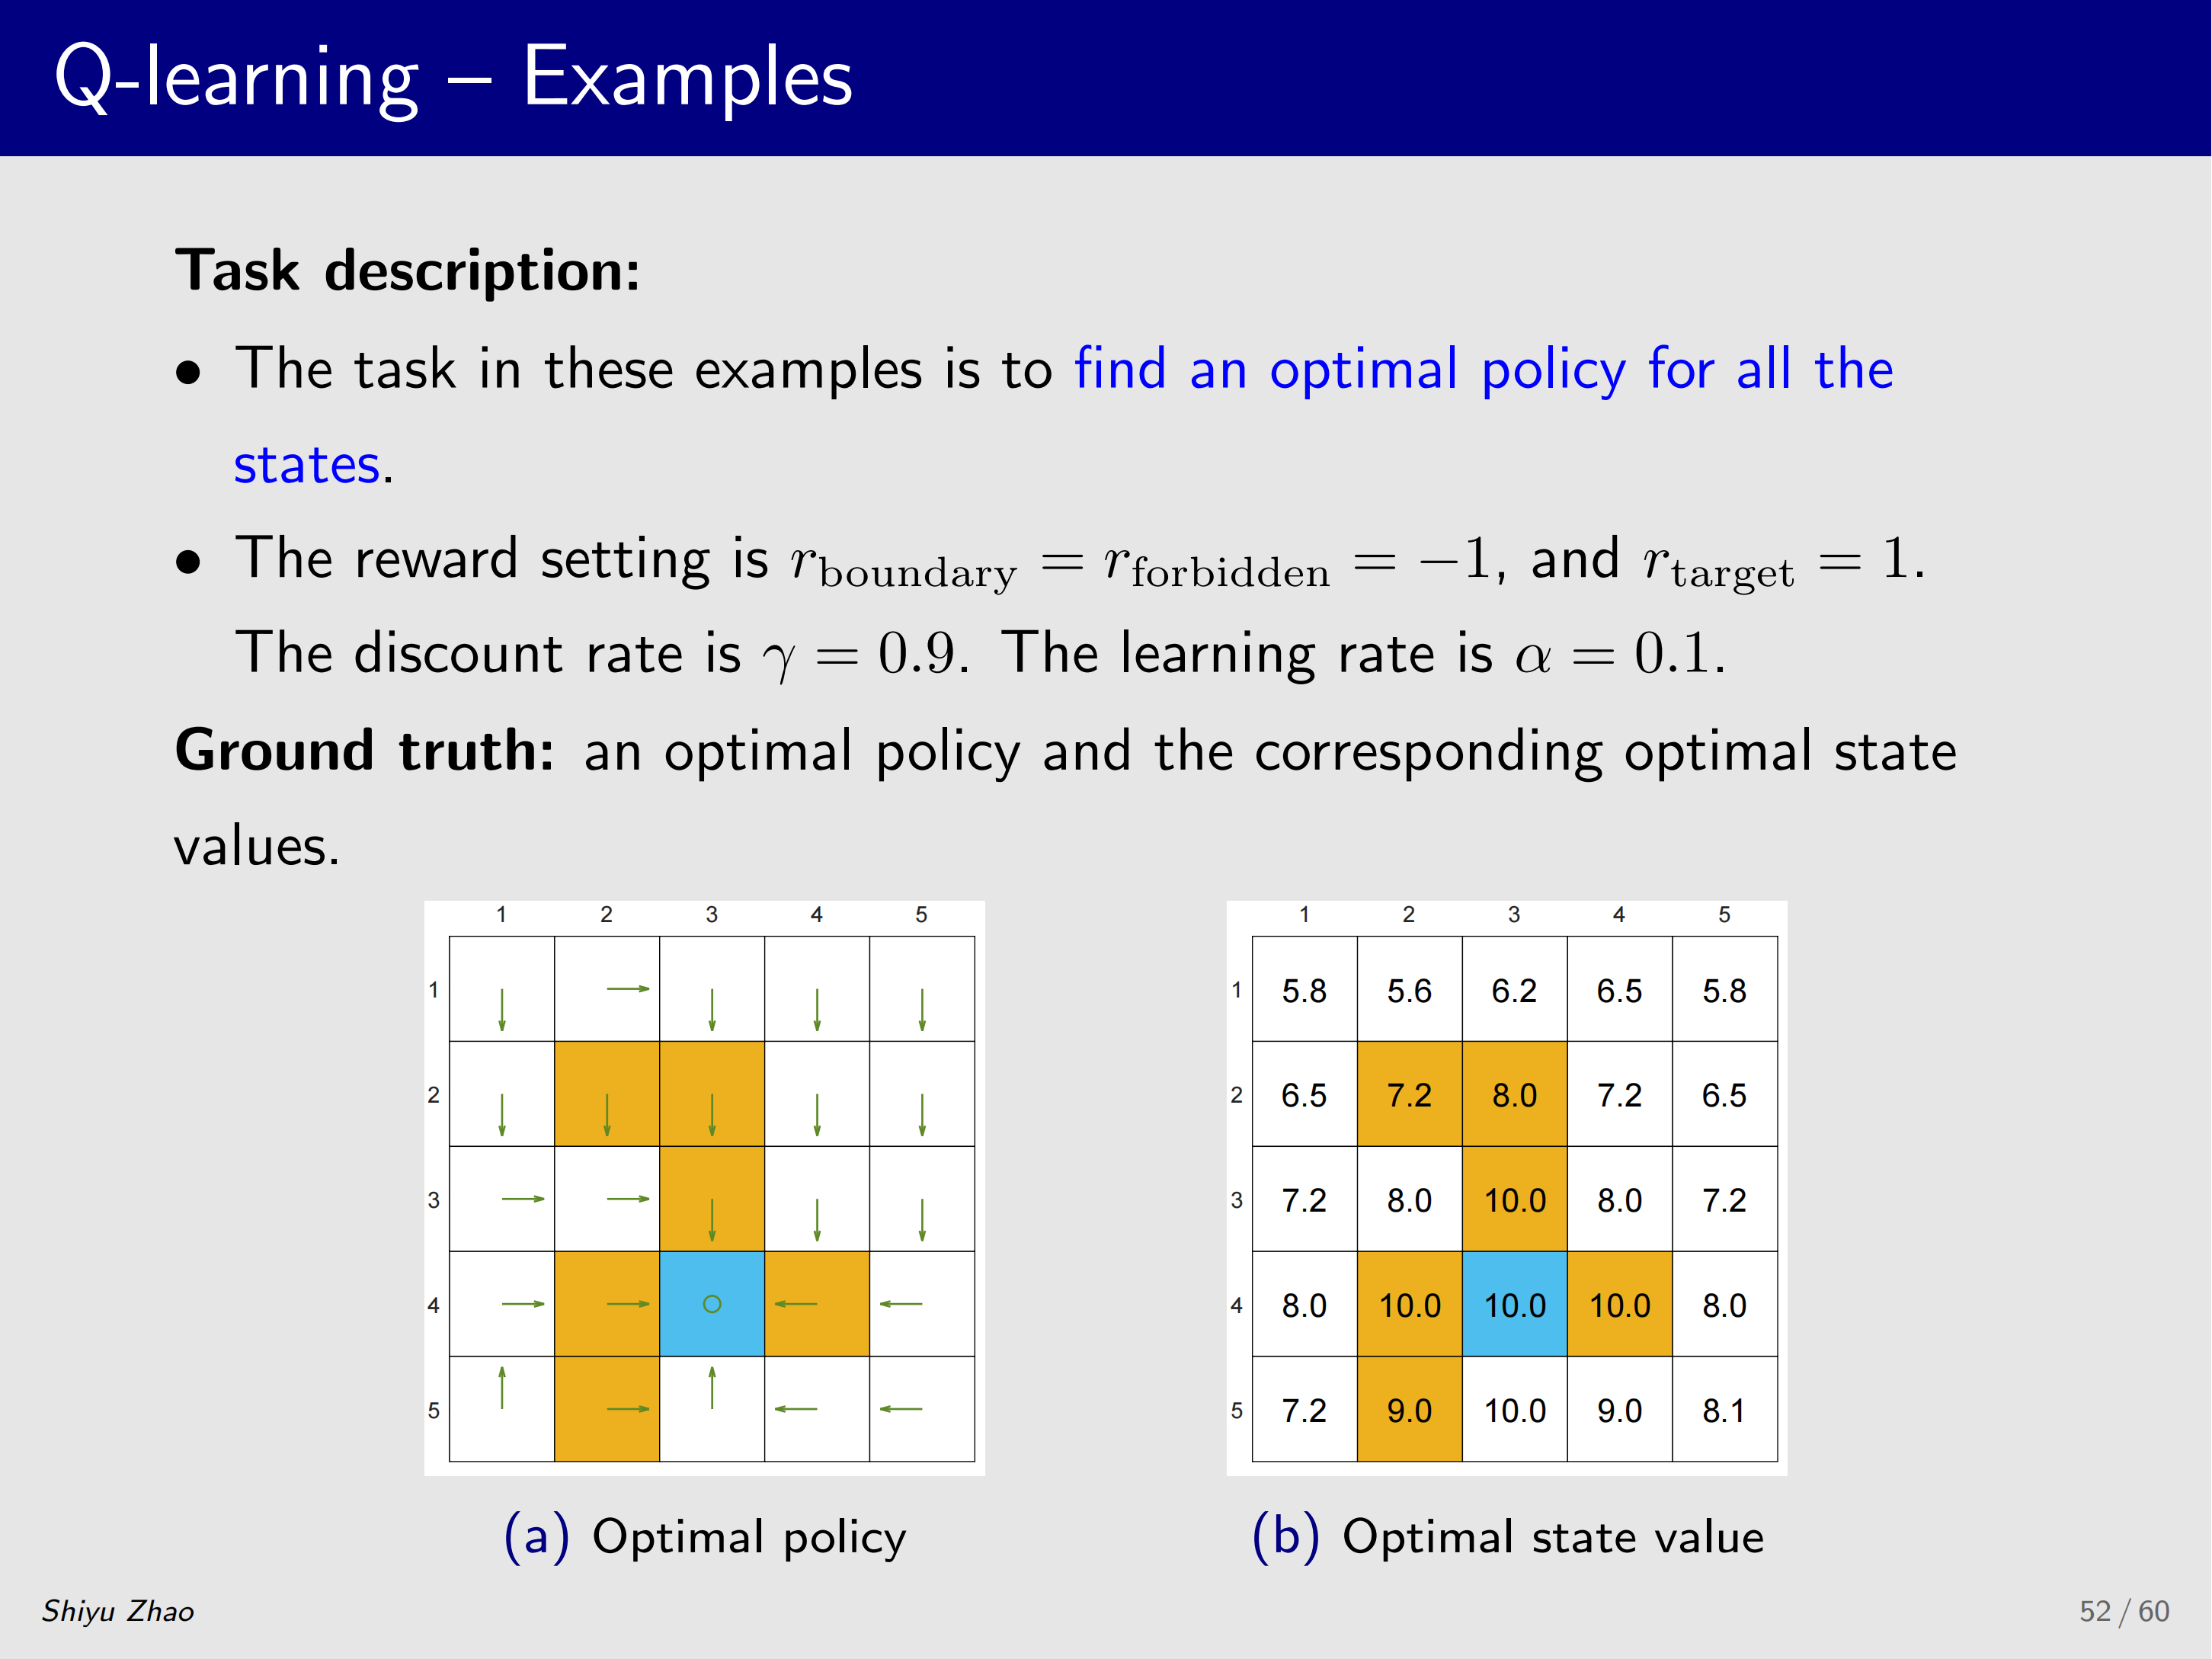
上图就是那个网格世界,我们先把它的 ground truth 给出来,什么意思呢?图 (a) 是最优策略,图 (b) 是对应的 optimal state value,待会用 Q-learning 算出一个策略,看它与 ground truth 是否相同,做个比较。
首先我们选定一个 behavior policy,然后用这个 behavior policy 去产生很多的数据:
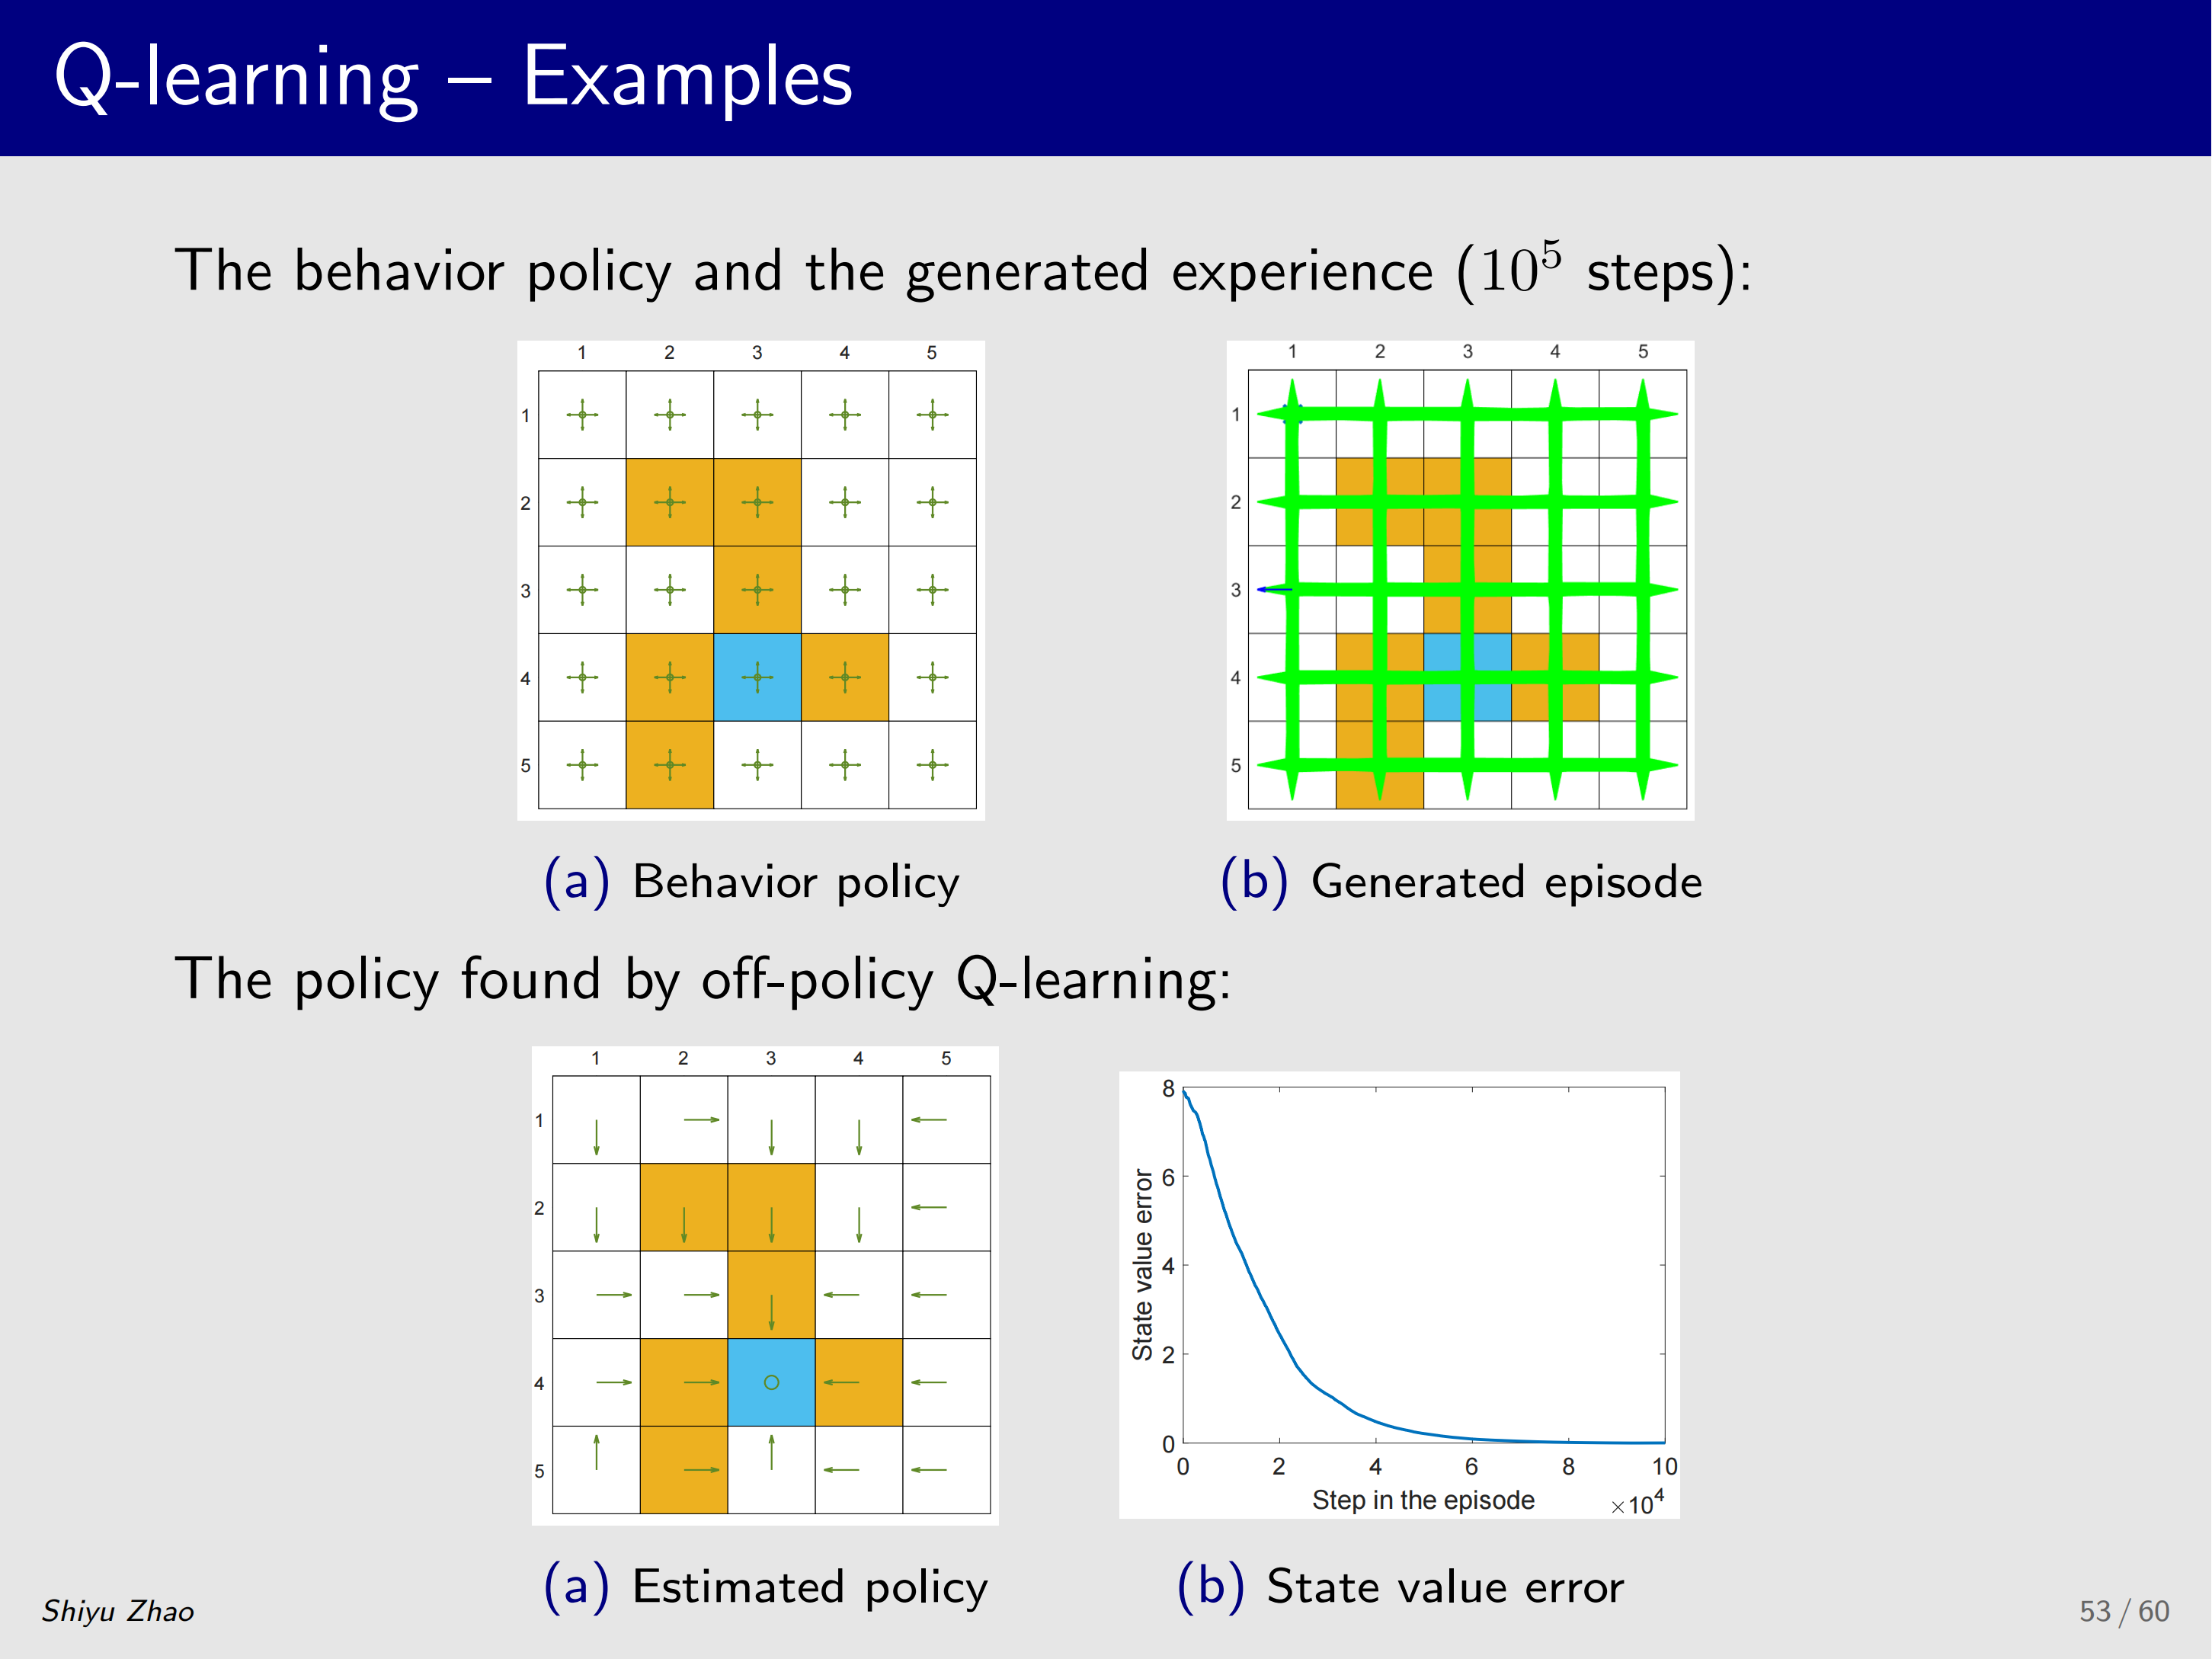
behavior policy 已用箭头绘制出来(第一张图所示的),它实际上是一个 均匀采样的策略 ,即每个状态的 5 个 action 都给 0.2 的概率,它的 探索性是比较强的,如第二张图所示,episode 有 10 万步,每个 state-action pair 都被访问了很多次,所以这个数据是比较好的。
下面看怎么用这些数据进行 Q-learning 计算:用 behavior policy 产生的数据估计,当然要用 off-policy 版本的 Q-learning ,左下角的图就是它最后给出的策略,这个策略与刚才的 ground truth 基本一样,唯一的区别:比如 ( 5 , 1 ) (5,1) (5,1),ground truth 中是向下,而这里是向左---其实没有太大区别(因为存在多个最优策略)。
然后这个策略的最优性也可以通过右下角的图来展示,右下角图的纵坐标代表什么?估计过程中,Q-learning 会给出一个策略序列,每个策略都对应一个 state value;用它与已知最优 state value 的差再取模,就是纵坐标的值。可以看到最开始策略不太好,与 optimal state value 有一段距离,最后策略已经很好,基本与 optimal state value 一致。
刚才用的 behavior policy 探索性较强 ,针对这个问题---要在每个 ( s , a ) (s,a) (s,a) 找最优策略,最好访问到所有 ( s , a ) (s,a) (s,a) 且访问多次,所以 behavior policy 最好有较强的探索性,若探索性不强会怎样?下面来看。
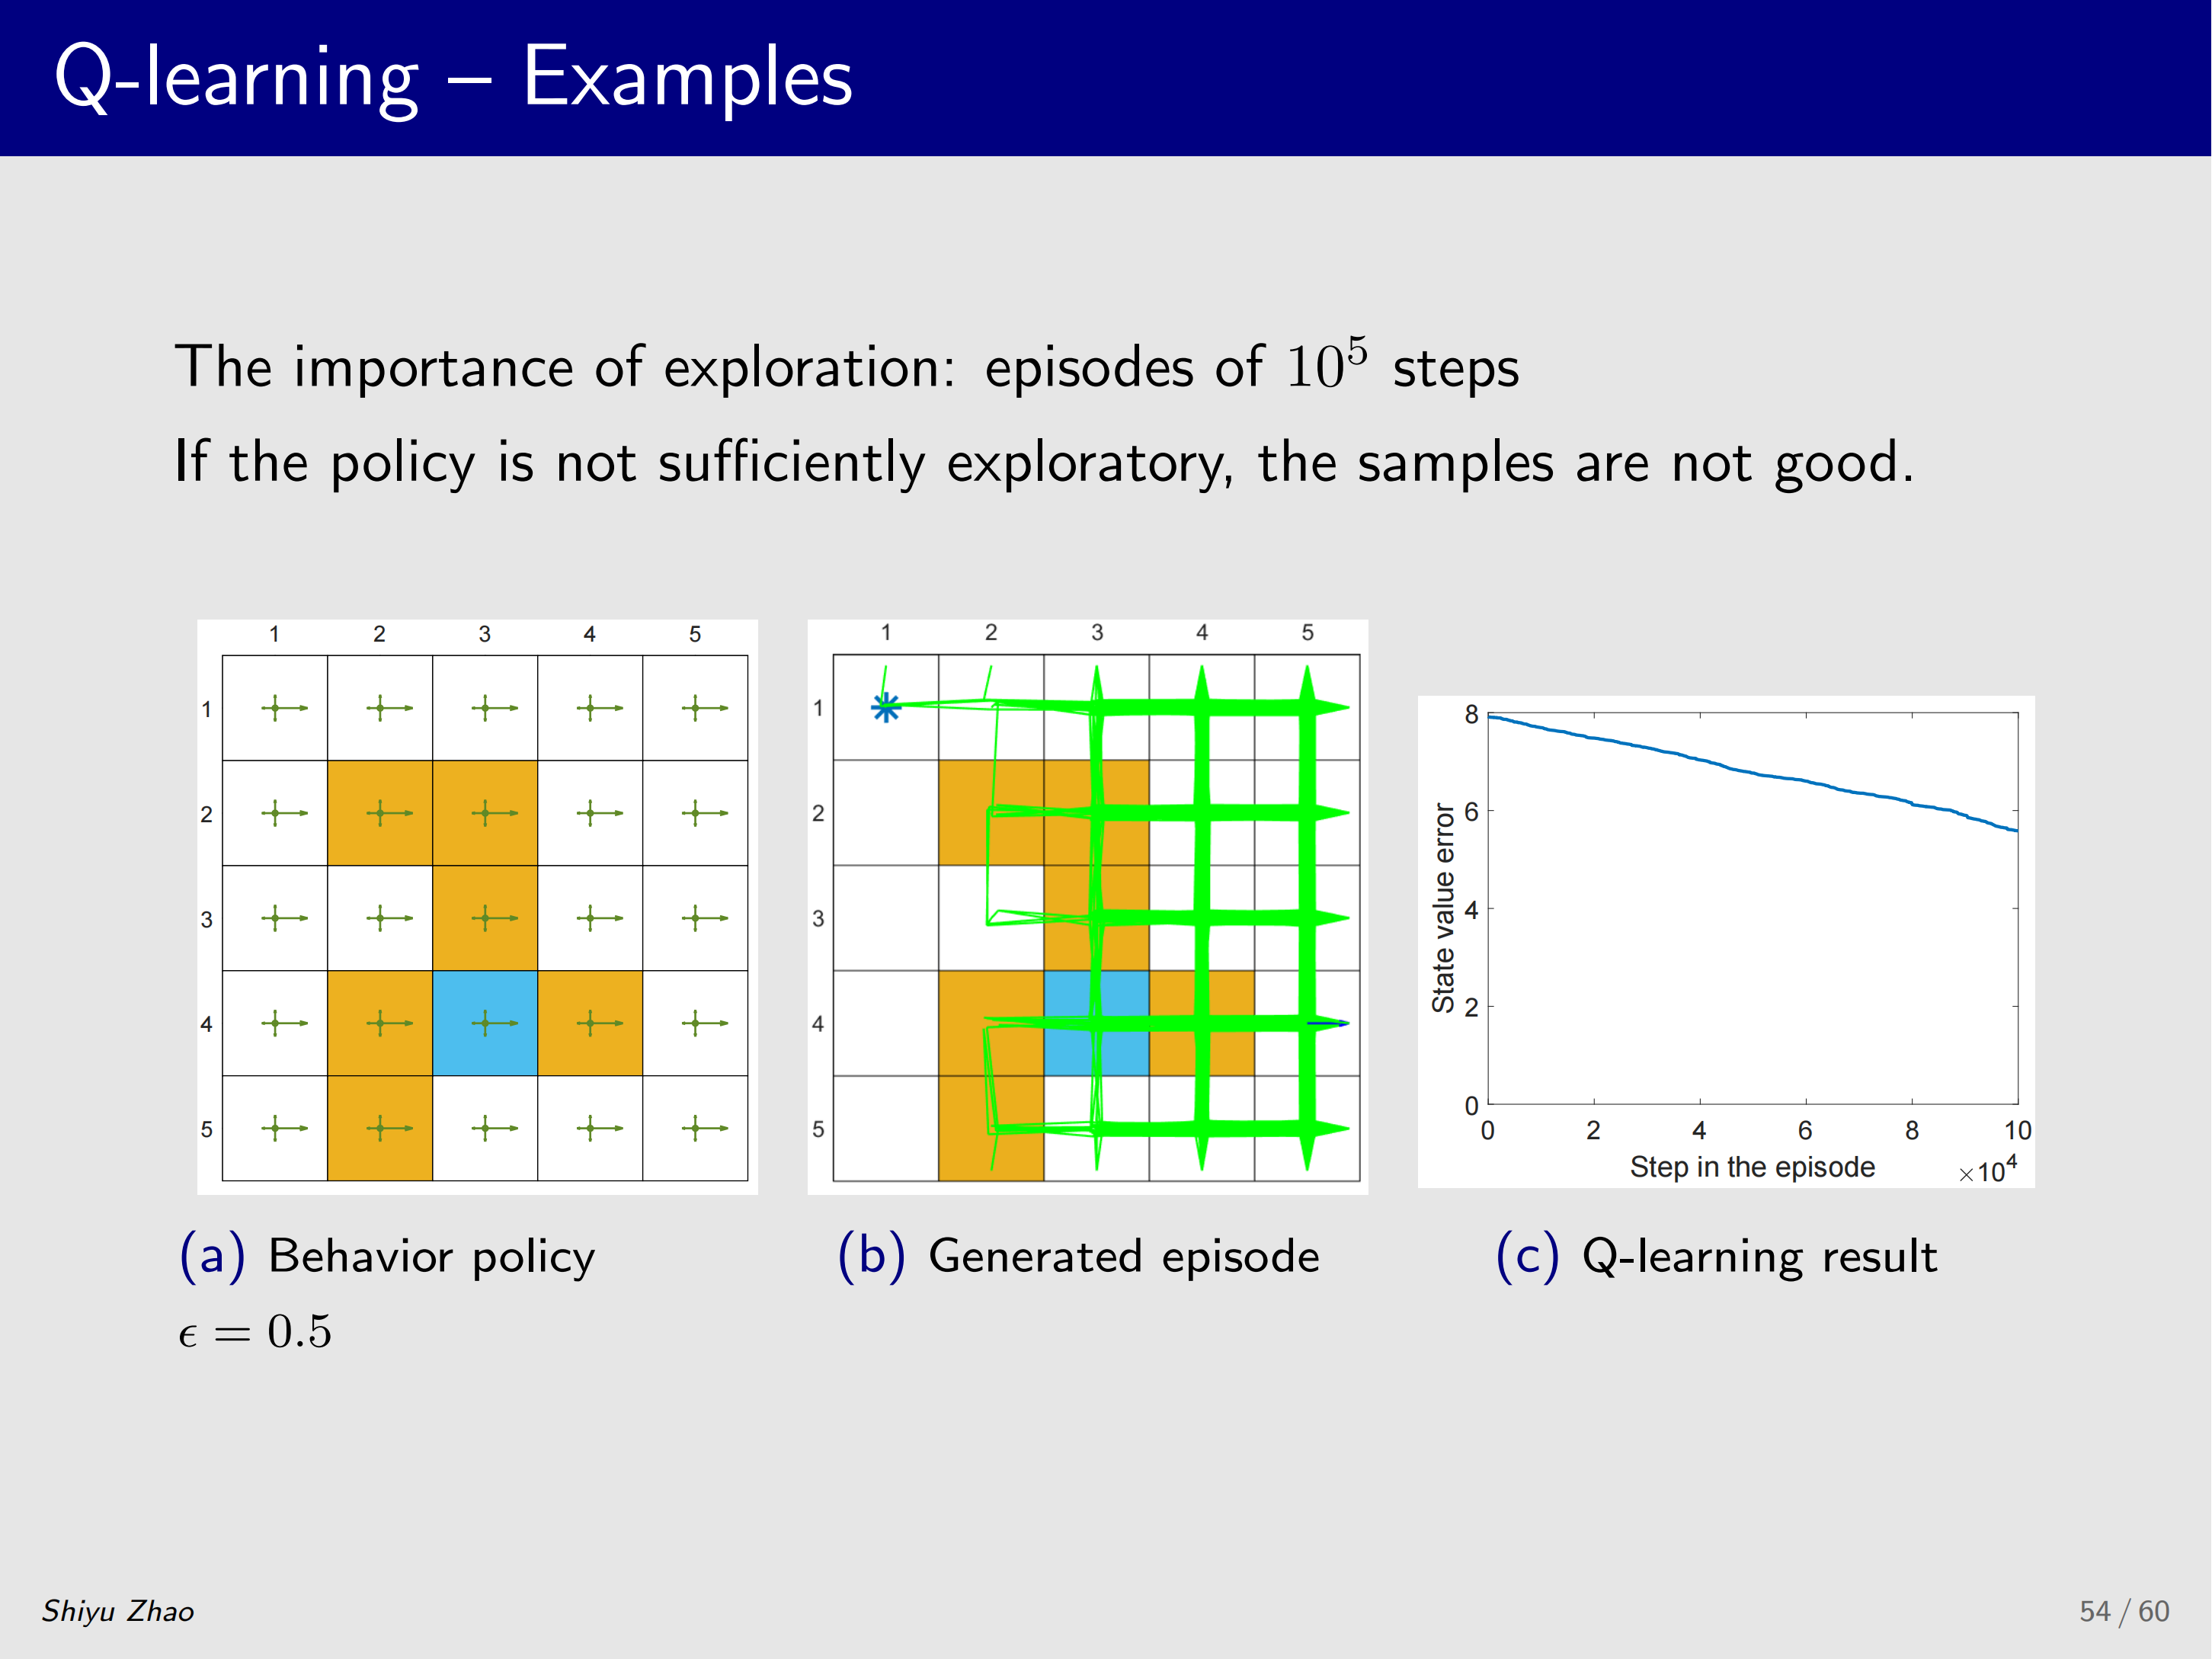
假如用上面这个策略( ε = 0.5 \varepsilon=0.5 ε=0.5):它在每个状态都有较大的概率向右走,显然探索性不如刚才--- 10 万步之后仍有很多 state-action pair 没被访问到。如果用这样的数据做 Q-learning,可以看到最终策略离最优策略仍有较大差距,最终策略就不画在这里了,只给出访问情况的图,大家直观上也能看到。
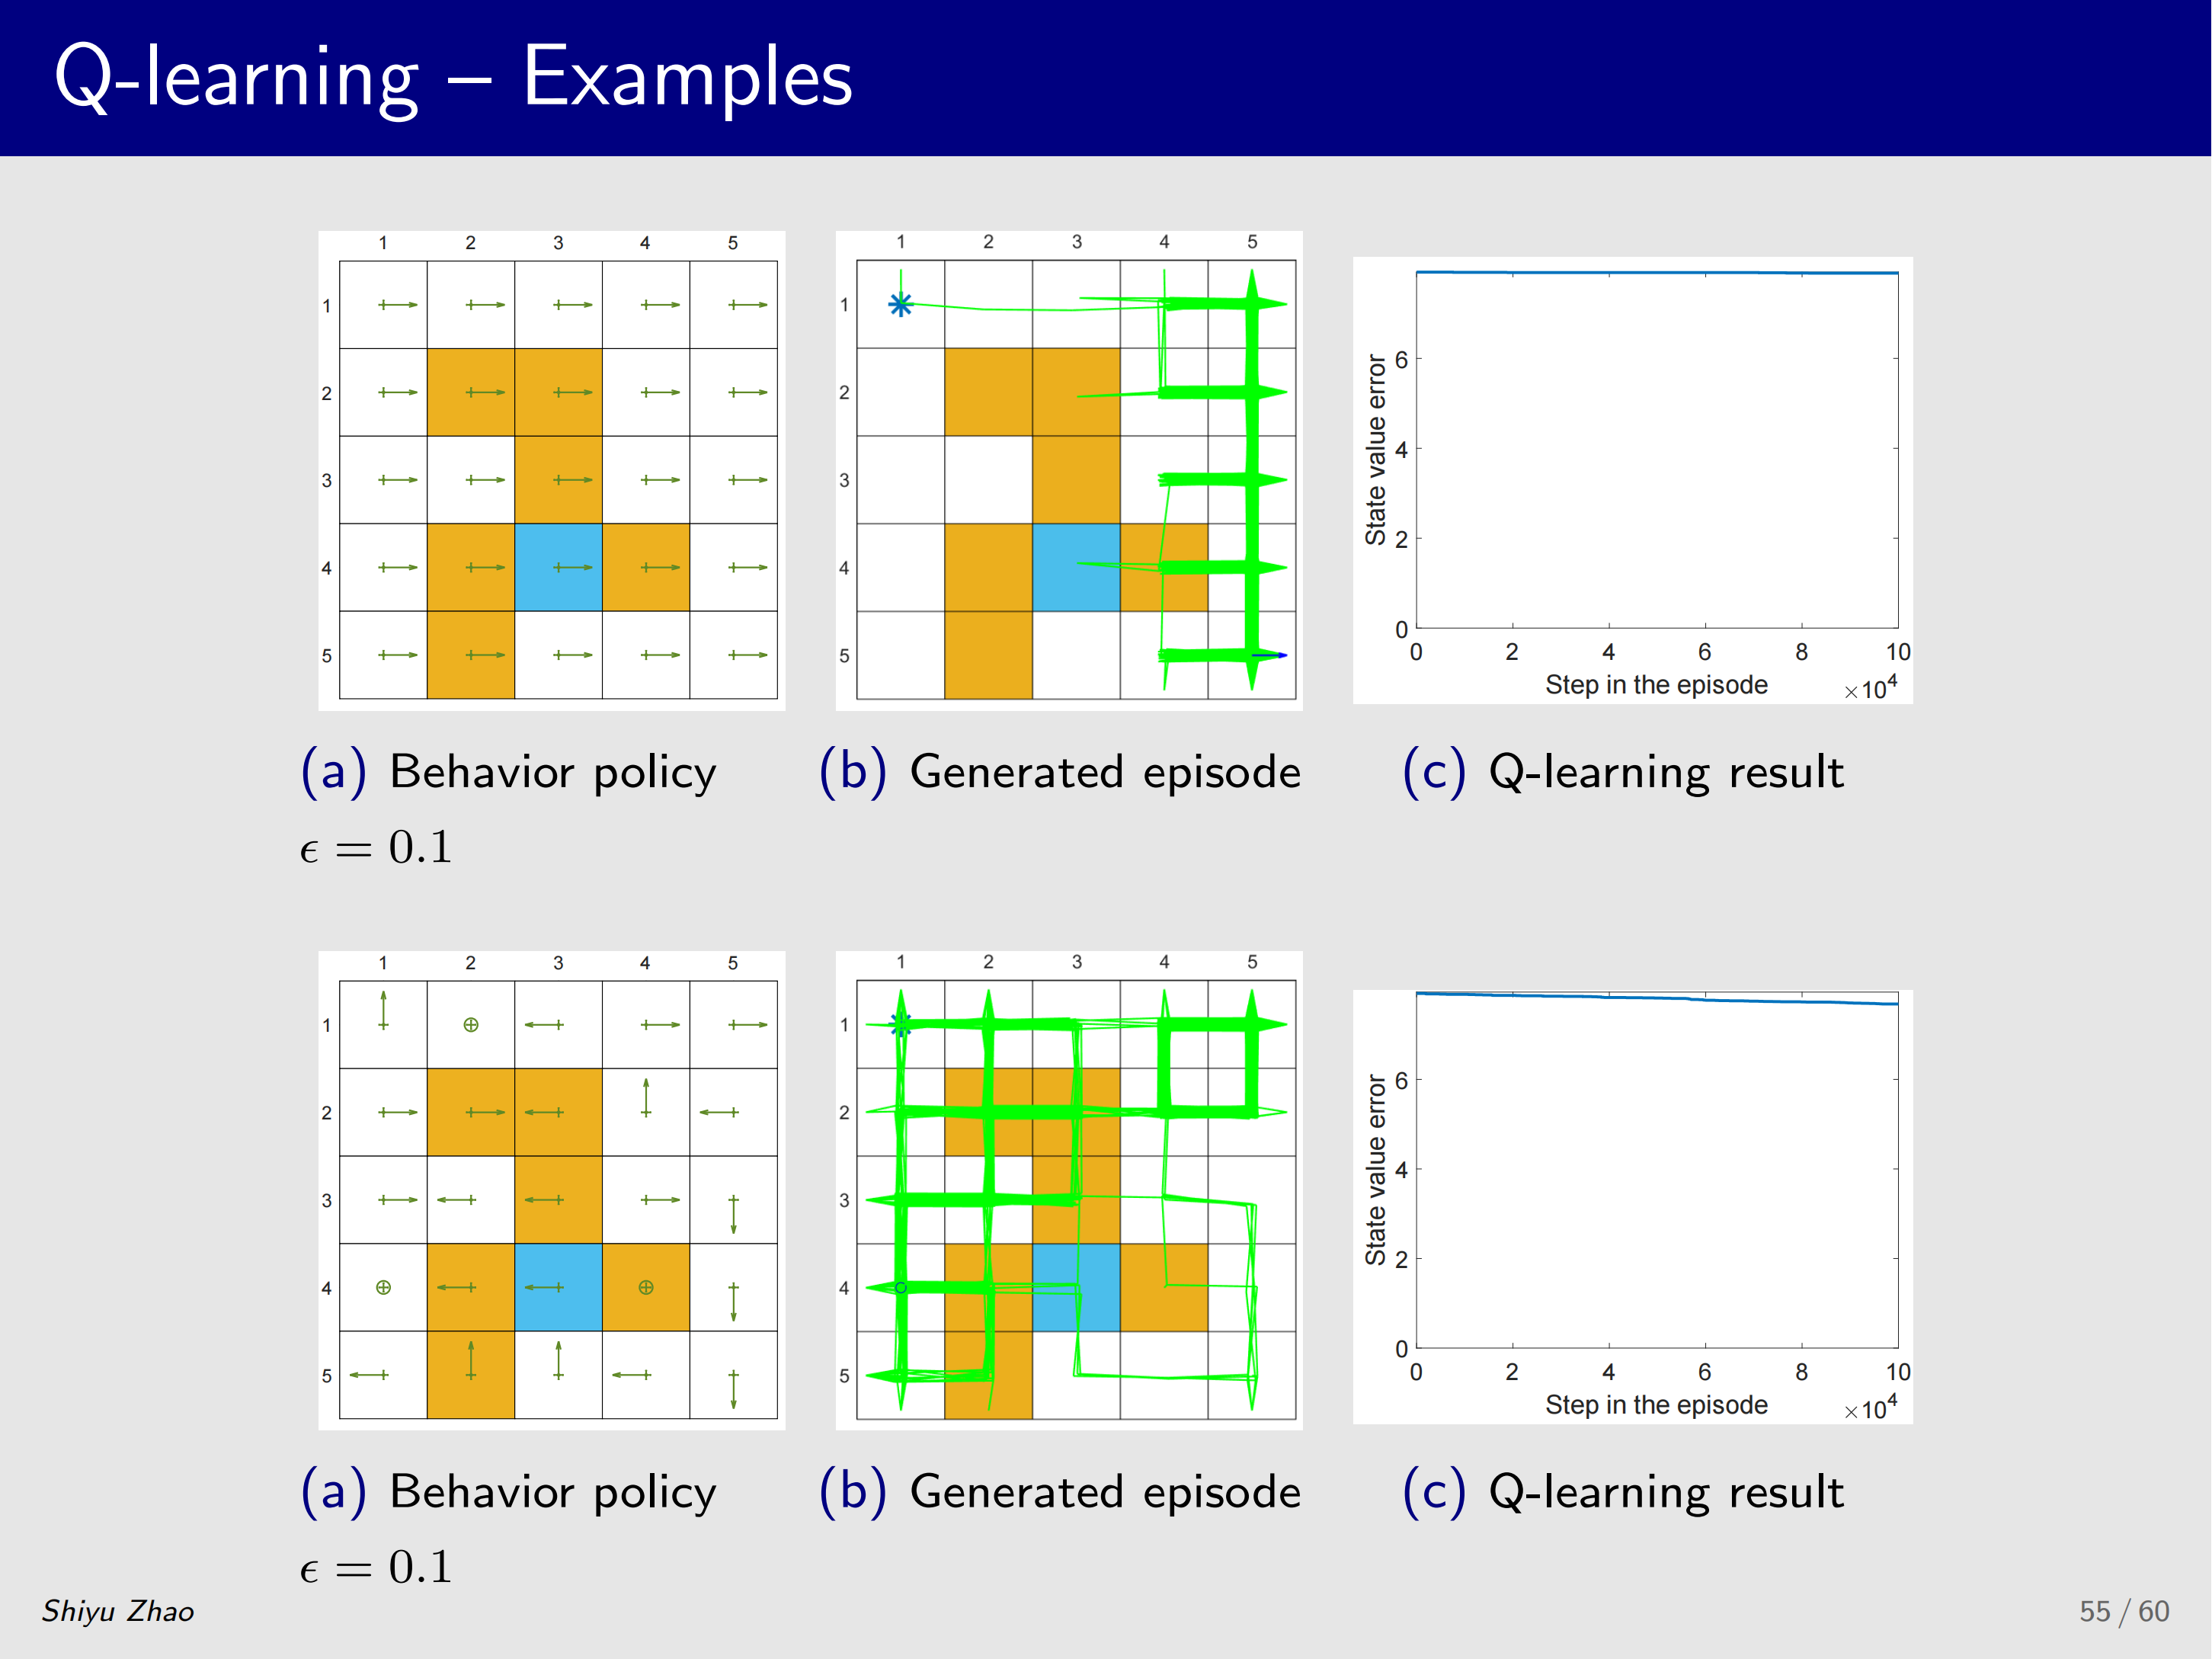
如果考虑探索性更弱的(如 ε = 0.1 \varepsilon=0.1 ε=0.1,如上图),几乎每个状态都有很大概率向右走,所得到的数据更差,最终策略也更差。左下角图同样:虽然不一直向右走,但 ε \varepsilon ε 也较小,探索性比较差,右下角图是它得到的数据,最终策略也有较大误差。
结语
本讲第七部分完成了 Q-learning 从算法到实践的最后一环。两个版本的同异展现了 on/off-policy 思想的实际落地:on-policy 版本与 Sarsa 结构完全相同(仅 TD target 换成 max a q t ( s t + 1 , a ) \max_a q_t(s_{t+1},a) maxaqt(st+1,a)),策略更新用 ε \varepsilon ε-greedy 以兼顾探索;off-policy 版本中,行为策略 π b \pi_b πb 专职生成经验,目标策略 π T \pi_T πT 则可以放心地采用纯 greedy 更新---因为它不负责探索,数据由 π b \pi_b πb 提供,这正是 off-policy 架构的魅力所在。
例子则给出了一个极为重要的实践教训:Q-learning 的最终效果直接取决于 behavior policy 的探索质量。用均匀随机策略(每个动作 0.2 概率)生成 10 万步数据时,所有 state-action pair 都被充分访问,学到的策略与 ground truth 几乎一致;而探索性弱的 behavior policy( ε \varepsilon ε=0.5 甚至 0.1)会遗漏大量 state-action pair,最终策略与最优策略差距明显。这说明:off-policy 虽然解耦了探索与利用,但 "探索充分性" 这一前提永远不会自动满足,数据质量始终是强化学习算法成败的关键🤗。