文章目录
- 前言
- 零、论文基本信息
- 一、问题:语义相关不等于上下文有效
-
- [1. 长程 Agent Memory 的四类能力](#1. 长程 Agent Memory 的四类能力)
- [2. 长上下文为什么仍会失败](#2. 长上下文为什么仍会失败)
- [3. 普通 RAG 为什么会取错](#3. 普通 RAG 为什么会取错)
- [4. 图记忆为什么也未必解决](#4. 图记忆为什么也未必解决)
- [二、Contextual Intent:给记忆增加结构化检索线索](#二、Contextual Intent:给记忆增加结构化检索线索)
- [三、STITCH 方法总览](#三、STITCH 方法总览)
- [四、Thematic Scope:跟踪当前潜在目标](#四、Thematic Scope:跟踪当前潜在目标)
-
- [1. 动机](#1. 动机)
- [2. 在线主题诱导](#2. 在线主题诱导)
- [3. 它解决了什么](#3. 它解决了什么)
- [五、Event Type:识别跨主题重复出现的动作](#五、Event Type:识别跨主题重复出现的动作)
-
- [1. 动态标签空间](#1. 动态标签空间)
- [2. 作用与风险](#2. 作用与风险)
- [六、Key Entity Types:明确当前需要什么属性](#六、Key Entity Types:明确当前需要什么属性)
- 七、结构对齐式共指消解
- [八、Memory Snippet:内容、结构和摘要并存](#八、Memory Snippet:内容、结构和摘要并存)
- [九、Intent-Aware Retrieval:结构优先,语义次之](#九、Intent-Aware Retrieval:结构优先,语义次之)
-
- [1. 查询也要进入同一结构空间](#1. 查询也要进入同一结构空间)
- [2. Label Density Ranking](#2. Label Density Ranking)
- 十、CAME-Bench:为什么需要新的评测
-
- [1. 现有 benchmark 遮蔽了上下文错配](#1. 现有 benchmark 遮蔽了上下文错配)
- [2. 两个领域](#2. 两个领域)
- [3. 四阶段生成流程](#3. 四阶段生成流程)
- [4. 评测质量控制](#4. 评测质量控制)
- 十一、实验设置
-
- [1. 数据集与指标](#1. 数据集与指标)
- [2. 基线](#2. 基线)
- 十二、主实验:轨迹越长,意图结构越重要
- [十三、为什么 LoCoMo 没有领先](#十三、为什么 LoCoMo 没有领先)
- 十四、消融:主题范围是最关键组件
- 十五、按问题类型分析:综合任务仍是短板
- 十六、错误分析:结构过滤也可能过早做错
- 十七、粒度、骨干模型与检索召回的鲁棒性
-
- [1. Scope 窗口不是越小越精确](#1. Scope 窗口不是越小越精确)
- [2. 提升不只来自 GPT-5-mini](#2. 提升不只来自 GPT-5-mini)
- [3. Small 上召回率低,却能回答更好](#3. Small 上召回率低,却能回答更好)
- 十八、效率:用写入成本换查询成本
- [十九、与 Agent Memory 系列方法横向比较](#十九、与 Agent Memory 系列方法横向比较)
- [二十、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发](#二十、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发)
-
- [1. Coding Agent:同一个文件名不代表同一个修复目标](#1. Coding Agent:同一个文件名不代表同一个修复目标)
- [2. Tool Agent:把工具返回绑定到目标和动作](#2. Tool Agent:把工具返回绑定到目标和动作)
- [3. Multi-Agent:需要角色条件化的上下文意图](#3. Multi-Agent:需要角色条件化的上下文意图)
- [4. 高风险系统不应使用不可逆硬过滤](#4. 高风险系统不应使用不可逆硬过滤)
- 二十一、局限性
-
- [1. 写入阶段昂贵](#1. 写入阶段昂贵)
- [2. 标签更新存在延迟](#2. 标签更新存在延迟)
- [3. 平坦 Event Taxonomy 不适合综合问题](#3. 平坦 Event Taxonomy 不适合综合问题)
- [4. 查询侧标签一旦选错,过滤难以恢复](#4. 查询侧标签一旦选错,过滤难以恢复)
- [5. CAME-Bench 的合成性与样本规模](#5. CAME-Bench 的合成性与样本规模)
- [6. LoCoMo 表明方法适用域有限](#6. LoCoMo 表明方法适用域有限)
- 二十二、我的理解与启发
-
- [1. 记忆检索的真正对象是"带条件的事实"](#1. 记忆检索的真正对象是“带条件的事实”)
- [2. Contextual Intent 更像复合索引,而不是摘要](#2. Contextual Intent 更像复合索引,而不是摘要)
- [3. 越强的过滤器,越需要不确定性管理](#3. 越强的过滤器,越需要不确定性管理)
- [4. 评测必须主动制造"相似但不对"的干扰](#4. 评测必须主动制造“相似但不对”的干扰)
- [5. 最完整的 Agent Memory 需要三种坐标](#5. 最完整的 Agent Memory 需要三种坐标)
- 二十三、总结
- 参考资料
前言
设想一个旅行规划 Agent 正在同时安排三天行程。它先讨论 Day 1 的 Apollo Hotel,报价 245 美元;几十轮后,Day 2 又出现同一家酒店,但房型和价格已经不同。临近结束时,用户问:"第二天那家酒店多少钱?"
传统向量检索很可能找到所有包含"Hotel""price"和"Apollo"的记录。问题不在于它没有召回相关文本,而在于它无法判断哪条记录属于 Day 2、哪条只是 Day 1 的语义近邻。上下文越长、重复实体越多,这种"召回内容看起来相关,但放在当前意图里是错的"现象就越严重。
此前的 Agent Memory 系列主要从不同位置缓解长程记忆问题:A-MEM 让记忆形成可演化的关联网络,MAGMA 与 CoM 关注多粒度组织和可组合上下文,ReMemR1 允许写入时回访历史,Mem²Evolve 研究长期演化,MemPO 优化单轨迹内滚动记忆的信用分配,Memp 则把跨任务轨迹沉淀为程序性技能。STITCH 进一步指出:记忆系统即使存对了信息,也可能因为缺乏"当前在做什么"的结构线索而取错。
STITCH 的唯一核心增量可以概括为:
为每个历史步骤建立由主题范围、事件类型和关键实体类型组成的 Contextual Intent,并在检索时先按意图结构兼容性过滤和排序,再用语义相似度细排,从而抑制"语义相似但上下文不匹配"的记忆。
论文还构建 CAME-Bench,专门把重复实体、交错目标、状态更新和隐式指代放入超长 Agent 轨迹中,使"在正确上下文里取回正确事实"成为显式评测对象。
零、论文基本信息
- 论文名称: Grounding Agent Memory in Contextual Intent
- 发表平台: Findings of the Association for Computational Linguistics: ACL 2026
- 代码仓库: https://contextual-intent.github.io/
- 作者: Ruozhen Yang, Yucheng Jiang, Yueqi Jiang, Priyanka Kargupta, Yunyi Zhang, Jiawei Han
一、问题:语义相关不等于上下文有效
1. 长程 Agent Memory 的四类能力
下面这张图不是普通任务分类,而是论文对"可靠长程记忆"必须具备的四种能力的定义。
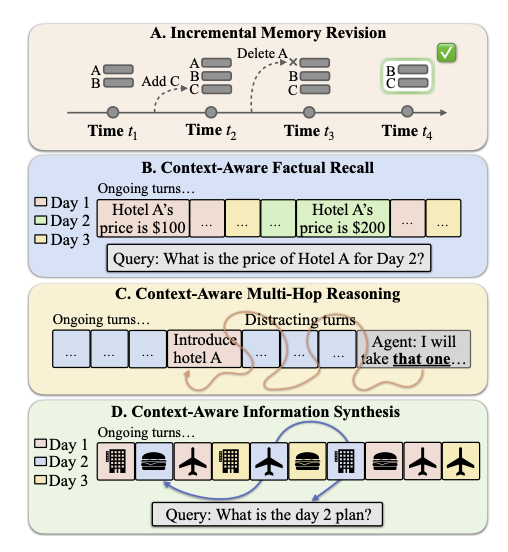
Figure 1:长程 Agent Memory 的四类挑战。 分别是增量状态修订、上下文感知事实召回、上下文感知多跳推理和跨步骤信息综合。
四类能力分别对应不同失败模式:
- Incremental Memory Revision: 候选 A 被添加、随后被删除,最终状态不能仍包含 A;
- Context-Aware Factual Recall: 同一家酒店在不同日期价格不同,必须匹配日期与房型;
- Context-Aware Multi-Hop Reasoning: "我刚才提到的那一家"需要先解指代,再取相关属性;
- Information Synthesis: 完整计划散落在多轮讨论中,需要跨步骤聚合。
2. 长上下文为什么仍会失败
长上下文模型在轨迹较短时可以直接关注分散细节,但成本高,而且超过窗口后只能截断。即使窗口容得下,模型还会遇到 lost-in-the-middle 和重复实体干扰。
3. 普通 RAG 为什么会取错
Embedding RAG 优化的是 query 与 chunk 的语义距离。若 Day 1 和 Day 2 都在讨论 Apollo Hotel 的价格,两段文本都高度相似。真正决定答案的"Day 2 itinerary"是潜在目标结构,不一定在每句话中被显式重复。
4. 图记忆为什么也未必解决
GraphRAG、HippoRAG 2、A-MEM 能建立实体与关系,但同一实体在不同目标段中可能扮演不同角色。若图只知道 Apollo Hotel 与 Price 相连,却没有"Day 1/Day 2"或"询价/预订"的上下文条件,仍会把不兼容事实聚在一起。
二、Contextual Intent:给记忆增加结构化检索线索
给定轨迹:
T = { s 1 , s 2 , ... , s n } T=\{s_1,s_2,\dots,s_n\} T={s1,s2,...,sn}
每一步为:
s t = ( r t , a t , τ t ) s_t=(r_t,a_t,\tau_t) st=(rt,at,τt)
r t r_t rt 是行动角色, a t a_t at 是自然语言动作描述, τ t \tau_t τt 是时间戳。STITCH 为每一步推断一个上下文意图元组:
ι t = ( σ t , ϵ t , κ t ) \iota_t=(\sigma_t,\epsilon_t,\kappa_t) ιt=(σt,ϵt,κt)
其中:
- σ t \sigma_t σt:Thematic Scope,当前高层目标或主题段;
- ϵ t \epsilon_t ϵt:Event Type,当前执行的动作类别;
- κ t \kappa_t κt:Key Entity Types,与当前目标有关的实体属性类别集合。
以"Book it at price $245 for that day"为例:
- 主题范围可能是 Day-1 Plan;
- 事件类型是 Hotel Booking;
- 关键实体类型包含 Hotel、Price;
- 结构对齐后,"it"和"that day"被改写为 Apollo Hotel 与 Day 1。
这个元组不是预先编写的领域 ontology,而是在流式轨迹处理中动态诱导出来的。
三、STITCH 方法总览
下面这张图把写入和检索连成完整流程。左侧负责把原始步骤变成结构化记忆,右侧把问题转换为同一标签空间中的过滤配置。
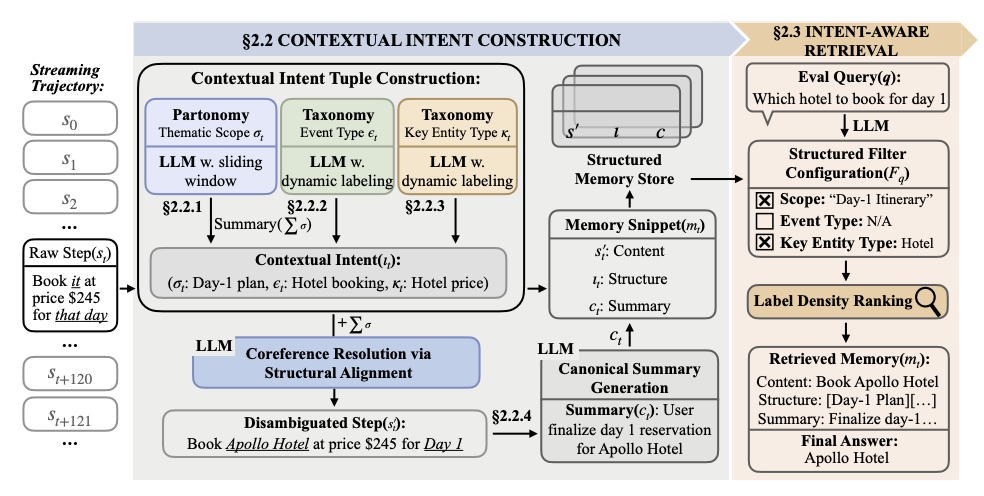
Figure 2:STITCH 方法总览。 流式轨迹经过主题范围、事件类型和关键实体类型标注,再进行结构对齐式共指消解与摘要,形成 Memory Snippet;查询侧产生结构过滤条件,通过标签密度优先、语义相似度次级的方式检索。
整体分为两个阶段:
- Contextual Intent Construction: 在线处理轨迹,构建结构化 Memory Snippet;
- Intent-Aware Retrieval: 将查询映射到结构过滤配置,按意图兼容性检索。
STITCH 的关键不是把三个标签拼到文本前,而是让它们参与写入时解指代、查询时过滤以及最终排序。
四、Thematic Scope:跟踪当前潜在目标
1. 动机
长轨迹通常包含多个相互穿插的子目标。相邻两轮可能属于不同主题,间隔很远的两轮反而同属 Day 2 规划。只按固定 chunk 或局部摘要切分,会破坏这种非局部目标连续性。
2. 在线主题诱导
STITCH 使用滑动窗口,让 LLM 根据当前步骤、最近历史与上一主题判断潜在目标是否变化:
σ t = M s c o p e ( s t , H s c o p e , σ t − 1 ) \sigma_t=M_{scope}(s_t,H_{scope},\sigma_{t-1}) σt=Mscope(st,Hscope,σt−1)
如果没有检测到 goal-state divergence,当前步骤继承上一主题;若发生边界事件,则生成新的 scope label。为防止窗口不断增长,系统维护当前主题的压缩摘要 Σ σ \Sigma_\sigma Σσ,供后续判断使用。
例如,"比较 Day 1 两家酒店""询问其中一家价格""最终预订"可以共享 Day-1 Itinerary;切换到 Day 2 时才产生新主题。
3. 它解决了什么
Thematic Scope 把原本只能靠文本暗示的宏观目标变成可索引字段。检索 Day 2 酒店时,可以先排除 Day 1 的同名实体,而不是让语义排序器在近乎相同的文本之间猜。
五、Event Type:识别跨主题重复出现的动作
主题范围回答"为哪个目标",Event Type 回答"正在做什么"。同一事件类型可在不同主题中反复出现,例如 Searching、Comparing、Booking、Rebuttal、Hyperparameter Tuning。
1. 动态标签空间
系统先对前 N s t a r t N_{start} Nstart 个步骤零样本归纳初始事件词表 V ϵ V_\epsilon Vϵ。处理新步骤时,先从词表召回 top- k e v e n t k_{event} kevent 相似标签,再由 LLM 选择最匹配者:
ϵ t = M l a b e l ( s t , R e t r i e v e ( V ϵ , s t , k e v e n t ) ) \epsilon_t=M_{label}\left(s_t,Retrieve(V_\epsilon,s_t,k_{event})\right) ϵt=Mlabel(st,Retrieve(Vϵ,st,kevent))
若没有合适标签,则新增标签。每隔 k u p d a t e k_{update} kupdate 步,系统合并近义或重叠标签,防止词表无限碎片化。
2. 作用与风险
事件标签适合区分"询价"和"预订":二者可能提到相同酒店和价格,却代表不同状态。但标签过细也会伤害信息综合。若完整行程答案需要同时聚合 Search、Compare、Book 多种事件,过早过滤到单一事件会删掉必要证据。
六、Key Entity Types:明确当前需要什么属性
κ t \kappa_t κt 表示当前步骤关心的实体类别或属性类型。例如研究任务中区分 Metric 与 Hyperparameter,旅行任务中区分 Price 与 Rating。
系统维护动态实体类型词表 V κ V_\kappa Vκ:
κ t = M e n t i t y ( s t , V κ ) \kappa_t=M_{entity}(s_t,V_\kappa) κt=Mentity(st,Vκ)
新类别可以加入词表,近义类别也会周期性合并。
这一模块不要求为每个领域预先设计完整 schema。它只保留对检索有帮助的轻量"槽位模板"。查询"Day 2 的酒店价格"时,Hotel 与 Price 会比同酒店的 Rating 记录更优先。
七、结构对齐式共指消解
长程轨迹中常出现"Book it""take that one""the dinner reservation I mentioned earlier"。若原样存入记忆,"it"本身几乎没有可检索信息。
STITCH 先从历史中召回与当前主题 σ t \sigma_t σt 和事件类型 ϵ t \epsilon_t ϵt 相容的上下文集合 C a l i g n C_{align} Calign,再重写当前步骤:
s t ′ = M r e w r i t e ( s t , C a l i g n ) s't=M{rewrite}(s_t,C_{align}) st′=Mrewrite(st,Calign)
例如:
Book it at price 245 for that day \text{Book it at price 245 for that day} Book it at price 245 for that day
被改写为:
Book Apollo Hotel at price 245 for Day 1 \text{Book Apollo Hotel at price 245 for Day 1} Book Apollo Hotel at price 245 for Day 1
这一步发生在存储前。它让后续检索面对的是显式实体,而不是把指代消解推迟到答案生成阶段。
附录用 Entity Resolution Recall 验证重写质量:
E R R = ∑ i = 1 ∣ T g o l d ∣ V ( e i , m i ) ∣ T g o l d ∣ ERR=\frac{\sum_{i=1}^{|T_{gold}|}V(e_i,m_i)}{|T_{gold}|} ERR=∣Tgold∣∑i=1∣Tgold∣V(ei,mi)
V ( e i , m i ) V(e_i,m_i) V(ei,mi) 检查标准实体是否出现在对应记忆片段中。Travel Planning 的 Small/Medium/Large ERR 分别为 97.4%、79.2%、81.1%;Debate 为 91.5%、78.6%、81.1%。长轨迹上约 80% 的召回说明模块有效,但仍有约五分之一实体未被正确显式化。
八、Memory Snippet:内容、结构和摘要并存
在结构对齐后,LLM 生成规范化摘要:
c t = M s u m ( s t ′ , ι t ) c_t=M_{sum}(s'_t,\iota_t) ct=Msum(st′,ιt)
最终记忆片段为:
m t = ( s t ′ , ι t , c t ) m_t=(s'_t,\iota_t,c_t) mt=(st′,ιt,ct)
它同时保留:
- s t ′ s'_t st′:经过解指代的具体内容;
- ι t \iota_t ιt:可过滤的结构字段;
- c t c_t ct:便于语义检索的规范摘要。
这种设计把"精确过滤"和"模糊匹配"分开:结构字段负责排除上下文不兼容记录,摘要负责在兼容集合中寻找语义最接近者。
九、Intent-Aware Retrieval:结构优先,语义次之
1. 查询也要进入同一结构空间
给定问题 q q q,LLM 从当前标签库存中选择过滤配置:
F q = ( S q , E q , K q ) F_q=(S_q,E_q,K_q) Fq=(Sq,Eq,Kq)
S q S_q Sq、 E q E_q Eq、 K q K_q Kq 分别是候选主题范围、事件类型和关键实体类型。查询侧不是重新自由生成一套标签,而是在已经诱导出的标签空间中选择,避免存储端与查询端词汇不一致。
2. Label Density Ranking
STITCH 先计算 Memory Snippet 的意图标签与 F q F_q Fq 的重合约束数量,标签密度越高,结构兼容性越强。只有密度相同的候选,再按 s i m ( q , c t ) sim(q,c_t) sim(q,ct) 的语义相似度排序,最后返回 top- k r e t r i e v e k_{retrieve} kretrieve。
可以把它理解为:
Rank ( m t ∣ q ) = ( ∣ ι t ∩ F q ∣ , s i m ( q , c t ) ) \text{Rank}(m_t\mid q)= \left( |\iota_t\cap F_q|, sim(q,c_t) \right) Rank(mt∣q)=(∣ιt∩Fq∣,sim(q,ct))
该式是对论文排序逻辑的简写:优先比较标签重合数量,再比较语义相似度,并非论文另行训练的加权打分函数。
结构优先的好处是,Day 1 的高语义相似片段不会压过 Day 2 的正确片段;风险则是上游标签一旦选错,相关证据可能在语义排序前就被不可逆过滤。
十、CAME-Bench:为什么需要新的评测
1. 现有 benchmark 遮蔽了上下文错配
许多长对话基准把主题切成相对独立的小段,或保持严格的一问一答。问题通常紧跟相关信息,模型依赖局部邻近性也能成功,不必维护跨越数十轮的目标状态。
CAME-Bench 故意加入非轮流发言、交错目标、延迟查询、重复实体和隐式指代,要求系统不仅找到相关词,还要确认事实属于正确目标和状态。
2. 两个领域
- Travel Planning: 多智能体协作制定多日行程,持续提出、比较、否决和确认酒店、餐厅与景点;
- Debate: 两个 Agent 围绕政策议题辩论,执行提出论点、攻击、防御、让步、补充背景和总结等动作。
旅行领域为住宿、餐厅和景点各构造 100 个闭世界实体;Debate 的证据以作者---年份形式归一化,削弱表面语义捷径。
3. 四阶段生成流程
- 构造闭世界实体与知识;
- 先生成具有因果约束的符号 storyboard;
- 将符号操作实现为自然语言轨迹;
- 进行指代重写与轮次切分,制造更自然的语用歧义。
这种"先符号、后语言"使答案可以从符号状态确定,同时保留自然语言交互的复杂性。
Subset Avg Context Tokens Trajectories Questions CAME-Bench S 23 K 6 144 CAME-Bench M 137 K 6 168 CAME-Bench L 408 K 2 61 \begin{array}{l|rrr} \text{Subset}&\text{Avg Context Tokens}&\text{Trajectories}&\text{Questions}\\\hline \text{CAME-Bench}_S&23K&6&144\\ \text{CAME-Bench}_M&137K&6&168\\ \text{CAME-Bench}_L&408K&2&61 \end{array} SubsetCAME-BenchSCAME-BenchMCAME-BenchLAvg Context Tokens23K137K408KTrajectories662Questions14416861
Table 4:CAME-Bench 数据规模。 Small、Medium、Large 平均上下文分别为 23K、137K 和 408K tokens;Large 因生成成本只包含 2 条高密度轨迹。
Large 只有两条轨迹是一个明显限制。论文随后用不同初始化轨迹做稳定性检查,但它仍无法替代更大规模的独立任务样本。
4. 评测质量控制
自动验证在随机抽取的 200 个符号操作---自然语言步骤对上达到 99.5% 一致率。人工验证抽取四条 Small 轨迹,由四位具有计算机或 AI 背景的志愿者标注,每条由两人阅读;人与 LLM 生成标准答案平均一致率为 98.25%。
十一、实验设置
1. 数据集与指标
除 CAME-Bench 外,论文还评估 LongMemEval 与 LoCoMo。CAME-Bench 使用答案集合的 Macro Precision、Recall 和 F1;LongMemEval 与 LoCoMo 报告 Accuracy。LoCoMo 排除了必须使用图像的问题。
2. 基线
- 长上下文:DeepSeek V3.1、Qwen3、GPT-4o-mini、GPT-4.1-mini、GPT-5-mini;
- Embedding RAG:Qwen3-Embedding-8B、text-embedding-3-small/large;
- 结构记忆:RAPTOR、GraphRAG、HippoRAG 2、A-MEM、SeCom。
所有检索类方法共享 4096-token 检索预算。STITCH 与基线的生成阶段使用 gpt-5-mini、medium reasoning;答案由 gpt-4.1-mini、temperature 0、top-p 0.9 进行 LLM-as-a-Judge 评估。
关键超参数为:
N s t a r t = 50 , k u p d a t e = 50 , k r e t r i e v e = 40 , k e v e n t = 5 N_{start}=50,\quad k_{update}=50,\quad k_{retrieve}=40,\quad k_{event}=5 Nstart=50,kupdate=50,kretrieve=40,kevent=5
十二、主实验:轨迹越长,意图结构越重要
下面重制 Table 1 的核心结果。CAME-Bench 报告 Precision/F1,LongMemEval 分为 Original/Small/Medium,LoCoMo 报告总体准确率。
KaTeX parse error: Undefined control sequence: \multicolumn at position 35: ...|rr|rr|rrr|r} &\̲m̲u̲l̲t̲i̲c̲o̲l̲u̲m̲n̲{2}{c|}{CAME\te...
Table 1:CAME-Bench、LongMemEval 与 LoCoMo 主结果。 比较长上下文模型、Embedding RAG、结构化记忆系统与 STITCH;CAME-Bench Medium/Large 的 STITCH 结果相对各自最强基线通过配对 t t t 检验, p < 0.05 p<0.05 p<0.05。
在 Small 上,STITCH F1 0.844,仅比 GPT-5-mini 的 0.804 高 0.040,长上下文仍很强。到 Medium,STITCH 达到 0.682,最强基线 GPT-5-mini 为 0.566,绝对提升 0.116,相对提升约 20.5%。
Large 上,最强基线是 SeCom 的 0.236,而 STITCH 为 0.592,绝对提升 0.356,相对翻倍。这正是摘要中"35.6%"的来源,指 35.6 个 F1 百分点,而不是相对提升 35.6%。
LongMemEval 上,STITCH 在 O/S/M 分别为 0.860、0.860、0.800,整体最佳或并列最佳。LoCoMo 上则只有 0.703,低于 GPT-5-mini 的 0.811、A-MEM 的 0.731 与 HippoRAG 2 的 0.725。STITCH 的优势并非覆盖所有对话记忆任务。
十三、为什么 LoCoMo 没有领先
作者随机分析 60 个 LoCoMo 失败样本:
- 53.3% 是 Contextual-Intent Coverage Mismatch:开放式社交细节与明确目标状态关系弱,STITCH 的主题/事件/实体结构覆盖不足;
- 21.7% 是信息冲突未正确处理;
- 16.7% 是标签密度排序把正确片段排在干扰项之后;
- 8.3% 是摘要或重写削弱了原对话中的微妙语境连接。
这说明 STITCH 最适合目标导向、状态持续变化的 Agent 轨迹,并不是通用聊天记忆的全面替代品。
十四、消融:主题范围是最关键组件
Variant P S F 1 S P M F 1 M P L F 1 L STITCH full .810 .844 .665 .682 .616 .592 w/o thematic scope .457 .463 .257 .257 .269 .213 w/o event type .730 .753 .525 .527 .383 .273 w/o coreference .554 .578 .508 .489 .469 .404 w/o key entity type .713 .735 .513 .511 .513 .458 \begin{array}{l|rr|rr|rr} \text{Variant}&P_S&F1_S&P_M&F1_M&P_L&F1_L\\\hline \text{STITCH full}&\mathbf{.810}&\mathbf{.844}&\mathbf{.665}&\mathbf{.682}&\mathbf{.616}&\mathbf{.592}\\ \text{w/o thematic scope}&.457&.463&.257&.257&.269&.213\\ \text{w/o event type}&.730&.753&.525&.527&.383&.273\\ \text{w/o coreference}&.554&.578&.508&.489&.469&.404\\ \text{w/o key entity type}&.713&.735&.513&.511&.513&.458 \end{array} VariantSTITCH fullw/o thematic scopew/o event typew/o coreferencew/o key entity typePS.810.457.730.554.713F1S.844.463.753.578.735PM.665.257.525.508.513F1M.682.257.527.489.511PL.616.269.383.469.513F1L.592.213.273.404.458
Table 2:STITCH 组件消融。 分别移除主题范围、事件类型、结构对齐式共指消解和关键实体类型,报告三个长度分区的 Macro Precision/F1。
移除 Thematic Scope 后 Large F1 从 0.592 跌到 0.213,下降 0.379,是最严重退化。它证明"当前属于哪个目标段"是避免上下文错配的首要信号。
移除 Event Type 后 Large F1 为 0.273,说明动作类别也很重要;移除 Key Entity Type 后仍有 0.458,影响相对较小;移除共指模块后为 0.404,说明写入前显式化隐含实体是后续检索的基础。
十五、按问题类型分析:综合任务仍是短板
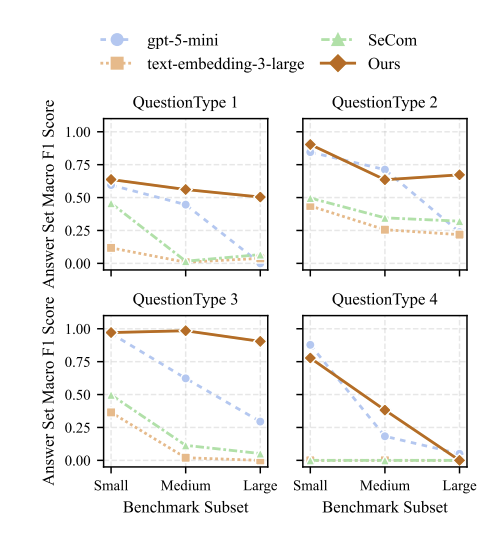
Figure 3:CAME-Bench 分问题类型结果。 比较 STITCH 与三类最强基线在增量修订、事实召回、多跳推理和信息综合上的 Macro-F1,并展示 Small、Medium、Large 随长度变化的趋势。
Type 1、2、3 中,STITCH 随轨迹变长退化明显更慢,尤其多跳推理在 Large 上仍接近 0.9。说明主题范围与共指对跨越大量干扰轮次的证据连接很有效。
Type 4 信息综合则是明显反例:STITCH 从 Small 约 0.78 降到 Medium 约 0.39,Large 接近 0;GPT-5-mini 在 Small 还更高。原因是细粒度 Event Type 适合过滤单一事实,却可能把综合答案所需的不同动作类型拆散。作者因此提出未来使用层次化标签,而不是平坦 taxonomy。
十六、错误分析:结构过滤也可能过早做错
Failure Mode Frequency Non-Inducible Label 78.4 % Granularity Mismatch 71.8 % \begin{array}{l|r} \text{Failure Mode}&\text{Frequency}\\\hline \text{Non-Inducible Label}&78.4\%\\ \text{Granularity Mismatch}&71.8\% \end{array} Failure ModeNon-Inducible LabelGranularity MismatchFrequency78.4%71.8%
Table 3:查询侧标签选择失败分布。 一个案例可同时具有多种错误,因此两项比例之和可以超过 100%。
Non-Inducible Label 指模型选择了在整个轨迹里很合理、但不能仅从当前问题推出的标签。也就是说,标签模型被轨迹背景诱导,替用户问题补了未经授权的上下文。
Granularity Mismatch 指选出的标签过粗或过细。过粗会把多个子主题混在一起;过细会过早锁定某个子情境,把正确证据在排序前排除。
这暴露了 STITCH 的结构性风险:Embedding 排错还可能在后续 rerank 中纠正,而硬结构过滤一旦选错标签,语义模型根本看不到被删掉的证据。
十七、粒度、骨干模型与检索召回的鲁棒性
1. Scope 窗口不是越小越精确
默认主题窗口为 50 turns。附录分别测试 10 与 100:
- 10-turn 过度分段会切断上下文连续性和共指链,伤害 Type 3 多跳推理;
- 100-turn 分段不足会合并不同 episode,最伤害 Type 2 上下文事实召回;
- 50-turn 在抽取的代表轨迹上整体更平衡。
但该敏感性实验每个分区只评估一条代表轨迹,证据强度有限。
2. 提升不只来自 GPT-5-mini
在 GPT-4o-mini 与 GPT-4.1-mini 骨干上,STITCH 相对 Full Context 和 SeCom 的优势仍随长度增加。在 GPT-4.1-mini 上,Full Context 的 Small F1 为 0.712,高于 STITCH 的 0.555;到 Medium/Large,STITCH 分别为 0.440/0.308,超过 Full Context 的 0.362/0.213。
3. Small 上召回率低,却能回答更好
附录 Table 10 中,STITCH 的 retrieval recall 在 Small 只有 0.416,低于 RAPTOR 0.694;到 Medium/Large 则以 0.387/0.292 最高。它说明召回更多原始 turn 不等于答案更好,尤其多个片段都能支持答案时,raw-turn recall 并不是唯一可靠指标。
十八、效率:用写入成本换查询成本
KaTeX parse error: Undefined control sequence: \multicolumn at position 28: ...y}{l|rrr|rrr} &\̲m̲u̲l̲t̲i̲c̲o̲l̲u̲m̲n̲{3}{c|}{\text{I...
Table 7:CAME-Bench token 成本拆解。 Ingestion 表示流式构建记忆的成本,Query 表示检索与答案生成成本;数值单位为千 tokens。
STITCH 的优势不是零成本。Small 写入需要 6.1K tokens,高于 SeCom 的 5.2K;原因是每一步要进行多个 LLM 调用构造意图、解指代和摘要。但查询阶段只需 1.4K/3.2K/1.9K,远低于 Full Context,也低于流式 SeCom。
因此它适合"一次写入、多次查询"或查询延迟敏感的系统。若每条轨迹只查询一次,必须把额外写入调用纳入总成本,不能只比较 query tokens。
十九、与 Agent Memory 系列方法横向比较
方法 核心对象 主要检索线索 与 STITCH 的区别 A-MEM 原子记忆及其链接 语义与图关联 STITCH 额外约束当前目标与事件 MAGMA 多粒度记忆 粒度与模块协同 STITCH 强调上下文有效性 CoM 可组合记忆单元 组合后的上下文需求 STITCH 先做结构兼容过滤 ReMemR1 可回访历史记忆 回调查询 解决写入遗忘,不专门建意图索引 Mem 2 Evolve 持续演化记忆 动态经验结构 STITCH 聚焦流式轨迹的检索 cue MemPO 单轨迹滚动记忆 策略内摘要 STITCH 是外部结构化检索系统 Memp 跨任务程序技能 任务/关键事实相似度 记"怎样做",STITCH 记"哪个上下文" STITCH 目标导向情节步骤 Scope/Event/Entity + Semantic 抑制语义相似但意图不兼容的历史 \begin{array}{l|l|l|l} \text{方法}&\text{核心对象}&\text{主要检索线索}&\text{与 STITCH 的区别}\\\hline \text{A-MEM}&\text{原子记忆及其链接}&\text{语义与图关联}&\text{STITCH 额外约束当前目标与事件}\\ \text{MAGMA}&\text{多粒度记忆}&\text{粒度与模块协同}&\text{STITCH 强调上下文有效性}\\ \text{CoM}&\text{可组合记忆单元}&\text{组合后的上下文需求}&\text{STITCH 先做结构兼容过滤}\\ \text{ReMemR1}&\text{可回访历史记忆}&\text{回调查询}&\text{解决写入遗忘,不专门建意图索引}\\ \text{Mem}^{2}\text{Evolve}&\text{持续演化记忆}&\text{动态经验结构}&\text{STITCH 聚焦流式轨迹的检索 cue}\\ \text{MemPO}&\text{单轨迹滚动记忆}&\text{策略内摘要}&\text{STITCH 是外部结构化检索系统}\\ \text{Memp}&\text{跨任务程序技能}&\text{任务/关键事实相似度}&\text{记"怎样做",STITCH 记"哪个上下文"}\\ \text{STITCH}&\text{目标导向情节步骤}&\text{Scope/Event/Entity + Semantic}&\text{抑制语义相似但意图不兼容的历史} \end{array} 方法A-MEMMAGMACoMReMemR1Mem2EvolveMemPOMempSTITCH核心对象原子记忆及其链接多粒度记忆可组合记忆单元可回访历史记忆持续演化记忆单轨迹滚动记忆跨任务程序技能目标导向情节步骤主要检索线索语义与图关联粒度与模块协同组合后的上下文需求回调查询动态经验结构策略内摘要任务/关键事实相似度Scope/Event/Entity + Semantic与 STITCH 的区别STITCH 额外约束当前目标与事件STITCH 强调上下文有效性STITCH 先做结构兼容过滤解决写入遗忘,不专门建意图索引STITCH 聚焦流式轨迹的检索 cueSTITCH 是外部结构化检索系统记"怎样做",STITCH 记"哪个上下文"抑制语义相似但意图不兼容的历史
横向比较:STITCH 在 Agent Memory 生命周期中的位置。 它主要改变写入索引与查询过滤,补足以往方法对潜在目标、动作类别和属性角色建模不足的问题。
STITCH 并不必然替代这些系统。其 Contextual Intent 可以作为 A-MEM 节点元数据、MAGMA 的跨粒度路由信号,或 Memp 程序库的适用条件。真正互补的方向是:既知道记忆之间如何关联,也知道当前任务意图允许调用哪些关联。
二十、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发
以下内容是基于论文机制的工程推演,不是论文直接验证的结论。
1. Coding Agent:同一个文件名不代表同一个修复目标
代码历史中会反复出现同一模块、函数和错误关键词。可以为每一步修改附加:当前主题范围(性能优化/权限修复)、事件类型(定位/修改/测试/回滚)、实体类型(函数、配置、数据库表)。检索"上次如何修复登录超时"时,应先过滤相同故障与环境,而不是只召回所有包含 login 的提交。
2. Tool Agent:把工具返回绑定到目标和动作
网页、API 和日志常包含重复实体。为工具结果添加"当前子目标 + 调用类型 + 关键字段类型",可避免把旧环境、旧时间点或不同权限范围的返回当作当前事实。
3. Multi-Agent:需要角色条件化的上下文意图
多智能体轨迹中,同一证据可能在 Researcher、Planner、Executor 手中承担不同作用。STITCH 已把 role 放入原始步骤,但检索元组主要围绕 scope、event、entity。工程上可再加入角色、权限与证据来源,防止跨 Agent 越权读取或误用。
4. 高风险系统不应使用不可逆硬过滤
查询标签置信度低时,可以保留一条 semantic-only fallback 通道,或先扩大候选、再由验证器判断上下文兼容性。这样可缓解标签选择错误导致的证据永久丢失。
二十一、局限性
1. 写入阶段昂贵
每个步骤需要多次 LLM 调用构造三类标签、做共指重写和生成摘要。论文明确承认其 ingestion 成本高于轻量 embedding 系统。
2. 标签更新存在延迟
实验每 50 步才合并或更新标签空间,以换取 schema 稳定性。新事件类型在一个 buffer 中段出现时,不能立即被正式纳入稳定 taxonomy。
3. 平坦 Event Taxonomy 不适合综合问题
细粒度标签有利于精确事实查找,却会割裂跨多种动作的信息。Figure 3 的 Type 4 Large 接近 0,是论文最重要的失败证据之一。
4. 查询侧标签一旦选错,过滤难以恢复
78.4% 的标签错误涉及问题本身无法推出的标签,71.8% 涉及粒度不匹配。当前系统缺少层次化候选、置信度回退和检索后的动态修正。
5. CAME-Bench 的合成性与样本规模
闭世界与符号 storyboard 保证可控,但可能与真实 Agent 轨迹的混乱程度不同。Large 只有两条轨迹,且大量构建与评估依赖 OpenAI 模型和 LLM-as-a-Judge。
6. LoCoMo 表明方法适用域有限
STITCH 围绕明确目标和任务状态构建结构,对开放式社交记忆中的情绪、关系和弱目标细节覆盖不足。0.703 的结果说明它不能被直接宣传为通用长期记忆 SOTA。
二十二、我的理解与启发
1. 记忆检索的真正对象是"带条件的事实"
传统 RAG 把事实看作一段文本;STITCH 提醒我们,Agent 历史中的事实应写成:在什么目标、什么事件、针对哪类实体属性、什么时间点成立。酒店价格不是一个孤立值,而是由日期、房型、阶段和动作共同限定的状态。
2. Contextual Intent 更像复合索引,而不是摘要
Thematic Scope 类似数据库分区键,Event Type 类似操作类型,Key Entity Type 类似字段选择器,semantic similarity 则像分区内的模糊排序。STITCH 的成功说明 Agent Memory 可以借鉴数据库:先用高精度结构条件缩小候选,再做近似匹配。
3. 越强的过滤器,越需要不确定性管理
结构过滤能大幅去噪,也使错误更具破坏性。未来系统应保留多层标签、概率分布和回退路径:高置信度时严格过滤,低置信度时放宽 scope 或 event,再用证据一致性验证。
4. 评测必须主动制造"相似但不对"的干扰
只考能否从长文本找到答案,容易高估 Memory。更真实的问题是:系统能否拒绝同名实体、旧状态和错误目标下的高相似证据。CAME-Bench 最值得继承的不只是数据,而是这种"上下文有效性优先"的评测思想。
5. 最完整的 Agent Memory 需要三种坐标
一个长期运行的 Agent 至少需要:
- 内容坐标: 发生了什么、有哪些事实;
- 意图坐标: 当时为了什么目标、在执行哪类动作;
- 时间坐标: 事实何时成立、后来是否被覆盖。
STITCH 重点补上意图坐标,但对时间更新和跨任务技能的建模仍可与其他方法结合。
二十三、总结
STITCH 重新定义了 Agent Memory 检索的瓶颈:问题往往不是召回不到语义相关内容,而是无法判断它是否属于当前目标、当前动作和当前属性需求。方法为每个轨迹步骤构造 Thematic Scope、Event Type 和 Key Entity Types,通过结构对齐先消解隐式指代,再将具体内容、意图结构和规范摘要共同存入 Memory Snippet。查询时,同样生成结构过滤配置,优先按标签密度排序,再用语义相似度细排。
在平均上下文达到 408K tokens 的 CAME-Bench Large 上,STITCH 的 F1 为 0.592,相对最强基线绝对提升 0.356;在 LongMemEval 上也取得最佳总体表现。但 LoCoMo 只有 0.703,Type 4 长程信息综合几乎失效,同时写入阶段需要更多 LLM 调用。这些结果共同表明,意图索引对目标导向的长程 Agent 很有效,却仍需要层次化标签、不确定性回退和更低成本的结构预测器。
一句话总结:
STITCH 的核心贡献,是让 Agent Memory 从"检索语义上像的历史"升级为"检索在当前目标、动作与实体角色下真正有效的历史"。
参考资料
- Yang et al. Grounding Agent Memory in Contextual Intent. Findings of ACL 2026.
- 论文主页:https://aclanthology.org/2026.findings-acl.584/
- 项目与代码:https://contextual-intent.github.io/
- Wu et al. LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory. 2024.
- Maharana et al. LoCoMo: Evaluating Very Long-Term Conversational Memory of LLM Agents. 2024.