问题描述
小明是一位古生物研究员,最近在分析一批远古生物化石的DNA序列。每个DNA序列由一系列字符组成(仅包含'A', 'C', 'G', 'T'),他发现这些序列中,除了一个序列外,其他所有序列都恰好有另一个完全相同的序列与之配对(表示来自同一个生物个体)。完全相同指的是字符串内容完全一致。
现在需要你帮助小明找出那个没有配对的独特DNA序列,以确定其所属的生物种类。
要求:
- 设计一个算法,在O(n)的时间复杂度内找出独特的DNA序列,其中n是序列的数量。
- 尽量减少额外空间的使用,以体现算法的优化能力。
测试样例
样例1:
输入:
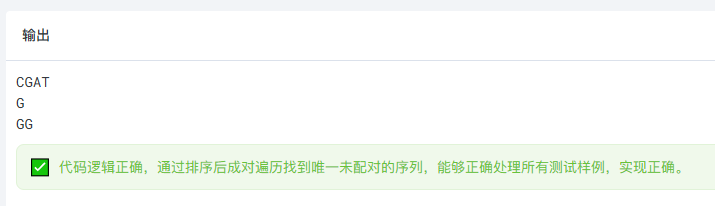
sequences = ["ACGT", "ACGT", "GCTA", "GCTA", "TTAA", "TTAA", "CGAT"]输出:"CGAT"解释:序列"ACGT"出现两次(配对),"GCTA"出现两次(配对),"TTAA"出现两次(配对),"CGAT"只出现一次(没有配对)。
样例2:
输入:
sequences = ["A", "A", "C", "C", "G"]输出:"G"解释:序列"A"出现两次(配对),"C"出现两次(配对),"G"只出现一次(没有配对)。
样例3:
输入:
sequences = ["TT", "TT", "AA", "CC", "CC", "AA", "GG"]输出:"GG"解释:序列"TT"出现两次(配对),"AA"出现两次(配对),"CC"出现两次(配对),"GG"只出现一次(没有配对)。
约束条件
- 1 ≤ sequences.length ≤ 1001(且为奇数)
- 1 ≤ sequencesi.length ≤ 100
- sequencesi 仅包含字符 'A', 'C', 'G', 'T'
- 除了一个序列外,其他每个序列都恰好出现两次
程序代码
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
// 比较函数:按字典序
int cmp(const void* a, const void* b) {
return strcmp(*(char**)a, *(char**)b);
}
char* findUniqueDNA(char** sequences, int sequencesSize) {
// 复制指针数组(避免修改原数组)
char** sorted = (char**)malloc(sequencesSize * sizeof(char*));
for (int i = 0; i < sequencesSize; i++) {
sortedi = sequencesi;
}
// 排序
qsort(sorted, sequencesSize, sizeof(char*), cmp);
// 遍历找独特字符串
char* result = NULL;
int i = 0;
while (i < sequencesSize) {
if (i + 1 < sequencesSize && strcmp(sortedi, sortedi + 1) == 0) {
// 成对,跳过两个
i += 2;
} else {
// 独特字符串
result = sortedi;
break;
}
}
free(sorted);
return result;
}
int main() {
char* sequences1\[\] = {"ACGT", "ACGT", "GCTA", "GCTA", "TTAA", "TTAA", "CGAT"};
int size1 = 7;
printf("%s\n", findUniqueDNA(sequences1, size1)); // CGAT
char* sequences2\[\] = {"A", "A", "C", "C", "G"};
int size2 = 5;
printf("%s\n", findUniqueDNA(sequences2, size2)); // G
char* sequences3\[\] = {"TT", "TT", "AA", "CC", "CC", "AA", "GG"};
int size3 = 7;
printf("%s\n", findUniqueDNA(sequences3, size3)); // GG
return 0;
}
cpp
#include <stdio.h>
#include <stdlib.h>
#include <string.h>

// 比较函数:按字典序
int cmp(const void* a, const void* b) {
    return strcmp(*(char**)a, *(char**)b);
}

char* findUniqueDNA(char** sequences, int sequencesSize) {
    // 复制指针数组(避免修改原数组)
    char** sorted = (char**)malloc(sequencesSize * sizeof(char*));
    for (int i = 0; i < sequencesSize; i++) {
        sorted[i] = sequences[i];
    }

    // 排序
    qsort(sorted, sequencesSize, sizeof(char*), cmp);

    // 遍历找独特字符串
    char* result = NULL;
    int i = 0;
    while (i < sequencesSize) {
        if (i + 1 < sequencesSize && strcmp(sorted[i], sorted[i + 1]) == 0) {
            // 成对,跳过两个
            i += 2;
        } else {
            // 独特字符串
            result = sorted[i];
            break;
        }
    }

    free(sorted);
    return result;
}

int main() {
    char* sequences1[] = {"ACGT", "ACGT", "GCTA", "GCTA", "TTAA", "TTAA", "CGAT"};
    int size1 = 7;
    printf("%s\n", findUniqueDNA(sequences1, size1));  // CGAT

    char* sequences2[] = {"A", "A", "C", "C", "G"};
    int size2 = 5;
    printf("%s\n", findUniqueDNA(sequences2, size2));  // G

    char* sequences3[] = {"TT", "TT", "AA", "CC", "CC", "AA", "GG"};
    int size3 = 7;
    printf("%s\n", findUniqueDNA(sequences3, size3));  // GG

    return 0;
}
运行结果