那天晚上我在给 tri-article 补一篇文章,照例往 articles/index.json 里加一条记录。加完顺手 list 了一眼,返回 1 条。
我盯着屏幕愣了三秒。那个文件里躺着两三个月攒下来的 75 条文章记录------标题、slug、领域、标签、内容哈希、落盘路径全在里面。现在只剩我刚加的这一条。
退出码 0,stderr 一行都没有,终端上打印的是新记录完整的 JSON,跟过去几十次长得一模一样。要不是我那天多看了这一眼,它大概会在我下一次 add 之后彻底变成历史。
复现一次,比读十遍代码快
tri-article 的索引维护在 tri-article/hooks/index.py,205 行,纯标准库,dedup / add / search / list 四个子命令。我先把它拷到实验目录,造了 75 条假记录,然后把索引文件截断成 400 字节------这就是一个坏掉的 JSON。
bash
# 索引已经坏了,但没人告诉我
$ python -c "
import sys; sys.path.insert(0,'.')
import index_orig as M
print('load_index ->', len(M.load_index('work_a')))"
load_index -> 0

# 照常 add
$ python index_orig.py --root work_a add --title "今天新写的一篇" \
      --domain demo --slug today --path p/today.md
rc = 0 | stderr = ''
add 之后条数 = 1 -> ['today']
75 条进去,1 条出来,中间没有任何提示。根因在第 38 到 43 行:
python
def load_index(root):
    path = os.path.join(root, INDEX_FILE)
    if not os.path.isfile(path):
        return []
    try:
        with open(path, encoding="utf-8") as fh:
            data = json.load(fh)
        return data if isinstance(data, list) else []
    except (ValueError, OSError):
return [] # ← 解析不出来,就当「从来没有过文章」我个人特别讨厌这种写法。except 里返回空列表,语义上等于告诉调用方「你的库是空的」,而真实情况是「你的库我读不了」。这两件事在 add 眼里完全一样:都是「追加一条然后写回」。于是坏文件 + 一次 add = 静默清库。
文件不存在时返回 [] 我认,那是首次运行。解析失败也返回 [],就是把数据损坏伪装成初始化。
并发跑,六个进三个
既然读出来是整份、写回去也是整份,那并发就一定有问题。我起了 6 个子进程,各自往 10 条的库里加 1 条:
text
6 个进程各自 add 1 条,起始 10 条 -> 最终 13 条
存活的并发 slug = ['conc0', 'conc4', 'conc5']
丢掉的         = ['conc1', 'conc2', 'conc3']
三条蒸发。没有锁,没有临时文件,没有 os.replace,就是 open(w) 直接盖。谁写得晚谁说了算。
这事儿跟我自己的工作流直接撞车------我那个「每天自动产一篇 tri-xxx 文章」的任务,同日并行过不止一次实例,两边都在往同一个 index.json 追加。以前我只当是「后写的覆盖先写的」这类小毛病,现在知道了:不是覆盖一条,是整份读改写,丢多少取决于调度时序。
add 的「覆盖更新」会把字段一起抹平
cmd_add 里有个我觉得挺好的设计:同 (slug, domain) 视为同一篇文章,原地替换而不是追加(127-135 行),避免索引随覆盖无限膨胀。这点值得学。
但它替换得太干净了。我造了一条带完整字段的旧记录,然后只传三个必填参数重新 add:
text
覆盖前: {'slug': 's0', 'created_at': '2026-01-01', 'content_hash': 'deadbeef',
         'status': 'draft-ready', 'tags': ['旧标签']}
覆盖后: {'slug': 's0', 'created_at': '',       'content_hash': '',
         'status': 'done',         'tags': []}
--created_at 默认空串、--content_hash 默认空串、--status 默认 done、--tags 默认空。四个字段全被默认值冲掉,同样没有警告。我原来那条 draft-ready 的记录,被一次无心的 add 改成了 done,内容哈希也丢了。
| 位置 | 原版行为 | 我期望的行为 |
|---|---|---|
load_index 解析失败 |
返回 [],后续 add 清库 |
抛错退出,绝不覆盖原文件 |
| 写回方式 | open(w) 直接覆盖,无锁 |
临时文件 + os.replace 原子替换 |
add 覆盖同 slug |
未传字段一律重置为默认值 | 未传字段沿用旧值 |
dedup 软重复 |
duplicate=True 但退出码 0 |
退出码非 0,编排能拦住 |
search --keyword |
只匹配 title |
------(文档 §1.5 本就说「title 包含」,属一致) |
dedup 不传 --slug,软判定会反过来咬人
cmd_dedup 第 96 行长这样:
python
if edit_distance(r["slug"], slugify(args.slug or "")) <= SOFT_DISTANCE:--slug 是可选项。不传的时候 slugify("") 得到空串,于是 edit_distance(已有slug, "") 恒等于 len(已有slug)。判定条件退化成「库里有没有长度 ≤2 的 slug」。
实测造了两条记录,一条 slug 是 ab,一条是 ai-coding-pitfalls,然后查一个跟两者毫无关系的新标题:
text
--- 未提供 --slug ---
rc = 0 | duplicate = True | level = soft | soft 命中: ['X']     ← 就是那条 slug='ab'
--- 提供 --slug "brand-new-title" ---
rc = 0 | duplicate = False | level = none
也就是说,你越认真地不填 --slug,越容易撞上假阳性。反过来说,长 slug 的库里软去重等于完全没生效------距离永远大于 2。
还有一个更影响编排的:cmd_dedup 结尾是 return 1 if hard else 0(第 106 行)。真·软重复(slug 距离 1)实测 duplicate=True、level=soft,退出码照样是 0。SKILL.md §1.5 白纸黑字写着软重复要「提示换角度」,可用退出码串流程的话,软重复会被整条吞掉。
真实索引里,有 6 条是搜不到的
我拿手上这份 75 条的真索引跑了 search:
text
--domain 开发者工具            -> 19 条
--domain developer-tools   -> 49 条
--domain "AI 工程"          ->   0 条
--domain "ai-工程"          ->   0 条
slugify("AI 工程") 得到 ai-工程(空格不是 \w 也不是 CJK,被换成连字符)。可这 6 条存进去的时候没走 slugify,domain 字段原样是 AI 工程。查询侧 slugify、存储侧不 slugify,两边永远对不上------这 6 条在 domain 维度上是索引里的暗物质,占全库 8%,而 search 的退出码还是 0。
顺带把 search 的另两条语义也摸清楚了:--keyword 只匹配标题,标签里的 HarmonyOS 搜不出来(实测 0 条);--tag 是小写后精确全等,Harmony 这种前缀搜不到。前者跟 §1.5 写的一致,后者属于我自己想当然。
| 检索方式 | 实测结果 | 说明 |
|---|---|---|
--keyword HarmonyOS(只在 tags) |
0 条 | 只比 title |
--keyword 鸿蒙(在 title) |
1 条 | 命中 |
--tag HarmonyOS / --tag harmonyos |
1 条 | 小写后全等 |
--tag Harmony(前缀) |
0 条 | 不支持模糊 |
--domain "AI 工程" |
0 条 | 存储值带空格,查询被 slugify |
还有个 dead code,以及一次自证
save_index() 定义在第 46 行,全文零处调用 。cmd_add 在 136 到 139 行把同样的保存逻辑又内联写了一遍。短期看不影响功能,长期看这就是两处逻辑漂移的温床------哪天有人改了 save_index 的缩进或编码,cmd_add 不会跟着变。
我用脚本自己的 normalize_title + title_hash 去核对这 75 条记录的 title_hash 字段,65 条对得上,86.7%。剩下 10 条里,1 条能对上「只做 lowercase」的旧版归一化,另外 9 条连 title_norm 字段都停在旧值------是标题后来被改过、哈希没跟着更新。这批失配不是脚本的锅,是我自己改标题时没回写。重来一次我会在改标题的地方加一道钩子,标题一变就把 title_norm 和 title_hash 一起重算。
我给自己打的三个补丁
不打算改 skill 源码(那会让四件套版本号跟着动),我在外面包了一层校验壳,实测三处都生效:
python
def load_index_strict(path):
    """原版:解析失败吞成 []。加固版:坏文件直接抛,绝不返回空列表当「没有历史」。"""
    if not os.path.isfile(path):
        return []                       # 首次运行,确实是空库
    with open(path, encoding="utf-8") as fh:
        data = json.load(fh)            # 解析失败让它炸,交给调用方决定
    if not isinstance(data, list):
        raise ValueError(f"{path} 顶层不是数组,实际是 {type(data).__name__}")
    return data

def save_index_atomic(path, records):
    """原版:open(w) 直接覆盖。加固版:临时文件 + os.replace。"""
    tmp = path + ".tmp"
    with open(tmp, "w", encoding="utf-8") as fh:
        json.dump(records, fh, ensure_ascii=False, indent=2)
    os.replace(tmp, path)
跑在刚才那个坏文件上,加固版抛 JSONDecodeError 并退出码 2,原文件一个字节没动;原版同一份文件返回 []。dedup 那边我加了长度差预筛和「软重复返回 2」,实测不传 slug 不再误报、传 abc 能正确报 soft。
开销我也量了一下,顺手确认 edit_distance 不是瓶颈:同域 800 条、slug 长 34 字符,一次 dedup 比对耗时 114.7 ms(100 条 15.0 ms,400 条 58.2 ms),线性增长,这个量级完全够用。
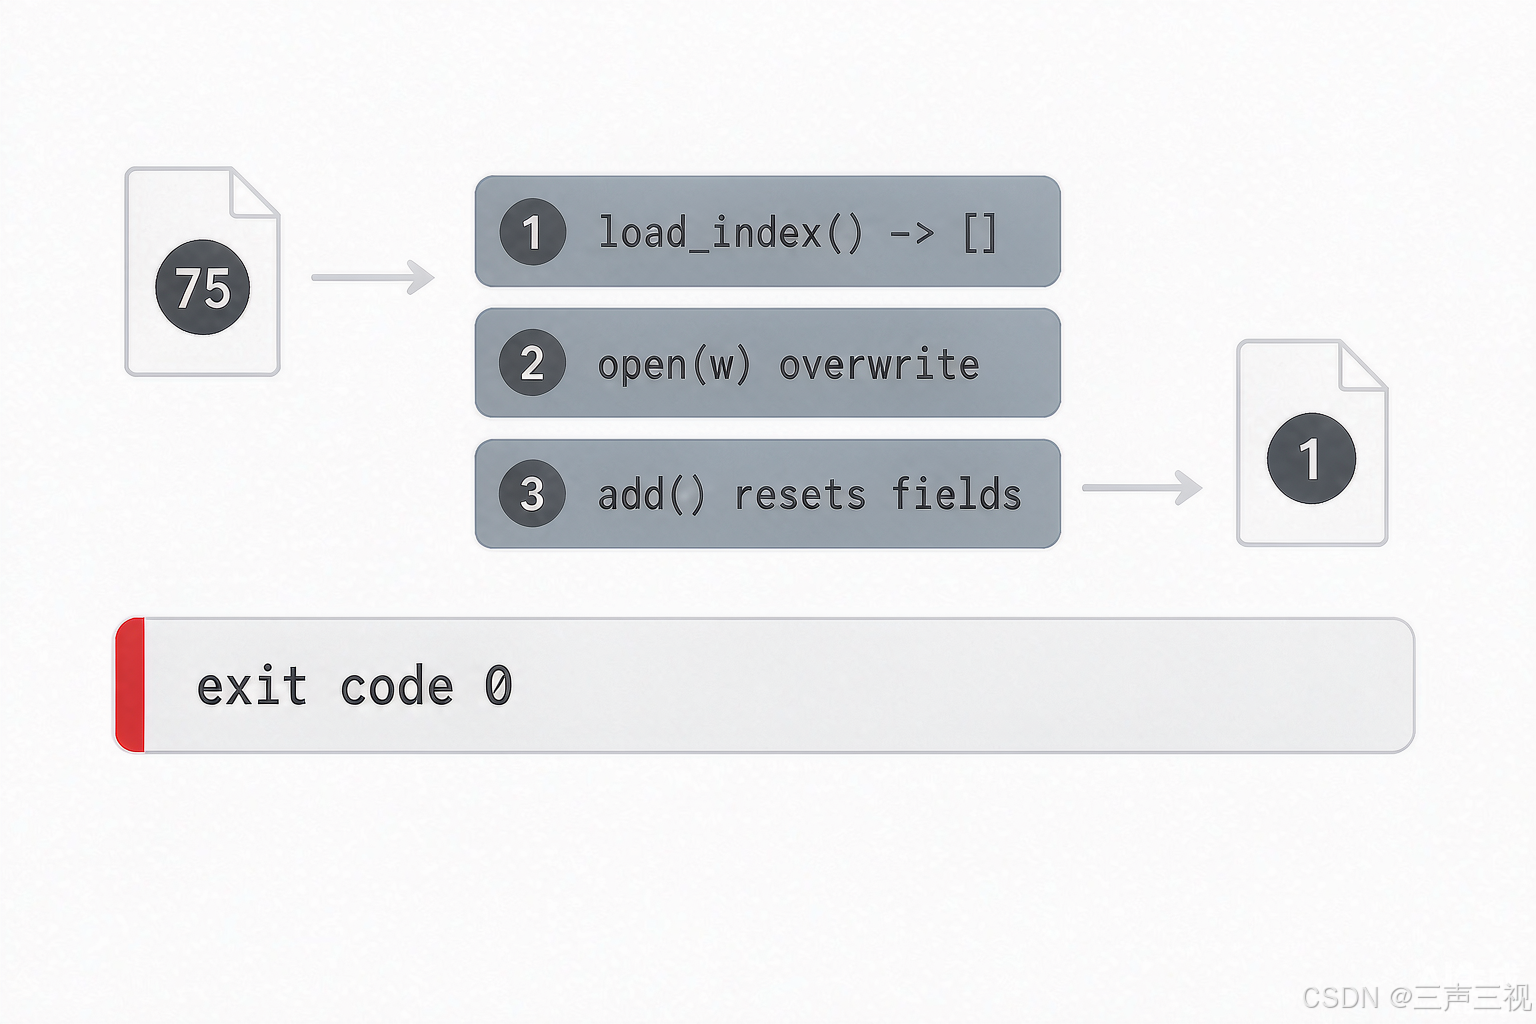
上面这张图是我按代码画的三处静默点:坏文件被吞成空、并发写覆盖、覆盖更新抹字段。三件事单独看都不致命,叠在一起就成了「索引说不清自己有多少条」。
现在我的规矩变成两条:动 index.json 之前先 cp 一份 .bak;add 之后必跑一次 list 核条数,不相等就停手。土办法,但比退出码 0 靠谱。
顺便一提,产品雷达鸭那边每周自动攒竞品选题,撞的是同一道题:怎么知道这个角度上周是不是已经写过了。我给它的做法也很土------标题归一化后算哈希,跟历史库比一把。够用,但也就够用而已。
你们的索引是自己手写的还是脚本生成的,有没有真的数过一次条数?
个人介绍
我是老三,10 年软件开发老油条,软件设计师、注册人工智能工程师。平时搞 Web 前端,这两年也在啃鸿蒙 ArkTS 北向开发,顺手折腾 AI 自动化,不定期在 CSDN 写点实战踩坑。
本文遵循 MIT 协议,转载请注明出处。