摘要
在 Linux 服务器实际运维中,有三个问题经常会碰到:服务器时间不一致、服务受到 SELinux 权限限制,以及系统日志越来越多却不好排查。
这些问题单独看并不复杂,但真正放到多台服务器的环境里,就会直接影响系统维护和业务运行。
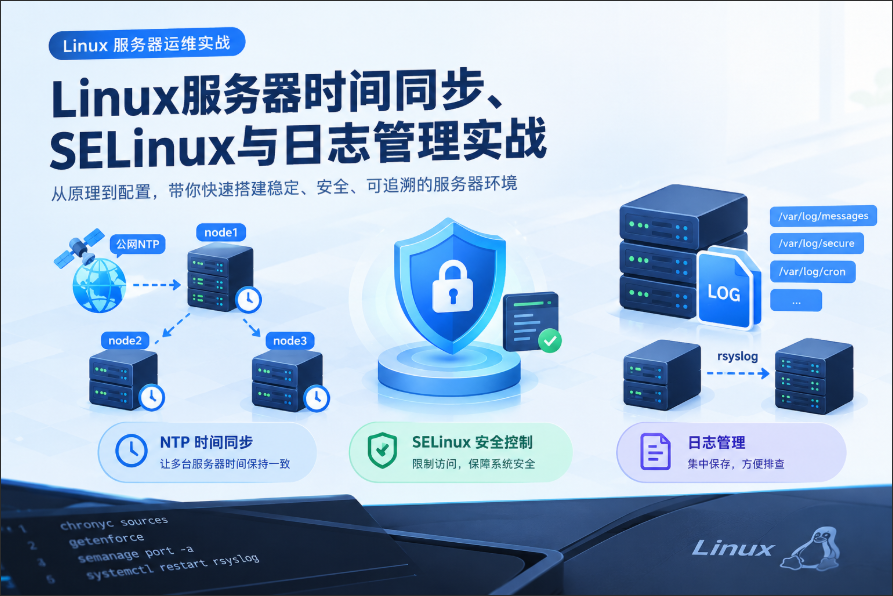
例如,node1、node2、node3 三台服务器,如果时间不一致,那么同一个故障在不同服务器上的日志时间可能对不上;如果 Nginx 使用了 SELinux 默认没有允许的端口,服务甚至无法启动;如果服务器发生故障,只查看当前屏幕上的报错往往也不够,还需要通过 /var/log/ 下的日志进行分析。
所以,这篇文章就按照实际服务器环境,把 NTP 时间同步、SELinux 管理和 rsyslog 日志管理串起来做一次实操。
引言
Linux 服务器数量越来越多以后,单台服务器自己配置时间已经不太够用了。尤其是在局域网环境中,有的服务器可以访问互联网,有的服务器只能访问内网。
文档中的场景就是比较典型的一种:node1 可以连接外网,而 node2、node3 只能和 node1 通信。这时候可以让 node1 连接公网 NTP,再让 node2、node3 统一向 node1 同步时间,这样就形成一个简单的内部时间同步环境。
另外,Linux 中的安全控制也不能忽略。SELinux 开启以后,即使是 root 用户,也可能因为安全策略导致服务无法使用某个端口。日志管理则负责把系统发生过的事情记录下来,方便后面定位问题。
NTP时间同步服务
什么是NTP
NTP 是网络时间协议,主要作用就是让网络中的多台计算机保持时间一致。
这个事情看起来很简单,但在服务器环境中非常重要。比如多台服务器一起处理一个请求,如果 node1 记录的是 10:00:01,而 node2 的时间却是 09:59:55,那么后面查日志的时候就很难判断到底哪个操作先发生。
NTP 对分布式系统、日志排查、安全认证以及业务系统都有作用。
NTP同步服务器原理
NTP 使用 Stratum 分层结构同步时间。最上层可以理解为原子钟、GPS 等标准时间来源,下面的服务器逐级获取时间。
text
原子钟 / GPS
     ↓
Stratum 1
     ↓
Stratum 2
     ↓
Stratum 3
     ↓
Linux客户端
Linux 客户端并不是简单地"拿一个时间过来",而是通过 NTP 的机制尽可能消除网络延迟,让服务器时间接近 UTC 标准时间。
查看当前时间源
bash
chronyc sources代码解释
执行以后重点看 MS、Stratum、Reach 和 Last sample。
* 表示当前正在使用的时间源,+ 表示候选时间源,- 表示可用但没有被选中,? 表示通信失败或时间源无效。
例如:
text
^* 111.230.189.174 2 6 377这里 * 表示当前正在使用这个时间源,Stratum 2 表示它属于第二层时间服务器,Reach 377 表示最近的通信状态比较正常。
chrony时间同步服务
Rocky Linux 中通常已经安装 Chrony。没有安装时可以使用:
bash
dnf install chrony -y
systemctl start chronyd
systemctl enable chronyd
systemctl status chronyd
Chrony 的配置文件是:
bash
/etc/chrony.conf例如可以把默认时间源修改成文档中的国内时间源:
text
pool ntp.org.cn iburst
pool ntp.aliyun.com iburst
pool ntp.tencent.com iburst
pool ntp.ntsc.ac.cn iburst
pool time.tencentcloud.com iburst
修改完成后:
bash
systemctl restart chronyd
chronyc sources
实际场景一:三台服务器统一时间
假设 node1 可以访问外网,node2 和 node3 只能访问 node1。
第一步,让 node1 同步公网 NTP:
text
pool ntp.org.cn iburst
pool ntp.aliyun.com iburst
pool ntp.tencent.com iburst

allow 192.168.88.0/24
然后:
bash
systemctl restart chronyd
firewall-cmd --add-service=ntp --permanent
firewall-cmd --reload
node2、node3 的 /etc/chrony.conf 指向 node1:
text
pool node1 iburst最后分别重启:
bash
systemctl restart chronyd
chronyc sources
代码解释
这里实际上就是把 node1 当成局域网里的时间服务器。
text
互联网NTP
    ↓
  node1
  /    \
 ↓      ↓
node2  node3
这样 node2、node3 不需要直接连接互联网,也能通过 node1 获取时间。
SELinux
基本概念
SELinux 是 Linux 中的一套强制访问控制机制。它不仅检查用户权限,还会根据安全策略限制进程访问文件、端口和其他资源。
所以有时候会出现一种情况:普通 Linux 权限看起来完全正常,但服务就是启动不了。这个时候就需要检查 SELinux。
三种工作模式
主要有三种:
text
Enforcing   强制执行策略
Permissive  只记录,不拦截
Disabled    关闭SELinux
查看状态:
bash
getenforce
sestatus
临时修改:
bash
setenforce 0
setenforce 1
永久配置:
bash
vi /etc/selinux/config
SELINUX=disabled
永久修改后需要重启服务器。
semanage管理端口
代码示例
假设 Nginx 要使用 8070 端口:
bash
semanage port -a -t http_port_t -p tcp 8070
systemctl restart nginx
查看:
bash
semanage port -l | grep http删除:
bash
semanage port -d -p tcp 8070代码解释
-a 是添加,-d 是删除,-t http_port_t 表示把这个端口定义成 HTTP 服务可以使用的类型,-p tcp 表示使用 TCP 协议。
实际环境中,如果 Nginx 配置为:
nginx
server {
    listen 8070;
}
但 SELinux 没有允许 8070,那么启动 Nginx 时可能出现:
text
bind() to 0.0.0.0:8070 failed (13: Permission denied)这时候不是简单关闭 SELinux,而是可以通过 semanage 给 8070 添加正确的 SELinux 类型。
实际场景二:Nginx自定义端口
bash
dnf install -y nginx
vi /etc/nginx/nginx.conf

# 修改为
listen 8070;

semanage port -a -t http_port_t -p tcp 8070
systemctl restart nginx
这个场景比较适合实际服务器,因为企业内部的网站不一定都使用 80 端口。使用自定义端口时,需要同时考虑 Nginx 配置和 SELinux 策略。
日志管理
日志基本介绍
日志可以理解成服务器的一本"运行记录"。
系统什么时候启动、用户什么时候登录、服务发生什么错误,都可能被记录下来。
常见日志包括:
text
/var/log/cron
/var/log/messages
/var/log/secure
/var/log/btmp
/var/log/wtmp
其中 /var/log/messages 记录大量系统重要信息,排查 Linux 系统问题时经常会查看它;/var/log/secure 则主要和登录、认证、权限等信息有关。
rsyslog日志服务
rsyslog 的主要配置文件:
bash
/etc/rsyslog.conf它可以控制日志记录级别、保存位置以及远程转发。
日志等级从低到高:
text
debug < info < notice < warning < err
< crit < alert < emerg
例如:
text
*.warning;mail.none;authpriv.none;cron.none /var/log/messages表示记录 warning 以及更严重级别的日志,同时排除 mail、authpriv 和 cron。
实际场景三:把node1日志集中保存到node2
如果 node1 出问题,连 node1 本身都无法正常访问,那么只把日志保存在 node1 上就不太方便。
这时候可以让 node1 把日志发送到 node2。
node2配置
bash
vi /etc/rsyslog.conf添加:
text
module(load="imtcp")
input(type="imtcp" port="514")
然后:
bash
systemctl restart rsyslog
ss -tunpl | grep 514
防火墙放行:
bash
firewall-cmd --add-port=514/tcp --permanent
firewall-cmd --reload
node1配置
bash
vi /etc/rsyslog.conf添加:
text
*.warning;mail.none;authpriv.none;cron.none @@node2然后:
bash
systemctl restart rsyslog
logger -p local0.warning "node1 test message"
最后到 node2 查看:
bash
tail /var/log/messages代码解释
这里的 @ 和 @@ 有区别:
text
@node2表示通过 UDP 发送。
text
@@node2表示通过 TCP 发送。
文档中的案例使用 TCP,让 node1 的日志发送到 node2。这样 node1 负责产生日志,node2 负责集中保存。
日志本地保存+远程转发
如果希望 node1 自己保留一份,同时 node2 再保存一份,可以配置:
text
*.info;mail.none;authpriv.none;cron.none /var/log/messages再配合远程转发:
text
Target="node2"
Port="514"
Protocol="tcp"
测试:
bash
logger -p local0.warning "node1 test message"这样出现故障以后,可以直接在 node1 查看本地日志,也可以到 node2 查看远程日志。文档中的 rsyslog 配置还使用了队列机制,在远程主机暂时不可用时可以先把消息保存下来,之后再继续发送。
QA环节
Q1:为什么服务器一定要做时间同步?
因为多台服务器时间不一致,会造成日志时间线混乱,也可能影响认证、安全机制和业务处理。
Q2:Nginx使用8070端口为什么会被SELinux拦截?
因为 SELinux 会根据策略限制服务使用的资源。8070 如果没有被定义为 HTTP 服务允许使用的端口,Nginx 就可能无法绑定该端口。
Q3:rsyslog中的@和@@有什么区别?
@ 使用 UDP,@@ 使用 TCP。文档中的远程日志案例主要使用 TCP。
Q4:为什么要把日志发送到另一台服务器?
如果所有日志都只存在本机,一旦本机出现严重故障,查看日志会比较麻烦。把日志同步到 node2,可以方便后续排查。
总结
这几个知识点放在一起,其实就是一套比较基础的 Linux 服务器运维思路。
NTP 解决的是"服务器时间要统一"的问题;SELinux 解决的是"服务访问资源时要符合安全策略"的问题;rsyslog 解决的是"系统发生了什么,需要留下记录并方便排查"的问题。
实际服务器环境中,这三个功能经常会同时出现。先保证服务器时间一致,再处理 SELinux 权限,最后把重要日志保存和转发出去,服务器的基础运维环境就比较完整了。
:::end writing block