在企业在线考试系统中,监控大屏看起来似乎只是一个"数据展示页面"。
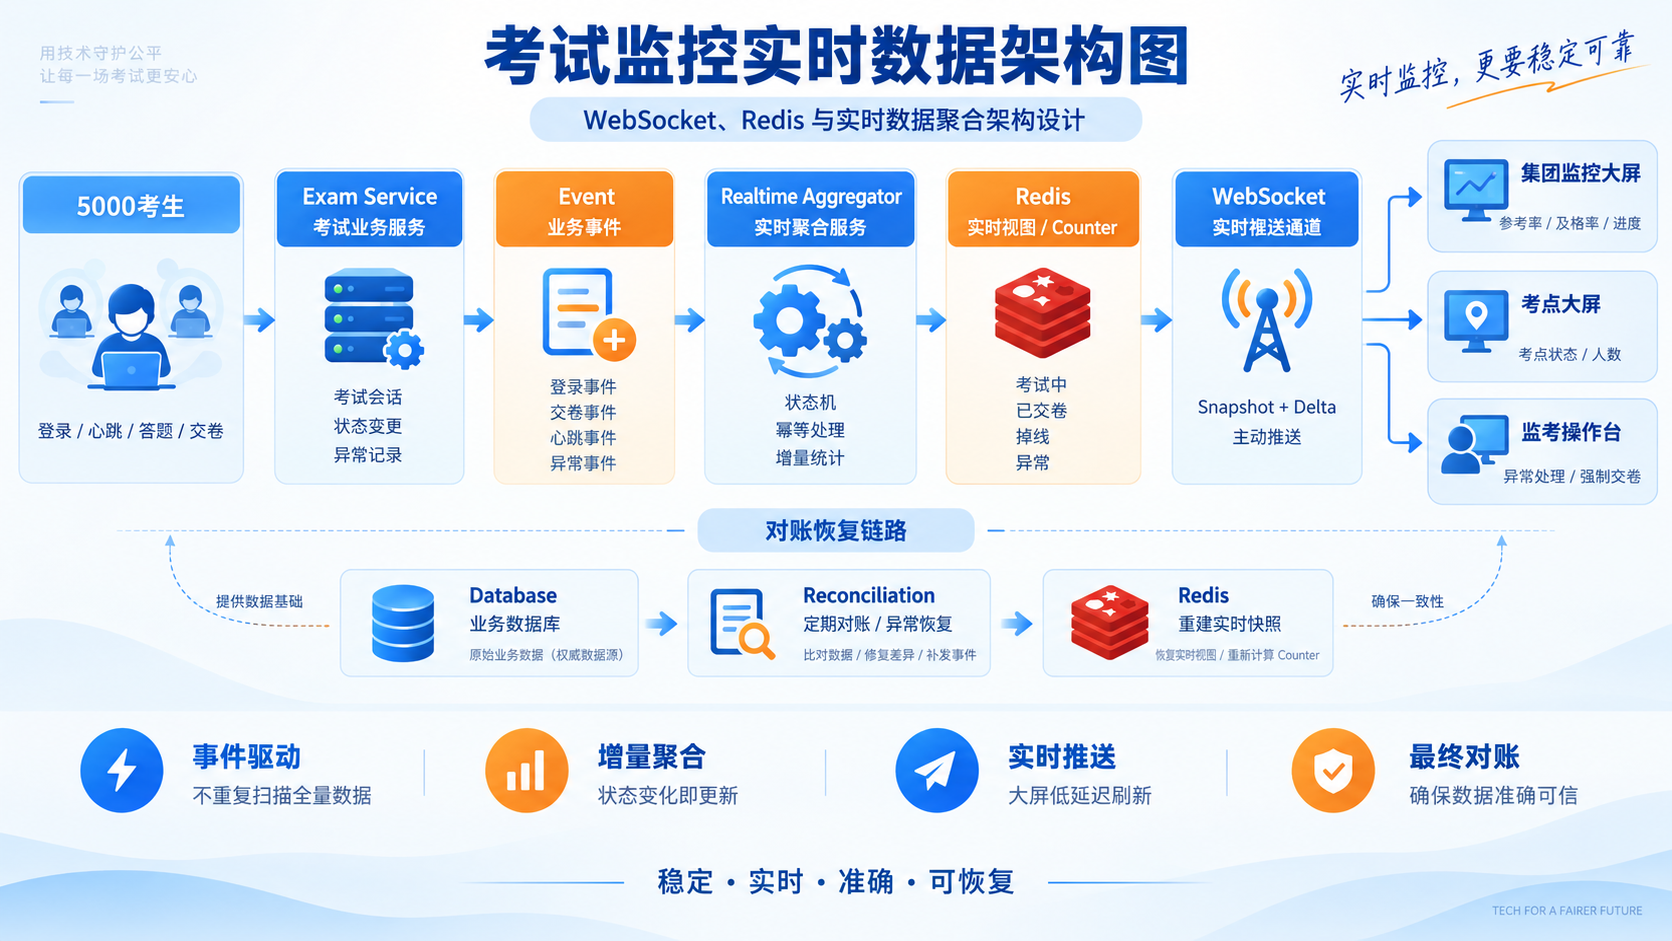
应考5000人、已登录4826人、考试中4712人、已交卷86人、掉线9人、异常19人,再配上参考率、交卷趋势、部门进度和异常考生列表,一块大屏基本就完成了。
于是很多项目第一版都会采用一种最直接的实现方式:
浏览器大屏
    ↓
每2秒请求一次接口
    ↓
后台查询数据库
    ↓
COUNT / GROUP BY
    ↓
返回最新统计结果
数据量小时,这套方案完全可以运行。
但当系统真正进入集团企业、煤矿、能源、电力、高校或者大型职业技能竞赛场景,同时考试人数从几百人增加到3000人、5000人甚至更多以后,这种设计很容易出现一个非常尴尬的问题:
监控大屏本来是用来观察考试是否稳定的,结果大屏自己反而成了考试数据库的压力来源。
更加严重的是,正式考试期间数据库本身正在不断处理答案自动保存、考试心跳、交卷、日志、异常记录等业务。如果监控页面再不断执行COUNT、GROUP BY、JOIN和排序统计,就可能让"看考试的人"与"正在考试的人"争抢同一套数据库资源。
所以大型考试系统的实时监控不能简单理解成"前端不断查数据库"。
更加合理的思路应该是:
业务事件
   ↓
实时状态聚合
   ↓
Redis实时视图
   ↓
WebSocket推送
   ↓
监控大屏
本文结合大型在线考试业务,并以宏远培训考试系统这类面向企业集中考试、监考中心和数字化大屏的应用场景为例,分析考试实时监控背后的 WebSocket、Redis、状态聚合、数据一致性和异常恢复设计。
需要说明的是,本文中的 WebSocket、Redis 等属于面向该类业务场景的通用架构设计思路,实际项目可以根据系统版本、部署环境和现有技术体系进行调整。
一、为什么大屏直接查数据库,小规模没问题,大规模容易出问题?
假设一场集团考试有5000名考生。
系统需要展示以下数据:
应考人数
已登录人数
考试中人数
已交卷人数
掉线人数
异常人数
参考率
交卷率
各部门考试进度
最近异常考生
实时交卷趋势
如果大屏每2秒刷新一次,并且后台分别执行多条SQL:
SELECT COUNT(*)
FROM exam_session
WHERE exam_id = ?;
再查询考试中人数:
SELECT COUNT(*)
FROM exam_session
WHERE exam_id = ?
  AND status = 'EXAMING';
再查询已交卷:
SELECT COUNT(*)
FROM exam_session
WHERE exam_id = ?
  AND status = 'SUBMITTED';
部门进度可能又是一条:
SELECT
    org_id,
    COUNT(*) AS total,
    SUM(CASE WHEN status = 'SUBMITTED' THEN 1 ELSE 0 END) submitted
FROM exam_session
WHERE exam_id = ?
GROUP BY org_id;
异常统计再来一次:
SELECT COUNT(*)
FROM exam_abnormal_log
WHERE exam_id = ?
  AND create_time >= ?;
一块大屏可能一次刷新就产生十几条SQL。
如果同时还有:
集团总部大屏
二级公司监控页面
各考点监控室
监考员操作台
考试管理后台
多个页面同时轮询,数据库收到的就不再是一块屏幕的请求。
而正式考试过程中,数据库还在执行:
答案保存
考试状态更新
心跳记录
切屏日志
人脸核验记录
交卷
成绩写入
监考操作
于是:
考试业务写入
      +
监控统计查询
      =
共同竞争数据库资源
这才是问题的核心。
二、大屏最危险的SQL通常不是普通查询,而是聚合查询
查一个考生:
SELECT *
FROM exam_session
WHERE session_id = ?;
只要索引合理,成本通常比较可控。
但大屏喜欢做的是:
COUNT
SUM
AVG
GROUP BY
ORDER BY
趋势统计
多表JOIN
例如要计算各部门实时参考率:
SELECT
    o.org_name,
    COUNT(s.id) AS should_count,
    SUM(
        CASE
            WHEN s.status IN ('EXAMING', 'SUBMITTED')
            THEN 1
            ELSE 0
        END
    ) AS joined_count
FROM exam_session s
LEFT JOIN sys_org o
    ON s.org_id = o.id
WHERE s.exam_id = ?
GROUP BY s.org_id, o.org_name;
这种SQL如果每隔两三秒执行一次,就相当于反复计算一个其实只发生少量变化的数据集合。
例如:
上一秒考试中:4680人
这一秒考试中:4682人
实际上只变化了两个人。
但传统方式却重新扫描、聚合5000个人的数据。
这在架构上属于:
为了得到2条变化,重新计算5000条状态。
数据量小时感觉不明显。
规模扩大以后,这种浪费就会逐渐暴露出来。
三、真正需要改变的不是SQL,而是思维方式
传统监控思路是:
我现在想知道有多少人考试
        ↓
去数据库重新数一遍
实时系统更合理的思路则是:
每当有人状态发生变化
        ↓
实时更新统计结果
例如某个考生:
未登录
  ↓
已登录
  ↓
考试中
  ↓
已交卷
系统已经知道:
考试中 -1
已交卷 +1
那为什么还要重新:
SELECT COUNT(*)扫描所有考生?
这就是实时数据聚合和传统报表查询最大的区别。
可以把它理解成:
传统报表:
数据 → 查询 → 计算结果

实时大屏:
事件 → 更新结果 → 直接展示
前者适合历史统计。
后者更加适合考试监控。
四、一套比较合理的考试监控架构
可以把整体架构设计成:
                    5000名考生
                         │
        ┌────────────────┼────────────────┐
        ▼                ▼                ▼
      登录             答题             交卷
        │                │                │
        └────────────────┼────────────────┘
                         ▼
                   考试业务服务
                         │
                         ▼
                    状态变化事件
                         │
              ┌──────────┴──────────┐
              ▼                     ▼
         业务数据库              实时聚合服务
                                    │
                                    ▼
                                  Redis
                                    │
                           实时状态 / Counter
                                    │
                                    ▼
                             WebSocket服务
                                    │
              ┌─────────────────────┼─────────────────────┐
              ▼                     ▼                     ▼
          集团大屏               考点大屏              监考操作台
这里数据库和Redis承担的是两个完全不同的角色。
数据库负责最终业务事实。
例如:
张三参加了考试
张三的最终答案是什么
张三什么时候交卷
张三最终成绩是多少
而Redis负责:
现在这一秒钟,大屏应该显示什么。
例如:
考试中:4712
已交卷:86
掉线:9
异常:19
这两个概念不能混为一谈。
五、Redis不是数据库替代品,而是实时状态视图
这是实时监控架构中特别需要强调的一点。
有人可能认为:
既然用了Redis,考试数据是不是都放Redis?
并不是。
正式考试的答卷、成绩、考试记录、日志等核心数据最终仍应该可靠持久化。
Redis更加适合维护:
实时Counter
在线状态
考试状态
心跳时间
临时异常状态
大屏快照
例如:
exam:realtime:20260910001可以使用Hash:
should_count      5000
login_count       4826
examining_count   4712
submitted_count   86
offline_count     9
abnormal_count    19
对应Redis命令:
HGETALL exam:realtime:20260910001此时大屏获取6个核心统计数据,不再需要执行6条:
COUNT(*)而只是读取一个已经计算好的结果。
六、考生状态变化以后,Counter应该如何更新?
假设考生张三当前状态:
EXAMING随后完成交卷:
EXAMING
    ↓
SUBMITTED
那么系统可以产生事件:
{
    "eventType": "EXAM_STATUS_CHANGED",
    "examId": "20260910001",
    "userId": "10086",
    "oldStatus": "EXAMING",
    "newStatus": "SUBMITTED",
    "timestamp": 1789007412000
}
聚合服务收到事件以后,不需要重新统计5000人。
只需要:
examining_count - 1

submitted_count + 1
Redis操作可以类似:
HINCRBY exam:realtime:20260910001 examining_count -1

HINCRBY exam:realtime:20260910001 submitted_count 1
这样复杂度从:
扫描5000人变成:
更新2个Counter人数进一步扩大时,这种设计的价值会更加明显。
七、但是直接HINCRBY还有一个大坑:重复事件
假设交卷事件因为网络或者消息重试,被处理了两次。
第一次:
examining_count -1
submitted_count +1
第二次又执行:
examining_count -1
submitted_count +1
最后大屏人数就错了。
于是可能出现:
实际交卷:1000人
大屏显示:1001人
考试继续进行以后,误差还可能越来越大。
因此实时Counter更新必须建立在:
状态转换幂等
基础之上。
不能只看:
事件告诉我 +1而应该先确认:
这个人的状态是不是第一次
从EXAMING变成SUBMITTED?
八、比较可靠的办法:保存考生当前状态
例如Redis中同时维护:
exam:candidate:status:{examId}Hash结构:
10001 = EXAMING
10002 = SUBMITTED
10003 = EXAMING
10004 = OFFLINE
处理张三事件时:
oldState = Redis当前状态
newState = 事件中的状态
如果:
oldState == newState说明重复事件。
直接忽略。
如果:
oldState = EXAMING
newState = SUBMITTED
才真正执行Counter变化。
伪代码:
public void changeStatus(
        Long examId,
        Long userId,
        ExamStatus newStatus) {

    ExamStatus oldStatus =
            redisRepository.getStatus(examId, userId);

    if (oldStatus == newStatus) {
        return;
    }

    redisRepository.decrease(
            examId,
            oldStatus
    );

    redisRepository.increase(
            examId,
            newStatus
    );

    redisRepository.setStatus(
            examId,
            userId,
            newStatus
    );
}
但这里还有一个问题:
如果两个请求并发执行怎么办?
所以生产环境通常还需要保证这一组状态转换操作的原子性。
可以使用Redis Lua脚本或者其他原子操作机制完成。
九、Redis Lua脚本为什么适合实时状态切换?
例如逻辑可以抽象成:
读取旧状态
     ↓
判断是不是重复事件
     ↓
旧状态Counter -1
     ↓
新状态Counter +1
     ↓
更新人员状态
这几步如果分别发送Redis命令,中间可能被其他请求插入。
Lua脚本则可以把整组操作作为一次原子执行。
示意逻辑:
local oldStatus =
    redis.call(
        'HGET',
        KEYS[1],
        ARGV[1]
    )

local newStatus = ARGV[2]

if oldStatus == newStatus then
    return 0
end

if oldStatus then
    redis.call(
        'HINCRBY',
        KEYS[2],
        oldStatus,
        -1
    )
end

redis.call(
    'HINCRBY',
    KEYS[2],
    newStatus,
    1
)

redis.call(
    'HSET',
    KEYS[1],
    ARGV[1],
    newStatus
)

return 1
这样才比较接近一个可靠的:
Real-Time State Machine十、考试状态最好设计成状态机,而不是几个Boolean字段
早期系统有时喜欢这样设计:
is_login
is_exam
is_submit
is_offline
这种设计很快会出现:
is_exam = true
is_submit = true
到底代表什么状态?
更加合理的方式是定义主状态:
public enum ExamSessionStatus {

    NOT_LOGIN,

    LOGGED_IN,

    EXAMING,

    SUBMITTED,

    FINISHED
}
其中:
掉线
异常
切屏
人脸异常
不一定应该全部变成主状态。
因为一个考生完全可能:
当前仍然处于EXAMING

同时存在:
切屏异常
人脸异常
所以更加合理的数据模型是:
Main Status
+
Realtime Flags
例如:
{
    "status": "EXAMING",
    "online": true,
    "abnormal": true,
    "abnormalTypes": [
        "WINDOW_SWITCH"
    ]
}
这比把所有状态揉成一个字段更加灵活。
十一、掉线人数为什么特别容易统计错?
"掉线"看起来简单,其实并不是一个业务按钮触发的状态。
用户不会告诉服务器:
我现在掉线了。
服务器只能根据:
最后心跳时间判断。
例如客户端每隔一定时间发送:
HEARTBEAT服务器记录:
lastHeartbeat = 10:30:16如果到:
10:30:46仍然没有新心跳,就可以根据配置规则判定:
OFFLINE但这里同样不建议每次心跳都:
UPDATE exam_session
SET last_heartbeat = NOW();
如果5000人每5秒一次:
5000 ÷ 5
=
1000次心跳/秒
如果这些心跳全部写数据库,反而会制造大量没有必要的数据库写入。
更加适合的是:
Heartbeat
   ↓
Redis
   ↓
更新TTL / LastHeartbeat
正式业务数据库只在必要时保存关键状态或者最终异常记录。
十二、WebSocket真正解决的问题是什么?
如果Redis已经保存了实时数据,为什么还需要WebSocket?
因为大屏还需要知道:
数据什么时候发生变化。
最简单方案仍然是:
setInterval(() => {
    fetch('/api/exam/realtime')
}, 2000);
这仍然属于Polling。
即使数据放在Redis里,也意味着:
没有变化
→ 仍然请求

只有1个人变化
→ 仍然请求全部数据
WebSocket则把模式改变为:
客户端问服务器变成:
服务器主动通知客户端架构变成:
Redis状态变化
      ↓
Realtime Aggregator
      ↓
WebSocket
      ↓
Browser
当:
submitted_count
86 → 87
服务器主动推送:
{
    "type": "EXAM_REALTIME_UPDATE",
    "examId": "20260910001",
    "submitted": 87,
    "examining": 4711
}
前端收到以后直接修改页面。
十三、但是千万不要"一个事件推一次大屏"
这是另一个常见误区。
假设5000名考生正在考试。
每一个考生:
登录
开始考试
保存答案
发送心跳
切换窗口
交卷
都会产生事件。
如果每收到一个事件就立即向大屏推送一次,那么WebSocket本身也可能形成大量无意义消息。
尤其是:
Heartbeat完全没有必要每次都刷新大屏。
更加合理的办法是:
事件实时处理,大屏合并推送。
例如内部一分钟可能处理数万个细粒度事件,但WebSocket可以按照:
200ms
500ms
1秒
这样的可配置窗口进行聚合。
例如500毫秒内发生:
考试中 -12
已交卷 +10
掉线 +2
只推一次:
{
    "examining": 4700,
    "submitted": 96,
    "offline": 11
}
而不是连续推送24条消息。
这叫:
Event Coalescing或者可以简单理解为:
业务事件细粒度,UI刷新粗粒度。
十四、大屏第一次打开的时候怎么办?
WebSocket还有一个非常容易被忽略的问题。
假设监考员:
10:35才打开监控大屏。
他之前没有接收到任何WebSocket消息。
难道页面从0开始等事件?
显然不行。
因此实时页面一般需要:
Snapshot + Delta模式。
第一次连接:
GET /api/exam/realtime/snapshot得到:
{
    "examId": "20260910001",
    "should": 5000,
    "login": 4890,
    "examining": 4300,
    "submitted": 570,
    "offline": 12,
    "abnormal": 26,
    "version": 18752
}
随后建立WebSocket。
之后只接收增量变化:
Snapshot
   ↓
WebSocket Delta
   ↓
WebSocket Delta
   ↓
WebSocket Delta
这样即使监控端中途刷新或者重新打开,也能马上得到完整数据。
十五、WebSocket断线以后,怎么保证大屏没有漏消息?
监控室网络也可能断。
例如:
10:30:01
WebSocket断开

10:30:08
重新连接
这7秒钟可能发生:
120人交卷
8人掉线
3个异常
如果客户端重新连接以后只是继续接收新消息,那么中间这批状态就丢了。
因此重新连接以后最稳妥的处理通常不是:
继续接着猜而是:
重新获取Snapshot例如:
WebSocket断线
      ↓
自动重连
      ↓
重新拉取完整实时快照
      ↓
恢复增量推送
这样大屏最多短暂延迟,不会长期显示错误数据。
十六、多台应用服务器以后,WebSocket还会遇到什么问题?
单机开发环境中:
Browser
   ↓
Server A
非常简单。
但正式系统可能有:
Server A
Server B
Server C
考生交卷请求可能落到:
Server A而监控大屏WebSocket连接在:
Server C此时Server C怎么知道Server A刚刚发生了状态变化?
这就是多节点实时通信问题。
可以增加一层:
Redis Pub/Sub
Redis Stream
MQ
其他事件总线
例如:
Server A
   ↓
产生状态事件
   ↓
Realtime Channel
   ↓
Server C
   ↓
WebSocket
   ↓
监控大屏
于是应用服务器不再依赖:
我自己有没有处理这个请求而是订阅整个考试的实时事件。
十七、Redis中的统计数据会不会有一天和数据库不一致?
会。
任何实时缓存系统如果运行足够长时间,都应该考虑:
事件丢失
重复事件
程序异常
Redis重启
网络分区
人工修改
因此不能认为:
Redis显示4712人,就永远是真理。
真正的最终事实仍然应该来自:
Database所以成熟一点的架构还需要:
Reconciliation也就是对账。
例如按照配置周期执行:
SELECT status, COUNT(*)
FROM exam_session
WHERE exam_id = ?
GROUP BY status;
然后和Redis比较:
Database:

EXAMING   4712
SUBMITTED 86


Redis:

EXAMING   4711
SUBMITTED 87
发现不一致以后:
报警
+
修正实时视图
+
记录异常日志
注意这里数据库聚合查询并没有被彻底消灭。
区别在于:
以前每2秒查一次。
现在可能只在初始化、恢复、定期校验以及最终统计时查询。
数据库压力完全不是一个量级。
十八、Redis挂掉以后,大屏是不是就彻底没数据了?
不应该。
Redis保存的是:
实时视图而不是唯一业务事实。
所以Redis异常恢复以后,系统应该能够根据数据库重新构建。
例如:
Redis异常
   ↓
服务恢复
   ↓
查询exam_session
   ↓
重新计算5000名考生状态
   ↓
重建Realtime Snapshot
   ↓
恢复WebSocket推送
这也是为什么不建议只在Redis保存:
考生最终交卷状态而数据库什么都没有。
正确关系应该是:
数据库
=
Source of Truth

Redis
=
Real-Time Projection
可以翻译成:
数据库管"事实",Redis管"现在怎么看事实"。
十九、异常考生列表不能只维护一个数字
大屏可能显示:
异常人数:19但监考员真正需要的是:
哪19个人?点击以后应该看到类似:
| 考生 | 单位 | 当前状态 | 异常类型 | 时间 |
|---|---|---|---|---|
| 张三 | 机电部 | 考试中 | 多次切屏 | 10:31:22 |
| 李四 | 安全部 | 考试中 | 心跳异常 | 10:32:05 |
| 王五 | 生产部 | 考试中 | 人脸异常 | 10:32:17 |
因此Redis不仅可以保存Counter,还可以维护:
exam:abnormal:{examId}其中保存:
userId
abnormalType
lastTime
level
大屏点击:
异常人数 19以后直接读取异常集合。
与此同时,最终需要留档的异常记录仍然写入数据库,用于后续考试复核和审计。
二十、监考操作台为什么又比普通大屏复杂一步?
普通大屏主要属于:
Read但监考中心还可能需要:
提醒考生
标记异常
强制抓拍
强制交卷
移交复核
这时候数据流就是双向的:
                  WebSocket
考试系统 ─────────────────────→ 监考端

考试系统 ←───────────────────── 监考端
                  Command
例如:
{
    "command": "FORCE_SUBMIT",
    "examId": "20260910001",
    "userId": "10086"
}
但这里需要特别注意:
WebSocket不能代替权限校验。
监考员发出强制交卷命令以后,后台仍然应该检查:
当前操作人是谁
是否拥有监考权限
是否能够管理本场考试
目标考生是否属于授权范围
考试当前是否允许执行该操作
并记录审计日志。
否则实时通信通道反而可能变成越权操作入口。
二十一、以宏远培训考试系统为例,监考大屏真正应该解决什么?
从企业正式考试场景来看,监控大屏的价值并不是"做几个漂亮图表"。
真正的问题是:
一场几千人的考试正在进行,管理人员能不能快速判断考试现在是否正常?
例如宏远培训考试系统的监考中心业务场景中,可以围绕:
应考
登录
考试中
已交卷
掉线
异常
形成实时状态视图。
集团总部可以查看整体参考进度,下属单位可以在权限范围内查看本单位考试情况;监考人员可以进一步查看异常考生,并结合考试日志进行处理。
这比简单显示:
考试人数:5000更加有价值。
因为监考真正关心的是:
还有多少人没有进入考试?

哪些单位参考率明显偏低?

一分钟内为什么突然出现大量掉线?

哪个考点连续发生异常?

交卷是否出现集中堵塞?

考试结束以后还有多少人没有成功提交?
这实际上已经不是普通"数据看板"。
而是:
Real-Time Exam Observability
即考试过程的实时可观测能力。
二十二、私有化考试环境为什么更需要做好这套架构?
企业、煤矿、电厂以及部分政务场景经常采用:
局域网
内网
专网
私有云
本地服务器
部署考试系统。
这种环境的优势之一是系统资源可控,但也意味着项目方需要根据:
实际人数
服务器配置
数据库性能
网络结构
监考功能
进行容量规划。
宏远培训考试系统面向内网、外网以及私有化部署场景时,如果正式考试电脑端与监控中心同时运行,就更加需要避免大屏统计影响考生答题业务。
从架构角度可以把优先级明确为:
第一优先级:
答题与答案保存

第二优先级:
交卷与考试状态

第三优先级:
监考与异常处理

第四优先级:
实时统计展示
任何情况下,都不能为了让大屏每秒刷新几个数字,而降低正式考试数据链路的稳定性。
二十三、大屏实时架构最好监控哪些指标?
当系统上线以后,不应该只监控:
CPU
内存
还要观察实时链路本身。
例如:
| 指标 | 关注的问题 |
|---|---|
| Online WebSocket Connections | 当前监控连接数量 |
| Event Input QPS | 每秒考试状态事件数量 |
| Aggregation Latency | 事件到聚合完成的延迟 |
| Redis OPS | Redis实时操作压力 |
| WebSocket Push Latency | 状态变化到大屏显示的延迟 |
| Event Backlog | 是否存在事件积压 |
| Reconnect Count | 是否频繁发生WebSocket断线 |
| Snapshot Load Time | 大屏首次加载速度 |
| Reconciliation Difference | Redis与数据库是否出现偏差 |
| DB Dashboard Queries | 大屏是否重新大量访问数据库 |
最后一个指标其实非常有意思。
如果架构改造以后:
WebSocket很多
Redis OPS很多
但是:
Dashboard DB Query仍然非常高,就意味着系统可能只是表面上加了一层Redis,大屏底层仍然不断查数据库。
这种改造意义就比较有限。
二十四、六个特别常见的实时大屏设计误区
实际项目中,可以把几种实现方式放在一起比较:
| 设计方式 | 看起来的问题 | 真正的问题 |
|---|---|---|
| 每秒直接查数据库 | 实现简单 | 聚合SQL持续压库 |
| 加Redis但仍不断查DB | 有缓存 | 缓存没有成为实时视图 |
| 使用WebSocket但每次先查DB | 实时推送 | 只是把轮询换成主动查询 |
| 每个事件立即推大屏 | 延迟低 | 消息量巨大、页面频繁重绘 |
| Redis Counter直接HINCRBY | 性能高 | 重复事件造成统计漂移 |
| 只信Redis不做对账 | 架构简单 | 异常后数据无法证明准确 |
真正比较完整的方案应该同时解决:
事件
状态
聚合
推送
幂等
恢复
对账
而不是只引入某一个技术名词。
二十五、最终可以形成怎样的一套实时监控链路?
综合前面的设计,完整架构可以抽象成:
                         考生端
                           │
       ┌───────────────────┼───────────────────┐
       ▼                   ▼                   ▼
      登录                心跳                交卷
       │                   │                   │
       └───────────────────┼───────────────────┘
                           ▼
                      Exam Service
                           │
                     Business Event
                           │
               ┌───────────┴───────────┐
               ▼                       ▼
            Database              Event Channel
         最终业务事实                   │
                                       ▼
                              Realtime Aggregator
                                       │
                         ┌─────────────┴─────────────┐
                         ▼                           ▼
                    Candidate State              Counter
                         │                           │
                         └─────────────┬─────────────┘
                                       ▼
                                     Redis
                                       │
                              Realtime Snapshot
                                       │
                                       ▼
                               WebSocket Gateway
                                       │
                  ┌────────────────────┼────────────────────┐
                  ▼                    ▼                    ▼
              集团监控大屏          考点监控大屏          监考操作台
同时旁边还应该存在一条:
Database
   ↓
Reconciliation
   ↓
Redis Snapshot
负责:
初始化
定期校验
异常恢复
最终对账
这样才能把实时性和可靠性结合起来。
二十六、总结:实时监控的核心不是WebSocket,而是"不重新计算已经知道的事情"
考试监控大屏为什么不应该频繁直接查询数据库?
并不是因为:
数据库性能一定很差。
而是因为系统其实已经知道:
谁登录了
谁进入考试了
谁掉线了
谁交卷了
谁发生异常了
这些业务事件已经在系统中真实发生过。
如果每次大屏刷新时再把所有数据重新扫描一遍,相当于:
系统不断重新计算自己刚刚已经知道的结果。
更加合理的方式应该是:
考试行为
   ↓
产生状态事件
   ↓
幂等状态转换
   ↓
实时聚合
   ↓
Redis维护Realtime View
   ↓
WebSocket合并推送
   ↓
监控大屏
数据库继续承担:
最终数据持久化
历史记录
考试结果
审计证据
数据恢复
Redis承担:
当前状态
实时Counter
心跳
实时快照
WebSocket承担:
服务器主动推送聚合服务负责:
把大量细粒度考试事件
转换成大屏真正需要的数据
而定期对账机制负责:
证明实时数据没有越跑越偏对于几百人的普通考试,这套架构可能显得稍微复杂。
但当场景变成:
3000人
5000人
集团多考点
多人监考
异常抓拍
实时交卷
集中监控
以后,它解决的就不仅仅是"大屏卡不卡"。
更加重要的是:
监控系统本身不能成为正式考试系统的负担。
以宏远培训考试系统这类面向企业集中培训考试、私有化部署和多级组织管理的系统为例,监考大屏真正有价值的地方,也不是把几个数字做得多炫,而是让集团管理员、考试负责人和监考人员在不影响正式考试业务的前提下,实时知道考试进行到了哪里、哪里发生了异常、哪些问题需要马上处理。
从工程角度看,这套架构最终可以归纳成四个词:
事件驱动、增量聚合、实时推送、最终对账。
WebSocket和Redis只是实现这些目标的技术手段。
真正决定一块考试监控大屏能不能在几千人同时考试时依然稳定、准确、可信的,是背后的整套实时数据架构。