目录
知识点:正则表达式,是一套字符串匹配规则,用来快速查找,提取,校验字符串
[HttpContent模块,用于 提取并解析 一个完整的请求HttpRequest](#HttpContent模块,用于 提取并解析 一个完整的请求HttpRequest)
引入
LoopThread模块
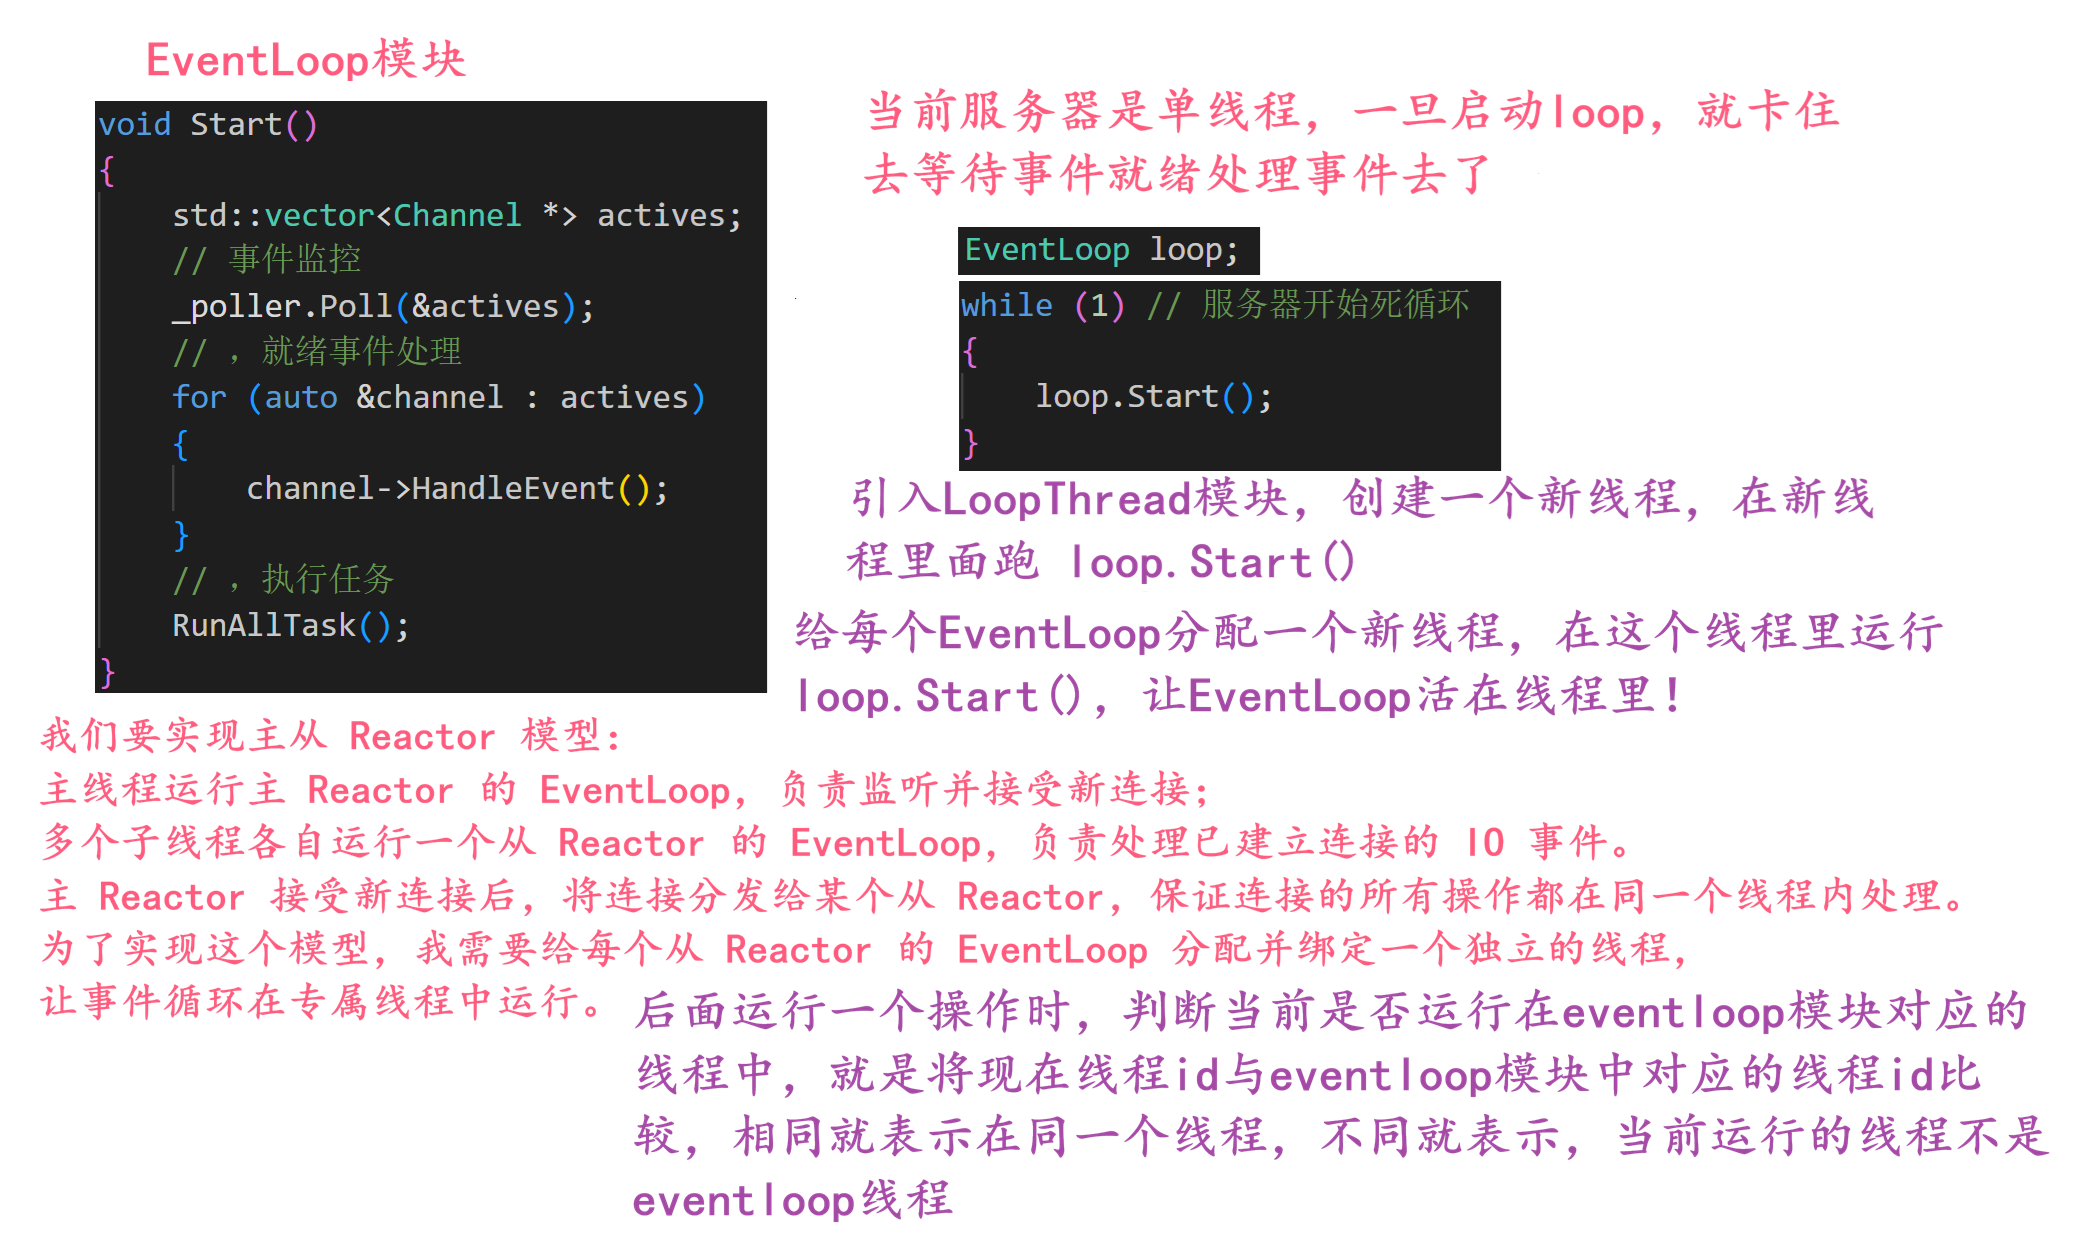
引入LoopThread模块,将EventLoop与线程Thread整合到一起,是对 EventLoop+专属运行线程 的整体封装,
- 1.创建EventLoop对应的线程
- 2.在子线程中实例化EventLoop对象
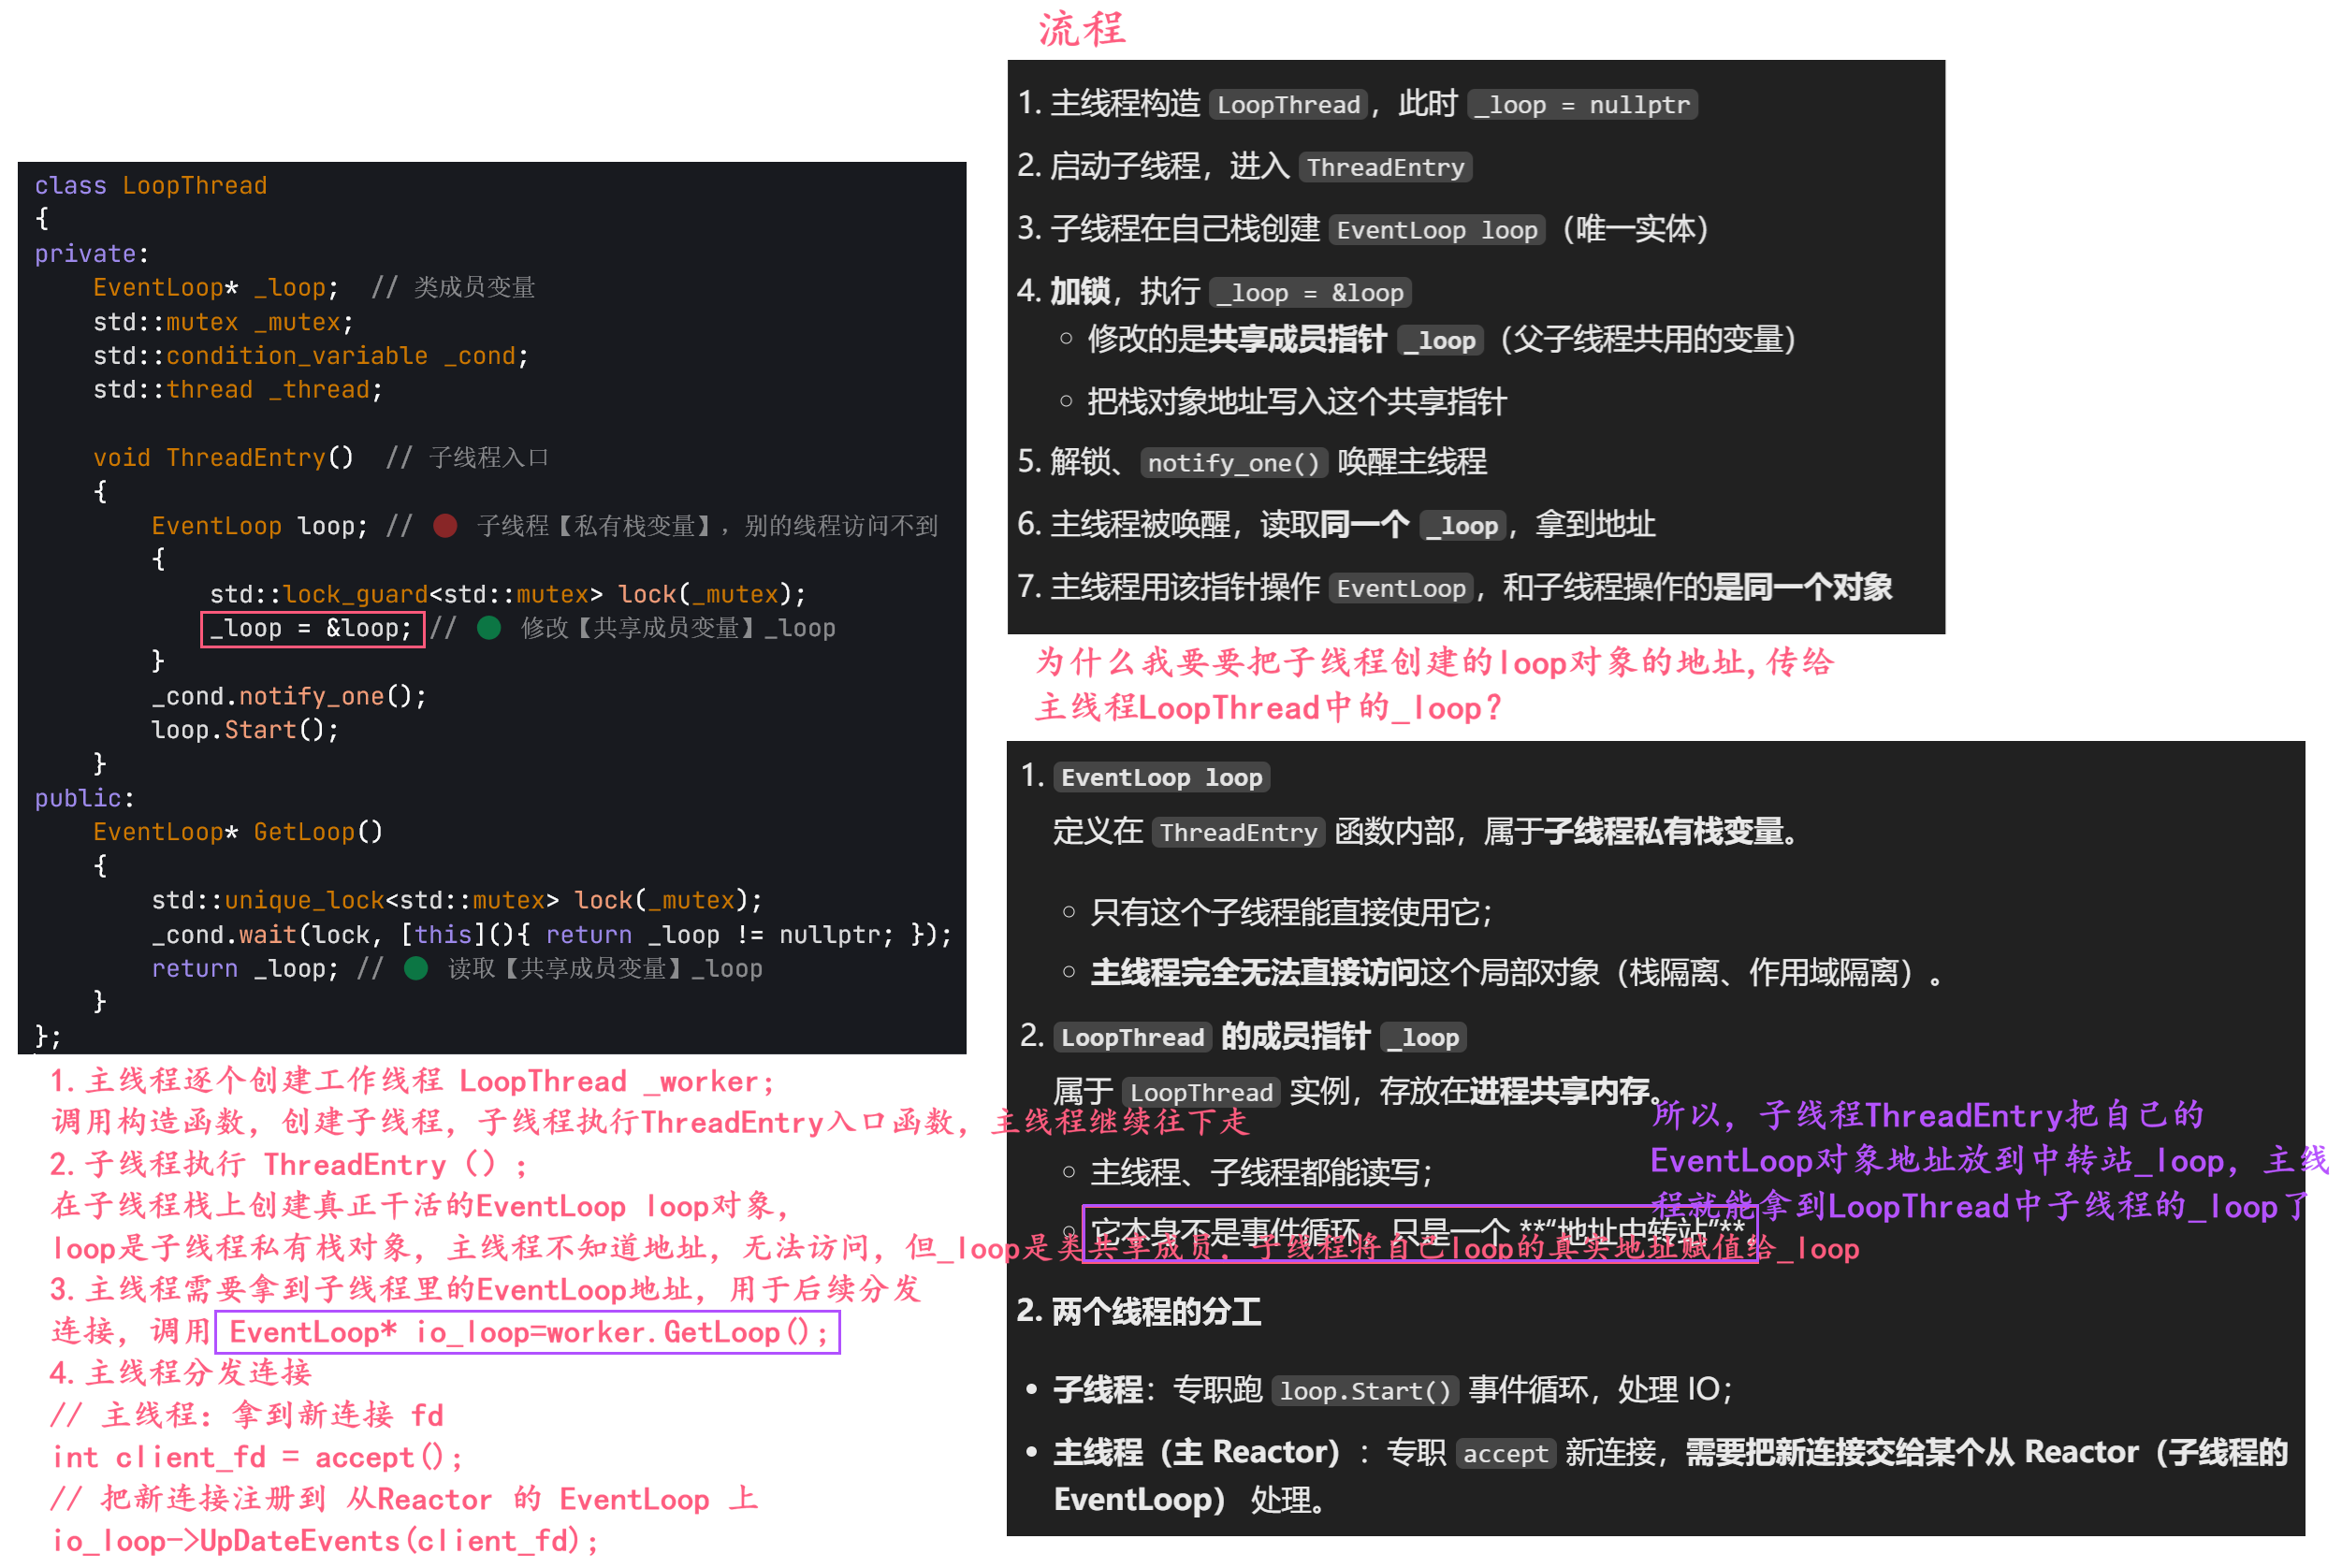
实现方法:
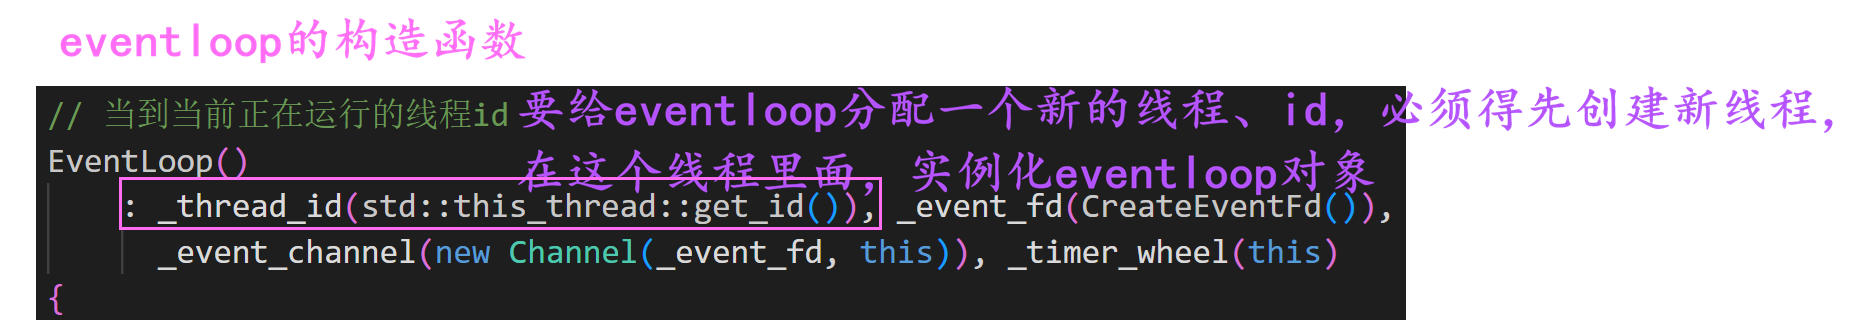
- EventLoop的构造函数时将当前正在运行线程的id传进去,所以创建子线程,在子线程里创建EventLoop对象
- GetLoop()函数是给父线程调用的,子线程把自己的EventLoop地址传给父线程,便于后续主线程将连接分发到不同子线程
- 而且还需要锁和条件变量,锁:父线程要读取_loop,子线程要往里写入_loop;条件变量:父线程一旦创建完子线程,立刻调用GetLoop获取子线程的_loop,子线程可能没执行完ThreadEntry(),_loop是空值,子线程正在执行ThreadEntry()和父线程正在执行GetLoop()同时执行,要父线程阻塞在子线程的条件变量中,这样获得的_loop是有效的;直到子线程赋值完_loop,唤醒该条件变量下的所有线程
cpp
class LoopThread
{
private:
    // 0.互斥锁+条件变量,实现loop获取的同步关系,避免线程创建但还没实例化出loop,外界获取loop的情况
    // 外界获取loop必须得等到它已经实例化完了
    std::mutex _mutex;
    std::condition_variable _cond;
    // 1.eventloop对应的线程
    std::thread _thread;
    // 2.本身并不创建eventloop,只是记录真实对象的地址
    EventLoop *_loop;

private:
    // 线程入口函数
    // 1.实例化一个EventLoop对象,并且开始运行eventloop模块的功能,loop.Start()死循环
    // 2.唤醒cond上可能阻塞的线程
    void ThreadEntry()
    {
        // 子线程栈上创建的对象,主线程找不到它的地址,不能直接访问它
        EventLoop loop; // 生命周期随loopthread
        {
            std::unique_lock<std::mutex> lock(_mutex);
            //_loop是LoopThread的成员变量,因为是线程,只要拿到地址,父子都能访问,记录_loop的真实地址
            // 取子线程 私有对象的地址&loop,写入到共享的指针变量_loop(父子线程共用的变量)
            // 主线程用指针操控_loop,和子线程用的是同一个EventLoop对象
            _loop = &loop;
            // 这样主线程就拿到了 子线程真正运行的EventLoop,为什么要拿到呢?
            //  主线程要把新连接 分配给子线程的EventLoop,但又碰不到它
            // GetLoop()拿到 子线程中干活的 EventLoop,就需要把它的地址提前存入_loop
            _cond.notify_all();//唤醒在条件变量下阻塞的所有线程,告诉它们,_loop已经初始化完成了,可以拿走了!
        }
        loop.Start(); // 子线程的loop 开始处理事件
    }

public:
    // 创建线程,设置线程入口函数,创建子线程立刻跑
    LoopThread() : _loop(nullptr), _thread(std::thread(&LoopThread::ThreadEntry, this))
    {
    }
    // 新连接到来了,要给它分配一个eventloop,首先得获取到这个eventloop
    // 返回当前线程关联的EventLoop对象的指针
    EventLoop *GetLoop()
    {
        EventLoop *loop = nullptr;
        {
            std::unique_lock<std::mutex> lock(_mutex); // 加锁
            // loop为空,线程放在条件变量下等待
            // 每次被唤醒后,自动检查条件是否满足,避免虚假唤醒
            _cond.wait(lock, [&]()
                       { return _loop != nullptr; });
            // 满足条件
            loop = _loop;
        }
        return loop;
    }
    // 一个问题,当线程创建完毕,但还没有实例化EventLoop对象的时候,
    // 如果外界获取GetLoop时,就会获取到空,不合适,所以要加锁
};
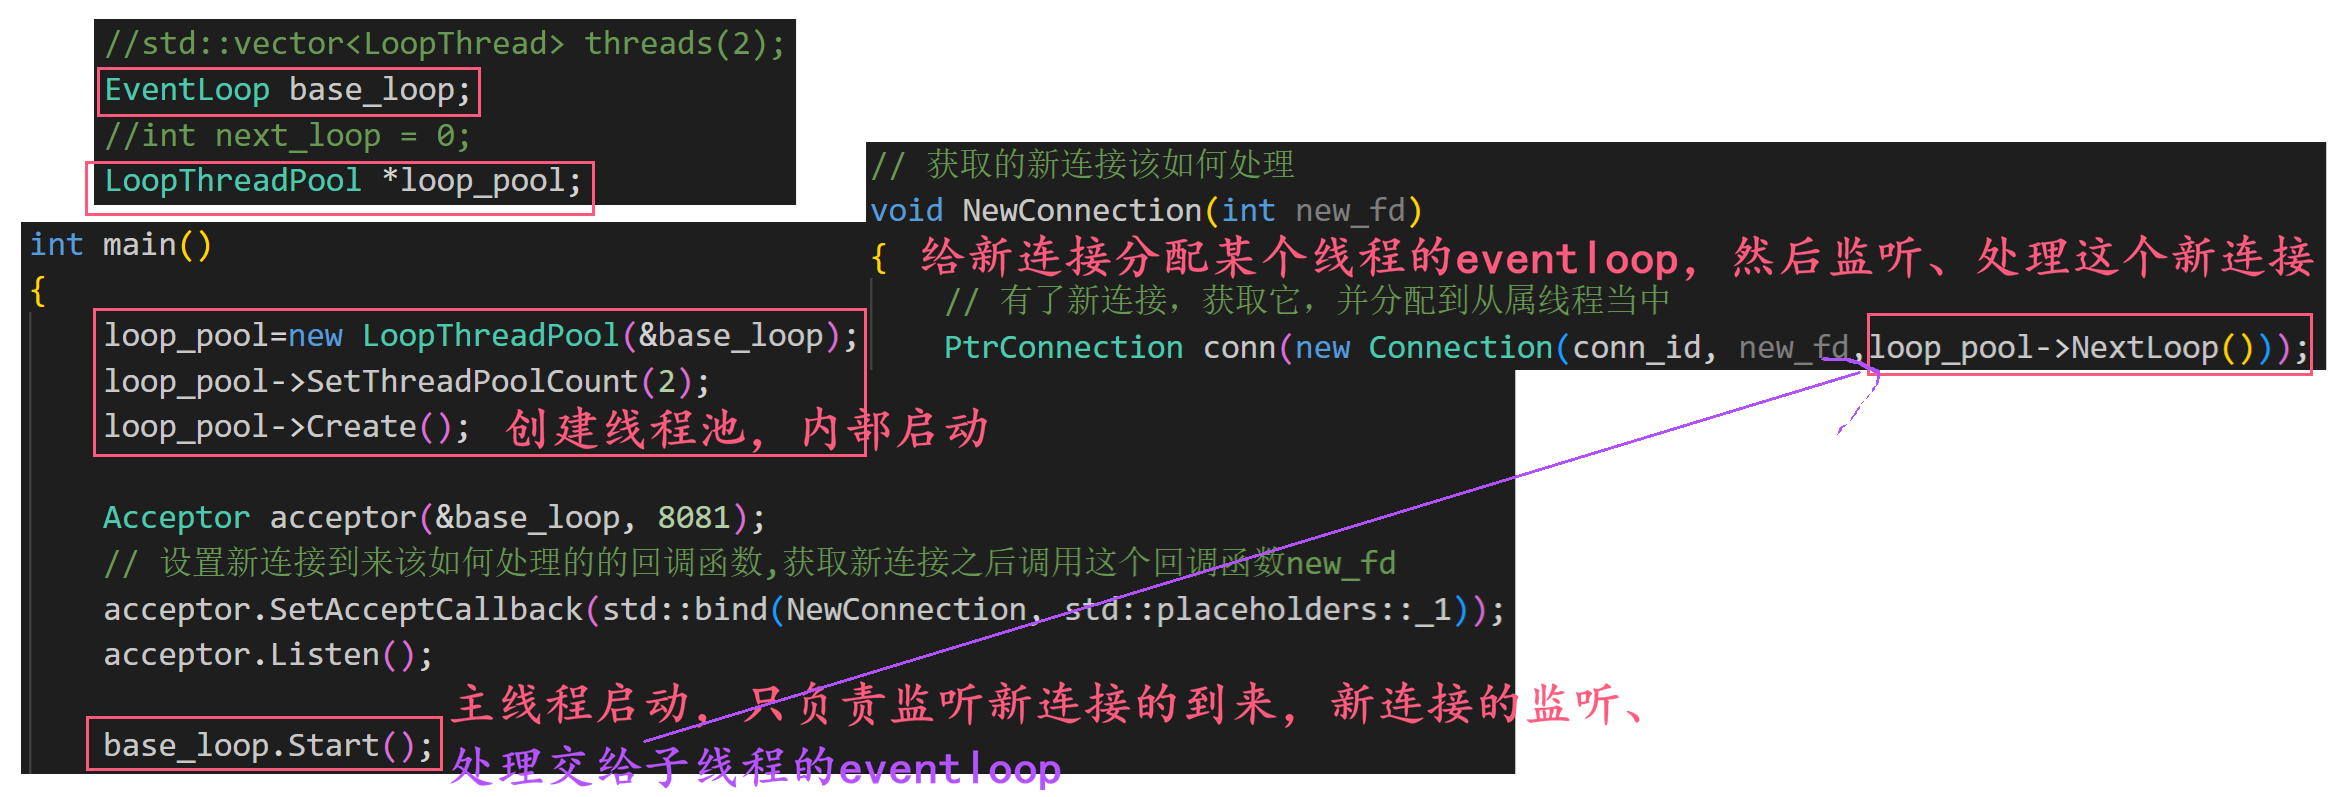
LoopThreadPool模块
管理所有线程LoopThread,拿到所有线程的地址进而通过GetLoop()拿到子线程的对应的Eventloop地址,线程的创建、连接conn分发到哪个线程对应的EventLoop
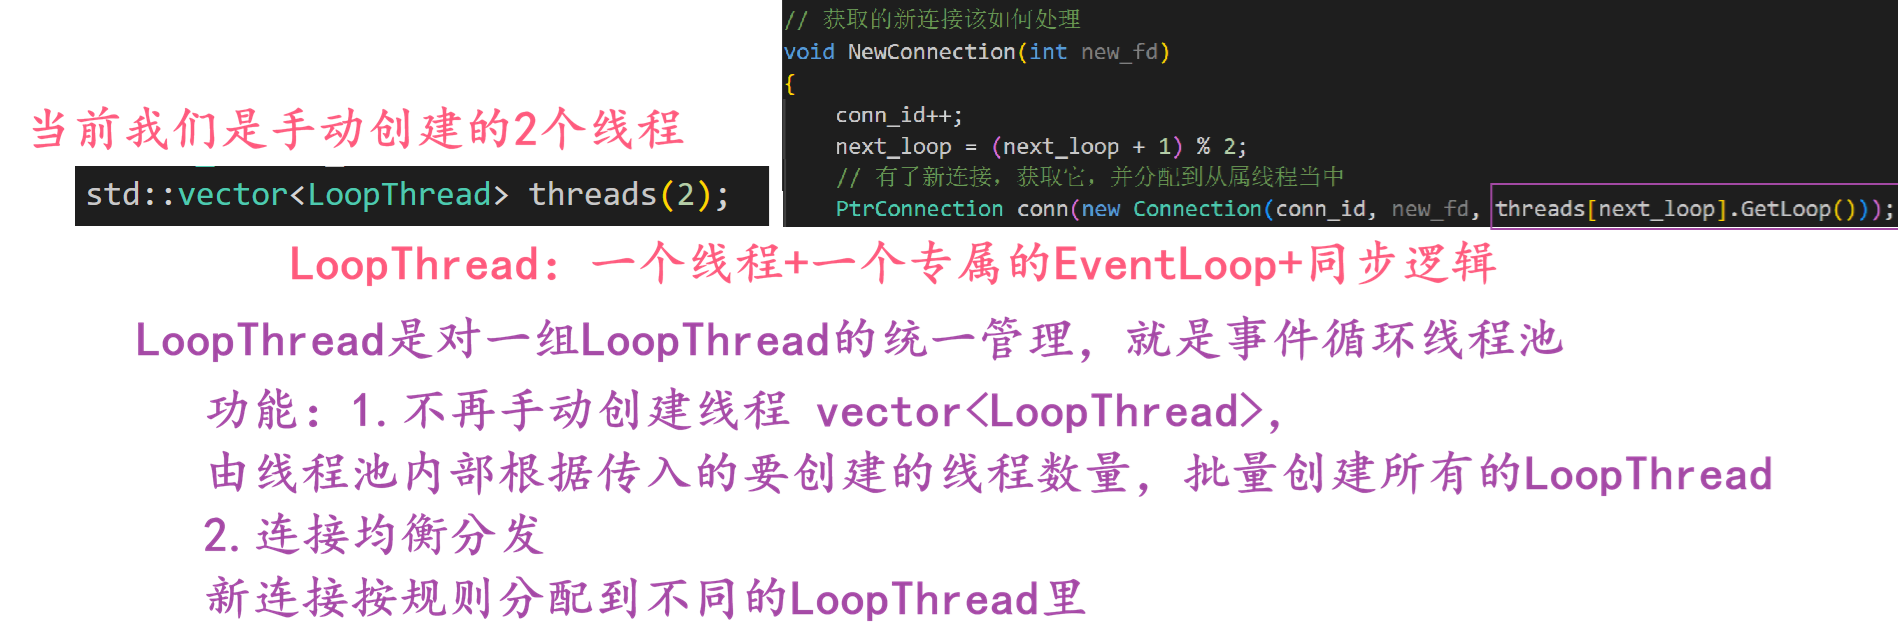
注意事项,
- 1.线程数量可配置,主从Reactor,主线程负责新连接的获取,从属线程负责新连接的事件监控以及处理。为了更加灵活,从属线程的数量可以为0,也就是线程池的数量可以为0,也就是但Reactor服务器,一个线程负责获取新连接+新连接的处理
- 2.连接的分配,主线程负责获取新连接,接着要处理这个新连接,也就是监控和事件就绪的处理。如果由0个从属线程,则直接将这个连接分配给主线程的EventLoop,直接处理;如果有多个从属线程,采取均分的思想,将连接分配给对应线程专属的EventLoop,EventLoop负责新连接的监听以及处理。
- 3.父线程Create()创建所有线程的时候,一旦子线程创建成功,子线程就在它的栈上创建EventLoop,把这个地址交给父线程,父线程通过GetLoop()就可以获取到;父线程创建完子线程后立刻调用GetLoop(),有可能此时子线程可能还没执行完ThreadEntry(),没将_loop的地址交给父线程,因此父线程就会阻塞在对应子线程的条件变量中,直到获取到_loop返回
cpp
class LoopThreadPool
{
private:
    // 从属线程的数量
    int _thread_count;
    int _next_loop_idx; // eventloop的下标
    // 线程分配,如果从属线程为0,直接分配到主线程,否则就逐个分配到_thread里面对应的eventloop
    EventLoop *_baseloop; // 主eventloop,运行在主线程
    // 将这个指针设置给conn,就相当于把conn挂到了eventloop,就挂到了线程上
    std::vector<EventLoop *> _loops;
    // 管理从属线程
    std::vector<LoopThread *> _threads;
public:
    LoopThreadPool(EventLoop *baseloop) : _thread_count(0), _next_loop_idx(0), _baseloop(baseloop)
    {
    }
    // 设置线程数量
    void SetThreadPoolCount(int count)
    {
        _thread_count = count;
    }
    // 创建、启动所有从属线程
    void Create()
    {
        if (_thread_count > 0)
        {
            _threads.resize(_thread_count);
            _loops.resize(_thread_count);
            // 创建LoopThread
            for (int i = 0; i < _thread_count; i++)
            {
                _threads[i] = new LoopThread();     // 创建LoopThread,就创建了子线程+对应的eventloop,并启动
                _loops[i] = _threads[i]->GetLoop(); // 获取子线程的 eventloop指针,实例化eventloop完成才会返回
            }
        }
    }
    // 获取下一个EventLoop,用来轮转分配
    EventLoop *NextLoop()
    {
        if (_thread_count == 0)
        {
            return _baseloop; // 从属线程为0,直接返回主线程
        }
        _next_loop_idx = (_next_loop_idx + 1) % _thread_count;
        return _loops[_next_loop_idx];
    }
};
cpp
Connection(uint64_t conn_id, int sockfd, EventLoop *loop)
     : _conn_id(conn_id), _sockfd(sockfd), _enable_inactive_release(false), _loop(loop),
       _statu(CONNECTING), _socket(_sockfd), _channel(_sockfd, _loop)
{
     //...
}
void Established() // 连接建立就绪后,进行channel回调设置,启动读监控,调用_connected_callback
{
    _loop->RunInLoop(std::bind(&Connection::EstablishedInLoop, this));
}
给新连接conn分配eventloop之后,conn可以调用 EstablishedInLoop(),进而将自己加入到对应子线程中,进行事件监控
TcpServer模块
把 主线程EventLoop(每一个线程内部都要属于自己的epoll)、监听套接字Acceptor、连接池ThreadPool、各类回调 全部整合在一起,对外暴露极简的启动 / 停止接口,上层业务不用关心底层 IO、线程、监听细节。
管理:
- 1.Acceptor对象,封装监听套接字,读事件就绪的阶段处理回调函数 NewConnection()传入,监听事件 Channel 加入到当前主线程 EventLoop 的 Poller 进行事件监控
- 2.主EventLoop对象,主线程主Reactor,_baseloop实现对监听套接字的事件监控
- 3.一旦有新连接,为它创建Conn,也就是监听套接字的回调函数NeConnection()的逻辑,再管理所有连接,服务器层面上的管理,连接要释放,首先要调用连接自己的销毁函数,其次调用服务器层面的函数,将它从tcpserver类中移除
- 4.LoopThreadPool对象,创建线程池,将新连接挂到从属线程,进行事件监听和处理
功能:
- 1.设置从属线程池数量
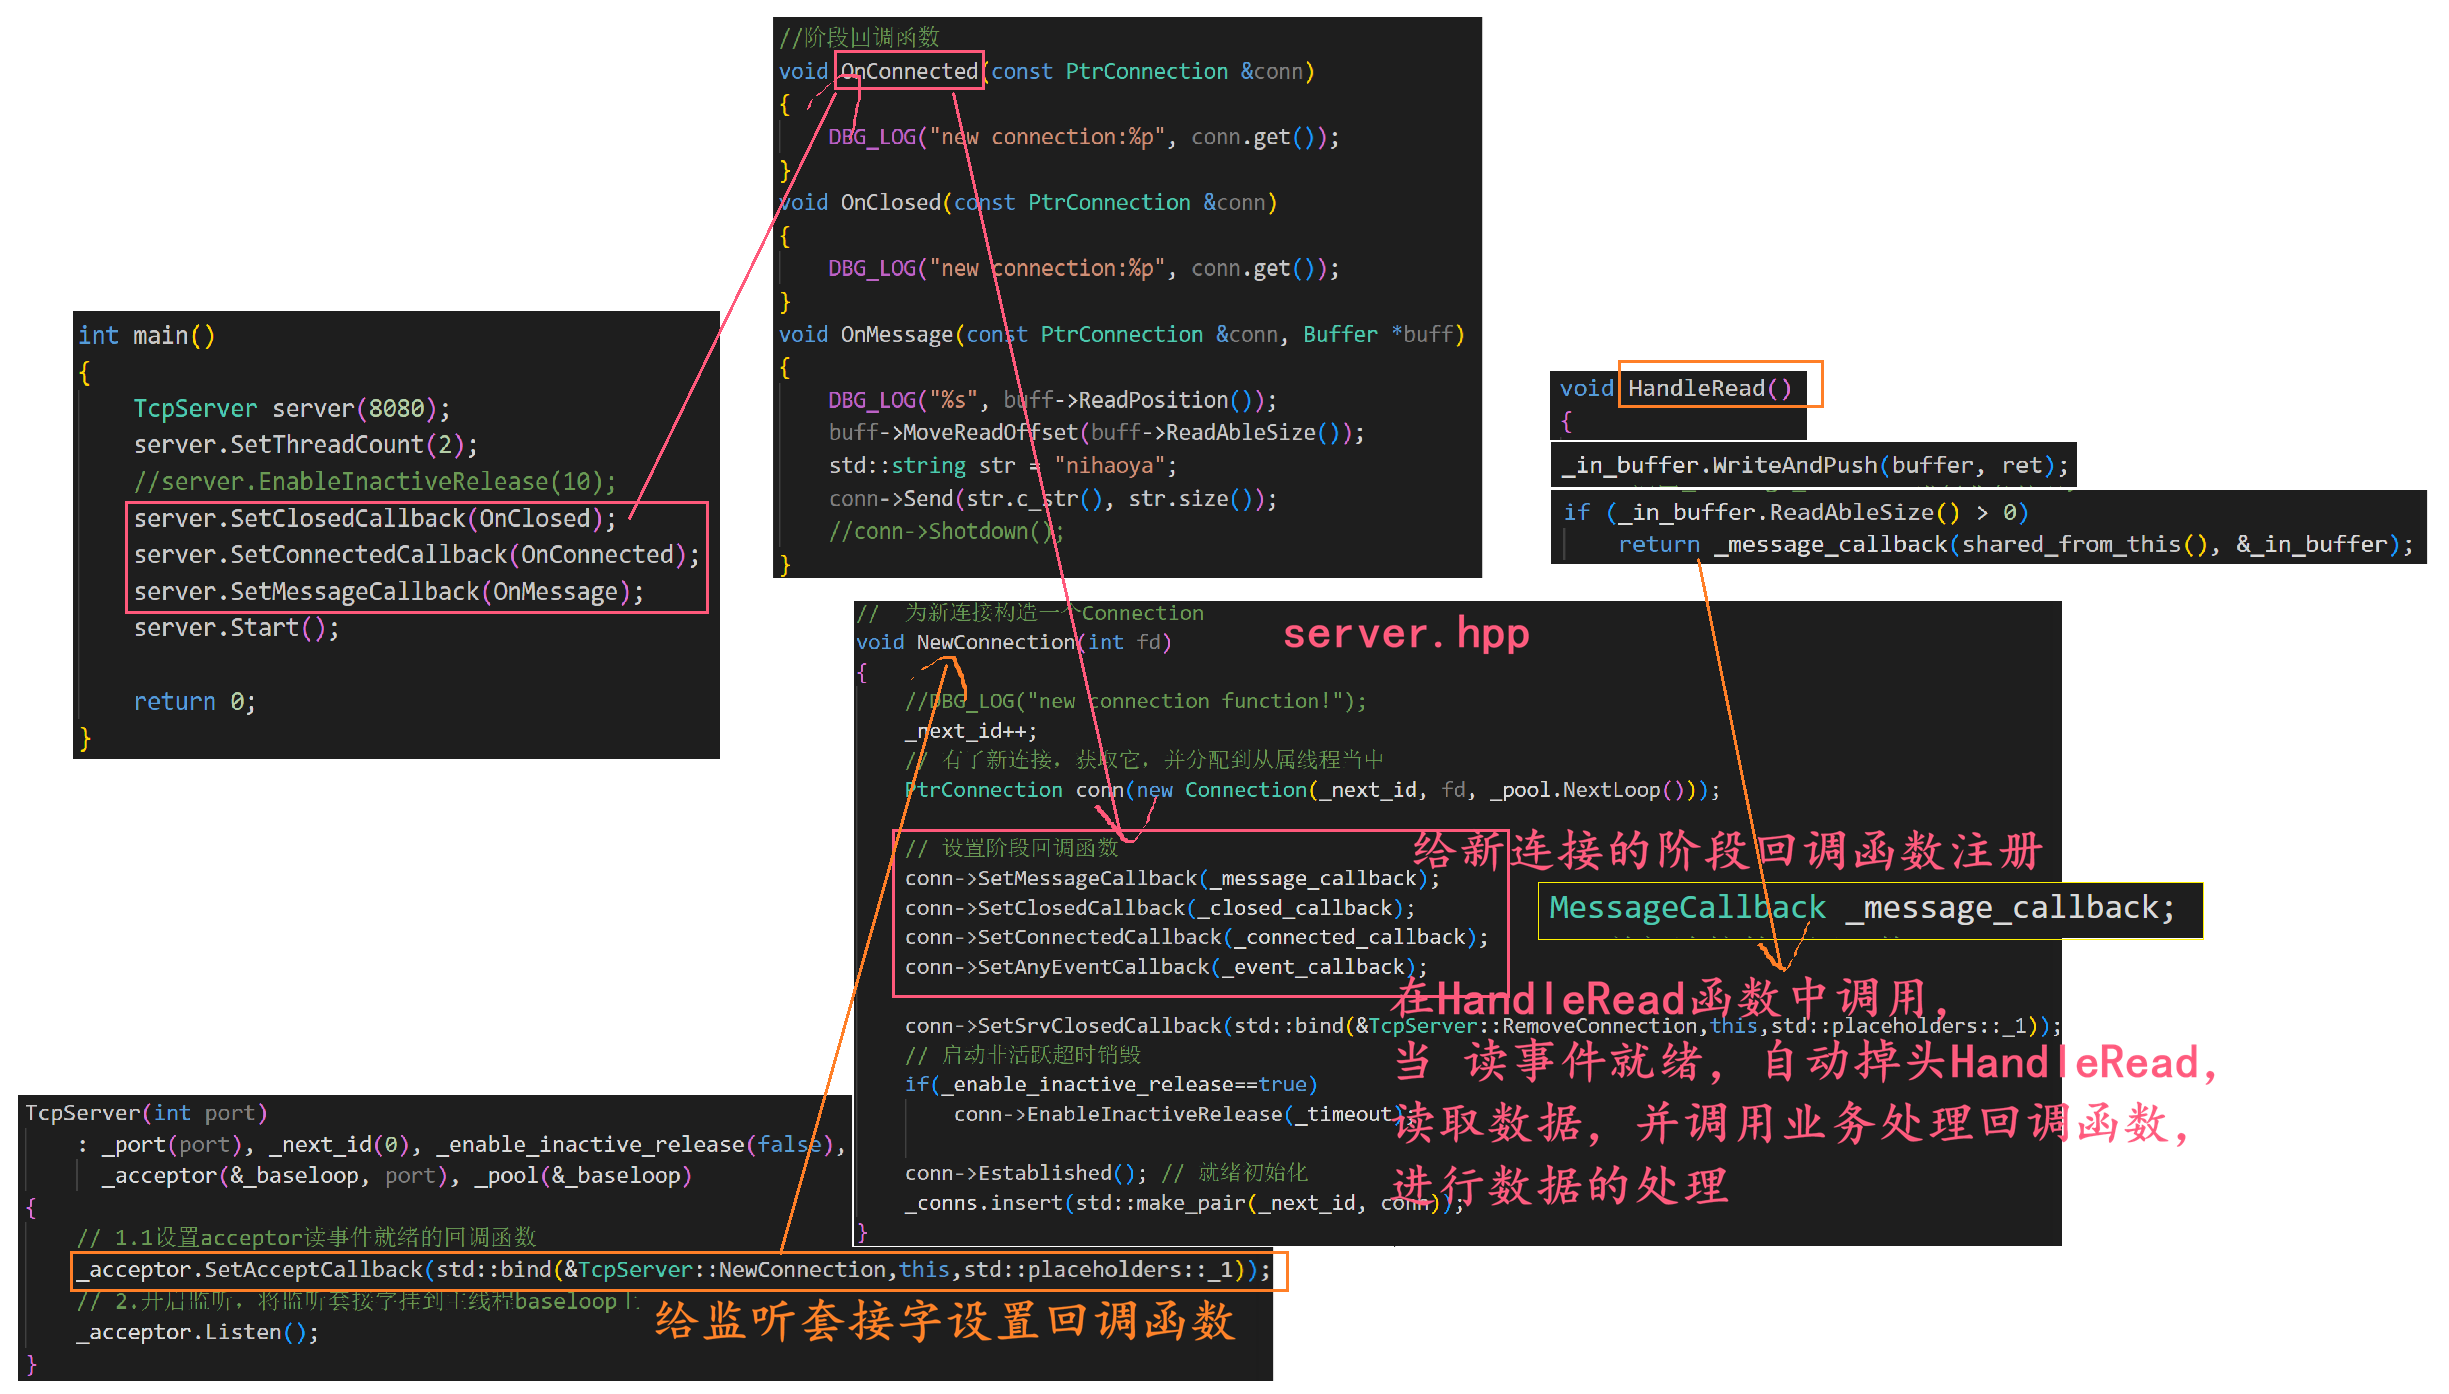
- 2.设置新连接connection建立的阶段回调函数,比如 连接建立回调OnConnected,收到消息进行业务处理回调OnMessage...,提供Connection中Channel的HandlerRead()的部分逻辑,这样一旦事件就绪,1.调用HandlerRead()读取数据到Buffer,2.再进行业务处理OnMessage()****_channel.SetReadCallback(std::bind(&Connection::HandleRead, this));
- 3.是否启动非活跃连接超时销毁功能
- 4.启动服务器
- 5.添加定时任务的功能
流程:
- 1.在TcpServer中实例化一个Acceptor对象,一个EventLoop对象--bashloop
- 2.将Acceptor挂到baseloop上进行事件监控
- 3.一旦Acceptor就绪了可读事件,执行读事件回调函数,获取新连接
- 4.对新连接创建Connection,并进行管理
- 5.对连接Connection设置功能回调--连接建立完成回调,收到消息回调,关闭回调,任意事件回调
- 6.启动Connection的非活跃连接超时销毁功能
- 7.将新连接对应的Connection挂到LoopThreadPool的从属线程的EventLoop中,进行事件监控
- 8.一旦Connection连接可读事件就绪,执行读事件回调函数,读取数据,之后TcpServer设置的消息回调函数--进行业务处理
cpp
class TcpServer
{
private:
    // id,自动增长
    uint64_t _next_id;
    // 服务器要监听的端口
    int _port;
    // 非活跃连接的统计时间,多长时间无通信就是非活跃连接
    int _timeout;
    // 是否启动非活跃超时销毁的功能
    bool _enable_inactive_release;
    // 主线程的EventLoop对象,负责监听事件的处理
    EventLoop _baseloop;
    // 监听套接字的管理对象
    Acceptor _acceptor;

    // 从属EventLoop线程池,把获取的新连接 交给从属的eventloop
    LoopThreadPool _pool;
    // 所有连接的管理,为了便于查找,用unordered_map
    // 保存shared_ptr,一旦删除,才表明,这个连接要释放
    std::unordered_map<uint64_t, PtrConnection> _conns;

private:
    // Connection需要的回调
    using ConnectedCallback = std::function<void(const PtrConnection &)>;
    using MessageCallback = std::function<void(const PtrConnection &, Buffer *)>;
    using ClosedCallback = std::function<void(const PtrConnection &)>;
    using AnyEventCallback = std::function<void(const PtrConnection &)>;

    using Functor =std::function<void()>;

    ConnectedCallback _connected_callback;
    MessageCallback _message_callback;
    ClosedCallback _closed_callback;
    AnyEventCallback _event_callback;

private:
    // 辅助功能
    //  为新连接构造一个Connection
    void NewConnection(int fd)
    {
        //DBG_LOG("new connection function!");
        _next_id++;
        // 有了新连接,获取它,并分配到从属线程当中
        PtrConnection conn(new Connection(_next_id, fd, _pool.NextLoop()));

        // 设置阶段回调函数
        conn->SetMessageCallback(_message_callback);
        conn->SetClosedCallback(_closed_callback);
        conn->SetConnectedCallback(_connected_callback);
        conn->SetAnyEventCallback(_event_callback);

        conn->SetSrvClosedCallback(std::bind(&TcpServer::RemoveConnection,this,std::placeholders::_1));
        // 启动非活跃超时销毁
        if(_enable_inactive_release==true)
            conn->EnableInactiveRelease(_timeout);

        conn->Established(); // 就绪初始化
        _conns.insert(std::make_pair(_next_id, conn));
    }
    // 从管理的_conn里移除Connection连接,才能真正释放连接
    // SetSrvCallback() 把服务器内部管理的Connection信息移除,连接最终被释放
    void RemoveConnection(const PtrConnection& conn)
    {
        _baseloop.RunInLoop(std::bind(&TcpServer::RemoveConnectionInLoop,this,conn));
    }

    // 添加定时任务功能
    void RunAfterInLoop(const Functor &task, int delay)
    {
        _next_id++;
        _baseloop.TimerAdd(_next_id, delay, task);
    }
    void RemoveConnectionInLoop(PtrConnection& conn)
    {
        int id=conn->GetId();
        auto it=_conns.find(id);
        if(it!=_conns.end())
            _conns.erase(it);
    }

public:
    TcpServer(int port)
        : _port(port), _next_id(0), _enable_inactive_release(false),
          _acceptor(&_baseloop, port), _pool(&_baseloop)
    {
        // 1.1设置acceptor读事件就绪的回调函数
        _acceptor.SetAcceptCallback(std::bind(&TcpServer::NewConnection,this,std::placeholders::_1));
        // 2.开启监听,将监听套接字挂到主线程baseloop上
        _acceptor.Listen();
    }
    void SetThreadCount(int count)
    {
        return _pool.SetThreadPoolCount(count);
    }
    void Start()
    {
        // 1.创建线程池的从属线程,之前要设置线程数量
        _pool.Create();
        // 3.主线程eventloop启动,开始监听 客户端的新连接
        _baseloop.Start(); // 死循环
        return;
    }
    // 添加定时任务功能
    void RunAfter(const Functor &task, int delay)
    {
        _baseloop.RunInLoop(std::bind(&TcpServer::RunAfterInLoop, this, task, delay));
    }

    void SetConnectedCallback(const ConnectedCallback &cb) { _connected_callback = cb; }
    void SetMessageCallback(const MessageCallback &cb) { _message_callback = cb; }
    void SetClosedCallback(const ClosedCallback &cb) { _closed_callback = cb; }
    void SetAnyEventCallback(const AnyEventCallback &cb) { _event_callback = cb; }

    // 非活跃连接的超时销毁功能
    void EnableInactiveRelease(int timeout)
    {
        _timeout = timeout;
        _enable_inactive_release = true;
    }
};
EchoServer,对tcpserver的进一步封装
cpp
class EchoServer
{
private:
    TcpServer _server;
private:
    // 给server设置的阶段回调函数
    //...
public:
    EchoServer(int port) : _server(port)
    {
        _server.SetThreadCount(2);
        _server.EnableInactiveRelease(10);
        _server.SetClosedCallback(std::bind(&EchoServer::OnClosed,this,std::placeholders::_1));
        _server.SetConnectedCallback(std::bind(&EchoServer::OnConnected,this,std::placeholders::_1));
        _server.SetMessageCallback(std::bind(&EchoServer::OnMessage,this,std::placeholders::_1,std::placeholders::_2));
        _server.Start();
    }
    void Start()
    {
        _server.Start();
    }
};
这样直接初始化echoserver,并start就能运行回显服务器了
cpp
EchoServer server(8080);
server.Start();
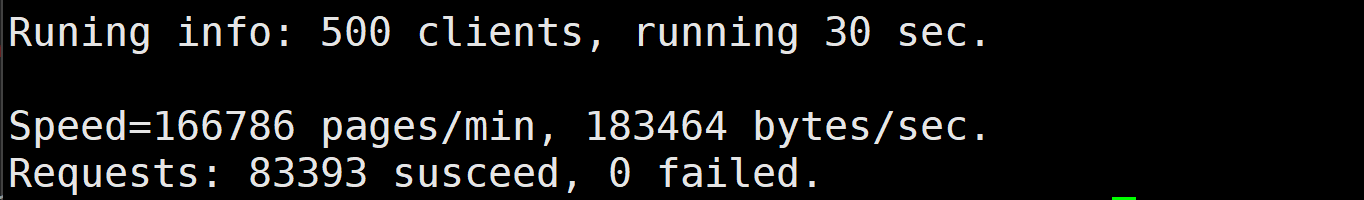
测试
工具类的实现
知识点:Http的请求格式
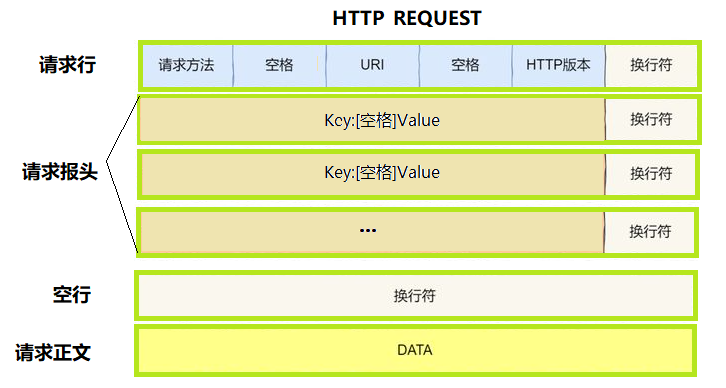
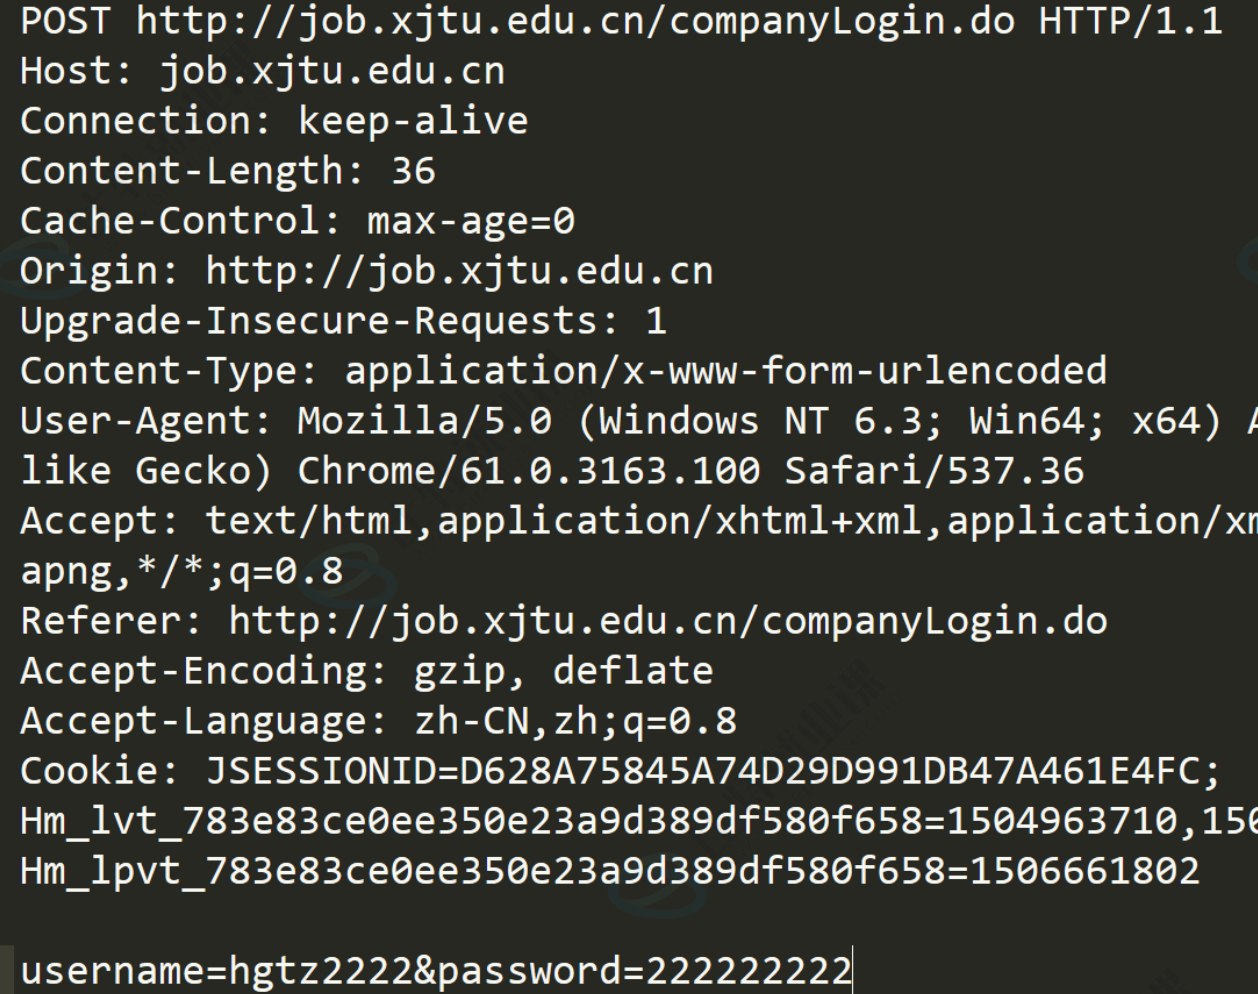
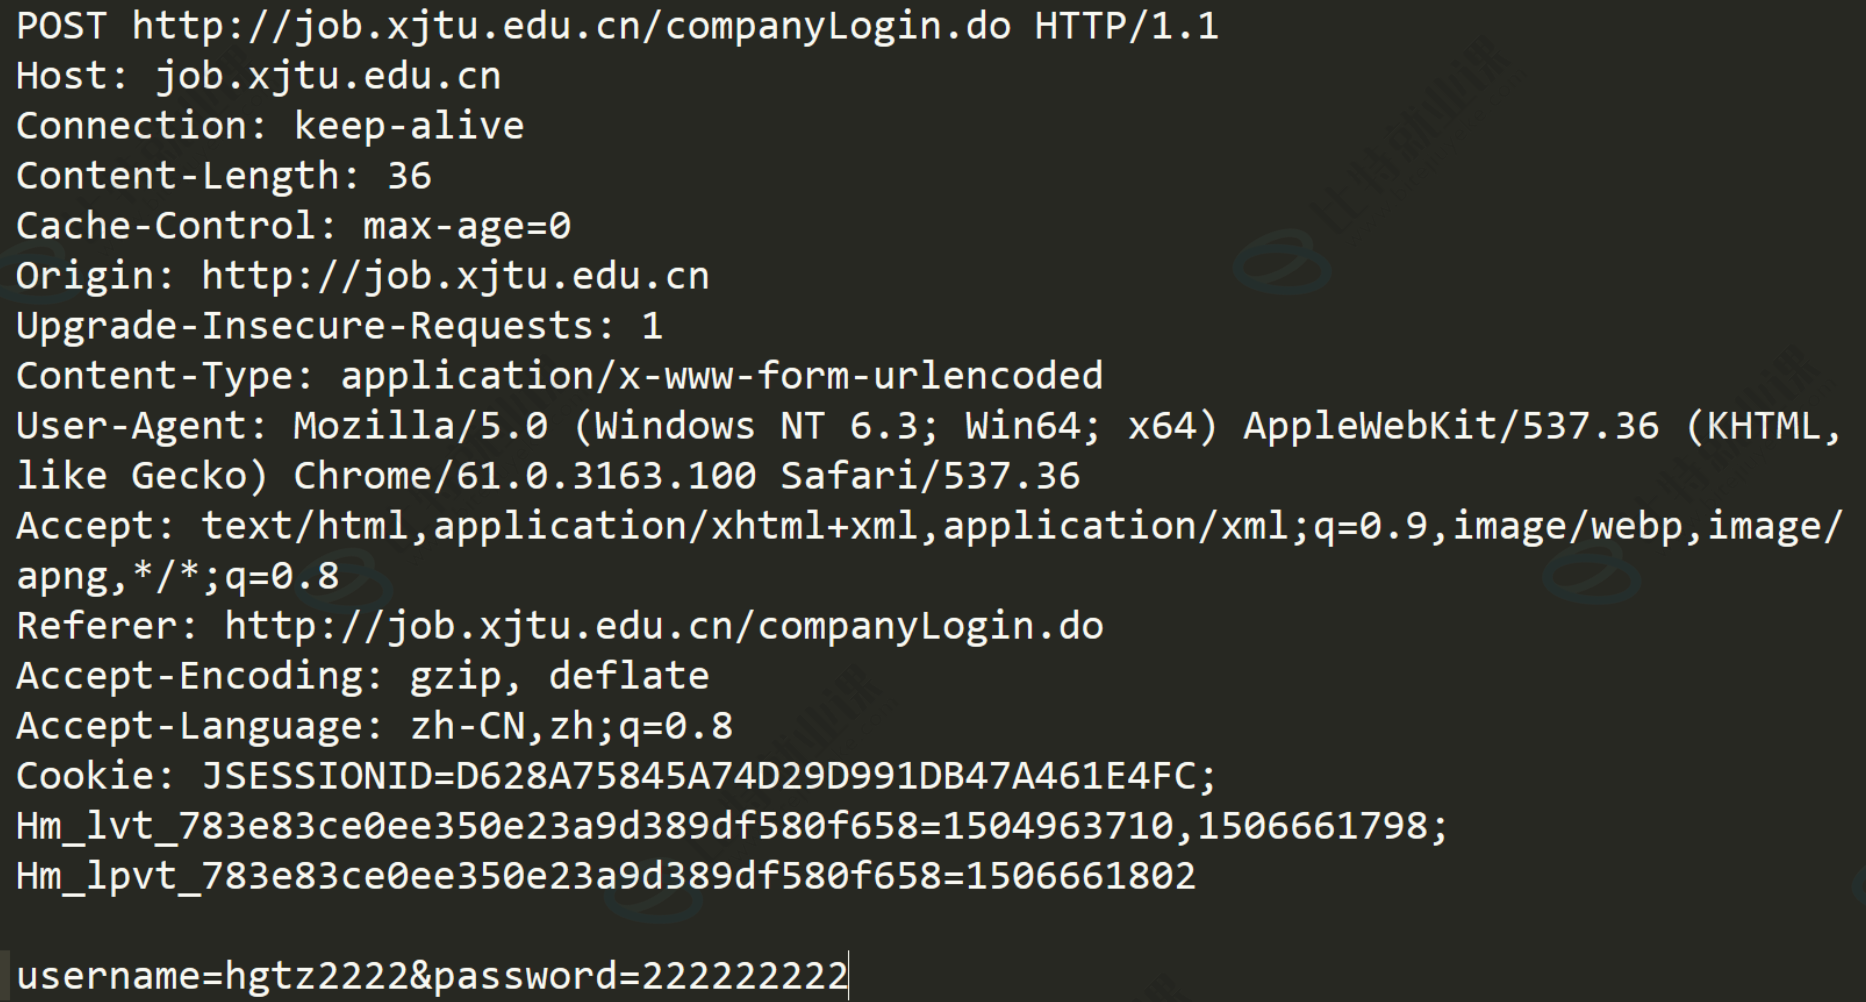
1.请求行,格式:请求方法 URL HTTP版本 \r\n,比如 GET /index.html HTTP/1.1,各部分含义:请求方法:告诉服务器你想怎么做,是GET,获取资源,还是POST,提交数据,比如登陆。URL:想访问服务器上的哪个资源,路径,以及传递参数。
2.请求报头,每一行都是,键:空格 值\r\n。比如Content-Length: 10,如果有请求正文,告诉服务器正文有多少字节,告诉服务器一堆额外描述,比如客户端信息等
3.请求正文,要发给服务器的业务数据,不是所有请求都有,比如POST,表单的数据放在请求正文中,GET,可以没有请求正文,查询的参数放在URI里
URL:

原始的字符串是 q=苹果&香蕉,也就是提交的 查询参数是苹果&香蕉,直接拼接URI,
/search?msg=苹果&香蕉
拿这个举例,
解析规则:&是参数之间的分隔标记,
先用&把多个参数分离,得到多个小段 msg=苹果 香蕉
再对每一小段,用 = 分割成 参数名=参数值
msg=苹果→ key=msg,value=苹果香蕉→ 里面没有=,key=香蕉,value = 空字符串所以要采取URI编码,把数据里的&,编码成%26,编码的完整URL为:/search?msg=苹果%26香蕉,
问号后内容:
msg=苹果%26香蕉
- 字符串里没有普通
&,不会切割成两段- 整段拆分:
msg=苹果%26香蕉- 服务器拿到值后自动解码,
%26还原回&最终得到你想要的完整:msg的值 =苹果&香蕉某些字符不能随意出现,因为已经被 url 当做特殊意义理解了,
- RFC 3986标准,不编码特殊字符有:. - _ ~ 以及字母和数字
- W3C 标准,查询字符串中的空格,比如msg=苹果 香蕉,需要编码成+
编码规则:将特殊字符的ascii值,转换为两个16进制字符,并且加一个前缀%
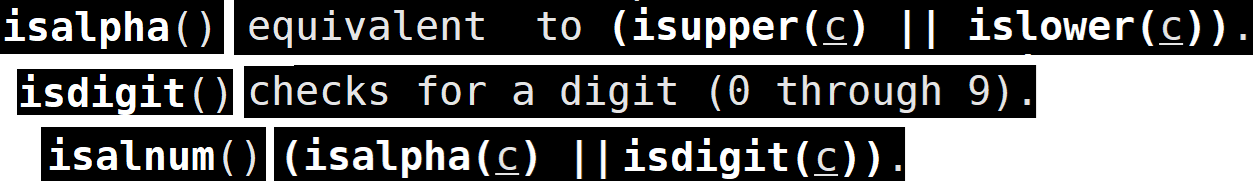
URL编码
cpp
static std::string UrlEncode(const std::string url,bool convert_space_to_plus)
    {
        std::string res;
        for(auto& c:url)
        {
            if(c=='.'||c=='-'||c=='_'||c=='~')
            {
                //不用编码的字符
                res+=c;
                continue;
            }
            if(c==' '&&convert_space_to_plus==true)
            {
                res+='+';
                continue;
            }
            //数字和字母不需要转换
            if(isalnum(c))
            {
                res+=c;
                continue;
            }
            //剩下的字符都需要编码,%HH,比如不是W3C标准的空格
            char tmp[4]={0};
            //%%,第一个%为转义字符,输出一个%
            //%X,把数字输出为大写的16进制
            snprintf(tmp,4,"%%%02X",c);
            res+=tmp;
        }
        return res;
    }
URL解码
cpp
// 把十六进制的的字符,翻译成对应的整数数值,数字0-15
    char HEXTOI(char c)
    {
        if(c >= '0' && c <= '9')
        {
            //数字字符
            return c-'0';
        }
        else if(c >= 'a' && c <= 'z')
        {
            //小写字符
            return c-'a'+ 10;
        }
        else if(c >= 'A' && c <= 'Z')
        {
            return c-'A'+ 10;//B--11
        }
        else
        {
            //有问题
            return -1;
        }
    }
    static std::string UrlDecode(std::string url , bool convert_plus_to_space)
    {
        // %2B
        // 遇到%,将紧随其后的两个字符转换为两个数字,第一个数字*16,+第二个数字,就是这个字符的ascii
        std::string res;
        for(int i=0;i<url.size();i++)
        {
            if(url[i]=='+'&& convert_plus_to_space==true)
            {//加号+ 转成空格
                res+=' ';
                continue;
            }
            if(url[i]=='%' && i+2 < url.size())
            {
                char v1=HEXTOI(url[i+1]); // 第一个数字
                char v2=HEXTOI(url[i+2]);
                // 字符底层存储的是数字
                char val= (v1 * 16) + v2;
                res+=val;
                i+=2;
                continue;
            }
            res+=url[i];
        }
        return res;
    }
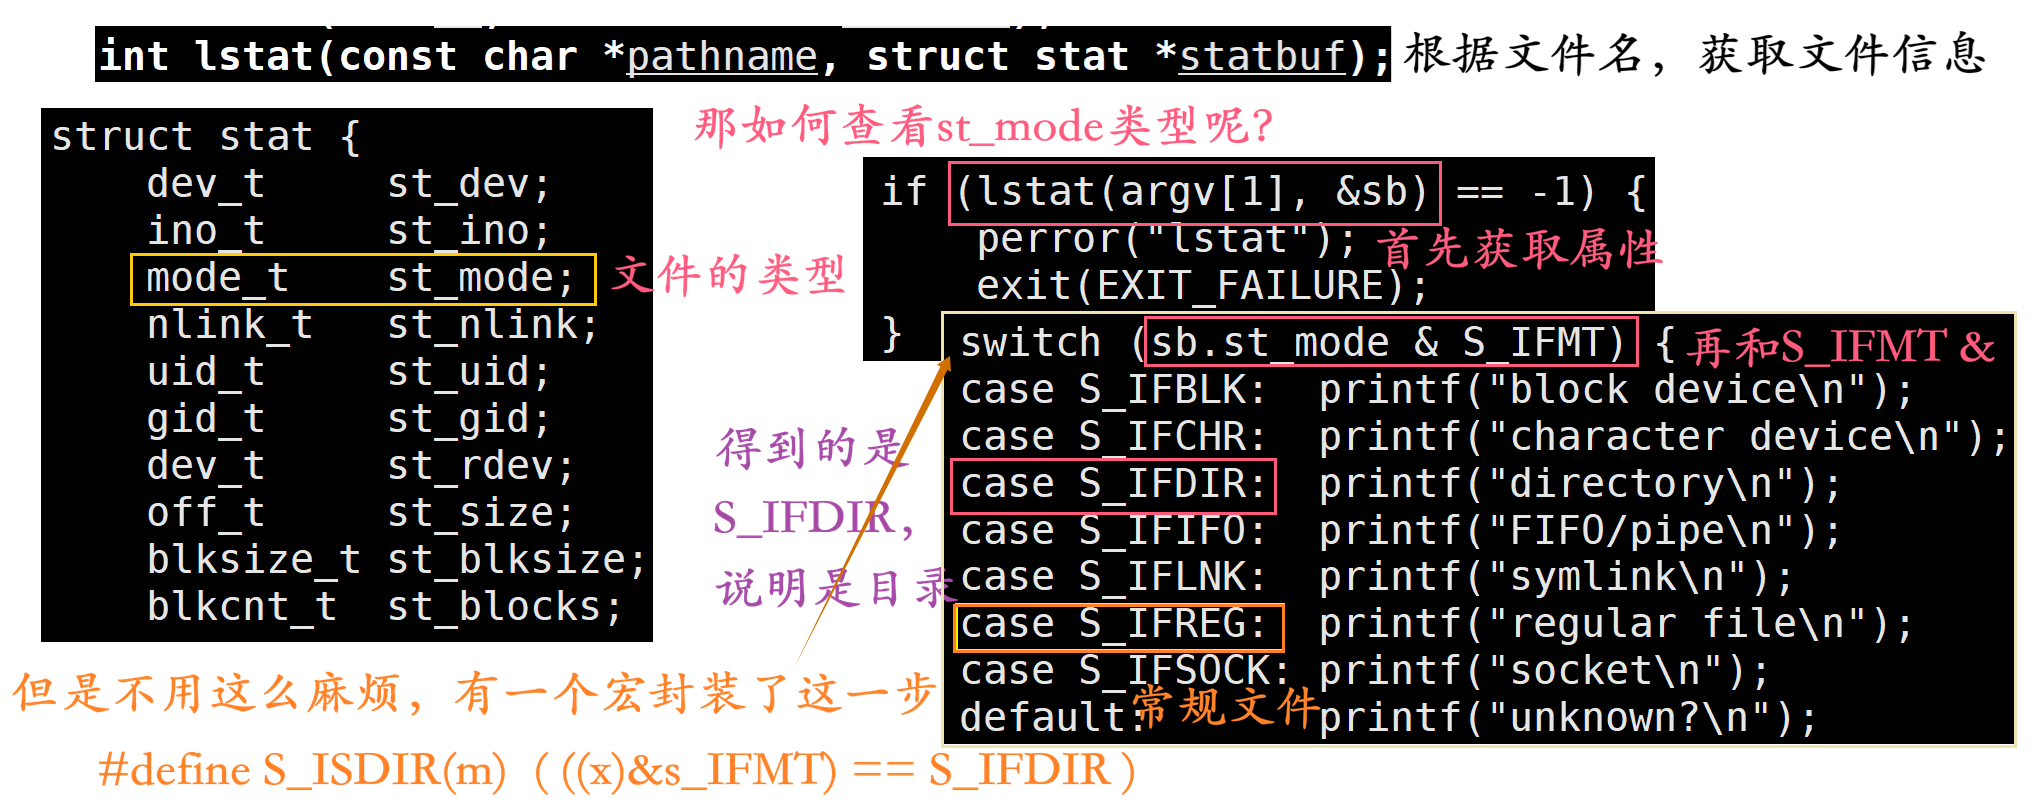
通过文件名判断这个文件是否是目录
HTTP服务器
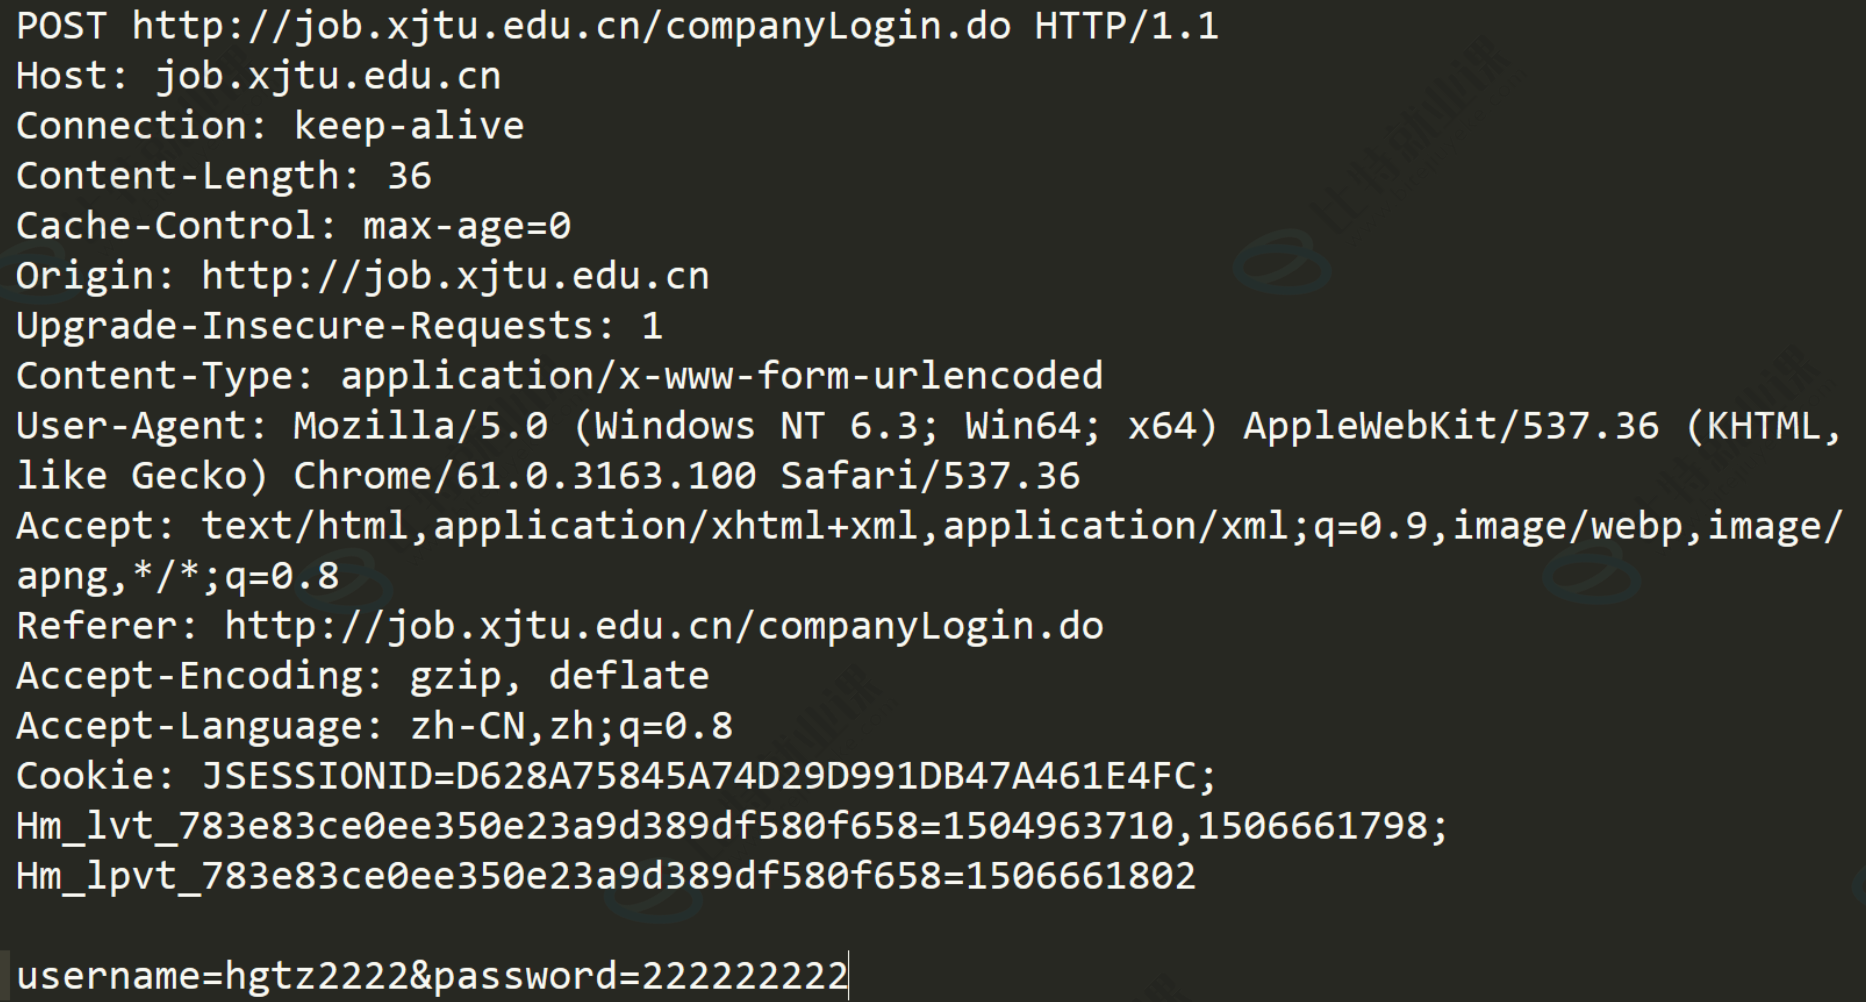
HttpRequest模块,存储HTTP请求信息要素,包括
- 请求行:请求方法,URL,协议版本
URL又包括:资源路径,查询字符串 GET /search?word=C++&en=uft8 HTTP/1.1
- 请求报头: key:value\r\nkey:value\r\n... Content-Length:0\r\n
- 请求正文
要素:请求方法,资源路径,协议版本,查询字符串,请求报头,正文,正则表达式帮助提取
**URI 比如,**https://leetcode.cn//?envType=study-plan-v2\&envId=top-100
接口:
1.提供查询字符串的功能,比如能解析 URL 里 ? 后面的键值、拿到参数、根据参数返回不同内容 GET /search?word=C++
- 解析 URI,区分路径和
?后的查询字符串;- 分割
&、=,提取所有键值对;- 支持 URL 解码(
%2B→+);- 业务代码可以读取参数,动态生成不同响应。
2.请求报头里有多个key,value,要实现一套管理请求报头的方法,包括单个查询、获取,插入功能
3.获取正文长度Content-Length
4.判断长连接还是短连接Connection:close / keep-alive
知识点:正则表达式,是一套字符串匹配规则,用来快速查找,提取,校验字符串
std::regex_match函数,判断整个字符串是否完全匹配 正则规则
bool regex_match( 待匹配字符串, 正则表达式 );从头到尾整串必须完全匹配
std::regex_match ("subject", std::regex("(sub)(.*)") ). :匹配任意单个字符,但不能匹配
\r、\n换行 / 回车符* :前面的字符出现0次或无数次
+:前面字符出现一次或多次。 意思就是,整个字符串必须 以sub开头,后面可以跟任意字符(包括啥也不跟)
():功能1,分组,把括号内的内容看成一个整体,用来限定量词(
*/+/?/{})的作用范围。
ab+:a固定,b重复 1 次及以上 → 匹配ab、abb、abbb(ab)+:把ab当成整体重复 → 匹配ab、abab、ababab():功能2,捕获分组,()会把匹配到的内容单独存放起来,后续可以按编号取出
例子1
- std::string s = "subject";
- std::regex reg("(sub)(.*)");
- std::smatch res;
- regex_match(s, res, reg)
//res0固定代表整个完整匹配的字符串subject res1表示第一个()捕获的内容sub res2表示第二个()捕获的内容ject
bool std::regex_match(const std::string& src,std::smatch& matches,std::regex& e)
src原始字符串;matches存放符合规则的提取的数据;类似数组 e正则表达式的匹配规则;返回值用于确定匹配是否成功
例子2
- std::string str="/numbers/1234";
- std::regex e("/numbers/(\\d+)");
- std::smatch res;
- std::regex_match(str,res,e);//res0=/numbers/ res1=1234
\d匹配单个数字,+表示前面的\d数字至少出现1次,单个\是转义字符,要想写出\d字面量,必须再在前面加上一个\,\\d,然后()来捕获 匹配的一串连续数字
\[\]:表示匹配在\[\]里的任意字符,abc匹配a或b或c,单个字符匹配
^:两种含义,在\[\]里,\^表示取反\^abc匹配非a/b/c的字符
不在\[\]里,^是字符串的开头锚点,^/numbers/,表示匹配的字符串必须以/numbers/开头,比如/numbers/abc
?:两种含义,表示前面 字符/分组 出现了0次或者1次,字面量?,想匹配真实?,必须\?
例子1
- 字符串:/user/1001/?name=tom
- 正则:^(\^?+)(\?(.*))?$
^:从字符串开头开始匹配
(\^?+):分组 1,匹配所有不是?的字符 → 拿到路径
/user/1001\?:转义,匹配字面问号
(.*):分组 3,问号后面所有内容 → 查询串
name=tom?&:分组后面的?→
(\?(.*))?,整个?xxx这一整段,要么出现 1 次,要么完全没有
正则默认就是 从左到右、逐个字符依次匹配
cpp
int main()
{
    //HTTP请求格式:请求方法GET  URL资源 /bit/login?user=sxm&password=123123  协议版本HTTP/1.1\r\n
    std::string str="GET /bit/login?user=sxm&password=123123 HTTP/1.1";
    std::smatch res;
    //1.请求方法的匹配 GET POST ...
    //第一个正则
    std::regex e("(GET|POST|HEAD|PUT|DELETE) .*");
    bool ret=std::regex_match(str,res,e);
    if(ret==false) return -1;

    //2.请求方法后面以空格开始,直到?作为结束的字符串,提取URL中的资源路径
    // [^?]*,[^?]表示匹配非问好字符,*表示0次或多次,从当前位置开始,连续匹配所有非?字符,直到碰到?为止
    // .*匹配任意单个字符,0个或多个,也就是往后所有剩余字符
    //第二个正则
    std::smatch res1;
    std::regex e1("(GET|POST|HEAD|PUT|DELETE) ([^?]*).*");
    bool ret1=std::regex_match(str,res1,e1);
    if(ret1==false) return -1;

    //3.提取URL中的查询字符串,?开始,空格结束
    // \\?表示原始的?,(.*)表示提取?之后的任意字符0或多次,直到遇到 空格
    std::smatch res2;
    std::regex e2("(GET|POST|HEAD|PUT|DELETE) ([^?]*)\\?(.*) .*");
    bool ret2=std::regex_match(str,res2,e2);
    if(ret2==false) return -1;

    //4.提取协议版本
    // \\.表示原始的.,[01]表示匹配任意一个字符 0或1
    std::smatch res3;
    std::regex e3("(GET|POST|HEAD|PUT|DELETE) ([^?]*)\\?(.*) (HTTP/1\\.[01])");
    bool ret3=std::regex_match(str,res3,e3);
    if(ret3==false) return -1;
    for(auto& s:res3)
    {
        std::cout<<s<<std::endl;
    }

    return 0;
}
问题1. .匹配不了\r\n
- std::string str="GET /bit/login?user=sxm&password=123123 HTTP/1.1\r\n";
- // \\.表示原始的.,01表示匹配任意一个字符 0或1,\r\n可以有或者没有
- // (?:\n|\r\n)? ,(?:...)表示,匹配某个格式字符串,单数不提取 最后的问好,表示匹配0次或者1次,可能有也可能没有
- std::smatch res3;
- std::regex e3("(GET|POST|HEAD|PUT|DELETE) (\^?*)\\?(.*) (HTTP/1\\.01)(?:\n|\r\n)?");
- bool ret3=std::regex_match(str,res3,e3);
问题2:而且可能没有查询字符串,那这时候就要 在\\?(.*) 整体后面加?
- std::string str="GET /bit/login HTTP/1.1\r\n";
- std::regex e3("(GET|POST|HEAD|PUT|DELETE) (\^?*)(\\?(.*))? (HTTP/1\\.01)(?:\n|\r\n)?");
- 接着加 ?:,表示不要以?开头的字符串,要(.*)的字符串,外层不捕获,内层捕获
- 2. std::regex e3("(GET|POST|HEAD|PUT|DELETE) (\^?*)(?:\\?(.*))? (HTTP/1\\.01)(?:\n|\r\n)?");
回归HttpRequest模块
HttpRequest 还需要添加一个要素,std::smatch 正则表达式,来保存提取的请求行的信息
cpp
class HttpRequest
{
public:
    std::string _method;//请求方法
    std::string _path;//资源路径
    std::string _version;//协议版本
    std::string _body;//正文
    std::unordered_map<std::string,std::string> _headers;//请求报头的key-value
    std::unordered_map<std::string,std::string> _params;//url 查询字符串
    std::smatch _matches;//存放资源路径url的数据
public:
    //设置\插入 头部字段
    void SetHeader(const std::string& key,const std::string val);
    //查询,是否有 头部字段
    bool HasHeader(const std::string& key);
    //获取 头部字段
    std::string GetHeader(const std::string& key);
    //设置、插入 查询字符串
    void SetParam(const std::string& key,const std::string val);
    //查询 查询字符串
    bool HasParam(const std::string& key);
    //获取 查询字符串
    std::string GetParam(const std::string& key);
    //获取正文长度
    size_t ContentLength();
    //判断是长连接还是短连接
    bool Close();
    //重置 请求
    void ReSet();
};
HttpResponse模块,存储Http相应信息要素
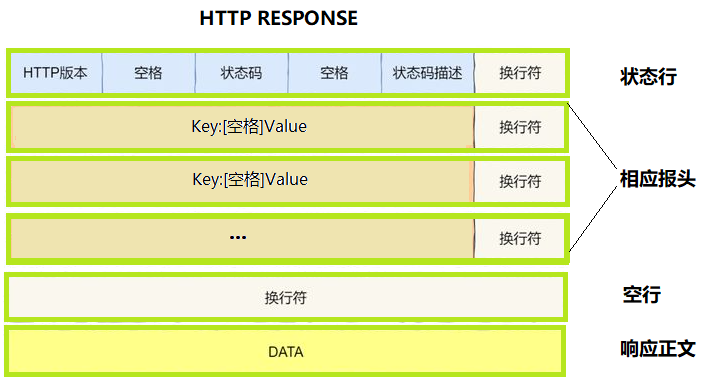
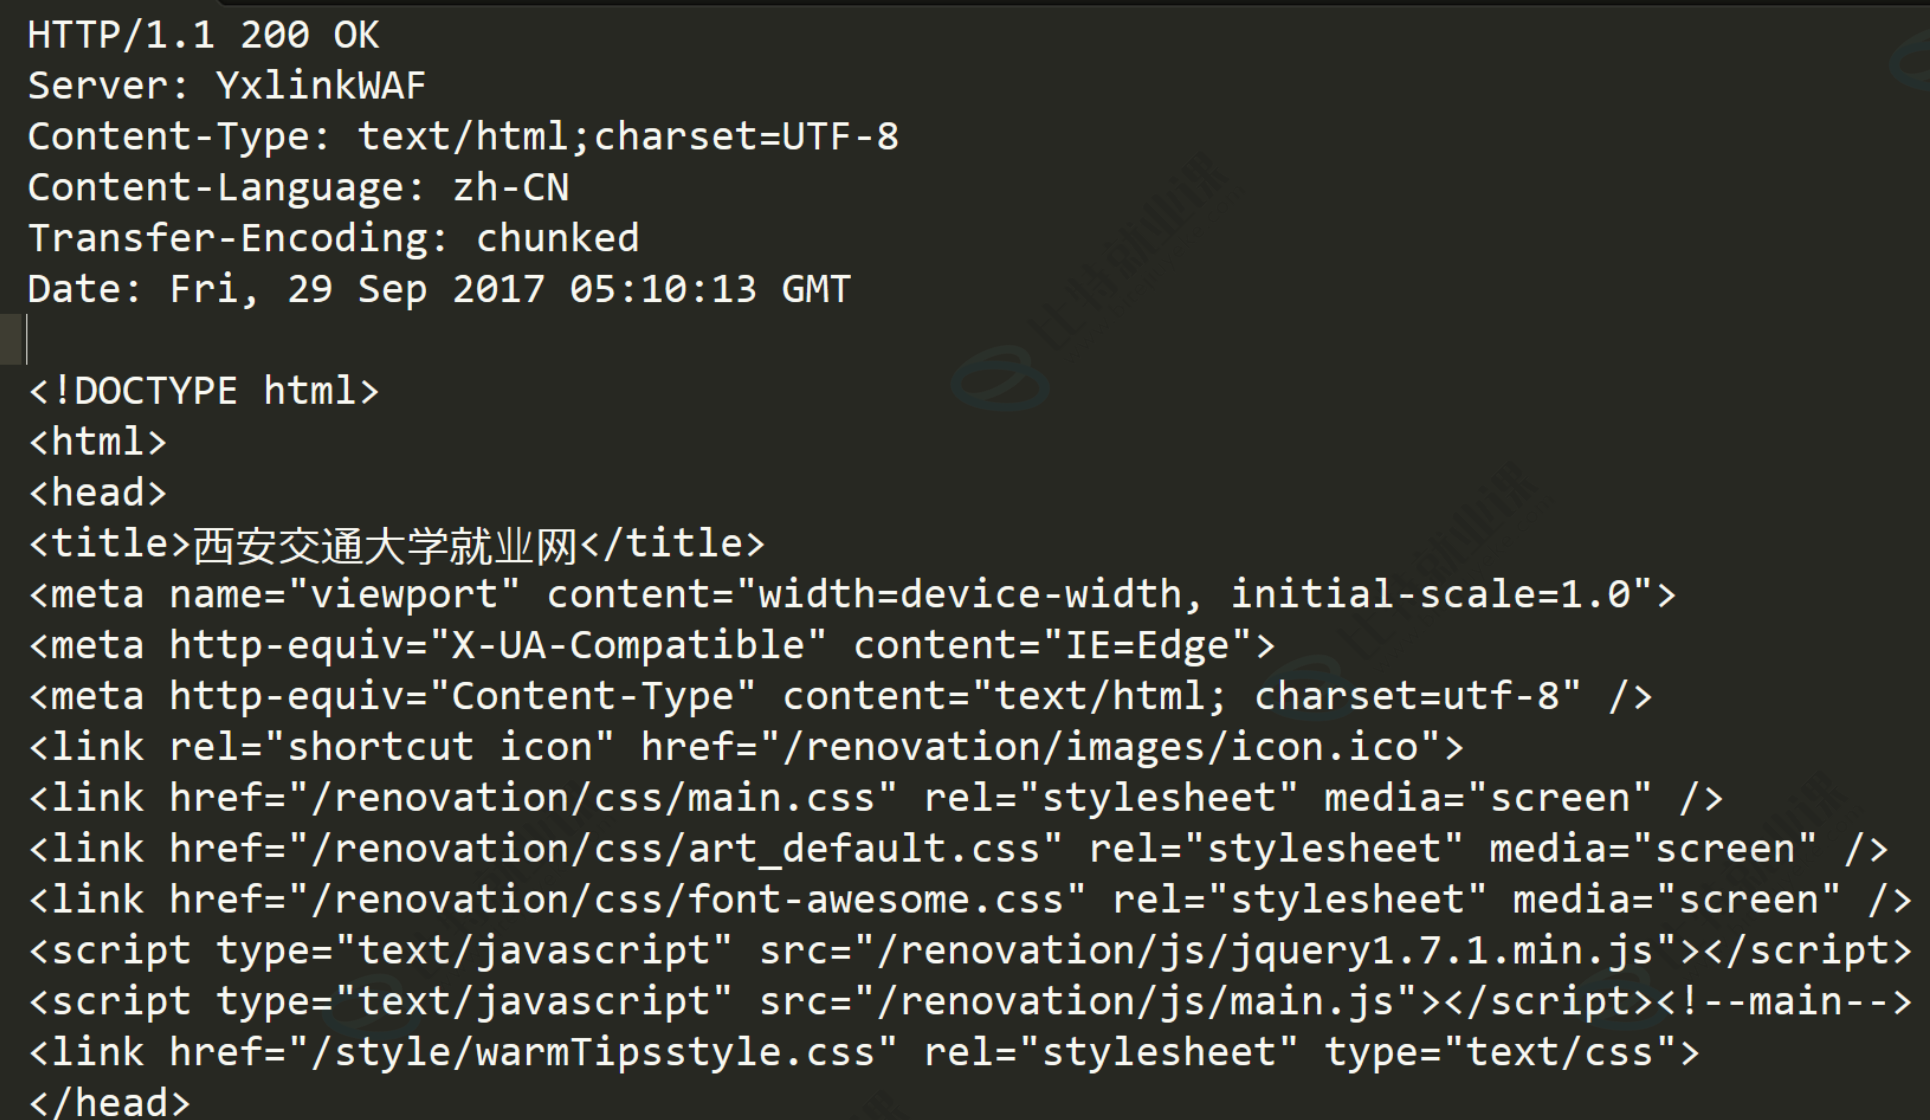
要素:响应状态码,请求报头字段,相应正文,重定向信息:是否进行了重定向的标准,以及重定向的路径
接口:
1.头部字段的新增、查询、获取
2.正文的设置
3.长短连接的判断
cpp
class HttpResponse
{
public:
    int _statu;//响应状态码
    std::unordered_map<std::string,std::string> _headers;//头部字段
    std::string _body;//相应正文
    bool _redirect;//重定向标志,响应里是否设置了重定向
    std::string _redirect_url;//重定向的url
public:
    HttpResponse():_statu(200),_redirect(false)
    {}
    HttpResponse(int statu):_statu(statu),_redirect(false)
    {}
    //头部字段的插入
    void SetHeader(const std::string& key,const std::string& val);
    //是否包含某个头部字段
    bool HasHeader(const std::string& key);
    //获取某个头部字段
    std::string GetHeader(const std::string& key);
    //正文设置,同时设置正文类型Content-Type
    void SetContent(const std::string& body,const std::string& type="text/html");
    //设置重定向
    void SetRedirect(const std::string& url,int statu=302); _redirect_url=url;
    }
    //长短连接的判断
    bool Close();
    //重置响应
    void Reset();
};
HttpContent模块,用于 提取并解析 一个完整的请求HttpRequest
每个连接配套一套buffer,TCP recv读取到的数据全部放入buffer,缓存不完整的分段数据-TCP分包、粘包,只存放原始的字节流
HttpContent管3件事:记录当前的解析状态(请求行、头部、正文、完成、错误);提供一套解析函数,消耗 buffer 里的数据;把解析成功的数据存放至HttpContent的内部成员request
每个连接配一个Content协议上下文,用于存放这个连接准备发送的但可能还不完整的请求httprequest
cpp
typedef enum
{//将要、正c在
    RECV_HTTP_LINE,//当前接收到 请求行的阶段
    RECV_HTTP_HEAD,//处于 头部接收 阶段
    RECV_HTTP_BODY,// 接收到 正文 的阶段
    RECV_HTTP_OVER,//结束阶段,等待处理请求
    RECV_HTTP_ERROR // 解析完整请求出错了 的阶段
}HttpRecvStatu;
#define MAX_LINE 8192
class HttpContent
{
private:
    int _resp_statu;// 响应状态码
    HttpRecvStatu _recv_statu;//当前接收 处于的阶段
    HttpRequest _request;//已经解析得到的 请求信息
private:
    //...
    // 解析请求行
    bool ParseHttpLine(std::string& line)
    {
        std::smatch matches;
        //"GET /bit/login?user=sxm&password=123123 HTTP/1.1";
        std::regex e("(GET|HEAD|POST|PUT|DELETE) ([^?]*)(?:\\?(.*))? (HTTP/1\\.[01])(?:\n|\r\n)?");
        bool ret=std::regex_match(line,matches,e);
        if(ret==false)
        {
            _recv_statu=RECV_HTTP_ERROR;
            _resp_statu=400;//bad request 解析失败,请求有问题
            return false;
        }
        //0 : GET /bit/login?user=sxm&password=123123 HTTP/1.1
        //1 : GET
        //2 : /bit/login
        //3 : user=sxm&password=123123
        //4 : HTTP/1.1
        // 放入到request里面
        _request._method=matches[1];
        // 资源路径的获取,需要URL解码,不需要+转空格
        _request._path=Util::UrlDecode(matches[2],false);
        _request._version=matches[4];
        // 查询字符串的解析,按&分割,按=分割,变成key-value,存放到_params里
        // 查询字符串的获取,需要URL解码,需要+转空格
        std::vector<std::string> query_string_array;
        std::string query_string=matches[3];
        Util::Split(query_string,"&",&query_string_array);
        for(auto& str:query_string_array)
        {
            //1.user=sxm  2.password=123123  key=value
            size_t pos=str.find("=");
            if(pos==std::string::npos)
            {
                _recv_statu=RECV_HTTP_ERROR; //请求有问题
                _resp_statu=400;
                return false;
            }
            //找着了,填充请求字符串params
            std::string key=Util::UrlDecode(str.substr(0,pos),true);
            std::string val=Util::UrlDecode(str.substr(pos+1),true);
            _request.SetParam(key,val);
        }
        //查询字符串中是经过url编码的,要进行解码
        return true;
    }
    // 接收请求行,从buffer里拿数据
    bool RecvHttpLine(Buffer* buf)
    {
        if(_recv_statu!=RECV_HTTP_LINE) return false;
        // 1.获取请求行的数据,到\r\n,
        // GetLineAndPop是获取buffer一行的方法,如果缓冲区数据不足一行,返回""
        // 或者一行的数据超大
        std::string line = buf->GetLineAndPop();
        if(line.size()==0)
        {
            //缓冲区数据不足以行,判断缓冲区的刻度数据长度,很长了还不足以行,有问题
            if(buf->ReadAbleSize()>MAX_LINE)
            {
                _recv_statu=RECV_HTTP_ERROR;
                _resp_statu=414;//uri too long
                return false;
            }
            //缓冲区数据不足一行,再等等新数据,不处理
            return true;
        }
        //接收到了一行数据,先判断
        if(line.size()>MAX_LINE)
        {
            _recv_statu=RECV_HTTP_ERROR;
            _resp_statu=414;//uri too long
            return false;
        }
        //然后解析首行,填充request
        bool ret=ParseHttpLine(line);
        if(ret==false) return false;
        //首行接收解析完毕,接下来进入头部获取
        _recv_statu=RECV_HTTP_HEAD;
        return true;
    }
public:
    HttpContent():_resp_statu(200),_recv_statu(RECV_HTTP_LINE)
    {}
    //...
    //接收并解析Http请求
    void RecvHttpRequest(Buffer* buf)
    {
        switch(_recv_statu)
        {
            case RECV_HTTP_LINE:
                RecvHttpLine(buf);
                //不要加break,接着继续解析,如果上一个解析失败,不会更改状态,下一个也进不去
            case RECV_HTTP_HEAD:
                RecvHttpHead(buf);
            case RECV_HTTP_BODY:
                RecvHttpBody(buf);
        }
        return;
    }
};
HttpServer模块
对HTTP所有模块进行整合,搭建一个httpserver服务器
1.设计一张请求路由表,即映射关系,表中记录了请求路径的正则 和,对应函数的映射关系,进而来进行上层业务处理
- 当服务器收到一个请求,是动态请求,
- 1.通过该方法(Get)的Handles,匹配所有正则表达式,匹配成功,
- 2.执行这个正则表达式对应的处理函数
- 3.构建resp
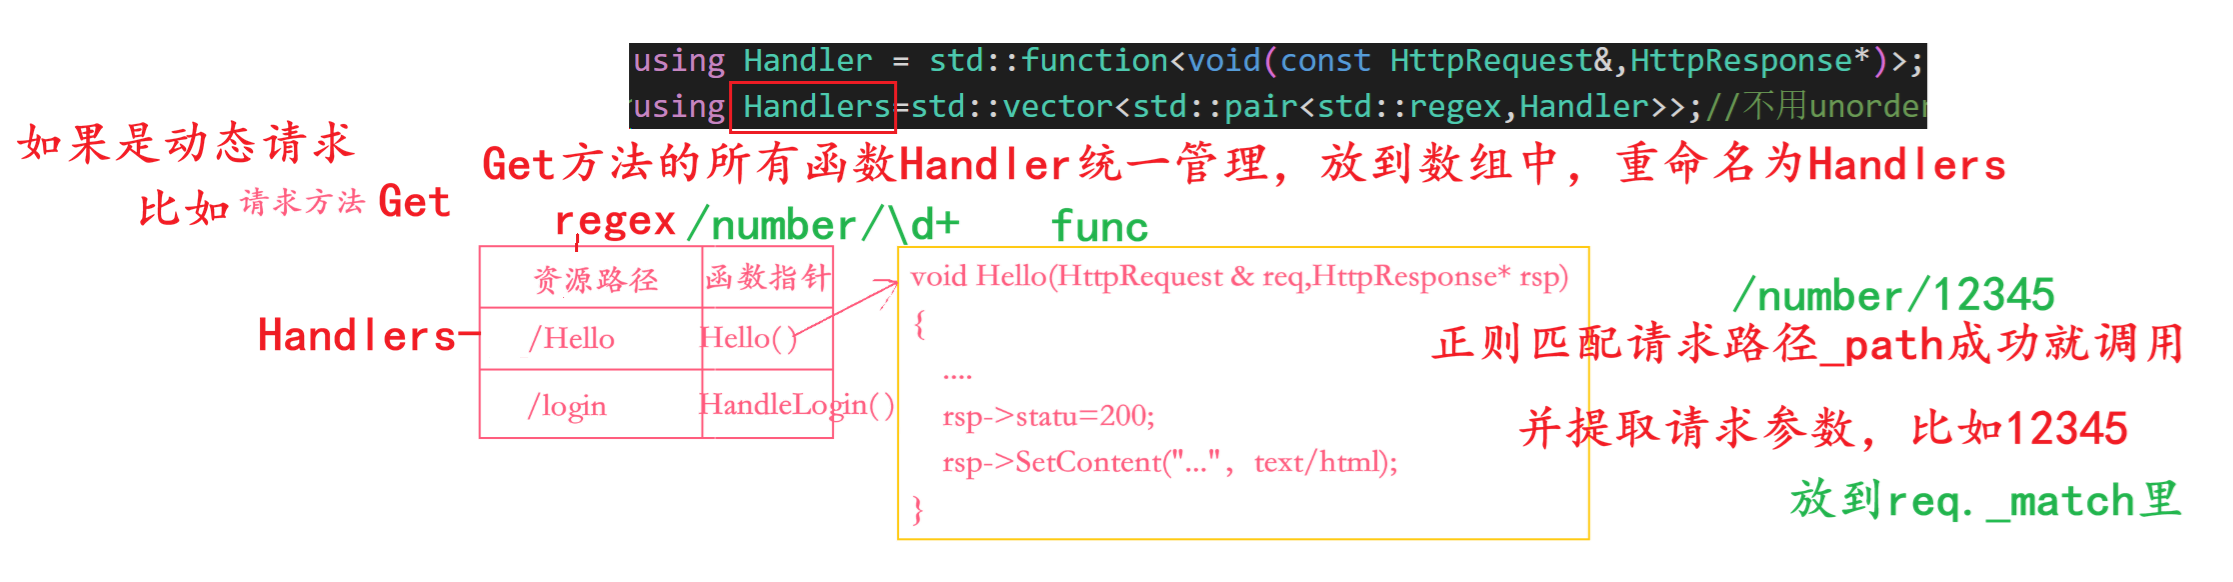
组件使用者实现对应的业务处理函数,添加到服务器中,这样服务器只需要接收、解析,请求查找路由映射关系,执行业务回调函数
同一个 URL 路径/user,GET 和 POST 做的事完全不同,不能用同一个函数处理,所以要有多个请求方法的路由映射表,比如POST的路由映射表、GET的路由映射表等等
这个路由映射表,key:请求路径 value:对应的回调函数
url中的请求路径可能是 /number/1234----Number(),但请求路径是变化的,比如/number/12345,这些路径对应的回调函数都相同,所以可以用正则表达式填充<string,string> -> <regex,string>,/number/\\d+---统一使用Number()函数来处理
cpp
void Dispatcher(HttpRequest& req,HttpResponse* rsp,Handlers& handlers)
        {
            //再对应请求方法的路由表中,查找对应请求是否含有对应请求资源的处理函数,有就调用,没有就返回404
            // 路由表存储的是键值对---正则表达式:处理函数
            //用正则表达式,对请求的资源路径进行正则匹配,匹配成功,使用对应函数进行处理
            // /numbers/\d+  /numbers/12345
            for(auto& it : handlers)
            {
                //用&,这样不用每次调用的时候都拷贝一份新的正则对象,而是直接操作一份内存空间
                const std::regex& e=it.first;
                const Handler& functor=it.second;
                bool ret=std::regex_match(req._path,req._matches,e);
                if(ret==false)
                {
                    continue;//遍历下一个映射关系
                }
                //匹配成功,执行业务处理
                functor(req,rsp);
                return;
            }
            //路由表中没找到相应处理方法
            rsp->_statu=404;
            return;
        }
GET /api/getuser → HandleGetUser
POST /login → HandleLogin
2.还有静态资源请求,必须是Get 或者Head,服务器上预先存在的资源,文件内容写死在硬盘,统一走文件读取函数,所以要有静态资源请求根目录。
- 1.比如 GET /1234.txt HTTP/1.1 静态资源根目录是 /wwwroot/1234.txt
- 2.服务器发现请求的是静态资源,将/wwwroot自动拼接到静态资源的前面,得到/wwwroot/1234.txt,那就找这个文件,把这个文件的数据读出来,组织成一个响应rsp,返回给客户端
- 3.还有一种特殊的请求,url的末尾直接是 /,单纯的目录,要自动拼接默认首页 index.html,得到index.html
判断是静态资源请求
cpp
bool IsFileHandler(const HttpRequest& req)
{
    //1.必须设置了静态资源根目录
    if(_basedir.empty()) return false;
    //2.请求方法,必须是GET/HEAD
    if(req._method!="GET"&& req._method!="HEAD") return false;
    //3.请求的资源路径必须合法
    if(Util::ValidPath(req._path)==false) return false;

    //4.请求的资源必须存在
    // 有一种请求 /、/image/ 单纯的目录 ,特殊,追加首页 index.html
    std::string req_path=_basedir + req._path;//加上前面的相对根目录
    if(req._path.back()=='/')
    {
        req_path += "index.html";
    }
    //这个文件是否是普通文件,静态资源
    if(Util::IsRegular(req_path)==false)
    {
        return false;
    }
    return true;
}
读取静态文件,组成一个响应
cpp
// 处理静态资源请求,将静态资源数据读取出来,放到rsp的正文当中,并设置Content-Type
void FileHandler(const HttpRequest& req,HttpResponse* rsp)
{
    std::string req_path=_basedir + req._path;
    if(req._path.back()=='/')
    {
        req_path += "index.html";
    }
    bool ret=Util::ReadFile(req_path,&rsp->_body);
    if(ret==false)
    {
        return;//读取文件失败
    }
    std::string mime=Util::ExtMime(req_path);
    rsp->SetHeader("Content-Type",mime);
    return;
}
/index.html、/logo.png、/music.aac → ExtMime
服务器处理流程:
- 1.客户端发数据,从socket接收数据,放到buffer接收缓冲区
- 2.调用OnMessage回调函数,进行业务处理
- 3.对请求进行解析,得到了一个完整的HttpRequest请求
- 4.查找请求对应的处理方法
4.1静态资源请求 html...,将数据读取出来,填充到response里
4.2动态资源请求,根据路由表,找到对应的处理函数,处理完将结果填充到
response里
- 5.将请求处理完毕后,得到了HttpResponse,组织http格式并发送
感谢阅读^^,完。