MAVFusion具有运动感知稀疏交互的特点
- 用一句话来概括就是
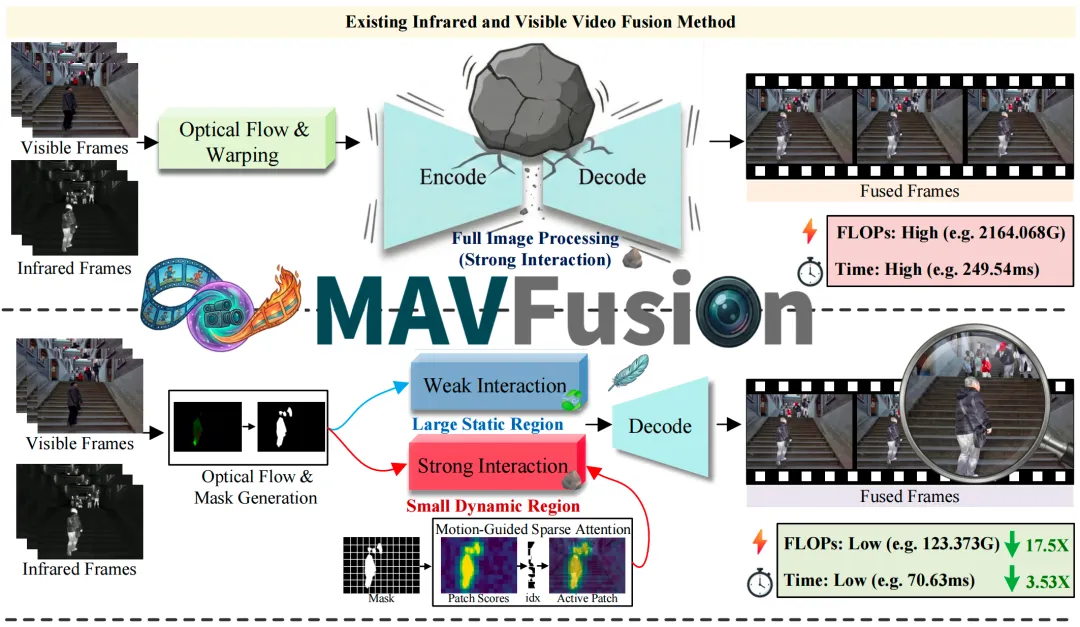
MAVFusion 为了解决运动错位、时间闪烁以及高计算开销等问题而提出的解决方案是:用光流来区分子帧中运动和静止的部分,并且对于运动部分使用稀疏强交互的方式,而对于静止部分则采用轻量弱交互的方法,在保证了融合效果和时序一致性的前提下降低了计算成本。
- 论文信息
-
题目: MAVFusion: Efficient Infrared and Visible Video Fusion via Motion-Aware Sparse Interaction | 通过运动感知稀疏交互实现高效红外与可见光视频融合
-
发表: ECCV 2026
-
作者: Xilai Li+、Weijun Jiang+、Xiaosong Li*、Yang Liu、Hongbin Wang、Tao Ye、Huafeng Li、Haishu Tan
-
单位:
-
佛山大学
-
昆明理工大学
-
中国矿业大学(北京)
-
代码:
-
论文:
3. 论文摘要
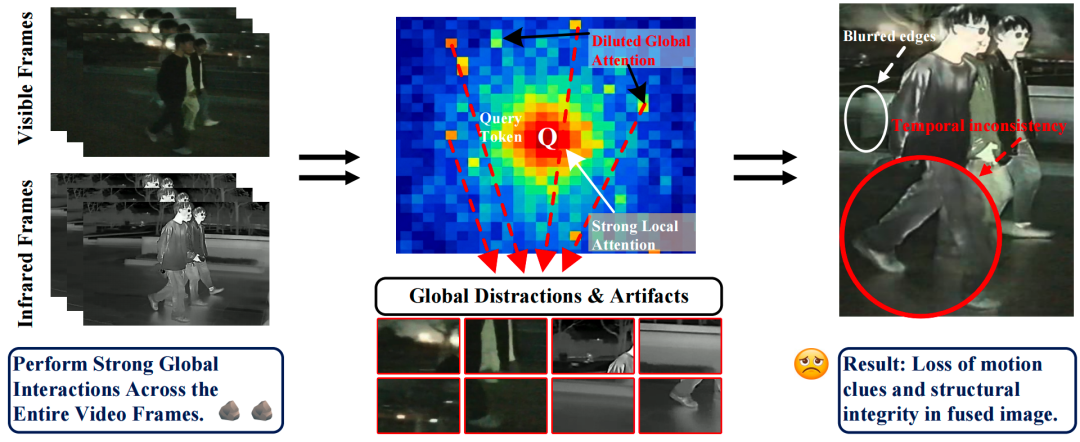
目前的视频融合方法通常会对整个画面进行密集的空间-时间交互操作,虽然可以提高计算速度但是也会造成静止背景和移动物体之间的互相影响。MAVFusion 采用运动感知特征对应以及动静两支并行的方式来进行融合,在重要的运动区域做复杂的运算来保证时间和空间上的准确性的同时也提高了推理的速度。
4. 核心创新点
创新一:静态和动态分离
用光流法产生运动遮罩来区分出运动的目标和静止的背景,并且给它们以不同的计算量,从而消除全部图像都进行高强度交互所造成的多余信息以及相互影响。
创新二:运动感知特征一致
运动感知特征对齐模块(Motion-Aware Feature Alignment Module,MAFM)用的是"光流粗对齐+跨模态残差细化"的方式来解决跨帧错位、重影以及边缘模糊的问题。
创新三:运动引导稀疏交互
运动引导双交互模块(Motion-Guided Dual-Interaction Module,MDIM)只在运动比较明显的时候起作用,即当 Top-N 中存在明显的运动时。
图像块进行注意力交互之后,复杂度就变成了 降低至 。
5. 方法详解
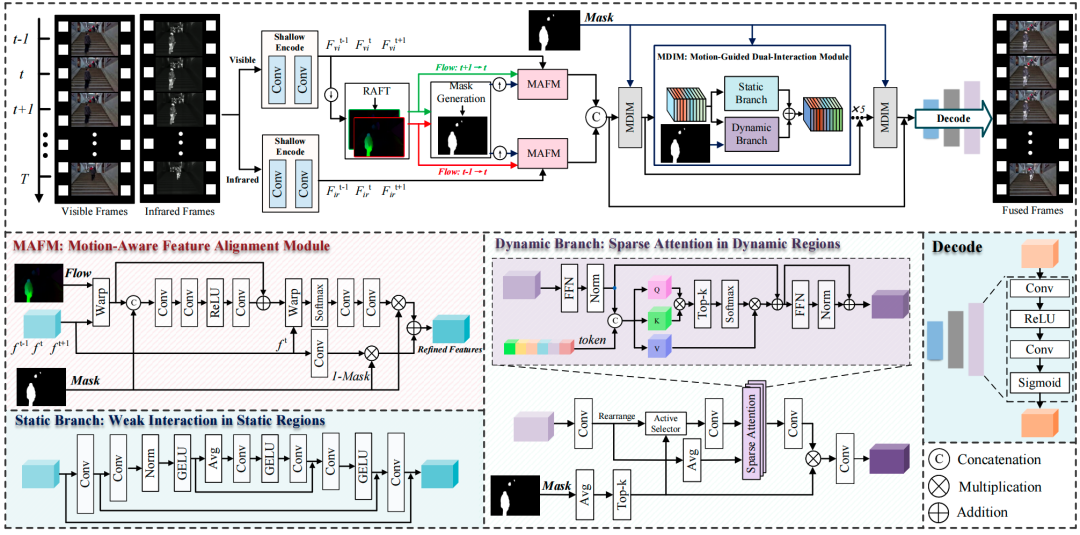
图 2. MAVFusion 的整个结构由跨帧对齐、动态稀疏交互、静态弱交互和重构过程组成。
5.1 模型结构
模型输入 、 和 ,按照一定的顺序对红外和可见光帧进行浅层特征抽取、MAFM 配准、MDIM 融合以及图像还原之后得到的结果就是当前时刻的合成图像。
5.2 运动感知特征一致
MAFM 用冻结的 SEA-RAFT 来计算相邻帧之间的光流,从而得到初步的配准结果:
其中, 为时刻 的特征, 为光流, 双线性变换就是这样的。
接着再加入一个模态特征作为空间锚点,并且对残差光流进行预测:
公式解读: 第一部分解决大面积帧间运动问题,第二部分用跨模态特征来校正光流错误,以此来降低错位和重影现象的发生。
对齐之后的特征按照可学习的时间权重大致相加:
运动遮罩也用来抑制时间信息的传递,在运动的部分用到多个帧的信息来推断出运动的情况,在静止的地方只保留当前帧的信息。
5.3 运动引导双交互
把特征分成 个 ,把图片分成很多小块,用运动遮罩来决定保留哪些小块。
动态块保留的比例是 :
其中, 为块级运动得分, 对于动态块进行索引, 为软权重。
动态分支只用被选择的部分来查询,在全局上下文里取到键和值:
静态分支用深度可分隔卷积来保存局部特征,最后再用运动遮罩进行重构:
公式解读: 对于动态的目标进行强烈的交互作用,而把静态的背景只做一个简单的局部建模来降低计算量并且防止背景纹理过平滑。
5.4 损失函数
总的损失可以分成两部分,即空间保真损失以及时间一致性的损失:
其中, 为了保持红外特征和可见光结构, 用来保证相邻融合帧之间的一致性的。
时间损失为:
公式解读: 把前后融合帧变形为现在的时刻之后再做一致性约束,并用有效的掩模来消除遮挡以及不正确的配准的地方。
用一句话来概括这个方法就是: 根据光流来确定哪些地方要进行复杂的融合,并且把大部分的计算集中在实际有变化的地方上。
6. 实验结果
6.1 实验条件
本实验使用 M3SVD、HDO 和 VTMOT 三个数据集,其中 M3SVD 有 30 条视频序列、HDO 有 24 条、VTMOT 有 90 条;从每一个数据集中随机选取 5 条进行测试,剩下的用来做训练用。输入截取长度为 ,批量大小是 32,使用的是 Adam 优化算法,并且初始的学习率是 ,经过 40,000 次迭代之后衰减到原来的 1%,使用的显卡是四张 NVIDIA GeForce RTX 3090。
6.2 定量的结果
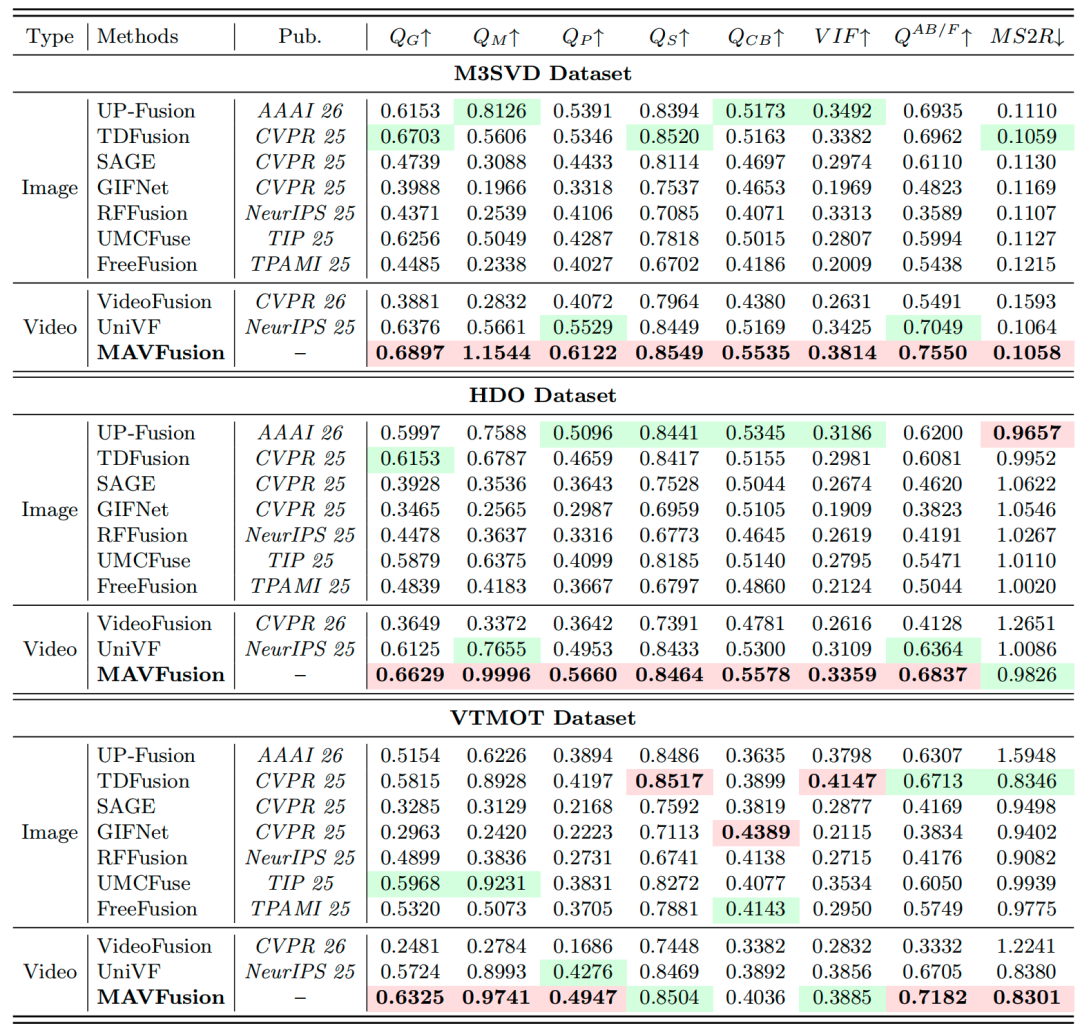
表 1. 对三个视频的数据集进行定量分析。
MAVFusion 在 M3SVD 的 8 个方面都取得了最好的成绩,其中包括 、、、。
HDO 上七种图像质量最好的是 、、;,排名第二。
VTMOT 上 、、、 和 均为最佳。
6.3 定性的结论
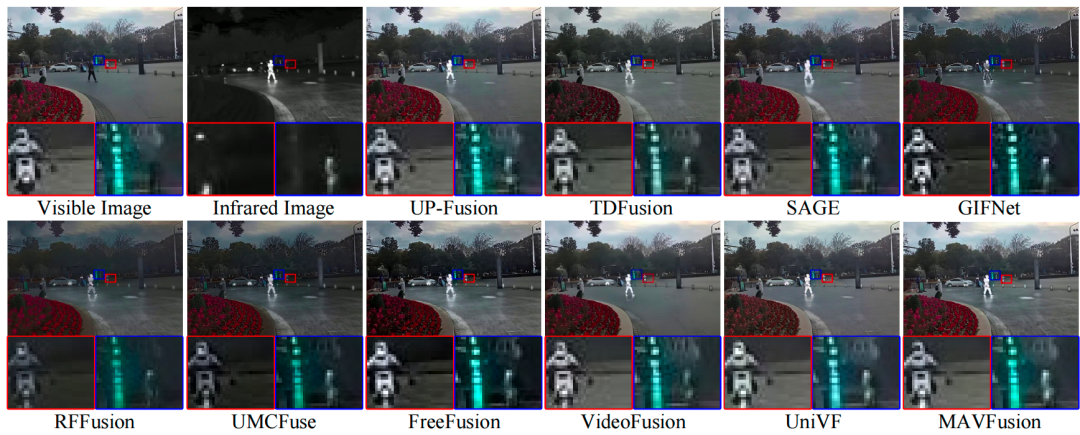
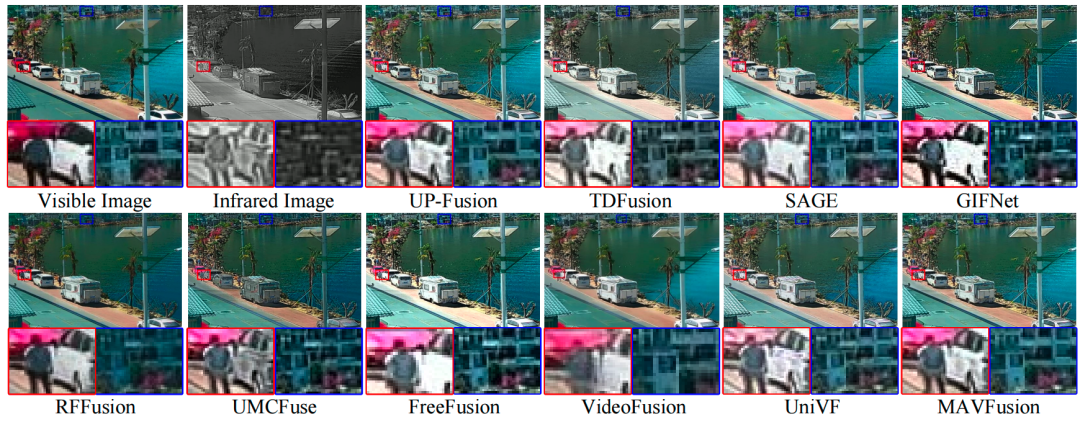
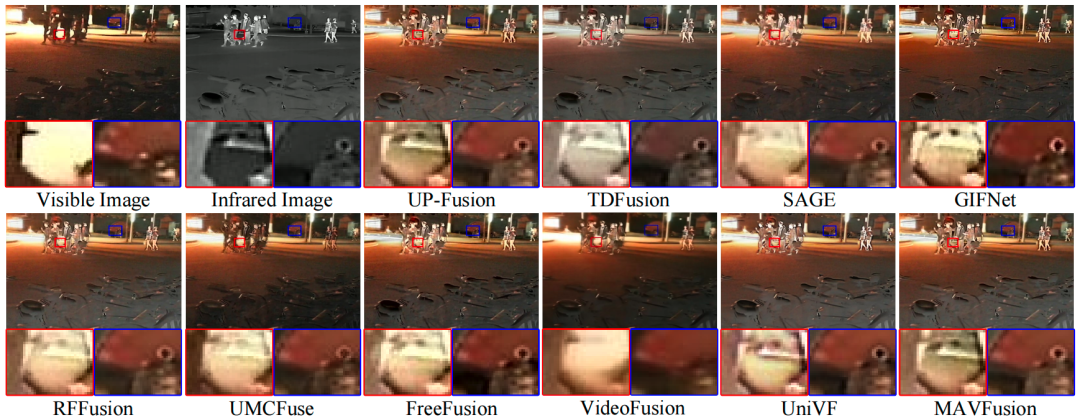
图 4--6. M3SVD、HDO、VTMO 上的定性结论。
单图像融合的方法对于运动区域会产生重影、模糊等问题;而一些视频方法可以提高时间一致性但是又会降低静止区域的纹理效果。MAVFusion 可以同时保证动态目标的清晰以及背景结构的稳定。
6.4 下游的任务
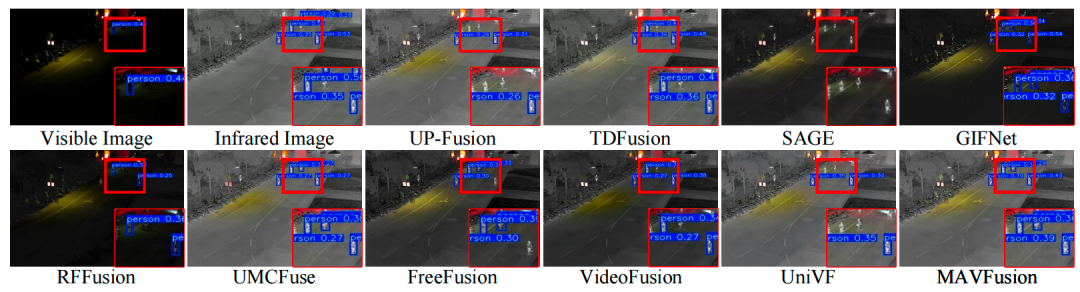
图 7. 各种目标检测方法进行对比。
本文使用 YOLO26 进行检测,在低光照条件下,MAVFusion 能较好的保持红外目标的特点并且得到最好的检测置信度。但是该文没有给出 、 和 的汇总数值。
6.5 消融实验
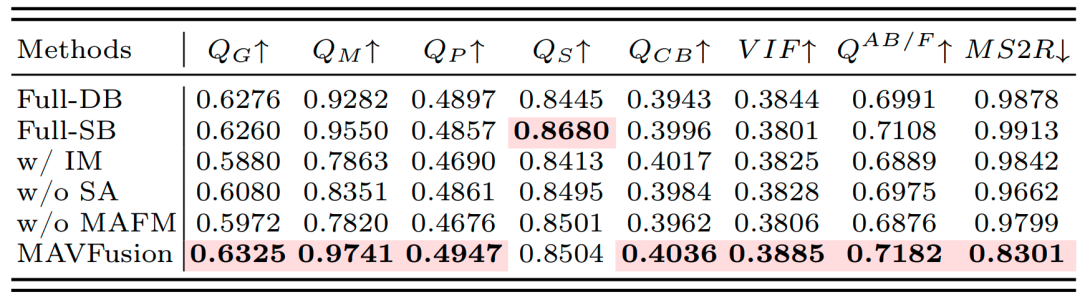
表 2. 各个部分和各个区域所采用的不同模块以及它们之间相互作用所产生的效果。
完整模型取得 、、 和 。去掉 MAFM 之后, 降到 0.5972 的时候, 降到 0.7820 的时候, 恶化到 0.9799 的时候,所有的图都出现了强交互、只有静态分支和反转运动掩码才会导致性能降低的现象,这也证明了动态强交互和静态弱交互是合理的。
6.6 模型复杂度
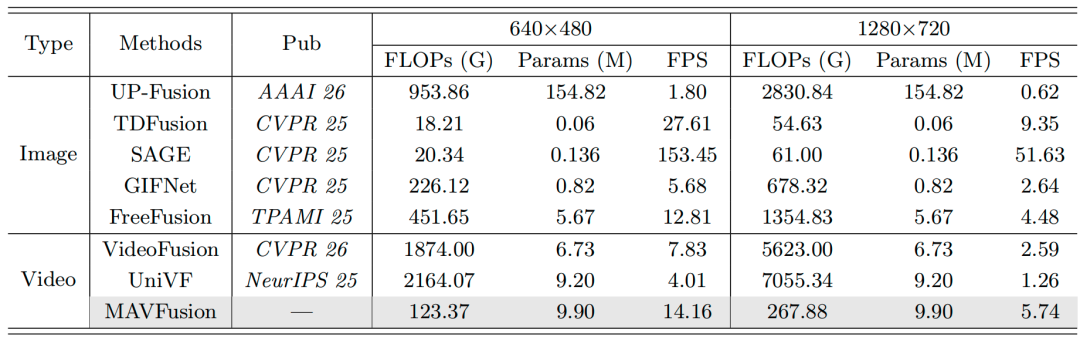
表 3. 在不同的分辨率下 FLOPs、参数数量以及 FPS 的区别。
在 下,MAVFusion 包括 参数、,速度为 。它的计算量大约是 VideoFusion 的六分之一左右、UniVF 的一半不到。
在 下,计算量是 ,速度为 ,相比于 VideoFusion 和 UniVF 来说要快一些,分别为 与 。
- 总结
MAVFusion 同时利用运动信息来实现跨帧对齐以及计算分配,在动态区域中使用稀疏性强交互的方式,在静态区域则用轻量弱交互的方法。实验结果表明此方法可以很好地在融合质量、时间一致性与推理效率三者之间找到一个较好的折衷点。
一句话总结: MAVFusion 的主要部分就是在真正的地方做昂贵的跨模态交互。
往期推荐