前篇Spring AI 2.0 Agent 入门与最小实践-CSDN博客的最小 Agent 已经能够记住对话,并通过 Tool 查询数据库或调用 Java 方法。此时还存在两个很现实的问题。
- 第一个问题是知识来源。模型可能不知道企业内部规定、项目文档、产品说明或者最新业务知识。RAG 可以在模型回答之前检索这些资料,并把相关内容补充进上下文。
- 第二个问题是结果使用。
.content()得到的是一段自然语言,而 Java 后端经常需要boolean、数字、枚举或者一个完整对象 。Structured Output 可以把模型结果直接转换成 Java 类型。
因此,一个更接近实际应用的 Agent 会逐渐形成:
用户
 ↓
ChatMemory
 ↓
RAG
 ↓
LLM
 ↓
Tool
 ↓
Tool Result
 ↓
LLM
 ↓
Structured Output
 ↓
Java业务系统
目录
[一、RAG:给 Agent 补充外部知识](#一、RAG:给 Agent 补充外部知识)
[二、RAG 实际上包含两个阶段](#二、RAG 实际上包含两个阶段)
[1. 知识入库](#1. 知识入库)
[2. 查询时检索](#2. 查询时检索)
[三、RAG 也需要控制检索范围](#三、RAG 也需要控制检索范围)
[四、RetrievalAugmentationAdvisor:进一步控制 RAG](#四、RetrievalAugmentationAdvisor:进一步控制 RAG)
[五、把 Memory、RAG 和 Tool 放到同一个 Agent](#五、把 Memory、RAG 和 Tool 放到同一个 Agent)
[六、Structured Output:让结果真正进入 Java 业务](#六、Structured Output:让结果真正进入 Java 业务)
[七、Spring AI 2.0 的 Schema Validation](#七、Spring AI 2.0 的 Schema Validation)
[八、这一阶段应该形成的 Spring AI 心智模型](#八、这一阶段应该形成的 Spring AI 心智模型)
一、RAG:给 Agent 补充外部知识
RAG,全称 Retrieval-Augmented Generation,即检索增强生成。
它解决的核心问题很简单:模型回答问题以前,先从外部知识库中找出与当前问题相关的资料,再让模型结合这些资料生成答案。【本质上是稳定性知识增强】
例如用户询问:
keyboard 需要补货吗?系统可能需要两类数据:
企业规定:
库存低于 10 件需要补货

实时库存:
keyboard 当前库存为 6 件
第一类属于相对稳定的企业知识,很适合放入 RAG。
第二类属于实时业务状态,更适合通过 Tool 查询。
因此可以建立一个很实用的区分:
ChatMemory
→ 之前聊过什么

RAG
→ 知识库里有什么规定和资料

Tool
→ 业务系统当前真实状态是什么
二、RAG 实际上包含两个阶段
1. 知识入库
RAG 首先需要把文档保存到可以进行语义检索的数据结构中。
最基本过程是:
企业文档
   ↓
Document
   ↓
Embedding Model
   ↓
向量
   ↓
VectorStore
Spring AI 使用 Document 表示文档,使用 VectorStore 对不同向量数据库提供统一抽象。
例如先放入一条极简知识:
java
// 创建一条极简知识文档
Document rule = new Document(
        "库存管理规定:商品库存低于 10 件时需要及时补货。"
);

// 将文档写入向量库
vectorStore.add(List.of(rule));
实际项目中当然不会手工写一句话。PDF、Word、Markdown 等资料通常还需要经过文档读取、切分和 Embedding,再写入 VectorStore。
初学阶段先记住:
原始资料
 ↓
Document
 ↓
Embedding
 ↓
VectorStore
这属于 RAG 的数据准备阶段。
2. 查询时检索
用户真正提出问题以后,程序再执行:
用户问题
 ↓
生成查询向量
 ↓
VectorStore 相似度检索
 ↓
找到相关 Document
 ↓
加入 Prompt
 ↓
交给 LLM
Spring AI 提供的 QuestionAnswerAdvisor 可以直接完成这种基础 RAG 。官方定义中,它会查询 VectorStore,然后把检索到的文档加入用户问题的上下文。(Home)
最小代码如下:
java
// 构建基础 RAG 顾问,绑定向量库
QuestionAnswerAdvisor ragAdvisor =
        QuestionAnswerAdvisor.builder(vectorStore)
                .build();
然后加入 ChatClient:
java
// 发起对话并携带 RAG 顾问
String answer = chatClient
        .prompt()
        .user("keyboard 的补货标准是什么?")
        .advisors(ragAdvisor)
        .call()
        .content();
内部过程就是:
问题
 ↓
QuestionAnswerAdvisor
 ↓
VectorStore
 ↓
找到:
"库存低于10件需要补货"
 ↓
加入 Prompt
 ↓
LLM
 ↓
回答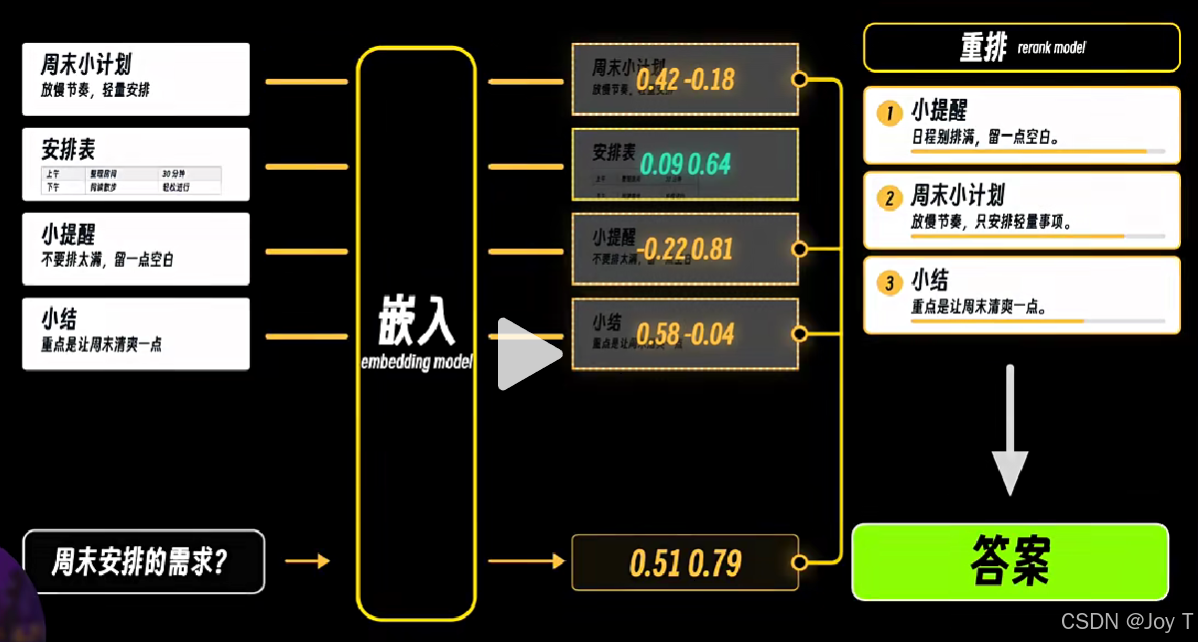
(图片来自于秋芝2046)
三、RAG 也需要控制检索范围
真正使用 RAG 时,通常不能把所有相似资料都发送给模型。
Spring AI 可以设置 similarityThreshold 和 topK:
java
// 构建带检索控制的 RAG 顾问
QuestionAnswerAdvisor ragAdvisor =
        QuestionAnswerAdvisor.builder(vectorStore)
                .searchRequest(
                        SearchRequest.builder()
                                .similarityThreshold(0.8) // 相似度阈值
                                .topK(4)                 // 返回最相关的 4 个文档
                                .build()
                )
                .build();
这里:
similarityThreshold = 0.8表示只保留相似度达到一定要求的结果。
topK = 4表示最多取最相关的 4 个文档。
因此 RAG 的关键并不只是"搜索知识库"。检索结果的相关性、数量以及噪声控制都会影响最终回答质量。Spring AI 2.0 还支持通过 metadata filter 限制检索范围。(Home)
例如企业拥有多个项目的知识库时,可以只查询某个项目:
project == "inventory"这样能够避免其他业务资料进入当前 Prompt。
四、RetrievalAugmentationAdvisor:进一步控制 RAG
QuestionAnswerAdvisor 很适合入门,它基本完成:
Query
 ↓
VectorStore
 ↓
Documents
 ↓
Prompt复杂应用还会遇到一个问题:用户的问题本身可能不适合直接检索(语义不完整)。
例如连续对话:
用户:keyboard 的补货标准是多少?

用户:那 mouse 呢?
第二句话只有:
那 mouse 呢?直接拿它检索知识库,查询语义并不完整。
更成熟的 RAG 会增加:
原始问题
 ↓
Query Rewrite / Compression
 ↓
更完整的检索问题
 ↓
Document Retrieval
 ↓
重排 / 去除噪声
 ↓
Prompt Augmentation
 ↓
LLM
Spring AI 2.0 为此提供了 RetrievalAugmentationAdvisor,并将 RAG 拆成 Query Transformation、Retrieval、Post-Retrieval 和 Query Augmentation 等模块。(Home)
一个最简单的版本是:
java
// 构建可组合的 RAG 顾问
Advisor ragAdvisor =
        RetrievalAugmentationAdvisor.builder()
                .documentRetriever(
                        VectorStoreDocumentRetriever.builder()
                                .vectorStore(vectorStore)
                                .similarityThreshold(0.7) // 相似度阈值
                                .topK(4)                 // 返回最相关的 4 个文档
                                .build()
                )
                .build();
随后仍然挂到 ChatClient:
java
// 发起对话并携带 RAG 顾问
chatClient
        .prompt()
        .advisors(ragAdvisor)
        .user(question)
        .call()
        .content();
因此可以先形成这样的学习层级:
QuestionAnswerAdvisor
→ 基础 RAG

RetrievalAugmentationAdvisor
→ 可组合、可进一步控制的 RAG
Spring AI 2.0 还提供 RewriteQueryTransformer、CompressionQueryTransformer 等组件,用于在真正检索以前重新整理用户问题 。(Home)
五、把 Memory、RAG 和 Tool 放到同一个 Agent
现在继续使用库存 Agent。
我们已经拥有:
ChatMemory
→ 保存多轮对话

RAG
→ 保存库存制度

Tool
→ 查询实时库存
可以把它们统一配置到 ChatClient:
java
// 统一配置 Memory、RAG 和 Tool 到 ChatClient
@Bean
public ChatClient chatClient(
        ChatClient.Builder builder,
        ChatMemory chatMemory,
        VectorStore vectorStore,
        InventoryTools inventoryTools) {

    return builder
            .defaultSystem("""
                    你是库存管理助手。
                    根据企业库存规则和实时库存判断是否需要补货。
                    """)
            .defaultAdvisors(
                    // 保存多轮对话
                    MessageChatMemoryAdvisor
                            .builder(chatMemory)
                            .build(),

                    // 检索库存制度
                    QuestionAnswerAdvisor
                            .builder(vectorStore)
                            .build()
            )
            .defaultTools(inventoryTools)
            .build();
}
此时用户发送:
keyboard 需要补货吗?可以形成完整过程:
① ChatMemory
读取当前会话上下文
        ↓
② RAG
检索:
库存低于10件需要补货
        ↓
③ LLM
发现还缺少实时库存
        ↓
④ Tool
getStock("keyboard")
        ↓
⑤ Tool Result
当前库存6件
        ↓
⑥ LLM
结合规则与实时数据
        ↓
⑦ 最终判断
需要补货
这里已经出现了比较完整的 Agent 信息来源设计:
Memory → 会话信息
RAG    → 外部知识
Tool   → 实时信息与执行能力
LLM    → 理解、推理和决策
Advisor 的实际执行顺序可以通过 order 控制,因此复杂项目需要明确设计 Advisor Chain,而不能只依赖书写位置理解执行顺序。
六、Structured Output:让结果真正进入 Java 业务
前面的最终结果仍然是:
java
// 获取模型返回的自然语言结果
.content();
得到的类型是:
java
// 返回类型为 String
String
例如:
java
// 示例返回结果
keyboard 当前库存为6件,根据公司规定建议补货。
给用户阅读没有问题,但后端程序可能还要执行:
创建补货任务
发送告警
写入数据库
显示红色状态
这时程序真正需要的可能是:
product = "keyboard"
stock = 6
needRestock = true
Spring AI 的 Structured Output 可以直接把模型结果转换成 Java 类型。(Home)
首先定义:
java
// 定义补货决策的 Java 记录类型
public record RestockDecision(
        String product,
        int stock,
        boolean needRestock,
        String reason
) {}
然后:
java
// 将模型结果转换为 Java 对象
RestockDecision result = chatClient
        .prompt()
        .user("判断 keyboard 是否需要补货")
        .call()
        .entity(RestockDecision.class);
最终拿到的是普通 Java 对象:
java
// 读取结构化结果中的字段
result.product();
result.stock();
result.needRestock();
后端就可以继续:
java
// 根据决策结果执行后续业务
if (result.needRestock()) {
    restockService.createTask(result.product());
}
这一步非常重要,因为 Agent 到这里才真正和传统 Java 业务系统重新连接起来。
七、Spring AI 2.0 的 Schema Validation
模型生成结构化内容时仍然可能出现字段缺失、类型错误等情况。
Spring AI 2.0 可以使用:
java
// 开启 Schema Validation,校验模型结果是否符合目标类型
RestockDecision result = chatClient
        .prompt()
        .user("判断 keyboard 是否需要补货")
        .call()
        .entity(
                RestockDecision.class,
                spec -> spec.validateSchema()
        );
开启 Schema Validation 后,Spring AI 会检查模型结果是否符合目标 Java 类型对应的 JSON Schema 。如果验证失败,可以把错误重新提供给模型并再次生成,默认最多进行多次尝试。(Home)
因此可以把 Structured Output 理解成两步:
LLM 自然语言能力
        ↓
JSON Schema 约束
        ↓
Java Object
Agent 的决策结果由此可以进入普通 Java Service、数据库和业务流程。
八、这一阶段应该形成的 Spring AI 心智模型
学到这里,一个 Spring AI Agent 已经可以表示为:
                  用户
                   ↓
               ChatClient
                   ↓
             Advisor Chain
          ┌────────┼────────┐
       Memory      RAG     Safety
          └────────┼────────┘
                   ↓
                  LLM
                   ↓
             Tool Calling
                   ↓
          Java Service / API
                   ↓
             Tool Result
                   ↓
                  LLM
                   ↓
          Structured Output
                   ↓
             Java业务系统
此时几个组件分别回答了不同问题:
ChatMemory
→ Agent 之前知道什么?

RAG
→ 外部知识库能够补充什么?

LLM
→ 根据当前信息下一步应该做什么?

Tool
→ 怎样查询真实状态或者执行操作?

Structured Output
→ 怎样把模型判断可靠地交回 Java?
理解到这一层以后,Spring AI 2.0 已经从"调用一个聊天模型"逐渐变成了一个完整的 AI 应用开发框架。
下一阶段再学习 MCP 会非常自然,因为 MCP 解决的正是另一个问题:当 Tool 越来越多,并且这些能力来自不同服务、不同进程甚至不同语言时,怎样使用统一协议将它们提供给 Agent。 Spring AI 已经提供 MCP Client、MCP Server 和 Tool 集成能力,适合单独作为下一篇展开。(Home)