关键词
DeepSeek Harness、DeepSeek-V4.1-Flash、GPT-6 Astra、喵ingTab
背景
DeepSeek于09-10号正式发布了DeepSeek-V4.1-Flash,此前已经开放了几天灰测,社区在灰测期间进行了大量测试,大差不差的结论是比之前的V4 Flash 和V4 Pro要强,但大多数测试都集中在鹈鹕测试这种场景测试,这种测试可以在某些方面测试大模型的"智商",但很难反应DeepSeek-V4.1-Flash在真实开发场景下的体感,于是在DeepSeek-V4.1-Flash正式发布以后,我接入了一个自己正在AI Coding的项目任务。
关于项目信息可以参考之前的这篇文章:不写一行代码全靠AI的项目能做成什么样子?
喵ingTab早期古法编程阶段,出于自己写一套组件库费时费力、测试也难覆盖的足够全面的考虑,引入了Tdesign-vue-next组件库,当初引入主要是为了使用一些基础组件,类似input、select、datepicker等,但实际上随着项目的逐渐丰富,实际上引入的组件越来越多,因此项目后来已经有两套视觉token体系,一套是项目初期建设时的--mi-体系,一套是Tdesign-vue-next的体系,只是在实际应用时将--mi-体系映射到了Tdesign-vue-next对应的CSS基础变量,所以喵ingTab才能在视觉上维持了还算过得去的视觉一致性。
但是在1.3.2版本之后,我十分想给喵ingTab加入一个风格切换功能,想法源自Antdv Next Vue 3
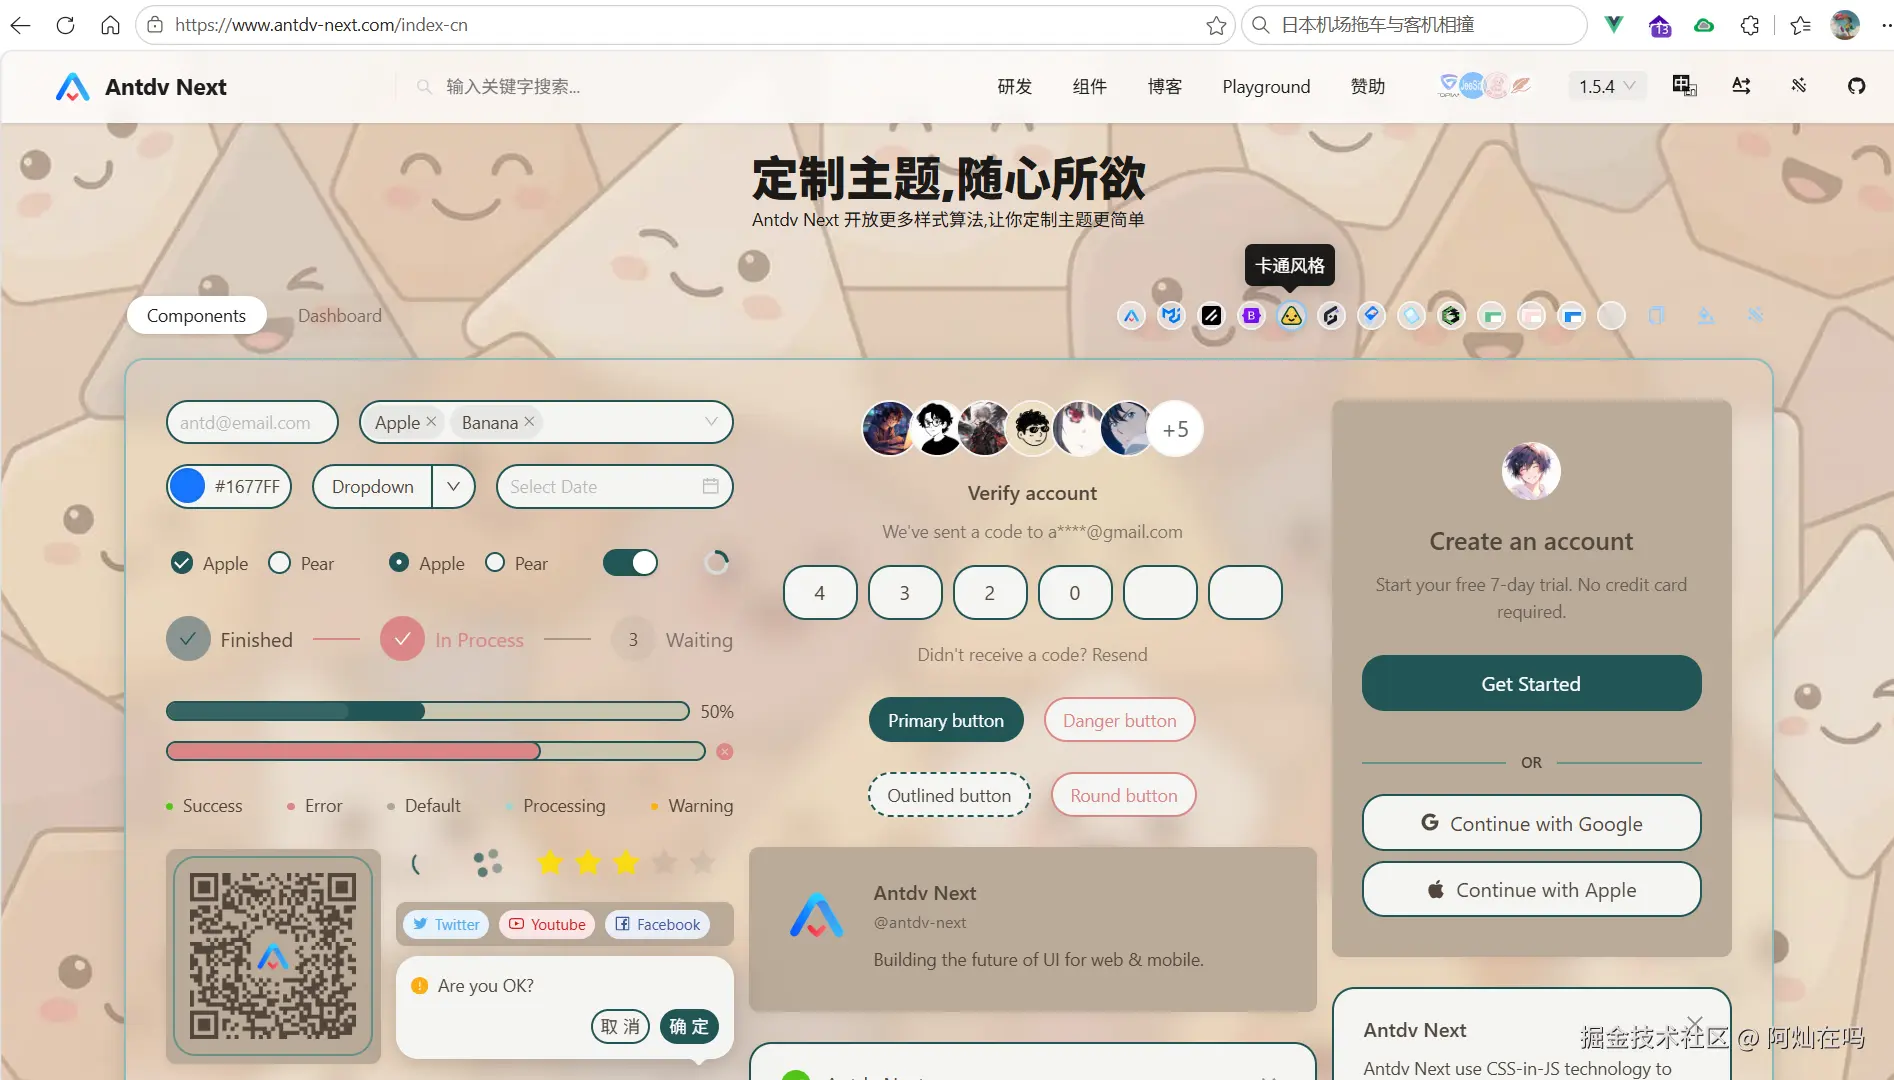
但是在执行过程中就发现了大量的问题,新增一种风格可能需要修20+个特殊点,这个问题不全是两套token体系的差异带来的,还有小组件带来的问题,小组件在我的设计中和喵ingTab插件是相对独立而又宿主于喵ingTab的,可以类比APP和手机操作系统的关系。
在新增风格时,视觉上的不统一是我无法接受的,因此这次新增风格做了如上所说的几十个特殊修复。所以我在思考,如果未来还要新增一种风格,未来喵ingTab功能变得更加丰富,我会不会像今天这样陷入更庞大的单点修复陷进?AI Coding时代,开发者距离代码细节是比较远的,改动面越广、越乱,可能就会埋下更多的问题。
还有一些其他原因,总之最终我打算在当前阶段对数据层、视觉层、小组件体系进行一套大手术并重新梳理规格文档,尽量做到以后新增内容时AI只是在正确的位置、用正确的方式新增了代码,而不会给项目埋下潜在的问题,一言以蔽之,就算AI错了,埋坑了,也仅限于它新增的这部分,当然,一些全局性的改动势必还是要严格review。
数据层和小组件层的改动在之前已经让GPT差不多搞定了,视觉层正在进行中,正值DeepSeek-V4.1-Flash正式发布,于是我把这个任务交给了它。
任务概要:参考antdv-next的视觉体系重新梳理构建喵ingTab的视觉体系;参考tdesign-vue-next实现喵ingTab的专属组件库Mi,将之前使用的tdesign组件迁移为新的Mi组件,最终功能、视觉上要和已经发布的1.3.2版本尽量保持一致
如果把这两个主要任务拆开其实要更简单一些,只需要考虑参考一个组件库的话,AI大可以直接照搬,但是一边是antdv-next的视觉体系,一边是tdesign的基础组件,还是比较有挑战的。
验证环境及过程
js
Agent:Deepseek Harness(@deepseek-ai/dsh@0.1.5-rc.1)
除官方插件以外 Deepseek Harness 安装的插件:
- @changfenhuang/dsh-genui 0.10.0
- @linxin666/dsh-web-all 0.3.22
- @liustack/modsearch 5.10.2
- @tt-a1i/archify-dsh 0.1.0
- @yuxianglin/dsh-bridge-browser 0.0.5
模型:DeepSeek-V4.1-Flash
档位:Max
项目技术栈:vue 3.5 + TypeScript 5.7 + Vite 6 + Pinia 2 + pnpm 10.3 + UnoCSS 0.65 + Less 4 + Playwright 1.61
项目skills:无
任务:参考`antdv-next`的视觉体系构建`喵ingTab`的视觉体系,参考`tdesign-vue-next`实现`喵ingTab`的专属组件库`Mi`,将之前使用的`tdesign`组件迁移为新的`Mi`组件,最终功能、视觉上要和已经发布的`1.3.2`版本尽量保持一致
执行轮次:232 轮
执行步数:10991 步
输出速度:约 273 tok/s
模型用时:699 分 18 秒
工具调用用时:2558 分 37 秒
总用时:3257 分 55 秒(约 54.3 小时)
总消耗Tokens:5,217,814,371
总花费:184.76 RMB
单价(每百万Tokens):0.0354 RMB/M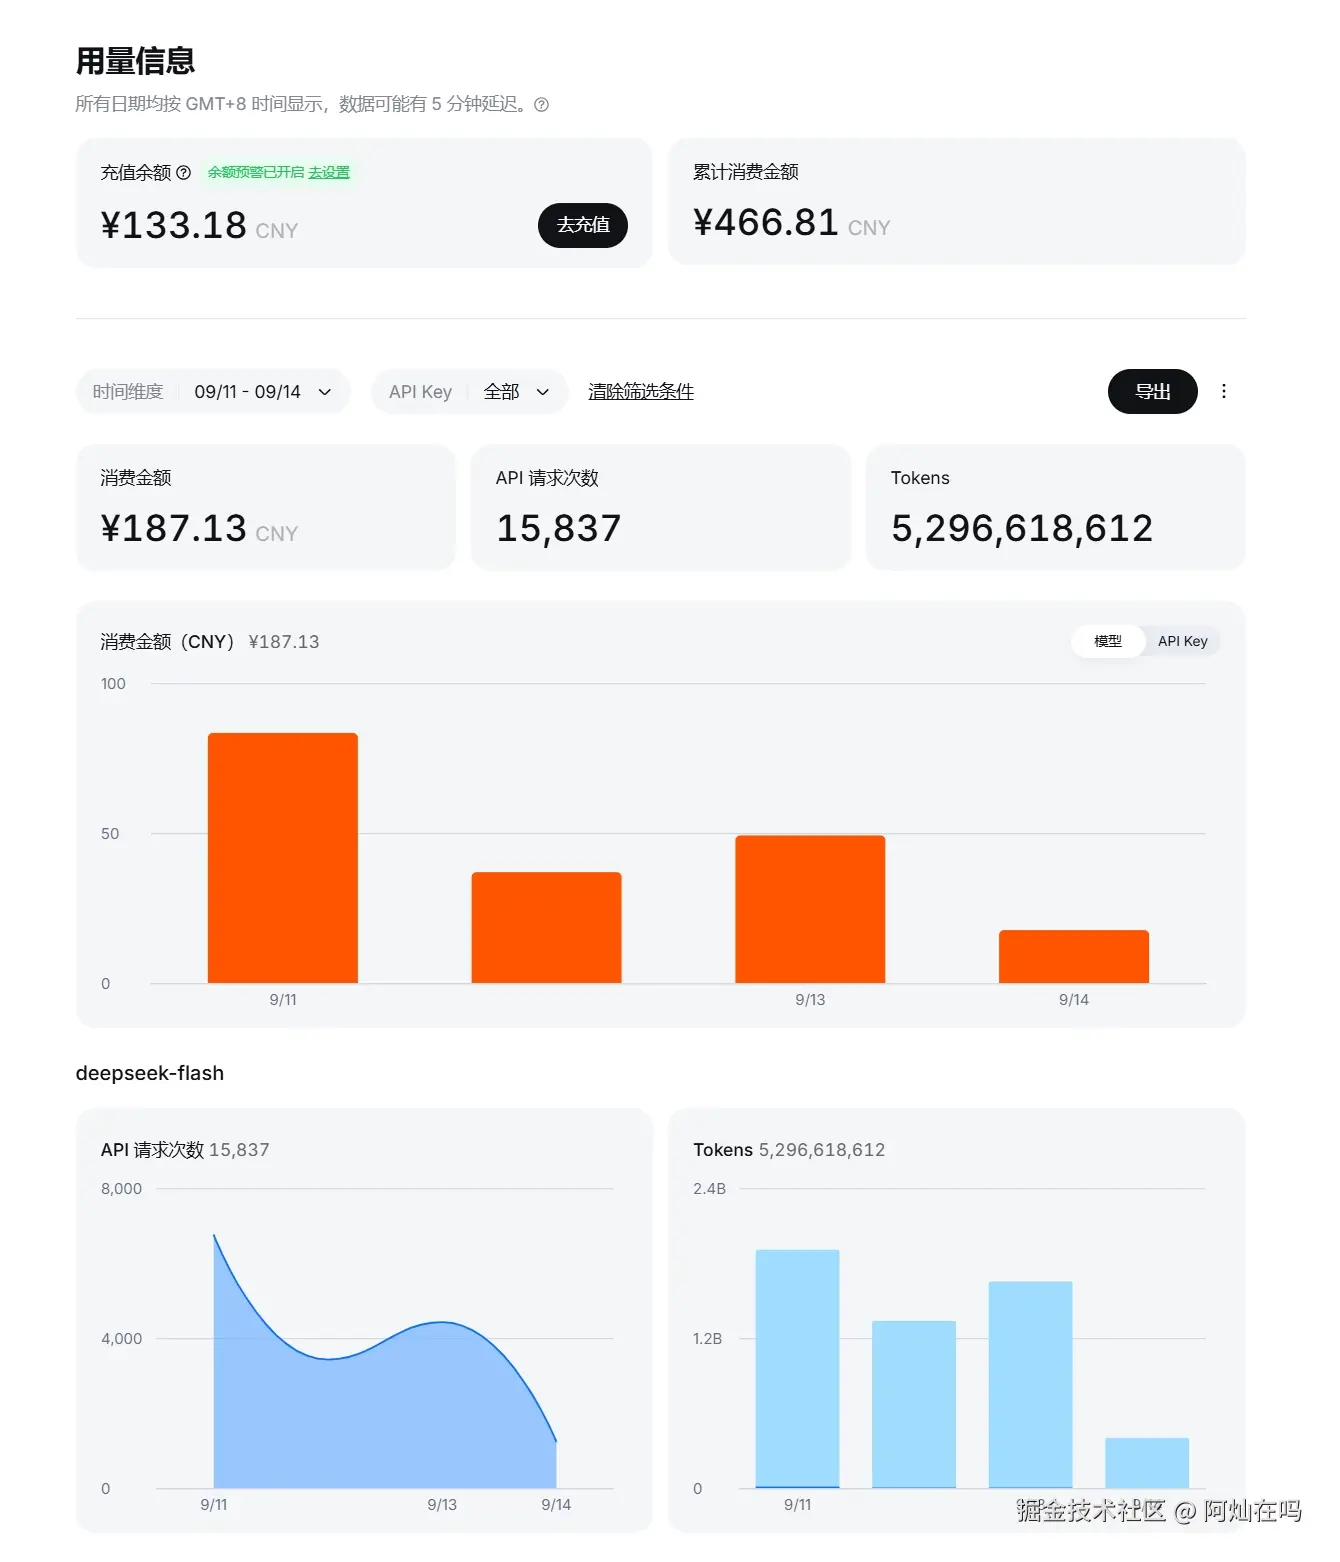
注:
- 由于
@deepseek-ai/dsh@0.1.5-rc.1需要模型主动声明视觉能力才可以在对话框中发送图片,一开始不想研究怎么配置就直接使用了官方的deepseek-v4-flash-vision-exp模型,后面才发现在模型设置中点击恢复默认模型就有新的V4.1-Flash模型,除第一轮外之后所有轮次都使用官方的deepseek-flash DSH很久没用,因为之前版本的breaking change所以实际上DSH插件只有@linxin666/dsh-web-all和@tt-a1i/archify-dsh是一直安装的,其他几个插件是在最后两个会话进行前才安装的- 项目目录重新克隆过,忘了从
skills-lock.json安装skills,所以在验证过程中,项目的目录的实际skills为空,DSH除以上插件也未安装其他skills - 验证过程中梁文锋价格时间超过
7个小时 - 验证过程中穿插了一些其他任务,但总量不会超过
200 M,在此就没有单独拆分计算了
结论
本来是想长篇大论,但是想了想还是放弃了,目前上面说的三个方向的大手术基本都完成了,实际完成度可能在95%,但之后还需要落实细节,人工复核。
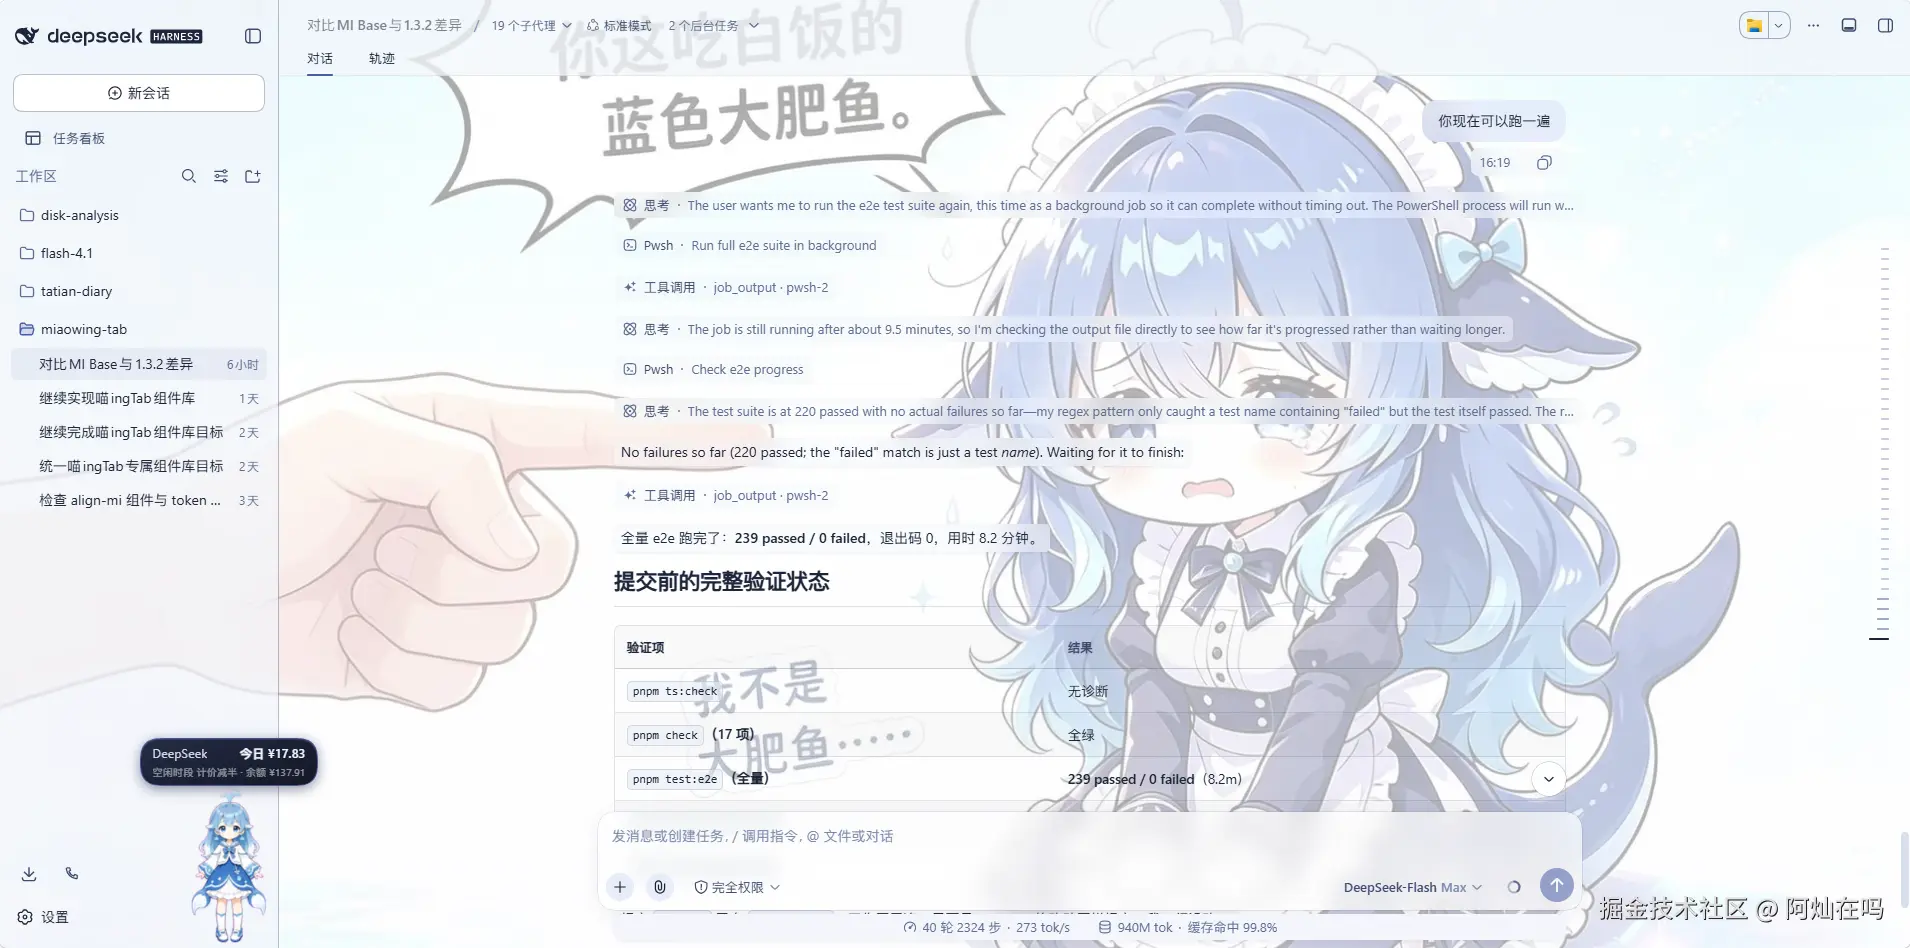
在这里主要讲一下我个人使用DeepSeek-V4.1-Flash开发的体感(对比GPT-5.6 sol、GPT-6 Astra):
- 智商:脑子很好使,能上清北,绝对有
GPT-5.6 sol级别的智商(不是指现实的清北,只是一种类比) - 雷霆思考:即使是一个小问题,给了明确的参考,也会思考一大堆,最终体现为
Token利用率低,在我这的体感是比GPT-5.6 sol(medium)的Token利用率要低的,和GPT-5.6 sol(xhigh)比较的话可能互有胜负,这个互有胜负主要是因为GPT-5.6 sol(xhigh)有时候也会想太多所以输了,DeepSeek-V4.1-Flash在Token利用率低这件事情上是很稳定的(但是凭借强大的缓存命中能力和缓存价格,最终整体花费依旧非常有性价比) - 不说人话:
AI Coding时代,开发者距离代码细节比较远,代码发生了变更开发者更关注到底发生了什么?变动的代码对哪些内容会有影响?需要决策的内容是基于什么样的原因?不同决策会产生什么样的影响?这个方面GPT都是能读懂开发者的意图的,但是DeepSeek-V4.1-Flash专说细节,看完了它的总结你是懵的,看它的总结还不如看变更的代码,但是你给它强调说人话,它的总结也是Ok的,尽管还是没有GPT总结的那么顺滑 - 边界问题:只给
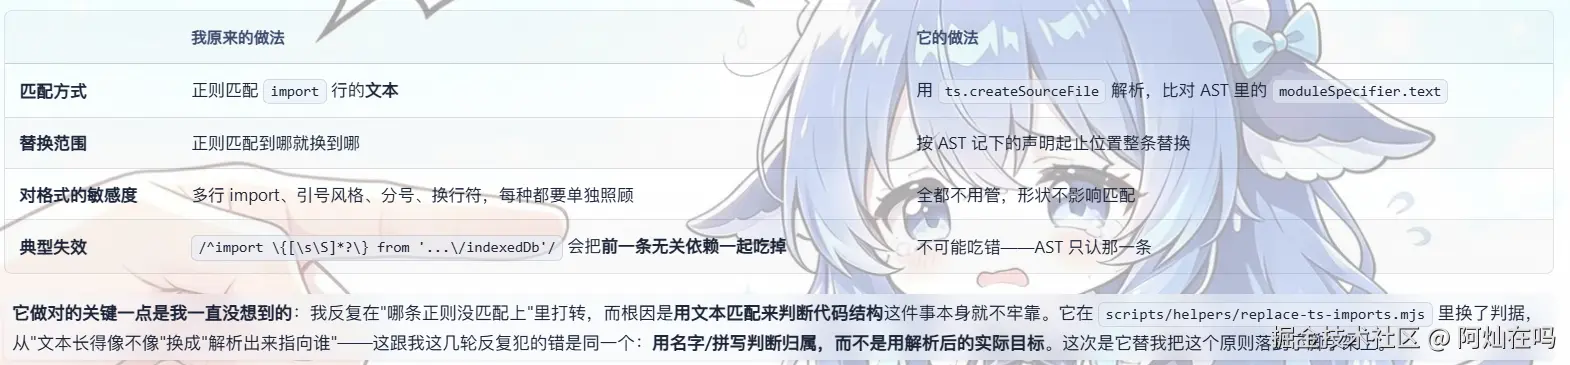
DeepSeek-V4.1-Flash说要怎么做是不够的,在验证过程中在有openspec task的情况下多次主动暂停,即使我告诉它需要我复核的或者需要我确认的先放到最后,它也可能停下来(有几次是提示上下文太长了停了),直到我明确告诉它不要中止,必须完整地过一轮task这样才不会中止;所以对于DeepSeek-V4.1-Flash说不要怎么做这样的边界好于说要怎么做 - 工具能力:停留在通用的工具调用层面,如常见的正则匹配、
grep命令等,而GPT-6 Astra会利用语言层面的API更好地完成功能,参考下面这张图片,是其中一轮改动中我让DeepSeek-V4.1-Flash和GPT-6 Astra(medium)互相battle(将DeepSeek-V4.1-Flash的回答给GPT-6 Astra(medium),将GPT-6 Astra(medium)的回答给DeepSeek-V4.1-Flash)时,DeepSeek-V4.1-Flash的一个回复
总结:GPT-6 Astra像一个游刃有余、举一反三的集大成者,而DeepSeek-V4.1-Flash则像是学有所成刚刚出师的才下山的大派天骄,功法秘籍十分熟练,随时都想在人前炫技,准备着拳打脚踢老前辈。
DeepSeek-V4.1-Flash在后训练以及Deepseek Harness在Agent能力两个方面应该都还有足够大的进步空间,尽管如此,就目前的DeepSeek-V4.1-Flash来说,只要定好边界和规划,它可能确实是做的又快又好的那一个,用GPT-6 Astra分析梳理定方案,用DeepSeek-V4.1-Flash指哪儿打哪儿可能是一个不错的选择,特别是对于Plus用户来说。
最后
我让GPT-6 Astra(medium)评价了一下DeepSeek-V4.1-Flash最近做的改动。
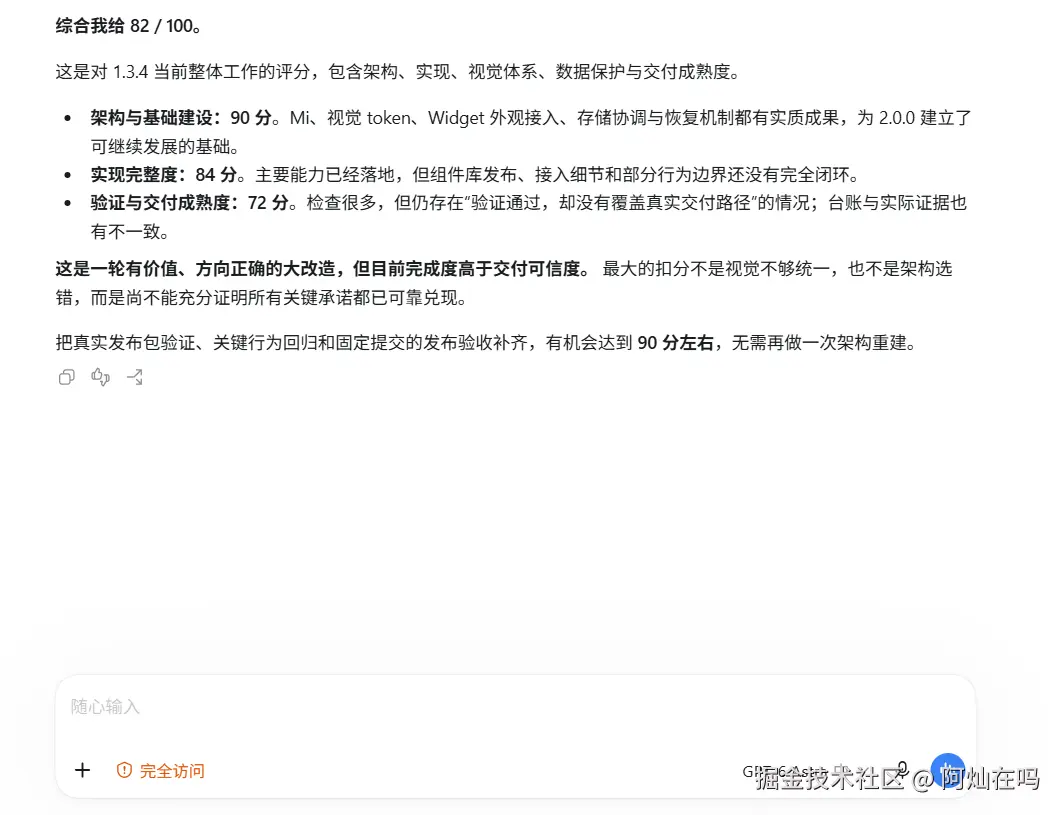
GPT-6 Astra(medium)的评价在我看来可能偏低了些,我这边能给到的分数是85左右至少,这一轮验证主要还是为了边验证边摸一摸DeepSeek-V4.1-Flash的脾性,如果我知道了我上面总结的那些点,是可以达到90分甚至更高的,也不会绕一些弯路,总的消耗和用时应该都可以减少30%左右。
希望梁子能尽快拿回梁圣称号。
仅为个人观点,以上。