你在界面上选中的那个模型名,未必就是真正给你算的那一个。
这不是猜测。OpenAI 开发者社区从 9 月初起有多起可复现的报告:请求侧的 metadata 明确写着 model_slug: gpt-5-6-thinking、thinking_effort: extended,而同一次请求最终的服务端 metadata 报的是 model_slug: gpt-5-5-mini,并伴随 did_auto_switch_to_reasoning: false、is_autoswitcher_enabled: false(来源:OpenAI Developer Community 报告帖,2026-09,含 HAR 与 turn trace 提交)。更值得工程同学注意的是一组对照实验。报告人用同一台机器、同一账号、同一 Plus 订阅、同一网络与 IP、同一 prompt、同一模型设置 ,只切换浏览器:Edge 解析到 gpt-5-6-thinking,Chrome 解析到 gpt-5-5-mini。把 Chrome 的 User-Agent 临时改成 Android 移动端后,服务端 metadata 立刻变成 gpt-5-6-thinking;改回桌面 UA 之后,路由保持 在 gpt-5-6-thinking。报告人还记录了一个未公开字段 a32e6ebcb 的取值从 1 变成 8(来源同上;该字段含义未知,报告人本人也只声称相关性,不声称因果 )。这组证据说明的不是「某家厂商在偷偷降级」,而是一件更基础的事:模型选择器里显示的名字,并不唯一地决定了这次请求最终由哪条计算路径服务。对做 AI 应用的人来说,这件事必须被观测。否则「我们的效果最近变差了」这句话,永远只能靠人肉感受去猜。## 一、证据链为什么能成立:两层 metadata 是分开的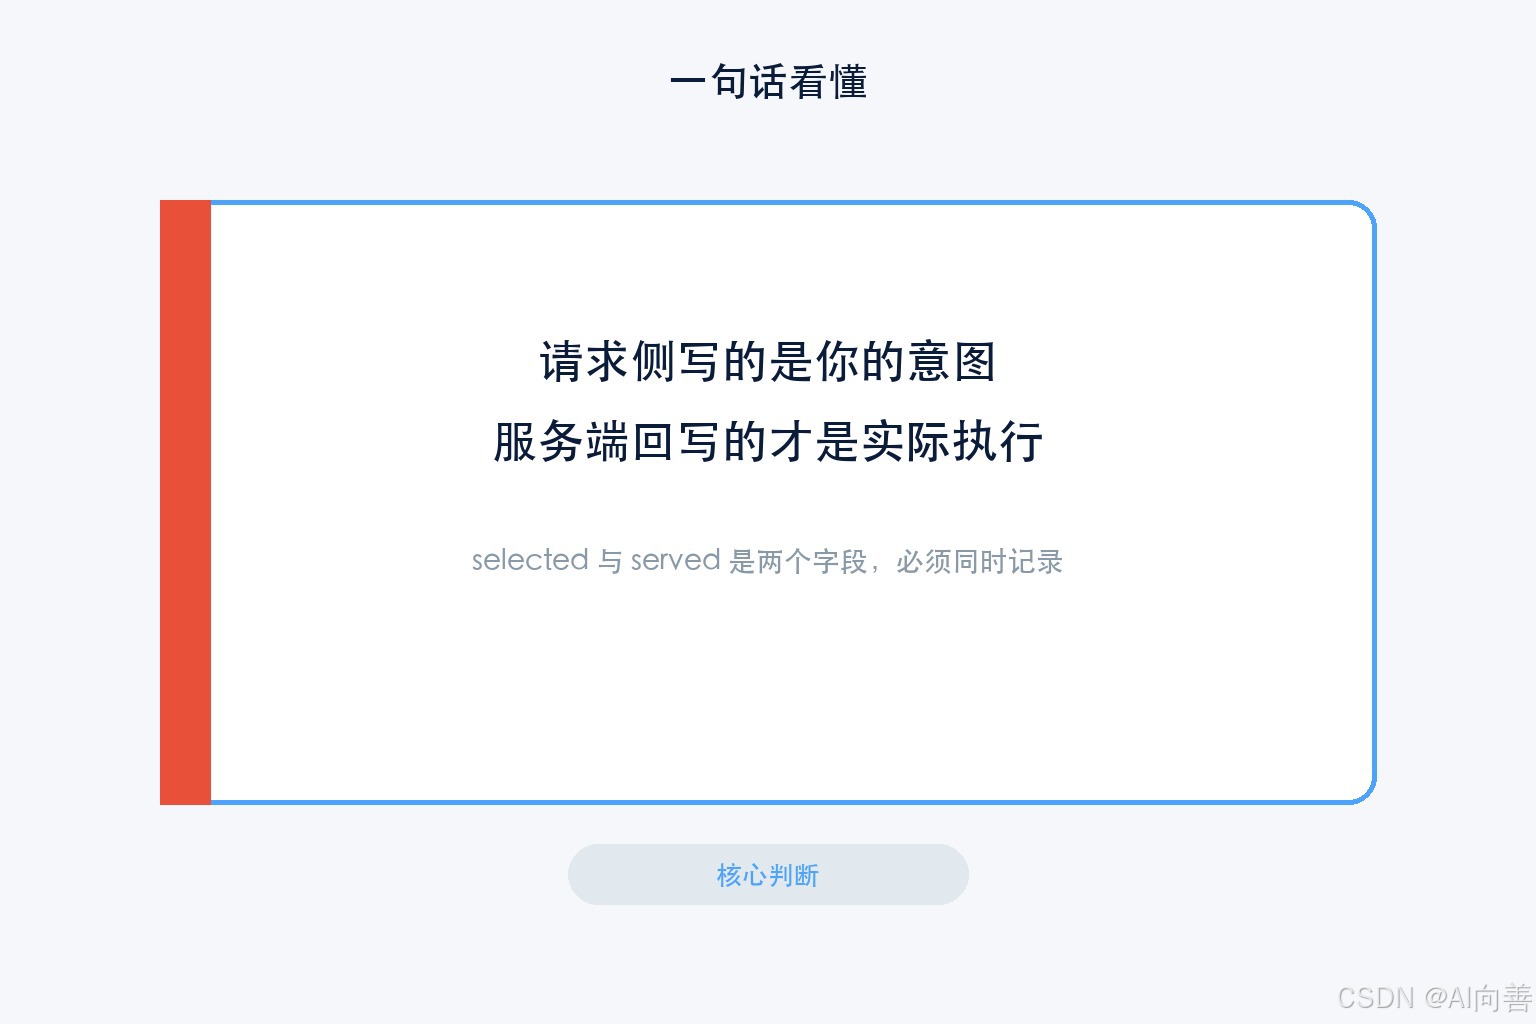 先把机制说清楚,后面的自证方法才有落点。一次请求里至少有两层模型标识:第一层是请求侧(客户端侧)。 你在界面上选了什么,客户端就往请求体里塞什么:
model_slug、default_model_slug、thinking_effort。这一层反映的是你的意图 。第二层是服务端侧。 请求进入平台后,服务端在流式响应的 metadata / telemetry 里回写它实际用了什么 :最终 model_slug、requested_model_experience、fast_convo、turn_use_case、user_agent 等字段。问题在于,绝大多数客户端只展示第一层。用户看到的是自己的意图,不是实际执行结果。 上面那组报告的价值就在于它同时拿到了两层,并且发现两者可以长期不一致,而且不一致会稳定地按客户端分组:同一账号在 Edge 上拿 thinking,在 Chrome 上拿 mini。既然是同一账号同时拿到两种结果,那么「账号级配额或风控」这个解释就不成立。
二、为什么这在任何多模型服务里都会发生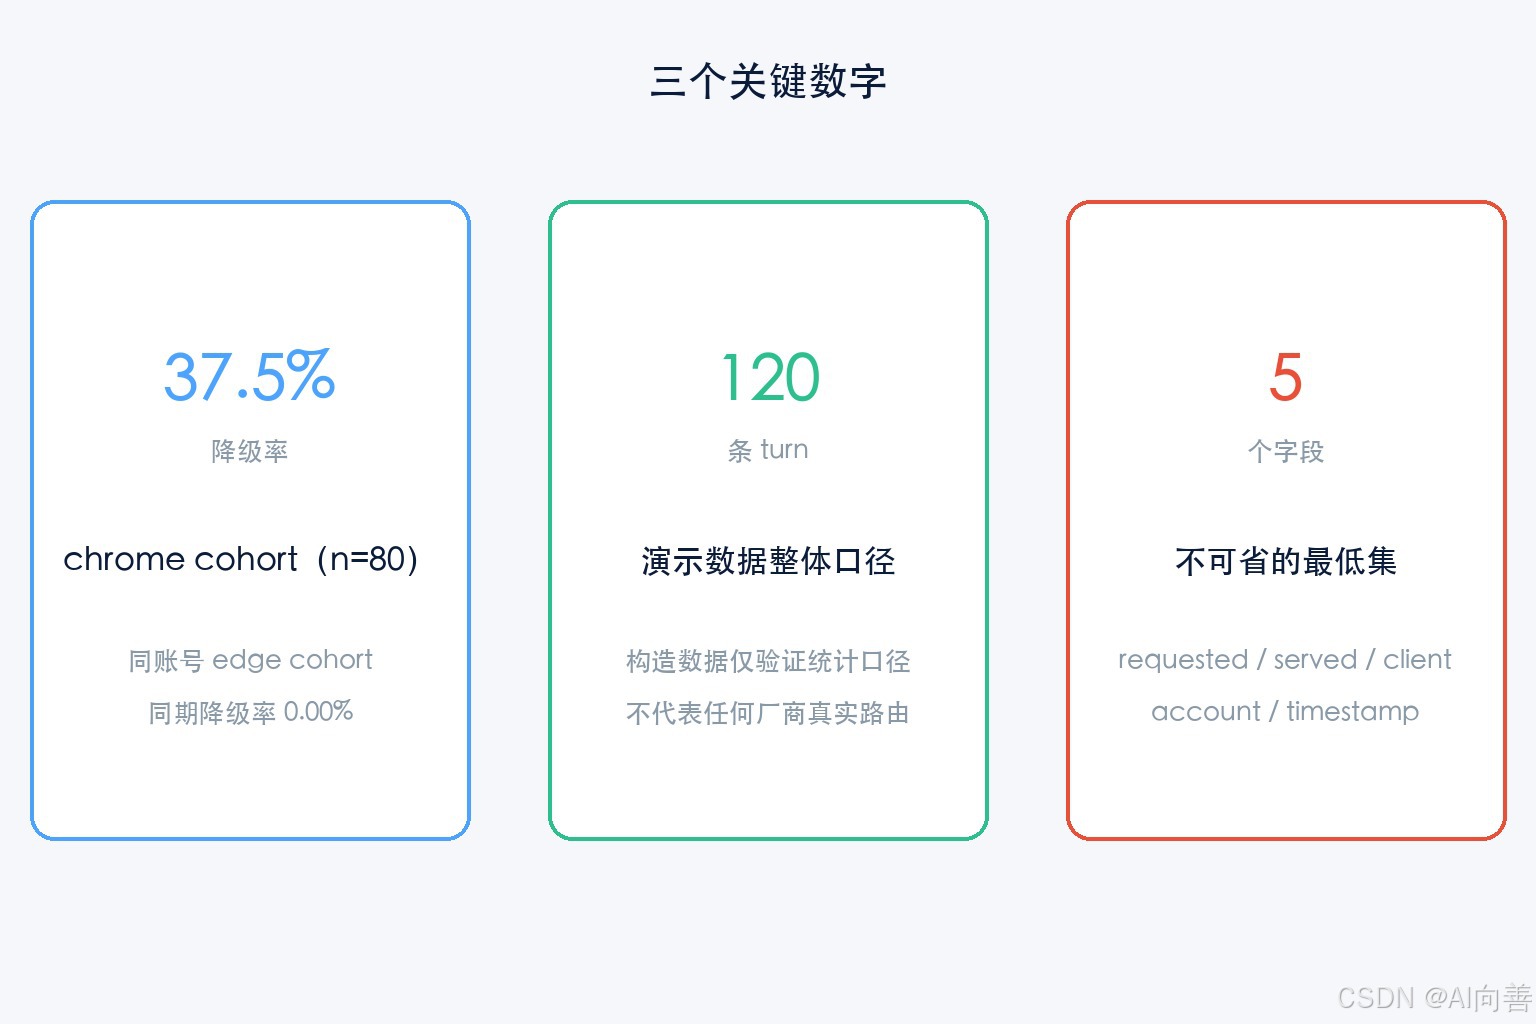 这里要说一句公道话:路由分层本身是正常设计,不是阴谋。一个前沿模型服务在上线期,请求在到达你选中的模型之前,会依次经过这些判断:1. 套餐与工作区权限 :哪些模型对你的 plan / workspace 可见;2. 配额与额度 :具体某个模型的用量是否耗尽(耗尽后按文档会「继续使用另一个可用的推理模型」);3. 风控信号:官方支持文档明确写了,「可疑活动(包含未知地点访问)」可能触发临时降级 ;订阅、套餐或支付信息变更期间也可能暂时限制能力;4. 容量与实验分组 :上线期容量紧张时,灰度与路由 cohort 会改变实际落点(Astra 上线期就出现过暂停 $200 Pro 20x 新订阅的容量动作);5. 回退(fallback) :主路径不可用时切到备用模型。这五层里,任何一层都能让「请求 A、执行 B」成立。比如套餐与工作区权限会决定哪些模型对你可见;比如某个具体模型的用量耗尽后,按官方文档会「继续使用另一个可用的推理模型」。所以真正的问题不是「有没有路由」,而是你有没有把路由结果记录下来 。五层里的任何一层,都能让「请求 A、执行 B」成立。换个角度说,这是可观测性问题,不是信任问题。 你不需要先证明有人在降级,才去记录实际使用的模型;恰恰相反,只有记录了,你才有可能知道。## 三、实测:3 步把「真实路由」变成可审计的数据
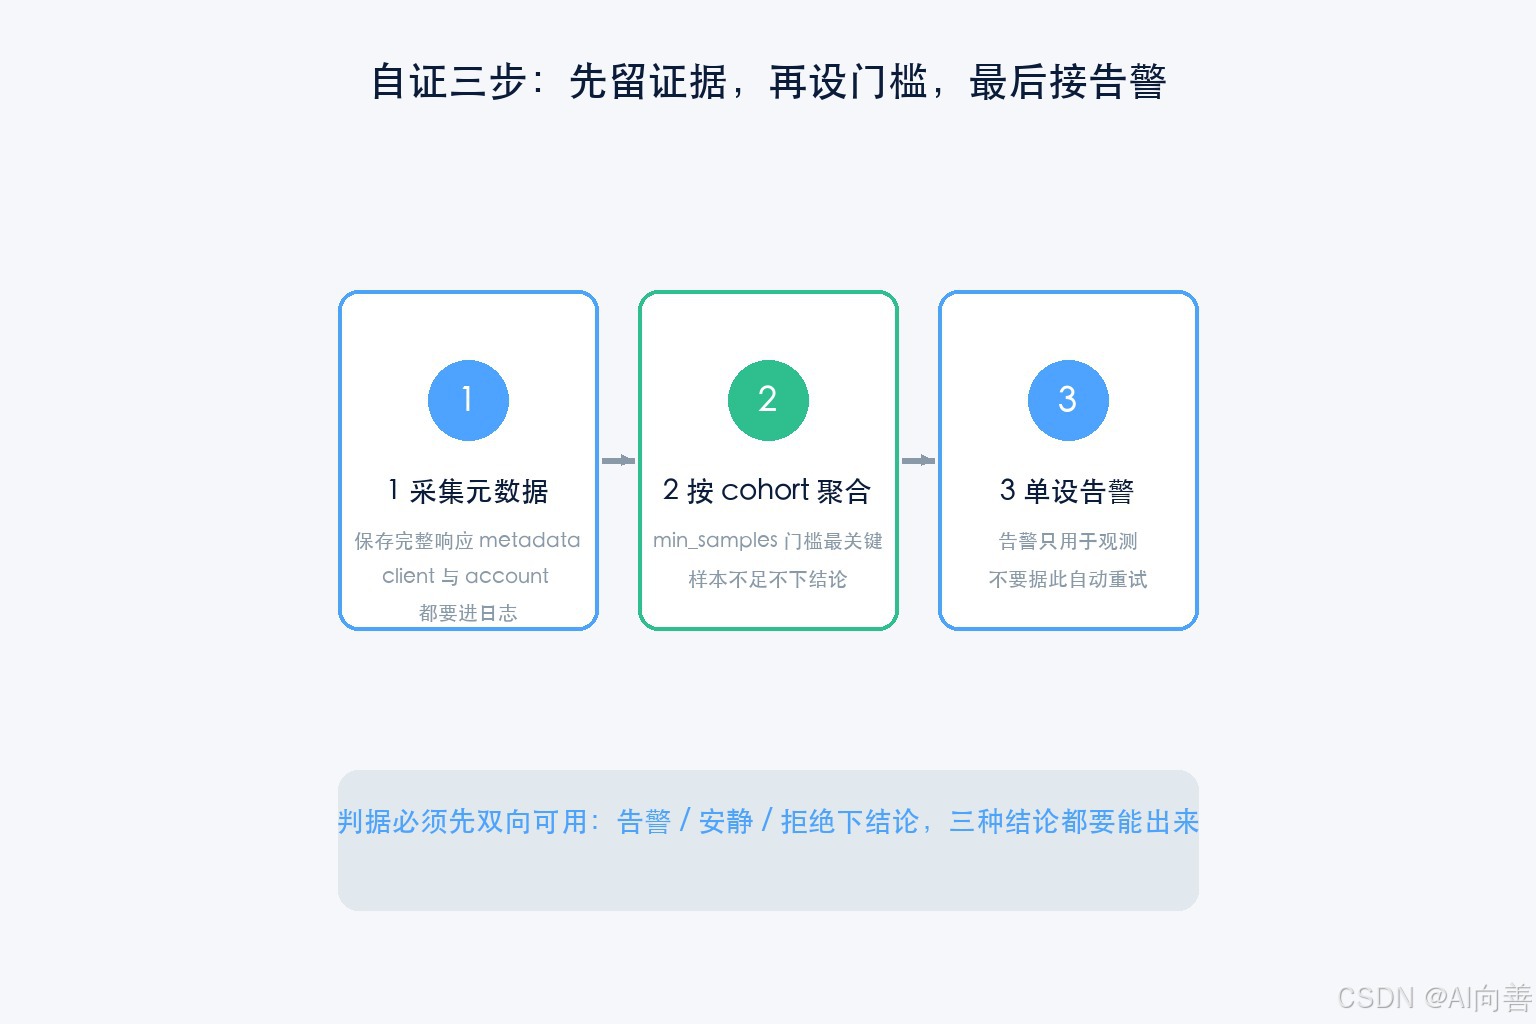 下面这套做法的目标很单一:让每一次请求都留下「我要什么」和「实际给我什么」两个字段,然后按 cohort 聚合。### 第 1 步:采集服务端 metadata,而不是只看请求侧关键动作是保存完整响应 metadata,包括未公开字段。你可以用一段最小拦截逻辑,把两层都写进日志:```pythonimport json, time, uuiddef record_turn(client, account, requested, resp_meta): """requested = 你请求的模型;resp_meta = 服务端回写的 metadata""" return { "ts": time.strftime("%Y-%m-%dT%H:%M:%SZ", time.gmtime()), "turn_id": str(uuid.uuid4()), "client": client, # 浏览器/客户端标识:cohort 维度之一 "account": account, # 账号:用于排除「账号级配额」假设 "requested": requested, # 请求侧:我的意图
"served": (resp_meta or {}).get("model_slug"), # 服务端侧:实际执行 "reasoning_effort": (resp_meta or {}).get("thinking_effort"), "auto_switched": (resp_meta or {}).get("did_auto_switch_to_reasoning"), "latency_ms": (resp_meta or {}).get("total_ms"), }```**注意两个设计选择**:`client` 和 `account` 都必须进日志。前者用于复现上面那组「同账号跨客户端」的对照,后者用于否掉「账号级风控」这一类解释。少了任何一个,你都无法判定差异来自哪里。### 第 2 步:按 cohort 聚合降级率,并且给样本量设门槛拿到 JSONL 之后,用下面这段脚本算降级率。完整可运行版本已随本文给出。```pythondef normalize(model: str) -> str: m = (model or "").strip().lower() for needle, canon in (("astra", "gpt-6-astra"), ("thinking", "gpt-5.6-thinking"), ("mini", "gpt-5.5-mini"), ("sol", "gpt-5.6-sol")): if needle in m: return canon return m or "unknown"def audit(rows, min_samples=20, rate_gate=0.05): cohorts = {} for r in rows: key = f"client={r.get('client')}|account={r.get('account')}" cohorts.setdefault(key, []).append(r) alerts, groups = [], [] for key, sub in sorted(cohorts.items()): n = len(sub) rate = sum(1 for r in sub if normalize(r["requested"]) != normalize(r["served"])) / n rec = {"cohort": key, "n": n, "downgrade_rate": round(rate, 4)} if n < min_samples: rec["verdict"] = "insufficient_samples" # 样本不够,只展示不判分 else: rec["verdict"] = "alert" if rate > rate_gate else "ok"
if rec["verdict"] == "alert": alerts.append(rec) groups.append(rec) return {"groups": groups, "alerts": alerts, "verdict": "alert" if alerts else "ok"}```**`min_samples` 这道门槛是全文最重要的工程细节。** 我见过太多次这样的排查:某天发现 1 个请求被降级了,降级率 100%,于是拉响告警;第二天一切正常,告警自动消失,团队白折腾一轮。**样本不足时,「100% 降级率」和「0%」一样没有信息量。** 所以脚本里把三种结论分开:告警、正常、样本不足。跑起来的命令:```bash# 第 3 步之前,先确认判据本身双向可用python route_metadata_audit.py --selftest# 审计真实记录python route_metadata_audit.py --jsonl turns.jsonl --min-samples 20 --rate 0.05 \ --json route_audit_report.json```自检输出(本地实跑):```bash$ python route_metadata_audit.py --selftest=== route_metadata_audit 自检 === 正控 充足样本+高降级率: ✅ 告警 (rate=33.3%) 负控 全健康: ✅ 未告警 小样本控制 n=1 100%降级: ✅ 拒绝下结论 判据三向可用(告警/安静/拒绝) → ✅ 通过```**下面用 120 条演示记录跑一遍**(演示数据为构造数据,用于验证口径,不代表任何厂商真实路由)。这份数据里,`chrome` cohort 有约四成请求落在 `gpt-5-5-mini`,`edge` cohort 全部命中请求模型:```bash$ python route_metadata_audit.py --jsonl _route_turns_demo.jsonl --min-samples 20总 turn 数:120 整体降级率:25.00%(样本门槛 20,低于门槛的 cohort 只展示不判分)🔴 client=chrome|account=acct-A n=80 降级率=37.50% 尾部延迟=11800ms → alert 证据:请求 gpt-5-6-thinking → 实际 gpt-5-5-mini✅ client=edge|account=acct-A n=40 降级率=0.00% 尾部延迟=11800ms → ok🔴 存在降级告警,请按下方动作排查```这张输出的价值在最后一列:**两个 cohort 同账号、同网络、同设置,降级率 37.5% 对 0%。** 这种差异不可能用「你的账号被风控了」解释,因为账号是同一个。第 3 步:把「请求侧 ≠ 服务端侧」单独设成一条告警前两步做好之后,第三步是接线:为这个差值单独设一条监控,而不是等用户抱怨质量。告警文案至少包含 cohort、样本量、降级率、以及一组 request/served 对照证据。同时要克制一件事:告警只用于观测,不要据此自动重试。 官方支持文档把「异常设备、地点、并发会话、VPN 与代理」列为可疑活动的信号来源;自动重试恰好会制造这类信号。用观测换确定性,别用重试赌运气。比如上面那段 normalize(),就是为了让 gpt-5.6-thinking 和 GPT-5.6 Thinking 不会被算成两条不同的路径(来源:本地实跑,2026-09-14)。## 四、工程取舍与踩坑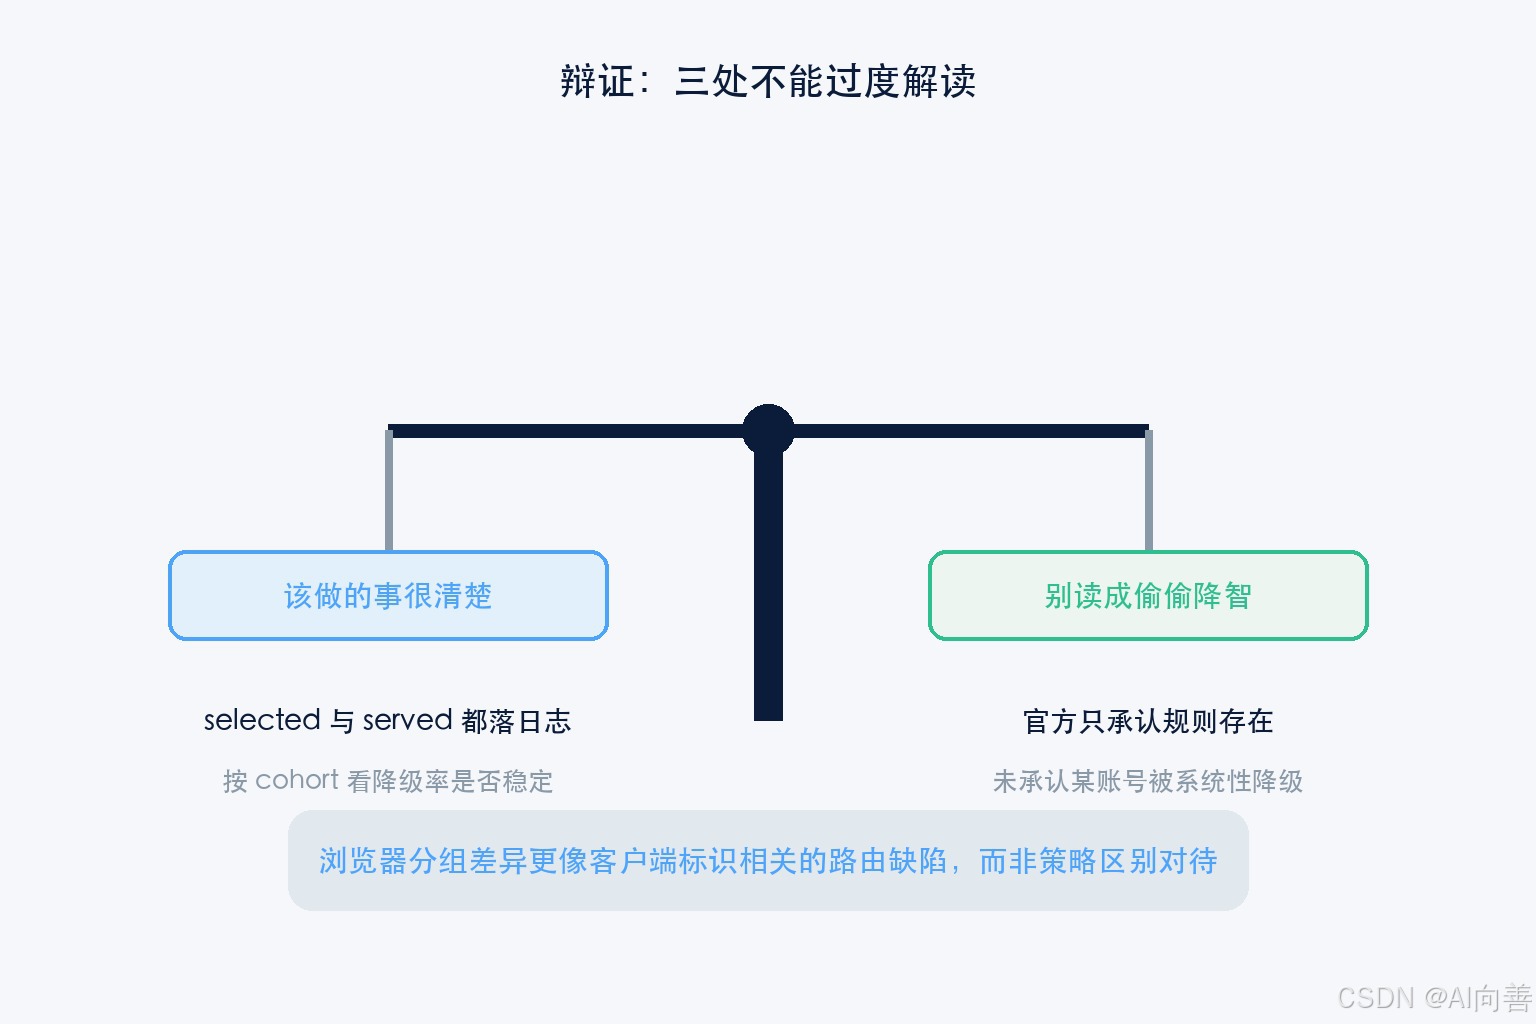 取舍一:采样率可以降,字段不能少。 高并发场景下全量落日志成本不低,可以把采样率降到 10%,但
requested、served、client、account、timestamp 这五个字段一个都不能省。少了 served 就等于没做这件事。取舍二:模型别名必须归一化。 gpt-5.6-thinking / gpt-5-6-thinking / GPT-5.6 Thinking 是同一个模型,不归一化会把同一路径拆成多条 cohort,降级率算出来完全不可信。脚本里那段 normalize() 不是装饰。取舍三:不要为了让数字好看而调阈值。 我第一次跑演示数据时降级率 25%,觉得太高想调 rate 门槛。正确做法是调 min_samples 和看 cohort 分布,而不是调 rate。 门槛调低只会让你看不见问题。踩坑一:把「未公开字段」当成因果。 报告里那个 a32e6ebcb 字段随路由变化而变值,很容易被读成「它就是原因」。报告人自己明确说了只声称相关性。字段含义未公开之前,任何因果结论都是猜测 。踩坑二:日志脱敏。 采集完整 metadata 很容易顺手把 session token、cookie、会话 ID 一起写进日志。上面脚本只取白名单字段,就是为了避开这个坑:要观测的是路由,不是用户身份。**踩坑三:别用一次对照定结论。 单次跨浏览器对照可能是缓存或实验分组造成的。要跨天、跨时段多轮采样,再看 cohort 降级率是否稳定。## 五、辩证:这件事有三处不能过度解读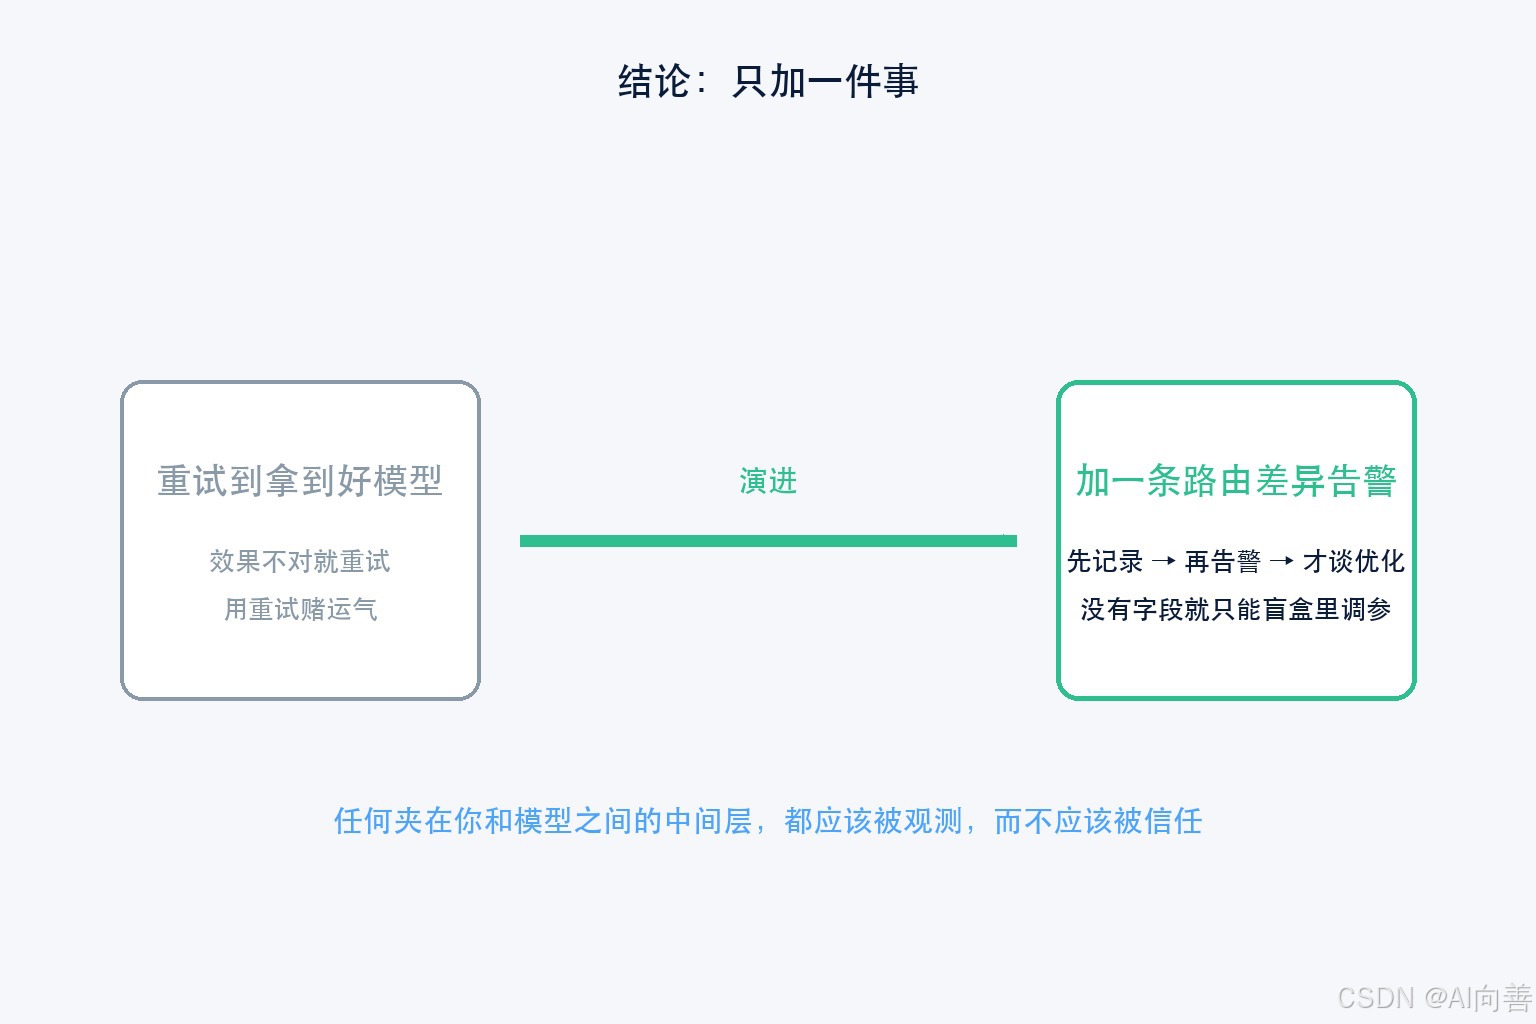 需要警惕的是,这类实测极容易被讲成「厂商在偷偷给用户降智」。这几条边界必须划清。第一,厂商没有承认账号级降级。 官方文档承认的是「可疑活动可能触发临时降级」和「订阅、套餐或支付信息变更期间可能暂时限制能力」这两条规则存在**,并没有承认某个特定账号被系统性降级。把「有控制能力」读成「一定在针对你」,是过度推断。
第二,社区本身也有反方向证据。 有开发者认为 Astra 的问题从上线那天就存在,只是首发周大家被惊艳到、后面测多了才发现毛病,也就是时间线是反的 。另有报告指出,部分请求的客户端 metadata 一开始就报 gpt-5-5-mini,那属于客户端侧的问题,不是服务端降级。同一个现象,至少有「服务端路由」「客户端 bug」「感知漂移」三种解释,本文只提供把它区分开的方法,不提供结论。**第三,浏览器分组差异更可能是一个 bug。 同一账号在 Edge 上正常、Chrome 上异常,这个形态更像是客户端标识相关的路由缺陷或实验分组,而不是策略性的区别对待。报告人自己也把可能原因列为「浏览器/客户端特定的灰度、路由 cohort、后端缓存的路由状态、特性开关交互、浏览器特定的路由 bug」,并注明 只有厂商能确认**。另一个角度:把这件事当成「模型不可信」的理由,是找错了敌人。 真正的问题是你没有可观测性。任何一家做多模型路由的服务(包括你自己的网关)都可能出现同样的形态,而能自证的团队会先发现问题、先止损。## 六、所以你的系统里该加什么如果只加一件事,我建议加一条路由差异告警 ,而不是加一个「重试直到拿到好模型」的逻辑。因为这次争议里最实用的结论只有一句:「选中的模型」和「实际执行的模型」是两个字段,你必须同时记录。 记录之后,你才第一次拥有把「效果变差」拆解成「模型变了 / 路由变了 / 提示词变了」的能力。在那之前,所有的优化都是在盲盒里调参。对做 AI 应用的人来说,还有一条更通用的推论:任何把你和模型之间的中间层,都应该被观测,而不应该被信任。 这包括厂商的路由层,也包括你自己写的那一层。---**你如果在生产环境里跑过多模型,欢迎在评论区聊聊:**1. 你的请求日志里,有没有同时记录「请求的模型」和「实际返回的模型」?如果没有,打算怎么补?2. 你有没有遇到过效果突然变差、最后定位到是路由或回退造成的?当时是怎么发现的?3. 如果给你一次机会加一条监控,你会先加哪个:路由差异、尾部延迟,还是单任务成功率?数据与事件来源 - 请求侧与服务端 metadata 不一致(model_slug: gpt-5-6-thinking → 服务端 gpt-5-5-mini)、同账号跨浏览器对照(Chrome → mini / Edge → thinking)、UA 改动后路由变化、未公开字段 a32e6ebcb:OpenAI Developer Community 报告帖(2026-09,报告人已提交 HAR 与 turn trace,Support Case #13600924);个人实测口径,厂商未回应,字段含义未公开,报告人仅声称相关性 。- 「可疑活动(含未知地点访问)可能触发临时降级」「订阅、套餐或支付信息变更期间可能暂时限制能力」:OpenAI 支持文档与欧洲隐私政策口径,经 CTOL Digital 综述;规则存在 ≠ 某账号被降级,两者不可混读。
- 「额度耗尽后继续使用另一个可用的推理模型」「$200 Pro 20x 新订阅暂停」「上线期容量压力」:OpenAI 官方说明与公开报道,经 felloai、CTOL Digital 综述。- 「模型从上线起就是该水平、时间线是反的」「部分请求客户端侧 metadata 初始即报 mini」:开发者公开社交平台发言,经 cryptocortex-ai 综述;社区观点,未经交叉验证 。- 本文脚本
route_metadata_audit.py已随文给出;--selftest的正控/负控/小样本控制在本地实测通过(输出为实跑结果,未做美化)。文中的 120 条记录为构造的演示数据 ,仅用于验证统计口径,不代表任何厂商的真实路由行为 。- 浏览器 UA 与路由 cohort 的关联目前只有相关性、没有因果证据,厂商未确认,请勿据此在生产环境做自动重试或规避动作。