文章目录
导读
论文标题:Learning a Diffusion Model Policy from Rewards via Q-Score Matching(ICML 2024)
项目地址:https://github.com/escontra/score_matching_rl
该论文发表于ICML 2024 ,由 UC Berkeley 的 Pieter Abbeel、Yi Ma 团队合作完成,是扩散模型与强化学习(RL)结合方向的兼具理论创新与算法落地的代表性工作。它针对扩散策略在强化学习中优化效率低、计算不稳定的痛点,提出了Q - 分数匹配(Q-Score Matching, QSM) 框架,从理论上建立了扩散策略与 Q 函数的关联,并实现了高效、稳定的离策略算法。
背景动机
在机器人控制等连续动作场景中,策略 π ( a ∣ s ) π(a|s) π(a∣s)(给定状态下动作的概率分布)的参数化是核心问题:
传统方案 大多采用高斯分布,优点是采样简单、计算便捷;本质缺陷 是只能建模单峰分布,无法刻画多模态最优策略(例如摆杆起摆任务中,向左、向右两个对称的最优动作方向),容易导致探索不充分、策略收敛到次优解。
扩散模型进入 RL 领域的现状
扩散模型凭借强大的任意分布建模能力,在生成式 AI 取得突破后被引入 RL 用于策略表示:
- 核心优势:可建模复杂连续分布,采样无需计算归一化常数,兼具表达力与采样效率;
- 现有应用的局限:
- 行为克隆(BC)场景:直接用专家数据做分数匹配训练扩散策略,适配性好,但只能模仿、无法从奖励信号中优化;
- 离线 RL / 策略梯度场景:要么沿用简单的 BC 损失,要么直接对整个扩散过程做策略梯度,存在样本效率低、计算复杂度高、梯度易消失 / 爆炸的问题 ------ 扩散模型是多步迭代过程,反向传播需要穿过所有扩散步,计算代价高且数值不稳定。
本文要解决的核心问题 是能否利用扩散模型本身的 score-based 结构,设计一种更高效、更稳定的策略优化方法,让扩散策略能直接从奖励中学习,同时保留扩散模型的表达力优势?
方法框架
核心思想:Q-Score Matching (QSM)
论文的核心洞察是:策略的分数(score,即 ∇ a l o g π ( a ∣ s ) ∇ₐ log π(a|s) ∇alogπ(a∣s))与 Q 函数对动作的梯度 ∇ a Q π ( s , a ) ∇ₐ Q^π(s,a) ∇aQπ(s,a) 在最优性上存在天然的对齐关系。
- 策略的 score:描述动作分布的对数概率在动作空间的变化方向,决定了扩散模型的去噪漂移方向,是扩散模型的本质参数;
- Q 函数的动作梯度 ∇ a Q ∇ₐQ ∇aQ:描述动作朝哪个方向调整,能让期望累积奖励最大化;
- Q - 分数匹配:迭代地让策略的 score 向 Q 函数的动作梯度对齐,就能单调提升策略的期望奖励。
这种方法的本质优势是:仅需训练扩散模型内部的去噪网络(score 网络),无需反向传播整个扩散采样过程,从根本上解决了传统策略梯度应用于扩散模型的计算痛点。
Diffusion‑QL:把整个扩散采样流程嵌入计算图,把采样出来的动作送入 Q 网络求损失,损失反向传播穿过全部 K 步去噪采样过程 更新去噪网络。
QSM 的 actor 损失是: L actor = E ∥ Ψ ϕ ( s , a ) − ∇ a Q ( s , a ) ∥ 2 \mathcal L_{\text{actor}}=\mathbb E\left\\left\\\|\\Psi_\\phi(s,a)-\\nabla_a Q(s,a)\\right\\\|\^2\\right Lactor=E∥Ψϕ(s,a)−∇aQ(s,a)∥2, ( s , a ) (s,a) (s,a)来自回放缓冲区的真实采样得到的 (s,a) 数据 ,不是当前模型从头扩散生成出来的;监督信号是Q 函数对动作 a 求导得到目标 ∇ a Q ( s , a ) \nabla_aQ(s,a) ∇aQ(s,a) ;损失只在单次网络前向 上构建,反向传播只经过一次 score 网络调用,不跑整条 K 步去噪链。
问题建模:连续时间 SDE 与扩散模型的桥梁
将状态空间记为欧氏空间 S = R s \mathcal S=\mathbb R^s S=Rs,动作空间记为另一欧氏空间 A = R a \mathcal A=\mathbb R^a A=Ra。本文理论部分考虑如下随机连续时间的状态、动作动力学:
d s = F ( s , a ) d t + Σ s ( s , a ) d B t s , d a = Ψ ( s , a ) d t + Σ a ( s , a ) d B t a , s ( 0 ) = s 0 , a ( 0 ) = a 0 . (1) \begin{align*} ds &= F(s,a)dt + \Sigma_s(s,a)dB_t^s,\\ da &= \Psi(s,a)dt + \Sigma_a(s,a)dB_t^a,\\ s(0) &= s_0,\\ a(0) &= a_0. \end{align*} \tag{1} dsdas(0)a(0)=F(s,a)dt+Σs(s,a)dBts,=Ψ(s,a)dt+Σa(s,a)dBta,=s0,=a0.(1)
Ψ : S × A → A \Psi: \mathcal S\times\mathcal A \to \mathcal A Ψ:S×A→A对应策略的分数 ,也是本场景下策略优化的核心待求参数。
F : S × A → S F:\mathcal S\times\mathcal A \to \mathcal S F:S×A→S 代表连续时间状态动力学;
Σ s ( s , a ) , Σ a ( s , a ) \Sigma_s(s,a),\Sigma_a(s,a) Σs(s,a),Σa(s,a)是从 S × A \mathcal S\times\mathcal A S×A映射到半正定矩阵的函数,维度分别为 R s × s \mathbb R^{s\times s} Rs×s与 R a × a \mathbb R^{a\times a} Ra×a,对应状态、动作动力学中不确定性的协方差结构。 B s , B a B^s,B^a Bs,Ba是相互独立的布朗运动,分别嵌入状态空间 S \mathcal S S与动作空间 A \mathcal A A。
机器人控制、工业控制等场景中,时间、状态、动作本质都是连续变化的,而不是离散跳跃的,连续时间建模比离散步长更贴合真实动力学。
diffusion 本质就是SDE的离散近似。把动作建模为连续SDE,就能自然地和diffusion 建立严格等价关系,进而用随机过程的成熟理论推导策略优化方法。
已有大量工作在连续时间状态 / 动作框架下构建强化学习,但将动作与状态联合建模为一套动力学系统的研究相对少见。当把这套理论结构和扩散模型建立联系时,该联合建模就体现出重要价值。
传统 动作是状态的显式函数 a ( t ) = π ( s ( t ) ) a(t)=\pi(s(t)) a(t)=π(s(t)),给定状态直接输出动作值;
本文 动作本身是一个独立的连续随机过程,有自己的演化规律 ------动作的变化率由 Ψ ( s , a ) \Psi(s,a) Ψ(s,a)决定,而非动作本身由s直接生成。这个特殊设计正是为了匹配扩散模型的结构。
式 (1) 中的动作模型并非常规形式:动作 a ( t ) a(t) a(t)被建模为随时间平滑演化的流,而不是状态 s ( t ) s(t) s(t)的显式函数。该模型的动机来自:通过欧拉 - 马尔亚马(Euler-Maruyama)方法对时间离散,并且在状态动力学与动作动力学采用不同时间尺度离散化,得到:
s t + 1 = s t + F ( s t , a t ) + z , z ∼ N ( 0 , Σ s ( s t , a t ) ) , a t i = a t i − 1 + 1 K Ψ ( s t , a t i − 1 ) + z t i , z t i ∼ N ( 0 , 1 K Σ a ( s t , a t i − 1 ) ) , a t + 1 = a t K , (6) \begin{align*} s_{t+1} &= s_t + F(s_t,a_t)+z,\; z\sim\mathcal N(0,\Sigma_s(s_t,a_t)),\\ a_t^i &= a_t^{i-1}+\frac1K\Psi(s_t,a_t^{i-1})+z_t^i,\\ z_t^i &\sim\mathcal N\left(0,\frac1K\Sigma_a(s_t,a_t^{i-1})\right),\\ a_{t+1} &= a_t^K, \end{align*} \tag{6} st+1atiztiat+1=st+F(st,at)+z,z∼N(0,Σs(st,at)),=ati−1+K1Ψ(st,ati−1)+zti,∼N(0,K1Σa(st,ati−1)),=atK,(6)
式中 a t i : = a t + i / K a_t^i:=a_{t+i/K} ati:=at+i/K。
环境状态只走1 大步 ,但是动作在这同一时间段内跑K 小步 ; s t s_t st全程固定不变,驱动 K 次动作迭代; K 次动作迭代 = 条件扩散模型的 K 步去噪生成动作;K越大,上一时刻输出动作 a t − 1 a_{t-1} at−1的记忆就越弱,动作更多由当前状态 s t s_t st决定。
在状态动力学离散化的同一时间步内,对动作动力学进行K次离散,由此得到深度为K、时间不变的扩散模型 ;其中去噪均值由 Ψ \Psi Ψ表示,方差由 Σ a \Sigma_a Σa表示。
在同一个环境步 s t s_t st内部做K次迭代,是为了得到复杂多模态条件分布 π ( a ∣ s t ) \pi(a|s_t) π(a∣st),这是diffusion 的核心能力。
只有跌倒到第K步的终点,才近似是目标稳态分布的样本,类比 MCMC / 朗之万采样里的 burn‑in(预热期):前面若干步是预热,要丢弃,只取预热完成之后的样本。
传统扩散策略梯度的固有缺陷
回顾策略梯度的定义:全局目标 J ( θ ) = E s , a Q π ( s , a ) J(\theta)=\mathbb{E}_{s,a}Q^\pi(s,a) J(θ)=Es,aQπ(s,a)的梯度由下式给出(Sutton 等人,1999):
∇ θ J ( θ ) = E ( s 0 , a 0 , s 1 , a 1 , ... ) ∑ t = 1 ∞ Q ( s t , a t ) ∇ θ log π θ ( a t ∣ s t ) (7) \nabla_\theta J(\theta)=\underset{(s_0,a_0,s_1,a_1,\dots)}{\mathbb{E}}\sum_{t=1}^{\infty}Q(s_t,a_t)\nabla_\theta\log\pi_\theta(a_t|s_t) \tag{7} ∇θJ(θ)=(s0,a0,s1,a1,...)Et=1∑∞Q(st,at)∇θlogπθ(at∣st)(7) 该期望是关于策略 π \pi π与环境动力学共同服从的分布。
针对时间离散化后的扩散策略,我们无法直接获得全局概率 π ( a ∣ s ) \pi(a|s) π(a∣s),只能得到扩散模型内部的增量转移概率 π ( a τ ∣ a τ − 1 , s ) \pi(a^\tau|a^{\tau-1},s) π(aτ∣aτ−1,s)(上标 τ \tau τ代表扩散模型的内部时间步),并且需要对全部可能路径积分,得到:
π ( a K ∣ s ) = ∫ a K − 1 ⋯ ∫ a 1 π ( a 1 ∣ s ) ∏ τ = 2 K π ( a τ ∣ a τ − 1 , s ) d a 1 ... d a K − 1 (8) \pi(a^K|s)=\int_{a^{K-1}}\dots\int_{a^1}\pi(a^1|s)\prod_{\tau=2}^{K}\pi(a^\tau|a^{\tau-1},s)da^1\dots da^{K-1} \tag{8} π(aK∣s)=∫aK−1⋯∫a1π(a1∣s)τ=2∏Kπ(aτ∣aτ−1,s)da1...daK−1(8) 当K取值较大时,直接对该式计算梯度会迅速变得不可行。
扩散过程每一步,你只能得到单步条件转移概率 π ( a τ ∣ a τ − 1 , s ) \boldsymbol{\pi(a^\tau | a^{\tau-1}, s)} π(aτ∣aτ−1,s):给定上一步中间动作 a τ − 1 a^{\tau-1} aτ−1和状态s,生成这一步中间动作 a τ a^\tau aτ的概率。网络只定义单步转移,没有直接写出 "最终动作a在给定s下的全局概率密度 π ( a ∣ s ) \pi(a|s) π(a∣s)"。
同一个最终动作 a 2 = 1.5 a^2=1.5 a2=1.5,可以通过无数不同的中间 a 1 a^1 a1生成。 想要算 "输出 a 2 = 1.5 a^2=1.5 a2=1.5的总概率",就必须把所有能抵达 a 2 = 1.5 a^2=1.5 a2=1.5的全部中间路径的概率全部加起来(积分)。
不过,将式 (8) 代入式 (7) 化简后,我们可以得到如下形式:
∇ θ J ( θ ) = E ∑ t = 1 ∞ Q ( s t , a t K ) ( ∑ τ = 1 K ∇ θ log π θ ( a t τ ∣ a t τ − 1 , s t ) ) (9) \nabla_\theta J(\theta)=\mathbb{E}\sum_{t=1}^{\infty}Q(s_t,a_t^K)\left(\sum_{\tau=1}^{K}\nabla_\theta\log\pi_\theta(a_t^\tau|a_t^{\tau-1},s_t)\right) \tag{9} ∇θJ(θ)=Et=1∑∞Q(st,atK)(τ=1∑K∇θlogπθ(atτ∣atτ−1,st))(9) 此处期望的采样对象是全部状态 { s t } t = 1 ∞ \{s_t\}{t=1}^\infty {st}t=1∞与所有内部中间动作 { a t τ } τ = 1 K \{a_t^\tau\}{\tau=1}^{K} {atτ}τ=1K。附录 B.1 给出该式的完整证明。
扩散策略中 log π ( a K ∣ s ) \log\pi(a^K|s) logπ(aK∣s)没有闭式。论文做数学恒等变形,把 ∇ θ log π ( a K ∣ s ) \nabla_\theta\log \pi(a^K|s) ∇θlogπ(aK∣s)拆解成内部每一步转移对数梯度之和。
关键结论 :该期望显式依赖所有内部中间状态 { a t τ } τ = 1 K \{a_t^\tau\}{\tau=1}^{K} {atτ}τ=1K,而不仅仅是最终执行的动作 a t a_t at;该推导不依赖扩散模型的特殊结构,对于任意带有隐式内部动作 { a t τ } τ = 1 K \{a_t^\tau\}{\tau=1}^{K} {atτ}τ=1K的模型均成立。
因此可以预判:直接套用该公式进行优化会带来严重的样本低效问题;第 5 节将给出对比实验结果。这也促使我们去探索另一类更新扩散策略的方法,这类方法可以利用扩散模型本身基于分数(score) 的结构来估计Q函数,规避策略梯度带来的上述缺陷。
QSM 的核心理论:最优性条件
在已经得到Q函数的前提下,提出一套全新的策略更新方式,不再依赖策略梯度。优化目标 :将分数场 Ψ \Psi Ψ匹配到目标函数J对应的最优分布分数 Ψ ∗ \Psi^* Ψ∗。
但和标准分数匹配文献不同:我们既无法获取 Ψ ∗ \Psi^* Ψ∗的采样样本,甚至无法得到它所生成的动作分布 π ∗ \pi^* π∗ 。因此这套匹配方案必须依赖一个 Ψ ∗ \Psi^* Ψ∗的替代近似目标。
∇ a log π ( a ∣ s ) \nabla_a \log \pi(a|s) ∇alogπ(a∣s),就是对数概率对动作a求梯度。它是一个向量场,论文记作 Ψ ( s , a ) \boldsymbol \Psi(s,a) Ψ(s,a)。 Ψ ∗ \boldsymbol \Psi^* Ψ∗:最优策略 π ∗ \pi^* π∗对应的分数场 , Ψ ∗ = ∇ a log π ∗ ( a ∣ s ) \Psi^*=\nabla_a\log \pi^{*}(a|s) Ψ∗=∇alogπ∗(a∣s)。 如果我们能直接让当前策略的分数 Ψ \Psi Ψ等于 Ψ ∗ \Psi^* Ψ∗,那我们的策略就直接变成最优策略,任务就解决了。
量纲分析给出一个核心假设:将 Ψ \Psi Ψ与 ∇ a Q Ψ \nabla_a Q^\Psi ∇aQΨ做对比 ------ ∇ a Q Ψ \nabla_a Q^\Psi ∇aQΨ同样是定义在状态--动作空间 S × A \mathcal{S}\times\mathcal{A} S×A上的向量场。直观理解: ∇ a Q Ψ \nabla_a Q^\Psi ∇aQΨ指明了动作应当朝哪个方向调整,才能最大化期望回报。基于此我们定义近似目标 Ψ ∗ ≈ ∇ a Q \Psi^*\approx\nabla_a Q Ψ∗≈∇aQ,并把策略更新转化为迭代地让分数 Ψ \Psi Ψ拟合 ∇ a Q \nabla_a Q ∇aQ目标。
我们可以通过不断将 Ψ \Psi Ψ匹配到自身Q函数关于动作的梯度 ∇ a Q Ψ ( s , a ) \nabla_a Q^\Psi(s,a) ∇aQΨ(s,a)来完成优化。定理 4.1 与定理 4.3 严格给出这套理论结论。
确定性设定:定理 4.1 :在确定性动力学下,若 Ψ ∗ \Psi^* Ψ∗是最大化 Q Ψ ( 0 , 0 ) Q^\Psi(0,0) QΨ(0,0)的最优分数场,则沿最优轨迹上的所有 ( s , a ) (s,a) (s,a),都有:
Ψ ∗ ( s , a ) = α s , a ∇ a Q Ψ ∗ ( s , a ) , α s , a > 0 \Psi^{*}(s, a)=\alpha_{s, a} \nabla_{a} Q^{\Psi^{*}}(s, a), \quad \alpha_{s,a}>0 Ψ∗(s,a)=αs,a∇aQΨ∗(s,a),αs,a>0
即最优策略的分数场与 Q 函数的动作梯度处处共线(方向一致)。
证明思路(反证法) :如果某点处 Ψ \Psi Ψ与 ∇ a Q \nabla_a Q ∇aQ不共线,那么构造一个局部修正的 Ψ ′ \Psi' Ψ′,将该点的分数往 Q 梯度方向偏转,就能严格提升 Q 值,说明原 Ψ \Psi Ψ不是最优的。
随机性设定:定理 4.3:将结论扩展到带布朗噪声的随机动力学(更接近真实 RL 场景),结论依然成立:最优分数场与 Q 函数的动作梯度在分布支撑集内处处共线。
理论的算法意义
- 给出了策略优化的几何视角:策略优化等价于让 score 向量场不断向 Q 的动作梯度向量场对齐;
- 提供了可落地的更新规则:每次迭代中,训练 score 网络 Ψ ϕ \Psi_\phi Ψϕ,让其输出逼近当前 Q 估计的动作梯度 ∇ a Q \nabla_a Q ∇aQ,就能保证策略单调提升。
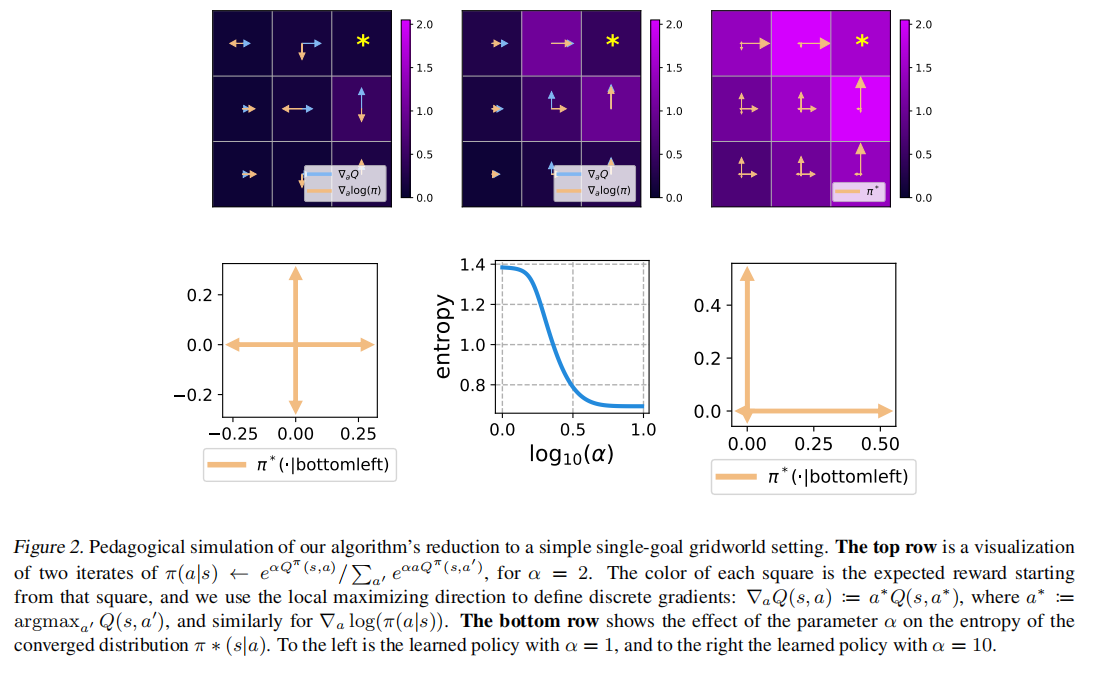
网格世界的直观验证
在离散网格世界中,QSM 退化为经典的软策略迭代 : π ′ ( a ∣ s ) = e α Q π ( s , a ) ∑ A e α Q π ( s , a ) \pi'(a | s)=\frac{e^{\alpha Q^{\pi}(s, a)}}{\sum_{\mathcal{A}} e^{\alpha Q^{\pi}(s, a)}} π′(a∣s)=∑AeαQπ(s,a)eαQπ(s,a)
其中 α \alpha α是逆温度系数:
- α \alpha α越小,策略熵越高,探索性越强;
- α \alpha α越大,策略越集中于高 Q 值动作,越贪心。
这一结论验证了 QSM 与经典 RL 理论的一致性,也说明 α \alpha α可以作为控制探索 - 利用平衡的参数。
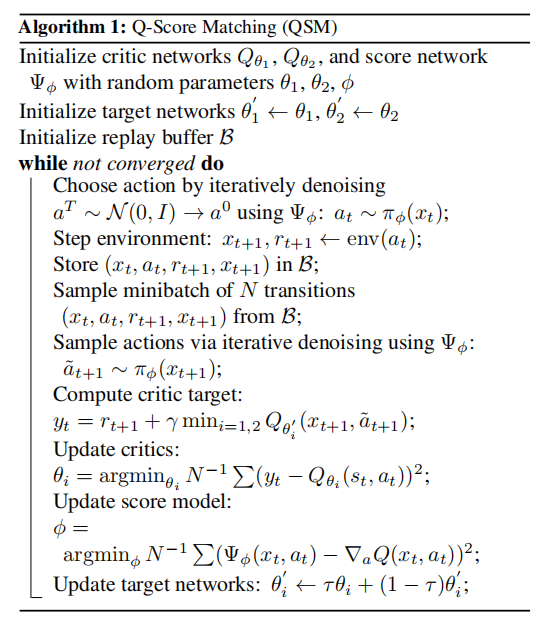
演员更新仅需对去噪网络本身求导,无需反向传播整个扩散采样链,计算量远小于 Diffusion-QL 等方法;数值稳定 :避免了多步扩散反向传播的梯度消失 / 爆炸问题; 天然多模态 :扩散模型的分布表达力 + Q 梯度的引导,能自然学到多模态最优策略; 样本效率高:离策略设计 + 高效的策略更新,样本效率不输 SAC、TD3 等传统高斯策略算法。
实验分析
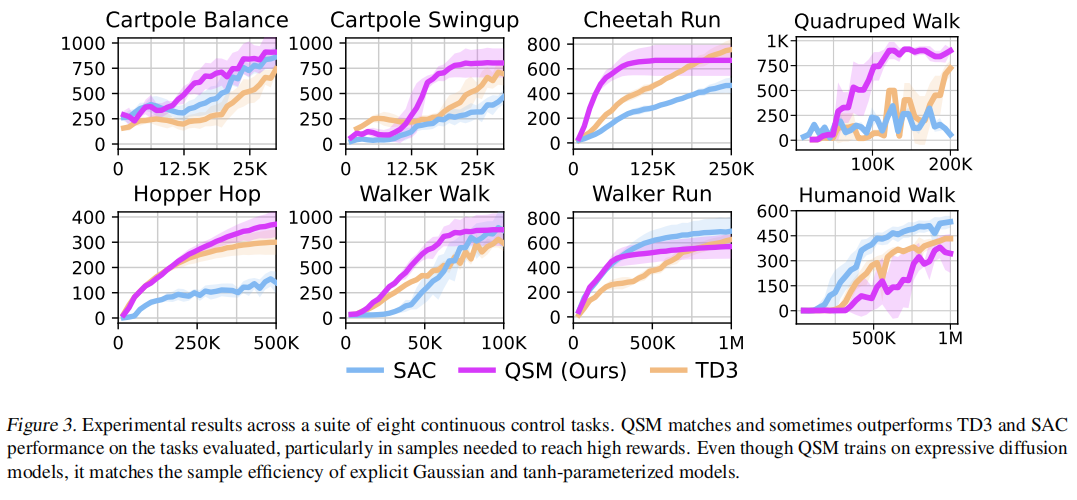
论文在 DeepMind 控制套件的 8 个连续控制任务(Cartpole、Walker、Hopper、Humanoid 等)上进行实验。
与主流 RL 算法的性能对比
基线:SAC(软演员评论家,高斯策略)、TD3(双延迟 DDPG,确定性策略)
- QSM 在所有任务上均达到与 SAC、TD3 相当甚至更优的最终性能;
- 在达到高奖励所需的样本量上,QSM 表现更优 ------ 虽然使用了表达力更强的扩散模型,但样本效率没有下降。
传统高斯策略受限于单峰分布,容易遗漏最优动作模式;QSM 的多模态策略能更精准地逼近真实最优分布。
多模态策略能力验证
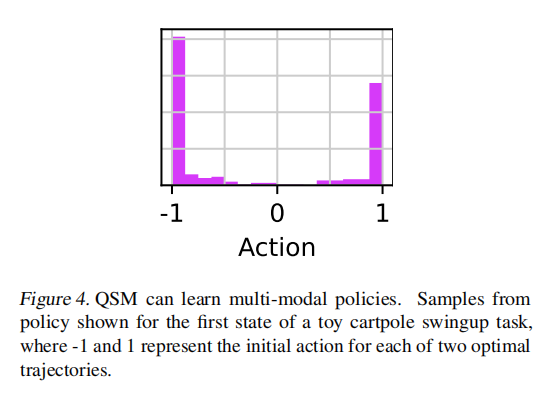
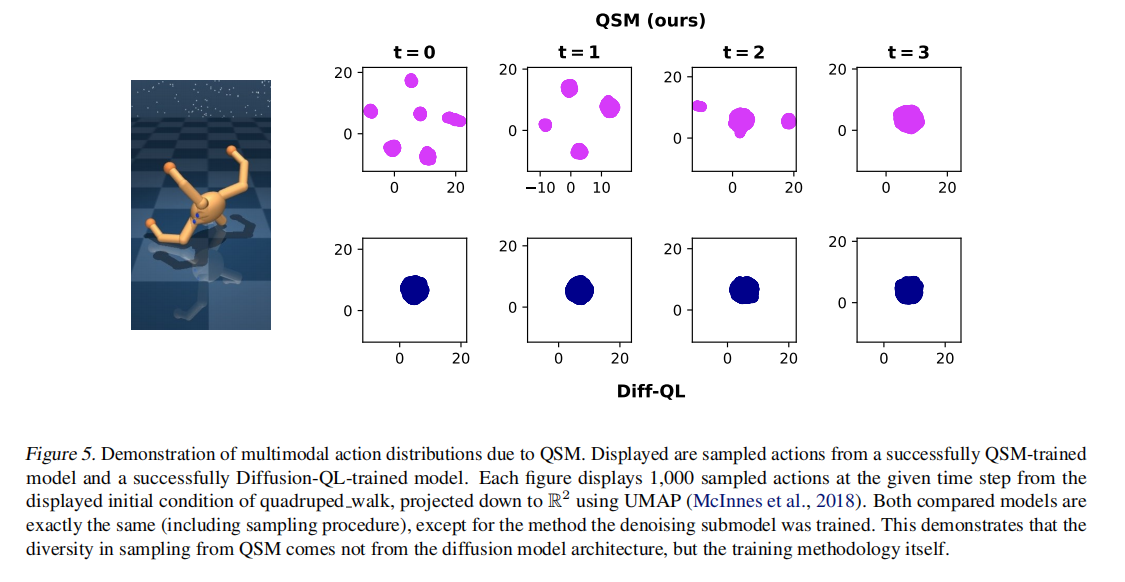
在 Cartpole Swingup 任务中,摆杆起摆存在向左、向右两个对称的最优轨迹,对应两个初始动作模式。
- 结果:QSM 学到的策略在初始状态下是双峰分布,两个峰值分别对应左右两个最优动作方向;
- 对照实验:同样是扩散模型架构,Diffusion-QL 学到的分布更集中、偏向单峰,而 QSM 的动作多样性显著更高 ------ 说明多模态特性来自 QSM 的训练方法,而非扩散模型本身。
与扩散策略梯度的对比
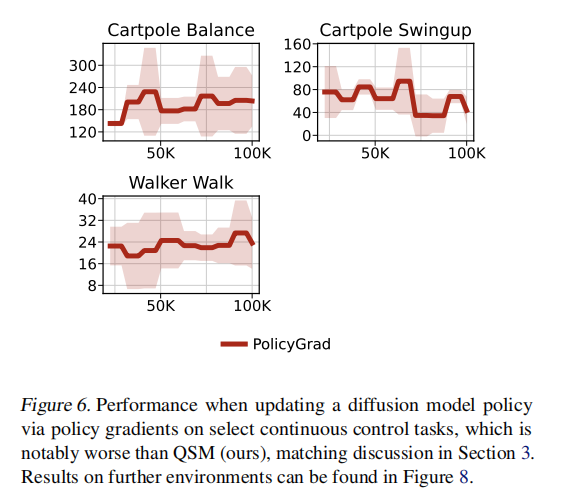
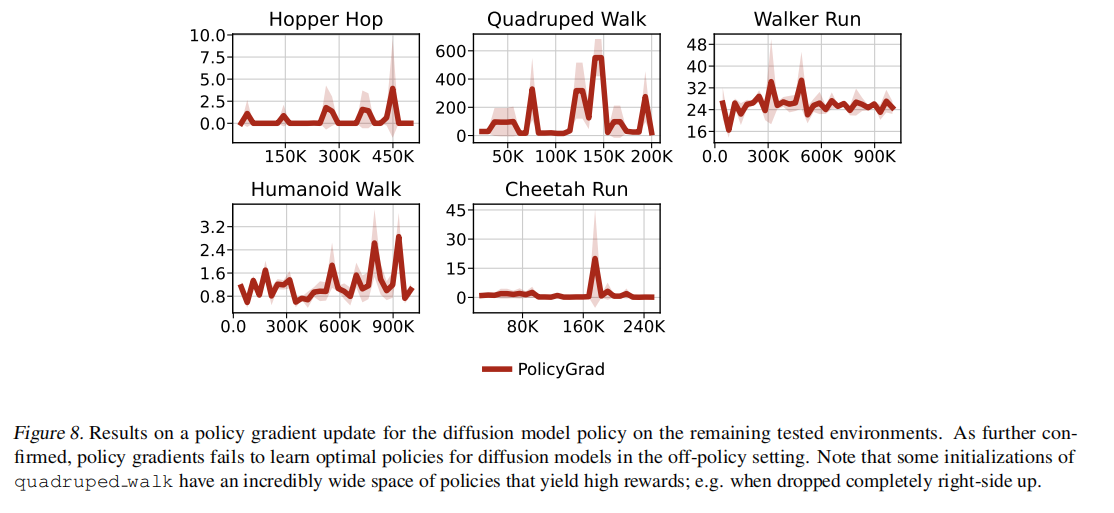
直接对扩散模型用策略梯度(PolicyGrad)的效果远差于 QSM(图 6、图 8),验证了第三章的理论分析:传统策略梯度应用于扩散模型时样本效率极低,难以学到最优策略。
与 Diffusion-QL 的对比
Diffusion-QL 是另一种扩散策略 RL 方法,需要反向传播整个扩散过程来优化 Q 值。
- 性能:两者最终性能相近,但 QSM 更稳定,不容易陷入次优解;
- 计算效率:QSM 的策略更新仅需训练去噪网络,速度远快于 Diffusion-QL;
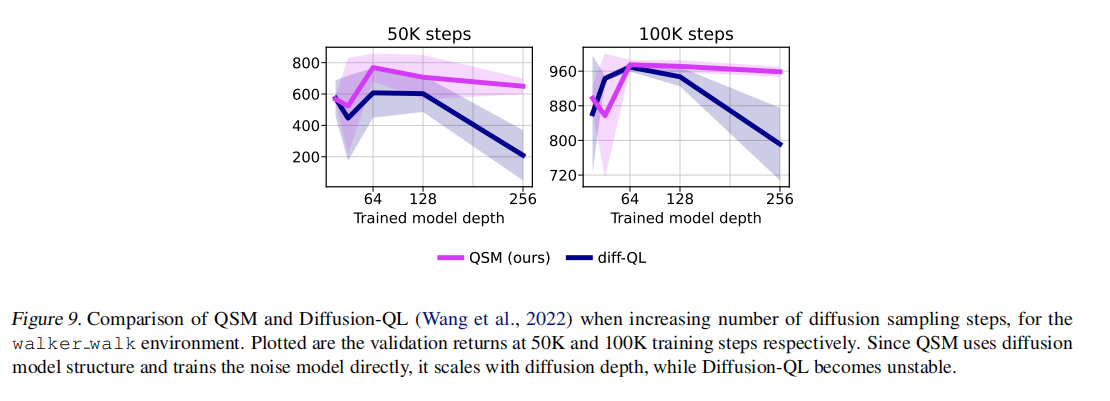
- 扩展性(图 9):当扩散采样步数(模型深度)增加时,QSM 性能稳定提升,而 Diffusion-QL 会变得不稳定 ------ 因为 QSM 天然适配扩散模型的层级结构,而 Diffusion-QL 的长链反向传播会随步数增加而恶化。
总结思考
建立了扩散策略的分数场与 Q 函数动作梯度之间的最优性条件,为扩散模型策略的优化提供了全新的几何视角;提出 Q-score matching 算法,仅通过训练去噪网络实现策略更新,计算高效、稳定性强,解决了扩散策略梯度的核心痛点;在连续控制任务上实现了兼具多模态表达力和高样本效率的策略,性能比肩主流 RL 算法。
当前假设 Σ a \Sigma_a Σa固定,未来可同时优化噪声项,与最大熵强化学习结合,更好地平衡探索与利用;利用扩散模型的特性(如控制去噪步数)设计更智能的探索机制; 复杂场景推广:将 QSM 推广到高维动作空间、机器人操作等更复杂的任务中。
额外补充
- 为什么 EBM 必须算 Z 才能得到概率?
假设我们想知道「北京随机选一个人,住在哪个区的概率」: 非归一化概率 :只统计各区的人口数:朝阳区 300 万、海淀区 200 万、西城区 100 万。这些数字只反映 相对多少。
EBM 的标准形式是: p ( x ) = 1 Z ⋅ e − E ( x ) p(x) = \frac{1}{Z} \cdot e^{-E(x)} p(x)=Z1⋅e−E(x)
- e − E ( x ) e^{-E(x)} e−E(x) 就是非归一化概率 :神经网络只输出一个标量能量 E ( x ) E(x) E(x),能量越低, e − E ( x ) e^{-E(x)} e−E(x)越大,代表 x 越「可能」。它只表示相对高低,不是真正的概率。
在 高维空间里,直接输出「积分等于 1 的概率密度」几乎不可能 ,而输出一个任意标量能量函数非常简单。 Z = ∫ e − E ( x ) d x Z=\int e^{-E(x)}dx Z=∫e−E(x)dx 归一化常数 是高维积分,根本无法精确计算。这就是 EBM 的核心痛点:只能比大小,算不出精确概率,采样也很麻烦。
- 为什么扩散模型 推理阶段必须跑完整 K 步去噪?
只要是用扩散模型生成样本(推理 / 采样阶段),都必须跑完整 K 步去噪。这是扩散模型本身的固有性质,和算法无关。扩散模型的设计从根上就是「多步迭代」的:
前向加噪一点点把信号染成噪声,每一步只改变一点点分布 ,单步无法直接从纯噪声跳到干净数据。反向去噪一点点把噪声还原成信号,教网络的是 给定带噪样本 a t a_t at,预测单步的噪声 / 分数 ------ 网络只会「修一步」。
训练可以看成练「每擦一次黑板的手法」;推理 = 把写满字的黑板擦干净,必须擦很多次,一次擦不干净。所有扩散模型都遵守这个逻辑。
为什么训练阶段可以单步?
因为训练的是 单步去噪算子 :拿一个真实样本 a 0 a_0 a0,手动加 t 步噪声得到 a t a_t at,让网络预测这一步的噪声 / 分数,损失只在这一步上计算。计算图只有一次网络前向,反向传播自然只走一次。
推理采样 :所有扩散方法都要 K 步;训练更新:QSM 和标准扩散一样是「单步训练」,Diffusion-QL 是「多步训练」。
- 不同监督目标的区别:原始扩散 vs QSM
| 对比项 | 原始扩散 / 行为克隆 | QSM |
|---|---|---|
| 监督信号 | 真实数据的噪声 / 数据分布分数 | Q 函数对动作的梯度 |
| 公式目标 | m i n ∥ ε θ − ε ∥ 2 min∥εθ−ε∥2 min∥εθ−ε∥2 | m i n ∥ Ψ ϕ − ∇ a Q ∥ 2 min∥Ψϕ−∇aQ∥2 min∥Ψϕ−∇aQ∥2 |
| 分数场含义 | 数据分布的坡度 | Q 值函数的坡度 |
| 采样终点 | 和专家数据一致 | Q 值最高的区域 |
| 学习范式 | 模仿学习 | 强化学习优化 |
| 训练结构 | 单步拟合,反向传播 1 次 | 单步拟合,反向传播 1 次 |
| 推理结构 | K 步迭代去噪 | K 步迭代去噪 |
原始diffusion 拟合训练数据分布 的对数概率梯度: ∇ a log p data ( a ∣ s ) \nabla_a \log p_{\text{data}}(a|s) ∇alogpdata(a∣s)。拿真实样本 a 0 a_0 a0,加噪得到 a t a_t at,监督信号是真实加的噪声 ε \varepsilon ε(等价于真实分数): L = E t , a 0 , ε ∥ ε θ ( a t , s , t ) − ε ∥ 2 \mathcal{L} = \mathbb{E}_{t,a_0,\varepsilon}\left\\left\\\|\\varepsilon_\\theta(a_t,s,t) - \\varepsilon\\right\\\|\^2\\right L=Et,a0,ε∥εθ(at,s,t)−ε∥2
就像你跟着导航走,导航的终点是「别人去过的地方」(专家演示)。你走的路径和专家一模一样,不会探索新的更好的地方。
QSM 拟合Q 函数对动作的梯度 : ∇ a Q π ( s , a ) \nabla_a Q^\pi(s,a) ∇aQπ(s,a) 。拿回放缓冲区的真实动作 a,加噪得到 a t a_t at,监督信号是当前 Q 网络对动作的梯度: L = E ( s , a ) ∼ B , t ∥ Ψ ϕ ( a t , s , t ) − ∇ a Q ( s , a ) ∥ 2 \mathcal{L} = \mathbb{E}_{(s,a)\sim\mathcal{B},t}\left\\left\\\|\\Psi_\\phi(a_t,s,t) - \\nabla_a Q(s,a)\\right\\\|\^2\\right L=E(s,a)∼B,t∥Ψϕ(at,s,t)−∇aQ(s,a)∥2
就像你跟着等高线的坡度走,坡度指向山顶(回报最高的地方)。你不需要别人走过,只要知道哪里高就往哪爬。
为什么 Diffusion-QL 训练必须多步反向传播?
Diffusion-QL 的损失不是「单步拟合误差」,而是「最终生成动作的 Q 值 」: L = − E s Q ( s , a 0 θ ( s ) ) \mathcal{L} = -\mathbb{E}{s}\leftQ\\left(s,\\,a_0\^\\theta(s)\\right)\\right L=−EsQ(s,a0θ(s)),反向传播时,梯度要从 a 0 a_0 a0 一路往回传,穿过每一层 f θ f\theta fθ,一直传到初始噪声 a T a_T aT。而 QSM 把损失放在了「单步分数拟合」上,彻底绕开了整条采样链的反向传播,同时又通过定理保证了优化方向的正确性。
损失在链条的最末端,梯度必须顺着整条链往回传,才能更新到每一步的网络参数。
QSM 的巧妙之处,就是把 RL 的策略优化问题,转化成了和标准扩散一样的 "单步监督拟合" 问题。
从回放缓冲区拿一个真实交互得到的动作a (相当于干净样本 a 0 a_0 a0); 随机选一个时间步t,给a加t步噪声,得到带噪动作 a t a_t at; 分数网络输入 a t , s , t a_t,s,t at,s,t,输出预测的分数 Ψ ϕ \Psi_\phi Ψϕ; 监督目标 :不是加的噪声,而是当前 Q 网络对动作a的梯度 ∇ a Q ( s , a ) \nabla_a Q(s,a) ∇aQ(s,a); 损失 = MSE ( Ψ ϕ , ∇ a Q ) (\Psi_\phi,\ \nabla_a Q) (Ψϕ, ∇aQ); 反向传播:梯度只穿过1 次分数网络,直接更新参数。
定理 4.1/4.3 严格证明:最优策略的分数场 Ψ ∗ \Psi^* Ψ∗,和最优 Q 函数的动作梯度 ∇ a Q ∗ \nabla_a Q^* ∇aQ∗,在空间中处处方向一致(共线): Ψ ∗ ( s , a ) = α s , a ⋅ ∇ a Q ∗ ( s , a ) , α s , a > 0 \Psi^*(s,a) = \alpha_{s,a}\cdot\nabla_a Q^*(s,a),\quad \alpha_{s,a}>0 Ψ∗(s,a)=αs,a⋅∇aQ∗(s,a),αs,a>0
所以我们不需要绕弯子去 "优化最终动作的 Q 值",直接让单步的分数逼近 Q 梯度,就等价于在优化策略------ 相当于把 "全程优化" 的难题,拆解成了 "每一步都往正确方向挪一点" 的单步监督问题。
- ODE 与 SDE
普通常微分方程(ODE): d x d t = b ( x ( t ) ) ⇒ d x = b ( x ( t ) ) d t \frac{dx}{dt}=b(x(t)) \quad \Rightarrow \quad dx = b(x(t)) dt dtdx=b(x(t))⇒dx=b(x(t))dt,描述完全确定、没有噪声的系统:给定初值,未来轨迹唯一确定。
但现实世界到处有随机噪声(风、测量噪声、环境扰动)。
随机微分方程(Stochastic Differential Equation, SDE) = 确定性漂移 + 随机噪声扰动
d x ( t ) = b ( x ( t ) ) d t + σ ( x ( t ) ) d W t \boldsymbol{dx(t) = b(x(t))\,dt + \sigma(x(t))\,dW_t} dx(t)=b(x(t))dt+σ(x(t))dWt
- d x ( t ) dx(t) dx(t):过程 x ( t ) x(t) x(t)在无穷小时间dt内的增量
- b ( x ( t ) ) d t b(x(t))dt b(x(t))dt:漂移项 (drift),确定性部分。
b ( x ) b(x) b(x)就是瞬时变化速度;如果没有后面一项,就是普通 ODE。
- σ ( x ( t ) ) d W t \boldsymbol{\sigma(x(t))\,dW_t} σ(x(t))dWt:扩散项 (diffusion),随机噪声部分
- W t W_t Wt:布朗运动(维纳过程 Wiener process)
- d W t dW_t dWt:布朗运动的无穷小增量